So extrahieren Abrechnungsteams
Daten aus Hunderten von EOBs im Batch-Verfahren
Die meisten Dokumentextraktionstools gehen bei Leistungsabrechnungen von derselben Annahme aus: dass es sich um standardisierte Dokumente handelt. Das sind sie nicht. Eine Blue-Cross-EOB aus Florida sieht ganz anders aus als eine Blue-Cross-EOB aus Illinois. Eine Aetna-EOB verwendet andere Spaltenüberschriften als eine Medicare-Zahlungsmitteilung. Multiplizieren Sie das mit 15 oder 20 Kostenträgern, und der Engpass bei der EOB-Verarbeitung ist nicht die Tippgeschwindigkeit—sondern die Formatvielfalt. Für Abrechnungsteams, die monatlich Hunderte dieser Dokumente verarbeiten, ist die Frage nicht, ob KI eine EOB lesen kann. Sondern ob eine einzige Extraktionskonfiguration alle in einem einzigen Batch verarbeiten kann.
Warum sich EOBs der Automatisierung widersetzen, die bei Standardformularen funktioniert
Der Grund, warum die meisten Dokumentextraktions-Tools bei Explanation of Benefits scheitern, ist nicht die Genauigkeit—sondern die Fragmentierung der Formate. Es gibt über 6.000 verschiedene EOB-Layouts bei den Kostenträgern in den USA. Jeder Versicherer—UnitedHealthcare, Aetna, Cigna, Humana, Medicare, Medicaid, Arbeitnehmerentschädigungsträger—organisiert dieselben Datenpunkte unterschiedlich. Einige verwenden horizontale Tabellen, andere vertikale Abschnitte. Einige unterteilen die Patientenverantwortung in vier Unterspalten; andere fassen sie in einer Zeile zusammen. Einige Zahlungsträger ändern sogar die Layouts innerhalb einer einzelnen EOB, indem sie ein Format für bezahlte Ansprüche und ein anderes für abgelehnte auf derselben PDF verwenden.
Das ist wichtig, weil vorlagenbasierte Extraktionswerkzeuge—Werkzeuge, die erfordern, dass Sie ein festes Layout für jeden Dokumenttyp definieren—eine separate Vorlage für jedes Paylerformat verlangen. Wenn ein Payler sein Layout aktualisiert, was häufiger passiert, als Sie erwarten, bricht die Vorlage. Abrechnungsteams müssen dann Extraktionsvorlagen pflegen, anstatt Zahlungen zu verbuchen.
Eine EOB, kurz für Explanation of Benefits, ist das Dokument, das eine Versicherungsgesellschaft nach der Verarbeitung eines Gesundheitsanspruchs sendet. Es zeigt auf, was abgerechnet wurde, was der Plan abdeckte, was der Versicherer zahlte und was der Patient schuldet. Für Anbieter, die nicht bei jedem Payler für elektronische Überweisungsmitteilungen (ERA) angemeldet sind—oder die unabhängig davon Papier-EOBs von bestimmten Trägern erhalten—muss jede EOB manuell überprüft, in das Praxisverwaltungssystem eingegeben und mit den Claim-Aufzeichnungen abgeglichen werden. Die ERA ist die elektronische Version einer EOB, die als ASC X12 835-Transaktion unter HIPAA-Standards übertragen wird. Wenn sie funktioniert, automatisiert sie die Verbuchung. Aber viele Versicherer senden weiterhin Papier- oder PDF-EOBs, und selbst Anbieter, die für große Versicherer bei ERA angemeldet sind, erhalten oft PDF-EOBs von sekundären Versicherern, Arbeitgeberentschädigungsträgern oder staatsspezifischen Medicaid-Programmen.
Wichtige Erkenntnis: Der Engpass bei der EOB-Verarbeitung ist nicht die Geschwindigkeit der Dateneingabe. Es ist die Tatsache, dass keine zwei Versicherer dasselbe Format verwenden—und Abrechnungsteams dennoch jeden Datenpunkt aus jedem Format benötigen, um Zahlungen korrekt zu verbuchen.
Die tatsächlichen Arbeitskosten der manuellen EOB-Erfassung
Die manuelle EOB-Dateneingabe verbraucht laut Daten aus Abrechnungsabteilungen, die dies gemessen haben, 5 bis 8 Minuten pro Dokument. Bei 500 EOBs pro Monat—einem typischen Volumen für eine mittelgroße Praxis oder ein kleines Abrechnungsunternehmen—sind das 40 bis 65 Arbeitsstunden des Personals. Bei 25 $ pro Stunde für Abrechnungspersonal belaufen sich die jährlichen Arbeitskosten auf etwa 12.000 bis 19.500 $, allein für die EOB-Dateneingabe.
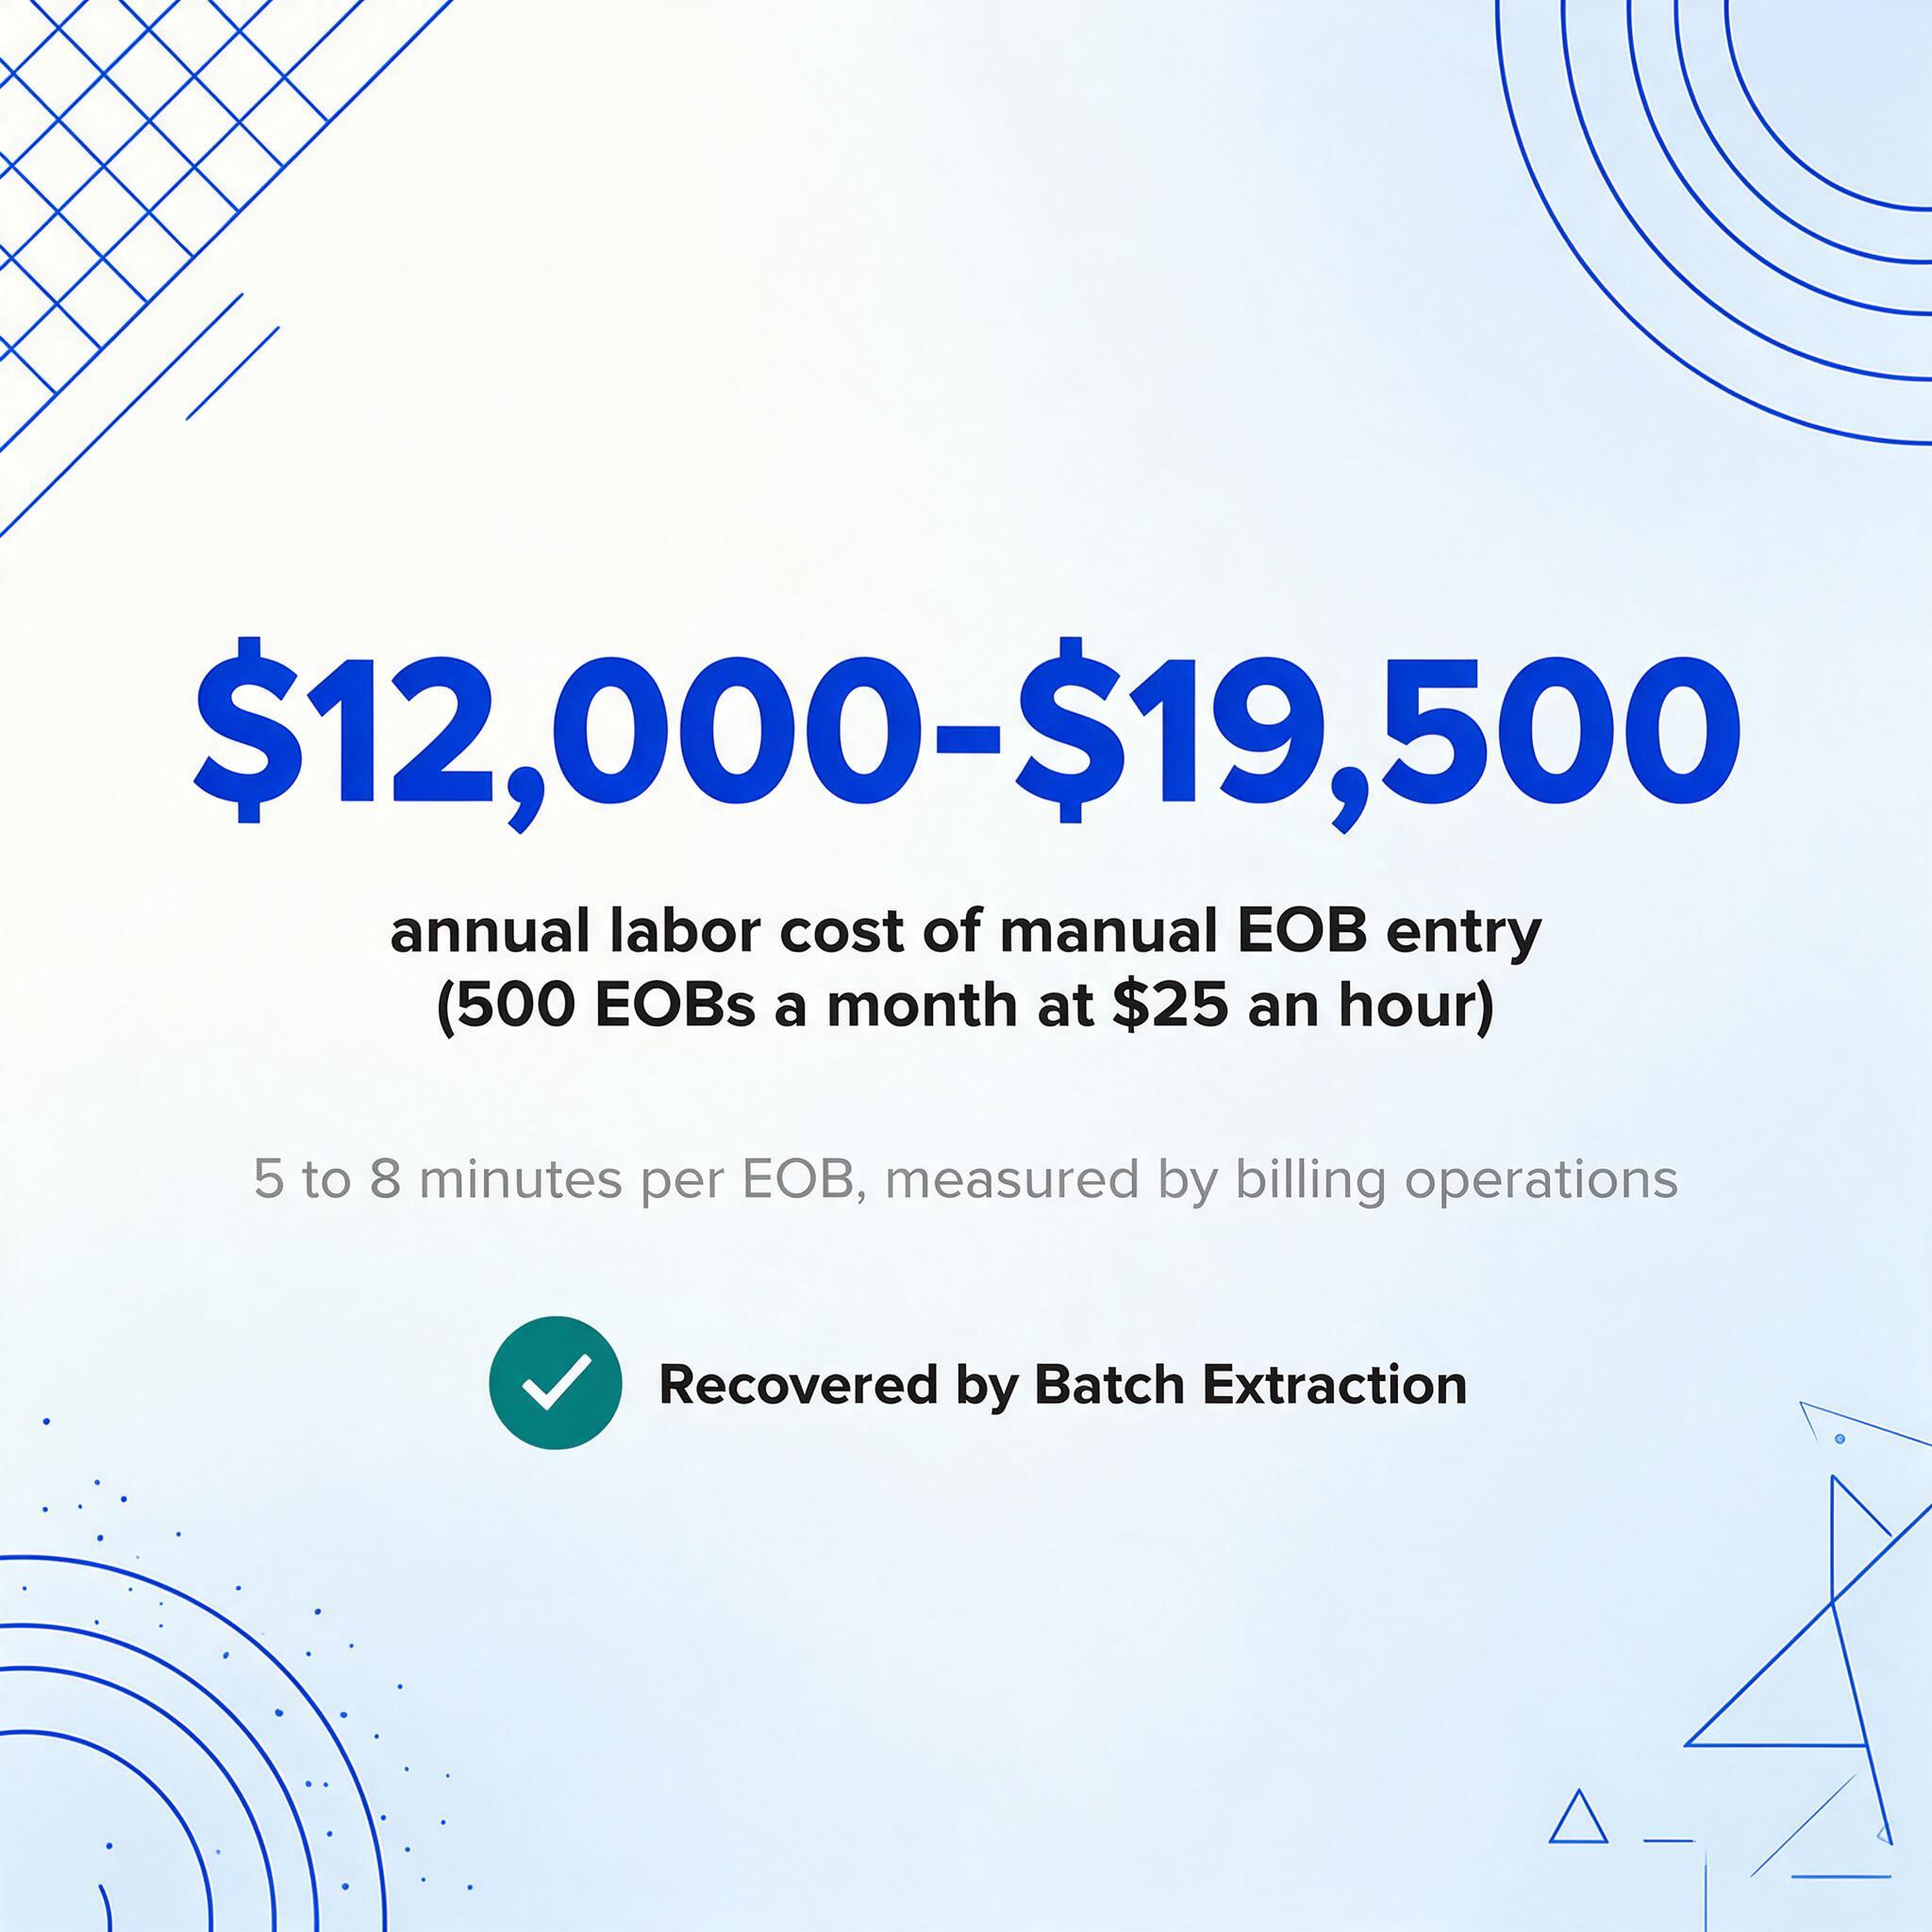
Diese Zahl umfasst nicht die nachgelagerten Kosten. Der CAQH-Index, der maßgebliche Branchen-Benchmark für administrative Transaktionskosten, beziffert die Kosten für die Nachbearbeitung eines einzelnen abgelehnten Anspruchs auf etwa 25 $ für einfache Korrekturen. Komplexe Einsprüche, die klinische Dokumentation erfordern, können 100 $ oder mehr kosten. Und die Ablehnungsraten steigen: Der nationale Durchschnitt für 2025 überschritt 12,4 %, ein Zehnjahreshoch laut Branchendaten. Die MGMA-DataDive 2023 ergab, dass Einzelfachpraxen eine Ablehnungsrate von 8 % bei der Ersteinreichung hatten, und eine MGMA-Umfrage vom März 2024 berichtete, dass 60 % der medizinischen Gruppen im Vergleich zum Vorjahr höhere Ablehnungsraten verzeichneten.
Wenn EOB-Daten manuell eingegeben werden, führen Tippfehler bei CPT-Codes (Current Procedural Terminology Codes, gepflegt von der American Medical Association, zur Beschreibung medizinischer Leistungen auf Ansprüchen), falsche Anpassungsbeträge oder falsch gelesene CARC-Codes (Claim Adjustment Reason Codes—standardisierte Codes, die erklären, warum ein Anspruch anders vergütet wurde als abgerechnet) zu nachgelagerter Abstimmungsarbeit. Eine CO-45-Anpassung (Gebühr übersteigt den Gebührenplan), die fälschlich als CO-97 eingegeben wird (Leistung in einer anderen Zahlung enthalten), führt das Abrechnungsteam auf den falschen Lösungsweg. Dies sind keine theoretischen Randfälle—sondern alltägliche Vorkommnisse in manuellen Arbeitsabläufen.
Laut dem Council for Affordable Quality Healthcare (CAQH) werden 24 Cent jedes Gesundheitsdollars für Verwaltungs- und Abrechnungskosten ausgegeben. Die Branche könnte schätzungsweise 9,4 Milliarden $ jährlich einsparen, indem manuelle Transaktionen in elektronische umgewandelt werden. Der CAQH-Index 2025 ergab, dass das US-Gesundheitswesen 2024 durch elektronische Transaktionen 258 Milliarden $ an Verwaltungskosten vermieden hat—was bedeutet, dass es in den Teilen des Umsatzzyklus, die manuell bleiben, wie der PDF-EOB-Verarbeitung, weiterhin erhebliches Verbesserungspotenzial gibt.
Was Einzel-EOB-Extraktionstools bei Batch-Workflows übersehen
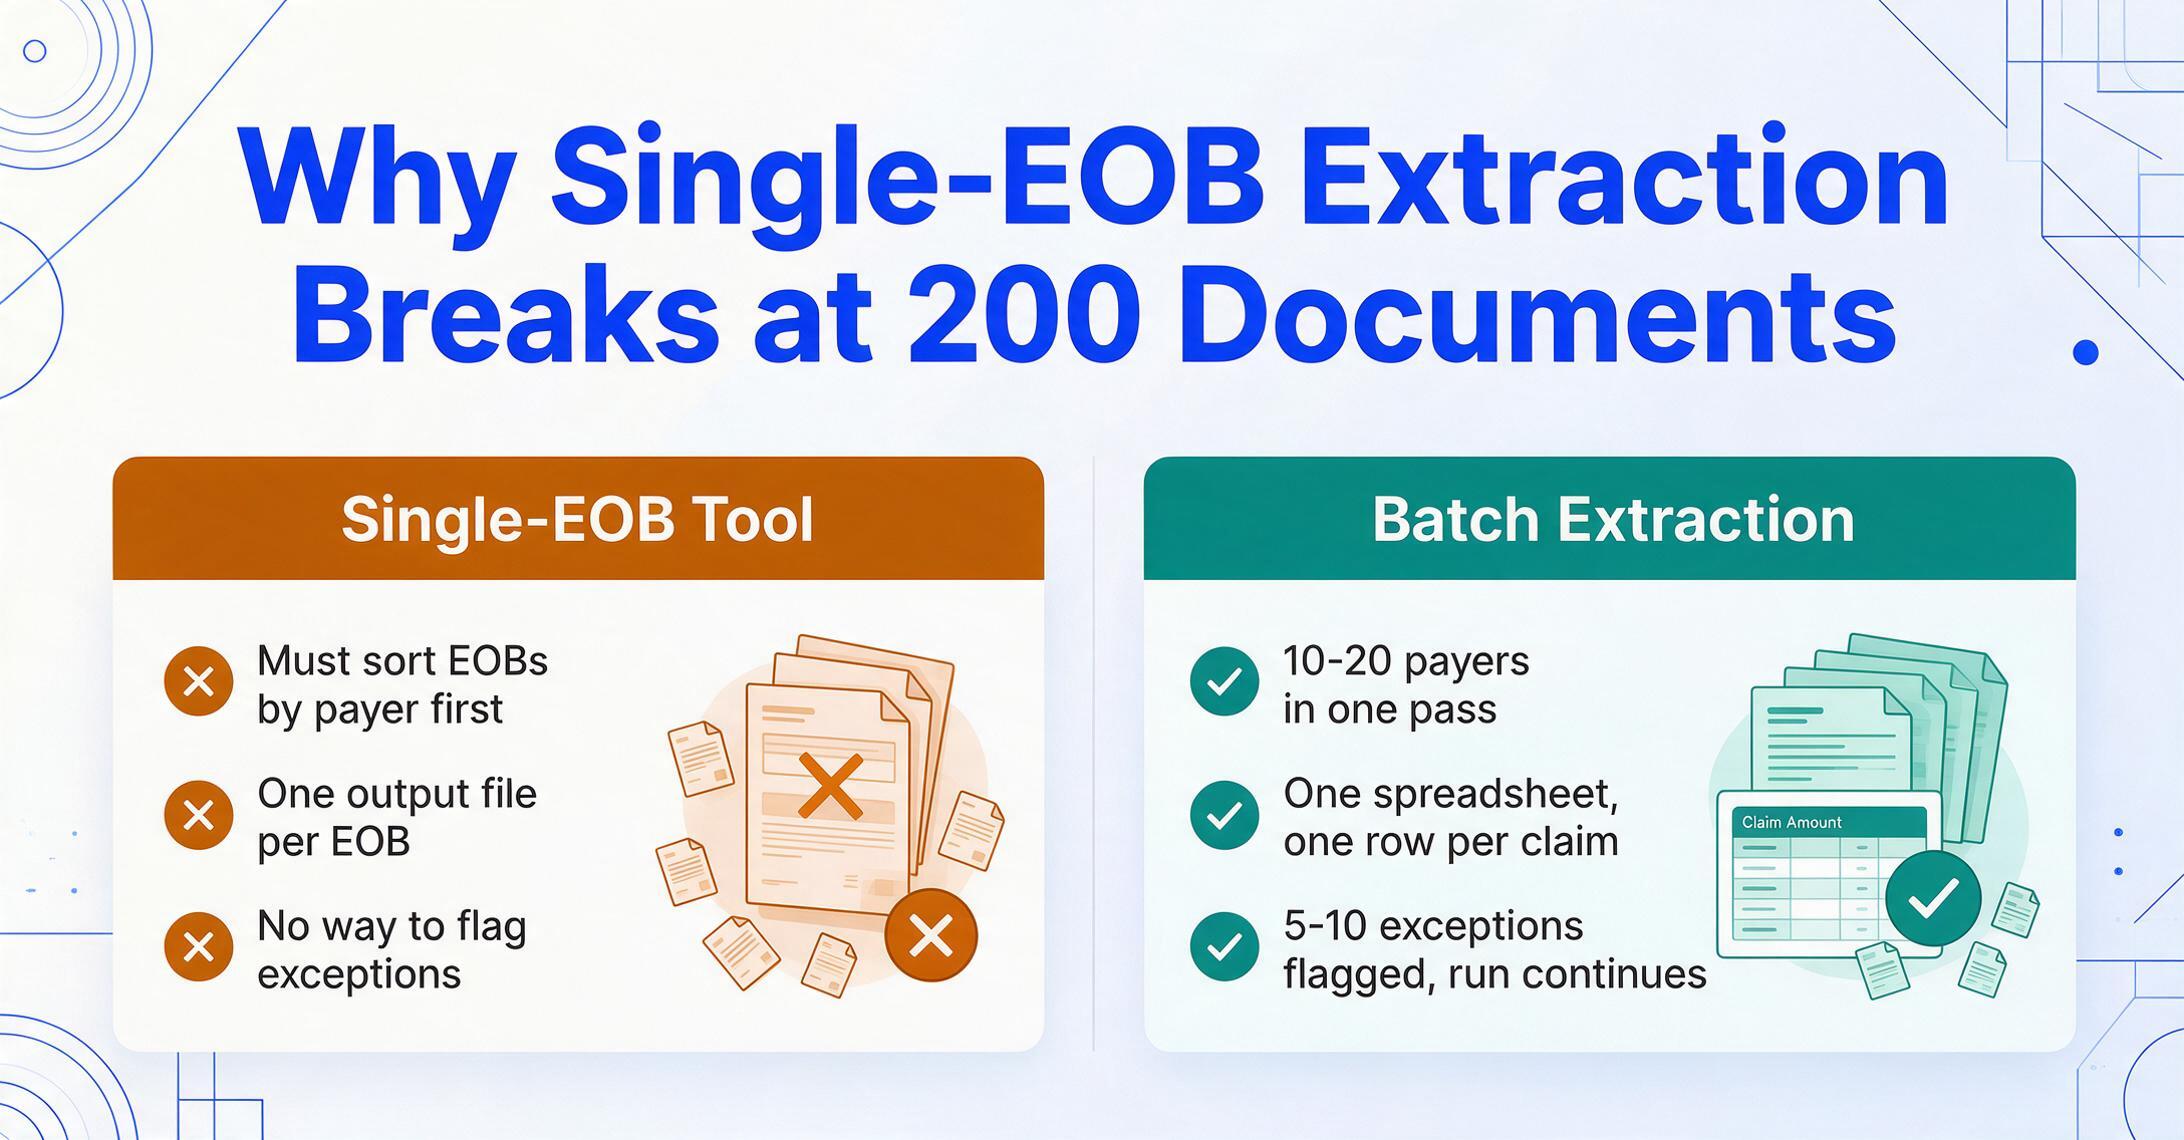
Eine einzelne EOB zu verarbeiten ist ein grundlegend anderes Problem als 200 auf einmal zu verarbeiten. Der Einzel-EOB-Workflow—PDF öffnen, Daten extrahieren, ins System kopieren, wiederholen—bricht bei hohem Volumen auf eine Weise zusammen, die nichts mit der Extraktionsgenauigkeit zu tun hat.
Gemischte Zahlerträger-Stapel. Ein Stapel von 200 EOBs enthält typischerweise Dokumente von 10 bis 20 verschiedenen Zahlern. Medicare-EOBs verwenden CARC/RARC-Codepaare in einem spezifischen Überweisungsmitteilungsformat. UnitedHealthcare-EOBs strukturieren die Patientenzahlungspflicht anders als Aetna-EOBs. Ein Batch-Extraktionstool muss alle in einem Durchgang verarbeiten, ohne dass der Benutzer die EOBs zuerst nach Zahler sortieren muss. Wenn Sie sie vor dem Hochladen trennen müssen, haben Sie die manuelle Arbeit nur einen Schritt nach vorne verlagert.
Zusammenführen der Ausgaben. Wenn ein Tool EOBs einzeln verarbeitet, ist die Ausgabe eine Datei pro EOB. Batch-Extraktion bedeutet, dass alle 200 Ergebnisse in einer einzigen Tabelle ankommen—eine Zeile pro Anspruch, alle Spalten ausgerichtet. Dies ist das Format, das Abrechnungsmanager für den Massenimport in ihr Praxismanagementsystem oder für den Monatsabschluss benötigen.
Ausnahmebehandlung. In einem Stapel von 200 EOBs werden 5 bis 10 etwas Ungewöhnliches aufweisen: eine handschriftliche Anpassungsnotiz am Rand, eine zweiseitige EOB mit Fortsetzungsdaten, ein Patientenname, der fast, aber nicht exakt mit Ihren Aufzeichnungen übereinstimmt. Ein Batch-Workflow muss diese Ausnahmen für die menschliche Überprüfung kennzeichnen, ohne den gesamten Verarbeitungslauf zu stoppen. Tools, die die Einzel-EOB-Extraktion als Standard behandeln, bieten dafür keinen Mechanismus.
Dateiquellen. Abrechnungsteams beziehen EOBs aus mehreren Kanälen: Zahlerträger-Portale (Availity, UnitedHealthcare Provider Portal, einzelne Carrier-Websites), per E-Mail gesendete PDFs, Faxkopien und gescannte Papieroriginale. Ein Batch-Workflow muss jede Kombination davon akzeptieren, ohne separate Vorverarbeitungsschritte für jede Quelle.
Wenn Sie neu darin sind, was eine EOB eigentlich ist und welche Felder für den Abgleich wichtig sind, deckt unsere Übersicht zur EOB-Datenextraktion die Feld-für-Feld-Aufschlüsselung ab, und unser vollständiger Leitfaden zur EOB-Datenextraktion führt Sie durch Auswahlkriterien und Exportoptionen von Anfang bis Ende. Und für einen direkten Vergleich von Tools, die diese Art von gemischtem Batch-Workflow bewältigen können, sehen Sie sich unsere Übersicht zu Dokumentextraktionstools im Gesundheitswesen an, die sieben Tools an 40 echten EOBs, Anspruchsformularen und Patientendokumenten testet.
So liest KI EOB-Layouts ohne Vorlagen pro Kostenträger
Der technische Ansatz, der die Formatvielfalt der Kostenträger bewältigt, unterscheidet sich grundlegend von der templatebasierten Extraktion. Template-Tools verwenden feste Koordinaten—„der Erstattungsbetrag befindet sich an Position X, Y auf der Seite." Wenn ein Kostenträger sein Layout ändert, stimmt die Koordinate nicht mehr. Wenn ein neuer Kostenträger seine erste EOB sendet, gibt es überhaupt kein Template.
KI-basierte Extraktion mit Vision-Language-Modellen funktioniert anders. Statt Seitenkoordinaten abzugleichen, liest sie das Dokument semantisch—sie versteht, was jeder Abschnitt bedeutet, nicht nur, wo er steht. Sie definieren die benötigten Spalten: Patientenname, Leistungsdatum, CPT-Code, Abrechnungsbetrag, Erstattungsbetrag, Selbstbeteiligung, Zuzahlung, Patientenzahlungspflicht, Anpassungscode (CARC), Anpassungsbetrag, Ablehnungsgrund. Die KI findet jeden Wert überall auf der Seite, indem sie die Struktur des Dokuments versteht—genau wie ein menschlicher Abrechnungssachbearbeiter ein unbekanntes EOB-Layout überfliegt, den Patientennamen oben findet und den Spaltenüberschriften folgt, um den Erstattungsbetrag zu ermitteln.
Dieser Ansatz, den ImageToTable.ai Spaltennamens-Extraktion nennt, bedeutet, dass Sie die gewünschten Feldnamen eingeben und die KI diese unabhängig davon, wo der jeweilige Kostenträger die Felder platziert, Werten zuordnet. Eine Konfiguration verarbeitet eine UnitedHealthcare-EOB und eine Aetna-EOB im selben Batch ohne Änderungen. Das Ergebnis ist eine einheitliche Tabelle, in der jede Zeile dieselben Spalten hat—unabhängig davon, welcher Kostenträger das ursprüngliche PDF erstellt hat.
Dateien werden sicher verarbeitet und nicht gespeichert.
Das ist der Unterschied zwischen dem Erstellen und Pflegen von 20 Extraktions-Templates—eines pro Kostenträger—und dem einmaligen Definieren Ihrer Ausgabespalten. Für ein Abrechnungsteam, das EOBs von 15 oder mehr Kostenträgern verarbeitet, ist der Pflegeaufwand des Template-Ansatzes keine einmalige Kosten. Er ist eine laufende operative Belastung.
Ein Batch-EOB-Extraktions-Workflow, Schritt für Schritt
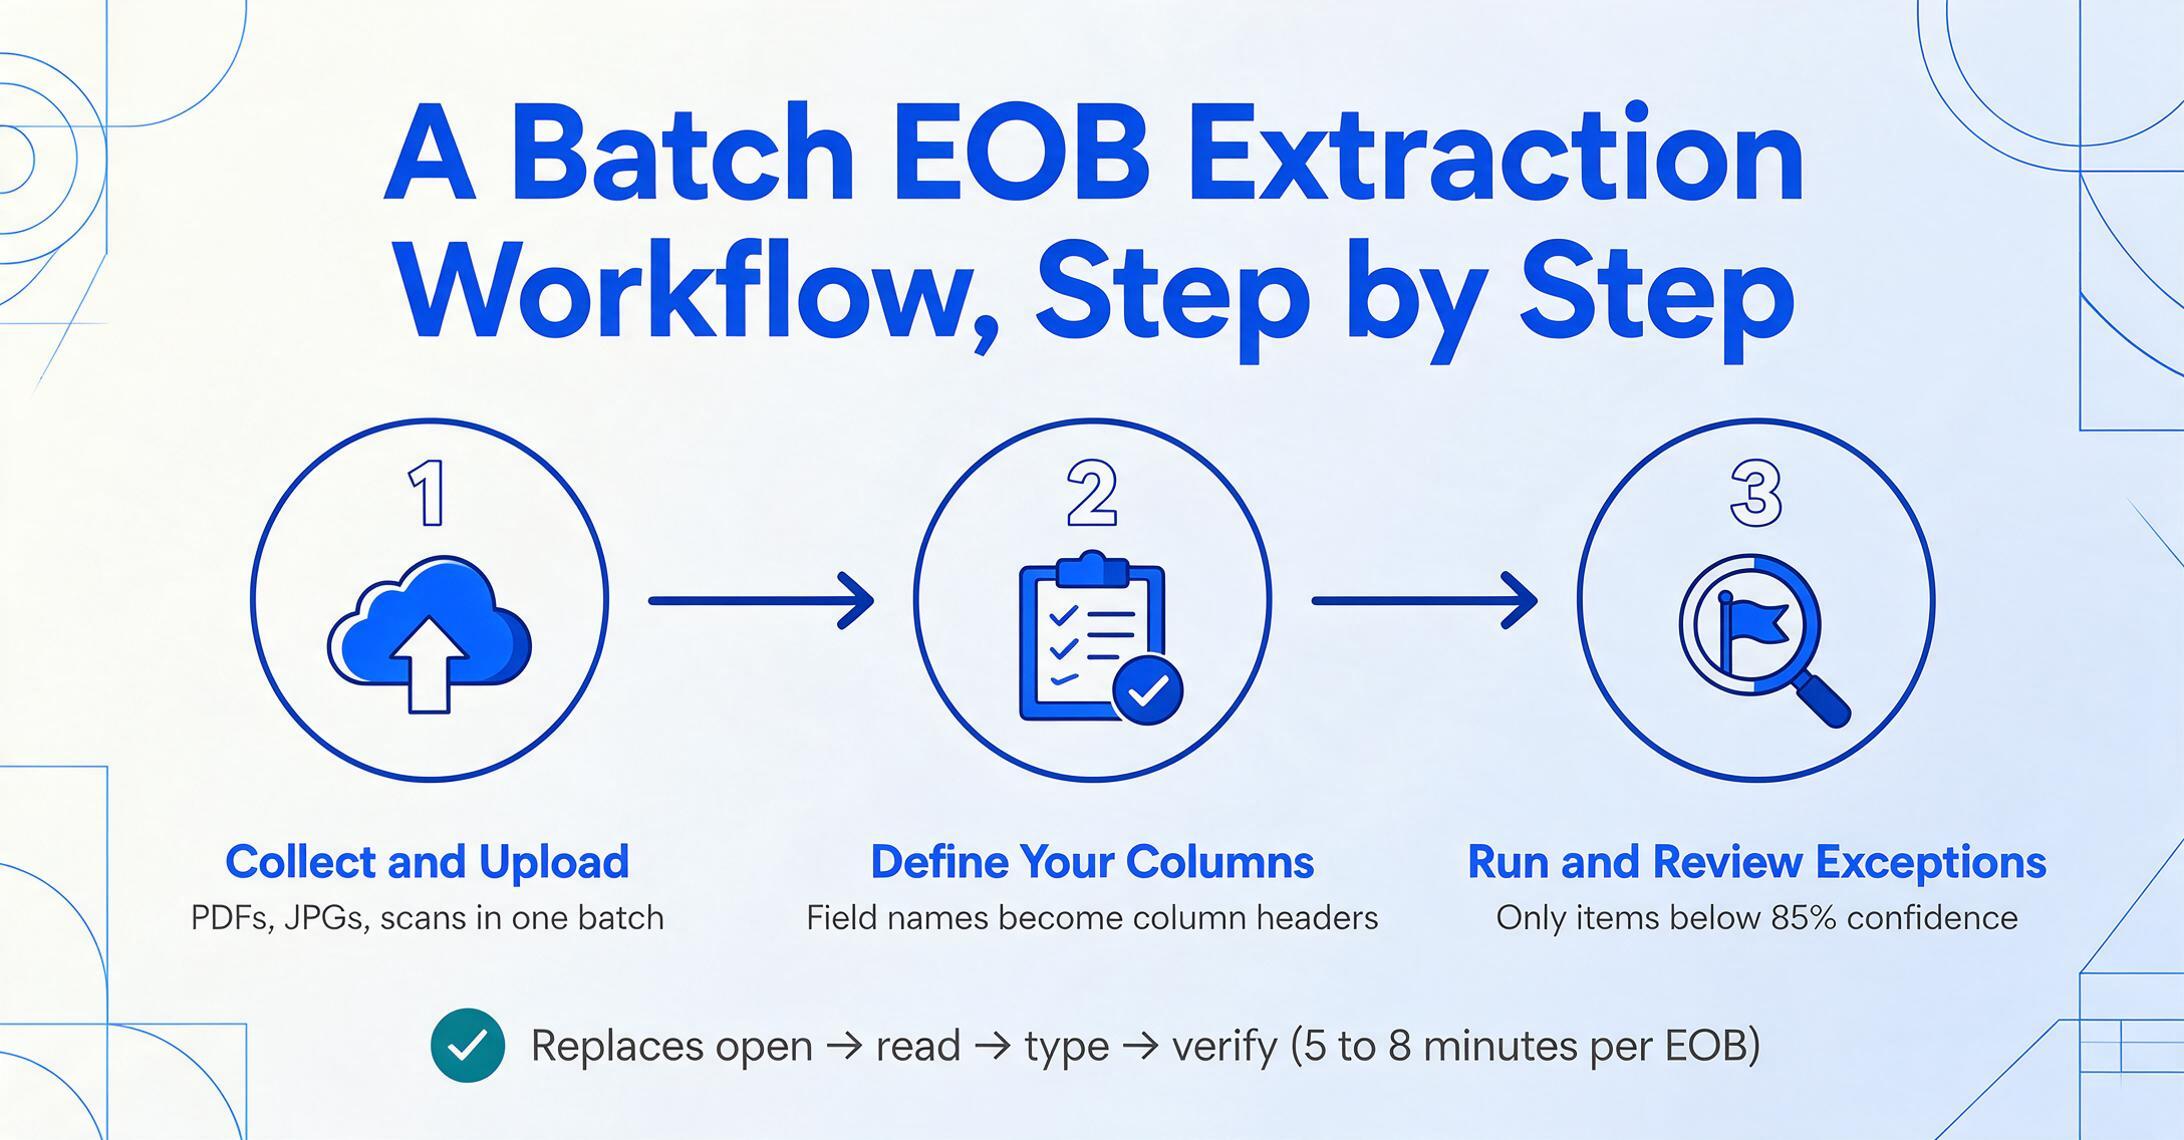
Ein Batch-EOB-Extraktions-Workflow unterscheidet sich von einem Einzeldokument-Workflow in drei Phasen: Vorbereitung, Verarbeitung und Ausnahmeprüfung. So funktioniert jede Phase in der Praxis.
Sammeln und hochladen.
Sammeln Sie EOBs von Zahlungsportalen, per E-Mail und gescannte Papierkopien in einem einzigen Ordner. Laden Sie den gesamten Batch hoch – ohne Sortierung nach Zahlungsanbieter oder Trennung von PDFs und Scans. ImageToTable.ai akzeptiert PDF-, JPG- und PNG-Dateien in einem einzigen Upload.
Spalten definieren.
Geben Sie die benötigten Feldnamen ein: Patientenname, Leistungsdatum, CPT-Code(s), Abgerechneter Betrag, Zugelassener Betrag, Selbstbehalt, Zuzahlung, Eigenanteil, Patientenzahlungspflicht, Gezahlter Betrag, Anpassungscode, Anpassungsgrund, Scheck-/EFT-Nummer, Scheckdatum. Diese werden zu den Spaltenüberschriften in Ihrer Ausgabetabelle.
Ausführen und Ausnahmen prüfen.
Die KI verarbeitet alle Dokumente in einem Durchgang. Jeder extrahierte Wert trägt einen Konfidenzwert. Legen Sie einen Schwellenwert fest (z. B. unter 85 %), um Elemente zur manuellen Prüfung zu markieren. Ein Mitarbeiter der Abrechnungsabteilung prüft nur die markierten Elemente – etwa 5 % der Gesamtdaten – statt jedes Feld jeder EOB zu verifizieren.
Dieser dreistufige Workflow ersetzt den EOB-für-EOB-Zyklus aus Öffnen → Lesen → Tippen → Prüfen, der 5 bis 8 Minuten pro Dokument beansprucht. Der Unterschied bei 500 EOBs pro Monat entspricht etwa 40 Stunden eingesparter Personalzeit – Zeit, die von der Dateneingabe auf Ablehnungsanalyse, Einspruchsvorbereitung und Zahlungsanbieter-Nachverfolgung verlagert wird. Für eine praktische Anleitung zu diesem Batch-Workflow vom Upload bis zur Tabellenausgabe finden Sie in unserem Leitfaden zum Konvertieren von EOBs in Excel.
Von extrahierten Daten zum Abrechnungssystem: Der fehlende Schritt
Die häufigste Frage, die Abrechnungsmanager nach einer Extraktionsdemo stellen, lautet: "Wie kommt das in mein System?" Die Antwort hängt von der verwendeten Praxisverwaltungssoftware ab, aber das Muster ist konsistent: Die Batch-Extraktionsausgabe—typischerweise eine Excel-Tabelle oder CSV-Datei—wird auf die Importschnittstelle der Abrechnungsplattform abgebildet.
Kareo unterstützt ERA-Autoposting für registrierte Zahlungsträger und manuelle Zahlungserfassung für Nicht-ERA-EOBs. Batch-extrahierte EOB-Daten können während des Zahlungsposting-Workflows überprüft und erfasst oder importiert werden, wenn die Praxis Kareos Batch-Importtools verwendet. AdvancedMD bietet eRemittance-Prüfbildschirme, in denen extrahierte Zahlungsdaten mit Forderungen abgeglichen werden können. CollaborateMD leitet Forderungen über sein Claim Control Center; extrahierte Anpassungsdaten fließen in die Warteschlange für das Ablehnungsmanagement.
Die Spalten, die Sie während der Extraktion definieren, sollten den Feldern entsprechen, die Ihr Abrechnungssystem erwartet. Wenn Ihr System Patientenkontonummern benötigt, nehmen Sie diese als Spalte auf. Wenn Sie CARC- und RARC-Codes verfolgen (Remittance Advice Remark Codes—ergänzende Codes, die zusätzlichen Kontext zu CARCs liefern, z. B. "N130: Zusätzliche Dokumentation für die Bearbeitung des Anspruchs erforderlich"), nehmen Sie diese als separate Spalten auf. Die Extraktionsausgabe wird zu einem strukturierten Datensatz, der direkt in den Revenue-Cycle-Workflow fließt. Für Teams, die einen Schritt weiter gehen möchten, unterstützt ImageToTable.ai abgeleitete Spalten: Sie können eine Spalte wie "Ablehnungskategorie (Optionen: Kodierungsfehler / Anspruchsberechtigung / Autorisierung / Medizinische Notwendigkeit / Rechtzeitige Einreichung / Sonstiges)" definieren, und die KI klassifiziert jede Ablehnung basierend auf dem CARC-Code und dem Bemerkungstext in eine Kategorie—Klassifizierung und Extraktion in einem einzigen Durchgang.
Hier schafft die Batch-Extraktion einen wachsenden Mehrwert. Ein Einzel-EOB-Tool spart 5 Minuten pro Dokument. Ein Batch-Tool, das auch Ablehnungen klassifiziert und auf Abrechnungsimportfelder abbildet, spart 5 Minuten pro EOB und eliminiert die 15-20 Minuten pro Batch, die Mitarbeiter für die Sortierung und Kategorisierung nach der Extraktion aufwenden.
Batch-EOB-Verarbeitung und HIPAA-Konformität
Jedes Tool, das EOB-Daten verarbeitet, verarbeitet geschützte Gesundheitsinformationen (PHI). HIPAA-Konformität ist keine Pflichtübung am Ende einer Anbieterbewertung—sondern der erste Filter. Die Kernanforderungen für ein Batch-EOB-Extraktionstool sind: Verschlüsselung während der Übertragung und im Ruhezustand, keine dauerhafte Speicherung hochgeladener Dokumente, sofern nicht ausdrücklich konfiguriert, sowie eine Geschäftspartnervereinbarung (BAA) für abgedeckte Einrichtungen.
ImageToTable.ai verarbeitet Dateien während der Extraktion und speichert sie danach nicht. Für Gesundheitsorganisationen ist die praktische Workflow-Auswirkung klar: EOB-PDFs aus einer sicheren Umgebung hochladen, Daten extrahieren, die strukturierte Ausgabe herunterladen und die Quelldateien aus der Upload-Warteschlange löschen. Die Daten verlassen die Extraktionsumgebung und gelangen unter Ihren bestehenden Compliance-Kontrollen in Ihr Praxisverwaltungssystem.
Allerdings sollten Abrechnungsteams die spezifischen Compliance-Zertifizierungen (SOC 2, HIPAA-Bescheinigung) eines Extraktionstools mit den Anforderungen ihrer Organisation abgleichen. Kein Tool ersetzt die Pflicht zur Anbieter-Sorgfaltspflicht, und dieser Artikel ist kein Ersatz für diesen Prozess.
Praktischer Hinweis: Bevor Sie EOBs per Batch durch ein Extraktionstool verarbeiten, bestätigen Sie, dass der Anbieter eine BAA bereitstellt, prüfen Sie die Datenverarbeitungs- und Aufbewahrungsrichtlinien und testen Sie zuerst mit anonymisierten Beispiel-EOBs, um sicherzustellen, dass der Workflow Ihre Compliance-Anforderungen erfüllt.
Häufig gestellte Fragen
Kann die Batch-EOB-Extraktion Electronic Remittance Advice (ERA)-Dateien verarbeiten?
ERA-Dateien (ASC X12 835-Format) sind bereits strukturierte Daten—sie benötigen keine Extraktion. Wenn Sie sowohl ERA-Dateien als auch PDF-EOBs erhalten, übernimmt die Batch-Extraktion den PDF-/Papieranteil Ihres EOB-Eingangs. Die extrahierten Daten können so formatiert werden, dass sie zu Ihrem ERA-Posting-Workflow passen, sodass alle Zahlungen, unabhängig vom Quellformat, in denselben Abstimmungsprozess fließen.
Bewahrt die Batch-Extraktion führende Nullen bei CPT-Codes und NPI-Nummern?
Ja. Das Erhalten führender Nullen ist ein Formatierungsaspekt in der Ausgabephase. Die Spaltennamenextraktion von ImageToTable.ai bewahrt die Originaldaten so, wie sie im Dokument erscheinen. Beim Export nach Excel können Sie Textformatierung für CPT-Code-, NPI- und Kontonummernspalten festlegen, um zu verhindern, dass Tabellenkalkulationssoftware führende Nullen entfernt.
Welche Genauigkeitsrate sollte ich bei gemischten Zahlerträger-EOB-Batches erwarten?
Gedruckter Text auf sauberen EOB-PDFs wird typischerweise mit einer Feldgenauigkeit von 95–99 % extrahiert. Die Genauigkeit sinkt bei stark gescannten oder gefaxten Dokumenten, handschriftlichen Randnotizen und ungewöhnlichen Zahlerträgerformaten, die erheblich von Standard-EOB-Layouts abweichen. Der Batch-Workflow ist auf diese Realität ausgelegt: Die Konfidenzbewertung markiert unsichere Extraktionen zur menschlichen Prüfung, sodass 100 % der Daten, die in Ihr Abrechnungssystem gelangen, verifiziert wurden – entweder durch KI-Konfidenz oder durch Personalprüfung.
Wie lange dauert die Einrichtung für das EOB-Format eines neuen Zahlerträgers?
Mit Spaltennamenextraktion: null Einrichtungszeit. Dieselben Spaltendefinitionen, die Sie für UnitedHealthcare-EOBs erstellt haben, funktionieren sofort mit dem Format eines neuen Zahlerträgers – die KI liest das Dokument kontextuell, statt eine gespeicherte Vorlage abzugleichen. Wenn ein neuer Zahlerträger einen ungewohnten Begriff für einen Standarddatenpunkt verwendet (z. B. „Plan Paid“ statt „Allowed Amount“), kann der erste Batch eine Anpassung des Spaltennamens erfordern, aber es gibt keine Vorlage zu erstellen oder zu trainieren.
Kann die Batch-Extraktion handschriftliche Notizen auf EOBs verarbeiten?
Teilweise. KI-basierte Extraktion kann klare Handschrift auf Dokumenten lesen, aber die Genauigkeit ist geringer als bei gedrucktem Text. Handschriftliche Anpassungen in den Rändern – häufig bei EOBs, bei denen ein Versicherer einen Ablehnungsgrund manuell annotiert – werden wahrscheinlich vom Konfidenzbewertungssystem zur menschlichen Prüfung markiert. Für Teams, die einen hohen Anteil annotierter EOBs erhalten, spart die Batch-Extraktion dennoch Zeit bei den 90 % gedruckten Daten, während handschriftliche Inhalte zur Verifizierung an das Personal weitergeleitet werden.
Was passiert, wenn ein Batch sowohl einseitige als auch mehrseitige EOBs enthält?
Jede Seite einer mehrseitigen EOB wird als Teil desselben Dokuments verarbeitet. Wenn Sie eine 3-seitige Aetna-EOB als drei separate Dateien hochladen, erscheinen sie als drei Zeilen in der Ausgabe. Für Batch-Workflows, bei denen mehrseitige EOBs auf mehrere Dateien aufgeteilt sind, ist es besser, sie vor dem Hochladen zu einer einzigen PDF pro EOB zusammenzuführen oder eine Spalte „Claim-Nummer" in Ihre Extraktionsdefinition aufzunehmen, damit Sie verwandte Zeilen während des Abgleichs gruppieren können.
Batch-Extraktion mit Ihren eigenen EOBs testen
Das Argument für die Batch-EOB-Extraktion dreht sich letztlich nicht um Genauigkeitsprozente oder Branchen-Benchmarks—sondern darum, was sich ändert, wenn Ihr Abrechnungsteam am Montagmorgen seine Warteschlange öffnet und eine fertige Tabelle statt eines Stapels PDFs vorfindet. Die 5 bis 8 Minuten pro EOB sind keine theoretische Schätzung; es ist eine Zahl, die Abrechnungsmanager validieren können, indem sie ihr eigenes Personal bei einem typischen Batch stoppen. Die Frage ist, was diese gewonnenen Stunden ermöglichen: mehr abgelehnte Ansprüche, schnellere Patientenabrechnung, kürzere Tage in der Debitorenbuchhaltung oder einfach ein Team, das die Zahlungsbuchung schon vor Mittwoch statt Freitag abschließt.
Testen Sie mit einem Batch Ihrer eigenen EOBs. Definieren Sie die Spalten, die Ihr Abrechnungssystem benötigt. Prüfen Sie, ob der Workflow vom Upload bis zur strukturierten Tabelle in Ihren monatlichen Zyklus passt. Der einzige Weg zu bewerten, ob die Spaltennamensextraktion mit Ihrem spezifischen Zahlermix umgeht, ist, sie mit Ihren tatsächlichen Dokumenten auszuführen.