Comment les équipes de facturation médicale
extraient les données par lots de centaines d'EOB
La plupart des outils d'extraction de documents font la même supposition à propos des formulaires d'explication des prestations : qu'il s'agit de documents standardisés. Ce n'est pas le cas. Un EOB Blue Cross de Floride ne ressemble en rien à un EOB Blue Cross de l'Illinois. Un EOB Aetna utilise des en-têtes de colonnes différents de ceux d'un avis de remboursement Medicare. Multipliez cela par 15 ou 20 payeurs, et le goulot d'étranglement dans le traitement des EOB n'est pas la vitesse de frappe—c'est la variation des formats. Pour les équipes de facturation qui traitent des centaines de ces documents par mois, la question n'est pas de savoir si l'IA peut lire un EOB. C'est de savoir si une seule configuration d'extraction peut gérer tous ces documents en un seul lot.
Pourquoi les EOB résistent à l'automatisation qui fonctionne pour les formulaires standard
La raison pour laquelle la plupart des outils d'extraction de documents échouent sur les formulaires d'explication des prestations n'est pas la précision—c'est la fragmentation des formats. Il existe plus de 6 000 mises en page distinctes d'EOB chez les payeurs aux États-Unis. Chaque assureur—UnitedHealthcare, Aetna, Cigna, Humana, Medicare, Medicaid, les assureurs d'indemnisation des accidents du travail—organise les mêmes points de données différemment. Certains utilisent des tableaux horizontaux, d'autres des sections verticales. Certains divisent la responsabilité du patient en quatre sous-colonnes ; d'autres la condensent en une seule ligne. Certains payeurs changent même de mise en page au sein d'un même EOB, utilisant un format pour les réclamations payées et un autre pour les réclamations refusées sur le même PDF.
Cela importe car les outils d'extraction basés sur des modèles—des outils qui exigent de définir une mise en page fixe pour chaque type de document—demandent un modèle séparé pour chaque format de payeur. Lorsqu'un payeur met à jour sa mise en page, ce qui arrive plus souvent qu'on ne le pense, le modèle casse. Les équipes de facturation finissent par maintenir des modèles d'extraction au lieu de comptabiliser les paiements.
Un EOB, abréviation d'explication des prestations, est le document qu'une compagnie d'assurance envoie après avoir traité une réclamation de soins de santé. Il détaille ce qui a été facturé, ce que le régime a couvert, ce que l'assureur a payé et ce que le patient doit. Pour les prestataires qui ne sont pas inscrits à l'avis de remise électronique (ERA) auprès de chaque payeur—ou qui reçoivent des EOB papier de certains transporteurs quoi qu'il en soit—chaque EOB doit être examiné manuellement, saisi dans le système de gestion de cabinet et rapproché des dossiers de réclamation. Le ERA est la version électronique d'un EOB, transmise sous forme de transaction ASC X12 835 selon les normes HIPAA. Lorsqu'il fonctionne, il automatise la comptabilisation. Mais de nombreux payeurs envoient encore des EOB papier ou PDF, et même les prestataires inscrits à l'ERA pour les grands transporteurs reçoivent souvent des EOB PDF de payeurs secondaires, d'indemnisation des accidents du travail ou de programmes Medicaid spécifiques à un État.
Point clé : Le goulot d'étranglement dans le traitement des EOB n'est pas la vitesse de saisie des données. C'est le fait qu'aucun payeur n'utilise le même format—et les équipes de facturation ont toujours besoin de chaque point de données de chaque format pour comptabiliser correctement les paiements.
Le coût réel de la main-d'œuvre pour la saisie manuelle des EOB
La saisie manuelle des données EOB prend 5 à 8 minutes par document, selon les données des opérations de facturation qui l'ont mesurée. Pour 500 EOB par mois—un volume typique pour un cabinet de taille moyenne ou une petite société de facturation—cela représente 40 à 65 heures de travail du personnel. À 25 $ de l'heure pour le personnel de facturation, le coût annuel de la main-d'œuvre est d'environ 12 000 $ à 19 500 $, rien que pour la saisie des données EOB.
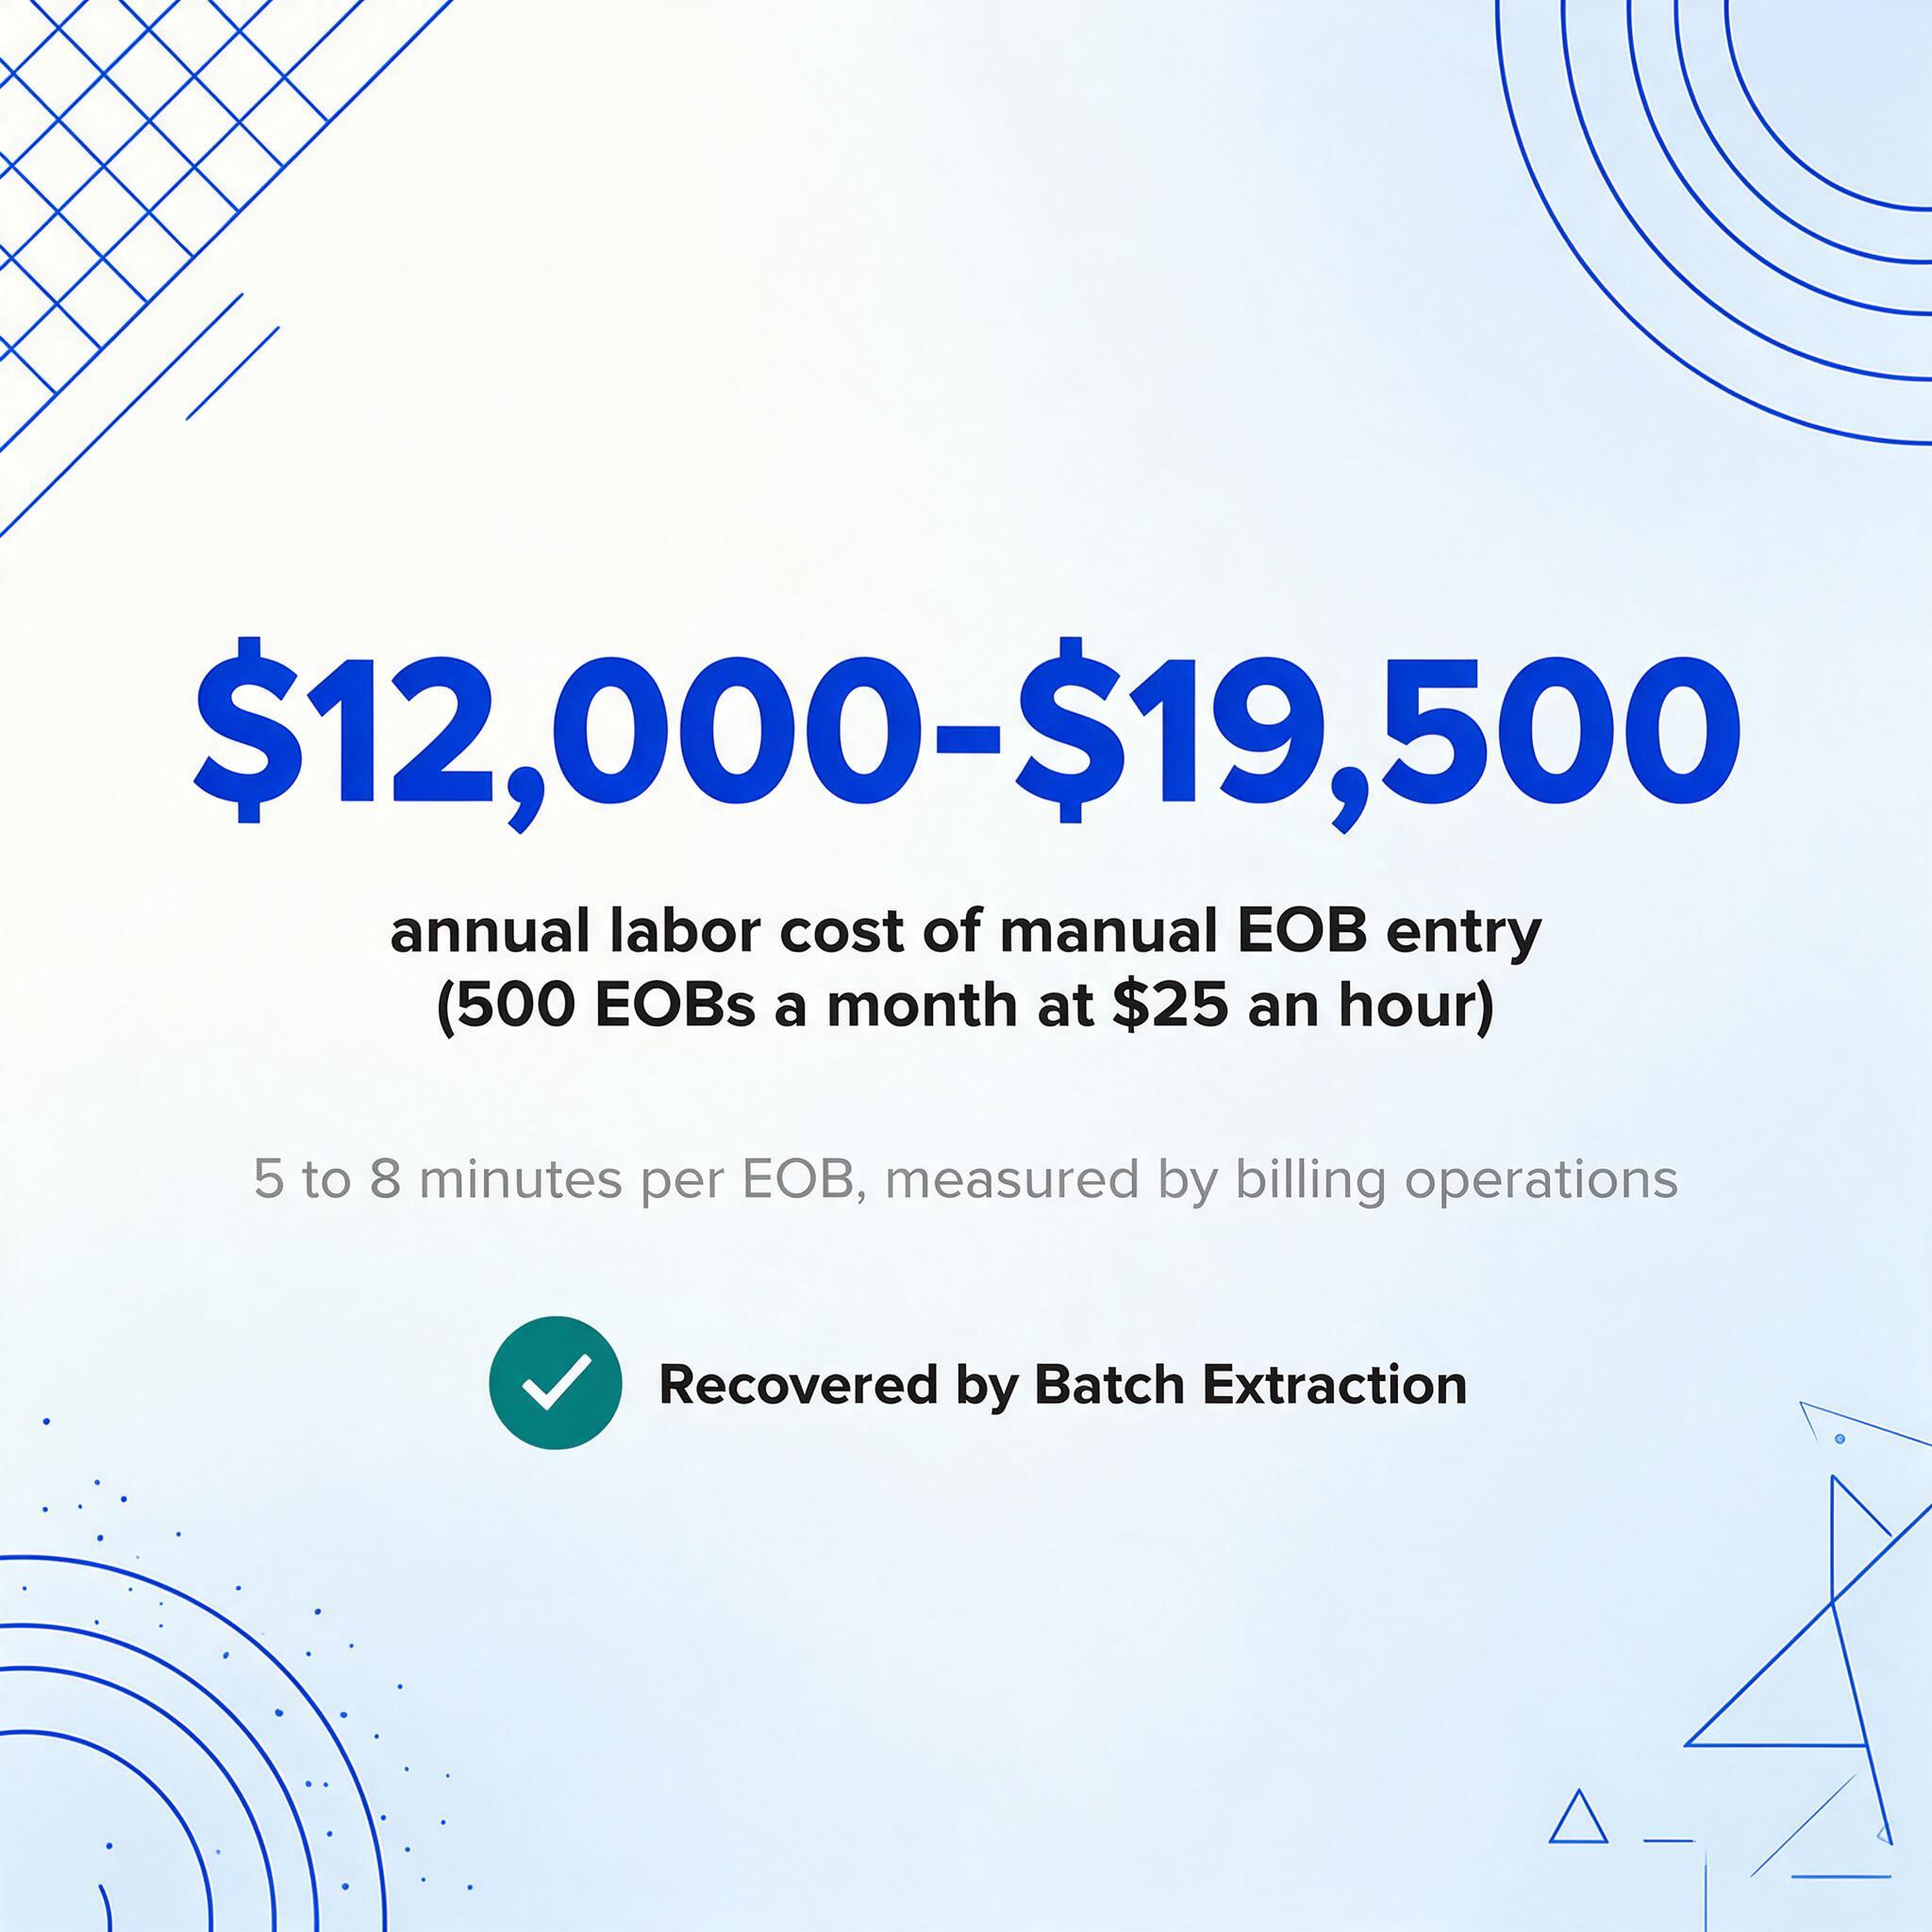
Ce chiffre n'inclut pas les coûts en aval. L'indice CAQH, la référence faisant autorité du secteur sur les coûts des transactions administratives, évalue le coût de la reprise d'une seule réclamation refusée à environ 25 $ pour des corrections simples. Les appels complexes nécessitant une documentation clinique peuvent atteindre 100 $ ou plus. Et les taux de refus augmentent : la moyenne nationale de 2025 a dépassé 12,4 %, un sommet sur dix ans selon les données du secteur. Le DataDive 2023 de MGMA a révélé que les cabinets mono-spécialité avaient un taux de refus de 8 % à la première soumission, et un sondage MGMA de mars 2024 a rapporté que 60 % des groupes médicaux ont constaté davantage de refus par rapport à l'année précédente.
Lorsque les données EOB sont saisies manuellement, des codes CPT mal saisis (codes de terminologie procédurale courante maintenus par l'American Medical Association, utilisés pour décrire les services médicaux sur les réclamations), des montants d'ajustement incorrects ou des codes CARC mal lus (codes de raison d'ajustement des réclamations—des codes standardisés qui expliquent pourquoi une réclamation a été payée différemment de ce qui a été facturé) créent un travail de rapprochement en aval. Un ajustement CO-45 (les frais dépassent le barème des honoraires) mal saisi comme un CO-97 (service inclus dans un autre paiement) envoie l'équipe de facturation sur la mauvaise voie de résolution. Ce ne sont pas des cas limites théoriques—ce sont des occurrences quotidiennes dans les flux de travail manuels.
Selon le Council for Affordable Quality Healthcare (CAQH), 24 cents de chaque dollar de soins de santé sont consacrés aux coûts administratifs et de facturation. Le secteur pourrait économiser environ 9,4 milliards de dollars par an en convertissant les transactions manuelles en transactions électroniques. L'indice CAQH 2025 a constaté que les soins de santé américains ont évité 258 milliards de dollars en coûts administratifs en 2024 grâce aux transactions électroniques—ce qui signifie qu'il reste encore une marge d'amélioration significative dans les parties du cycle de revenus qui restent manuelles, comme le traitement des EOB en PDF.
Ce que les outils d'extraction EOB unique manquent dans les flux de travail par lots
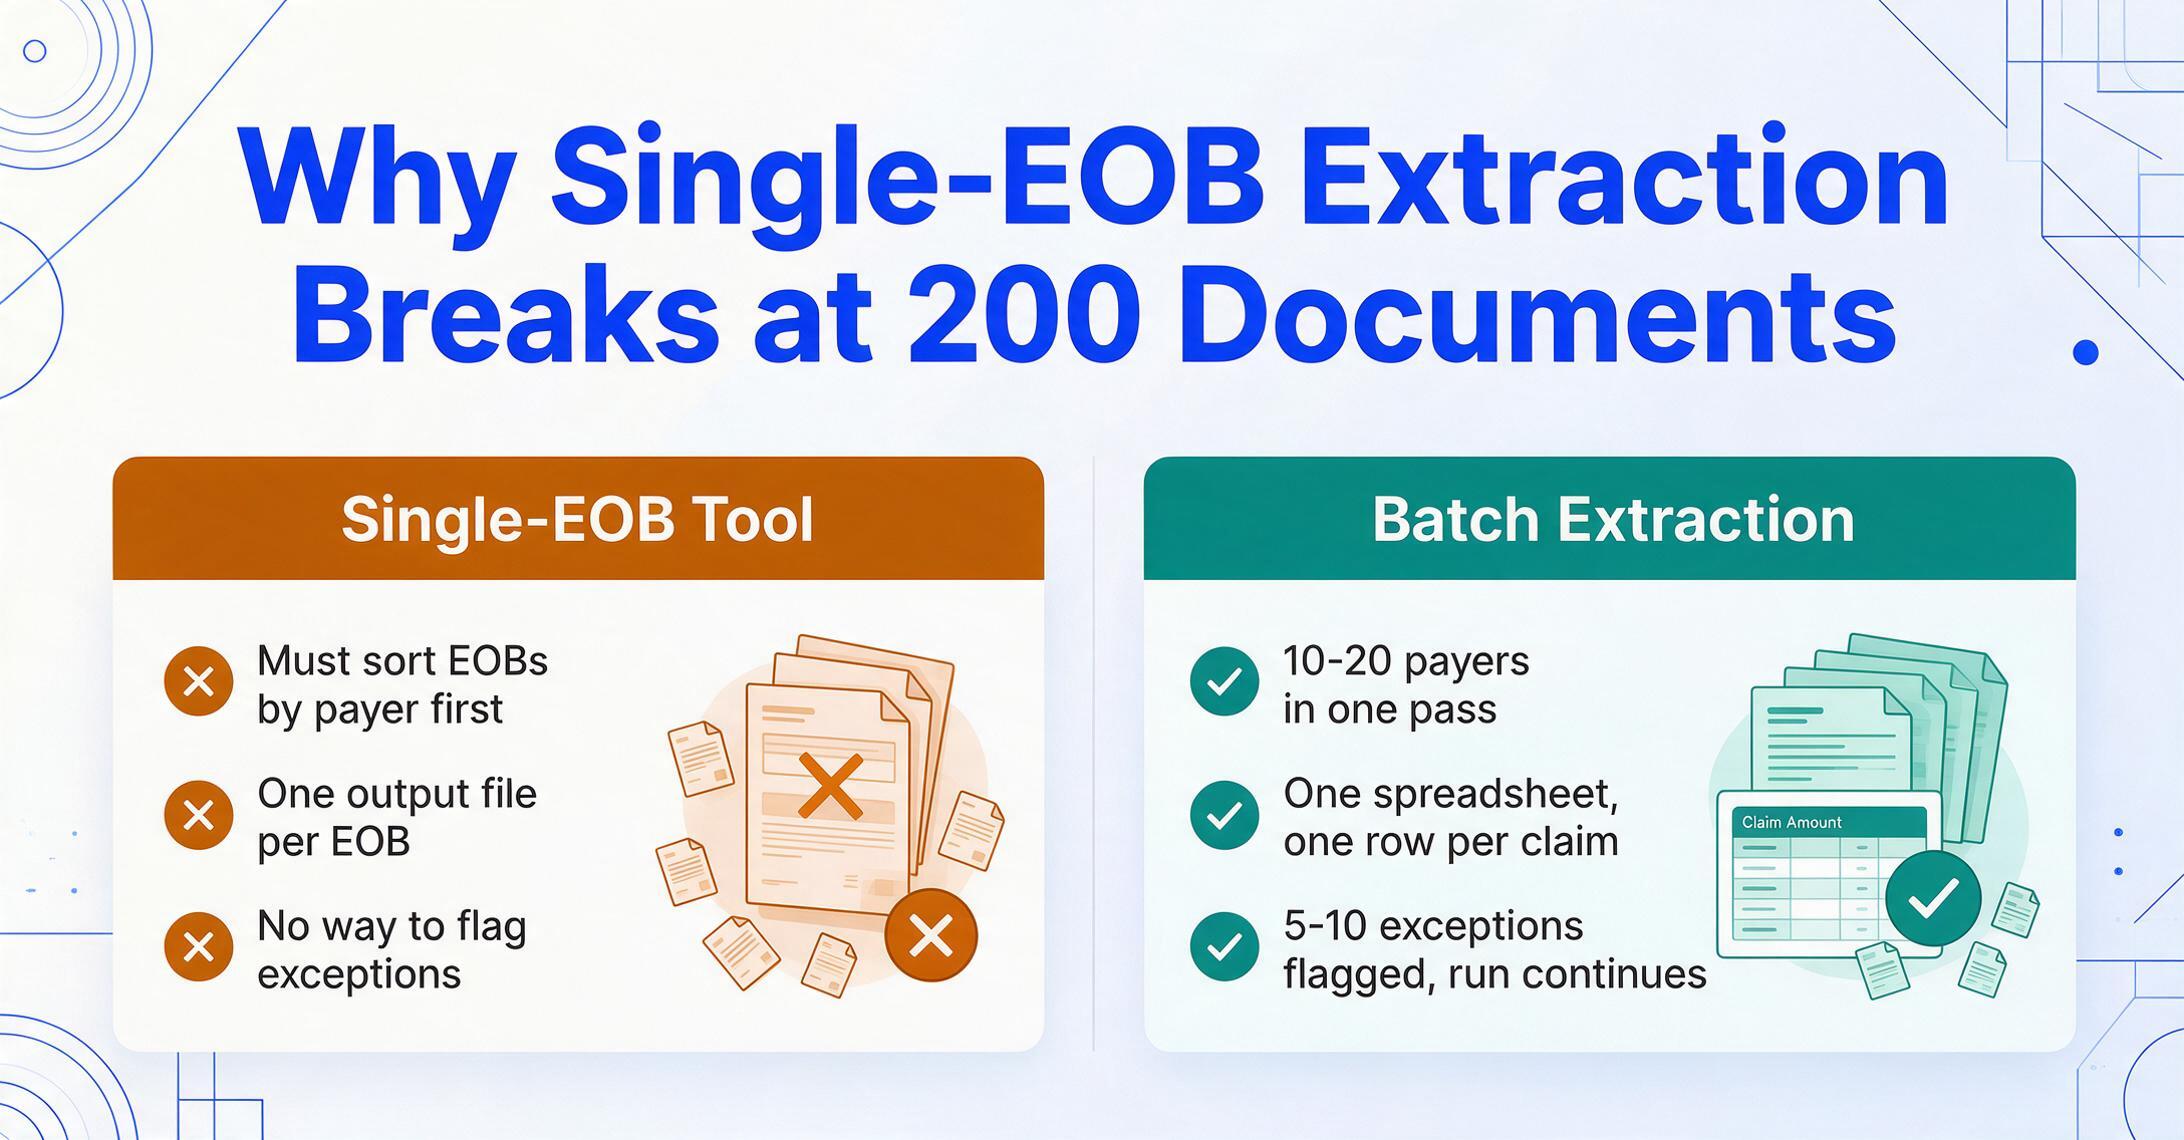
Traiter un seul EOB est un problème fondamentalement différent de traiter 200 à la fois. Le flux de travail EOB unique—ouvrir un PDF, extraire les données, copier dans le système, répéter—se brise à grande échelle pour des raisons qui n'ont rien à voir avec la précision de l'extraction.
Piles multi-payeurs. Un lot de 200 EOB contient généralement des documents de 10 à 20 payeurs différents. Les EOB Medicare utilisent des paires de codes CARC/RARC dans un format d'avis de remise spécifique. Les EOB UnitedHealthcare structurent la responsabilité du patient différemment des EOB Aetna. Un outil d'extraction par lots doit gérer tous ces cas en une seule passe sans obliger l'utilisateur à trier les EOB par payeur au préalable. Si vous devez les séparer avant le téléchargement, vous n'avez fait que déplacer le travail manuel une étape en amont.
Fusion des sorties. Lorsqu'un outil traite les EOB un par un, la sortie est un fichier par EOB. L'extraction par lots signifie que les 200 résultats arrivent dans une seule feuille de calcul—une ligne par réclamation, toutes les colonnes alignées. C'est le format dont les gestionnaires de facturation ont besoin pour l'import en masse dans leur système de gestion de cabinet ou pour la réconciliation de fin de mois.
Gestion des exceptions. Dans un lot de 200 EOB, 5 à 10 présenteront quelque chose d'inhabituel : une note d'ajustement manuscrite dans la marge, un EOB de deux pages avec des données de continuation, un nom de patient qui correspond presque mais pas exactement à vos dossiers. Un flux de travail par lots doit signaler ces exceptions pour examen humain sans arrêter tout le traitement. Les outils qui traitent l'extraction un-EOB-à-la-fois par défaut n'offrent aucun mécanisme pour cela.
Sources de fichiers. Les équipes de facturation récupèrent les EOB via plusieurs canaux : portails payeurs (Availity, portail fournisseur UnitedHealthcare, sites des transporteurs individuels), PDF envoyés par e-mail, copies par fax et originaux papier scannés. Un flux de travail par lots doit accepter toute combinaison de ces sources sans étapes de prétraitement séparées pour chaque source.
Si vous découvrez ce qu'est réellement un EOB et quels champs comptent pour la réconciliation, notre aperçu de l'extraction de données EOB couvre la répartition au niveau des champs, et notre guide complet de l'extraction de données EOB détaille les critères de sélection et les options d'export de bout en bout. Et pour une comparaison côte à côte des outils capables de gérer ce type de flux de travail par lots multi-payeurs, consultez notre tour d'horizon des outils d'extraction de documents de santé, qui teste sept outils sur 40 EOB réels, formulaires de réclamation et documents patients.
Comment l'IA lit les mises en page EOB sans modèles par payeur
L'approche technique qui gère la variation des formats de payeurs est fondamentalement différente de l'extraction basée sur des modèles. Les outils à modèles utilisent des coordonnées fixes—« le montant autorisé se trouve à la position X, Y sur la page. » Lorsqu'un payeur modifie sa mise en page, la coordonnée devient erronée. Lorsqu'un nouveau payeur envoie sa première EOB, il n'existe aucun modèle.
L'extraction basée sur l'IA utilisant des modèles de langage visuels fonctionne différemment. Au lieu de faire correspondre des coordonnées de page, elle lit le document de manière sémantique—en comprenant ce que chaque section signifie, pas seulement où elle se trouve. Vous définissez les colonnes dont vous avez besoin : Nom du patient, Date de service, Code CPT, Montant facturé, Montant autorisé, Franchise, Coassurance, Responsabilité du patient, Code d'ajustement (CARC), Montant d'ajustement, Motif de refus. L'IA localise chaque valeur n'importe où sur la page en comprenant la structure du document—de la même manière qu'un facturier humain parcourt une mise en page EOB inconnue, trouve le nom du patient en haut et suit les en-têtes de colonnes pour trouver le montant autorisé.
Cette approche, que ImageToTable.ai appelle extraction par nom de colonne, signifie que vous saisissez les noms de champs souhaités et que l'IA les fait correspondre aux valeurs, quel que soit l'endroit où chaque payeur place ces champs. Une seule configuration traite une EOB UnitedHealthcare et une EOB Aetna dans le même lot sans modification. Le résultat est une feuille de calcul unifiée où chaque ligne comporte les mêmes colonnes, quel que soit le payeur à l'origine du PDF.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
C'est la différence entre créer et maintenir 20 modèles d'extraction—un par payeur—et définir vos colonnes de sortie une seule fois. Pour une équipe de facturation traitant des EOB de 15 payeurs ou plus, la charge de maintenance de l'approche par modèles n'est pas un coût ponctuel. C'est une taxe opérationnelle permanente.
Un flux de travail d'extraction EOB par lots, étape par étape
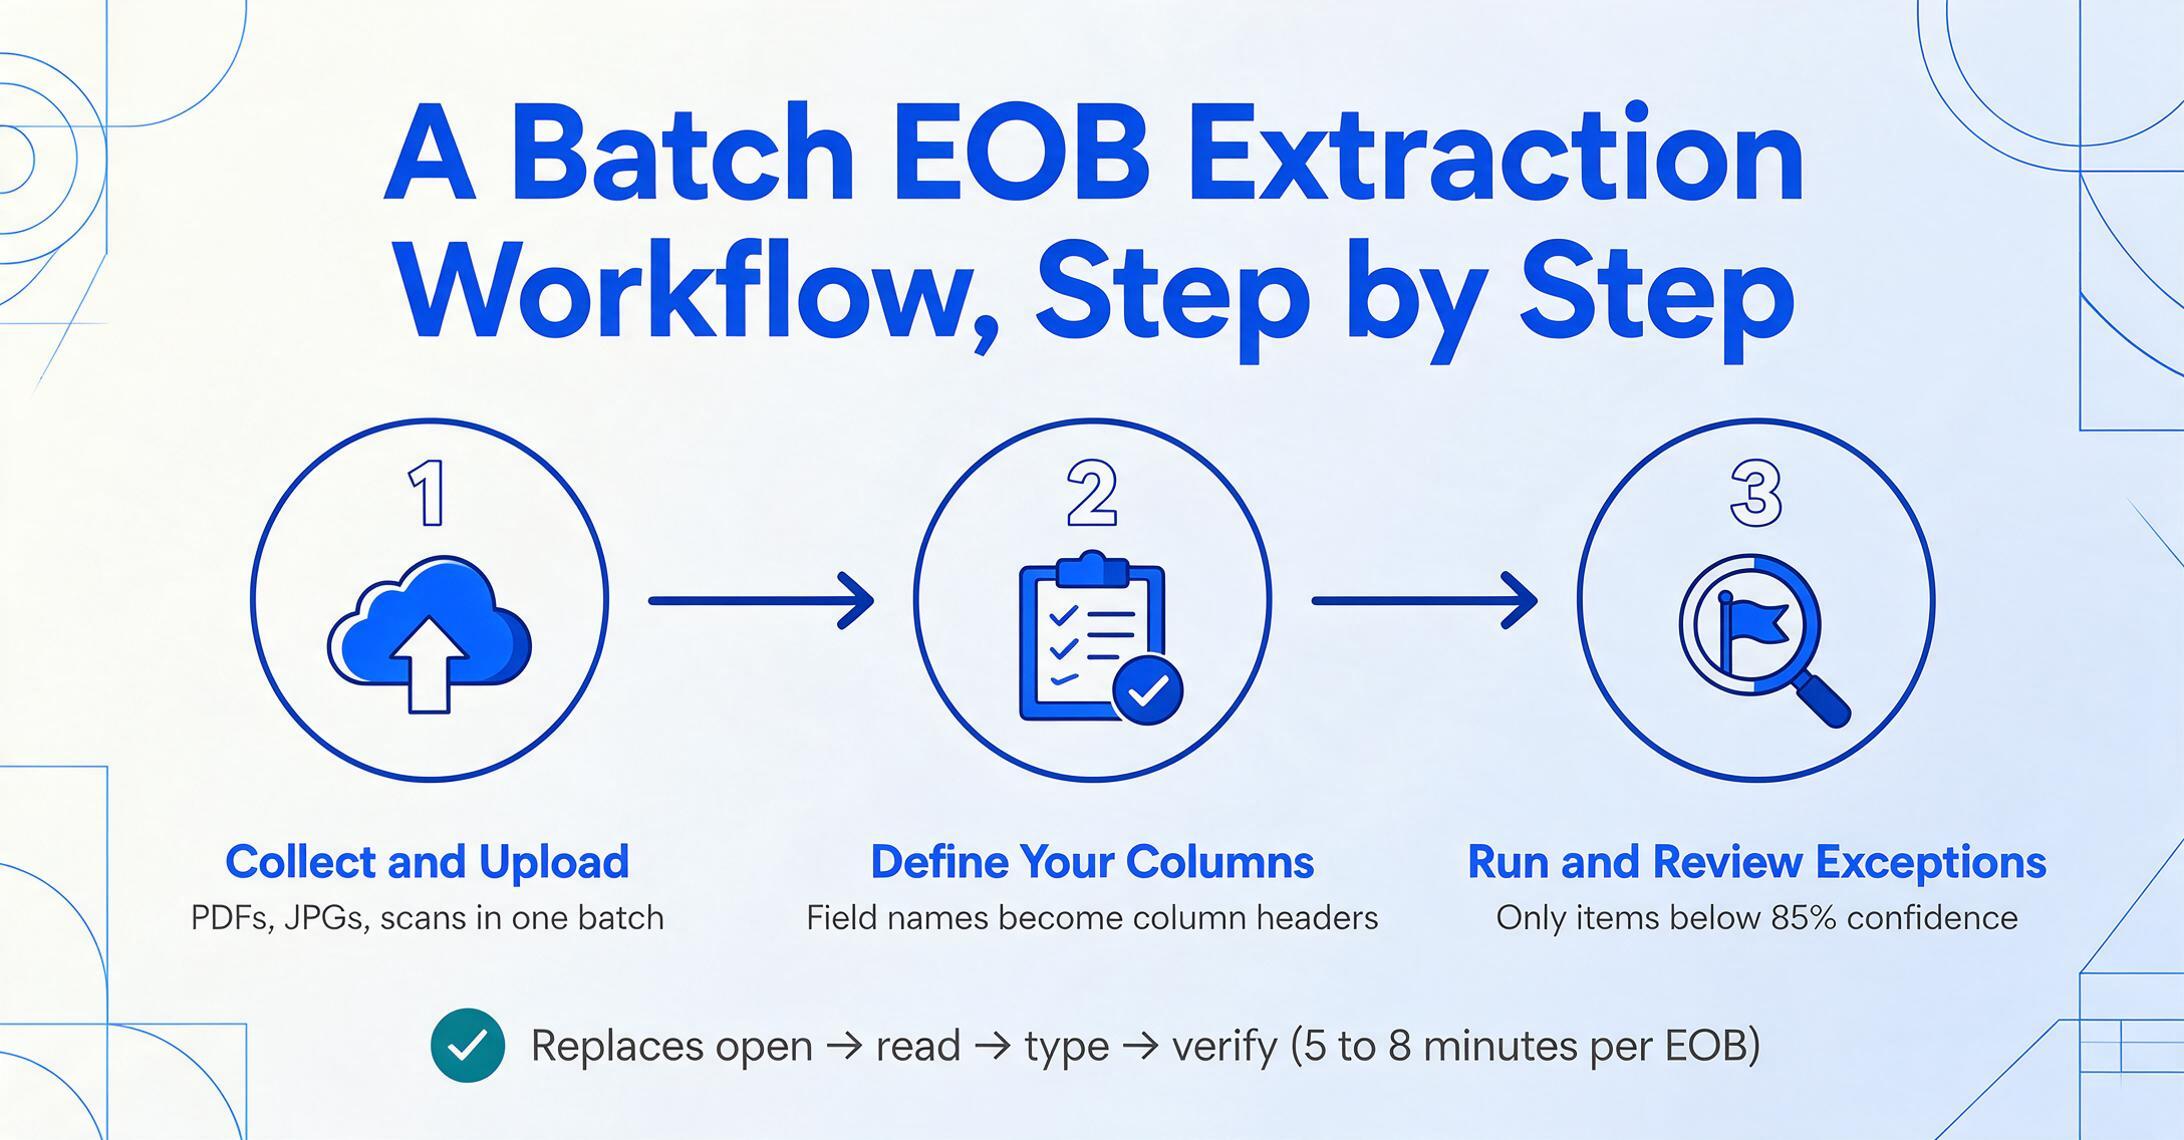
Un flux de travail d'extraction EOB par lots diffère d'un flux de travail sur document unique à trois étapes : préparation, traitement et examen des exceptions. Voici comment chacune fonctionne en pratique.
Collecter et téléverser.
Rassemblez les EOB provenant des portails des payeurs, des e-mails et des copies papier scannées dans un seul dossier. Téléversez le lot complet—pas besoin de trier par payeur ou de séparer les PDF des scans. ImageToTable.ai accepte les fichiers PDF, JPG et PNG en un seul téléversement.
Définir vos colonnes.
Saisissez les noms de champs dont vous avez besoin : Nom du patient, Date de service, Code(s) CPT, Montant facturé, Montant autorisé, Franchise, Coassurance, Copaiement, Responsabilité du patient, Montant payé, Code d'ajustement, Motif d'ajustement, Numéro de chèque/virement, Date du chèque. Ceux-ci deviennent les en-têtes de colonnes dans votre feuille de calcul de sortie.
Exécuter et examiner les exceptions.
L'IA traite tous les documents en une seule passe. Chaque valeur extraite porte un score de confiance. Définissez un seuil (par exemple, sous 85 %) pour signaler les éléments à examiner manuellement. Un membre du personnel de facturation ne vérifie que les éléments signalés—peut-être 5 % des données totales—au lieu de vérifier chaque champ sur chaque EOB.
Ce flux de travail en trois étapes remplace le cycle par EOB d'ouverture → lecture → saisie → vérification qui occupe 5 à 8 minutes par document. La différence à 500 EOB par mois est d'environ 40 heures de temps du personnel récupérées—du temps qui passe de la saisie de données à l'analyse des refus, à la préparation des recours et au suivi auprès des payeurs. Pour une démonstration pratique de ce flux de travail par lots, du téléversement à la sortie de feuille de calcul, consultez notre guide sur la conversion des EOB en Excel.
Des données extraites au système de facturation : l'étape manquante
La question la plus fréquente que se posent les responsables de facturation après une démonstration d'extraction est : « Comment cela arrive-t-il dans mon système ? » La réponse dépend du logiciel de gestion de cabinet utilisé, mais le schéma est cohérent : la sortie de l'extraction par lots—généralement un fichier Excel ou CSV—correspond à l'interface d'importation de la plateforme de facturation.
Kareo prend en charge la validation automatique des ERA pour les payeurs inscrits et la saisie manuelle des paiements pour les EOB non-ERA. Les données EOB extraites par lots peuvent être examinées et saisies lors du flux de travail de validation des paiements, ou importées si le cabinet utilise les outils d'importation par lots de Kareo. AdvancedMD propose des écrans de révision eRemittance où les données de paiement extraites peuvent être rapprochées des réclamations. CollaborateMD achemine les réclamations via son Claim Control Center ; les données d'ajustement extraites alimentent la file de gestion des refus.
Les colonnes que vous définissez lors de l'extraction doivent correspondre aux champs attendus par votre système de facturation. Si votre système nécessite les numéros de compte patient, incluez-les comme colonne. Si vous suivez les codes CARC et RARC (Remittance Advice Remark Codes—codes supplémentaires fournissant un contexte additionnel aux CARC, comme « N130 : Documentation supplémentaire requise pour le traitement de la réclamation »), incluez-les comme colonnes distinctes. La sortie d'extraction devient un ensemble de données structuré qui alimente directement le flux de travail du cycle de revenus. Pour les équipes qui souhaitent aller plus loin, ImageToTable.ai prend en charge les colonnes inférées : vous pouvez définir une colonne comme « Catégorie de refus (options : Erreur de codage / Éligibilité / Autorisation / Nécessité médicale / Dépôt dans les délais / Autre) » et l'IA classe chaque refus dans une catégorie en fonction du code CARC et du texte de remarque—classification et extraction en une seule passe.
C'est là que l'extraction par lots crée une valeur composée. Un outil pour EOB unique fait gagner 5 minutes sur un document. Un outil par lots qui classe également les refus et correspond aux champs d'importation de facturation fait gagner 5 minutes par EOB et élimine les 15 à 20 minutes par lot que le personnel consacre au tri et à la catégorisation après extraction.
Traitement par lots des EOB et conformité HIPAA
Tout outil qui traite des données EOB manipule des informations de santé protégées (PHI). La conformité HIPAA n'est pas une case à cocher à la fin d'une évaluation de fournisseur—c'est le premier filtre. Les exigences de base pour un outil d'extraction EOB par lots sont : le chiffrement en transit et au repos, aucune conservation persistante des documents téléchargés sauf configuration explicite, et un contrat d'associé commercial (BAA) disponible pour les entités couvertes.
ImageToTable.ai traite les fichiers pendant l'extraction et ne les conserve pas ensuite. Pour les organismes de santé, l'implication pratique du flux de travail est simple : téléversez les PDF EOB depuis un environnement sécurisé, extrayez les données, téléchargez la sortie structurée et supprimez les fichiers sources de la file de téléversement. Les données quittent l'environnement d'extraction et entrent dans votre système de gestion de cabinet sous vos contrôles de conformité existants.
Cela dit, les équipes de facturation doivent vérifier les certifications de conformité spécifiques de tout outil d'extraction (SOC 2, attestation HIPAA) par rapport aux exigences de leur organisation. Aucun outil ne supprime l'obligation de faire preuve de diligence raisonnable envers le fournisseur, et cet article ne remplace pas ce processus.
Conseil pratique : Avant de traiter des EOB par lots via un outil d'extraction, confirmez que le fournisseur fournit un BAA, vérifiez les politiques de traitement et de conservation des données, et testez d'abord sur des échantillons EOB dépersonnalisés pour garantir que le flux de travail répond à vos exigences de conformité.
Questions fréquentes
L'extraction par lots d'EOB peut-elle gérer les fichiers d'avis de règlement électronique (ERA) ?
Les fichiers ERA (format ASC X12 835) sont déjà des données structurées—ils n'ont pas besoin d'extraction. Si vous recevez à la fois des fichiers ERA et des PDF EOB, l'extraction par lots gère la partie PDF/format papier de votre réception d'EOB. Les données extraites peuvent être formatées pour correspondre à votre flux de travail de saisie ERA afin que tous les paiements, quel que soit le format source, alimentent le même processus de rapprochement.
L'extraction par lots préserve-t-elle les zéros non significatifs des codes CPT et des numéros NPI ?
Oui. La préservation des zéros non significatifs relève du formatage à l'étape de sortie. L'extraction par nom de colonne d'ImageToTable.ai conserve les données originales telles qu'elles apparaissent sur le document. Lors de l'exportation vers Excel, vous pouvez spécifier un formatage texte pour les colonnes de codes CPT, NPI et numéros de compte afin d'empêcher le tableur de supprimer les zéros non significatifs.
Quel taux de précision dois-je attendre sur les lots EOB multi-payeurs ?
Le texte imprimé sur des PDF EOB propres est généralement extrait avec une précision de 95 à 99 % au niveau des champs. La précision diminue sur les documents fortement scannés ou télécopiés, les annotations manuscrites en marge et les formats de payeurs inhabituels qui s'écartent nettement des mises en page EOB standard. Le flux de traitement par lots est conçu autour de cette réalité : le score de confiance signale les extractions incertaines pour révision humaine, de sorte que 100 % des données envoyées à votre système de facturation ont été vérifiées, soit par la confiance de l'IA, soit par un contrôle du personnel.
Combien de temps faut-il pour configurer un nouveau format EOB de payeur ?
Avec l'extraction par nom de colonne, aucun temps de configuration. Les mêmes définitions de colonnes créées pour les EOB UnitedHealthcare fonctionnent immédiatement sur le format d'un nouveau payeur—l'IA lit le document contextuellement plutôt que de correspondre à un modèle stocké. Si l'EOB d'un nouveau payeur utilise un terme inhabituel pour un point de données standard (par exemple, « Plan Paid » au lieu de « Allowed Amount »), le premier lot peut nécessiter un ajustement du nom de colonne, mais il n'y a aucun modèle à créer ou à entraîner.
L'extraction par lots peut-elle gérer les annotations manuscrites sur les EOB ?
Partiellement. L'extraction basée sur l'IA peut lire une écriture claire sur les documents, mais la précision est inférieure à celle du texte imprimé. Les ajustements manuscrits dans les marges—fréquents sur les EOB où un assureur annote manuellement un motif de refus—seront probablement signalés par le système de score de confiance pour révision humaine. Pour les équipes qui reçoivent un pourcentage élevé d'EOB annotés, l'extraction par lots fait toujours gagner du temps sur les 90 % de données imprimées tout en orientant le contenu manuscrit vers le personnel pour vérification.
Que se passe-t-il si un lot contient à la fois des EOB d'une page et de plusieurs pages ?
Chaque page d'un EOB multipage est traitée comme faisant partie du même document. Si vous téléversez un EOB Aetna de 3 pages sous forme de trois fichiers séparés, ils apparaîtront comme trois lignes dans la sortie. Pour les flux de travail par lots où les EOB multipages sont répartis entre plusieurs fichiers, il est préférable de les combiner en un seul PDF par EOB avant le téléversement, ou d'inclure une colonne Numéro de réclamation dans votre définition d'extraction afin de pouvoir regrouper les lignes associées lors du rapprochement.
Tester l'extraction par lots sur vos propres EOB
L'argument en faveur de l'extraction par lots d'EOB ne repose finalement pas sur des pourcentages de précision ou des références sectorielles—il repose sur ce qui change lorsque votre équipe de facturation ouvre sa file d'attente lundi matin et voit une feuille de calcul complétée au lieu d'une pile de PDF. Les 5 à 8 minutes par EOB ne sont pas une estimation théorique ; c'est un chiffre que les gestionnaires de facturation peuvent valider en chronométrant leur propre personnel sur un lot typique. La question est de savoir ce que ces heures récupérées permettent : plus de refus contestés, une facturation plus rapide aux patients, des jours de créances plus courts, ou simplement une équipe qui termine la saisie des paiements mercredi au lieu de vendredi.
Testez sur un lot de vos propres EOB. Définissez les colonnes dont votre système de facturation a besoin. Vérifiez si le flux de travail, du téléversement à la feuille de calcul structurée, s'adapte à votre cycle mensuel. La seule façon d'évaluer si l'extraction par nom de colonne gère votre combinaison spécifique de payeurs est de l'exécuter sur vos documents réels.