Como equipes de cobrança médica
extraem dados em lote de centenas de EOBs
A maioria das ferramentas de extração de documentos parte do mesmo pressuposto sobre os formulários de Explicação de Benefícios: que são documentos padronizados. Não são. Um EOB da Blue Cross da Flórida não se parece em nada com um EOB da Blue Cross de Illinois. Um EOB da Aetna usa cabeçalhos de coluna diferentes de um aviso de remessa do Medicare. Multiplique isso por 15 ou 20 pagadores, e o gargalo no processamento de EOBs não é a velocidade de digitação—é a variação de formato. Para equipes de cobrança que processam centenas desses documentos por mês, a questão não é se a IA consegue ler um EOB. É se uma única configuração de extração consegue lidar com todos eles em um único lote.
Por que os EOBs resistem à automação que funciona para formulários padrão
A razão pela qual a maioria das ferramentas de extração de documentos falha nos formulários de Explanation of Benefits não é a precisão—é a fragmentação de formatos. Existem mais de 6.000 layouts distintos de EOB entre as operadoras nos Estados Unidos. Cada seguradora—UnitedHealthcare, Aetna, Cigna, Humana, Medicare, Medicaid, seguradoras de compensação de trabalhadores—organiza os mesmos dados de maneiras diferentes. Algumas usam tabelas horizontais, outras usam seções verticais. Algumas dividem a responsabilidade do paciente em quatro subcolunas; outras a condensam em uma única linha. Algumas operadoras até mudam o layout dentro de um único EOB, usando um formato para sinistros pagos e outro para negados no mesmo PDF.
Isso importa porque ferramentas de extração baseadas em modelos—ferramentas que exigem que você defina um layout fixo para cada tipo de documento—exigem um modelo separado para cada formato de operadora. Quando uma operadora atualiza seu layout, o que acontece com mais frequência do que você imagina, o modelo quebra. As equipes de faturamento acabam mantendo modelos de extração em vez de lançar pagamentos.
Um EOB, abreviação de Explanation of Benefits, é o documento que a seguradora envia após processar uma reivindicação de assistência médica. Ele detalha o que foi cobrado, o que o plano cobriu, o que a seguradora pagou e o que o paciente deve. Para prestadores que não se inscreveram no aviso eletrônico de remessa (ERA) com todas as operadoras—ou que recebem EOBs em papel de certas operadoras independentemente disso—cada EOB deve ser revisado manualmente, os dados inseridos no sistema de gestão do consultório e conciliados com os registros de reivindicações. O ERA é a versão eletrônica de um EOB, transmitida como transação ASC X12 835 sob os padrões HIPAA. Quando funciona, automatiza o lançamento. Mas muitas operadoras ainda enviam EOBs em papel ou PDF, e até mesmo prestadores inscritos no ERA para grandes operadoras frequentemente recebem EOBs em PDF de operadoras secundárias, compensação de trabalhadores ou programas Medicaid específicos de cada estado.
Insight principal: O gargalo no processamento de EOBs não é a velocidade de entrada de dados. É o fato de que nenhuma operadora usa o mesmo formato—e as equipes de faturamento ainda precisam de cada dado de cada formato para lançar pagamentos corretamente.
O Custo Real da Mão de Obra no Lançamento Manual de EOB
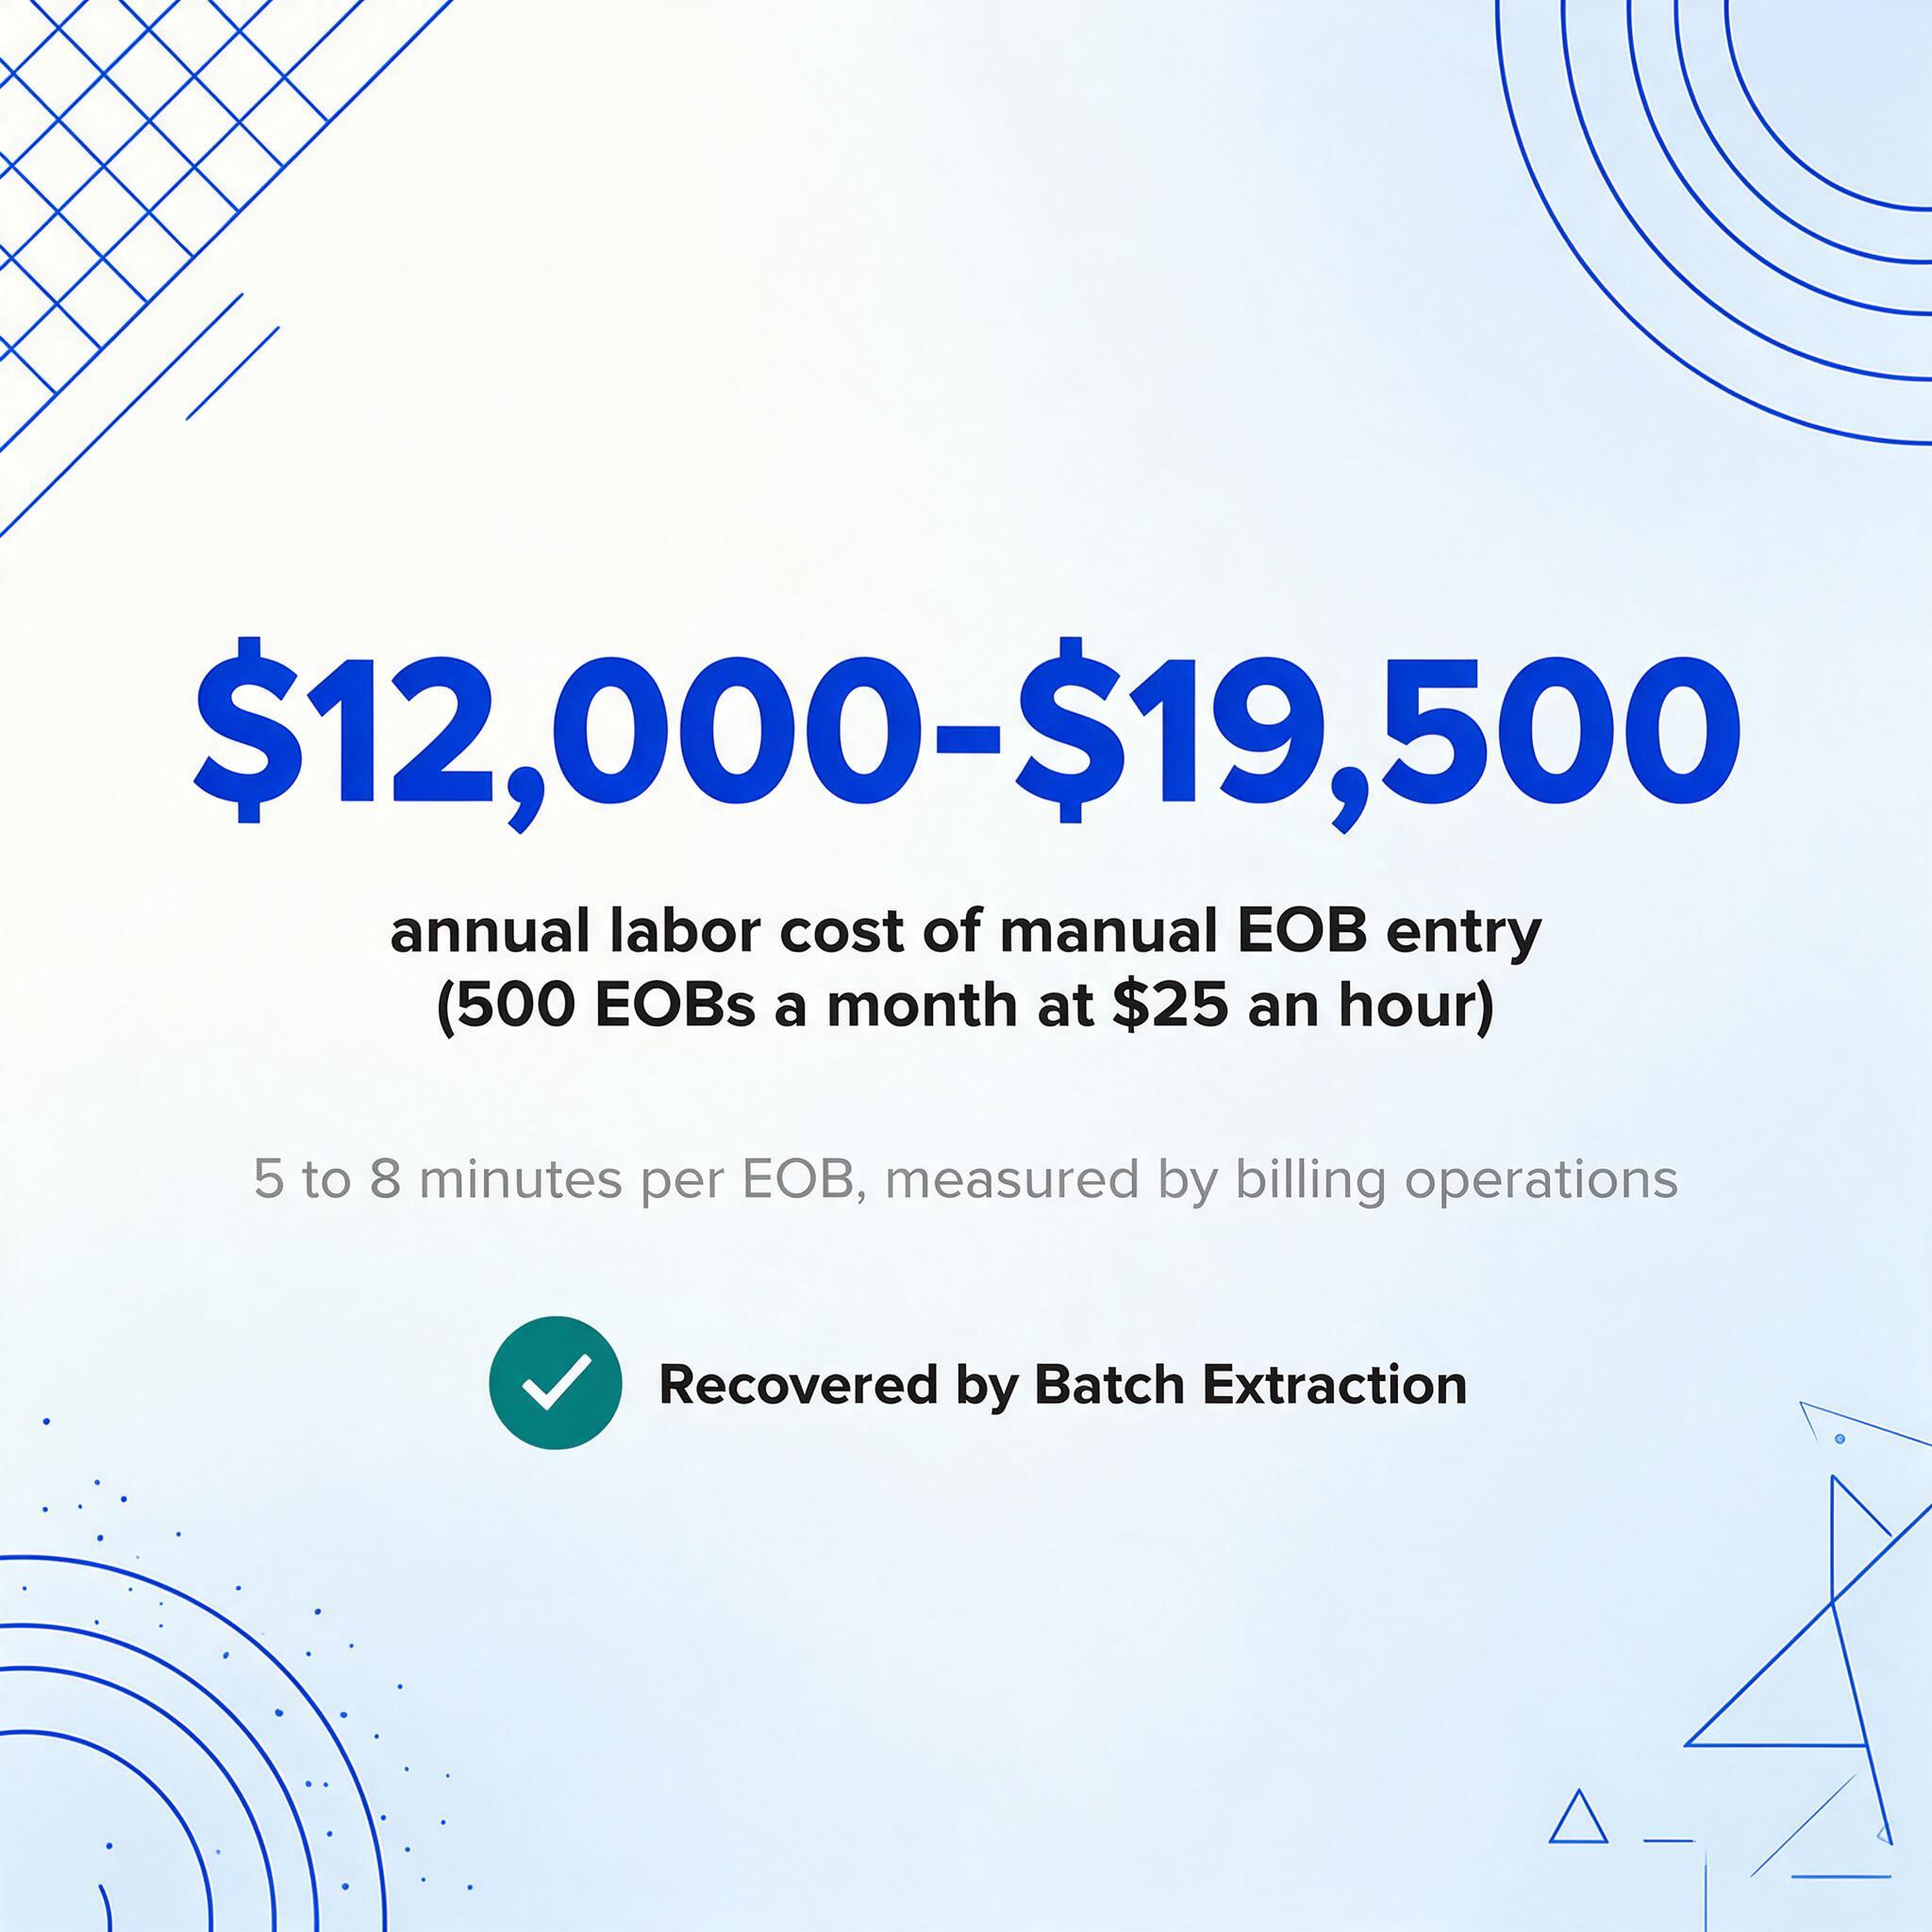
O lançamento manual de dados de EOB consome de 5 a 8 minutos por documento, de acordo com dados de operações de faturamento que mediram esse tempo. Com 500 EOBs por mês—um volume típico para um consultório de médio porte ou uma pequena empresa de faturamento—isso representa de 40 a 65 horas de trabalho da equipe. A US$ 25 por hora para a equipe de faturamento, o custo anual de mão de obra é de aproximadamente US$ 12.000 a US$ 19.500, apenas para o lançamento de dados de EOB.
Esse número não inclui os custos downstream. O Índice CAQH, referência autoritativa do setor sobre custos de transações administrativas, estima o custo de retrabalhar uma única reivindicação negada em aproximadamente US$ 25 para correções simples. Apelações complexas que exigem documentação clínica podem custar US$ 100 ou mais. E as taxas de negação estão aumentando: a média nacional de 2025 ultrapassou 12,4%, a maior em dez anos, de acordo com dados do setor. O DataDive de 2023 da MGMA descobriu que consultórios de especialidade única tinham uma taxa de negação de 8% na primeira submissão, e uma pesquisa da MGMA de março de 2024 relatou que 60% dos grupos médicos viram mais negações em comparação ao ano anterior.
Quando os dados de EOB são inseridos manualmente, códigos CPT digitados incorretamente (códigos de Terminologia Processual Atual mantidos pela Associação Médica Americana, usados para descrever serviços médicos em reivindicações), valores de ajuste incorretos ou códigos CARC lidos incorretamente (Códigos de Motivo de Ajuste de Reivindicação—códigos padronizados que explicam por que uma reivindicação foi paga de forma diferente da cobrada) criam trabalho de reconciliação downstream. Um ajuste CO-45 (cobrança excede a tabela de honorários) digitado incorretamente como CO-97 (serviço incluído em outro pagamento) envia a equipe de faturamento pelo caminho errado de resolução. Esses não são casos extremos teóricos—são ocorrências diárias em fluxos de trabalho manuais.
De acordo com o Conselho para Assistência Médica Acessível e de Qualidade (CAQH), 24 centavos de cada dólar de saúde são gastos em custos administrativos e de faturamento. O setor poderia economizar cerca de US$ 9,4 bilhões anualmente convertendo transações manuais em eletrônicas. O Índice CAQH de 2025 descobriu que o sistema de saúde dos EUA evitou US$ 258 bilhões em custos administrativos em 2024 por meio de transações eletrônicas—o que significa que ainda há espaço significativo para melhorias nas partes do ciclo de receita que permanecem manuais, como o processamento de EOB em PDF.
O Que Ferramentas de Extração de EOB Único Ignoram Sobre Fluxos de Trabalho em Lote
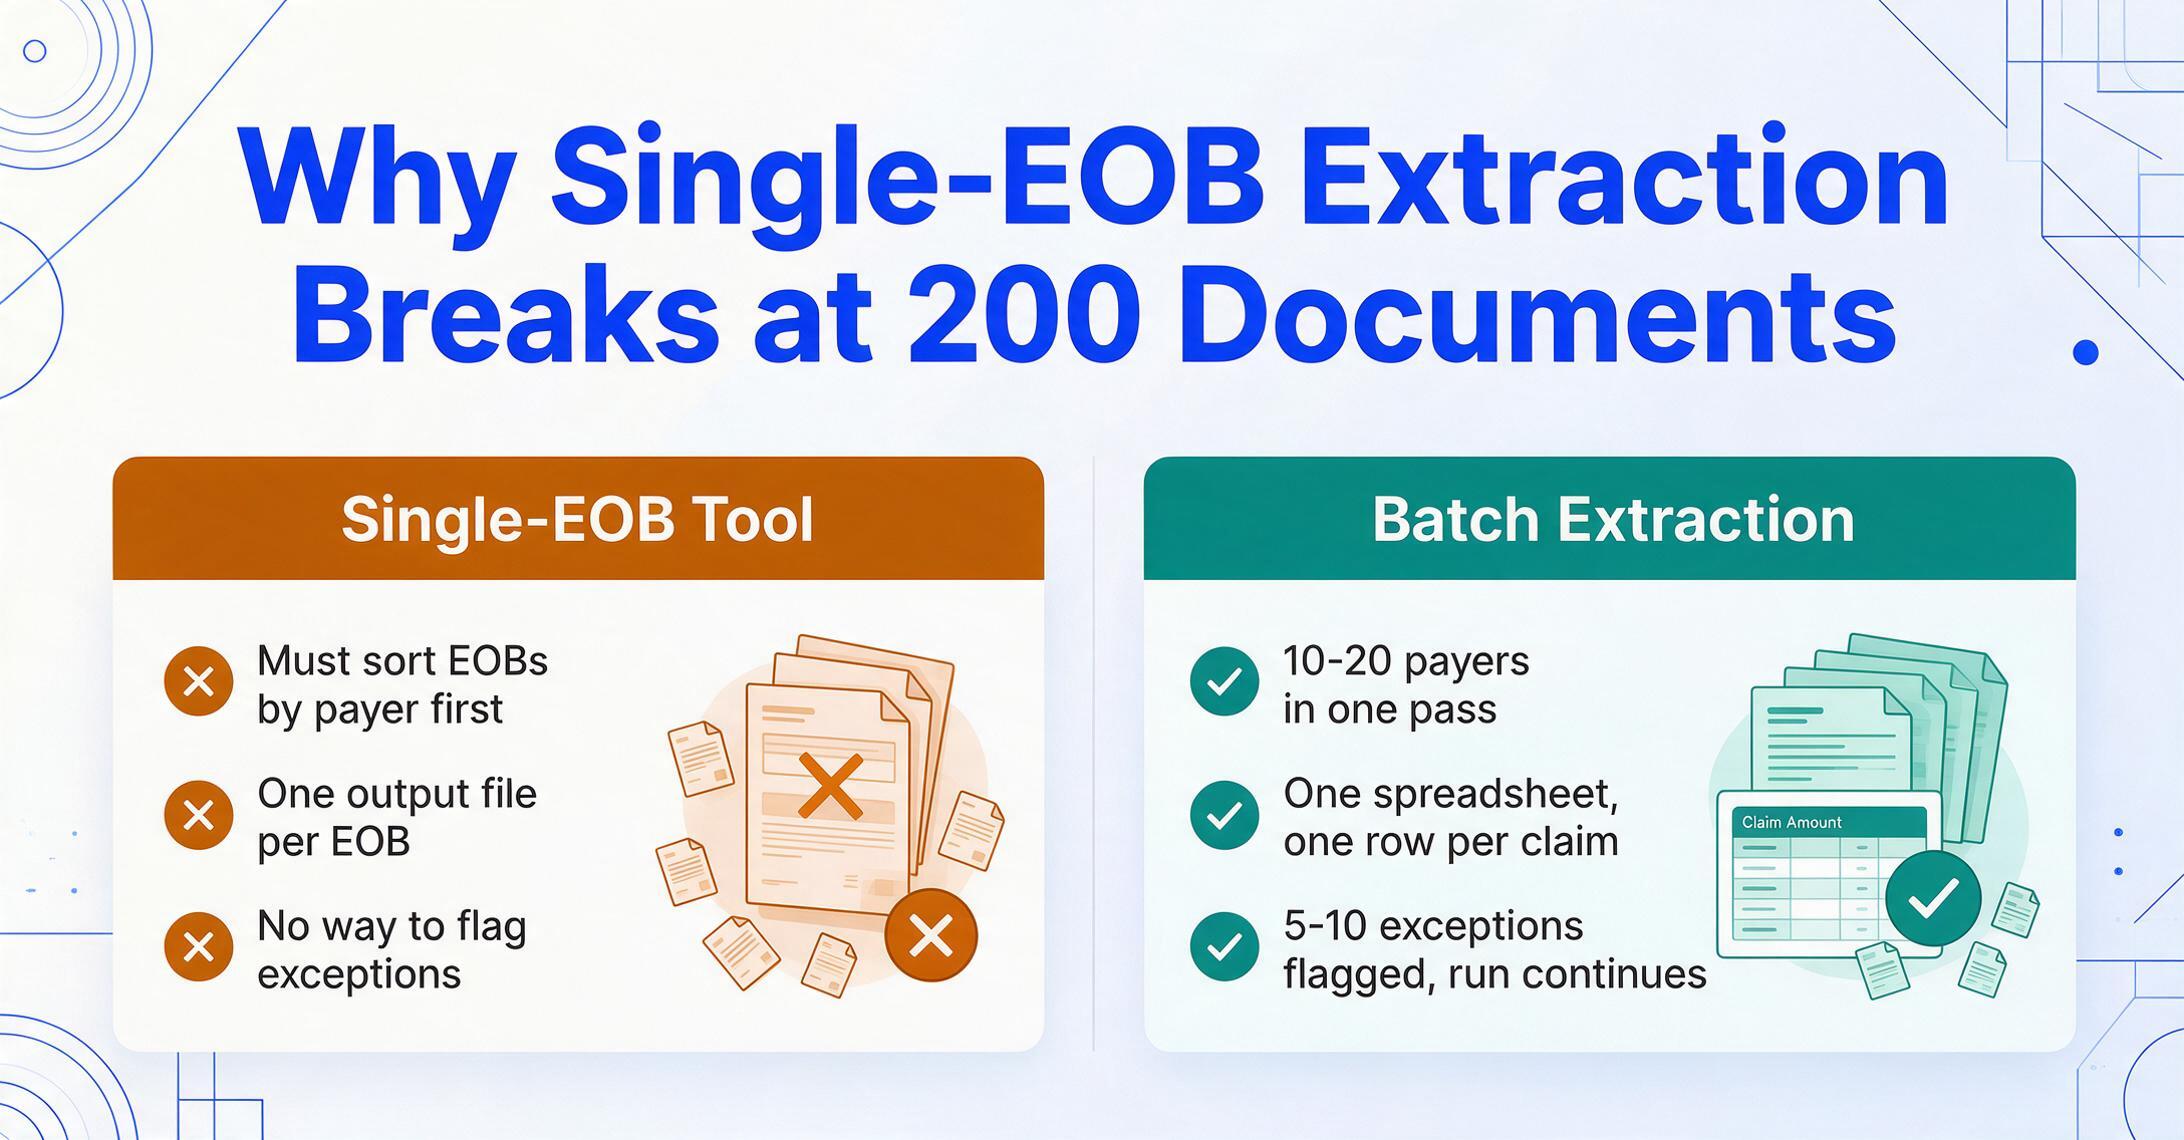
Processar um EOB é um problema fundamentalmente diferente de processar 200 de uma vez. O fluxo de trabalho de EOB único—abrir um PDF, extrair dados, copiar para o sistema, repetir—quebra em volume de maneiras que não têm nada a ver com a precisão da extração.
Pilhas de múltiplos pagadores. Um lote de 200 EOBs normalmente contém documentos de 10 a 20 pagadores diferentes. EOBs do Medicare usam pares de códigos CARC/RARC em um formato específico de aviso de remessa. EOBs da UnitedHealthcare estruturam a responsabilidade do paciente de forma diferente dos EOBs da Aetna. Uma ferramenta de extração em lote deve lidar com todos eles em uma única passada, sem exigir que o usuário separe os EOBs por pagador primeiro. Se você precisa separá-los antes de enviar, você apenas moveu o trabalho manual um passo adiante.
Mesclagem de saída. Quando uma ferramenta processa EOBs um de cada vez, a saída é um arquivo por EOB. Extração em lote significa que todos os 200 resultados chegam em uma única planilha—uma linha por sinistro, todas as colunas alinhadas. Este é o formato que os gerentes de faturamento precisam para importação em massa em seu sistema de gestão de consultório ou para conciliação de fim de mês.
Tratamento de exceções. Em um lote de 200 EOBs, 5 a 10 terão algo incomum: uma nota de ajuste manuscrita na margem, um EOB de duas páginas com dados de continuação, um nome de paciente que é quase idêntico, mas não exatamente igual aos seus registros. Um fluxo de trabalho em lote precisa sinalizar essas exceções para revisão humana sem interromper todo o processo de processamento. Ferramentas que tratam a extração de um EOB por vez como padrão não oferecem mecanismo para isso.
Fontes de arquivo. As equipes de faturamento obtêm EOBs de vários canais: portais de pagadores (Availity, Portal do Prestador da UnitedHealthcare, sites individuais de operadoras), PDFs enviados por e-mail, cópias por fax e originais em papel digitalizados. Um fluxo de trabalho em lote deve aceitar qualquer combinação desses sem etapas de pré-processamento separadas para cada fonte.
Se você é novo no que é um EOB e quais campos importam para conciliação, nossa visão geral da extração de dados de EOB cobre o detalhamento em nível de campo, e nosso guia completo de extração de dados de EOB percorre critérios de seleção e opções de exportação de ponta a ponta. E para uma comparação lado a lado de ferramentas que podem lidar com esse tipo de fluxo de trabalho em lote com múltiplos pagadores, veja nosso resumo de ferramentas de extração de documentos de saúde, que testa sete ferramentas em 40 EOBs reais, formulários de sinistros e documentos de pacientes.
Como a IA lê layouts de EOB sem modelos por operadora
A abordagem técnica que lida com a variação de formato das operadoras é fundamentalmente diferente da extração baseada em modelos. Ferramentas de modelo usam coordenadas fixas—"o valor permitido está na posição X, Y da página." Quando uma operadora muda o layout, a coordenada fica errada. Quando uma nova operadora envia o primeiro EOB, não existe modelo algum.
A extração baseada em IA usando modelos de linguagem visual funciona de forma diferente. Em vez de combinar coordenadas da página, ela lê o documento semanticamente—entendendo o que cada seção significa, não apenas onde está. Você define as colunas necessárias: Nome do Paciente, Data do Atendimento, Código CPT, Valor Cobrado, Valor Permitido, Franquia, Coparticipação, Responsabilidade do Paciente, Código de Ajuste (CARC), Valor do Ajuste, Motivo da Negativa. A IA localiza cada valor em qualquer lugar da página ao entender a estrutura do documento—da mesma forma que um cobrador humano examina um layout de EOB desconhecido, encontra o nome do paciente perto do topo e percorre os cabeçalhos das colunas para achar o valor permitido.
Essa abordagem, que a ImageToTable.ai chama de extração por nome de coluna, significa que você digita os nomes dos campos desejados e a IA os mapeia para os valores, independentemente de onde cada operadora coloca esses campos. Uma única configuração processa um EOB da UnitedHealthcare e um EOB da Aetna no mesmo lote sem modificação. O resultado é uma planilha unificada em que cada linha tem as mesmas colunas, independentemente de qual operadora gerou o PDF original.
Os arquivos são processados com segurança e não são armazenados.
Essa é a diferença entre criar e manter 20 modelos de extração—um por operadora—e definir suas colunas de saída uma única vez. Para uma equipe de cobrança que processa EOBs de 15 ou mais operadoras, o custo de manutenção da abordagem por modelo não é um custo único. É um imposto operacional contínuo.
Um Fluxo de Trabalho de Extração de EOB em Lote, Passo a Passo
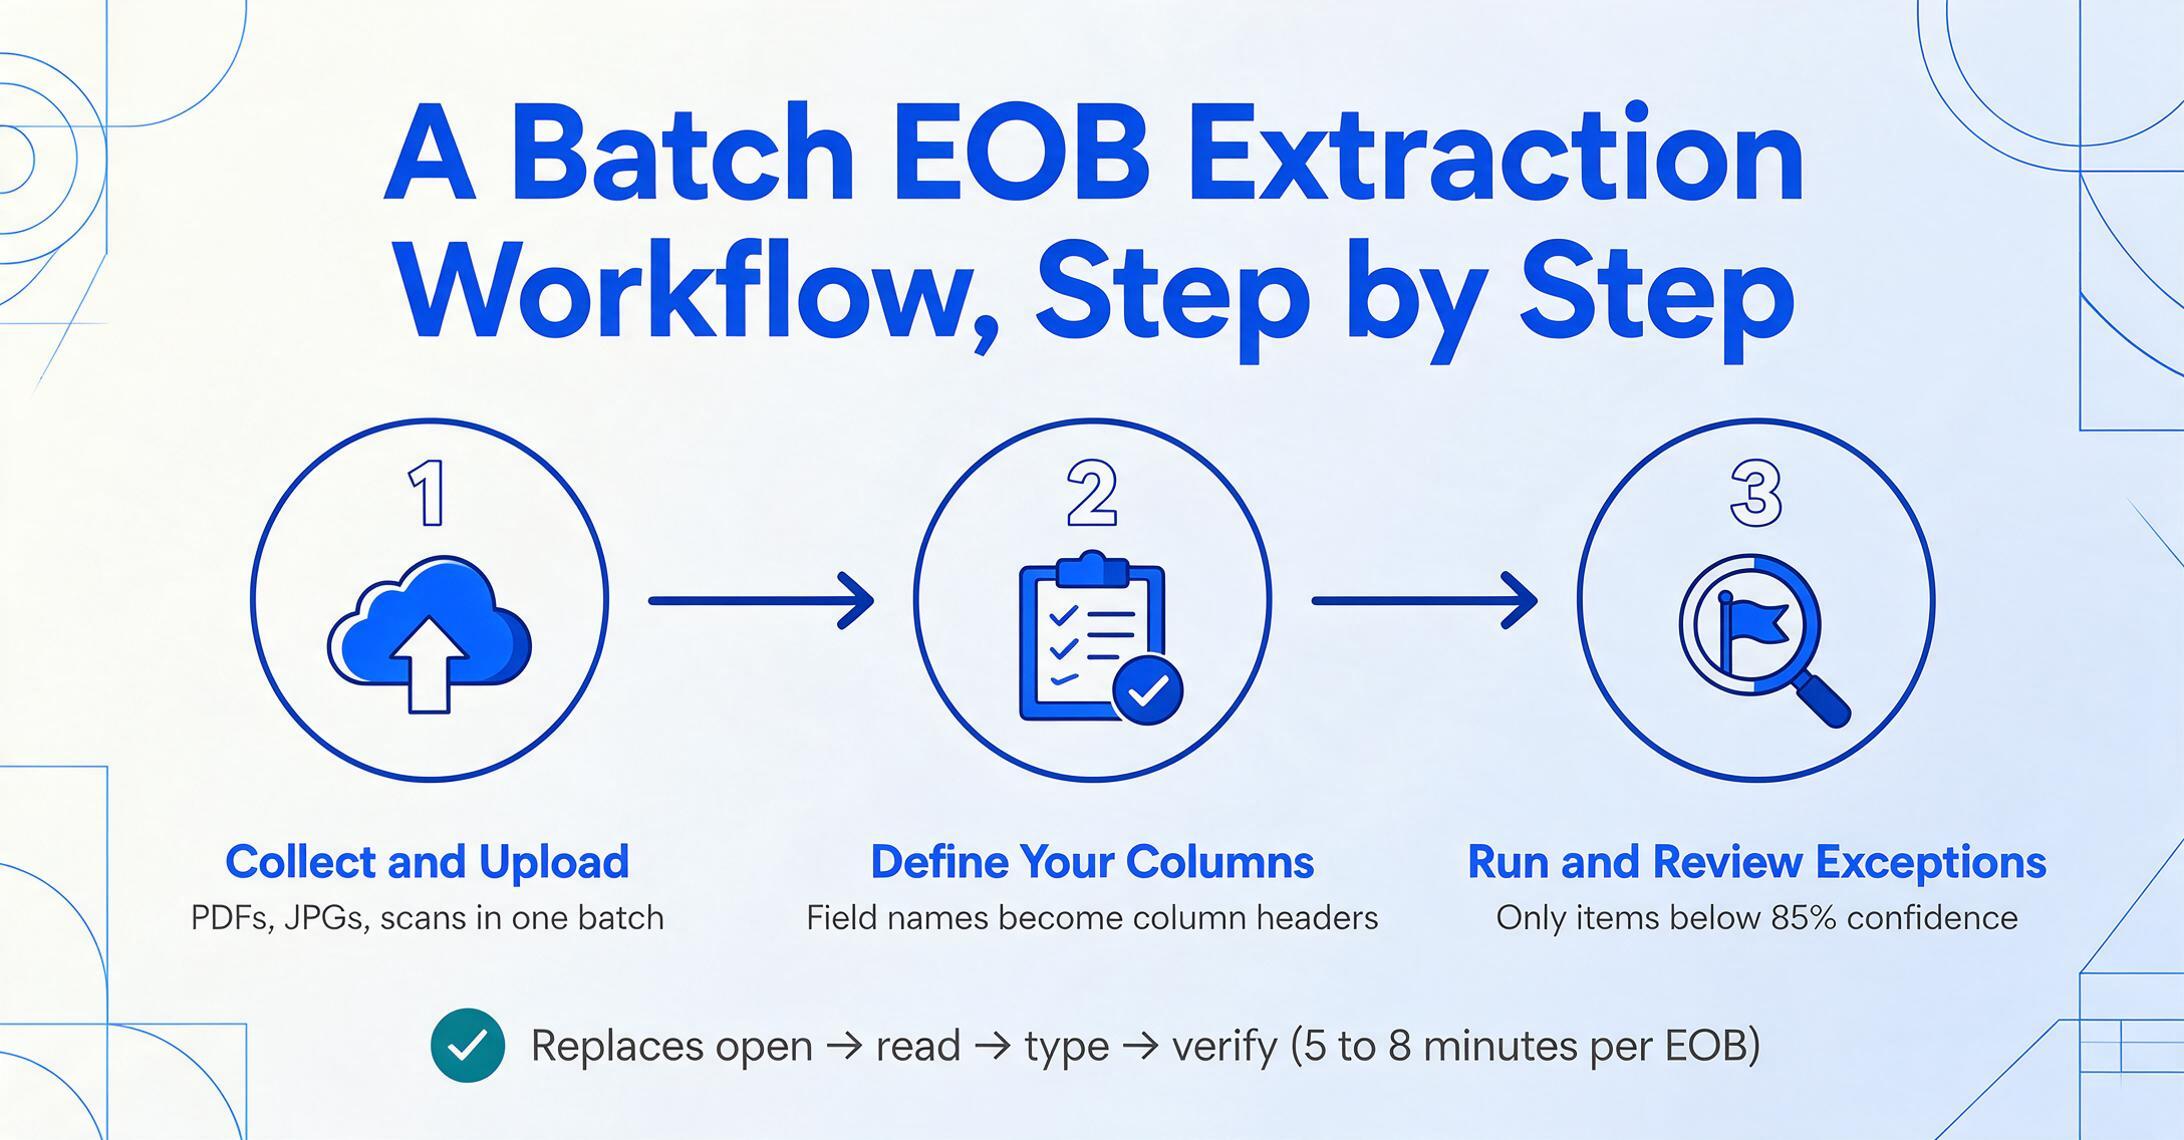
Um fluxo de trabalho de extração de EOB em lote difere de um fluxo de documento único em três etapas: preparação, processamento e revisão de exceções. Veja como cada uma funciona na prática.
Coletar e enviar.
Reúna EOBs de portais de pagadores, e-mail e cópias impressas digitalizadas em uma única pasta. Envie o lote completo—sem necessidade de classificar por pagador ou separar PDFs de digitalizações. O ImageToTable.ai aceita arquivos PDF, JPG e PNG em um único envio.
Defina suas colunas.
Insira os nomes dos campos necessários: Nome do Paciente, Data do Serviço, Código(s) CPT, Valor Cobrado, Valor Permitido, Franquia, Cosseguro, Coparticipação, Responsabilidade do Paciente, Valor Pago, Código de Ajuste, Motivo do Ajuste, Número do Cheque/EFT, Data do Cheque. Eles se tornam os cabeçalhos das colunas na sua planilha de saída.
Executar e revisar exceções.
A IA processa todos os documentos de uma só vez. Cada valor extraído possui uma pontuação de confiança. Defina um limite (por exemplo, abaixo de 85%) para sinalizar itens para revisão humana. Um membro da equipe de cobrança verifica apenas os itens sinalizados—talvez 5% do total de dados—em vez de verificar cada campo em cada EOB.
Este fluxo de trabalho em três etapas substitui o ciclo por EOB de abrir → ler → digitar → verificar, que ocupa de 5 a 8 minutos por documento. A diferença com 500 EOBs por mês é de aproximadamente 40 horas de tempo de equipe recuperadas—tempo que passa da entrada de dados para análise de negações, preparação de apelações e acompanhamento com pagadores. Para um passo a passo prático deste fluxo em lote, do envio à saída em planilha, consulte nosso guia sobre conversão de EOBs para Excel.
Dos Dados Extraídos ao Sistema de Faturamento: A Etapa que Falta
A pergunta mais comum que gerentes de faturamento fazem após ver uma demonstração de extração é: "Como isso entra no meu sistema?" A resposta depende do software de gerenciamento de consultório em uso, mas o padrão é consistente: a saída da extração em lote—normalmente uma planilha Excel ou arquivo CSV—mapeia para a interface de importação da plataforma de faturamento.
Kareo suporta postagem automática de ERA para pagadores inscritos e entrada manual de pagamentos para EOBs não-ERA. Os dados de EOB extraídos em lote podem ser revisados e inseridos durante o fluxo de postagem de pagamentos, ou importados se o consultório usar as ferramentas de importação em lote da Kareo. AdvancedMD fornece telas de revisão de eRemittance onde os dados de pagamento extraídos podem ser conciliados com as reivindicações. CollaborateMD roteia reivindicações pelo seu Claim Control Center; os dados de ajustes extraídos alimentam a fila de gerenciamento de negações.
As colunas que você define durante a extração devem corresponder aos campos que seu sistema de faturamento espera. Se o seu sistema precisa de números de conta do paciente, inclua isso como uma coluna. Se você rastreia códigos CARC e RARC (Remittance Advice Remark Codes—códigos suplementares que fornecem contexto adicional aos CARCs, como "N130: Documentação adicional necessária para processamento de reivindicação"), inclua-os como colunas separadas. A saída da extração se torna um conjunto de dados estruturado que alimenta diretamente o fluxo de trabalho do ciclo de receita. Para equipes que querem ir um passo além, o ImageToTable.ai suporta coluna inferida: você pode definir uma coluna como "Categoria de Negação (opções: Erro de Codificação / Elegibilidade / Autorização / Necessidade Médica / Envio em Tempo Hábil / Outro)" e a IA classifica cada negação em um grupo com base no código CARC e no texto do comentário—classificação e extração em uma única passagem.
É aqui que a extração em lote cria valor composto. Uma ferramenta de EOB único economiza 5 minutos em um documento. Uma ferramenta em lote que também classifica negações e mapeia para campos de importação de faturamento economiza 5 minutos por EOB e elimina os 15-20 minutos por lote que a equipe gasta com classificação e categorização pós-extração.
Processamento em Lote de EOBs e Conformidade com a HIPAA
Qualquer ferramenta que processe dados de EOB lida com informações de saúde protegidas (PHI). A conformidade com a HIPAA não é um item a ser verificado no final de uma avaliação de fornecedor—é o primeiro filtro. Os requisitos essenciais para uma ferramenta de extração de EOBs em lote são: criptografia em trânsito e em repouso, nenhum armazenamento persistente de documentos enviados, a menos que explicitamente configurado, e um Contrato de Associado de Negócios (BAA) disponível para entidades cobertas.
O ImageToTable.ai processa arquivos durante a extração e não os retém após o processamento. Para organizações de saúde, a implicação prática do fluxo de trabalho é direta: envie PDFs de EOB de um ambiente seguro, extraia os dados, baixe a saída estruturada e exclua os arquivos de origem da fila de upload. Os dados saem do ambiente de extração e entram no seu sistema de gestão de consultório sob seus controles de conformidade existentes.
Dito isso, as equipes de faturamento devem verificar as certificações de conformidade específicas de qualquer ferramenta de extração (SOC 2, atestado HIPAA) em relação aos requisitos da sua organização. Nenhuma ferramenta elimina a obrigação de realizar a devida diligência com o fornecedor, e este artigo não substitui esse processo.
Conselho prático: Antes de processar EOBs em lote por qualquer ferramenta de extração, confirme se o fornecedor fornece um BAA, verifique as políticas de tratamento e retenção de dados e teste primeiro com EOBs de amostra desidentificados para garantir que o fluxo de trabalho atenda aos seus requisitos de conformidade.
Perguntas Frequentes
A extração de EOBs em lote pode lidar com arquivos de Aviso de Remessa Eletrônica (ERA)?
Arquivos ERA (formato ASC X12 835) já são dados estruturados—eles não precisam de extração. Se você recebe tanto arquivos ERA quanto PDFs de EOB, a extração em lote lida com a parte de PDF/papel do seu recebimento de EOBs. Os dados extraídos podem ser formatados para corresponder ao seu fluxo de trabalho de lançamento de ERA, para que todos os pagamentos, independentemente do formato de origem, alimentem o mesmo processo de conciliação.
A extração em lote preserva zeros à esquerda em códigos CPT e números NPI?
Sim. Preservar zeros à esquerda é uma questão de formatação na etapa de saída. A extração de nomes de colunas do ImageToTable.ai preserva os dados originais conforme aparecem no documento. Ao exportar para Excel, você pode especificar formatação de texto para colunas de código CPT, NPI, e número de conta para evitar que o software de planilhas remova zeros à esquerda.
Qual taxa de precisão devo esperar em lotes de EOB de pagadores mistos?
Texto impresso em PDFs de EOB limpos normalmente é extraído com precisão de 95-99% em nível de campo. A precisão diminui em documentos muito escaneados ou enviados por fax, anotações manuscritas nas margens, e formatos de pagadores incomuns que se desviam significativamente dos layouts padrão de EOB. O fluxo de trabalho em lote é projetado em torno dessa realidade: a pontuação de confiança sinaliza as extrações incertas para revisão humana, então 100% dos dados que são lançados no seu sistema de cobrança foram verificados, seja pela confiança da IA ou pela verificação da equipe.
Quanto tempo leva para configurar um novo formato de EOB de pagador?
Com extração de nomes de colunas, zero tempo de configuração. As mesmas definições de colunas que você criou para EOBs da UnitedHealthcare funcionam imediatamente em um novo formato de pagador—a IA lê o documento contextualmente em vez de corresponder a um modelo armazenado. Se um novo formato de EOB de pagador usar um termo desconhecido para um dado padrão(ponto ex., "Plan Paid" em vez de "Allowed Amount"), o primeiro lote pode exigir um ajuste no nome da coluna, mas não há modelo para construir ou treinar.
A extração em lote pode lidar com anotações manuscritas em EOBs?
Parcialmente. A extração baseada em IA pode ler escrita clara em documentos, mas a precisão é menor do que para texto impresso. Ajustes manuscritos nas margens—comuns em EOBs onde uma seguradora anota manualmente um motivo de negação—provavelmente serão sinalizados pelo sistema de pontuação de confiança para revisão humana. Para equipes que recebem uma alta porcentagem de EOBs anotados, a extração em lote ainda economiza tempo nos 90% de dados impressos enquanto direciona conteúdo manuscrito para a equipe verificar.
O que acontece se um lote contiver EOBs de uma página e de várias páginas?
Cada página de um EOB de várias páginas é processada como parte do mesmo documento. Se você enviar um EOB da Aetna de 3 páginas como três arquivos separados, eles aparecerão como três linhas na saída. Para fluxos de trabalho em lote em que EOBs de várias páginas são divididos em arquivos, é melhor combiná-los em um único PDF por EOB antes do upload, ou incluir uma coluna Número da Reclamação na sua definição de extração para agrupar linhas relacionadas durante a reconciliação.
Testando a Extração em Lote nos Seus Próprios EOBs
O argumento para a extração de EOBs em lote não se resume a percentuais de precisão ou benchmarks do setor—trata-se do que muda quando sua equipe de cobrança abre a fila na segunda-feira de manhã e vê uma planilha concluída em vez de uma pilha de PDFs. Os 5 a 8 minutos por EOB não são uma estimativa teórica; é um número que os gerentes de cobrança podem validar cronometrando sua própria equipe em um lote típico. A questão é o que essas horas recuperadas permitem: mais negativas contestadas, cobrança mais rápida ao paciente, menos dias em A/R, ou simplesmente uma equipe que termina o lançamento de pagamentos antes de quarta-feira em vez de sexta-feira.
Teste com um lote dos seus próprios EOBs. Defina as colunas que seu sistema de cobrança precisa. Veja se o fluxo de trabalho, do upload à planilha estruturada, se encaixa no seu ciclo mensal. A única forma de avaliar se a extração por nome de coluna lida com sua combinação específica de pagadores é executá-la nos seus documentos reais.