医療請求チームが
数百件のEOBからデータを一括抽出
ほとんどの文書抽出ツールは、EOB(保険金支払説明書)について同じ前提を置いています。それは、EOBが標準化された文書であるという前提です。実際はそうではありません。フロリダのBlue CrossのEOBは、イリノイのBlue CrossのEOBとはまったく見た目が異なります。AetnaのEOBは、メディケアの送金明細書とは異なる列ヘッダーを使用しています。それが15〜20の保険者に掛け合わされると、EOB処理のボトルネックは入力速度ではなく、フォーマットの差異になります。毎月数百件のこれらの文書を処理する請求チームにとって、問題はAIがEOBを読み取れるかどうかではありません。1つの抽出設定で、それらすべてを単一のバッチで処理できるかどうかが問題です。
標準フォームで機能する自動化がEOBに効かない理由
ほとんどの文書抽出ツールがEOB(保険金支払説明書)で失敗する理由は、正確性ではなく、フォーマットの断片化にあります。米国では保険者ごとに6,000以上の異なるEOBレイアウトが存在します。各保険者—UnitedHealthcare、Aetna、Cigna、Humana、メディケア、メディケイド、労災保険—は、同じデータ項目を異なる方法で整理しています。横型テーブルを使用する保険者もいれば、縦型セクションを使用する保険者もいます。患者負担額を4つのサブ列に分割する保険者もいれば、1行にまとめる保険者もいます。中には、同じPDF内で支払済み請求と拒絶された請求で異なるフォーマットを使用し、単一のEOB内でレイアウトを変更する保険者もいます。
これは、テンプレートベースの抽出ツール—文書タイプごとに固定レイアウトの定義を必要とするツール—が、保険者ごとのフォーマットに個別のテンプレートを要求するため重要です。保険者がレイアウトを更新すると、予想以上に頻繁に発生しますが、テンプレートは機能しなくなります。請求チームは支払いの記帳ではなく、抽出テンプレートの維持に時間を費やすことになります。
EOB(保険金支払説明書)とは、保険会社が医療請求を処理した後に送付する文書です。請求された金額、プランがカバーした内容、保険者が支払った金額、患者が負担する金額を明細化します。すべての保険者でERA(電子送金明細)に登録していない医療機関や、保険者によっては紙のEOBを受け取る医療機関では、各EOBを手動で確認し、診療管理システムへのデータ入力、請求記録との照合を行う必要があります。ERAはEOBの電子版であり、HIPAA基準に基づきASC X12 835トランザクションとして送信されます。機能する場合、記帳を自動化します。しかし、多くの保険者は依然として紙またはPDFのEOBを送付しており、主要保険者でERAに登録している医療機関でも、セカンダリ保険者、労災保険、州固有のメディケイドプログラムからPDFのEOBを受け取ることがよくあります。
重要な洞察: EOB処理におけるボトルネックはデータ入力の速度ではありません。2つの保険者が同じフォーマットを使用していないという事実—そして請求チームが支払いを正確に記帳するために、すべてのフォーマットからすべてのデータ項目を必要とすることです。
手動EOB入力の実際の人件費
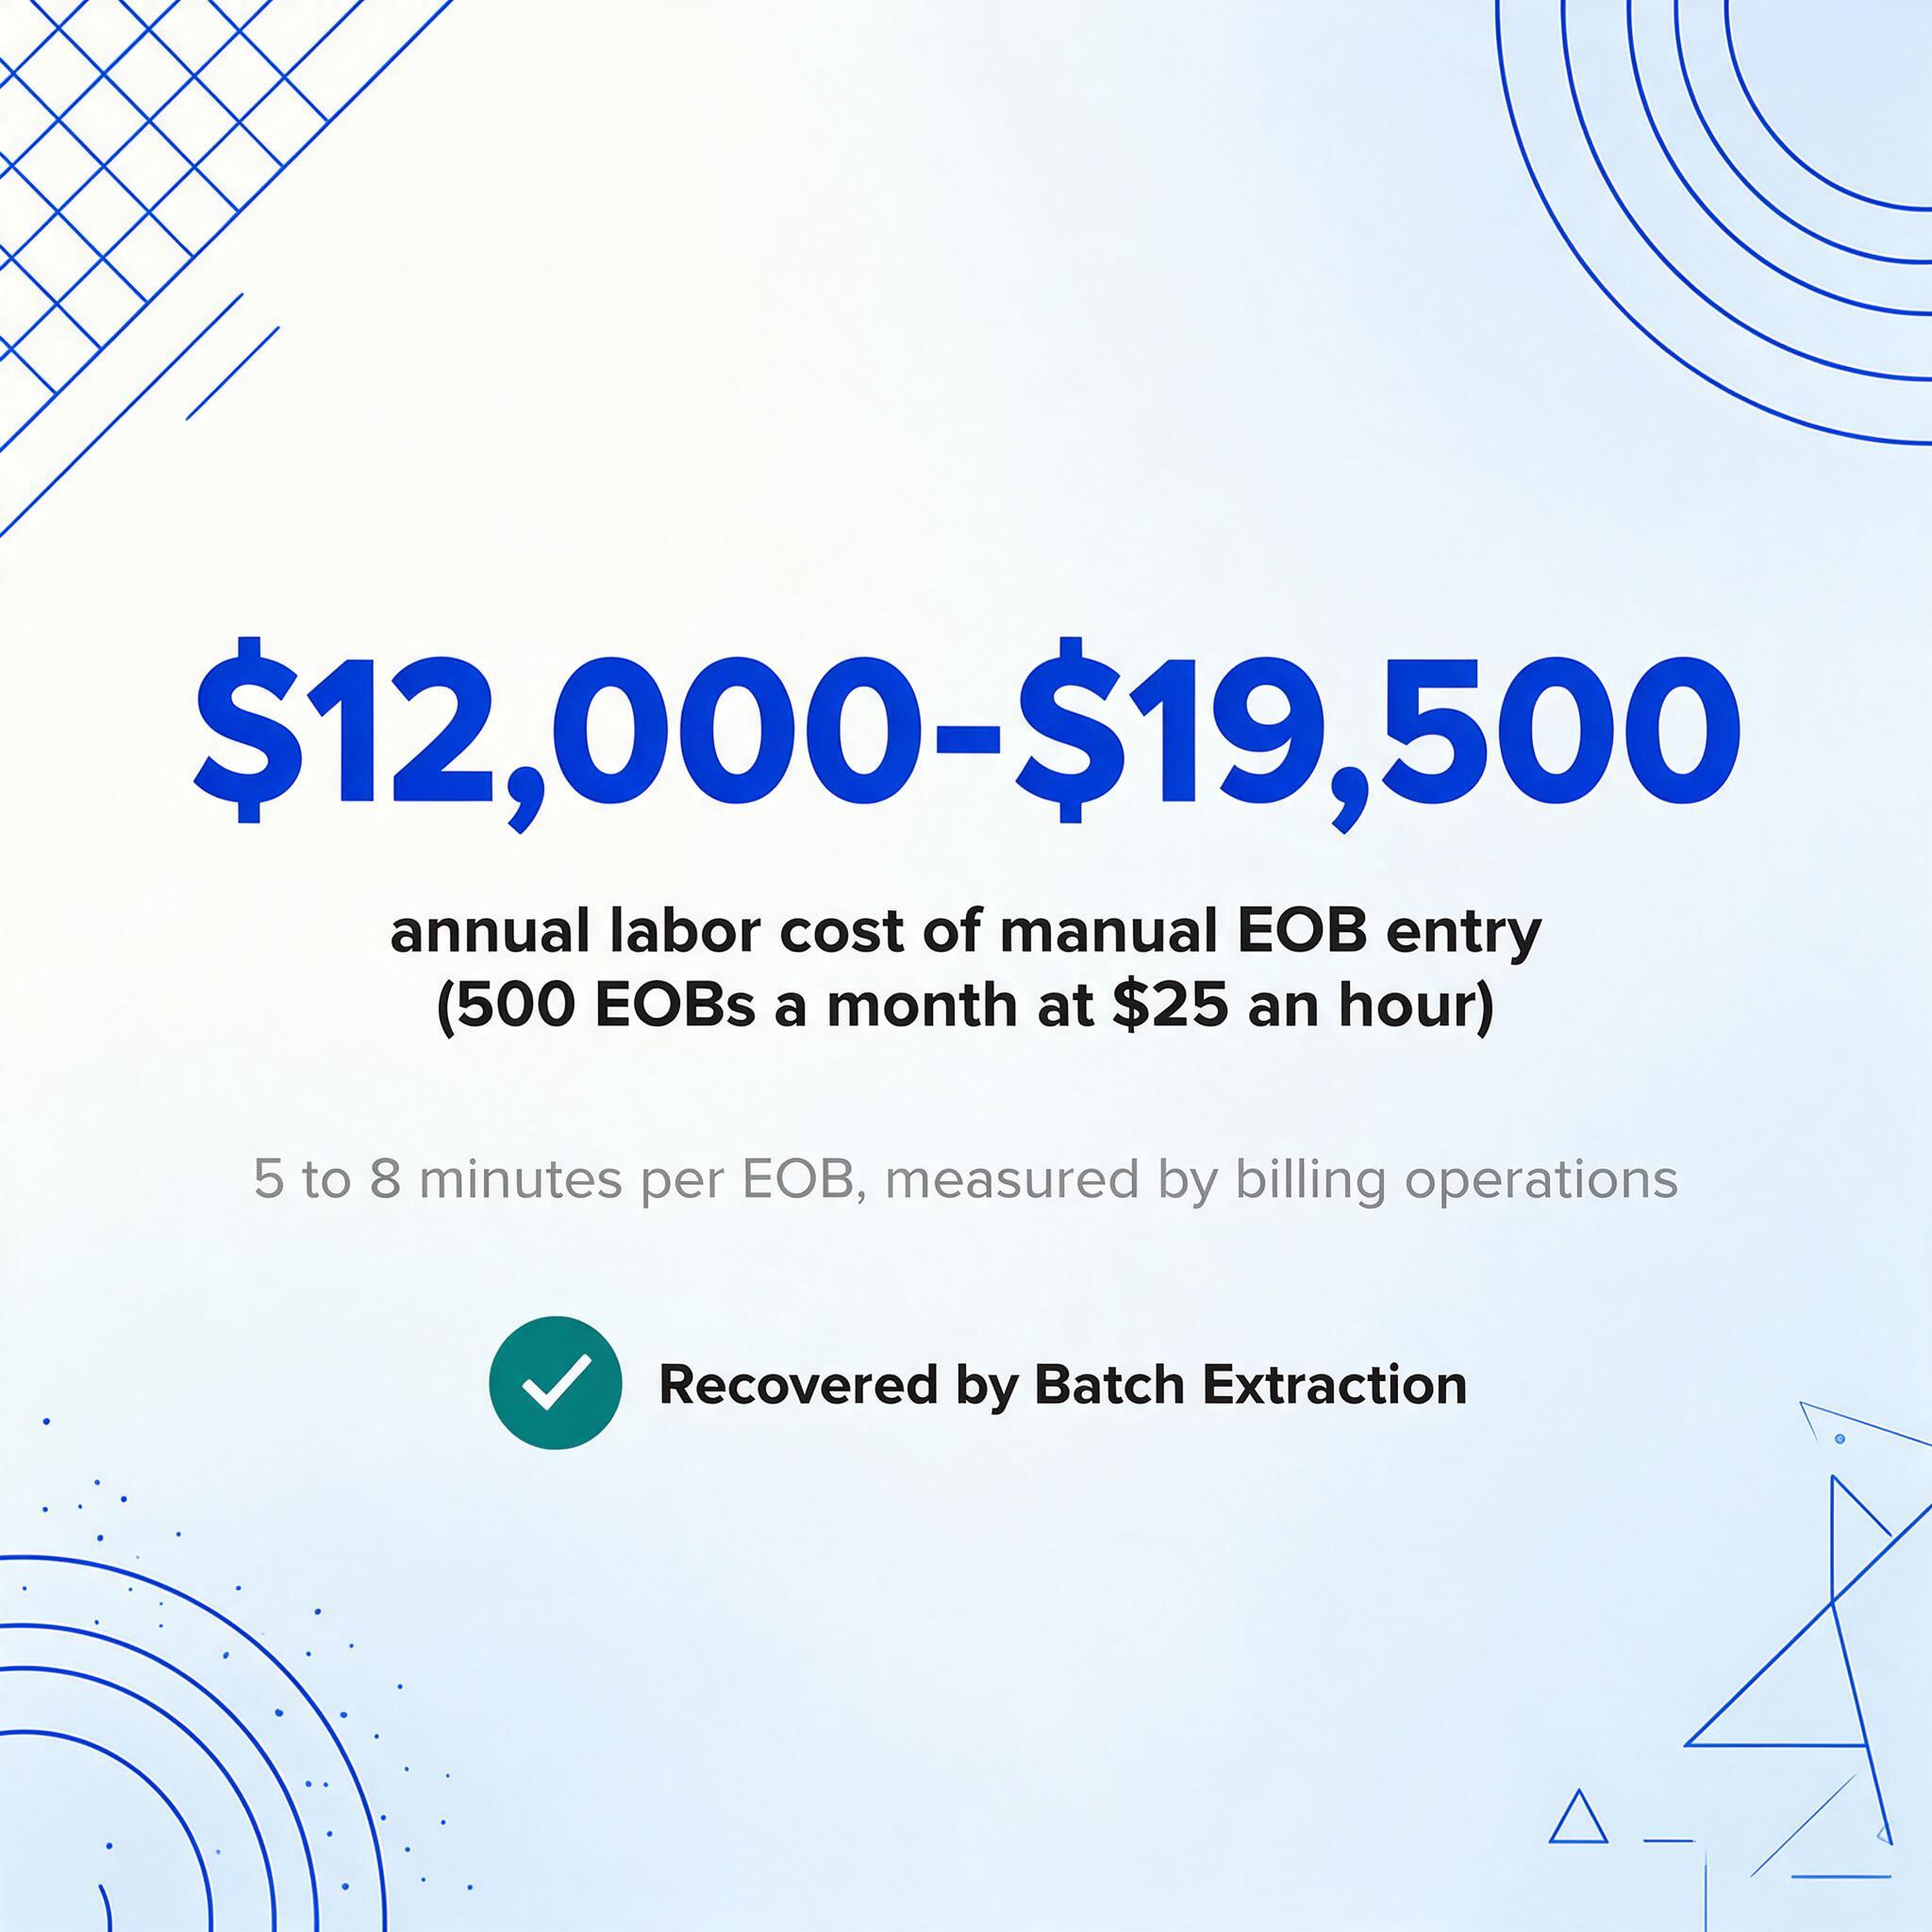
手動でのEOBデータ入力は、測定を行った請求業務のデータによると、1件あたり5〜8分かかります。月500件のEOB(中規模の診療所や小規模な請求会社では一般的な量)の場合、スタッフの労働時間は40〜65時間になります。請求スタッフの時給が25ドルだと、年間の人件費は約12,000〜19,500ドルとなり、これはEOBデータ入力だけの費用です。
この数字には、後続のコストは含まれていません。管理取引コストに関する業界の権威あるベンチマークであるCAQHインデックスによると、拒絶された請求1件の修正にかかるコストは、単純な修正で約25ドルです。臨床文書を必要とする複雑な異議申し立ては、100ドル以上かかる場合があります。そして拒絶率は上昇しています。2025年の全国平均は12.4%を超え、業界データによると10年ぶりの高水準です。MGMAの2023年DataDiveによると、単一専門診療所の初回提出時の拒絶率は8%で、2024年3月のMGMA世論調査では、医療グループの60%が前年比で拒絶の増加を報告しました。
EOBデータを手動で入力すると、誤入力されたCPTコード(米国医師会が管理する、請求書に医療サービスを記述するために使用される現行処置用語コード)、誤った調整額、または誤読されたCARCコード(請求が請求額と異なる支払いとなった理由を説明する標準化されたコードである請求調整理由コード)が、後続の照合作業を生み出します。CO-45調整(料金が料金表を超えている)を誤ってCO-97(別の支払いに含まれるサービス)として入力すると、請求チームは誤った解決経路に進んでしまいます。これらは理論上のエッジケースではなく、手動ワークフローでは日常的に発生することです。
医療品質向上協議会(CAQH)によると、医療費1ドルのうち24セントは管理費と請求コストに費やされています。業界は、手動取引を電子取引に変換することで、年間約94億ドルを節約できると推定されています。2025年のCAQHインデックスによると、米国の医療は2024年に電子取引を通じて2,580億ドルの管理コストを回避しました。つまり、PDF EOB処理のような手動のまま残っている収益サイクルの部分には、まだ改善の余地が大きくあるということです。
単一EOB抽出ツールがバッチワークフローで見落とすもの
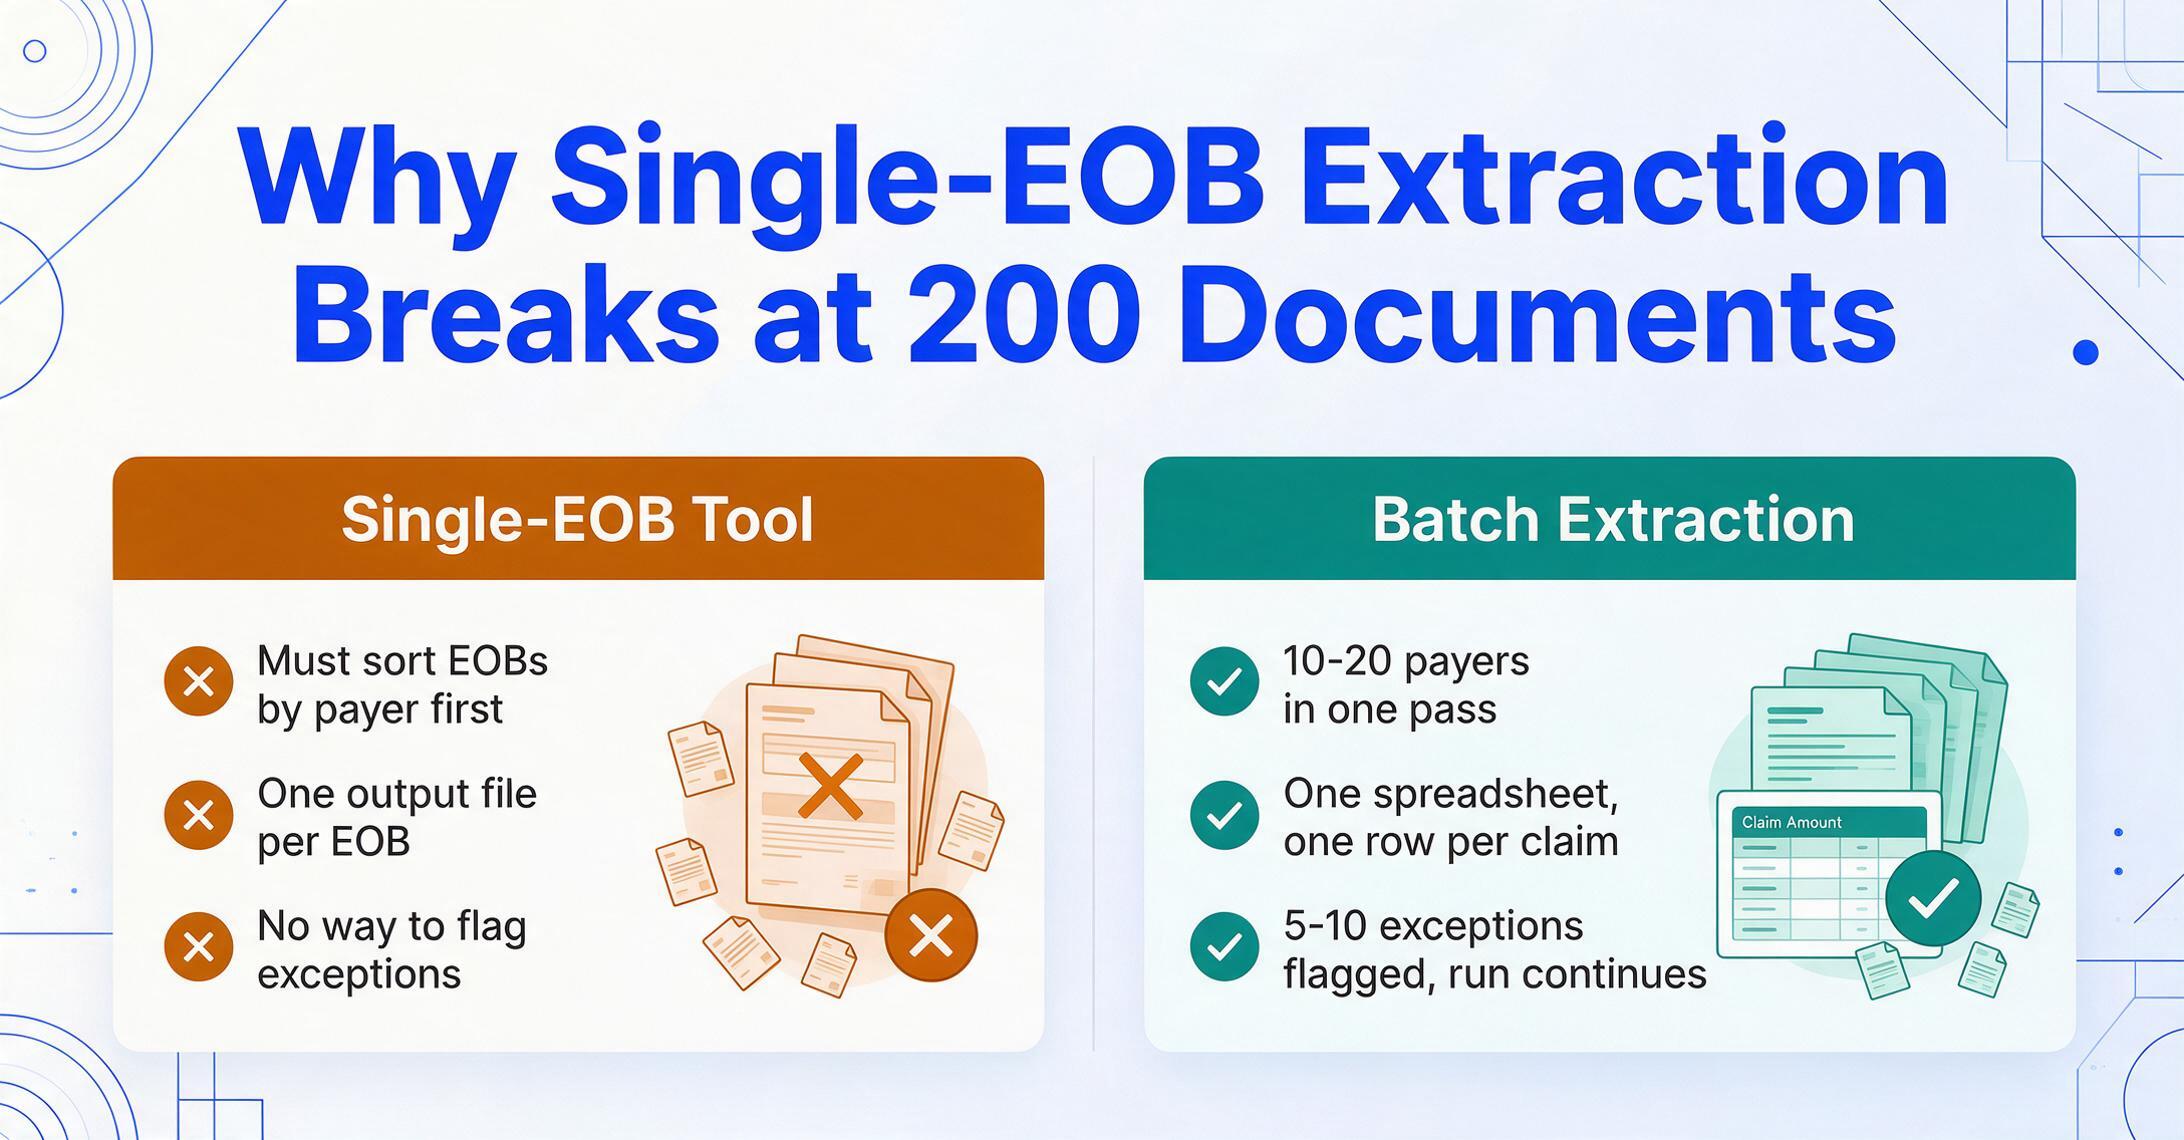
1件のEOBを処理することと、200件を一度に処理することは根本的に異なる問題です。単一EOBワークフロー(PDFを開き、データを抽出し、システムにコピーし、繰り返す)は、抽出精度とは無関係の理由で大量処理時に破綻します。
複数保険者の混在スタック。 200件のEOBバッチには通常、10〜20の異なる保険者からの文書が含まれます。メディケアのEOBは、特定の送金明細書形式でCARC/RARCコードのペアを使用します。UnitedHealthcareのEOBは、AetnaのEOBとは患者自己負担額の構成が異なります。バッチ抽出ツールは、ユーザーが保険者ごとにEOBを仕分けする必要なく、すべてを1回の処理で扱えなければなりません。アップロード前に仕分けが必要なら、手作業を上流に移しただけです。
出力の統合。 ツールがEOBを1件ずつ処理する場合、出力はEOBごとに1ファイルになります。バッチ抽出では、200件すべての結果が1つのスプレッドシートにまとまります。請求ごとに1行、すべての列が揃った状態です。これは、請求管理者が診療管理システムへの一括インポートや月末調整に必要な形式です。
例外処理。 200件のEOBバッチのうち5〜10件には何らかの異常があります。欄外の手書きの調整メモ、継続データを含む2ページのEOB、記録と完全一致しないが近似する患者名などです。バッチワークフローでは、処理全体を停止させることなく、これらの例外を人間のレビュー用にフラグ付けする必要があります。1件ずつの抽出をデフォルトとするツールには、この仕組みがありません。
ファイルソース。 請求チームは複数のチャネルからEOBを取得します。保険者ポータル(Availity、UnitedHealthcare Provider Portal、各保険会社のサイト)、メール添付のPDF、FAXコピー、スキャンした紙原本などです。バッチワークフローは、ソースごとに個別の前処理ステップを必要とせず、これらの任意の組み合わせを受け入れなければなりません。
EOBが実際に何であり、調整にどのフィールドが重要かをご存じない場合は、EOBデータ抽出の概要でフィールドレベルの内訳を、EOBデータ抽出の完全ガイドで選択基準とエクスポートオプションを最初から最後までご確認いただけます。また、このような複数保険者バッチワークフローに対応できるツールの比較については、医療文書抽出ツールの総合比較をご覧ください。7つのツールを40件の実在するEOB、請求書、患者文書でテストしています。
AIが保険者別テンプレートなしでEOBレイアウトを読み取る仕組み
保険者ごとのフォーマット差異に対応する技術的アプローチは、テンプレートベースの抽出とは根本的に異なります。テンプレートツールは固定座標を使用します。「支払い許容額はページのX、Yの位置にある」という方式です。保険者がレイアウトを変更すると、座標は無効になります。新しい保険者が最初のEOBを送信した場合、テンプレート自体が存在しません。
ビジョン言語モデルを使用したAIベースの抽出は、異なる動作をします。ページ座標を照合する代わりに、ドキュメントを意味的に読み取ります。各セクションが何を意味するかを理解し、単にどこに配置されているかではありません。必要な列を定義します。患者名、診療日、CPTコード、請求額、支払い許容額、自己負担額、共同保険、患者負担額、調整コード(CARC)、調整額、拒絶理由です。AIはドキュメントの構造を理解することで、ページ上のどこにでも各値を特定します。人間の請求担当者が慣れないEOBレイアウトを確認し、上部近くの患者名を見つけ、列ヘッダーをたどって支払い許容額を見つけるのと同じ方法です。
ImageToTable.aiがカラム名抽出と呼ぶこのアプローチは、必要なフィールド名を入力するだけで、各保険者がそれらのフィールドをどこに配置しても、AIが値をマッピングします。1つの設定で、UnitedHealthcareのEOBとAetnaのEOBを同じバッチで修正なしに処理できます。出力は統合されたスプレッドシートで、元のPDFを生成した保険者が誰であっても、すべての行に同じ列が含まれます。
ファイルは安全に処理され、保存されません。
これが、保険者ごとに20の抽出テンプレートを構築・維持する方法と、出力列を一度だけ定義する方法の違いです。15以上の保険者からEOBを処理する請求チームにとって、テンプレート方式の維持負担は一度きりのコストではありません。継続的な運用コストです。
バッチEOB抽出ワークフローのステップバイステップ
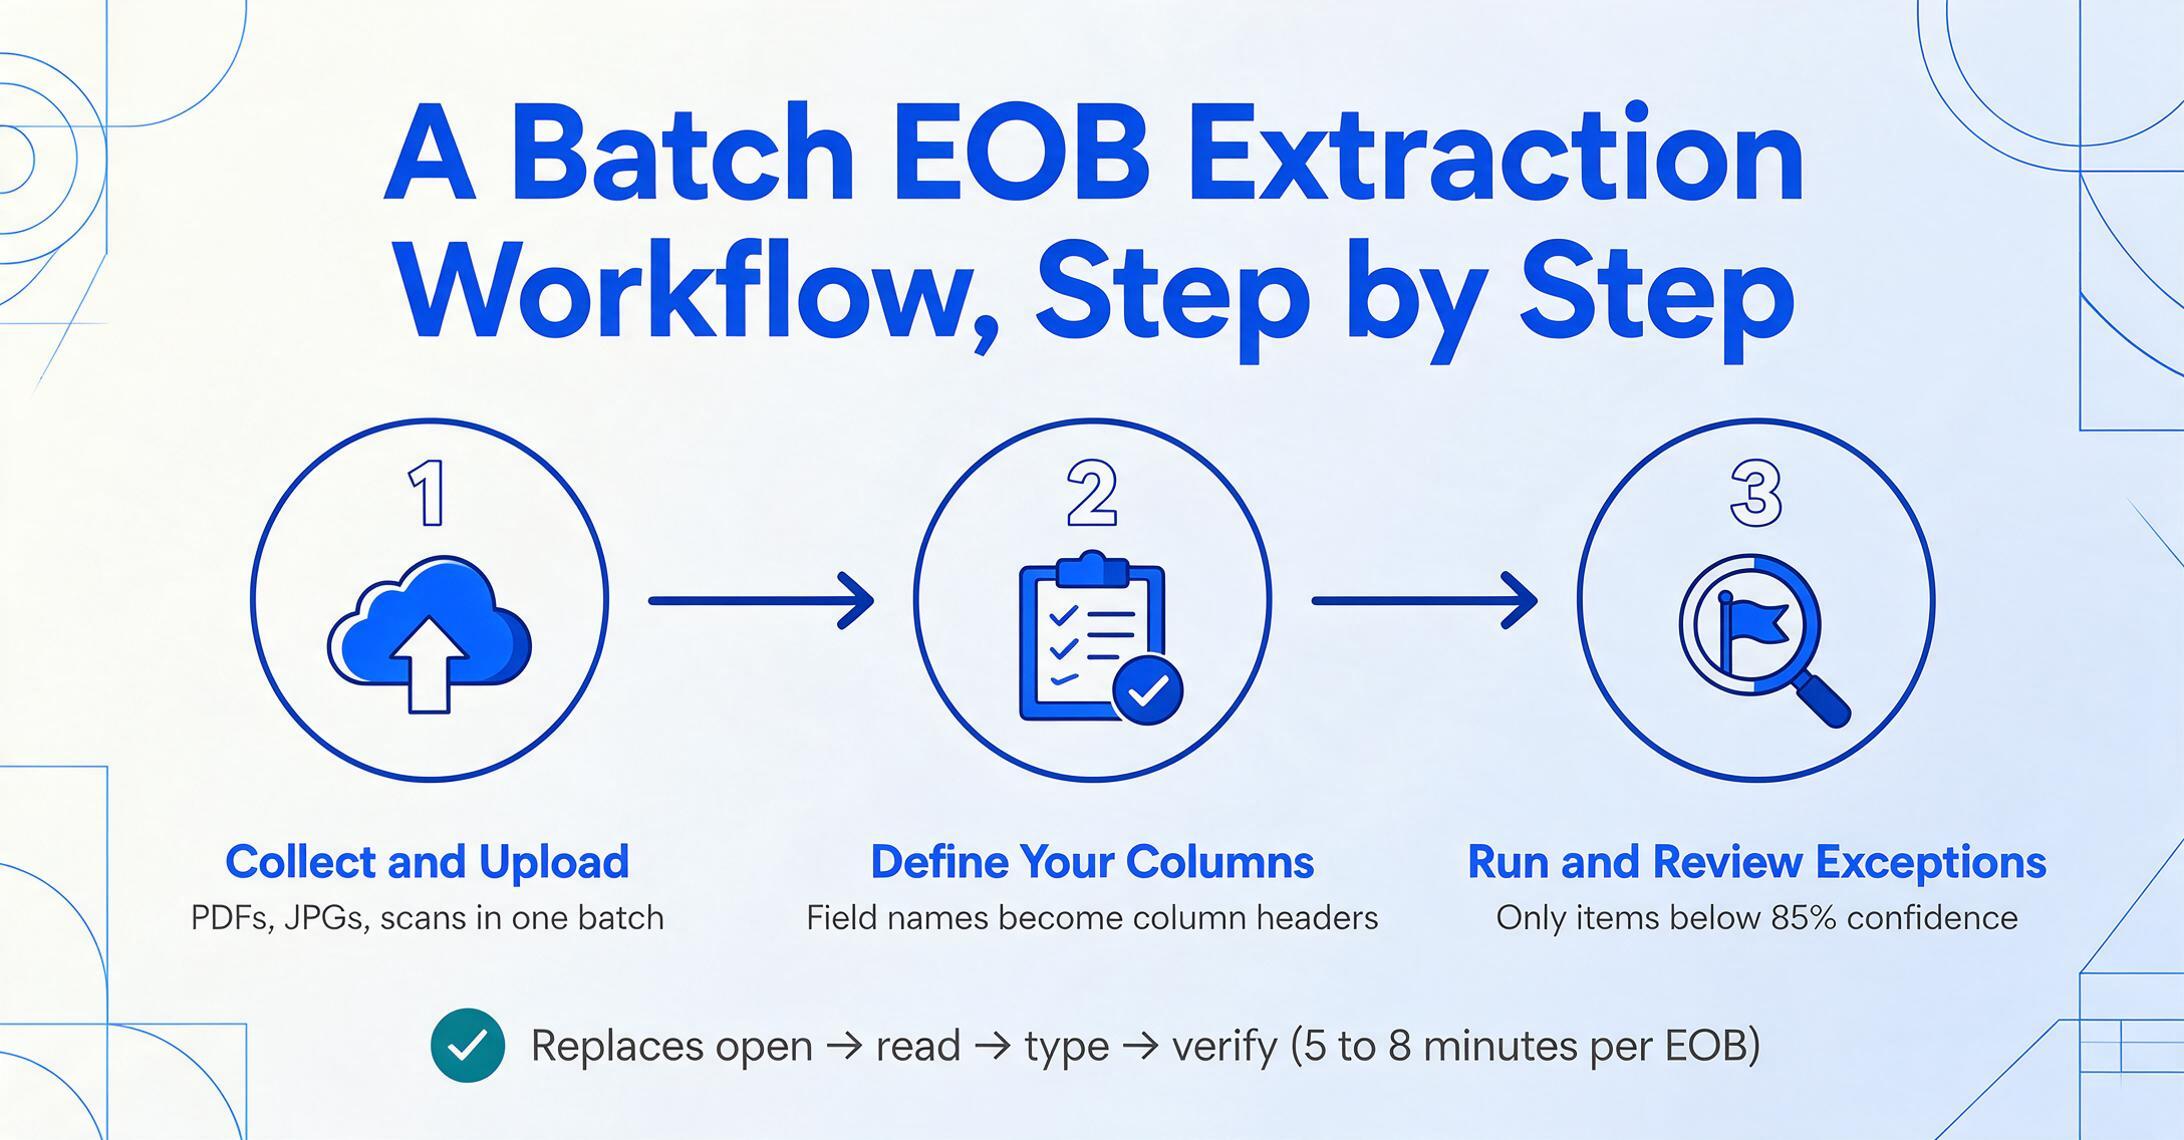
バッチEOB抽出ワークフローは、単一ドキュメントのワークフローと3つの段階で異なります:準備、処理、例外確認です。それぞれが実際にどのように機能するかを説明します。
収集とアップロード。
保険者ポータル、メール、スキャンした紙のコピーからEOBを1つのフォルダに集めます。バッチ全体をアップロードします—保険者ごとに仕分けたり、PDFとスキャン画像を分けたりする必要はありません。ImageToTable.aiは、1回のアップロードでPDF、JPG、PNGファイルに対応しています。
列を定義します。
必要なフィールド名を入力します:患者名、診療日、CPTコード、請求額、許可額、自己負担額(控除額)、共同保険、窓口負担金、患者負担額、支払額、調整コード、調整理由、小切手/EFT番号、小切手日付。これらが出力スプレッドシートの列ヘッダーになります。
実行と例外の確認。
AIがすべてのドキュメントを1回のパスで処理します。抽出された各値には信頼度スコアが付与されます。しきい値(例:85%未満)を設定して、人間による確認が必要な項目にフラグを立てます。請求担当スタッフは、フラグが立った項目のみを確認します—全体データの約5%程度—すべてのEOBのすべてのフィールドを検証する必要はありません。
この3ステップのワークフローは、1ドキュメントあたり5〜8分を要する「開く → 読む → 入力 → 確認」というEOBごとのサイクルを置き換えます。月500件のEOBの場合、約40時間のスタッフ時間が削減されます—その時間はデータ入力から拒絶分析、不服申立準備、保険者へのフォローアップへと移行します。このバッチワークフローをアップロードからスプレッドシート出力まで実際に体験するには、EOBをExcelに変換するガイドをご覧ください。
抽出データから請求システムへ:欠けているステップ
請求管理者が抽出デモを見た後に最もよく尋ねる質問は、「これをどうやって自分のシステムに取り込むのか」というものです。答えは使用中の診療管理システムによって異なりますが、パターンは一貫しています。バッチ抽出の出力(通常はExcelスプレッドシートまたはCSVファイル)は、請求プラットフォームのインポートインターフェースにマッピングされます。
Kareoは、登録済み保険者向けのERA自動転記と、非ERAのEOBに対する手動支払い入力に対応しています。バッチ抽出されたEOBデータは、支払い転記ワークフロー中に確認・入力するか、Kareoのバッチインポートツールを使用している場合はインポートできます。AdvancedMDは、抽出された支払いデータを請求と照合できるeRemittance確認画面を提供します。CollaborateMDは、請求をClaim Control Centerを通じてルーティングし、抽出された調整データは拒絶管理キューに送られます。
抽出時に定義する列は、請求システムが期待するフィールドと一致させる必要があります。システムが患者の口座番号を必要とする場合は、それを列として含めます。CARCおよびRARCコード(送金明細備考コード—CARCに追加のコンテキストを提供する補足コード、例:「N130:請求処理に追加書類が必要」)を追跡する場合は、それらを別の列として含めてください。抽出出力は、収益サイクルワークフローに直接取り込まれる構造化データセットになります。さらに一歩進めたいチーム向けに、ImageToTable.aiは推論列をサポートしています。「拒絶カテゴリ(オプション:コーディングエラー/資格/承認/医学的必要性/期限内提出/その他)」のような列を定義すると、AIがCARCコードと備考テキストに基づいて各拒絶を分類します—分類と抽出を1回のパスで実行します。
ここでバッチ抽出が複合的な価値を生み出します。単一EOBツールは1件の文書で5分を節約します。拒絶を分類し、請求インポートフィールドにマッピングするバッチツールは、EOBごとに5分を節約し、さらにスタッフが抽出後の仕分けと分類に費やすバッチあたり15〜20分を排除します。
バッチEOB処理とHIPAAコンプライアンス
EOBデータを扱うツールは、PHI(保護対象保健情報)を処理します。HIPAAコンプライアンスはベンダー評価の最後にチェックする項目ではなく、最初のフィルターです。バッチEOB抽出ツールの核となる要件は、転送中および保存時の暗号化、明示的に設定されない限りアップロードされた文書を永続保存しないこと、そして対象事業体が利用できるBAA(業務提携契約書)です。
ImageToTable.aiは抽出中にファイルを処理し、その後は保持しません。医療機関にとって、実際のワークフローへの影響は明確です。安全な環境からEOB PDFをアップロードし、データを抽出し、構造化された出力をダウンロードし、アップロードキューからソースファイルを削除します。データは抽出環境から出て、既存のコンプライアンス管理下で診療管理システムに入ります。
とはいえ、請求担当者は、抽出ツールの特定のコンプライアンス認証(SOC 2、HIPAA証明)を組織の要件に照らして確認する必要があります。どのツールもベンダー審査の義務を免除するものではなく、本記事はそのプロセスの代わりになるものではありません。
実務上のアドバイス: 抽出ツールでEOBをバッチ処理する前に、ベンダーがBAAを提供していることを確認し、データの取り扱いおよび保持ポリシーを検証し、まず匿名化されたサンプルEOBでテストして、ワークフローがコンプライアンス要件を満たしていることを確認してください。
よくある質問
バッチEOB抽出はERA(電子送金明細)ファイルを処理できますか?
ERAファイル(ASC X12 835形式)はすでに構造化されたデータであり、抽出は不要です。ERAファイルとPDFのEOBの両方を受け取る場合、バッチ抽出はEOB受入のPDF・紙部分を処理します。抽出されたデータはERA転記ワークフローに合わせてフォーマットできるため、ソース形式に関係なく、すべての支払いが同じ照合プロセスに統合されます。
バッチ抽出ではCPTコードやNPI番号の先頭のゼロは保持されますか?
はい。先頭のゼロの保持は出力段階での書式設定の問題です。ImageToTable.aiのカラム名抽出は、文書に表示されている元のデータをそのまま保持します。Excelにエクスポートする際に、CPTコード、NPI、口座番号の列にテキスト形式を指定することで、表計算ソフトが先頭のゼロを削除するのを防ぐことができます。
複数の保険者が混在するEOBバッチでは、どの程度の精度が期待できますか?
鮮明なEOB PDFの印刷テキストは、通常95〜99%のフィールドレベル精度で抽出されます。精度は、スキャンやFAXで劣化した文書、手書きの余白メモ、標準的なEOBレイアウトから大きく逸脱した特殊な保険者フォーマットでは低下します。バッチワークフローはこの現実を前提に設計されています。信頼度スコアリングが不確実な抽出を人間によるレビュー用にフラグ付けするため、請求システムに転記されるデータは100%、AIの信頼度またはスタッフの確認のいずれかによって検証済みです。
新しい保険者のEOBフォーマットのセットアップにはどのくらい時間がかかりますか?
カラム名抽出では、セットアップ時間はゼロです。UnitedHealthcareのEOB用に作成した列定義は、新しい保険者のフォーマットにもそのまま機能します。AIは保存されたテンプレートを照合するのではなく、文書を文脈に応じて読み取るためです。新しい保険者のEOBで標準的なデータ項目に馴染みのない用語が使われている場合(例:「Allowed Amount」の代わりに「Plan Paid」)、最初のバッチで列名の調整が必要になることがありますが、構築やトレーニングが必要なテンプレートはありません。
バッチ抽出はEOBの手書きメモを処理できますか?
部分的に対応可能です。AIベースの抽出は文書上の明確な手書き文字を読み取れますが、精度は印刷テキストより低くなります。保険者が拒絶理由を手書きで注記するEOBでよく見られる余白の手書き修正は、信頼度スコアリングシステムによって人間によるレビュー用にフラグ付けされる可能性が高いです。注記入りのEOBを多く受け取るチームでも、バッチ抽出は印刷データの90%で時間を節約し、手書きコンテンツはスタッフによる検証に振り分けます。
バッチに単一ページと複数ページのEOBが混在している場合はどうなりますか?
複数ページのEOBの各ページは、同じ文書の一部として処理されます。3ページのAetna EOBを3つの別々のファイルとしてアップロードした場合、出力には3つの行として表示されます。複数ページのEOBがファイルに分割されているバッチワークフローの場合は、アップロード前に各EOBを1つのPDFに結合するか、抽出定義にクレーム番号列を含めて、調整中に関連する行をグループ化できるようにすることをお勧めします。
ご自身のEOBでバッチ抽出をテストする
バッチEOB抽出の利点は、結局のところ精度の割合や業界のベンチマークではなく、請求チームが月曜日の朝にキューを開いたときに、PDFの山ではなく完成したスプレッドシートが表示されるという変化にあります。EOBあたり5〜8分というのは理論上の見積もりではなく、請求管理者が通常のバッチで自社スタッフの時間を計測して検証できる数字です。問題は、その回復した時間が何を可能にするかです。より多くの拒絶への上訴、より迅速な患者請求、A/R(売掛金)の日数の短縮、または単に水曜日ではなく金曜日までに支払い転記を完了するチームです。
ご自身のEOBのバッチでテストしてください。請求システムに必要な列を定義してください。アップロードから構造化スプレッドシートまでのワークフローが月次サイクルに適合するかどうかを確認してください。カラム名抽出が特定の保険者の組み合わせを処理できるかどうかを評価する唯一の方法は、実際の文書で実行することです。