OCRが小数点や通貨記号を見落とすのはなぜ?
5つの失敗パターンとその修正方法
ドキュメントには明らかに「$156.00」と書かれているのに、抽出結果は「15600」と読み取られました。小数点は消え、通貨記号も消え、スプレッドシートには$156の経費ではなく$15,600の誤差が記録されています。こうした小さな記号がなぜ最初に壊れるのか、そして各失敗パターンにどう対処するかを解説します。
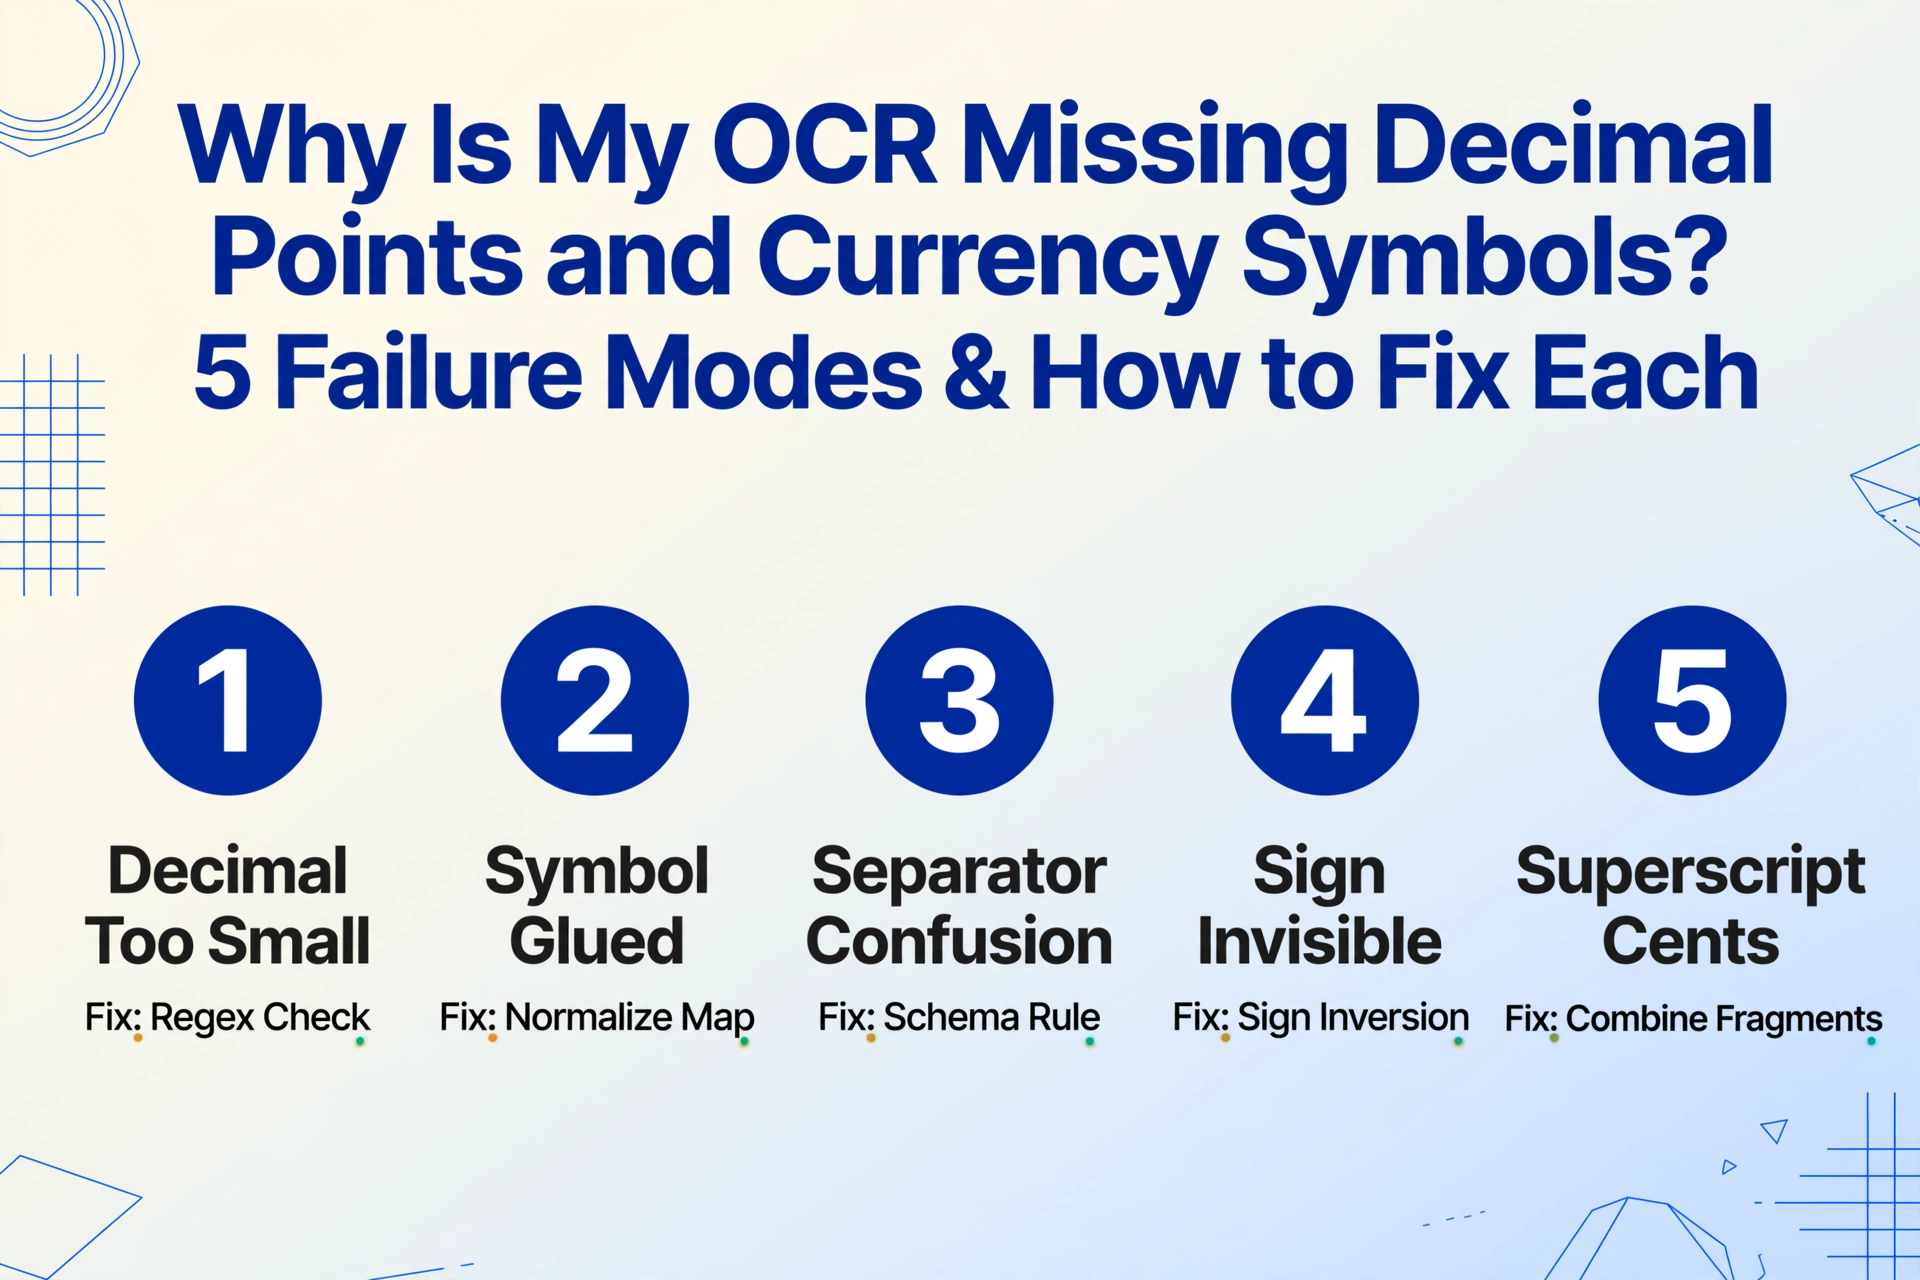
主なポイント
- 警告もなく、抽出結果が請求書を100倍にしてしまいました。$156.00が15600になり、取引先名、日付、明細行はすべて正確に読み取られています。最も重要な数値だけが誤っているのです。
- 低DPIでは小数点がゴミとして除去され(幅2ピクセル)、通貨記号は最初の数字に接触すると埋もれ、ヨーロッパ式のカンマは小数点の位置を反転させ、クレジットメモの括弧は破棄され、上付き文字のセントは別のテキスト行に消えてしまいます。これらはランダムなソフトウェアのバグに見える5つの物理的な問題です。
- 抽出されたすべての合計を明細行の合計と比較する検証ルールを1つ設けるだけで、100倍の誤りが総勘定元帳に届く前に検出できます。新しいツールも前処理も不要で、抽出のたびに実行されるチェックだけです。
小数点が1つ欠けるだけでも、小さな誤りではありません。10倍の誤りです。そして厄介なのは、抽出結果のそれ以外はきれいに見えることです。ベンダー名、日付、明細行はすべて正しく取得されています。最も重要な数値 — 合計、税額、単価 — だけが、気づかないうちに1~2桁ずれているのです。その影響は抽象的なものではありません。$156ではなく$15,600の支払いが計上されると、資金が拘束され、照合作業が発生し、自動処理への信頼が損なわれます。
ドキュメント処理研究から得られる核心的な知見は一貫しています。小さな記号 — 小数点、通貨記号、マイナス記号 — は、OCRエンジンの解像度しきい値の限界で機能するため、より大きな文字が失敗する前に失敗するのです。 これらはランダムなエラーではありません。それぞれに既知の根本原因がある、予測可能な失敗モードに従います。どのモードに対処しているのかを特定できるかどうかが、簡単な正規表現の修正で済むか、ERPにまで気づかれずに到達するデータ災害になるかの分かれ目です。
本記事では、小数点と通貨記号の欠落に関する5つの異なる失敗モードを扱います。それぞれに固有の診断シグネチャと固有の修正方法があります。テキストがはっきり読めるのに抽出ツールが誤った数値を返す理由の全体像については、誤った抽出数値を引き起こすフィールド設計の誤りに関する姉妹記事をご覧ください。あちらの記事は曖昧な列名に焦点を当てており、本記事は記号レベルの失敗に焦点を当てています。
失敗モード1:小数点が小さすぎてエンジンが認識できない
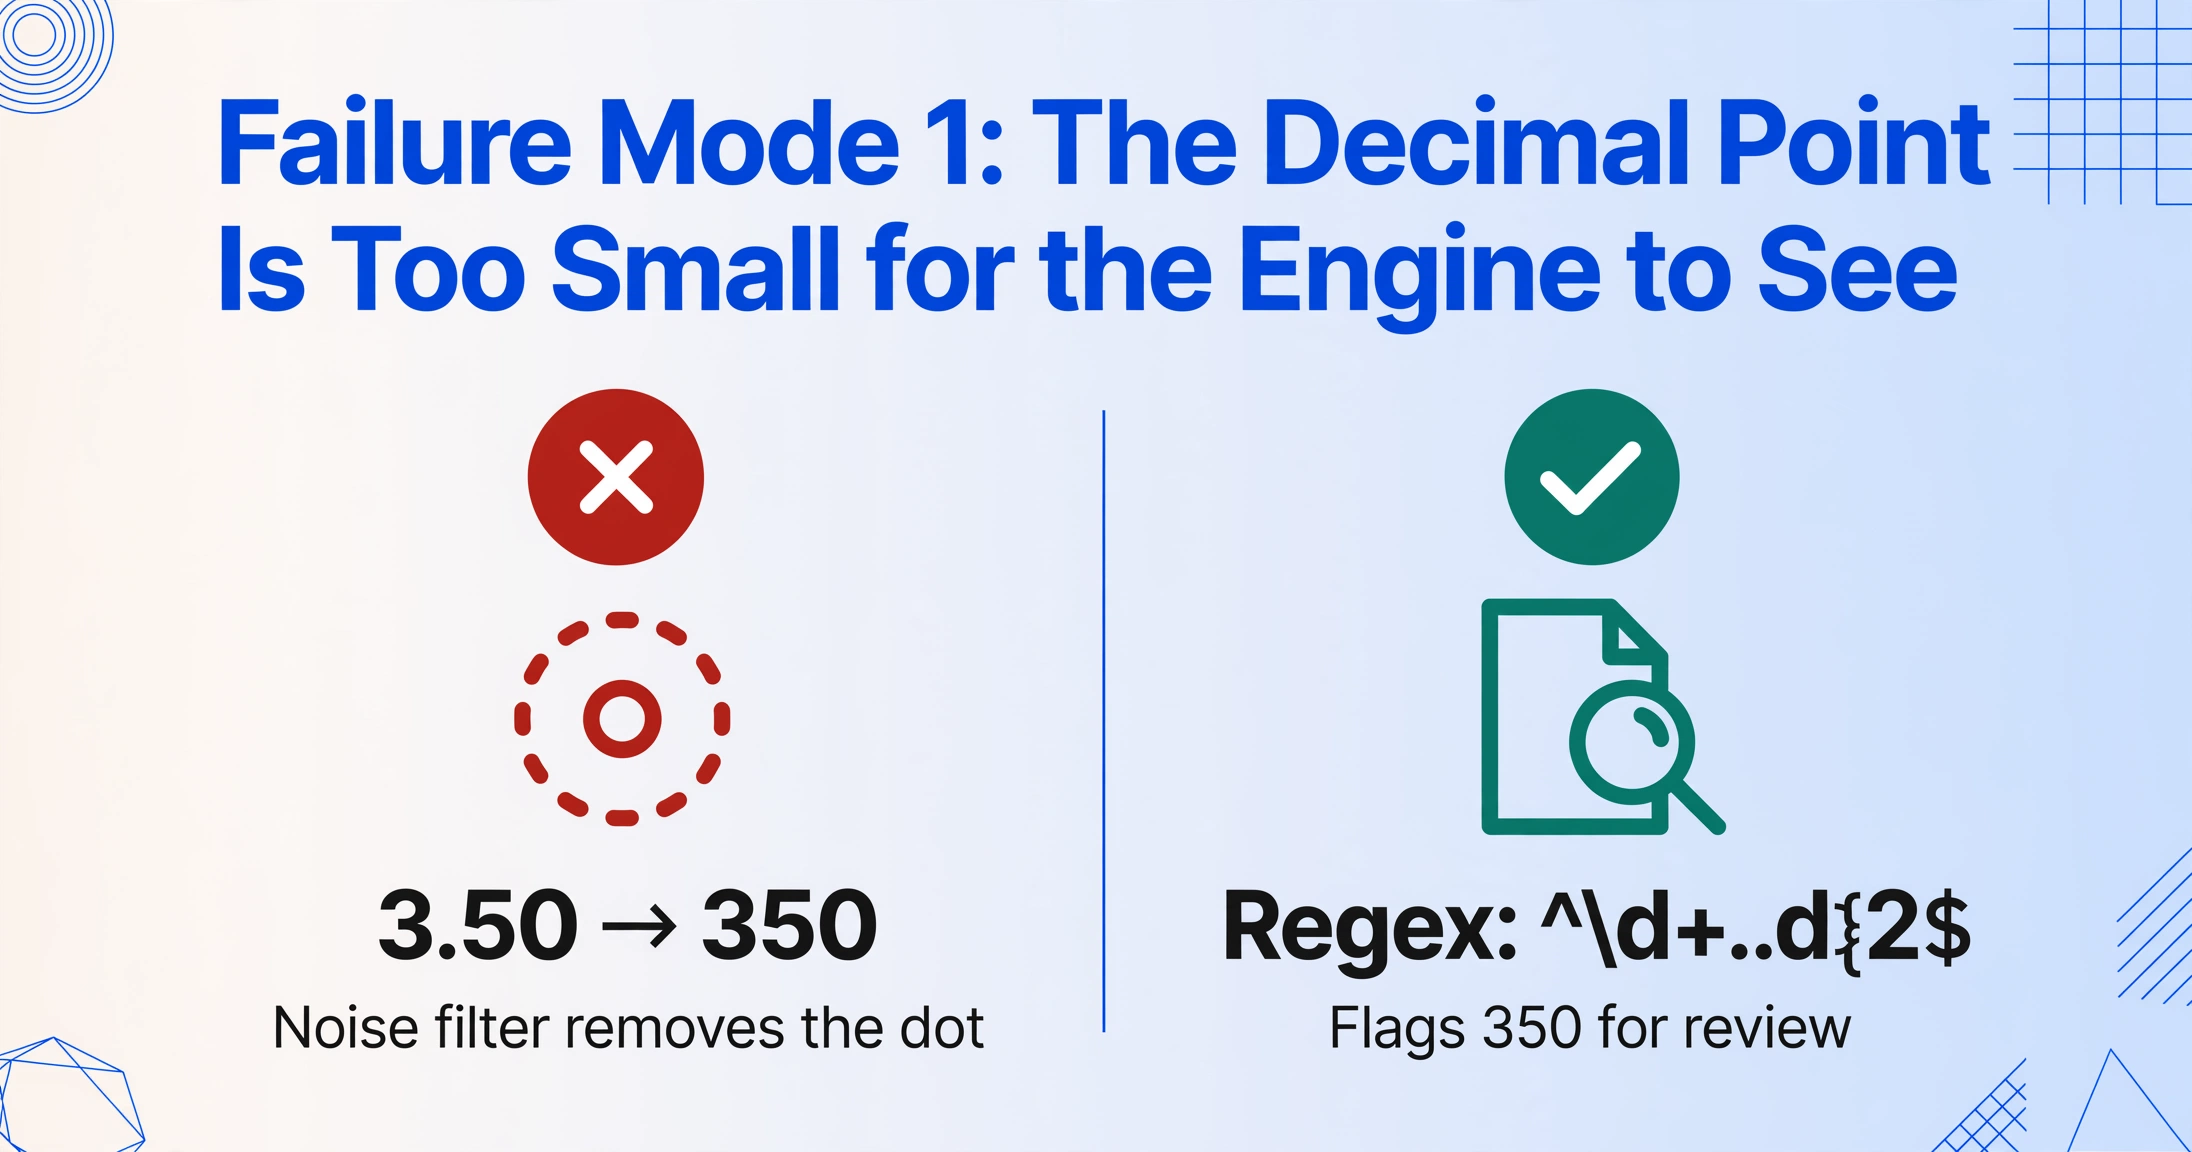
症状:「3.50」が「350」または「3 50」として抽出されます。「19.99」は「1999」になります。数字自体は完全に判読可能で、単に小数点が存在しないだけです。欠落した小数点は、スプレッドシート内のすべての数値を2桁ずらします。
なぜ起こるのか:従来のOCRエンジンは、文字を読み取る前にノイズフィルター、コントラスト調整、二値化を適用して画像を前処理します。サーマルレシート、低DPIスキャン、FAX文書でよく見られる高さ8~10ピクセルの小数点は、こうした前処理ステップのノイズフロアを下回ります。エンジンのフィルターは、2つの数字の間にある小さな斑点を、ほこり、紙の繊維、または圧縮アーティファクトとして分類します。72 DPIでは、小数点の幅はおよそ2~3ピクセルです。そのサイズでは、どの二値化アルゴリズムにとっても、ほこりの粒子と視覚的に区別できません。
これは認識の失敗ではなく、前処理の失敗です。小数点は、エンジンがそれを見る前に除去されたため、認識段階に到達しません。
修正方法:最も信頼できる修正は、OCRエンジンの前処理を変えようとするのではなく、抽出後の検証です。抽出されたすべての金額を期待されるパターンに対して検証する、フィールドレベルの正規表現チェックを実装します:
# Check: does this value have exactly two decimal places?
pattern = r'^\d+\.\d{2}$'
if not re.match(pattern, extracted_value):
flag_for_review(extracted_value)正規表現だけでなく、抽出された値を想定される桁数と比較してください。請求書の合計が通常$50~$5,000の範囲にあるのに、抽出結果が$500,000を返した場合、サニティチェックによって会計システムに届く前にエラーを検出できます。ImageToTable.aiを含む多くの抽出ツールでは、抽出時に金額を標準化する出力フォーマットルールを定義できます。小数点の位置は、生のOCR出力が保持すべきものではなく、出力スキーマの一部となります。
小数点が物理的に6ピクセル未満となる極めて低解像度のスキャンでは、後処理による修正は完全には信頼できません。正直なところ、元の画像に正確な抽出に必要な情報が含まれていないのです。そのような場合は、300 DPI以上で再スキャンすることが唯一の恒久的な解決策です。
失敗モード2:最初の数字に密着した通貨記号が欠落する
症状:「$156.00」が「156.00」(記号が欠落)として抽出されるか、さらに悪い場合は「$15600」(記号と数字が1つのトークンに統合され、統合の過程で小数点が失われる)として抽出されます。通貨のコンテキストが失われ、下流のシステムはUSD金額を単位のない数値として扱います。
発生する理由:通貨記号($、€、£、¥、R$)は数字とは活字的に異なります。多くの場合、異なる書体や太さで組まれ、数字と同じベースライン上にありながら視覚的なプロファイルが異なります。OCRエンジンが行をトークン化する際、「$」が数値の一部なのか別の要素なのかを判断する必要があります。近接性ベースのトークナイザーは記号を先頭の数字と統合しがちで、「$156」のような単一トークンを生成します。するとエンジンは、内部の文字分類器が後続の数字よりも「$」記号に対して低い信頼度しか持たないため、これを誤読します。エンジンはこの混乱を、信頼度の低い文字(通貨記号)を破棄し、信頼度の高い数字を保持することで解決します。
一部のビジョンベースの抽出エンジンは、文字単位でトークン化するのではなく視覚的なコンテキスト全体を処理するため、従来のOCRよりもこれをうまく処理できます。しかし、最新のモデルでも、通貨記号と最初の数字が狭いバウンディングボックスを共有している場合や、記号が珍しい書体(一部のレシートプリンターの丸まった「$」など)で表示される場合は、苦戦することがあります。
修正方法:抽出後のステップとして通貨記号の正規化マップを実装します。金額フィールドの想定出力形式(例:「USD 156.00」や「$156.00」)を定義し、抽出された値をその形式に正規化します:
# Known currency symbols by document context
currency_map = {
    'USD': r'[\$]',
    'EUR': r'[€]',
    'GBP': r'[£]',
    'JPY': r'[¥]'
}
# If the extracted value has digits but no symbol,
# assign the expected currency from document metadata
if re.match(r'^\d+\.\d{2}$', value) and not has_currency_prefix(value):
    normalized = f"{doc_currency} {value}"
重要なのは、記号が属するかどうかをOCRに判断させるのではなく、抽出スキーマのレベルで定義し、それに対して検証することです。
失敗モード3:桁区切り記号の混同で小数点が逆転する
症状:「1,234.56」と記載された米国の請求書が「1.23456」または「1234.56」(カンマが欠落)として抽出されます。「1.234,56」と記載された欧州のドキュメントは「1.23456」または「1234.56」として抽出され、ピリオドが小数点として扱われることで値が1,000倍に膨らみます。同じ句読点がロケールによって正反対の意味を持ち、OCRエンジンはどちらのルールを適用すべきかを判断できません。
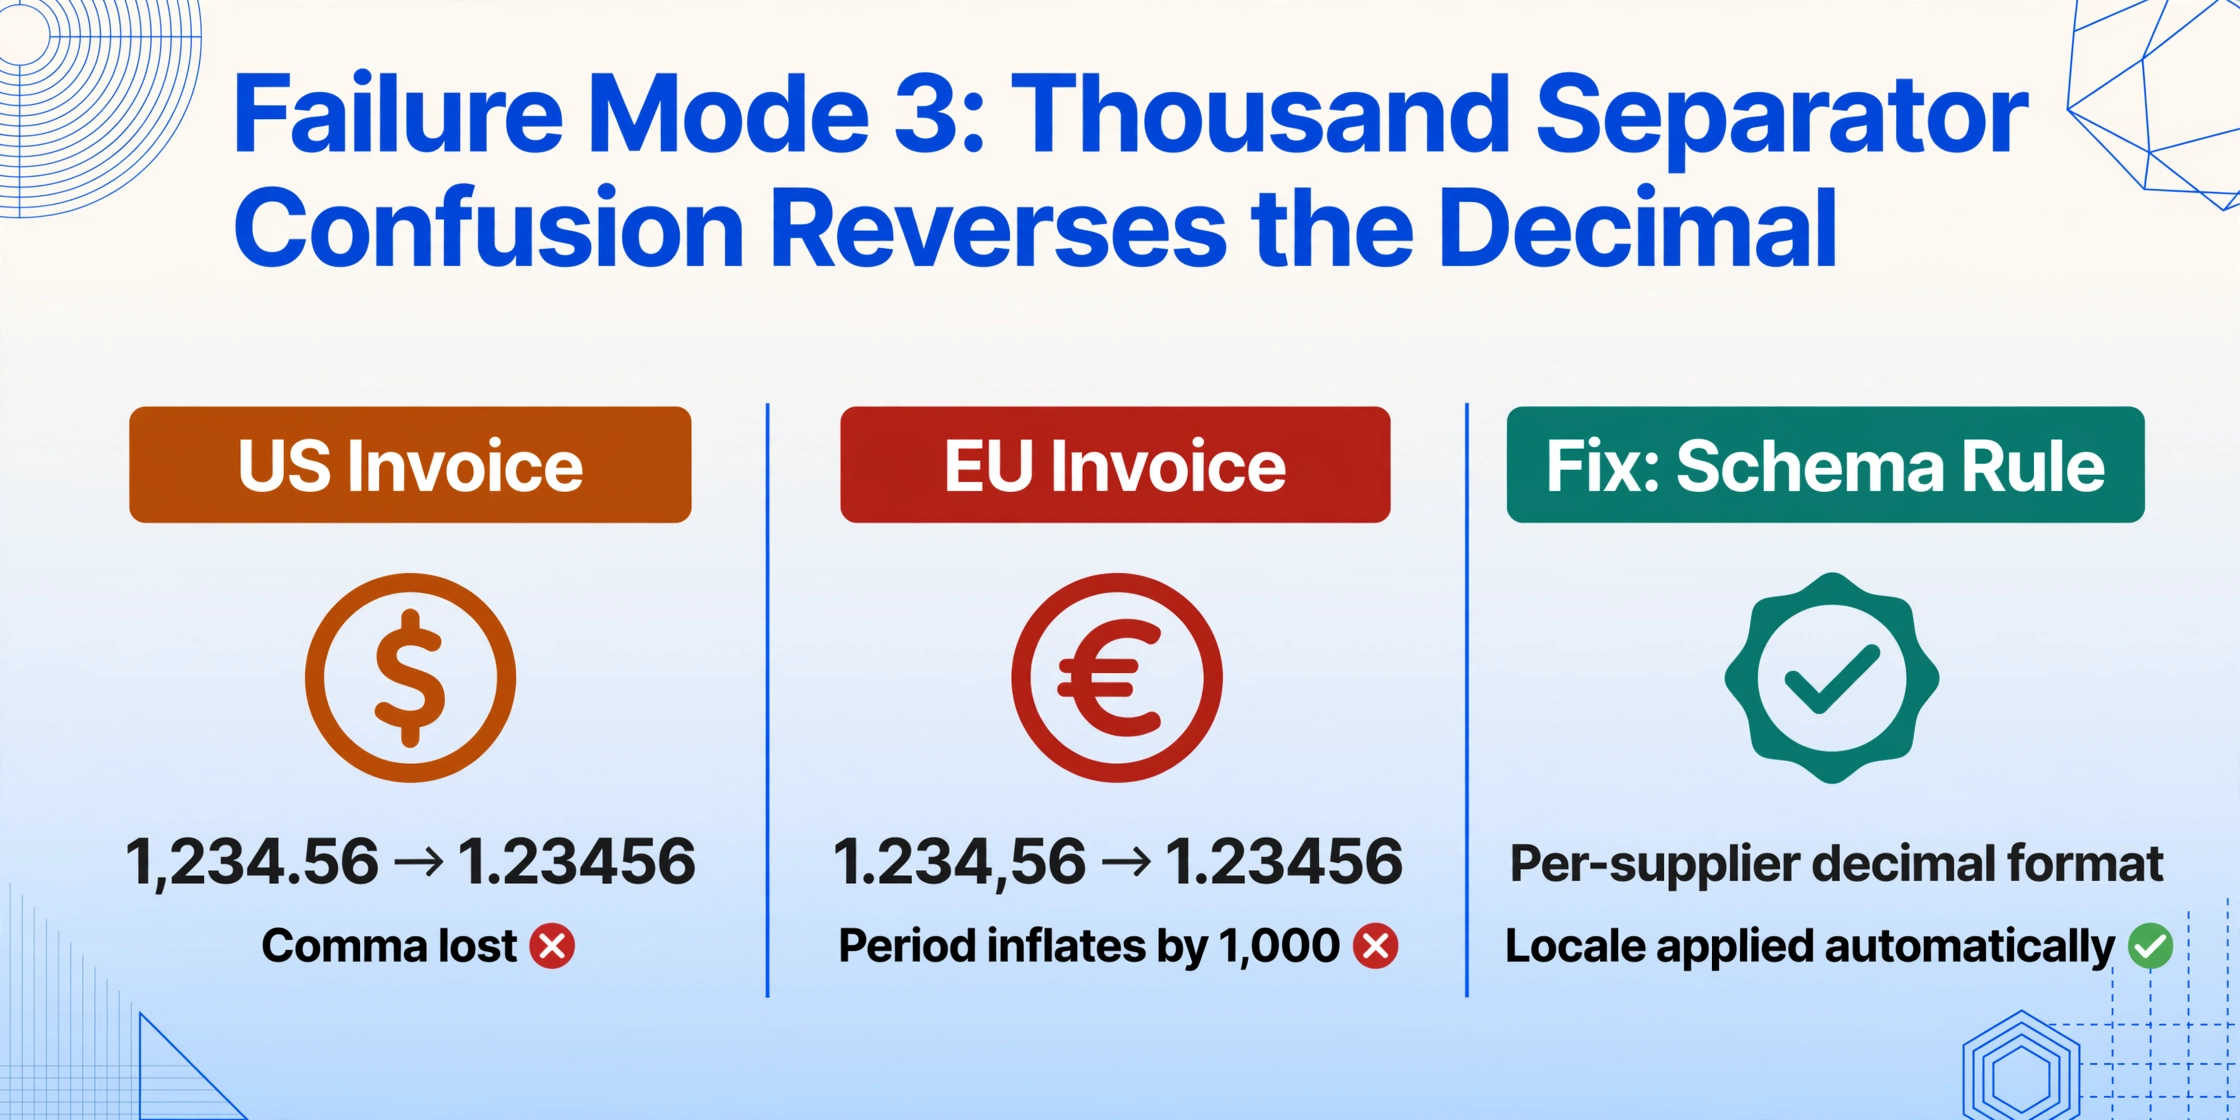
発生する理由:OCRエンジンは句読点を数学的な記法ではなく文字として扱います。ピリオドとカンマは視覚的特徴が既知の別個の文字ですが、エンジンはドキュメントのロケールにおいてどちらが小数点区切り記号であるかを本来的には認識していません。これは単一のエンジンの限界ではなく、Tesseractから商用クラウドAPIまで、あらゆる主要なOCRツールが句読点を同じように処理します。つまり、見えたままを出力し、その句読点の解釈は後段のロジックに委ねられます。その結果、同じ抽出パイプラインが米国の請求書では$1,234.56を、ドイツの請求書では1,234.56€を生成することがあり、後段のシステムがどちらの慣習を想定すべきかを知らなければ、どちらも誤って解析されます。
この問題は、複数の国の請求書を処理する場合にさらに深刻化します。米国、ドイツ、フランスのサプライヤーからの50件の請求書を1つのバッチで処理すると、3種類の異なる小数点の慣習が含まれることがあります。抽出エンジンは、どのドキュメントにどの慣習が適用されるかを自動的に検出しません。
修正方法:2つのアプローチがあります。1つ目はスキーマレベルです。抽出を実行する前に、サプライヤーごとまたはドキュメントタイプごとに想定される小数点形式を定義します。ドイツのサプライヤーからの請求書がカンマを小数点として使用していると分かっていれば、そのドキュメントグループに対してカンマを小数点区切り記号、ピリオドを桁区切り記号として解釈する解析ルールを設定します。
2つ目のアプローチは桁数(マグニチュード)の検証です。これは多言語抽出の精度低下に関する記事で詳しく説明している手法で、ドキュメントソース間の形式のばらつきが連鎖的なエラーを引き起こす仕組みを扱っています。実践的には、抽出された合計が明細項目の合計に対して妥当な範囲内にあるかを確認します。明細項目の合計が$12,345.67であるのに合計が$1,234,567.89になっていれば、小数点と桁区切り記号の逆転が明らかです。
# Validate: does the total match the sum of line items
# within a reasonable tolerance?
line_sum = sum(line_items)
total = extracted_total
# If total is ~1000x line_sum, decimal was read as thousand separator
if abs(total - line_sum) / max(line_sum, 1) > 100:
    flag_decimal_ambiguity(extracted_total)
失敗モード4:負の符号と括弧 — 見えない指標
症状:「(156.00)」と表示されたクレジットメモが、負の符号なしの「156.00」として抽出されます。銀行明細の残高「1,247.30-」が「1,247.30」として抽出され、末尾のマイナスが失われます。数値自体は正しいものの符号が誤っているため、クレジットがデビットに、返金が請求に変わってしまいます。
発生する理由:OCRエンジンは括弧を独立した句読点文字として扱います。負の値を表す標準的な会計表記である括弧で数値が囲まれている場合、開き括弧は最初の数字の前の別個の文字として、閉じ括弧は最後の数字の後の別個の文字として読み取られます。データ抽出時、これらの括弧は数値フィールドに期待される文字クラスに一致しないため、しばしば破棄されます。末尾のマイナス記号も同様です。数字の後に位置するため数値トークンの範囲外となり、抽出ロジックが数値と関連付けない別個のテキスト断片として分類されます。
解決方法:フィールド単位の符号検出ルールを定義します。抽出された値がクレジット、割引、負の調整を通常含むフィールドに現れる場合、または元のドキュメントで金額が括弧で囲まれている場合は、抽出後に符号反転を適用します。これとフィールド命名規則を組み合わせます。「Credit Amount」や「Discount」という名前の列は絶対値を想定し、OCRが何を返したかに関わらず自動的に負の符号を適用するようにします。
# If the document context indicates a negative-magnitude field
# and the extracted value is positive, invert the sign
negative_context_fields = ['credit_memo', 'discount', 'refund', 'adjustment']
if field_name in negative_context_fields and extracted_value > 0:
    extracted_value = -extracted_value
失敗モード5:上付き文字と下付き文字 — 行間に消えるセント
症状:「$9999」(99.99ドルを意味し、セントが上付き文字)と表示された価格タグが「$99」または「$9900」として抽出されます。小計の隣に小さな上付き文字で印刷された税額は完全に欠落します。基本の数値は正しくても、正確な金額を定義する小数部分が消えてしまいます。
発生する理由:上付き文字は主要な数値と同じ水平領域を共有しますが、ベースラインより上に、主要な数字のポイントサイズの通常40~60%という小さなサイズで配置されます。OCRエンジンは、垂直位置が主要なベースラインから外れているため、これらを別のテキスト行または断片として検出します。テキスト抽出では、この断片は別の出力行に割り当てられるか、レイアウト分析中に外れ値として破棄されます。小売価格タグや一部の請求書明細で一般的なセント表記が、最も頻繁に犠牲になります。
下付き文字の値は、金銭的な文脈ではあまり一般的ではありませんが、税率や参照コードでは頻繁に見られ、逆方向に同じ問題に直面します。ベースラインより下の文字は独立したテキスト領域として分割され、主要な数値との関連性を失います。
修正方法:最も実用的なアプローチは、狭い垂直範囲内で同じ水平位置を共有するすべてのテキスト断片を結合し、結合された値を想定される金額パターンに対して検証することです。主要な数値「99」の後に同じ列領域に上付き文字の「99」が続く場合、組み合わせ「99.99」は有効な金額です。これを空間マージルールとして実装します。主要な数値のX座標範囲の150%以内、かつ定義された垂直オフセット以内にあるテキスト断片は、抽出されたフィールド値にマージする必要があります。
# Merge fragments in the same horizontal region
# within a tight vertical band
def merge_superscript(main_number, fragments, y_threshold=15):
    """Combine main digit cluster with nearby fragments."""
    combined = main_number
    for frag in fragments:
        if abs(frag.y - main_y) < y_threshold and \
           abs(frag.x - main_x) < main_width * 0.5:
            combined += frag.text
    # Validate after merge
    if re.match(r'^\d+\.\d{2}$', combined):
        return combined
    return main_number  # fall back to original if merge is invalid
エスカレーションすべきケース:自動修正の正直な限界
上記の5つの修正で、小数点と通貨記号の失敗の大半はカバーできます。しかし、後処理ルールでは正しい値を確実に復元できないドキュメントのカテゴリがあります。小数点が、キャプチャ方法が再現できる最小解像度よりも物理的に小さいドキュメントです。72 DPIのサーマルレシート上の小数点は約2ピクセル幅です。このサイズでは、その情報は画像内に文字通り存在せず、従来のOCRであれビジョンAIであれ、どのエンジンも確実に読み取れません。
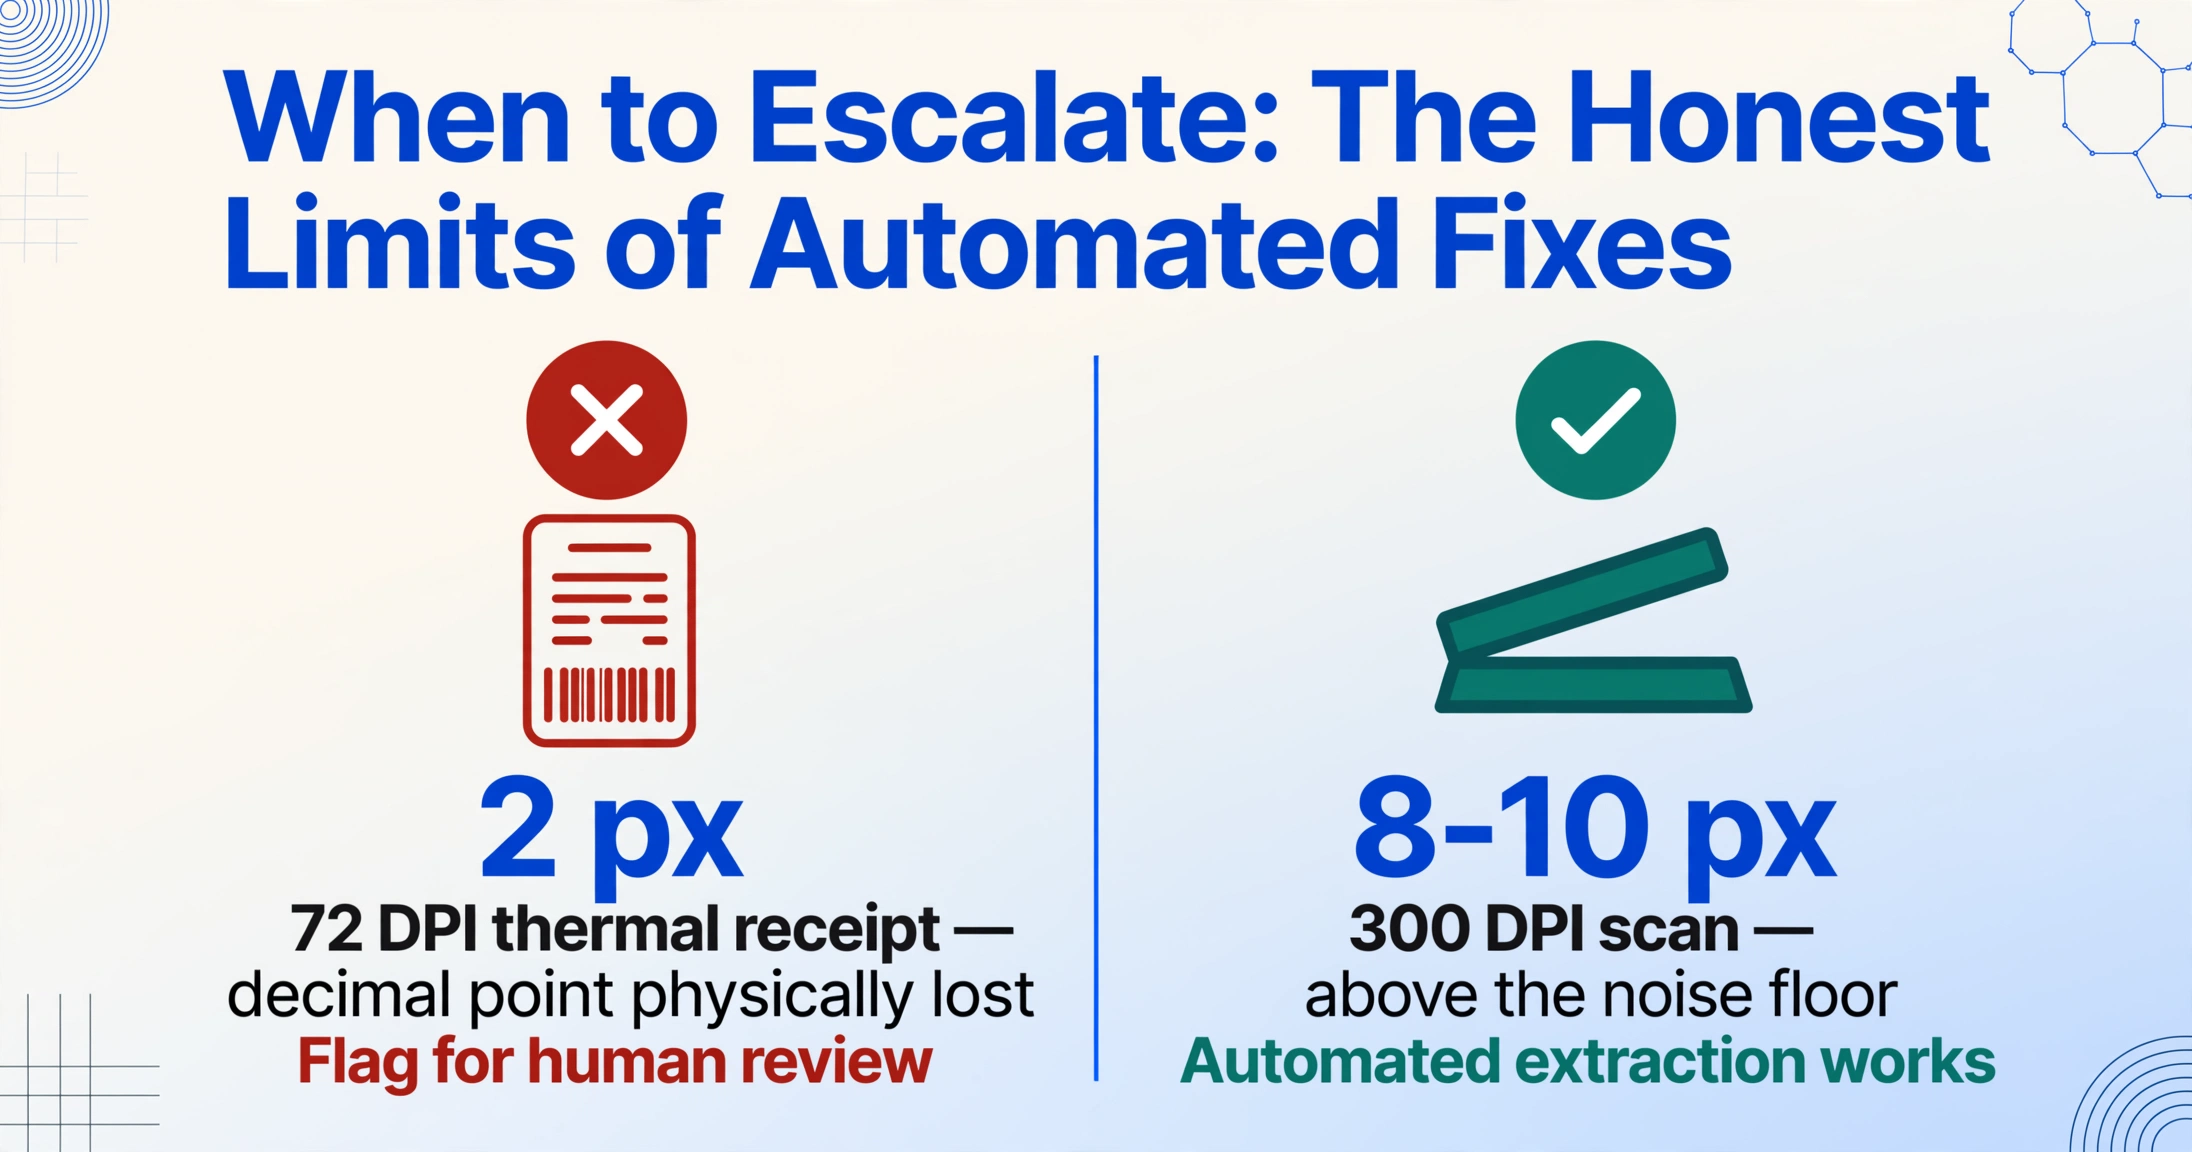
サーマルレシート、FAXされたドキュメント、第二世代のコピーを扱う場合、一部の小数点は手動での確認が必要になることを受け入れてください。実用的なアプローチは、桁数チェックに失敗したすべての抽出金額(合計が想定範囲外、明細の合計が合計額と一致しない、小数点以下の桁数が通貨と矛盾するなど)にフラグを立て、そのフラグを人間のレビュアーに回すことです。フラグの立った値を30秒でレビューする方が、キャプチャ時に失われた情報を後処理で復元しようと調整するよりも速く、確実です。
一貫して低解像度で届くドキュメントを処理するチームにとって、最も効果的な投資はより優れた抽出ツールではなく、受信ドキュメントに300 DPI以上を求めるスキャン基準です。300 DPIでは、小数点は8~10ピクセルを占め、これは最新の抽出エンジンのノイズフロアを上回ります。
よくある質問
AI抽出ツールはサーマルレシートの小数点を読み取れますか?
最新のビジョンAIツールは、印刷品質が良く、十分な解像度(理想的には300 DPI以上)で撮影された画像であれば、サーマルレシートの小数点を読み取ることができます。ただし、サーマルレシートは本質的にコントラストが低く、印刷は時間とともに薄れていきます。8ポイント未満の印刷サイズでは、小数点は物理的に小さすぎて、どのシステムでも背景ノイズと区別できない可能性があります。正直なところ、人間がレシート写真の小数点を見るのに目を細めなければならないなら、AIもそれを見逃します。
OCRが抽出した金額から$記号を落とし続けるのはなぜですか?
通貨記号が落ちるのは、スペース区切りなしで最初の数字のすぐ近くに現れる場合、または記号が周囲の数字と異なる書体を使用している場合に最もよく起こります。OCRエンジンは記号文字に対する信頼度が低く、信頼度の高い数字を保持し、信頼度の低い記号を破棄することでこれを解決します。これを修正するには、抽出スキーマで通貨記号の正規化ルールを定義します。ドキュメントソースごとに期待される通貨を指定し、OCRに記号の保持を依存するのではなく、抽出されたすべての金額に自動的に適用されるようにします。
抽出後の正規表現ですべての小数点エラーを修正できますか?
正規表現は多くの小数点エラーを捉えることができますが、すべてを修正することはできません。OCRキャプチャ中に小数点が失われ、抽出された値が「156.00」ではなく「15600」である場合、正規表現は追加のコンテキストなしに小数点がどこに属するかを判断できません。元のドキュメントの内容によって、値は15.600、156.00、または1560.0である可能性があります。正規表現は、大きさの検証(明細行の合計や予想範囲との比較)と組み合わせた場合、またはドキュメント形式が事前にわかっている場合(例:すべての価格が正確に小数点以下2桁)にうまく機能します。未知の形式のドキュメントでは、正規表現は修正メカニズムではなく、フラグ付けメカニズムです。
小数点の欠落を避けるために、どの解像度でスキャンする必要がありますか?
300 DPIは、印刷されたドキュメントの信頼性の高いOCRの業界標準です。300 DPIでは、10ポイントの小数点は幅約8~10ピクセルを占め、最新のOCRおよびAI抽出エンジンのノイズしきい値を十分に上回ります。150 DPI(ファックスやアーカイブスキャンで一般的)では、同じ小数点が4~5ピクセルに減少し、境界線上になります。72 DPI(ドキュメントの携帯電話スクリーンショットで典型的)では、小数点は幅わずか2ピクセルしかなく、事実上どの抽出システムにも見えません。小数点が一貫して欠落している場合は、まずスキャン解像度を確認してください。
次のステップ:診断から予防へ
小数点の欠落は偶発的な出来事ではなく、5つの既知の失敗モードのいずれかがもたらす予測可能な結果です。こうしたエラーを検出できるチームとできないチームの違いは、使っているツールではありません。診断フレームワークを持っているかどうかです。5つの失敗モードのどれに該当するかがわかれば、修正は通常、別のAIエンジンではなく後処理ルールで対応できます。
まずは簡単な監査から始めましょう。パイプラインから直近50件の抽出された金額を取得し、各エラーを失敗モード別に分類します。エラーの80%が1つか2つのカテゴリに集中していれば、数行の検証ロジックだけで済む焦点を絞った修正があります。エラーが5つのモードすべてに分散している場合、問題はおそらく取り込み品質にあり、修正はツールの変更ではなくスキャン基準の策定です。
抽出精度がドキュメント形式によってどう変わるか、曖昧さを最小限に抑えるフィールドをどう設計するかについて詳しくは、誤った抽出数値を生むフィールド設計のミスに関するガイドと、ドキュメントソース間の形式のばらつきが精度低下を招く仕組みの分析をご覧ください。フィールド設計、形式のばらつき、そして今回の記号レベルの失敗モード——これら3つの診断を組み合わせることで、パイプラインのあらゆるレベルで抽出精度をデバッグするための完全なフレームワークが得られます。