Pourquoi mon OCR manque-t-il les points décimaux
et les symboles monétaires ? 5 modes de défaillance et comment corriger chacun
Votre extraction a lu « 15600 » alors que le document indique clairement « 156,00 $ ». Le point décimal a disparu, le symbole monétaire s'est volatilisé, et votre feuille de calcul affiche maintenant une erreur de 15 600 $ au lieu d'une dépense de 156 $. Voici exactement pourquoi ces petits symboles sont les premiers à casser — et comment vous protéger contre chaque mode de défaillance.
Points clés à retenir
- Votre extraction a multiplié une facture par 100 sans le moindre avertissement — 156,00 $ est devenu 15 600 $, tandis que le nom du vendeur, la date et les lignes d'articles sont tous ressortis correctement. Seul le chiffre le plus important est faux.
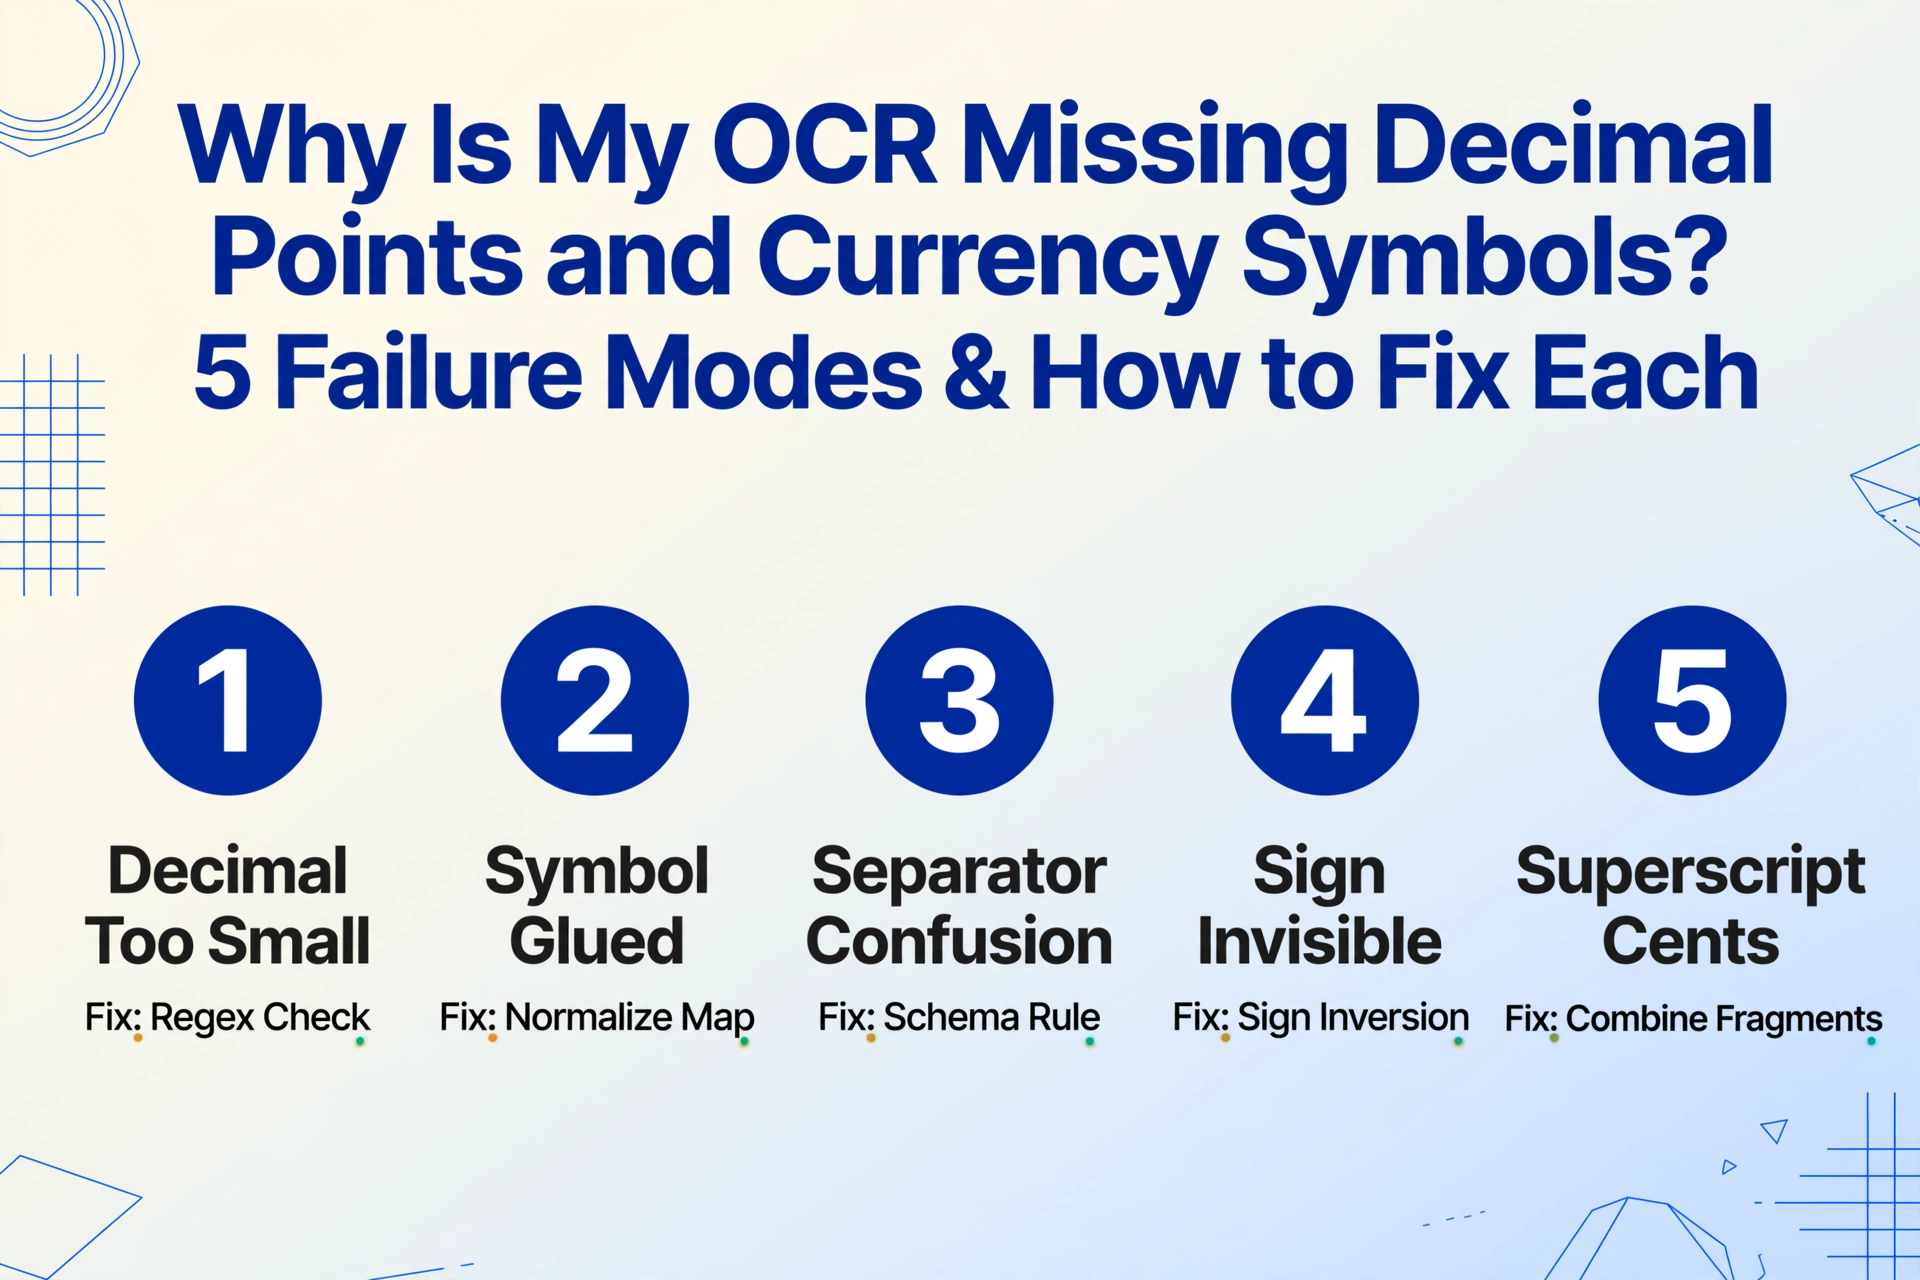
- Les points décimaux sont filtrés comme de la poussière à faible résolution (2 pixels de large), les symboles monétaires se noient lorsqu'ils touchent le premier chiffre, les virgules européennes inversent la position décimale, les parenthèses sur les notes de crédit sont écartées, et les centimes en exposant disparaissent dans des lignes de texte séparées — cinq problèmes physiques qui ressemblent à des bugs logiciels aléatoires.
- Une règle de validation comparant chaque total extrait à la somme des lignes d'articles détecte l'erreur de facteur 100 avant qu'elle n'atteigne votre grand livre — aucun nouvel outil, aucun prétraitement, juste une vérification exécutée après chaque extraction.
Un seul point décimal manquant n'est pas une petite erreur — c'est une erreur multipliée par dix. Et le plus frustrant, c'est que le reste de l'extraction semble propre. Le nom du fournisseur, la date, les lignes d'articles sont tous corrects. Seuls les chiffres les plus importants — totaux, montants de taxe, prix unitaires — ont silencieusement dérivé d'un ou deux ordres de grandeur. L'impact n'est pas abstrait : un paiement comptabilisé de 15 600 $ au lieu de 156 $ immobilise de la trésorerie, déclenche un travail de rapprochement et érode la confiance dans le processus automatisé.
La conclusion clé de la recherche sur le traitement de documents est cohérente : les petits symboles — points décimaux, signes de devise, signes moins — échouent avant les caractères plus grands, car ils opèrent à la limite du seuil de résolution d'un moteur OCR. Ce ne sont pas des erreurs aléatoires. Elles suivent des modes de défaillance prévisibles, chacun avec une cause racine connue. Identifier le mode auquel vous avez affaire fait la différence entre un correctif regex rapide et un désastre de données qui atteint votre ERP sans être détecté.
Cet article couvre cinq modes de défaillance distincts pour les points décimaux et symboles de devise manquants. Chacun a une signature diagnostique spécifique et un correctif spécifique. Pour une vue d'ensemble des raisons pour lesquelles les outils d'extraction renvoient des chiffres erronés même lorsque le texte est clairement lisible, consultez notre article complémentaire sur les erreurs de conception de champs qui causent des chiffres extraits incorrects — cet article se concentre sur les noms de colonnes ambigus, tandis que celui-ci se concentre sur les défaillances au niveau des symboles.
Mode de défaillance 1 : le point décimal est trop petit pour que le moteur le voie
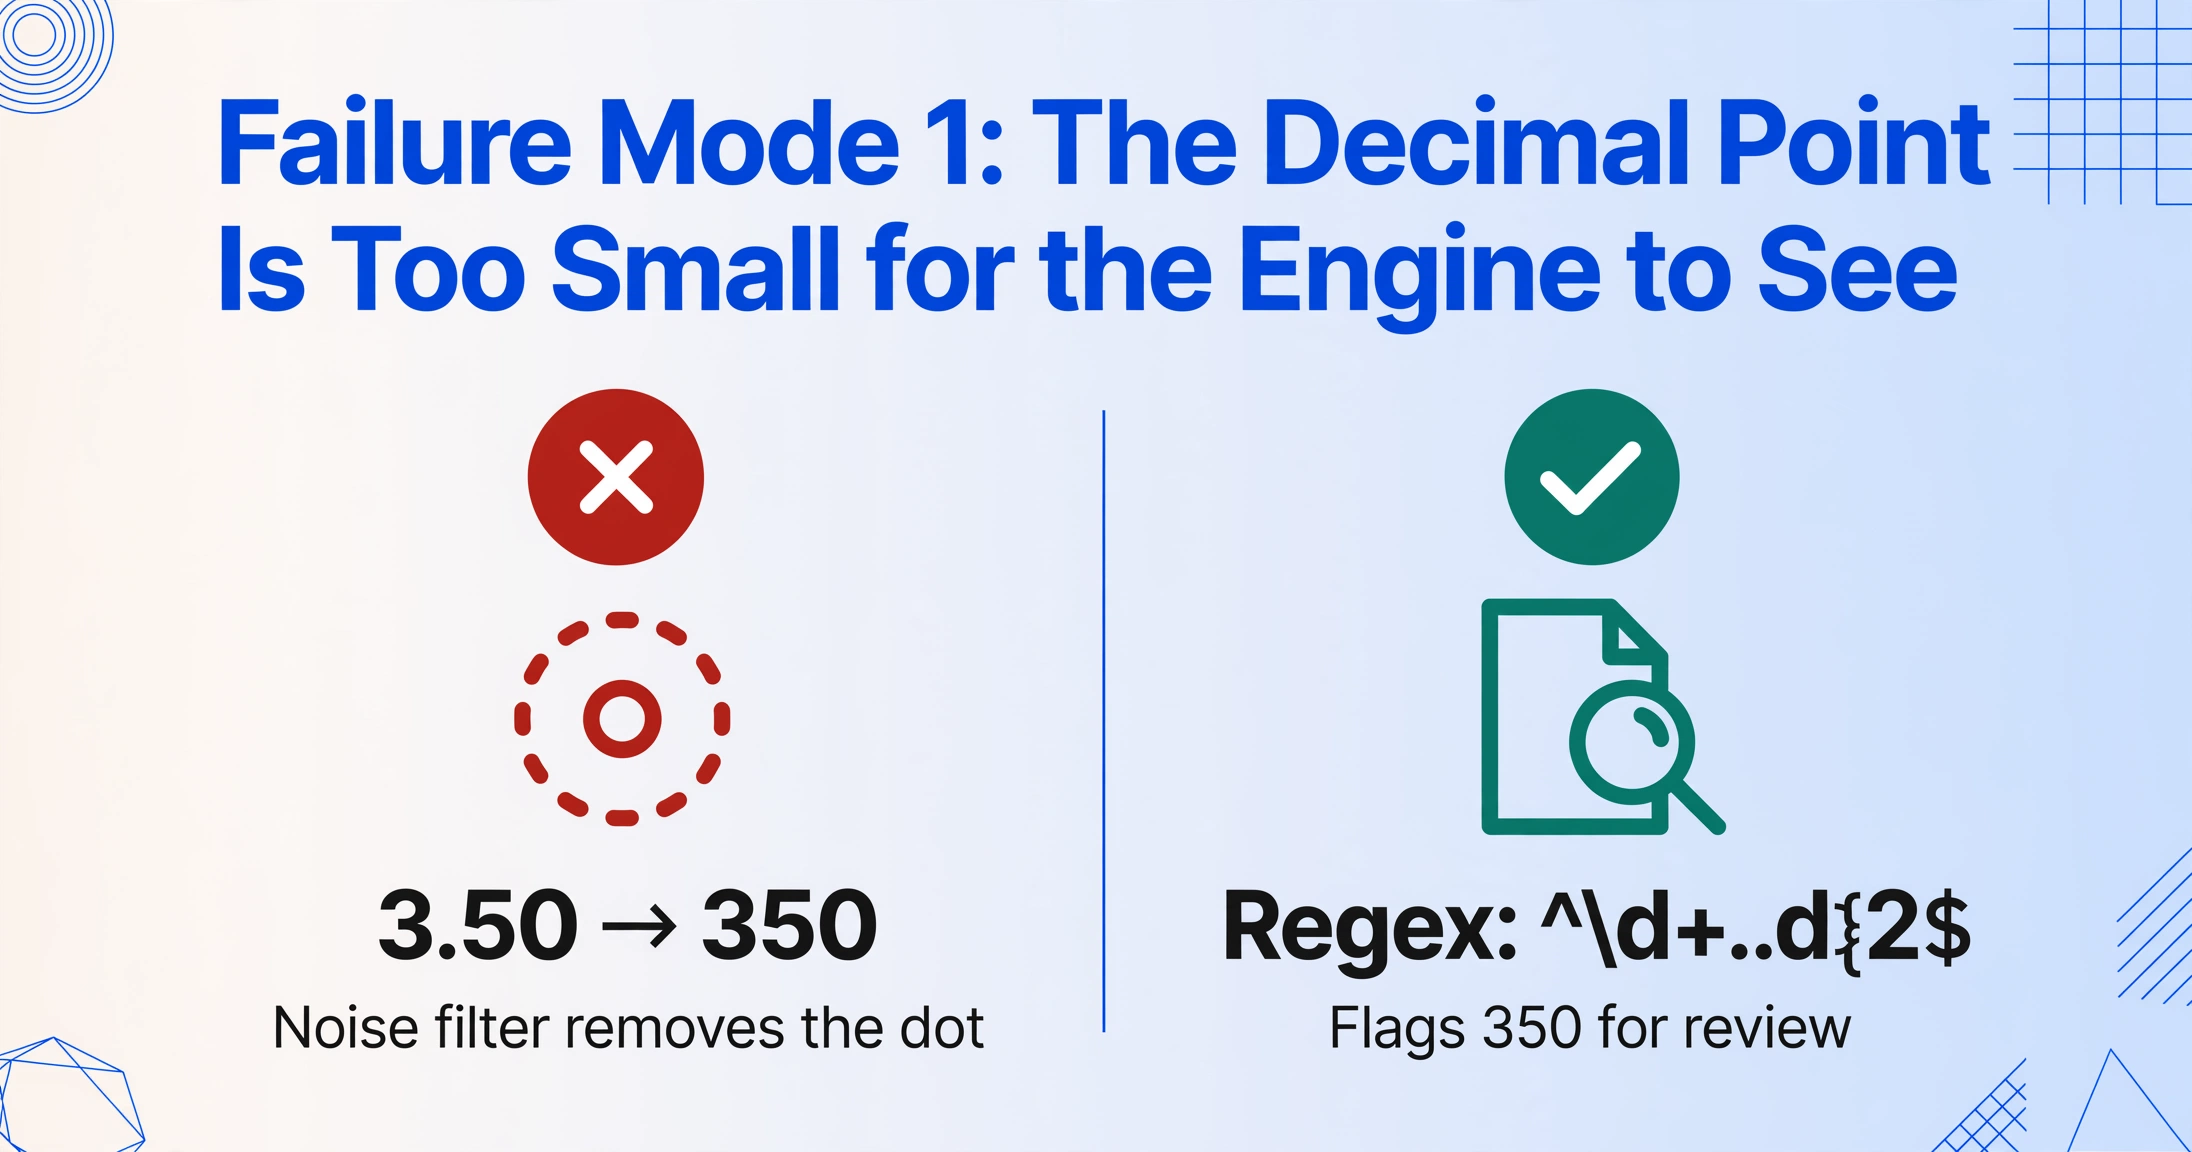
Symptômes : « 3,50 » est extrait comme « 350 » ou « 3 50 ». « 19,99 » devient « 1999 ». Les chiffres eux-mêmes sont parfaitement lisibles — le point décimal n'est tout simplement pas là. Le point manquant décale chaque nombre de votre feuille de calcul de deux ordres de grandeur.
Pourquoi cela se produit : Les moteurs OCR traditionnels prétraitent les images en appliquant des filtres de bruit, des ajustements de contraste et une binarisation avant de lire les caractères. Un point décimal de 8 à 10 pixels de hauteur — courant sur les reçus thermiques, les scans basse résolution et les documents faxés — tombe sous le seuil de bruit de ces étapes de prétraitement. Le filtre du moteur voit une petite tache entre deux chiffres et la classe comme poussière, fibre de papier ou artefact de compression. À 72 DPI, un point décimal occupe environ 2 à 3 pixels de largeur. À cette taille, il est visuellement indistinguable d'une particule de poussière pour tout algorithme de binarisation.
Ce n'est pas une défaillance de reconnaissance — c'est une défaillance de prétraitement. Le point décimal n'atteint jamais l'étape de reconnaissance car il a été supprimé avant que le moteur ne puisse l'examiner.
Comment le corriger : Le correctif le plus fiable est la validation post-extraction plutôt que d'essayer de modifier le prétraitement du moteur OCR. Implémentez une vérification regex au niveau du champ qui valide chaque montant monétaire extrait par rapport au modèle attendu :
# Vérification : cette valeur a-t-elle exactement deux décimales ?
pattern = r'^\d+\.\d{2}$'
if not re.match(pattern, extracted_value):
    flag_for_review(extracted_value)
Au-delà des regex, comparez la valeur extraite à une magnitude attendue. Si le total de votre facture se situe généralement entre 50 $ et 5 000 $ et que l'extraction renvoie 500 000 $, un contrôle de cohérence détecte l'erreur avant qu'elle n'atteigne votre système comptable. De nombreux outils d'extraction, dont ImageToTable.ai, permettent de définir des règles de formatage de sortie qui normalisent les montants pendant l'extraction — la position décimale fait partie du schéma de sortie plutôt que d'être laissée à la préservation par la sortie OCR brute.
Pour les scans à très basse résolution où les points décimaux sont physiquement plus petits que 6 pixels, aucun correctif de post-traitement n'est totalement fiable. La réponse honnête est que l'image source ne contient pas l'information nécessaire à une extraction précise. Dans ces cas, un nouveau scan à 300 DPI ou plus est le seul correctif durable.
Mode de défaillance 2 : le symbole monétaire collé au premier chiffre est supprimé
Symptômes : « 156,00 $ » est extrait comme « 156,00 » (symbole manquant) ou, dans les pires cas, comme « 15600 $ » (symbole + chiffres fusionnés en un seul jeton avec le point décimal perdu dans la fusion). Le contexte monétaire disparaît et les systèmes en aval traitent un montant en USD comme un nombre sans unité.
Pourquoi cela se produit : Les symboles monétaires ($, €, £, ¥, R$) sont typographiquement distincts des chiffres — ils sont souvent définis dans une police ou un poids différent, et ils se trouvent sur la même ligne de base que le nombre mais avec un profil visuel différent. Lorsqu'un moteur OCR tokenise une ligne, il doit décider si le « $ » fait partie du nombre ou s'il s'agit d'une entité distincte. Les tokeniseurs basés sur la proximité fusionnent fréquemment le symbole avec le chiffre de tête, produisant un seul jeton comme « 156 $ » que le moteur lit ensuite de manière erronée, car le classificateur de caractères interne a une confiance plus faible sur le symbole « $ » que sur les chiffres qui suivent. Le moteur résout la confusion en supprimant le caractère à faible confiance — le symbole monétaire — et en conservant les chiffres à haute confiance.
Certains moteurs d'extraction basés sur la vision gèrent mieux cela que l'OCR traditionnel, car ils traitent l'ensemble du contexte visuel plutôt que de tokeniser caractère par caractère. Mais même les modèles modernes peuvent avoir des difficultés lorsque le symbole monétaire et le premier chiffre partagent une boîte englobante serrée, ou lorsque le symbole apparaît dans une police inhabituelle (comme le « $ » incurvé sur certaines imprimantes de reçus).
Comment le corriger : Implémentez une carte de normalisation des symboles monétaires comme étape de post-extraction. Définissez le format de sortie attendu pour les champs monétaires — par exemple, « USD 156,00 » ou « 156,00 $ » — et normalisez les valeurs extraites dans ce format :
# Symboles monétaires connus selon le contexte du document
currency_map = {
    'USD': r'[\$]',
    'EUR': r'[€]',
    'GBP': r'[£]',
    'JPY': r'[¥]'
}
# Si la valeur extraite contient des chiffres mais aucun symbole,
# attribuez la devise attendue à partir des métadonnées du document
if re.match(r'^\d+\.\d{2}$', value) and not has_currency_prefix(value):
    normalized = f"{doc_currency} {value}"
La clé est de ne pas dépendre de l'OCR pour décider si le symbole appartient — définissez-le au niveau du schéma d'extraction et validez par rapport à celui-ci.
Mode de défaillance 3 : La confusion du séparateur de milliers inverse la décimale
Symptômes : Une facture américaine avec « 1 234,56 » est extraite comme « 1.23456 » ou « 1234.56 » (la virgule est perdue). Un document européen avec « 1.234,56 » est extrait comme « 1.23456 » ou « 1234.56 » — le point est traité comme une décimale, gonflant la valeur par 1 000. Le même signe de ponctuation signifie des choses opposées selon la région, et le moteur OCR ne sait pas quelle règle appliquer.
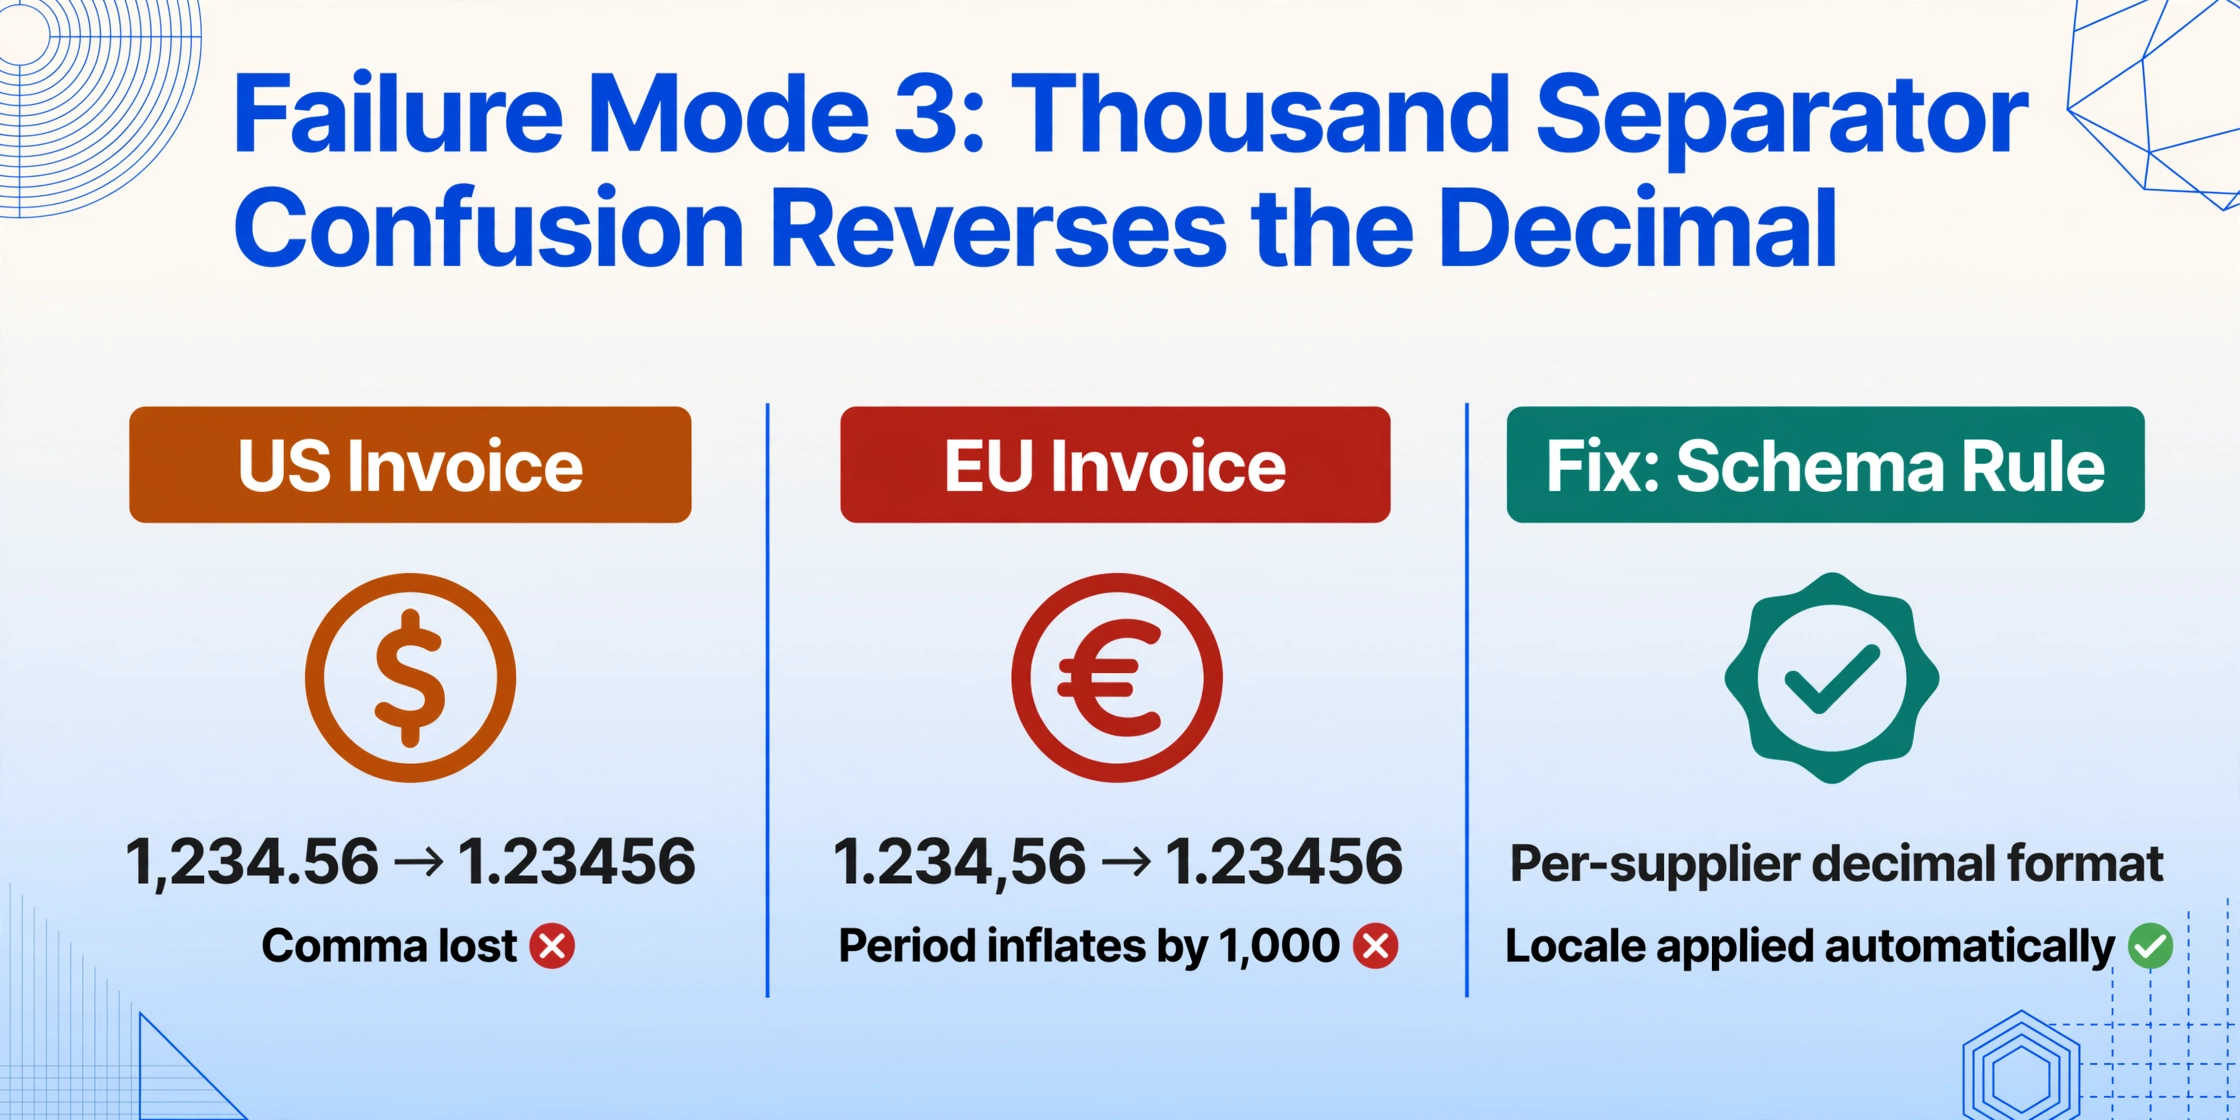
Pourquoi cela se produit : Les moteurs OCR traitent les signes de ponctuation comme des caractères, et non comme une notation mathématique. Un point et une virgule sont des caractères distincts avec des profils visuels connus, mais le moteur n'a pas de connaissance native de celui qui est un séparateur décimal dans la région du document. Ce n'est pas une limitation d'un seul moteur — chaque outil OCR grand public, de Tesseract aux API cloud commerciales, traite la ponctuation de la même manière : il génère ce qu'il voit, laissant l'interprétation de cette ponctuation à la logique en aval. Le résultat est que la même pipeline d'extraction peut produire 1 234,56 $ sur une facture américaine et 1.234,56 € sur une facture allemande — et les deux seront analysées incorrectement si le système en aval ne sait pas quelle convention attendre.
Ce problème s'aggrave lorsque vous traitez des factures de plusieurs pays. Un seul lot de 50 factures provenant de fournisseurs américains, allemands et français peut contenir trois conventions décimales différentes. Le moteur d'extraction ne détecte pas automatiquement quelle convention s'applique à quel document.
Comment le corriger : Deux approches. La première est au niveau du schéma : définissez le format décimal attendu par fournisseur ou par type de document avant que l'extraction ne s'exécute. Si vous savez que les factures de votre fournisseur allemand utilisent des virgules décimales, configurez une règle d'analyse qui interprète les virgules comme des séparateurs décimaux et les points comme des séparateurs de milliers pour ce groupe de documents.
La deuxième approche est la validation de la magnitude — une technique décrite en détail dans notre article sur les baisses de précision d'extraction multilingue, qui couvre comment la variance de format entre les sources de documents crée des erreurs en cascade. En pratique, vérifiez que le total extrait se situe dans une plage raisonnable par rapport à la somme des lignes. Un total de 1 234 567,89 $ lorsque les lignes totalisent 12 345,67 $ est un indicateur clair d'une inversion du séparateur décimal-milliers.
# Valider : le total correspond-il à la somme des lignes
# dans une tolérance raisonnable ?
line_sum = sum(line_items)
total = extracted_total
# Si le total est ~1000x la somme des lignes, la décimale a été lue comme séparateur de milliers
if abs(total - line_sum) / max(line_sum, 1) > 100:
    flag_decimal_ambiguity(extracted_total)
Mode de défaillance 4 : Signe négatif et parenthèses — l'indicateur invisible
Symptômes : Un avoir affiché « (156,00) » est extrait en « 156,00 » sans signe négatif. Un solde bancaire de « 1 247,30- » est extrait en « 1 247,30 » — le moins final est supprimé. Le nombre est techniquement correct, mais le signe est erroné, transformant un crédit en débit et un remboursement en frais.
Cause : Les moteurs d'OCR traitent les parenthèses comme des signes de ponctuation indépendants. Lorsqu'un nombre est entre parenthèses — notation comptable standard pour les valeurs négatives — la parenthèse ouvrante est lue comme un caractère distinct avant le premier chiffre, la parenthèse fermante comme un caractère distinct après le dernier chiffre. Lors de l'extraction, ces parenthèses sont souvent supprimées car elles ne correspondent pas à la classe de caractères attendue pour un champ numérique. Il en va de même pour les signes moins finaux : placés après les chiffres, ils sortent du jeton numérique et sont classés comme un fragment de texte distinct que la logique d'extraction n'associe jamais au nombre.
Solution : Définissez des règles de détection du signe au niveau du champ. Si la valeur extraite apparaît dans un champ contenant généralement des crédits, remises ou ajustements négatifs — ou si le document original contient des parenthèses autour d'un montant — appliquez une inversion de signe après extraction. Associez cela à une convention de nommage : une colonne intitulée « Montant du crédit » ou « Remise » doit s'attendre à une valeur absolue et appliquer automatiquement un signe négatif, indépendamment de ce que l'OCR a renvoyé.
# Si le contexte du document indique un champ à magnitude négative
# et que la valeur extraite est positive, inverser le signe
negative_context_fields = ['credit_memo', 'discount', 'refund', 'adjustment']
if field_name in negative_context_fields and extracted_value > 0:
    extracted_value = -extracted_value
Mode de défaillance 5 : Exposant et indice — des centimes qui disparaissent entre les lignes
Symptômes : Un prix affiché « 9999 € » (soit 99,99 €, avec les centimes en exposant) est extrait sous forme de « 99 » ou « 9900 ». Un montant de taxe imprimé en petit exposant à côté d'un sous-total disparaît complètement. Le nombre de base est correct, mais la partie fractionnaire qui définit la valeur monétaire précise disparaît.
Pourquoi cela se produit : Les caractères en exposant partagent la même zone horizontale que le nombre principal, mais se situent au-dessus de la ligne de base avec une taille réduite — généralement 40 à 60 % de la taille des chiffres principaux. Les moteurs d'OCR les détectent comme une ligne ou un fragment de texte distinct, car la position verticale s'écarte de la ligne de base principale. Lors de l'extraction de texte, ce fragment est soit attribué à une ligne de sortie différente, soit supprimé lors de l'analyse de la mise en page comme une valeur aberrante. La notation des centimes courante sur les étiquettes de prix et certaines lignes de facture est la plus fréquemment touchée.
Les valeurs en indice — moins courantes dans les contextes monétaires mais fréquentes dans les taux d'imposition et les codes de référence — rencontrent le même problème dans le sens inverse : les caractères sous la ligne de base sont segmentés en régions de texte indépendantes et perdent leur association avec le nombre principal.
Comment y remédier : L'approche la plus pratique consiste à combiner tous les fragments de texte partageant la même position horizontale dans une plage verticale restreinte, puis à valider la valeur combinée par rapport aux modèles monétaires attendus. Si un nombre principal « 99 » est suivi d'un exposant « 99 » dans la même zone de colonne, la combinaison « 99,99 » est une valeur monétaire valide. Implémentez cela comme une règle de fusion spatiale : tout fragment de texte situé dans un rayon de 150 % de la plage de coordonnées X du nombre principal et dans un décalage vertical défini doit être fusionné dans la valeur de champ extraite.
# Fusionner les fragments dans la même zone horizontale
# dans une bande verticale restreinte
def merge_superscript(main_number, fragments, y_threshold=15):
    """Combiner le groupe de chiffres principal avec les fragments proches."""
    combined = main_number
    for frag in fragments:
        if abs(frag.y - main_y) < y_threshold and \
           abs(frag.x - main_x) < main_width * 0.5:
            combined += frag.text
    # Valider après fusion
    if re.match(r'^\d+\.\d{2}$', combined):
        return combined
    return main_number  # revenir à l'original si la fusion est invalide
Quand passer au niveau supérieur : les limites honnêtes des corrections automatisées
Les cinq corrections ci-dessus couvrent la majorité des échecs liés aux points décimaux et aux symboles monétaires. Mais il existe une catégorie de documents pour laquelle aucune règle de post-traitement ne peut récupérer de manière fiable la valeur correcte : les documents où le point décimal est physiquement plus petit que la résolution minimale que la méthode de capture peut reproduire. Un point décimal sur un reçu thermique à 72 DPI mesure environ 2 pixels de large. À cette taille, l'information n'existe tout simplement pas dans l'image pour qu'un moteur — OCR traditionnel ou IA de vision — puisse la lire de manière fiable.
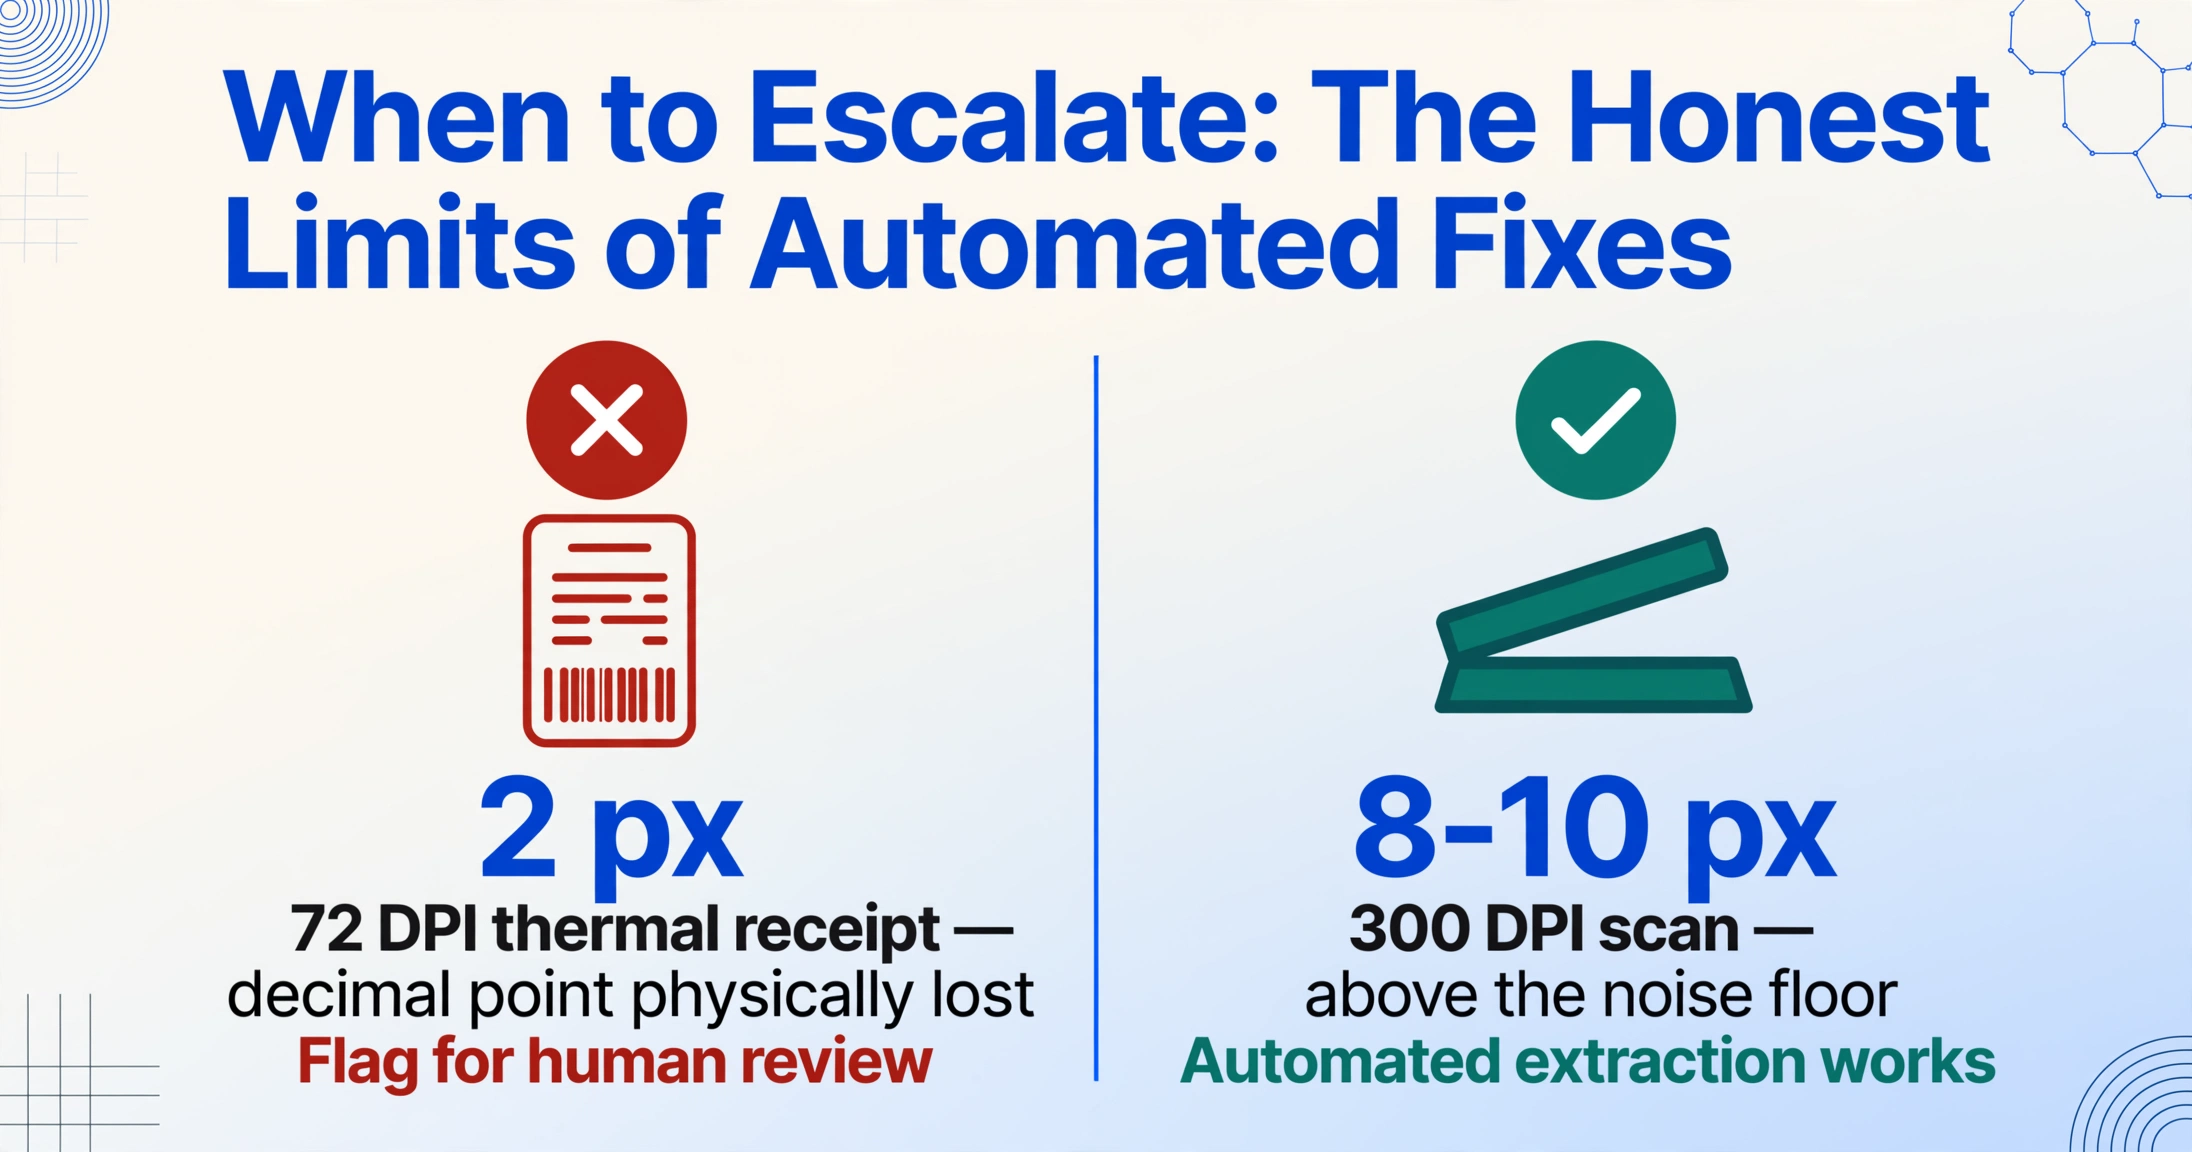
Si vous travaillez avec des reçus thermiques, des documents faxés ou des photocopies de deuxième génération, acceptez que certains points décimaux nécessitent une vérification manuelle. L'approche pratique consiste à signaler chaque valeur monétaire extraite qui échoue à un contrôle d'ordre de grandeur — total hors plage attendue, lignes qui ne correspondent pas au total, nombre de décimales incohérent avec la devise — et à acheminer ces signalements vers un réviseur humain. Une vérification de 30 secondes des valeurs signalées est plus rapide et plus fiable que d'essayer d'ajuster le post-traitement pour récupérer des informations perdues au moment de la capture.
Pour les équipes qui traitent des documents arrivant systématiquement en basse résolution, l'investissement le plus efficace n'est pas un meilleur outil d'extraction — c'est une norme de numérisation exigeant 300 DPI ou plus pour les documents entrants. À 300 DPI, un point décimal occupe 8 à 10 pixels, ce qui est au-dessus du seuil de bruit de tous les moteurs d'extraction modernes.
Questions fréquentes
Les outils d'extraction IA lisent-ils les points décimaux sur les tickets thermiques ?
Les outils d'IA modernes peuvent lire les points décimaux sur les tickets thermiques si l'impression est de bonne qualité et l'image capturée en résolution suffisante (idéalement 300 DPI ou plus). Cependant, les tickets thermiques ont un faible contraste et l'impression s'estompe avec le temps. En dessous de 8 points, le point décimal peut être physiquement trop petit pour être distingué du bruit de fond. Réponse honnête : si un humain doit plisser les yeux pour voir le point décimal sur une photo de ticket, l'IA le manquera aussi.
Pourquoi mon OCR supprime-t-il systématiquement le symbole $ des montants extraits ?
Les symboles monétaires sont souvent supprimés lorsqu'ils sont trop proches du premier chiffre sans espace, ou que leur police diffère des chiffres environnants. Le moteur OCR a une confiance plus faible sur le symbole et conserve les chiffres à haute confiance en éliminant le symbole. Solution : définissez une règle de normalisation du symbole monétaire dans votre schéma d'extraction — spécifiez la devise attendue par source de document et appliquez-la automatiquement à chaque montant extrait, plutôt que de compter sur l'OCR pour conserver le symbole.
Une regex post-extraction peut-elle corriger toutes les erreurs de point décimal ?
Les regex peuvent détecter de nombreuses erreurs de point décimal, mais pas toutes les corriger. Si le point décimal a été perdu lors de la capture OCR et que la valeur extraite est "15600" au lieu de "156.00", une regex ne peut pas déterminer où placer la décimale sans contexte supplémentaire — la valeur pourrait être 15.600, 156.00 ou 1560.0 selon le document original. Les regex fonctionnent bien combinées à une validation de magnitude (comparaison avec des totaux de lignes ou des plages attendues) ou lorsque le format du document est connu à l'avance (ex. tous les prix ont exactement deux décimales). Pour des formats inconnus, la regex est un mécanisme de signalement, pas de correction.
Quelle résolution de numérisation pour éviter la perte des points décimaux ?
300 DPI est la norme industrielle pour une OCR fiable sur documents imprimés. À 300 DPI, un point décimal de 10 points occupe environ 8 à 10 pixels de large — bien au-dessus du seuil de bruit des moteurs OCR et d'extraction IA modernes. À 150 DPI (courant pour la télécopie et l'archivage), le même point décimal tombe à 4–5 pixels et devient limite. À 72 DPI (typique pour les captures d'écran de documents sur mobile), le point décimal peut ne faire que 2 pixels de large et est pratiquement invisible pour tout système d'extraction. Si vos points décimaux manquent systématiquement, vérifiez d'abord votre résolution de numérisation.
Prochaines étapes : du diagnostic à la prévention
Un point décimal manquant n'est pas un événement aléatoire — c'est le résultat prévisible de l'un des cinq modes de défaillance connus. La différence entre une équipe qui détecte ces erreurs et une équipe qui ne les détecte pas ne réside pas dans l'outil utilisé, mais dans la présence d'un cadre de diagnostic. Lorsque vous savez lequel des cinq modes de défaillance vous concerne, la correction est généralement une règle de post-traitement — pas un autre moteur d'IA.
Commencez par un audit simple : prenez les 50 dernières valeurs monétaires extraites de votre pipeline et classez chaque erreur par mode de défaillance. Si 80 % de vos erreurs relèvent d'une ou deux catégories, vous avez une correction ciblée qui ne coûte rien d'autre que quelques lignes de logique de validation. Si les erreurs sont réparties sur les cinq modes, le problème vient probablement de la qualité de capture — et la solution est une norme de numérisation, pas un changement d'outil.
Pour un examen plus approfondi de la façon dont la précision d'extraction varie selon le format de document et de la façon de concevoir des champs qui minimisent l'ambiguïté, consultez notre guide sur les erreurs de conception de champs qui produisent des nombres extraits incorrects et l'analyse de la variance de format entre les sources de documents qui crée des baisses de précision. Entre ces trois diagnostics — conception de champs, variance de format et maintenant les modes de défaillance au niveau des symboles — vous disposez d'un cadre complet pour déboguer la précision d'extraction à chaque niveau du pipeline.