Por que meu OCR está perdendo pontos decimais
e símbolos de moeda? 5 modos de falha e como corrigir cada um
Sua extração leu "15600" quando o documento diz claramente "$156,00." O ponto decimal desapareceu, o símbolo de moeda sumiu, e agora sua planilha tem um erro de $15.600 em vez de uma despesa de $156. Aqui está exatamente por que esses pequenos símbolos são as primeiras coisas a quebrar — e como se proteger contra cada modo de falha.
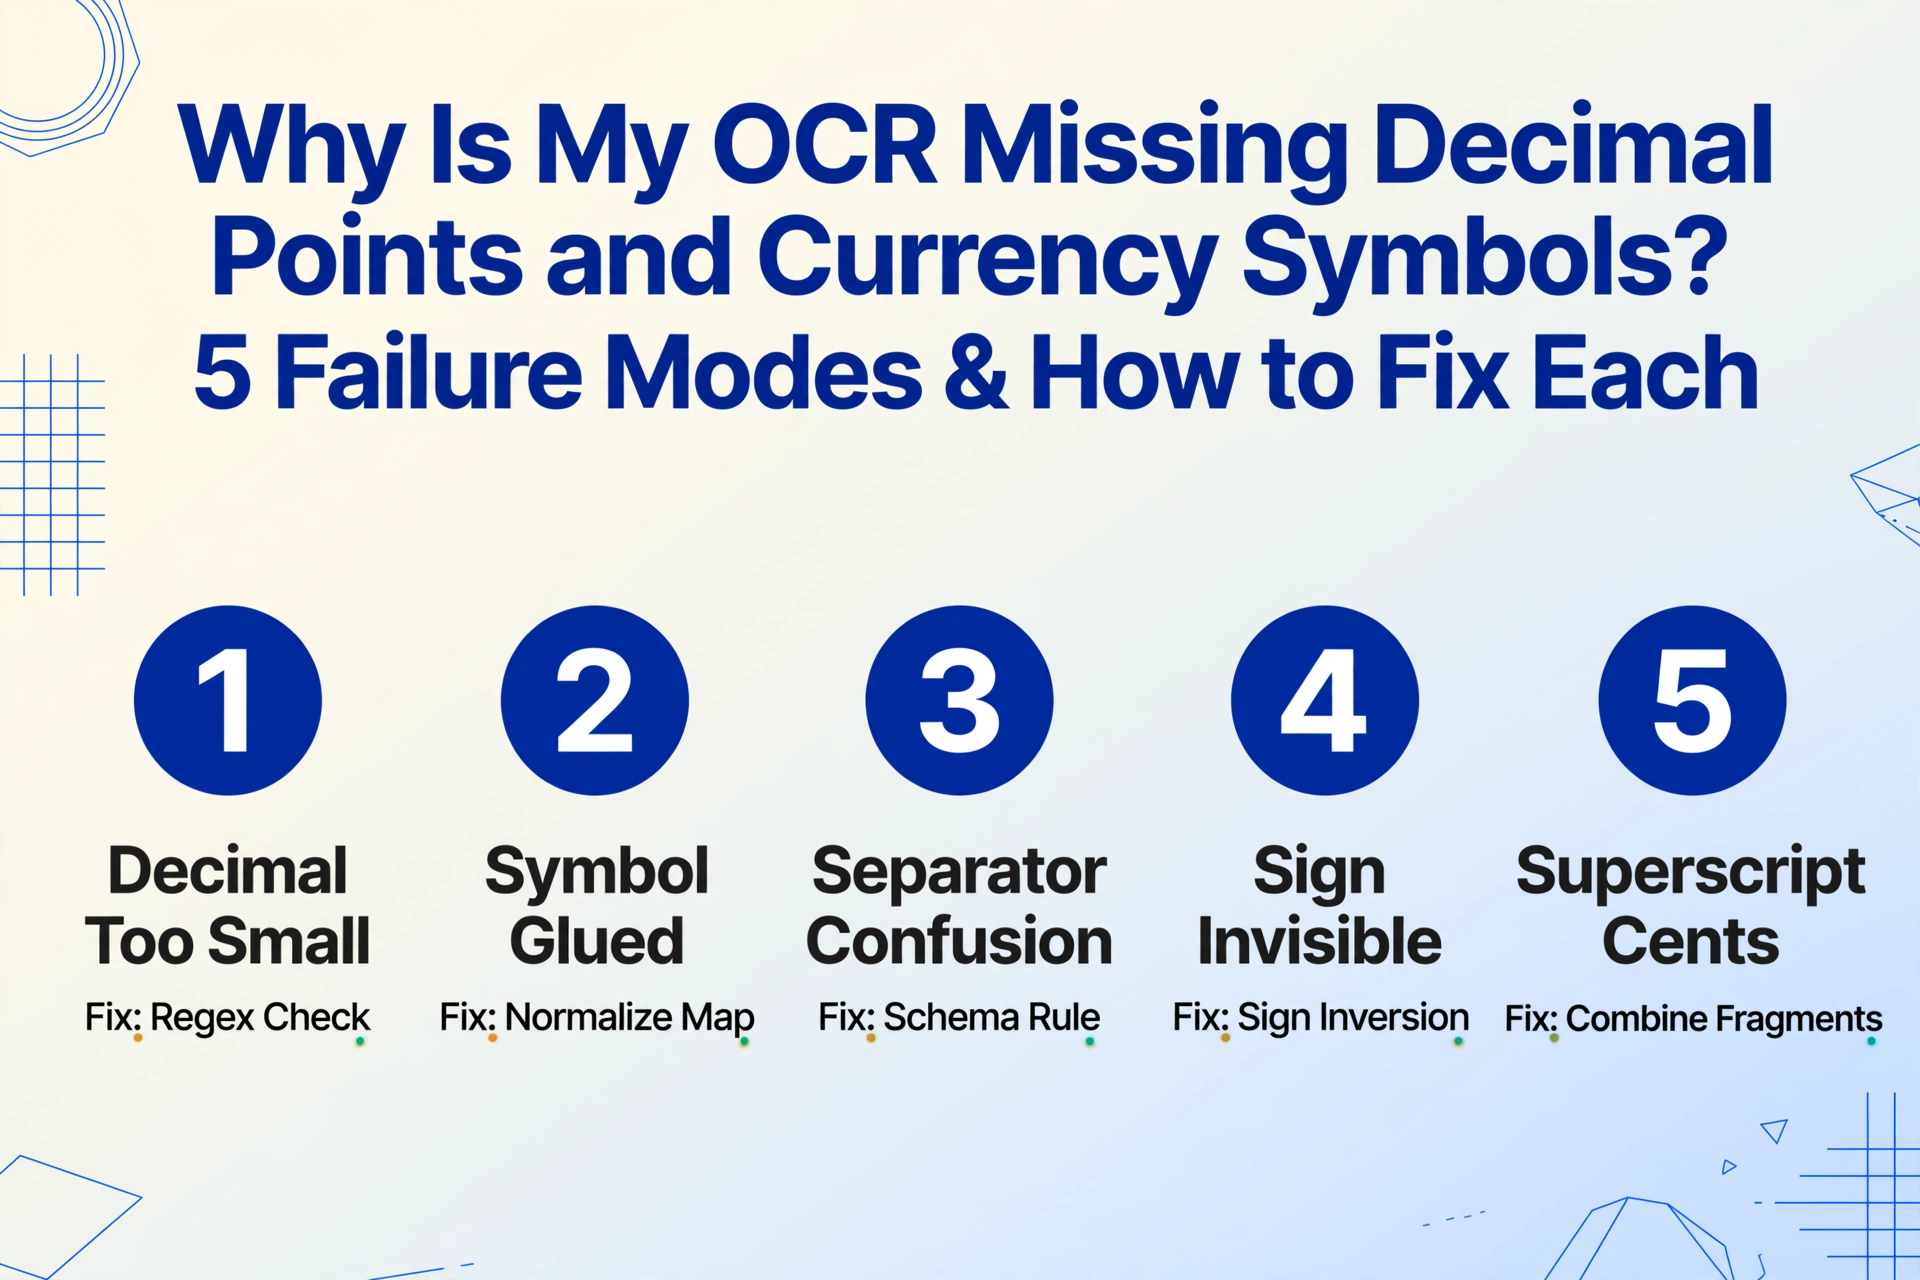
Principais conclusões
- Sua extração multiplicou uma fatura por 100 sem nenhum aviso — $156,00 virou 15600 enquanto o nome do fornecedor, a data e os itens de linha vieram corretos. Apenas o número mais importante está errado.
- Pontos decimais são filtrados como poeira em baixa DPI (2 pixels de largura), símbolos de moeda se perdem quando tocam o primeiro dígito, vírgulas europeias invertem a casa decimal, parênteses em notas de crédito são descartados, e centavos sobrescritos desaparecem em linhas de texto separadas — cinco problemas físicos que parecem bugs de software aleatórios.
- Uma regra de validação que compara cada total extraído com a soma dos itens de linha detecta o erro de 100x antes que ele chegue ao seu razão geral — sem nova ferramenta, sem pré-processamento, apenas uma verificação que roda após cada extração.
Um único ponto decimal ausente não é um erro pequeno — é um erro de dez vezes. E a parte frustrante é que o restante da extração parece correto. Nome do fornecedor, data, itens de linha — tudo vem corretamente. Apenas os números que mais importam — totais, valores de impostos, preços unitários — mudaram silenciosamente por uma ou duas ordens de magnitude. O impacto não é abstrato: um pagamento lançado de $15.600 em vez de $156 trava o caixa, gera trabalho de conciliação e corrói a confiança no processo automatizado.
A principal conclusão da pesquisa em processamento de documentos é consistente: símbolos pequenos — pontos decimais, marcas de moeda, sinais de menos — falham antes que caracteres maiores falhem, porque operam na borda do limite de resolução de um mecanismo de OCR. Esses não são erros aleatórios. Eles seguem modos de falha previsíveis, cada um com uma causa raiz conhecida. Identificar qual modo você está enfrentando é a diferença entre uma correção rápida com regex e um desastre de dados que chega ao seu ERP sem ser detectado.
Este artigo aborda cinco modos distintos de falha para pontos decimais e símbolos de moeda ausentes. Cada um tem uma assinatura diagnóstica específica e uma correção específica. Para uma visão mais ampla de por que ferramentas de extração retornam números errados mesmo quando o texto está claramente legível, veja nosso artigo complementar sobre erros de design de campos que causam números extraídos incorretos — aquele artigo foca em nomes de colunas ambíguos, enquanto este foca em falhas no nível de símbolos.
Modo de Falha 1: O Ponto Decimal É Pequeno Demais para o Mecanismo Enxergar
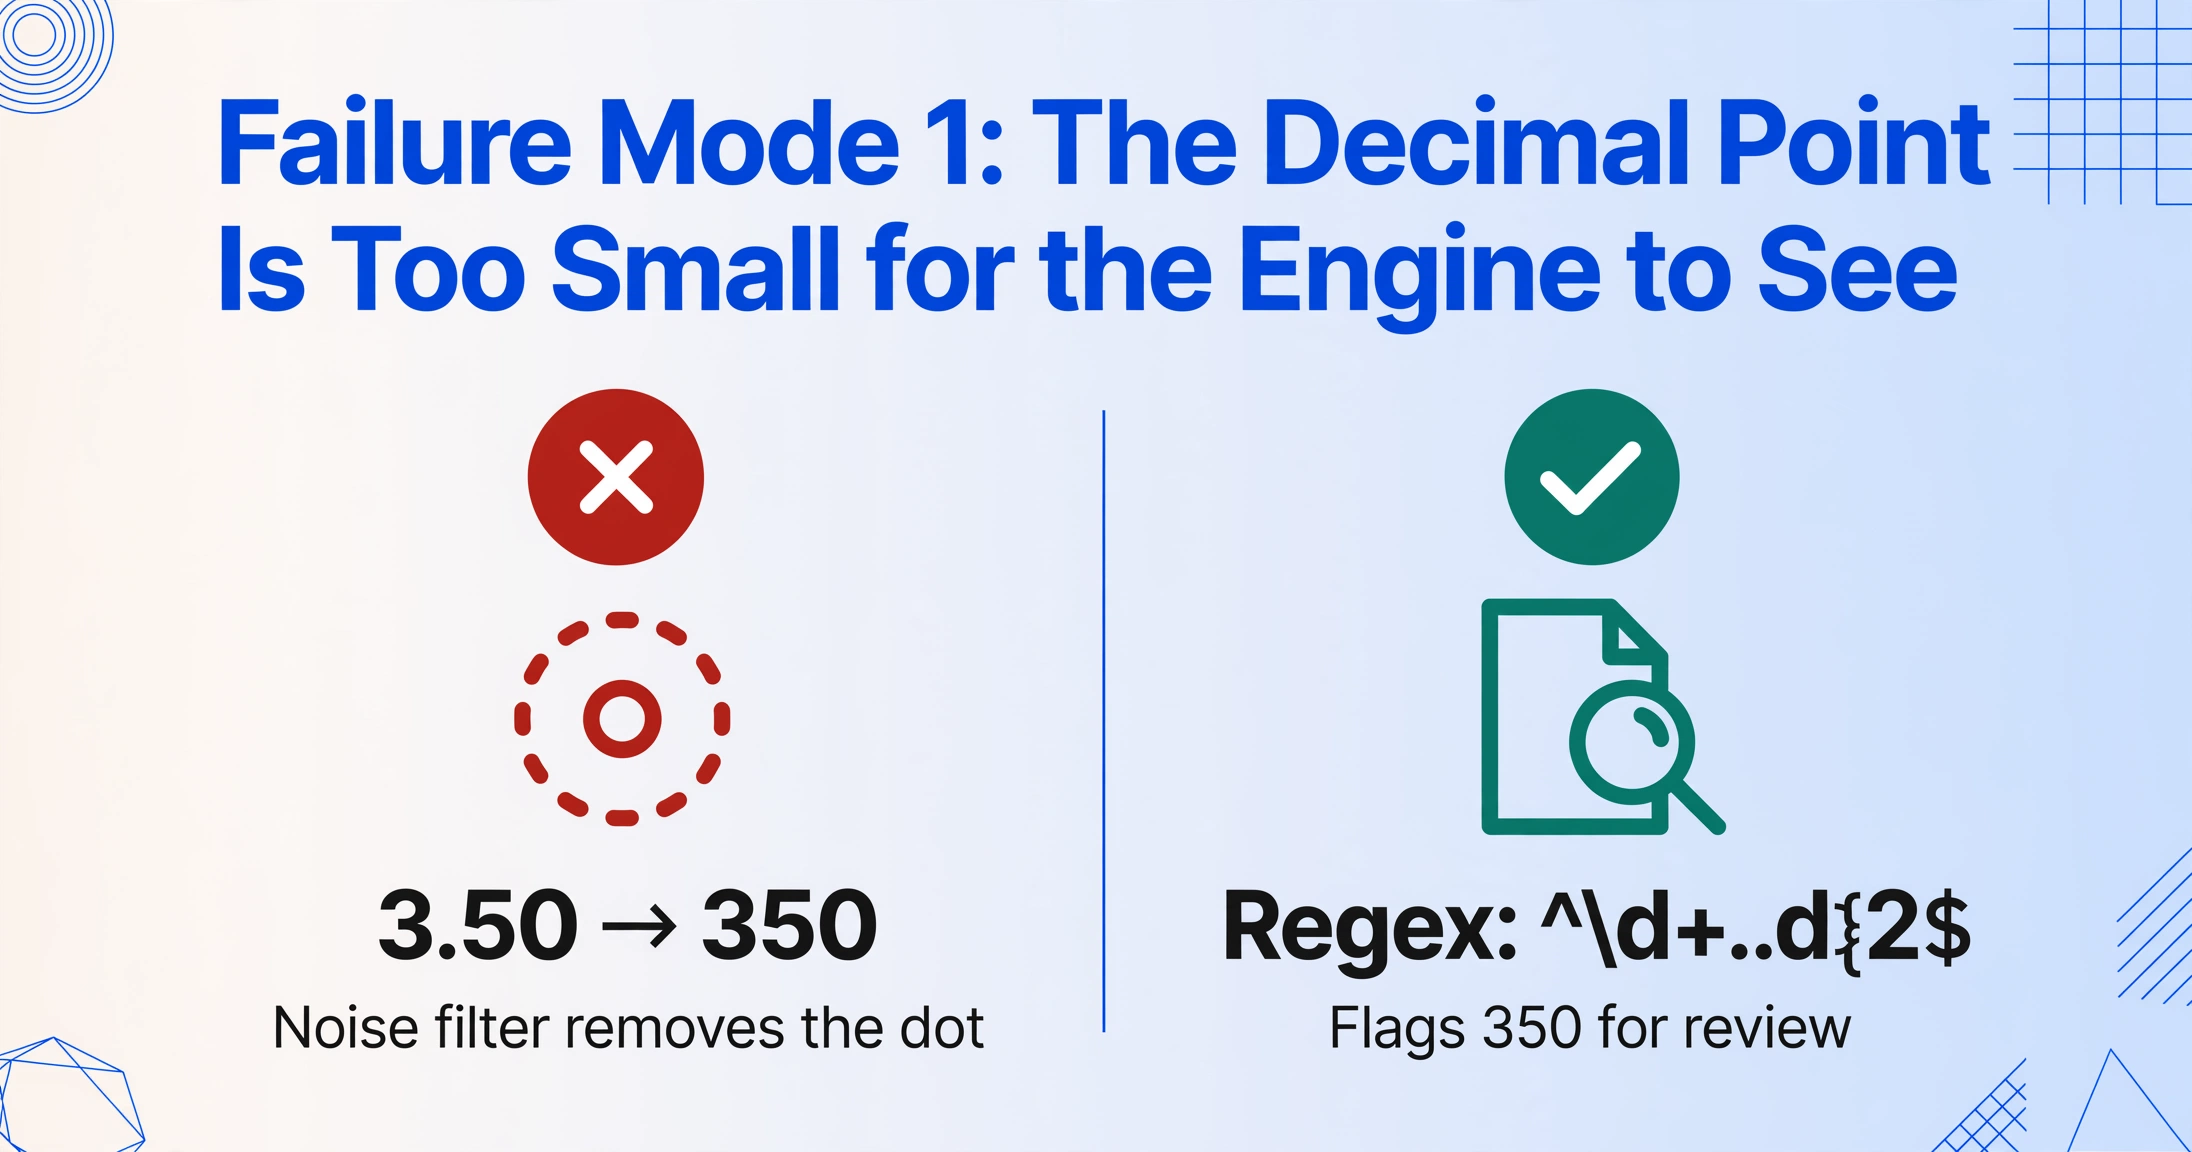
Sintomas: "3.50" é extraído como "350" ou "3 50". "19.99" vira "1999". Os dígitos em si estão perfeitamente legíveis — o ponto decimal simplesmente não está lá. O ponto ausente desloca cada número na sua planilha por duas ordens de magnitude.
Por que acontece: Mecanismos de OCR tradicionais pré-processam imagens aplicando filtros de ruído, ajustes de contraste e binarização antes de ler os caracteres. Um ponto decimal com 8–10 pixels de altura — comum em recibos térmicos, digitalizações de baixa DPI e documentos enviados por fax — fica abaixo do piso de ruído dessas etapas de pré-processamento. O filtro do mecanismo vê uma pequena mancha entre dois dígitos e a classifica como poeira, fibra de papel ou artefato de compressão. A 72 DPI, um ponto decimal ocupa aproximadamente 2–3 pixels de largura. Nesse tamanho, é visualmente indistinguível de uma partícula de poeira para qualquer algoritmo de binarização.
Isso não é uma falha de reconhecimento — é uma falha de pré-processamento. O ponto decimal nunca chega à etapa de reconhecimento porque foi removido antes que o mecanismo pudesse examiná-lo.
Como corrigir: A correção mais confiável é a validação pós-extração, em vez de tentar mudar o pré-processamento do mecanismo de OCR. Implemente uma verificação de regex no nível do campo que valide cada valor monetário extraído contra o padrão esperado:
# Verificação: este valor tem exatamente duas casas decimais?
pattern = r'^\d+\.\d{2}$'
if not re.match(pattern, extracted_value):
    flag_for_review(extracted_value)
Além de regex, compare o valor extraído com uma magnitude esperada. Se o total da sua fatura normalmente fica entre $50 e $5.000 e a extração retorna $500.000, uma verificação de sanidade detecta o erro antes que ele chegue ao seu sistema contábil. Muitas ferramentas de extração, incluindo o ImageToTable.ai, permitem definir regras de formatação de saída que padronizam valores durante a extração — a posição da vírgula decimal passa a fazer parte do esquema de saída, em vez de algo que o resultado bruto do OCR precise preservar.
Para digitalizações de resolução extremamente baixa, em que os pontos decimais são fisicamente menores que 6 pixels, nenhuma correção de pós-processamento é totalmente confiável. A resposta honesta é que a imagem de origem não contém as informações necessárias para uma extração precisa. Nesses casos, redigitalizar a 300 DPI ou mais é a única correção duradoura.
Modo de Falha 2: Símbolo de Moeda Colado ao Primeiro Dígito é Descartado
Sintomas: "$156.00" é extraído como "156.00" (símbolo ausente) ou, em casos piores, como "$15600" (símbolo + dígitos mesclados em um único token, com o ponto decimal perdido na mesclagem). O contexto da moeda desaparece, e sistemas downstream tratam um valor em USD como um número sem unidade.
Por que acontece: Símbolos de moeda ($, €, £, ¥, R$) são tipograficamente distintos dos dígitos — geralmente são definidos em uma tipografia ou peso diferente, e ficam na mesma linha de base do número, mas com um perfil visual diferente. Quando um mecanismo de OCR tokeniza uma linha, ele precisa decidir se o "$" faz parte do número ou é uma entidade separada. Tokenizadores baseados em proximidade frequentemente mesclam o símbolo com o dígito inicial, produzindo um único token como "$156" que o mecanismo então lê incorretamente, porque o classificador interno de caracteres tem menor confiança no símbolo "$" do que nos dígitos que o seguem. O mecanismo resolve a confusão descartando o caractere de baixa confiança — o símbolo de moeda — e mantendo os dígitos de alta confiança.
Alguns mecanismos de extração baseados em visão lidam com isso melhor do que o OCR tradicional, porque processam todo o contexto visual em vez de tokenizar caractere por caractere. Mas mesmo modelos modernos podem ter dificuldades quando o símbolo de moeda e o primeiro dígito compartilham uma caixa delimitadora apertada, ou quando o símbolo aparece em uma tipografia incomum (como o "$" curvado em algumas impressoras de recibos).
Como corrigir: Implemente um mapa de normalização de símbolos de moeda como etapa de pós-extração. Defina o formato de saída esperado para campos monetários — por exemplo, "USD 156.00" ou "$156.00" — e normalize os valores extraídos para esse formato:
# Símbolos de moeda conhecidos por contexto do documento
currency_map = {
    'USD': r'[\$]',
    'EUR': r'[€]',
    'GBP': r'[£]',
    'JPY': r'[¥]'
}
# Se o valor extraído tem dígitos, mas nenhum símbolo,
# atribua a moeda esperada a partir dos metadados do documento
if re.match(r'^\d+\.\d{2}$', value) and not has_currency_prefix(value):
    normalized = f"{doc_currency} {value}"
O ponto-chave é não depender do OCR para decidir se o símbolo pertence — defina isso no nível do esquema de extração e valide contra ele.
Modo de Falha 3: Confusão do Separador de Milhar Inverte o Decimal
Sintomas: Uma fatura dos EUA com "1.234,56" é extraída como "1.23456" ou "1234.56" (a vírgula é perdida). Um documento europeu com "1.234,56" é extraído como "1.23456" ou "1234.56" — o ponto é tratado como decimal, inflando o valor em 1.000. O mesmo sinal de pontuação significa coisas opostas dependendo da localidade, e o mecanismo de OCR não sabe qual regra aplicar.
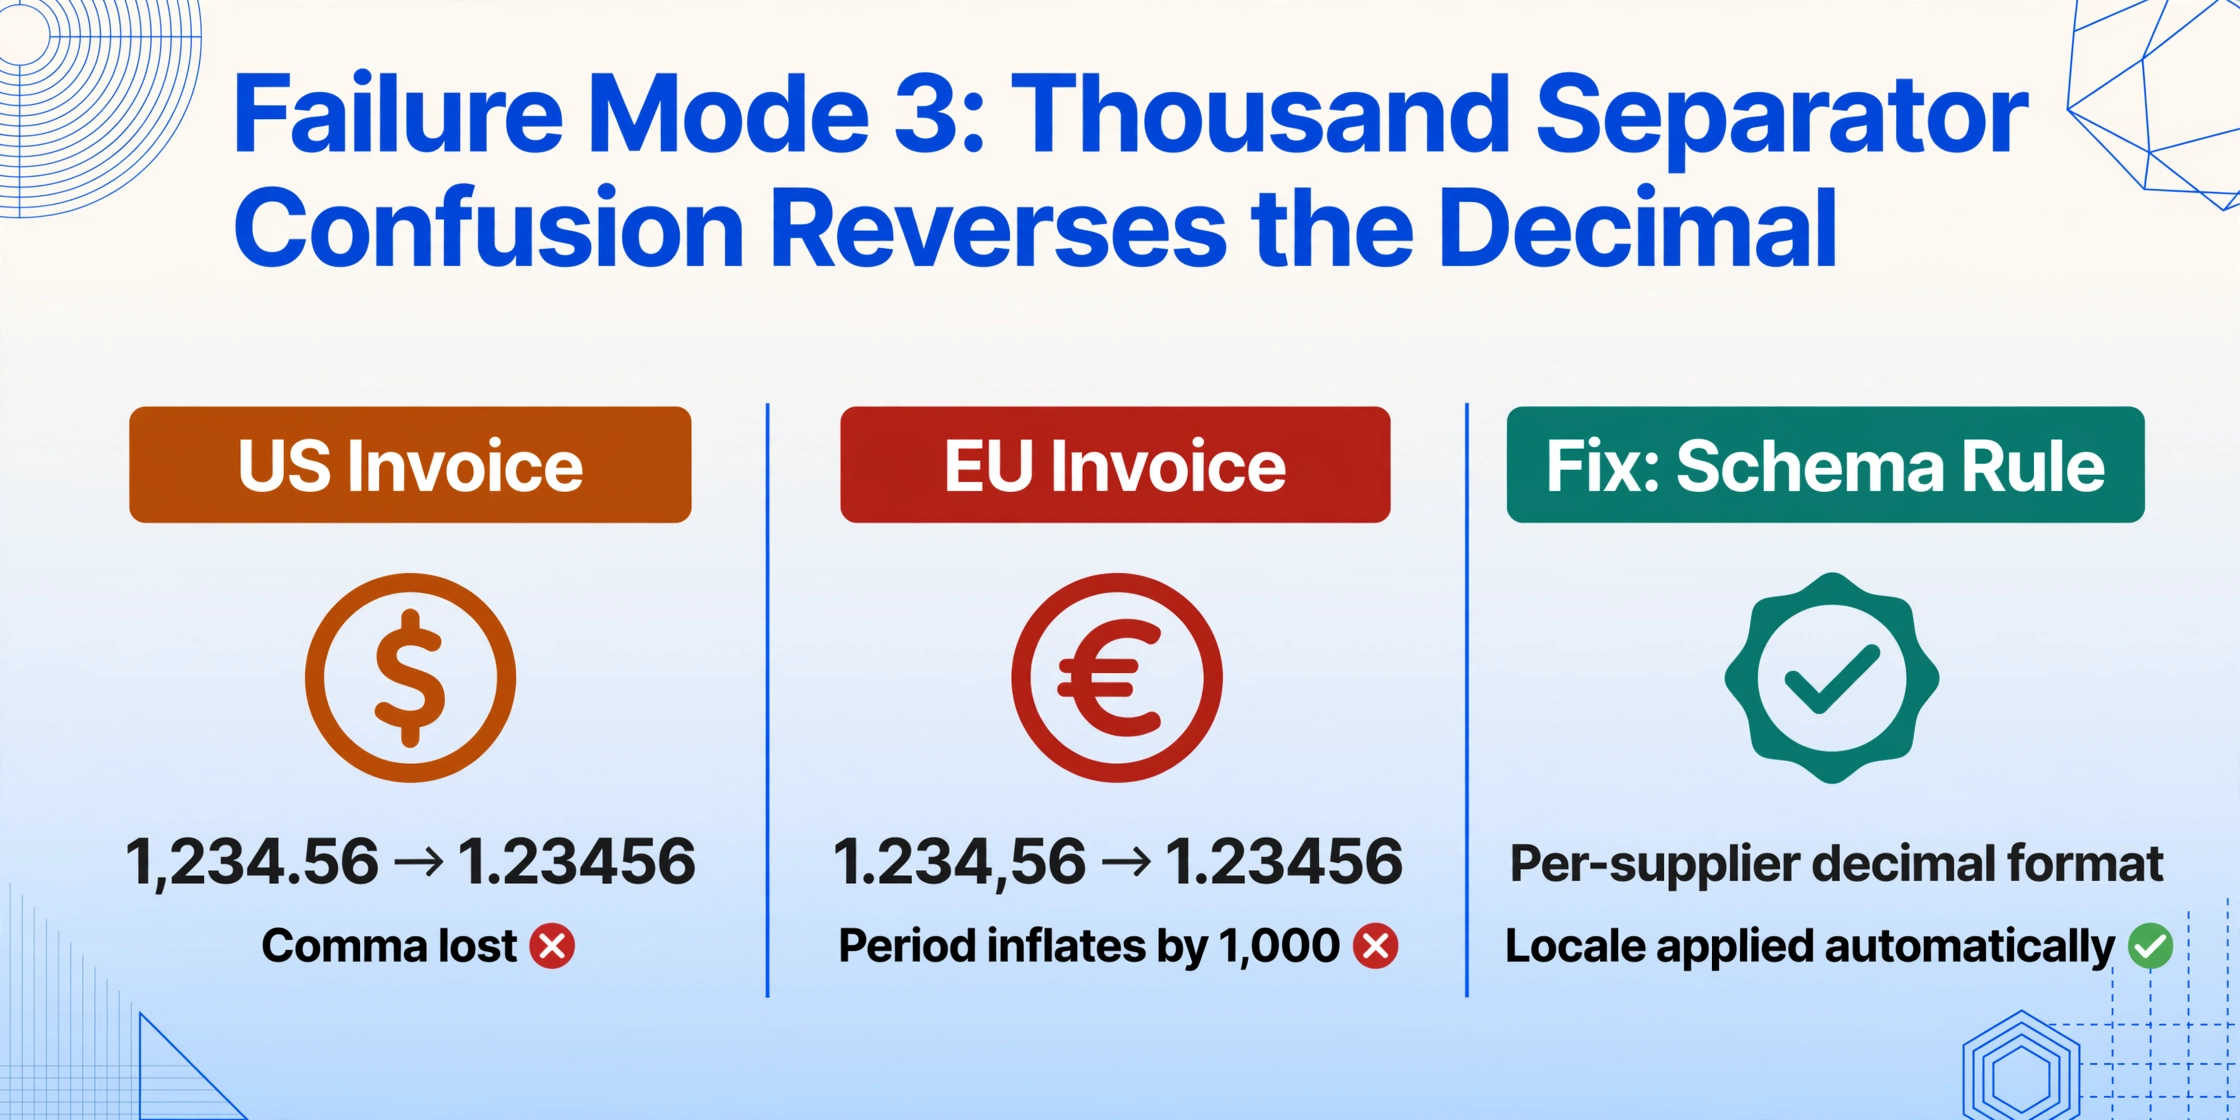
Por que isso acontece: Os mecanismos de OCR tratam os sinais de pontuação como caracteres, não como notação matemática. Um ponto e uma vírgula são caracteres distintos com perfis visuais conhecidos, mas o mecanismo não tem conhecimento nativo de qual deles é o separador decimal na localidade do documento. Isso não é uma limitação de um único mecanismo — toda ferramenta de OCR convencional, do Tesseract às APIs comerciais em nuvem, processa a pontuação da mesma forma: ela gera o que vê, deixando a interpretação dessa pontuação para a lógica downstream. O resultado é que o mesmo pipeline de extração pode produzir $1.234,56 em uma fatura dos EUA e 1.234,56€ em uma fatura alemã — e ambos serão analisados incorretamente se o sistema downstream não souber qual convenção esperar.
Esse problema se agrava quando você processa faturas de vários países. Um único lote de 50 faturas de fornecedores dos EUA, alemães e franceses pode conter três convenções decimais diferentes. O mecanismo de extração não detecta automaticamente qual convenção se aplica a qual documento.
Como corrigir: Duas abordagens. A primeira é no nível do esquema: defina o formato decimal esperado por fornecedor ou por tipo de documento antes da extração ser executada. Se você sabe que as faturas do seu fornecedor alemão usam vírgula decimal, configure uma regra de análise que interprete vírgulas como separadores decimais e pontos como separadores de milhar para esse grupo de documentos.
A segunda abordagem é a validação de magnitude — uma técnica descrita em profundidade no nosso artigo sobre quedas de precisão na extração multilíngue, que aborda como a variação de formato entre fontes de documentos cria erros em cascata. Na prática, verifique se o total extraído está dentro de uma faixa razoável da soma dos itens de linha. Um total de $1.234.567,89 quando os itens de linha somam $12.345,67 é um indicador claro de inversão entre separador decimal e de milhar.
# Valida: o total corresponde à soma dos itens de linha
# dentro de uma tolerância razoável?
line_sum = sum(line_items)
total = extracted_total
# Se o total for ~1000x line_sum, o decimal foi lido como separador de milhar
if abs(total - line_sum) / max(line_sum, 1) > 100:
    flag_decimal_ambiguity(extracted_total)
Modo de Falha 4: Sinal Negativo e Parênteses — O Indicador Invisível
Sintomas: Um aviso de crédito mostrando "(156,00)" é extraído como "156,00" sem sinal negativo. Um saldo de extrato bancário de "1.247,30-" é extraído como "1.247,30" — o menos final é descartado. O número está tecnicamente correto, mas o sinal está errado, transformando um crédito em débito e um reembolso em cobrança.
Por que acontece: Motores de OCR tratam parênteses como caracteres de pontuação independentes. Quando um número está entre parênteses — a notação contábil padrão para valores negativos — o parêntese de abertura é lido como um caractere separado antes do primeiro dígito, e o de fechamento como um caractere separado após o último dígito. Durante a extração de dados, esses parênteses são frequentemente descartados por não corresponderem à classe de caracteres esperada para um campo numérico. O mesmo se aplica a sinais de menos finais: posicionados após os dígitos, ficam fora do token numérico e são classificados como um fragmento de texto separado que a lógica de extração nunca associa ao número.
Como corrigir: Defina regras de detecção de sinal no nível do campo. Se o valor extraído aparecer em um campo que normalmente contém créditos, descontos ou ajustes negativos — ou se o documento original contiver parênteses em torno de um valor monetário — aplique uma inversão de sinal após a extração. Combine isso com uma convenção de nomenclatura de campos: uma coluna chamada "Valor do Crédito" ou "Desconto" deve esperar um valor absoluto e aplicar um sinal negativo automaticamente, independentemente do que o OCR retornou.
# Se o contexto do documento indicar um campo de magnitude negativa
# e o valor extraído for positivo, inverta o sinal
negative_context_fields = ['credit_memo', 'discount', 'refund', 'adjustment']
if field_name in negative_context_fields and extracted_value > 0:
    extracted_value = -extracted_value
Modo de Falha 5: Sobrescrito e Subscrito — Centavos Que Desaparecem Entre Linhas
Sintomas: Uma etiqueta de preço com "$9999" (significando $99,99, com centavos em sobrescrito) é extraída como "$99" ou "$9900." Um valor de imposto impresso em sobrescrito minúsculo ao lado de um subtotal desaparece completamente. O número base está correto, mas a parte fracionária que define o valor monetário preciso desaparece.
Por que acontece: Caracteres sobrescritos compartilham a mesma região horizontal do número principal, mas ficam acima da linha de base em uma fração do tamanho — tipicamente 40–60% do tamanho do ponto dos dígitos principais. Motores de OCR os detectam como uma linha ou fragmento de texto separado porque a posição vertical se desvia da linha de base principal. Na extração de texto, esse fragmento é atribuído a uma linha de saída diferente ou descartado durante a análise de layout como um valor atípico. A notação de centavos comum em etiquetas de preço de varejo e alguns itens de linha de faturas é a vítima mais frequente.
Valores subscritos — menos comuns em contextos monetários, mas frequentes em alíquotas de impostos e códigos de referência — enfrentam o mesmo problema na direção oposta: caracteres abaixo da linha de base são segmentados como regiões de texto independentes e perdem sua associação com o número principal.
Como corrigir: A abordagem mais prática é combinar todos os fragmentos de texto que compartilham a mesma posição horizontal dentro de um intervalo vertical restrito e, em seguida, validar o valor combinado com padrões monetários esperados. Se um número principal "99" for seguido por um sobrescrito "99" na mesma região de coluna, a combinação "99,99" é um valor monetário válido. Implemente isso como uma regra de mesclagem espacial: qualquer fragmento de texto dentro de 150% do intervalo de coordenada X do número principal e dentro de um deslocamento vertical definido deve ser mesclado ao valor do campo extraído.
# Mesclar fragmentos na mesma região horizontal
# dentro de uma faixa vertical restrita
def merge_superscript(main_number, fragments, y_threshold=15):
    """Combinar aglomerado de dígitos principal com fragmentos próximos."""
    combined = main_number
    for frag in fragments:
        if abs(frag.y - main_y) < y_threshold and \
           abs(frag.x - main_x) < main_width * 0.5:
            combined += frag.text
    # Validar após mesclagem
    if re.match(r'^\d+\.\d{2}$', combined):
        return combined
    return main_number  # retornar ao original se a mesclagem for inválida
Quando Escalar: Os Limites Reais das Correções Automatizadas
As cinco correções acima cobrem a maioria das falhas de ponto decimal e símbolo de moeda. Mas existe uma categoria de documento em que nenhuma regra de pós-processamento consegue recuperar o valor correto de forma confiável: documentos em que o ponto decimal é fisicamente menor que a resolução mínima que o método de captura consegue reproduzir. Um ponto decimal em um recibo térmico de 72 DPI tem aproximadamente 2 pixels de largura. Nesse tamanho, a informação literalmente não existe na imagem para nenhum mecanismo — OCR tradicional ou IA de visão — ser lida de forma confiável.
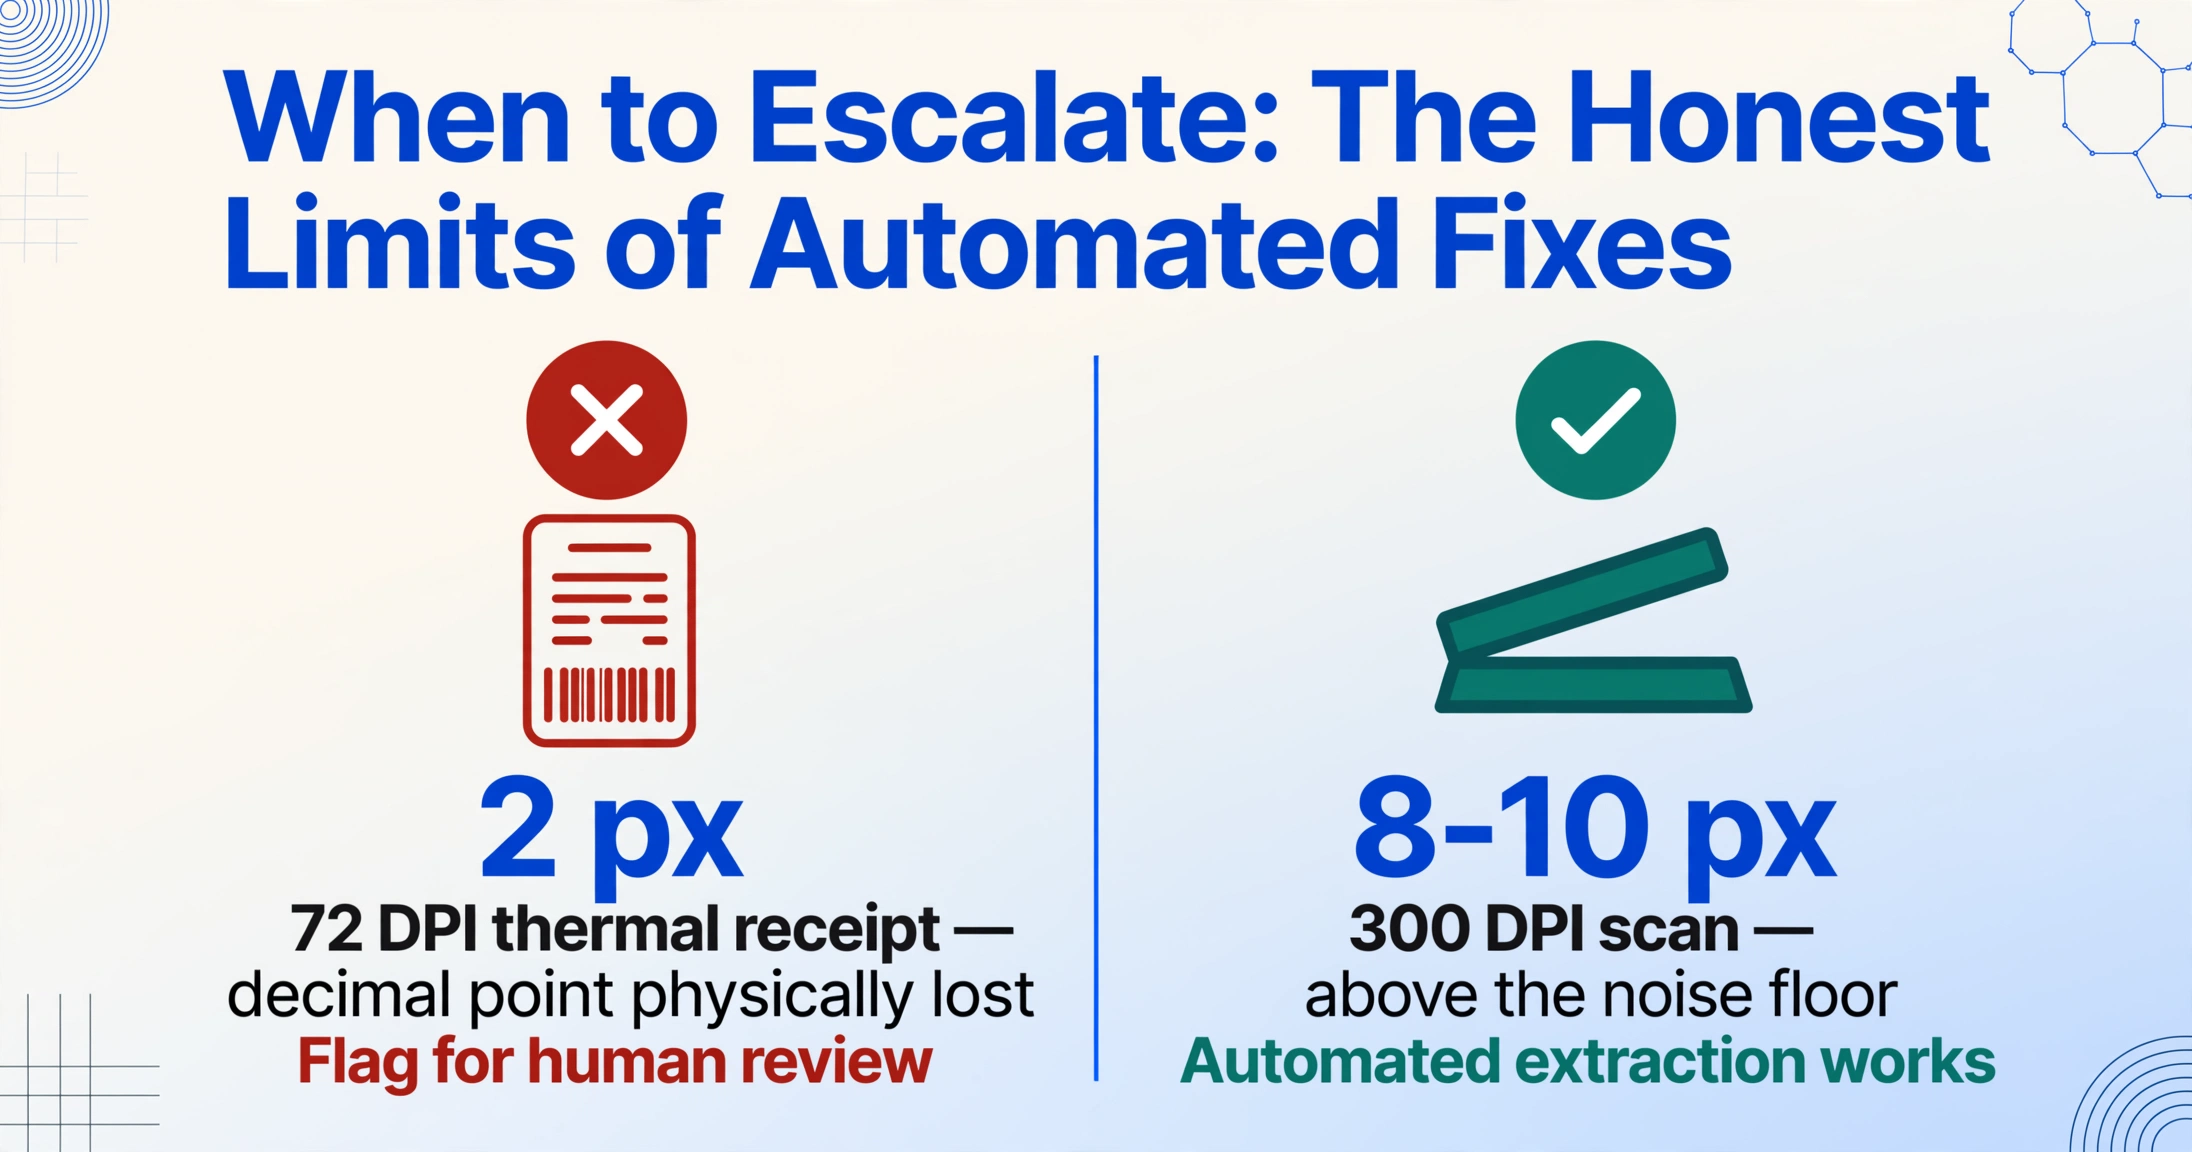
Se você trabalha com recibos térmicos, documentos enviados por fax ou fotocópias de segunda geração, aceite que alguns pontos decimais exigirão verificação manual. A abordagem prática é sinalizar todo valor monetário extraído que falhe em uma verificação de magnitude — total fora do intervalo esperado, itens que não somam ao total, número de casas decimais inconsistente com a moeda — e encaminhar essas sinalizações para um revisor humano. Uma revisão de 30 segundos dos valores sinalizados é mais rápida e confiável do que tentar ajustar o pós-processamento para recuperar informações perdidas no momento da captura.
Para equipes que processam documentos que chegam consistentemente em baixa resolução, o investimento mais eficaz não é uma ferramenta de extração melhor — é um padrão de digitalização que exija 300 DPI ou mais para documentos recebidos. A 300 DPI, um ponto decimal ocupa de 8 a 10 pixels, o que está acima do limite de ruído de todos os mecanismos de extração modernos.
Perguntas Frequentes
Ferramentas de extração por IA leem pontos decimais em recibos térmicos?
Ferramentas modernas de visão computacional conseguem ler pontos decimais em recibos térmicos quando a qualidade da impressão é boa e a imagem é capturada com resolução suficiente (idealmente 300 DPI ou mais). No entanto, recibos térmicos têm contraste naturalmente baixo e a impressão desbota com o tempo. Em tamanhos de fonte abaixo de 8 pontos, o ponto decimal pode ser fisicamente pequeno demais para qualquer sistema distinguir do ruído de fundo. A resposta honesta: se um humano precisa apertar os olhos para ver o ponto decimal na foto do recibo, a IA também vai errar.
Por que meu OCR sempre remove o símbolo $ dos valores extraídos?
Símbolos de moeda são removidos com mais frequência quando aparecem muito próximos ao primeiro dígito, sem espaço separador, ou quando o símbolo usa uma tipografia diferente dos dígitos ao redor. O motor de OCR tem baixa confiança no caractere do símbolo e resolve mantendo os dígitos de alta confiança e descartando o símbolo de baixa confiança. Corrija isso definindo uma regra de normalização de símbolo de moeda no seu esquema de extração: especifique a moeda esperada por fonte de documento e aplique-a automaticamente a todo valor extraído, em vez de depender do OCR para preservar o símbolo.
Regex pós-extração corrige todos os erros de ponto decimal?
Regex pode capturar muitos erros de ponto decimal, mas não corrige todos. Se o ponto decimal foi perdido durante a captura do OCR e o valor extraído é "15600" em vez de "156,00", um regex não consegue determinar onde o decimal pertence sem contexto adicional — o valor poderia ser 15.600, 156,00 ou 1560,0 dependendo do que o documento original dizia. Regex funciona bem quando combinado com validação de magnitude (comparando com somas de itens ou faixas esperadas) ou quando o formato do documento é conhecido antecipadamente (ex.: todos os preços têm exatamente duas casas decimais). Para documentos de formato desconhecido, regex é um mecanismo de sinalização, não de correção.
Qual resolução preciso usar no escaneamento para evitar perda de ponto decimal?
300 DPI é o padrão da indústria para OCR confiável em documentos impressos. A 300 DPI, um ponto decimal de 10 pontos ocupa aproximadamente 8–10 pixels de largura — bem acima do limite de ruído dos motores modernos de OCR e extração por IA. A 150 DPI (comum para fax e arquivamento de digitalizações), o mesmo ponto decimal cai para 4–5 pixels e se torna limítrofe. A 72 DPI (típico para capturas de tela de documentos em celular), o ponto decimal pode ter apenas 2 pixels de largura e é efetivamente invisível para qualquer sistema de extração. Se seus pontos decimais estão sumindo consistentemente, verifique primeiro a resolução do seu escaneamento.
Próximos Passos: Do Diagnóstico à Prevenção
Um ponto decimal ausente não é um evento aleatório — é o resultado previsível de um dos cinco modos de falha conhecidos. A diferença entre uma equipe que detecta esses erros e uma que não detecta não é a ferramenta que usam; é se eles têm um framework de diagnóstico. Quando você sabe qual dos cinco modos de falha está lidando, a correção geralmente é uma regra de pós-processamento — não um motor de IA diferente.
Comece com uma auditoria simples: pegue os últimos 50 valores monetários extraídos do seu pipeline e classifique cada erro por modo de falha. Se 80% dos seus erros caem em uma ou duas categorias, você tem uma correção focada que custa nada além de algumas linhas de lógica de validação. Se os erros estão espalhados por todos os cinco modos, o problema provavelmente é a qualidade da captura — e a correção é um padrão de digitalização, não uma mudança de ferramenta.
Para uma análise mais profunda de como a precisão da extração varia por formato de documento e como projetar campos que minimizem ambiguidade, veja nosso guia sobre erros de design de campo que produzem números extraídos incorretos e a análise de como a variação de formato entre fontes de documentos cria quedas de precisão. Entre esses três diagnósticos — design de campo, variação de formato e agora modos de falha em nível de símbolo — você tem um framework completo para depurar a precisão da extração em todos os níveis do pipeline.