RMA返品データを処理する方法
Excel追跡用
全米小売業協会(NRF)によると、2025年に米国の小売業者は8,499億ドルの返品を処理しました。その返品はすべてフォームから始まります。RMA伝票、返品承認PDF、時には返品箱に手書きで添えられたメモも。皮肉なことに、これらのフォームに記載されたデータこそが将来の返品削減に最も価値のある情報でありながら、ほとんどの現場でスプレッドシートにまで届いていません。

重要ポイント
- RMAフォームの項目をスプレッドシートに入力するだけでフルタイムスタッフ2名を費やしているのに、理由コードのデータが届く頃には不良バッチを次の出荷前に発見するには遅すぎる。
- テンプレートベースの抽出は、ベンダーがフォームのレイアウトを変更した瞬間に機能しなくなります。だからこそ、15種類もの異なるRMA形式を抱える現場では、どんなにテンプレートを構築しても返品のほぼ半数が自動化できないのです。
- 列名を一度定義すれば、同じ抽出処理がすべての形式(ポータルPDF、手書き伝票、ベンダーフォーム)を読み取ります。メンテナンスやトレーニング用のテンプレートは1つも不要です。
RMAデータの盲点:返品がフォームとスプレッドシートの間で崩れる理由
返品管理ソフトウェアは、RMAプロセスの顧客向けの半分を解決しました。Loop Returns、Happy Returns、Narvarのポータルでは、買い物客がサポートにメールすることなく返品を開始し、ラベルを印刷し、返金を追跡できます。しかし、その自動化はデータ層で止まります——RMAフォームの情報が、倉庫チーム、返品処理担当者、またはERPシステムが対応できるスプレッドシートの行になる必要がある時点です。
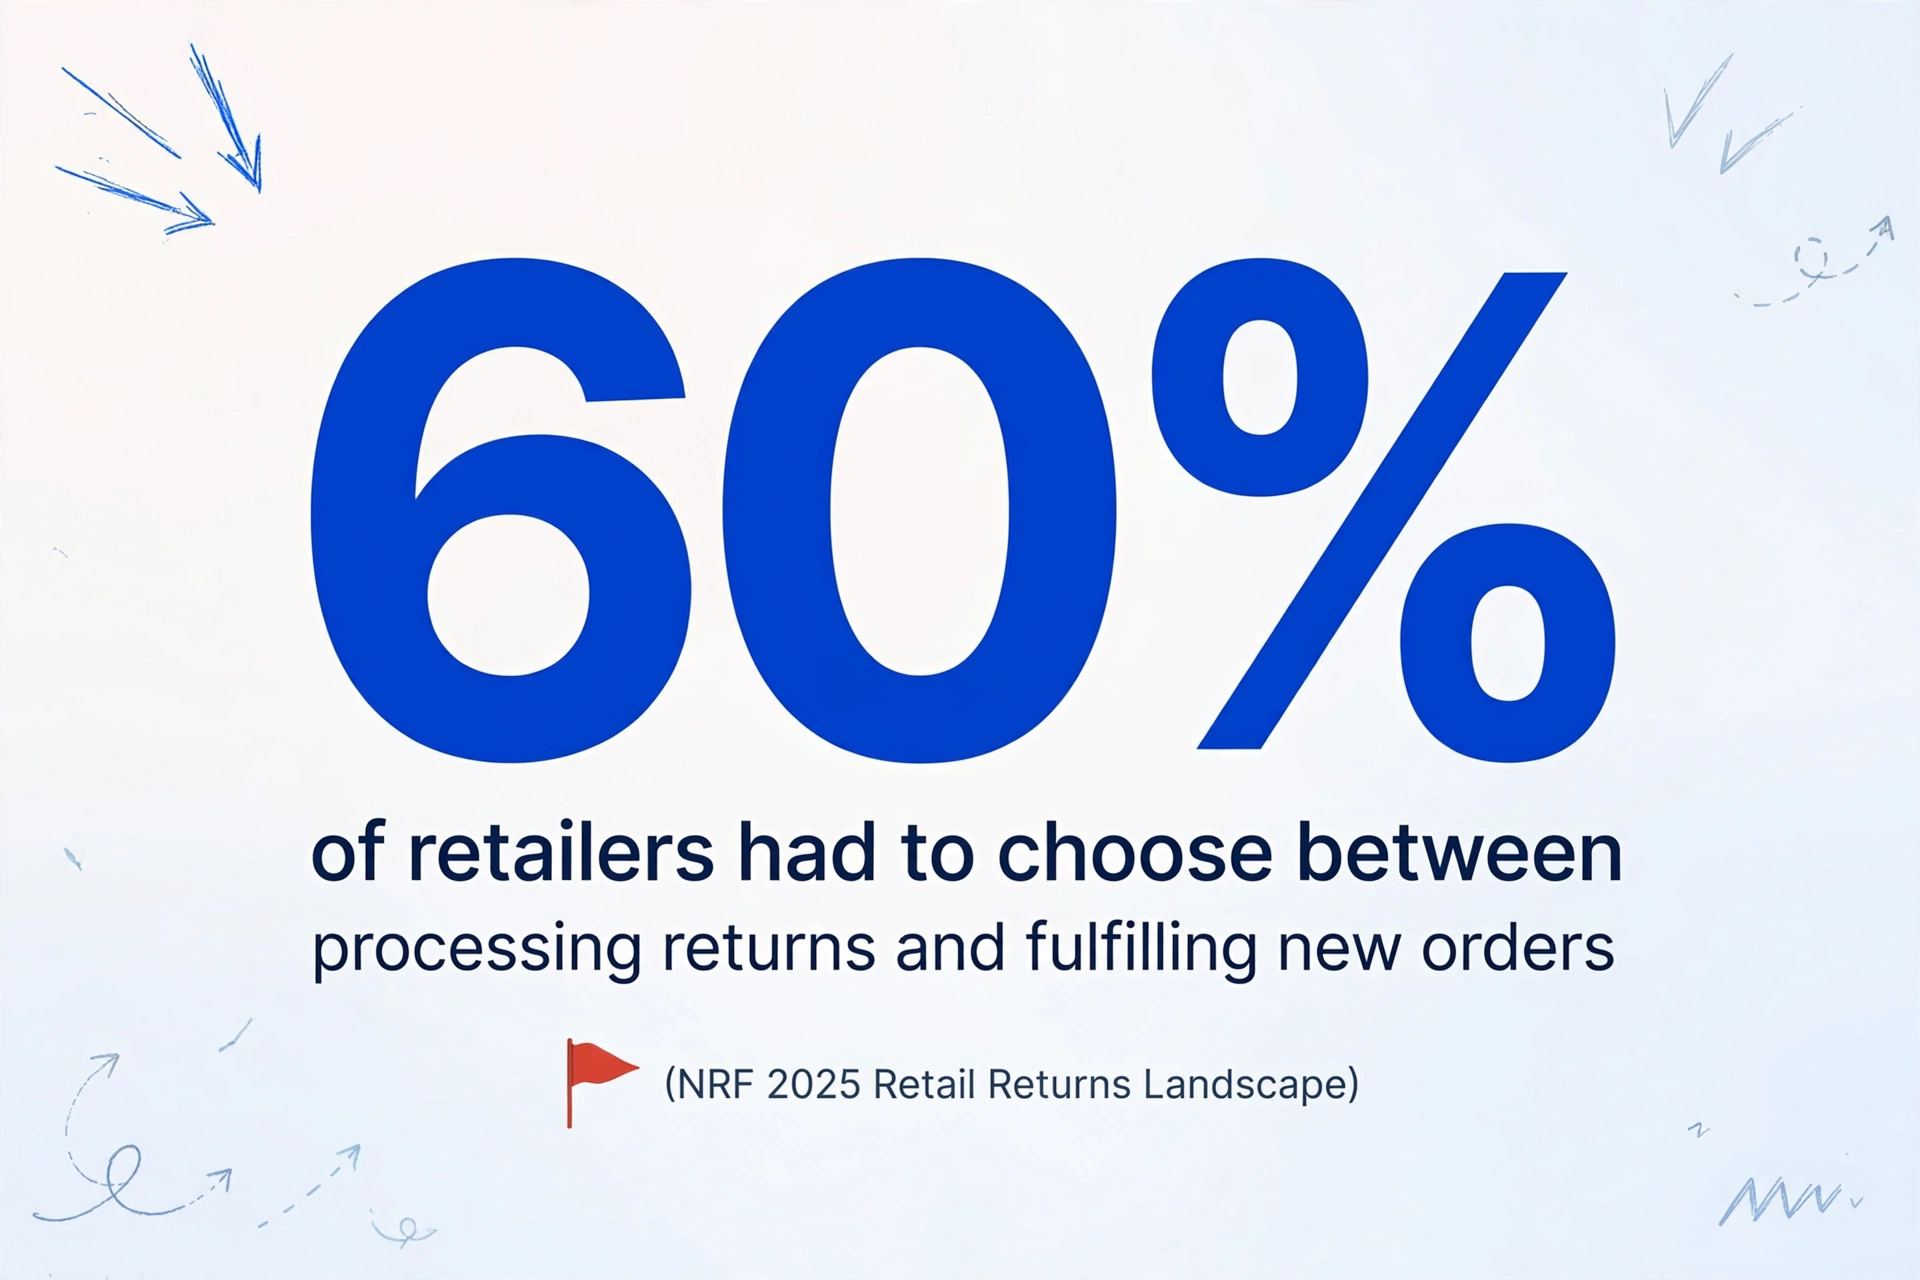
このギャップが重要である理由は数字が示しています。全米小売業協会(NRF)の2025年リテール返品レポート(Happy Returns(UPS傘下)との共同制作)によると、小売業者の60%が返品処理と新規注文のフルフィルメントのどちらかを選ばざるを得なかったことがあります。全返品の9%が不正として分類されており——構造化された追跡がなければ、正当な返品と不正な返品を区別することは推測になってしまいます。2033年までに3.18兆ドル規模になるとされる業界を代表するリバース・ロジスティクス協会は、最近の年次会議でデータ駆動型の処分を中心テーマに掲げています。
返品ポータルと倉庫現場の間にあるものは、驚くほどローテクです:誰かがRMAフォームを開き——顧客ポータルからのPDF、B2B販売業者からのスキャンされた返品伝票、箱の中に同梱された手書きの承認書——そしてフィールドを手動で追跡スプレッドシートに入力します。r/Netsuiteのある投稿は状況を正確に説明しています:「RMAプロセスは2人分のフルタイムの仕事になっています。すべての返品は顧客からのメールで始まり、誰かが手動で承認し、その後手動でラベルを生成します。」r/supplychainの販売業者はもっと率直に述べています:彼らの返品プロセスは「彼らを食い尽くしていた」——手動のRMAワークフロー、ベンダークレジット調整の悪夢、そして倉庫のボトルネック。
返品自動化に欠けているのは返品ポータルではありません。抽出層——フォームを構造化データに変えるステップ——こそが欠けているのです。
RMAフォームに実際に記載されているもの — 手入力ではスケールできない理由
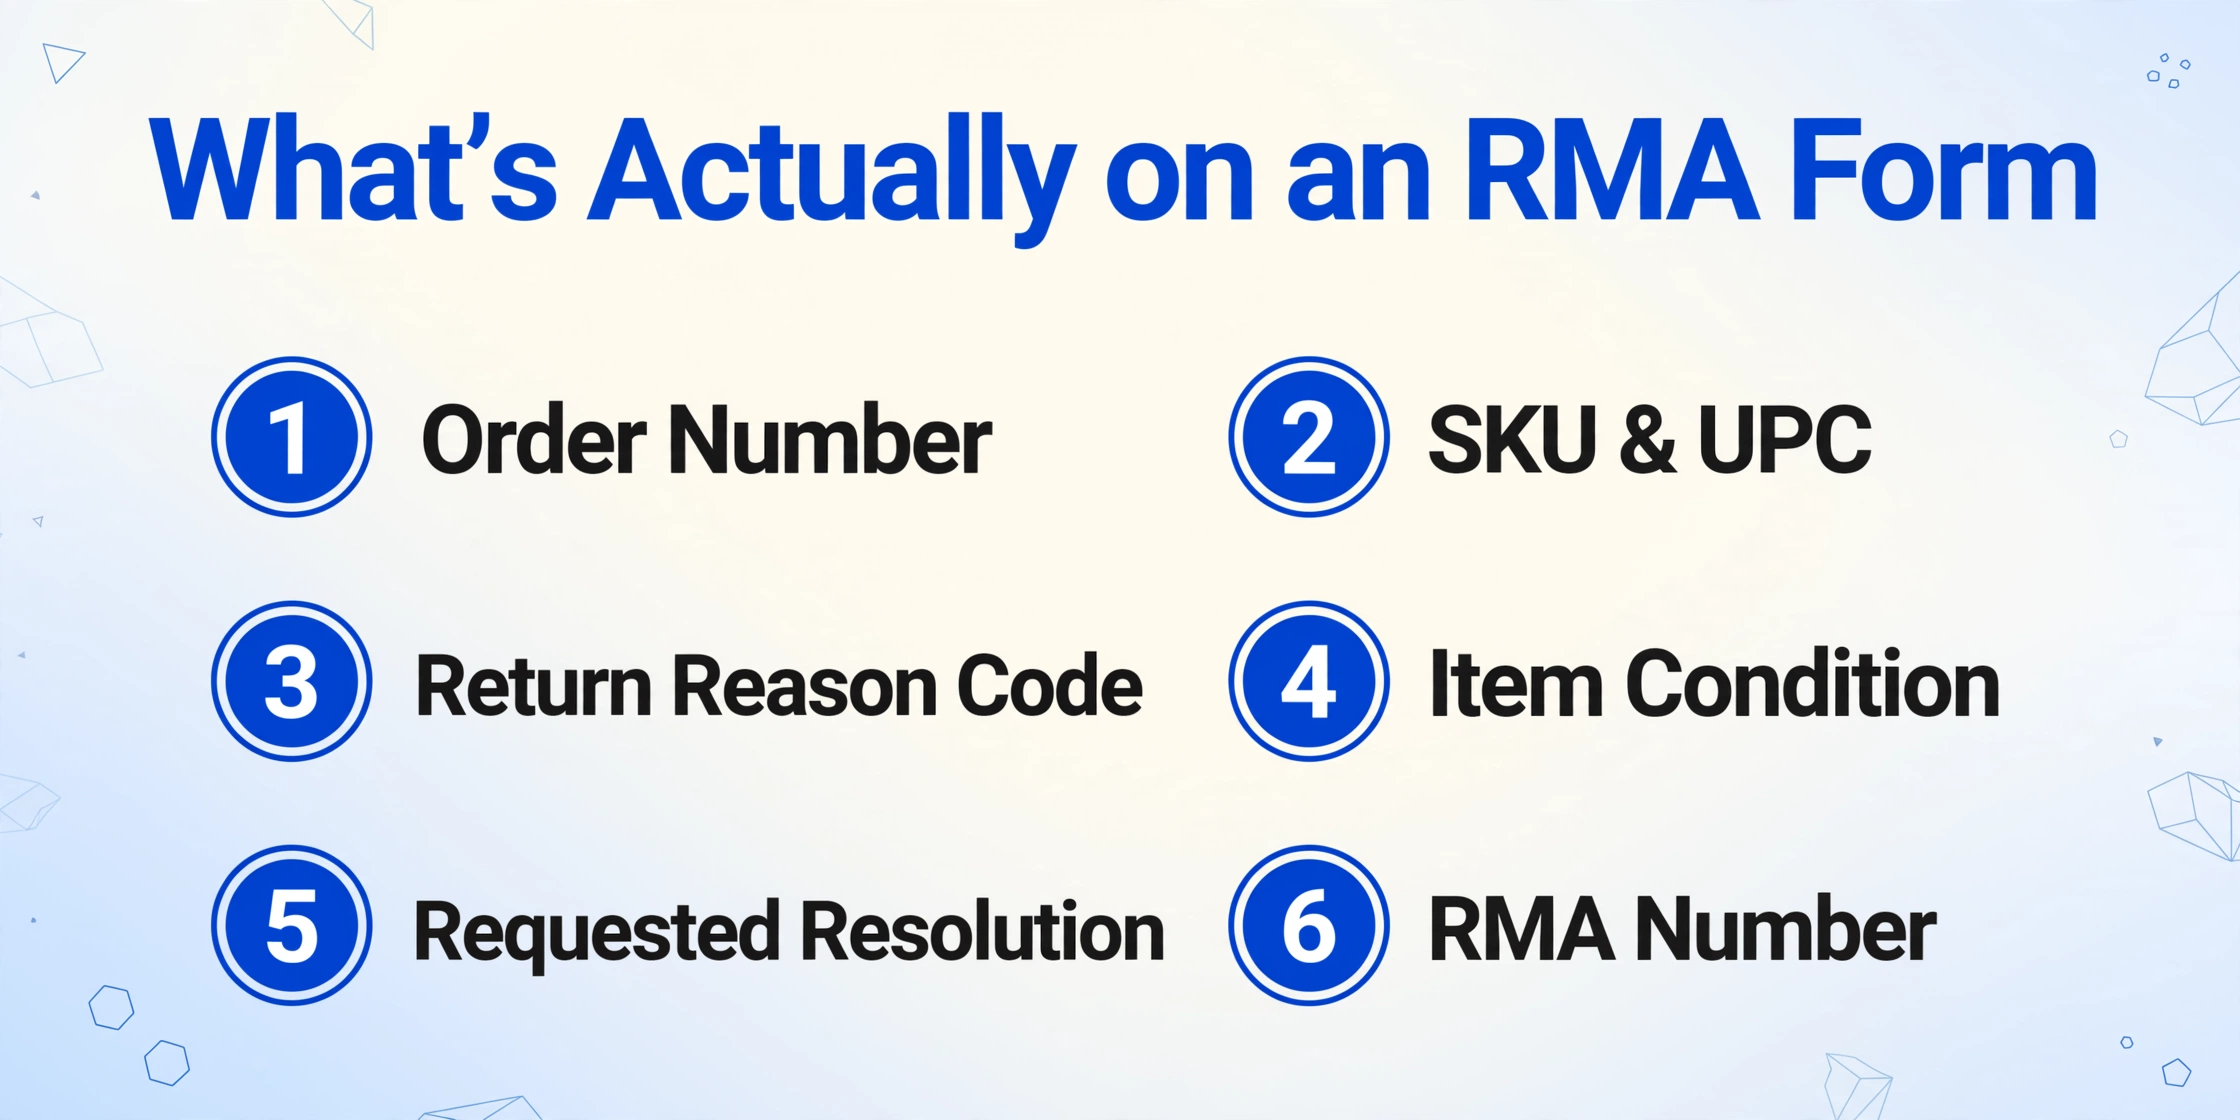
標準的なRMAフォームは、ほとんどの人が認識している以上に多くの情報を取得します。単に「顧客が商品を返品したい」というだけではありません。完全なRMAフォームには、注文番号、商品SKUとUPC、返品数量、返品理由コード(不良品、サイズ違い、説明と異なる、輸送中の破損、気が変わった)、到着時の商品状態(未開封、開封済み、破損、付属品欠品)、希望する対応(返金、交換、ストアクレジット、修理)、そして割り当てられたRMA番号自体が含まれます。B2B返品の場合 — IMARC Groupのデータによると2024年のリバースロジスティクス収益の35.1%を占めています — フォームには契約固有の条件、クレジットノート参照、および大量返品数量も含まれます。
そのフォームで業務上最も価値のあるフィールドは理由コードです。特定のSKUで「不良品」が急増した場合、それは品質管理のシグナルです。衣料品ラインで「サイズ違い」が返品の大半を占める場合、それはサイズガイドの問題です。LateShipmentのRMAデータ分析によると、理由コードレベルの追跡は、総合返品率では隠れてしまう問題を明らかにします — 全体的な返品率4%を生む製品ローンチは問題ないように見えるかもしれませんが、そのSKUだけで「説明と異なる」が2%から18%に跳ね上がったことがわかるまでは。
しかし、理由コードデータをスケールして取得するには、フォームから抽出する必要があります。すべての返品理由コードが手入力されている場合 — PDF、スキャンされた伝票、手書きのメモから — データは遅れて、不整合に、そしてしばしばまったく届きません。ReturnProの内部調査によると、顧客はドロップダウンメニューにリストされた最初の理由を不釣り合いに選択することがわかり、顧客向けフォームからの手動データはすでに汚染されていることを意味します。正確な理由コードデータを取得するには、抽出に加えて構造化された分類ロジックが必要です — 手入力では強制できないものです。
AI抽出がテンプレートなしでRMAフォームを読み取る仕組み
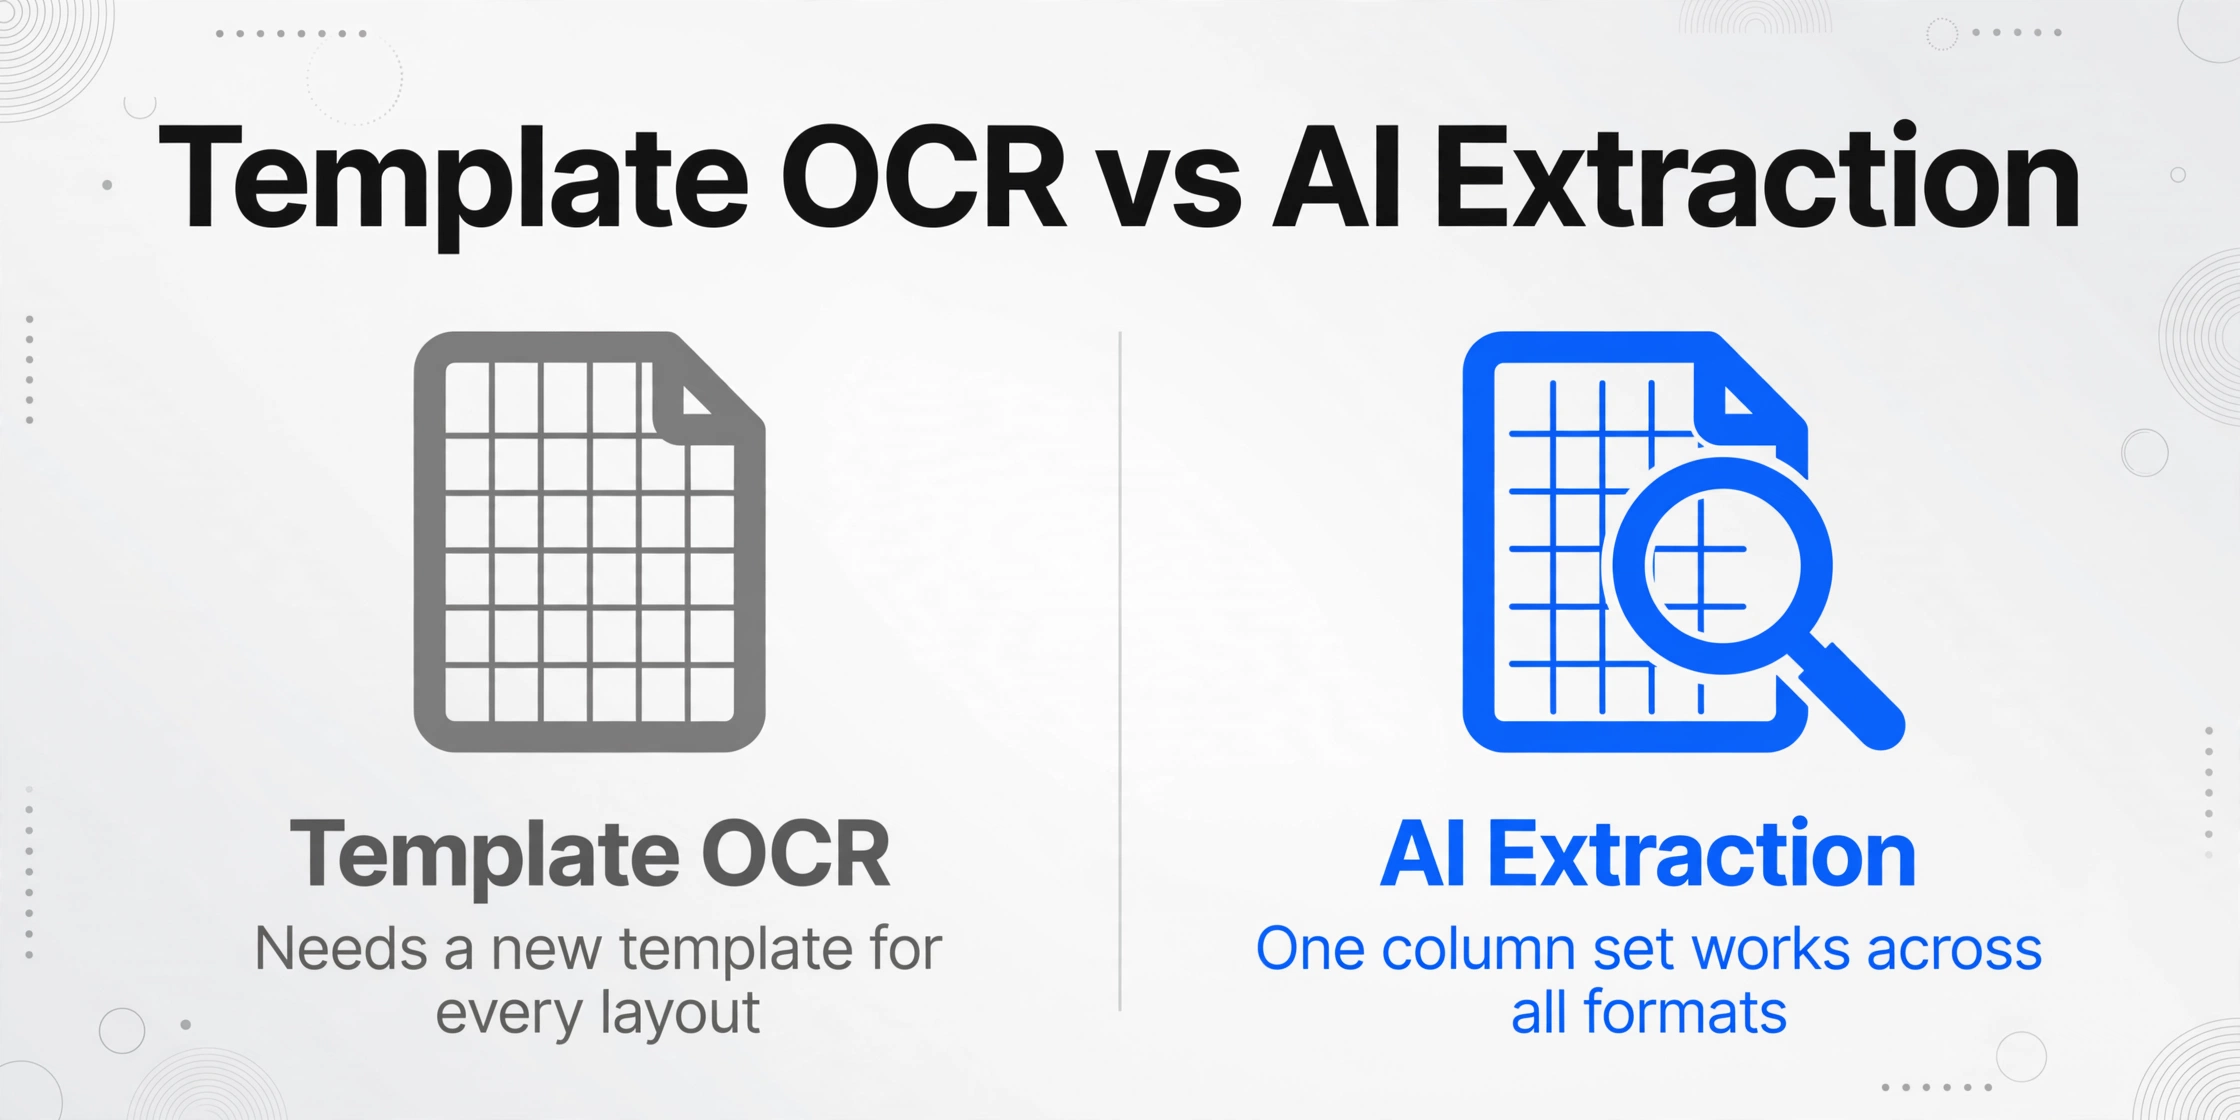
従来のOCRは、文字の画像をテキストストリームに変換してドキュメントを処理します。どのテキストがRMA番号で、どれが返品理由なのかは判別できず、ただ単語の羅列を渡すだけです。テンプレートベースのツールは、各フィールドの座標を定義できる点で一歩進んでいますが、フォームのレイアウトが変わるとすぐに機能しなくなります。あるRMAは返品ポータルが生成したPDF、次は手書きの伝票の写真、3つ目はベンダーのERPシステムからスキャンされたB2B承認フォームという具合です。各形式には新しいテンプレートが必要になり、フォームのバリエーションごとにテンプレートを維持管理することが、2人体制のRMA処理を恒久的な人員要件に変えてしまうのです。
AIベースのカスタム列抽出は動作が異なります。システムに各フィールドをページ上のどこで見つけるかを指示する代わりに、出力スプレッドシートに必要な列名を入力して、何を探しているかを伝えます。「RMA番号」「返品理由コード」「SKU」「数量」「希望する対応」。AIは各フォームを読み取り、座標ではなく意味に基づいて列名に一致する値を特定し、対応する列に自動入力します。同じ列名セットが、鮮明なPDF、手書きの返品伝票を斜めから撮影した写真、10年前のファイルキャビネットからスキャンした紙のフォームのいずれでも機能します。
これがデータ抽出とテキスト転写の違いです。にじんだペンで「RMA # — 44291 — 理由: 破損」と書かれた手書きのRMAも、ラベルが明確に記載されたポータル生成のPDFと同じように読み取られます。AIは番号とラベルの意味的な関係を理解して「44291」をRMA番号として識別するのであって、テンプレート上の所定の位置に一致させるからではありません。複数の倉庫、複数の販売チャネル、それぞれ異なるRMAフォーム形式で返品を処理するチームにとって、このテンプレート不要のアプローチは、機能するシステムと、最もきれいな60%のフォームしか処理できないシステムとの違いを生み出します。
この仕組みは、フォームに明示的に記載されたフィールドに限定されません。推論列を定義できます。たとえば、「処分カテゴリ」列を「オプション: 再入庫、再生、廃棄、ベンダー返品」と定義します。AIは商品の状態と理由コードを読み取り、ビジネスルールに基づいて推定される処分を割り当てます。フォームに「処分」フィールドが存在しなくてもです。抽出と分類を1回の処理で完了できます。
ステップバイステップ:フォームからスプレッドシートへのRMAデータパイプライン構築
抽出レイヤーは、RMA受付(顧客やパートナーが返品を送信する方法)と運用スタック(WMS、ERP、追跡スプレッドシート)の間に位置します。ここでは、RMAフォームに特化した設定方法を説明します。
RMA抽出列を定義する
運用を支えるフィールドから始めます。標準的なRMA抽出セットには以下が含まれます: RMA番号、注文番号、SKU、返品理由コード、返品数量、商品状態、希望する対応、顧客名。B2B返品を扱う場合は、ベンダー名、クレジットノート参照、契約番号を追加します。推論された処分を扱う場合は、処分(オプション:再入庫 / 再生 / 流動化 / RTV / 廃棄)を追加します。AIは理由コードと状態を使用して、処分を自動的に割り当てます。
RMAフォームを任意の形式でアップロードする
届いたままの形式でアップロードします — 返品ポータルからのPDF、フィールドサービスからの手書き返品伝票の写真、スキャンしたB2B承認フォームなど。前処理やフォーマットごとのテンプレート設定は不要です。AIはレイアウトではなく情報を認識するため、フォーマットをまたいで読み取ります。3つの販売チャネルと15のベンダー返品フォームからの返品を処理する場合、すべてを同じバッチにアップロードしてください — ステップ1で定義した列名はすべてに適用されます。
バッチを処理する
AIが各フォームを処理します — 通常1ページあたり5〜10秒 — 定義したフィールドを抽出し、設定されている場合は処分カテゴリを自動割り当てします。処理は並行して行われるため、50件のRMAフォームのバッチは数時間ではなく数分で完了します。フォームの処理が完了するにつれて、結果が行ごとに表示されます。
Excelにエクスポートし、運用スタックにルーティングする
結合されたスプレッドシートをダウンロードします — RMAフォームごとに1行、定義したすべての列が含まれます。出力はExcel(XLSX)またはCSVで、WMS、ERP、返品管理プラットフォームへのインポートにそのまま使用できます。ソースファイル名列により、すべての行を元のフォームに遡って追跡でき、フォームからデータまでの監査証跡を提供します。
ファイルは安全に処理され、保存されることはありません。
上記のデモは「RMAフォーム」をドキュメントタイプとして実行されます。ご自身で列名を入力し、サンプルのRMAフォームをアップロードして抽出の動作をご確認ください。毎週数百件の返品を処理する本番バッチでも、追加設定なしで同じワークフローがスケールします。フォームごとの設定も、テンプレートライブラリの管理も不要です。完全なフィールドリスト、混在フォーマットのバッチワークフロー、エクスポートオプションをまとめて確認するには、RMAからExcelへの変換ツールをご覧ください。
返品データの追跡:処分とトレンド分析
RMAデータがスプレッドシートに入ると、それはマージン回収に直接影響するリバースロジスティクス(逆物流)の意思決定の基盤となります。処分 — 返品された商品をどうするかの決定 — は、返品がコストになるか、価値を回収するかを左右します。標準的な処分経路は、再入庫(商品が再販可能在庫に戻る)、再生(再販前に修理が必要)、流動化(セカンダリーチャネルで割引販売)、ベンダー返品(RTV — クレジットのためにサプライヤーへ返送)、廃棄(回収可能な価値がない)です。
各経路の財務結果は異なります。定価での再入庫品は、処理コストを差し引いたほぼ全額を回収します。再生品は通常、元の価値の40〜60%を回収します。流動化されたパレットは10〜20%の回収かもしれません。返品を再入庫に回すか流動化に回すかの違いは、純粋なマージンの差です — しかし、正しい判断をするためには、検査時点で正確な商品状態と理由コードのデータが必要です。
抽出されたRMAデータがスプレッドシートにあれば、ほとんどの返品業務がスキップする分析を実行できます:
- SKU別の理由コード速度。どの製品が最も多い「不良品」返品を生み出していますか?特定のバッチ、それを扱う特定の倉庫、または根本的な設計上の問題ですか?すべての返品にわたって理由コードデータが正規化されていなければ、推測に過ぎません。
- 処分分布。返品の何パーセントが再入庫、再生、廃棄に回っていますか?廃棄率が上昇しているなら、上流で何かが変化しています — サプライヤーの品質、梱包、または返品理由の構成です。
- 処分経路別の処理時間。各返品は、RMA発行から倉庫受領、最終処分までの各段階でどのくらいの時間を費やしていますか?返品業務のベンチマークは、受領から処分まで2〜7日を目標としており、それを超えると毎日残存価値が減少します。
- 複数倉庫の比較。倉庫Aが同じ人員で倉庫Bの2倍の速度で返品を処理している場合、スプレッドシートはプロセス改善の焦点をどこに置くべきか — または、拠点間でフォーム入力品質が異なるかどうかを示します。
スプレッドシートはWMSの代わりにはなりません。それは、あなたが持っているデータ(フォーム)と、返品を正しくルーティングするためにWMSが必要とするデータの間のギャップを埋めます。
返品量が週に数百件に達すると、同じ抽出ワークフローはRMAフォームを単一の返金照合シートにバッチ処理するよう拡張されます — ルーティングと照合フィールドを出力に組み込み、2回目の手動パスで追加するのではなく実現します。
抽出したRMAデータを倉庫スタックと統合する
ほとんどの返品処理業務には、すでにソフトウェアスタックがあります。問題はそれを置き換えるかどうかではなく、いかにクリーンなデータを供給するかです。抽出レイヤーはExcel(XLSX)とCSVで出力しますが、主要なWMSおよびERPはすべてインポートを受け付けます。統合パスはお使いのシステムによって異なります。抽出した列を在庫システムのインポートスキーマにマッピングする方法の詳細な手順については、RMA返品データを在庫システムに取り込むガイドをご覧ください。
NetSuite: 返品チームがすでにNetSuiteでRMAレコードを作成している場合、ボトルネックはデータ入力工程です。フォームのフィールドをNetSuiteのRMAモジュールに入力する作業です。抽出スプレッドシートはNetSuiteのCSVインポートツールに直接インポートでき、抽出した列(RMA番号、SKU、理由コード、処分)をNetSuiteのRMAフィールドにマッピングできます。ユーザーが2名のフルタイム担当者によるRMA問題を説明したr/Netsuiteのスレッドでも、NetSuiteは「レコードを問題なく保持している」と指摘されており、問題は常にレコードへのデータ投入にありました。
ShipStation / Cin7 / Fishbowl: これらのWMSプラットフォームは在庫追跡と注文フルフィルメントをネイティブに処理しますが、返品ルーティング(返品されたアイテムの処分先の決定)は、RMAフォームから得られるデータに依存します。抽出したスプレッドシートをCSVとして返品モジュールにインポートすると、WMSは抽出中に生成した処分列に基づいて、アイテムを再入庫、検疫、再生、またはベンダー返品(RTV)ゾーンにルーティングできます。
Google スプレッドシート / 手動追跡: スプレッドシートで運用している業務では、抽出出力はすでに作業形式になっています。XLSXにエクスポートしてGoogle スプレッドシートで開くだけで、手動入力の工程が直接フィードに置き換わります。同じスプレッドシートで、入力作業は不要です。これは、正式なWMSを持たない中小規模の3PLや倉庫業務で最も一般的な構成です。
3つのアプローチすべてに共通するパターンは同じです。抽出レイヤーが「フォームの読み取り」と「データへの対応」を分離します。データがNetSuite、ShipStation、共有のGoogle スプレッドシートのどこに届くかは下流の判断であり、抽出の設定方法は変わりません。1つの抽出設定で全宛先に対応できます。
FAQ
手書きのRMA伝票でも対応できますか?
はい — すべての手書き文字認識に当てはまる同じ注意点が適用されます。手書き文字が適切な照明の下で人間の読者に判読できるものであれば、AI抽出で通常は読み取れます。にじんだインク、極端に圧縮された筆記体、他の欄に食い込んだ文字は精度を下げます。同じ列ベースの抽出が、設定変更なしで印字フォームと手書きフォームの両方で機能します — どのフォームが手書きでどれが印字かをシステムに伝える必要はありません。手書き文字の抽出性能の詳細については、手書き文字抽出精度を向上させるガイドをご覧ください。
異なる言語のRMAフォームからデータを抽出できますか?
AIは、記載されている言語でドキュメントの内容を読み取ります — RMAフォームが英語、スペイン語、ドイツ語、またはそれらの混合であっても、抽出は各フォームを個別に処理します。列名は、出力にしたい言語で指定してください。アップロード前に言語を事前翻訳したり正規化したりする必要はありません。
RMAフォームのフィールドがすべて同じでない場合はどうなりますか?
それが想定されるシナリオです。カスタム列抽出では、すべてのフォームにすべてのフィールドが含まれている必要はありません。定義したフィールドがフォームにない場合 — たとえば「返品理由コード」を含まない手書き伝票など — そのセルは出力で空白のままになります。システムはギャップを埋めるためにデータを推測したり捏造したりしません。これは特にRMAワークフローで重要です。異なるベンダーのB2B返品フォームは異なるフィールドセットを持つからです。
Loop ReturnsやHappy Returnsのような専用の返品管理プラットフォームを使う場合とどう違いますか?
専用の返品プラットフォームは、顧客向けワークフロー — ブランド化されたポータル、ラベル生成、返金処理 — を処理し、買い物客にセルフサービスの返品体験を提供する必要がある場合に適したツールです。抽出レイヤーは異なる機能を果たします:RMAフォームがどこから来たかに関係なく、そのフォームからデータを引き出します。すべての返品が構造化データ取得を備えた単一のポータルを通る場合、抽出は不要です — ポータルがすでに構造化データを提供しているからです。返品が複数のチャネル — ポータル、メール、B2Bベンダーフォーム、紙の伝票 — を通じて届く場合、抽出がポータルではカバーできないギャップを埋めます。
理由コードと処分フィールドの精度はどのくらいですか?
きれいな印刷済みRMAフォームの場合、注文番号やSKUなどの構造化フィールドの精度は最大99%に達します。理由コードは「不良品」や「サイズ違い」といった短いテキストラベルが一般的で、語彙が限定されているため信頼性が高くなります。最も大きな変動要因は入力品質です。印刷されたRMAフォームの鮮明な写真は、くしゃくしゃの返品伝票のぼやけた写真よりも正確に抽出できます。誤った処分先にルーティングするなど、エラーによるコストが大きいフィールドについては、インポート前にスプレッドシートを簡単に人間が確認することが実用的な予防策です。フィールドタイプ別の精度の詳細については、抽出精度のレイヤー別分析をご覧ください。
最初にAIを自分のRMAフォーム形式にトレーニングする必要がありますか?
いいえ。テンプレート不要の抽出とは、事前のトレーニングやサンプル注釈なしでAIが任意のRMAフォーム形式を処理できることを意味します。列名を一度定義すれば、その同じ列名が、ポータルPDF、スキャンしたベンダーフォーム、手書きの伝票、倉庫で撮影した写真など、あらゆる形式から抽出されます。ゼロトレーニング要件こそが、それぞれ独自のレイアウトを持つ数十の異なるソースからのフォームを処理する返品オペレーションにとって、このアプローチを実現可能にする理由です。
返品自動化が見落としたデータギャップを埋める
リバースロジスティクス業界は、返品の目に見える部分(カスタマーポータル、ドロップオフネットワーク、即時返金、不正検出)に投資を注いできました。自動化されなかったのは、最も地味で労働集約的なステップ、つまりフォームを読んでデータを入力することです。これは、スタック内のすべてのソフトウェアツールと、それらのツールが機能するために必要な実際の情報の間に位置するステップです。
年間8,490億ドルの返品がこのステップを通過します。トレンドを把握できる返品オペレーションと推測に頼るオペレーションの違いは、より良いポータルやより速い返金、より豪華なWMSではありません。それは、RMAフォームのデータが、意味のあるタイミングでスプレッドシートに反映されるかどうかです。
ご自身のRMAフォームでお試しください。バッチをアップロードして、手入力してきたデータが、フォーム1枚あたり5分ではなく5秒で列に表示されるのをご確認ください。
デモにサインアップは不要です