So verarbeiten Sie RMA-Retourendaten
für die Excel-Nachverfolgung
US-Einzelhändler verzeichneten 2025 Retouren im Wert von 849,9 Milliarden US-Dollar, so die National Retail Federation. Jede dieser Retouren begann mit einem Formular – einem RMA-Beleg, einem Retourenfreigabe-PDF, manchmal einem handschriftlichen Zettel in der zurückgesendeten Box. Die Ironie: Die Daten auf diesen Formularen sind der wertvollste Input zur Reduzierung künftiger Retouren, doch in den meisten Betrieben schaffen sie es nie in eine Tabelle.

Wichtigste Erkenntnisse
- Zwei Vollzeitkräfte, die nichts anderes tun, als RMA-Formularfelder in Tabellen einzutippen – und Ihre Grundcodedaten kommen trotzdem zu spät, um eine fehlerhafte Charge vor der nächsten Lieferung abzufangen.
- Vorlagenbasierte Extraktion scheitert, sobald ein Lieferant sein Formularlayout ändert – weshalb Ihre 15 verschiedenen RMA-Formate garantieren, dass fast die Hälfte Ihrer Retouren nie automatisiert wird, egal wie viele Vorlagen Sie erstellen.
- Definieren Sie Ihre Spaltennamen einmal und dieselbe Extraktion liest jedes Format – Portal-PDFs, handschriftliche Zettel, Lieferantenformulare – ohne eine einzige zu pflegende oder zu trainierende Vorlage.
Der RMA-Datenblindfleck: Warum Retouren zwischen Formular und Tabelle scheitern
Retourenverwaltungssoftware hat die kundenseitige Hälfte des RMA-Prozesses gelöst. Portale von Loop Returns, Happy Returns und Narvar ermöglichen es Käufern, Retouren zu initiieren, Etiketten zu drucken und Erstattungen zu verfolgen, ohne jemals den Support per E-Mail kontaktieren zu müssen. Doch diese Automatisierung endet auf der Datenebene – an dem Punkt, an dem Informationen aus einem RMA-Formular zu einer Zeile in einer Tabelle werden müssen, mit der ein Lagenteam, ein Retourenbearbeiter oder ein ERP-System arbeiten kann.
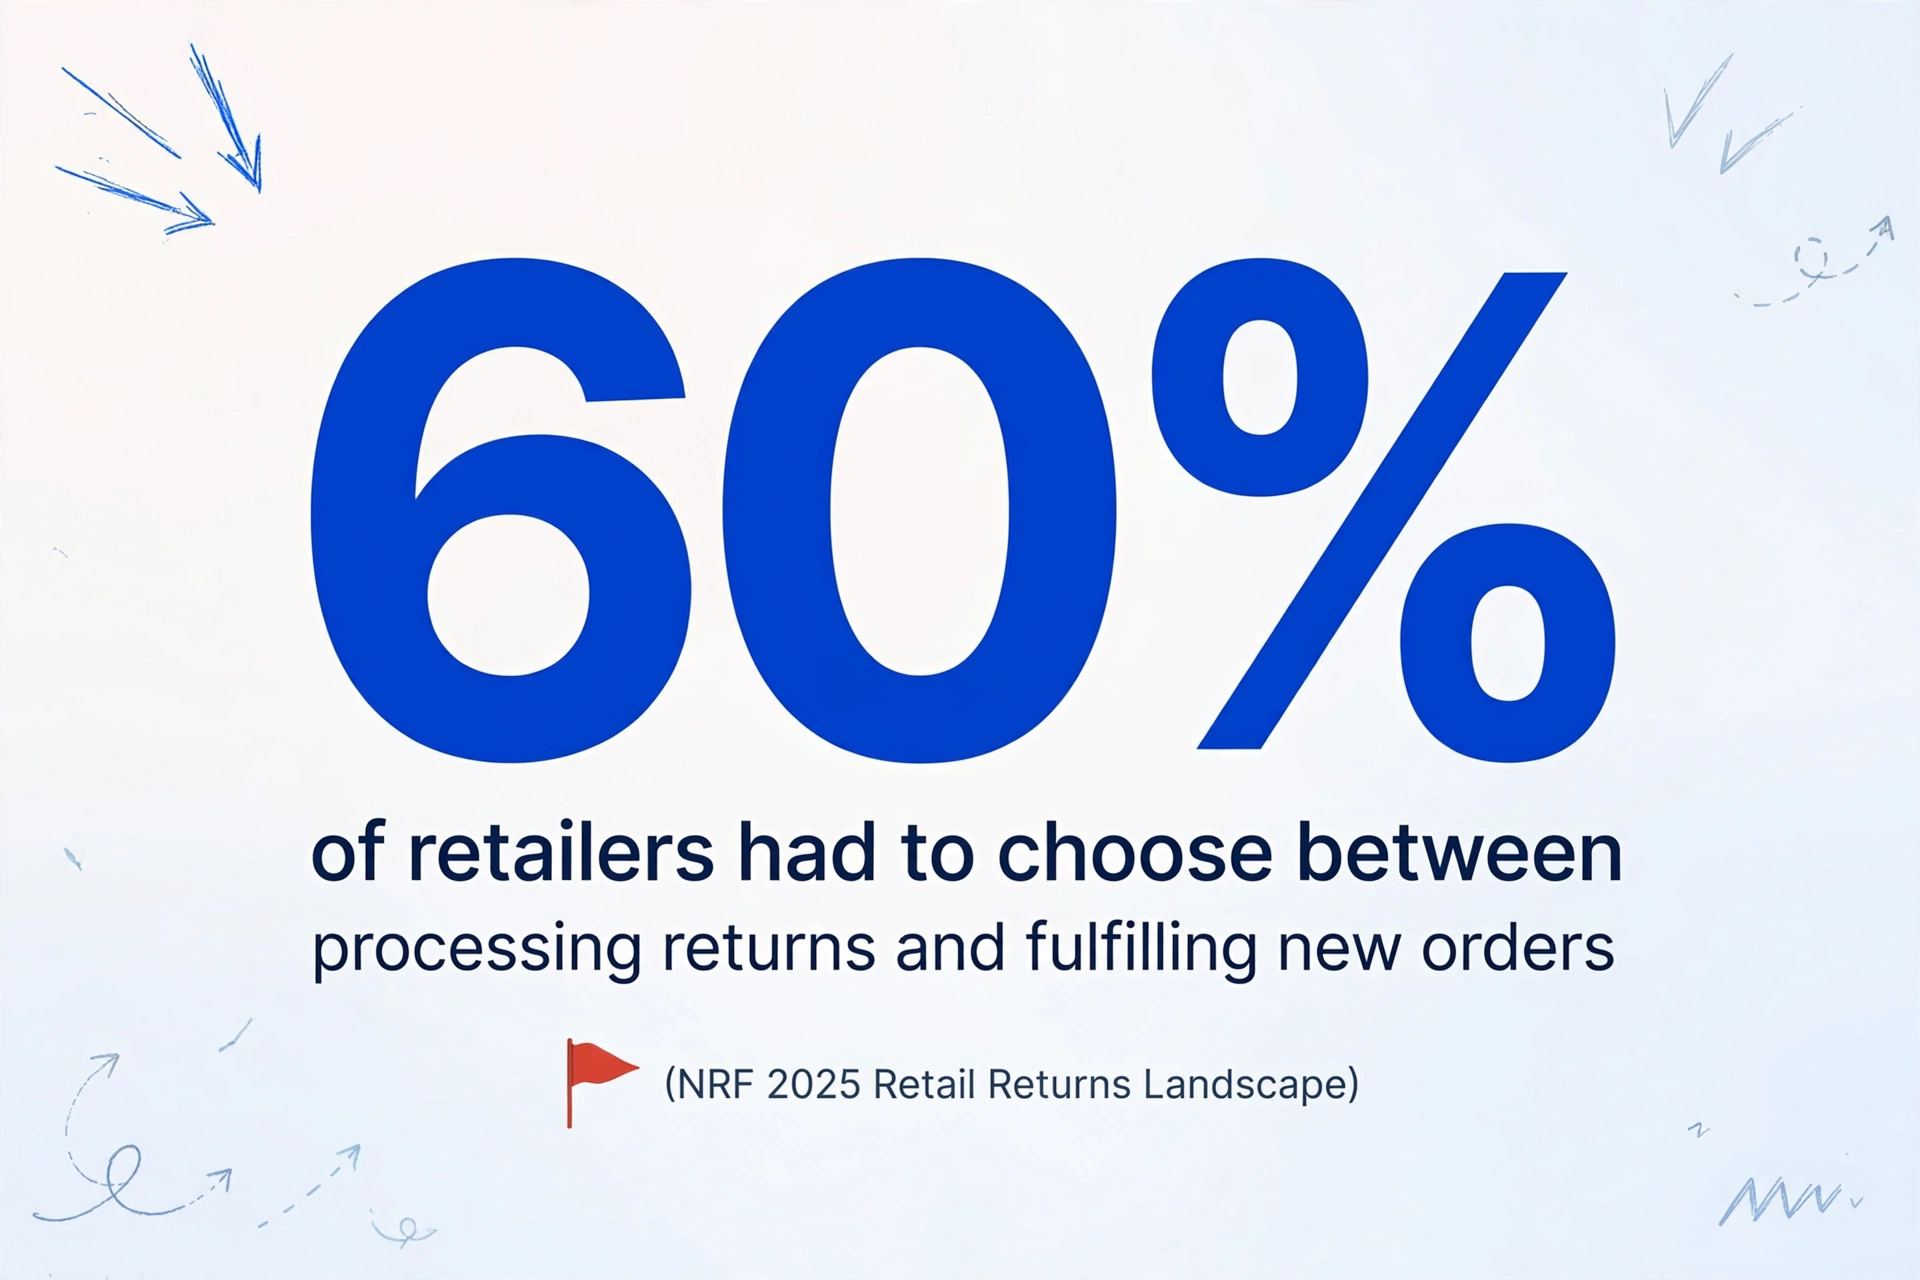
Die Zahlen erklären, warum diese Lücke wichtig ist. Der NRF 2025 Retail Returns Landscape-Bericht, erstellt in Partnerschaft mit Happy Returns (einem UPS-Unternehmen), ergab, dass 60 % der Einzelhändler zwischen der Verarbeitung von Retouren und der Erfüllung neuer Bestellungen wählen mussten. Neun Prozent aller Retouren werden als betrügerisch eingestuft – und ohne strukturierte Verfolgung wird die Unterscheidung zwischen einer legitimen und einer betrügerischen Retoure zur Ratespiel. Die Reverse Logistics Association, die den Markt der Branche von 3,18 Billionen US-Dollar bis 2033 vertritt, hat die datengesteuerte Disposition zu ihrem zentralen Thema bei den jüngsten Jahrestagungen gemacht.
Was zwischen dem Retourenportal und dem Lager liegt, ist überraschend low-tech: Jemand öffnet ein RMA-Formular – sei es ein PDF aus einem Kundenportal, ein gescannter Retourenschein von einem B2B-Händler oder eine handschriftliche Genehmigung in einer Box – und tippt die Felder manuell in eine Tracking-Tabelle. Ein Beitrag auf r/Netsuite beschrieb die Situation genau: „Der RMA-Prozess ist zu einem Vollzeitjob für zwei Personen geworden. Jede Retoure beginnt damit, dass ein Kunde uns eine E-Mail schreibt, jemand sie manuell genehmigt und dann manuell ein Etikett erstellt.“ Ein Händler auf r/supplychain formulierte es drastischer: Ihr Retourenprozess „fraß sie bei lebendigem Leibe“ – manuelle RMA-Workflows, Albtraum-Abstimmungen von Lieferantengutschriften und Lagerengpässe.
Das fehlende Puzzlestück in der Retourenautomatisierung ist nicht das Retourenportal. Es ist die Extraktionsebene – der Schritt, der ein Formular in strukturierte Daten verwandelt.
Was tatsächlich auf einem RMA-Formular steht – und warum manuelle Eingabe nicht skaliert
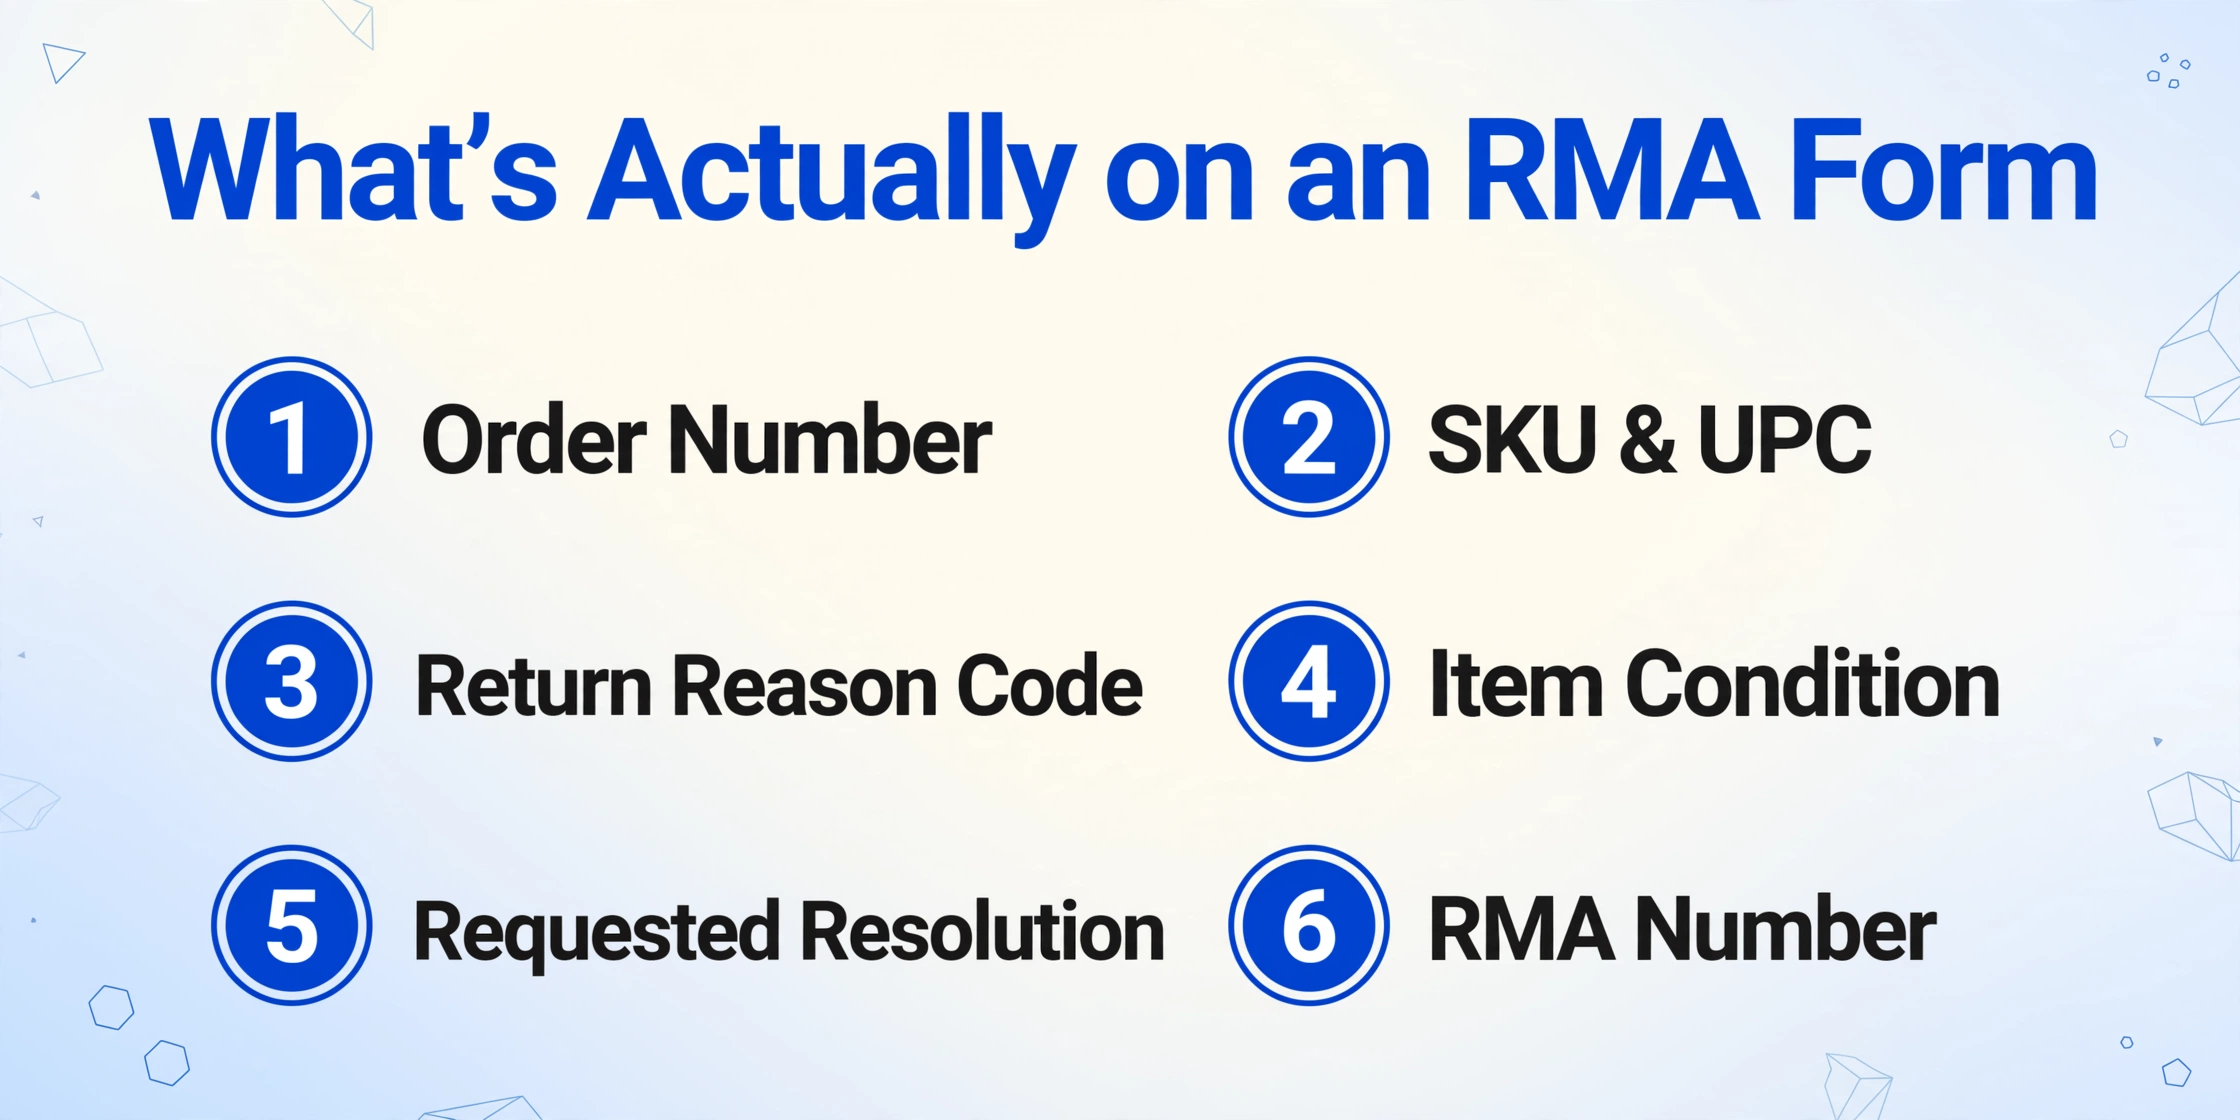
Ein Standard-RMA-Formular erfasst mehr Informationen, als die meisten annehmen. Es geht nicht nur um „Kunde möchte Artikel zurückgeben". Ein vollständiges RMA-Formular umfasst Bestellnummer, Produkt-SKU und UPC, zurückgegebene Menge, Rückgabegrund-Code (defekt, falsche Größe, nicht wie beschrieben, Transportschaden, umentschieden), Artikelzustand bei Ankunft (ungeöffnet, geöffnet, beschädigt, fehlendes Zubehör), bevorzugte Lösung (Erstattung, Umtausch, Guthaben, Reparatur) sowie die zugewiesene RMA-Nummer selbst. Bei B2B-Retouren – die laut IMARC Group-Daten 2024 für 35,1 % des Umsatzes in der Reverse-Logistik verantwortlich waren – enthält das Formular zusätzlich vertragsspezifische Bedingungen, Gutschriftverweise und Mengen für Sammelretouren.
Das operativ wertvollste Feld auf diesem Formular ist der Grund-Code. Wenn „defekt" für eine bestimmte SKU ansteigt, ist das ein Qualitätskontrollsignal. Wenn „falsche Größe" bei einer Bekleidungslinie dominiert, liegt ein Problem mit der Größentabelle vor. Die Analyse von RMA-Daten durch LateShipment ergab, dass die Verfolgung auf Grund-Code-Ebene Probleme aufdeckt, die aggregierte Retourenquoten verbergen – ein Produktlaunch mit einer Gesamtretourenquote von 4 % mag unauffällig wirken, bis man sieht, dass „nicht wie beschrieben" für genau diese SKU von 2 % auf 18 % gestiegen ist.
Doch die Erfassung von Grund-Code-Daten in großem Umfang erfordert deren Extraktion aus dem Formular. Wenn jeder Rückgabegrund-Code manuell eingegeben wird – aus einer PDF, einem gescannten Beleg oder einer handschriftlichen Notiz –, kommen die Daten spät, inkonsistent und oft gar nicht an. Die interne Forschung von ReturnPro ergab, dass Kunden überproportional häufig den ersten Grund in einem Dropdown-Menü wählen, was bedeutet, dass manuelle Daten aus kundenorientierten Formularen bereits verfälscht sind. Genaue Grund-Code-Daten erfordern Extraktion plus strukturierte Kategorisierungslogik – etwas, das manuelle Eingabe nicht gewährleisten kann.
So funktioniert KI-Extraktion bei RMA-Formularen ohne Vorlagen
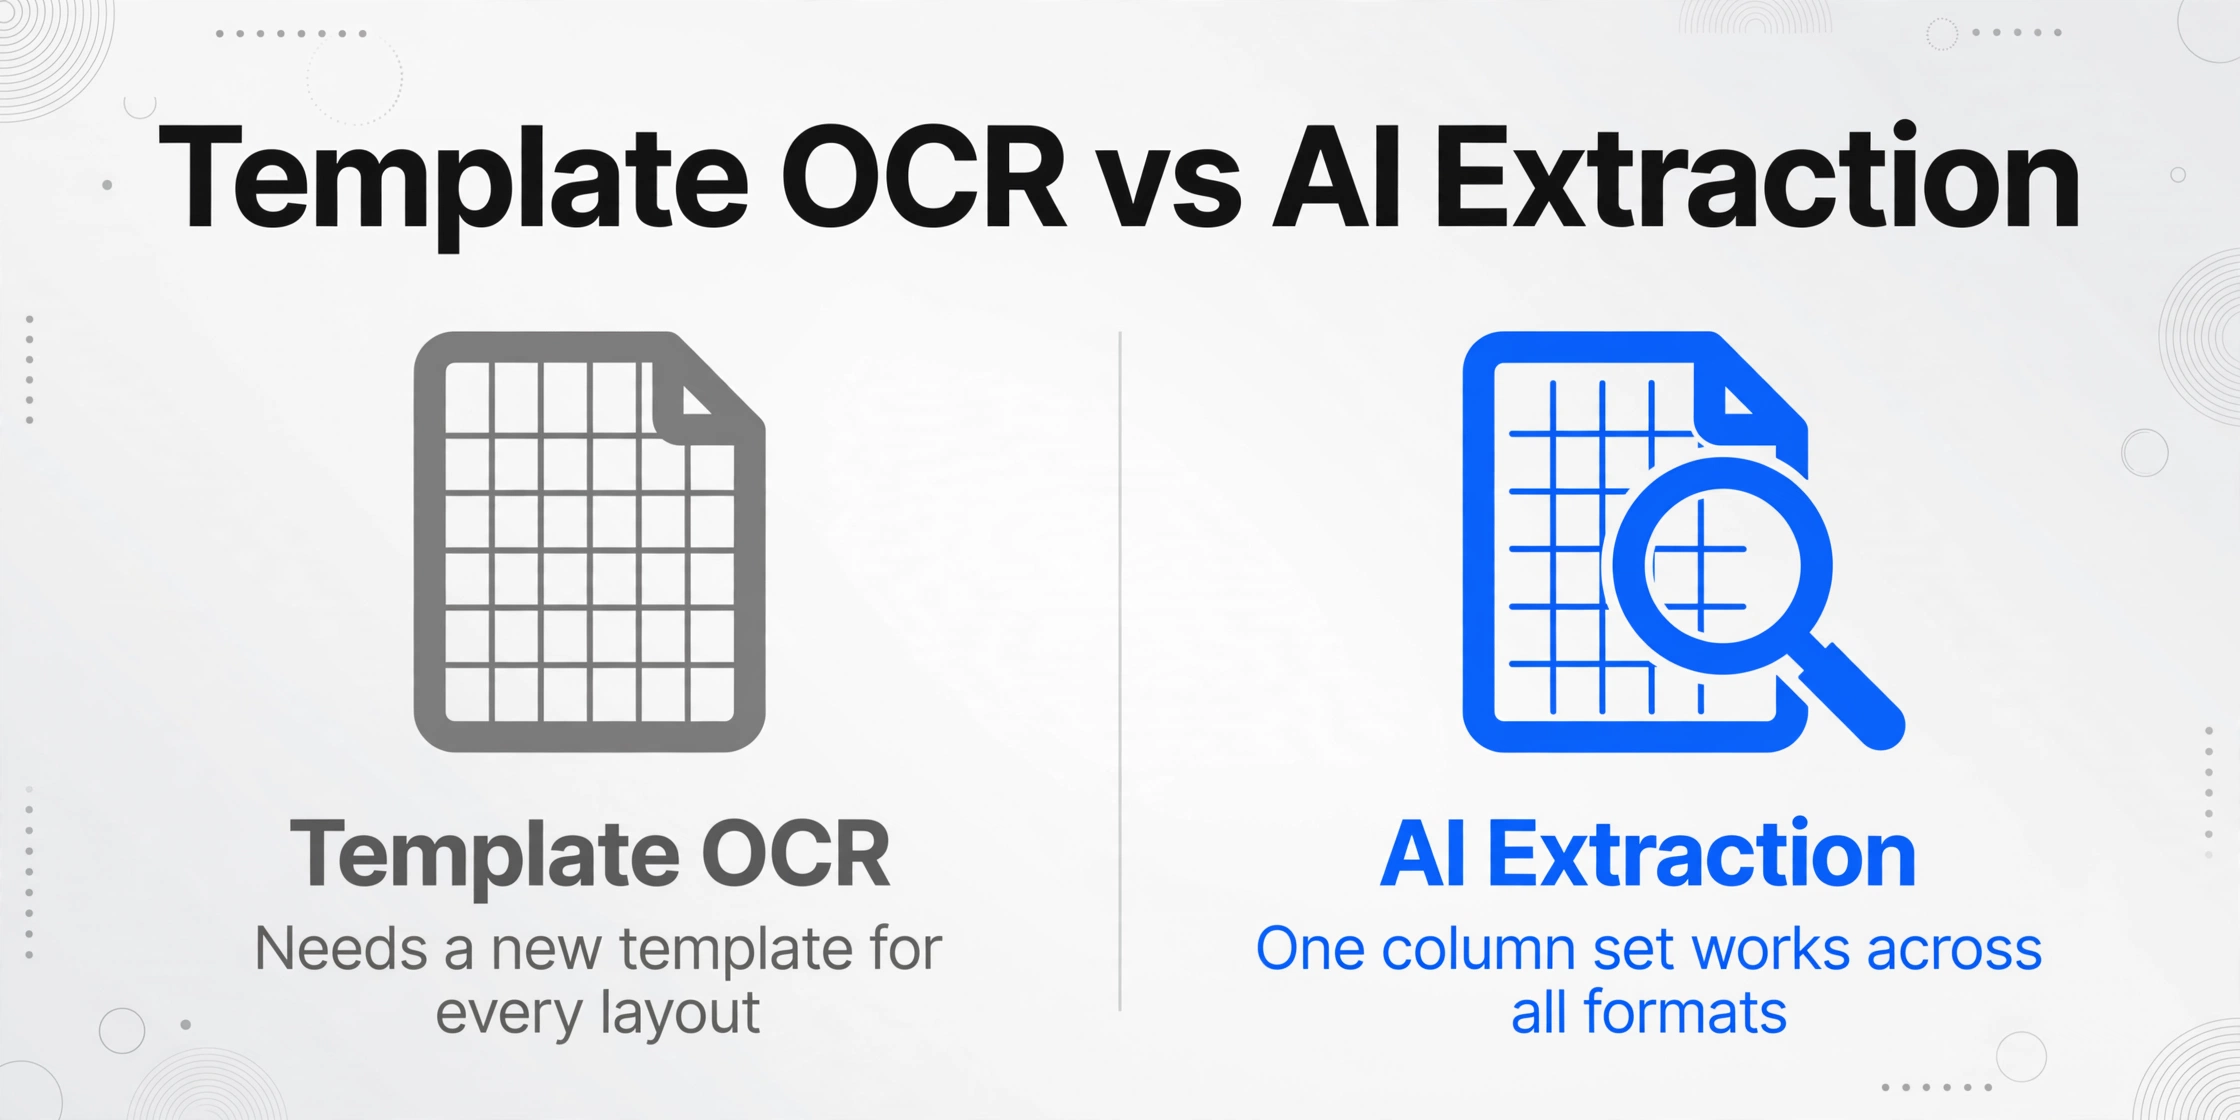
Herkömmliche OCR verarbeitet ein Dokument, indem sie Bilder von Zeichen in einen Textstrom umwandelt. Sie weiß nicht, welcher Text die RMA-Nummer und welcher der Rückgabegrund ist – sie liefert Ihnen nur eine Wand aus Wörtern. Vorlagenbasierte Tools gehen einen Schritt weiter, indem sie Ihnen erlauben, Koordinaten für jedes Feld zu definieren, aber dieser Ansatz scheitert, sobald sich ein Formularlayout ändert. Eine RMA kann als PDF von einem Rückgabeportal eintreffen; die nächste als Foto eines handschriftlichen Formulars; die dritte als gescanntes B2B-Autorisierungsformular aus dem ERP-System eines Lieferanten. Jedes Format erfordert eine neue Vorlage – und die Pflege von Vorlagen für verschiedene Formularvarianten ist das, was aus einem Zwei-Personen-RMA-Prozess einen dauerhaften Personalbedarf macht.
Die KI-basierte Benutzerdefinierte Spaltenextraktion funktioniert anders. Statt dem System zu sagen, wo jedes Feld auf der Seite zu finden ist, sagen Sie ihm, was Sie suchen – indem Sie die Spaltennamen eingeben, die Sie in Ihrer Ausgabetabelle möchten. „RMA-Nummer." „Rückgabegrund-Code." „SKU." „Menge." „Gewünschte Lösung." Die KI liest jedes Formular, findet die Werte, die diesen Spaltennamen entsprechen – basierend auf ihrer Bedeutung, nicht auf ihren Koordinaten – und füllt sie in die entsprechenden Spalten. Dieselben Spaltennamen funktionieren, ob das Formular ein gestochen scharfes PDF, ein schiefes Handyfoto eines handschriftlichen Rückgabebelegs oder ein gescanntes Papierformular aus einem Jahrzehnte alten Aktenschrank ist.
Das ist der Unterschied zwischen Datenextraktion und Texttranskription. Ein handschriftliches RMA-Formular mit „RMA # — 44291 — Grund: beschädigt" in verschmierter Tinte wird genauso gelesen wie ein Portal-generiertes PDF mit klar beschrifteten Feldern: Die KI identifiziert „44291" als RMA-Nummer, weil sie die semantische Beziehung zwischen einer Zahl und ihrer Beschriftung versteht – nicht weil sie einer vordefinierten Position auf einer Vorlage entspricht. Für Teams, die Retouren über mehrere Lager und Vertriebskanäle mit unterschiedlichen RMA-Formularformaten verarbeiten, ist dieser Ansatz ohne Vorlage der Unterschied zwischen einem funktionierenden System und einem, das nur die saubersten 60 % der Formulare bewältigt.
Dieser Mechanismus ist nicht auf Felder beschränkt, die explizit auf dem Formular stehen. Sie können abgeleitete Spalten definieren – zum Beispiel eine Spalte „Entsorgungskategorie" mit „Optionen: Restock, Refurbish, Dispose, Return to Vendor." Die KI liest den Artikelzustand und den Grundcode und weist basierend auf Ihren Geschäftsregeln eine wahrscheinliche Entsorgungskategorie zu – auch wenn kein „Entsorgung"-Feld auf dem Formular existiert. Sie erhalten Extraktion und Klassifizierung in einem einzigen Durchgang.
Schritt für Schritt: Eine RMA-Datenpipeline vom Formular zur Tabelle aufbauen
Die Extraktionsebene sitzt zwischen der RMA-Erfassung (wie auch immer Ihre Kunden oder Partner Retouren einreichen) und Ihrem Operations-Stack (WMS, ERP, Tracking-Tabelle). So richten Sie sie speziell für RMA-Formulare ein.
Definieren Sie Ihre RMA-Extraktionsspalten
Beginnen Sie mit den Feldern, die Ihre Abläufe steuern. Ein Standard-RMA-Extraktionssatz umfasst: RMA-Nummer, Bestellnummer, SKU, Retourengrund-Code, Zurückgegebene Menge, Artikelzustand, Gewünschte Lösung, Kundenname. Wenn Sie B2B-Retouren bearbeiten, fügen Sie Lieferantenname, Gutschrift-Referenz und Vertragsnummer hinzu. Für die abgeleitete Disposition fügen Sie Disposition (Optionen: Restock / Refurbish / Liquidate / RTV / Dispose) hinzu. Die KI weist anhand des Retourengrund-Codes und des Zustands automatisch eine Disposition zu.
RMA-Formulare in jedem Format hochladen
Laden Sie sie hoch, sobald sie eintreffen — PDFs aus Ihrem Retourenportal, Fotos von handschriftlichen Retourenscheinen aus dem Außendienst, gescannte B2B-Autorisierungsformulare. Keine Vorverarbeitung, kein Vorlagen-Setup pro Format. Die KI liest formatübergreifend, weil sie auf die Informationen schaut, nicht auf das Layout. Wenn Sie Retouren aus 3 Vertriebskanälen und 15 Lieferanten-Retourenformularen verarbeiten, laden Sie alle in denselben Batch hoch — die in Schritt 1 definierten Spaltennamen gelten universell.
Den Batch verarbeiten
Die KI verarbeitet jedes Formular — in der Regel 5–10 Sekunden pro Seite — extrahiert die von Ihnen definierten Felder und weist, wo konfiguriert, automatisch Dispositionskategorien zu. Die Verarbeitung erfolgt parallel, sodass ein Batch von 50 RMA-Formularen in Minuten statt Stunden abgeschlossen ist. Sie sehen die Ergebnisse Zeile für Zeile erscheinen, sobald die Formulare fertig sind.
Nach Excel exportieren und an Ihren Operations-Stack weiterleiten
Laden Sie die zusammengeführte Tabelle herunter — eine Zeile pro RMA-Formular, jede von Ihnen definierte Spalte. Die Ausgabe ist Excel (XLSX) oder CSV, bereit für den Import in Ihr WMS, ERP oder Ihre Retourenmanagement-Plattform. Eine Quellendateinamen-Spalte führt jede Zeile auf ihr ursprüngliches Formular zurück und bietet Ihnen einen Prüfpfad vom Formular zu den Daten.
Dateien werden sicher verarbeitet und nicht gespeichert.
Die Demo oben läuft mit „RMA-Formular“ als Dokumenttyp – geben Sie Ihre eigenen Spaltennamen ein und laden Sie ein Beispiel-RMA-Formular hoch, um die Extraktion in Aktion zu sehen. Für Produktions-Batches mit Hunderten von Rücksendungen pro Woche skaliert derselbe Workflow ohne zusätzliche Einrichtung. Keine Konfiguration pro Formular, keine Vorlagenbibliothek zu pflegen. Für die vollständige Feldliste, den Batch-Workflow mit gemischten Formaten und die Exportoptionen an einem Ort, siehe den RMA-zu-Excel-Konverter.
Rücksendedaten für Disposition und Trendanalyse verfolgen
Sobald Ihre RMA-Daten in einer Tabelle landen, bilden sie die Grundlage für Entscheidungen in der Retourenlogistik, die sich direkt auf die Margenrückgewinnung auswirken. Die Disposition – die Entscheidung darüber, was mit einem retournierten Artikel passiert – bestimmt, ob eine Retoure Geld kostet oder Wert zurückgewinnt. Die Standard-Dispositionspfade sind: Wiedereinlagerung (Artikel geht zurück in den verkaufsfähigen Bestand), Aufarbeitung (Artikel muss vor dem Weiterverkauf repariert werden), Liquidation (Verkauf mit Rabatt über Sekundärkanäle), Rücksendung an den Lieferanten (RTV – zur Gutschrift an den Lieferanten zurücksenden) oder Entsorgung (Artikel hat keinen verwertbaren Wert).
Jeder Pfad hat ein anderes finanzielles Ergebnis. Ein wiedereingelagerter Artikel zum vollen Verkaufspreis erzielt nahezu den vollen Wert abzüglich der Bearbeitungskosten. Ein aufgearbeiteter Artikel erzielt typischerweise 40–60 % des ursprünglichen Werts. Eine liquidierte Palette könnte 10–20 % erzielen. Der Unterschied zwischen der Weiterleitung einer Retoure zur Wiedereinlagerung statt zur Liquidation ist reine Marge – aber er hängt davon ab, dass genaue Daten zu Artikelzustand und Grundcode zum Zeitpunkt der Prüfung vorliegen, um die richtige Entscheidung zu treffen.
Mit extrahierten RMA-Daten in einer Tabelle können Sie die Analyse durchführen, die die meisten Retourenabteilungen überspringen:
- Grundcode-Geschwindigkeit nach SKU. Welche Produkte erzeugen die meisten „defekten" Retouren? Ist es eine bestimmte Charge, ein bestimmtes Lager, das sie bearbeitet, oder ein inhärentes Designproblem? Ohne über alle Retouren normalisierte Grundcodedaten raten Sie nur.
- Dispositionsverteilung. Welcher Prozentsatz der Retouren geht zur Wiedereinlagerung vs. Aufarbeitung vs. Entsorgung? Wenn die Entsorgungsquote steigt, ändert sich etwas vorgelagert – Lieferantenqualität, Verpackung oder die Mischung der Retourengründe.
- Bearbeitungszeit nach Dispositionspfad. Wie lange verbringt eine Retoure in jeder Phase – von der RMA-Ausstellung über den Lagereingang bis zur endgültigen Disposition? Der Benchmark für Retourenabläufe setzt das Ziel bei 2–7 Tagen vom Eingang bis zur Disposition; jeder weitere Tag schmälert den Restwert.
- Vergleich mehrerer Lager. Wenn Lager A Retouren doppelt so schnell verarbeitet wie Lager B bei gleicher Personalausstattung, zeigt Ihnen die Tabelle, wo Sie Prozessverbesserungen ansetzen sollten – oder ob die Qualität der Formularerfassung zwischen den Standorten variiert.
Die Tabelle ersetzt kein WMS. Sie schließt die Lücke zwischen den Daten, die Sie haben (Formulare), und den Daten, die Ihr WMS benötigt, um Retouren korrekt zu leiten.
Wenn das Retourenvolumen auf mehrere hundert pro Woche ansteigt, skaliert derselbe Extraktionsworkflow auf das Stapelverarbeiten von RMA-Formularen in ein einziges Erstattungsabgleichsblatt – mit Routing- und Abgleichsfeldern, die direkt in die Ausgabe integriert sind, statt in einem zweiten manuellen Durchgang hinzugefügt zu werden.
Integration extrahierter RMA-Daten in Ihren Warehouse-Stack
Die meisten Retourenabteilungen verfügen bereits über einen Software-Stack. Die Frage ist nicht, ob man ihn ersetzt — sondern wie man ihn mit sauberen Daten versorgt. Die Extraktionsebene gibt Daten als Excel (XLSX) und CSV aus, die jedes gängige WMS und ERP für den Import akzeptiert. Der Integrationsweg hängt davon ab, was Sie verwenden. Für eine feldweise Anleitung zum Zuordnen extrahierter Spalten zum Import-Schema eines Inventarsystems, siehe unseren Leitfaden zum Einspeisen von RMA-Retourendaten in Ihr Inventarsystem.
NetSuite: Wenn Ihr Retourenteam RMA-Datensätze bereits in NetSuite erstellt, ist der Engpass der Dateneingabeschritt — das Tippen von Formularfeldern in das RMA-Modul von NetSuite. Die Extraktionstabelle kann direkt in das CSV-Import-Tool von NetSuite importiert werden, wobei Ihre extrahierten Spalten (RMA-Nummer, SKU, Reason Code, Disposition) den RMA-Feldern von NetSuite zugeordnet werden. Im selben r/Netsuite-Thread, in dem Benutzer das Zwei-FTE-RMA-Problem beschrieben, wurde festgestellt, dass NetSuite "die Datensätze problemlos hielt" — das Problem war immer, Daten in die Datensätze zu bekommen.
ShipStation / Cin7 / Fishbowl: Diese WMS-Plattformen verwalten Inventarverfolgung und Auftragsabwicklung nativ, aber die Retourenweiterleitung — die Entscheidung, welche Disposition ein retourniertes Produkt erhält — hängt von Daten ab, die aus dem RMA-Formular stammen. Importieren Sie Ihre extrahierte Tabelle als CSV in das Retourenmodul, und das WMS kann Produkte basierend auf der während der Extraktion generierten Dispositionsspalte an Zonen für Wiedereinlagerung, Quarantäne, Aufarbeitung oder RTV weiterleiten.
Google Sheets / manuelle Nachverfolgung: Für Abteilungen, die mit Tabellenkalkulationen arbeiten, liegt das Extraktionsergebnis bereits in Ihrem Arbeitsformat vor. Exportieren Sie als XLSX, öffnen Sie es in Google Sheets, und Sie haben einen manuellen Tippschritt durch einen direkten Feed ersetzt — dieselbe Tabelle, kein Tippen. Dies ist die häufigste Einrichtung für kleine bis mittlere 3PLs und Lagerbetriebe ohne formelles WMS.
Das durchgängige Muster bei allen drei Ansätzen ist dasselbe: Die Extraktionsebene entkoppelt "das Formular lesen" von "mit den Daten arbeiten". Ob die Daten in NetSuite, ShipStation oder einem gemeinsamen Google Sheet landen, ist eine nachgelagerte Entscheidung, die nichts an der Einrichtung der Extraktion ändert. Eine Extraktionskonfiguration funktioniert für alle Ziele.
FAQ
Funktioniert das mit handschriftlichen RMA-Formularen?
Ja — mit denselben Einschränkungen, die für alle Handschrifterkennung gelten. Wenn die Handschrift für einen menschlichen Leser bei angemessener Beleuchtung lesbar ist, kann die KI-Extraktion sie in der Regel lesen. Verschmierte Tinte, extrem komprimierte Schreibschrift oder Schrift, die in andere Felder übergeht, verringern die Genauigkeit. Dieselbe spaltenbasierte Extraktion funktioniert bei getippten und handschriftlichen Formularen ohne Konfigurationsänderung — Sie müssen dem System nicht mitteilen, welche Formulare handschriftlich und welche gedruckt sind. Weitere Informationen zur handschriftsspezifischen Extraktionsleistung finden Sie in unserem Leitfaden zur Verbesserung der Handschriftextraktionsgenauigkeit.
Kann ich Daten aus RMA-Formularen in verschiedenen Sprachen extrahieren?
Die KI liest Dokumentinhalte in der Sprache, in der sie erscheinen — wenn Ihre RMA-Formulare auf Englisch, Spanisch, Deutsch oder gemischt sind, verarbeitet die Extraktion jedes Formular einzeln. Spaltennamen sollten in der Sprache sein, in der Sie Ihre Ausgabe wünschen. Es ist nicht nötig, vor dem Hochladen zu übersetzen oder die Sprache zu normalisieren.
Was, wenn meine RMA-Formulare nicht alle dieselben Felder haben?
Das ist der erwartete Fall. Benutzerdefinierte Spaltenextraktion erfordert nicht, dass jedes Formular jedes Feld enthält. Wenn einem Formular ein von Ihnen definiertes Feld fehlt — ein handschriftlicher Zettel ohne „Reason Code" zum Beispiel — bleibt diese Zelle in der Ausgabe leer. Das System rät nicht und erfindet keine Daten, um Lücken zu füllen. Das ist speziell für RMA-Workflows wichtig, da B2B-Rücksendeformulare verschiedener Anbieter unterschiedliche Feldsätze haben.
Wie ist das im Vergleich zu einer dedizierten Retourenmanagement-Plattform wie Loop Returns oder Happy Returns?
Dedizierte Retourenplattformen verwalten den kundenorientierten Workflow — Markenportale, Etikettengenerierung, Erstattungsabwicklung — und sind das richtige Werkzeug, wenn Sie Käufern ein Self-Service-Retourenerlebnis bieten möchten. Die Extraktionsebene erfüllt eine andere Funktion: Sie zieht Daten aus RMA-Formularen unabhängig davon, woher diese Formulare kommen. Wenn alle Ihre Retouren über ein einziges Portal mit strukturierter Datenerfassung laufen, benötigen Sie keine Extraktion — das Portal liefert bereits strukturierte Daten. Wenn Ihre Retouren über mehrere Kanäle eingehen — ein Portal, E-Mail, B2B-Anbieterformulare, Papierzettel — schließt die Extraktion die Lücke, die das Portal nicht abdecken kann.
Wie genau sind die Ergebnisse bei Reason Codes und Disposition-Feldern?
Bei sauberen, gedruckten RMA-Formularen erreicht die Genauigkeit bei strukturierten Feldern wie Bestellnummern und SKUs bis zu 99 %. Reason Codes – in der Regel kurze Textlabels wie „Defekt" oder „Falsche Größe" – sind aufgrund ihres begrenzten Vokabulars sehr zuverlässig. Der größte Einflussfaktor ist die Qualität der Eingabe: Ein scharfes Foto eines gedruckten RMA-Formulars wird genauer extrahiert als ein unscharfes Foto eines zerknitterten Retourenbelegs. Bei Feldern, bei denen ein Fehler teuer ist – etwa wenn eine Retoure der falschen Disposition zugewiesen wird – ist eine kurze manuelle Prüfung der Tabelle vor dem Import eine sinnvolle Absicherung. Weitere Informationen zur Genauigkeit nach Feldtyp finden Sie in unserer detaillierten Analyse der Extraktionsgenauigkeit.
Muss ich die KI zuerst auf mein RMA-Formularformat trainieren?
Nein. Die Extraktion ohne Vorlage bedeutet, dass die KI jedes RMA-Formularformat ohne vorheriges Training oder Beispielannotation verarbeitet. Sie definieren die Spaltennamen einmal, und dieselben Spaltennamen werden aus jedem Format extrahiert, das Sie verwenden – Portal-PDFs, gescannte Lieferantenformulare, handschriftliche Belege, Fotos aus dem Lager. Die Tatsache, dass kein Training erforderlich ist, macht diesen Ansatz für Retourenabteilungen geeignet, die Formulare aus Dutzenden verschiedener Quellen mit jeweils eigenem Layout verarbeiten.
Schließen der Datenlücke, die die Retourenautomatisierung vergessen hat
Die Reverse-Logistik-Branche hat in die sichtbaren Teile der Retouren investiert – Kundenportale, Abgabestellen, Soforterstattungen, Betrugserkennung. Was nicht automatisiert wurde, ist der leiseste und arbeitsintensivste Schritt: das Lesen des Formulars und das Eintippen der Daten. Es ist der Schritt, der zwischen jedem Softwaretool im Stack und den tatsächlichen Informationen liegt, die diese Tools benötigen, um zu funktionieren.
Retouren im Wert von 849,9 Milliarden US-Dollar durchlaufen diesen Schritt jedes Jahr. Der Unterschied zwischen einer Retourenabteilung, die Trends erkennt, und einer, die nur rät, ist nicht ein besseres Portal, eine schnellere Erstattung oder ein ausgefeilteres WMS. Es ist die Frage, ob die Daten auf dem RMA-Formular rechtzeitig in eine Tabelle gelangen, um relevant zu sein.
Probieren Sie es mit Ihren eigenen RMA-Formularen aus. Laden Sie einen Batch hoch und sehen Sie, ob die Daten, die Sie bisher von Hand eingetippt haben, in 5 Sekunden in Spalten erscheinen – statt 5 Minuten pro Formular.
Für die Demo ist keine Anmeldung erforderlich