Como Processar Dados de Devoluções RMA
para Rastreamento em Excel
Os varejistas dos EUA lidaram com US$ 849,9 bilhões em devoluções em 2025, segundo a National Retail Federation. Cada uma dessas devoluções começou com um formulário — um comprovante de RMA, um PDF de autorização de devolução, às vezes uma nota manuscrita dentro da caixa devolvida. A ironia: os dados nesses formulários são o insumo mais valioso para reduzir devoluções futuras, mas na maioria das operações eles nunca chegam a uma planilha.

Principais Conclusões
- Dois funcionários em tempo integral só digitando campos de formulários RMA em planilhas — e seus dados de código de motivo ainda chegam tarde demais para detectar um lote defeituoso antes do próximo envio.
- A extração baseada em modelo falha no momento em que um fornecedor muda o layout do formulário — por isso seus 15 formatos RMA diferentes garantem que quase metade das suas devoluções nunca seja automatizada, não importa quantos modelos você crie.
- Defina os nomes das suas colunas uma vez e a mesma extração lê todos os formatos — PDFs de portal, comprovantes manuscritos, formulários de fornecedores — sem um único modelo para manter ou treinar.
O Ponto Cego de Dados de RMA: Por Que as Devoluções Falham Entre o Formulário e a Planilha
O software de gerenciamento de devoluções resolveu a metade voltada ao cliente do processo de RMA. Portais da Loop Returns, Happy Returns e Narvar permitem que compradores iniciem devoluções, imprimam etiquetas e acompanhem reembolsos sem precisar enviar e-mails ao suporte. Mas essa automação para na camada de dados — o ponto em que as informações de um formulário de RMA precisam se tornar uma linha em uma planilha que uma equipe de armazém, um processador de devoluções ou um sistema ERP possa usar.
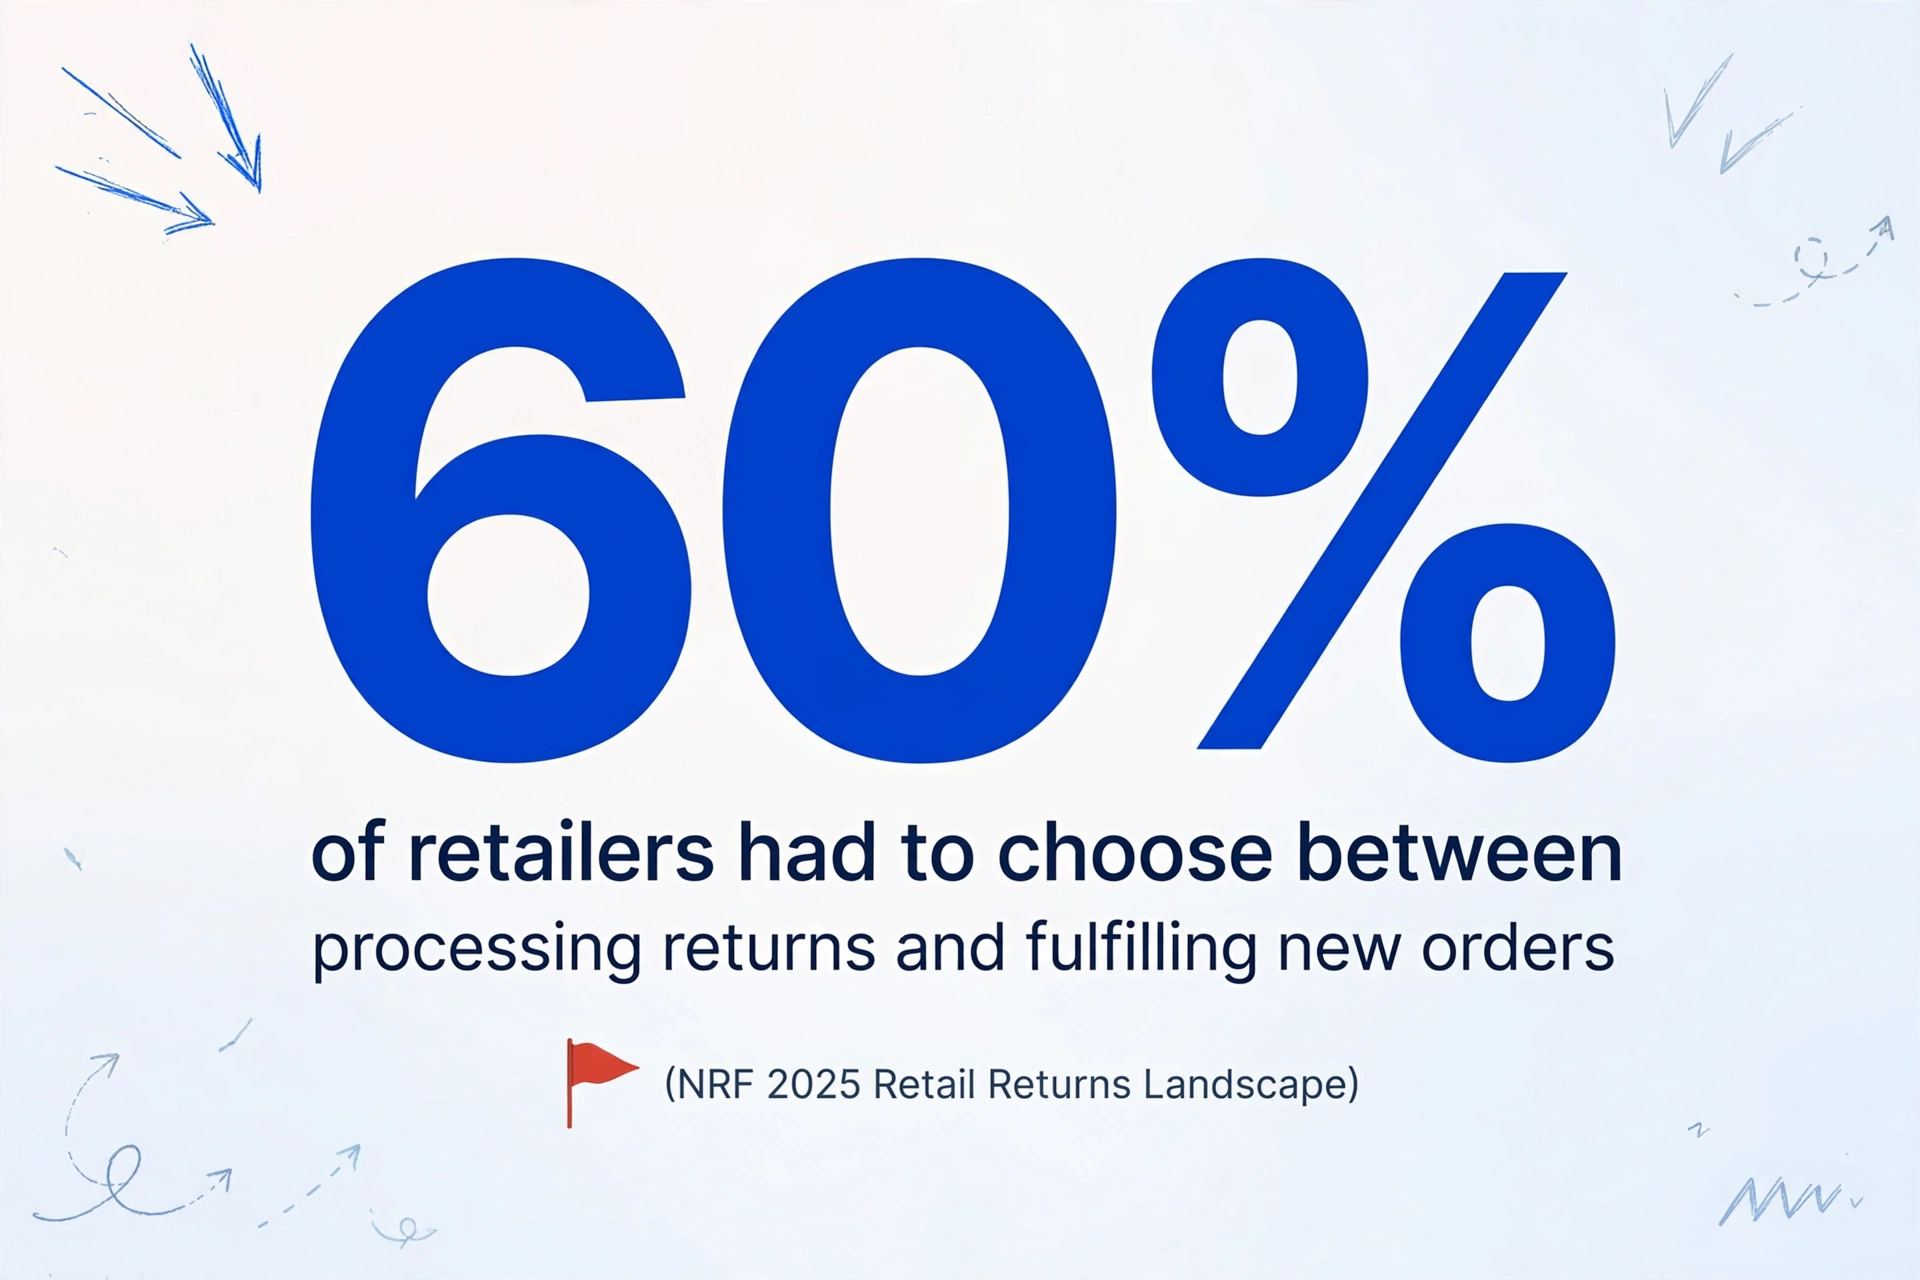
Os números explicam por que essa lacuna importa. O relatório NRF 2025 Retail Returns Landscape, produzido em parceria com a Happy Returns (uma empresa da UPS), descobriu que 60% dos varejistas tiveram que escolher entre processar devoluções e atender novos pedidos. Nove por cento de todas as devoluções são classificadas como fraudulentas — e sem rastreamento estruturado, distinguir uma devolução legítima de uma fraudulenta vira adivinhação. A Reverse Logistics Association, que representa o mercado de US$ 3,18 trilhões até 2033 da indústria, tornou a disposição orientada por dados seu tema central nas conferências anuais recentes.
O que fica entre o portal de devoluções e o chão do armazém é surpreendentemente de baixa tecnologia: alguém abre um formulário de RMA — seja um PDF de um portal do cliente, um comprovante de devolução digitalizado de um distribuidor B2B ou uma autorização manuscrita dentro de uma caixa — e digita manualmente os campos em uma planilha de rastreamento. Uma publicação no r/Netsuite descreveu a situação exatamente: "O processo de RMA virou um trabalho em tempo integral para duas pessoas. Toda devolução começa com um cliente nos enviando um e-mail, alguém aprovando manualmente e depois gerando uma etiqueta manualmente." Um distribuidor no r/supplychain foi mais direto: o processo de devoluções deles estava "devorando-os" — fluxos de trabalho manuais de RMA, pesadelos de reconciliação de crédito com fornecedores e gargalos no armazém.
A peça que falta na automação de devoluções não é o portal de devoluções. É a camada de extração — a etapa que transforma um formulário em dados estruturados.
O que Realmente Tem em um Formulário de RMA — e Por Que Digitá-lo Não Escala
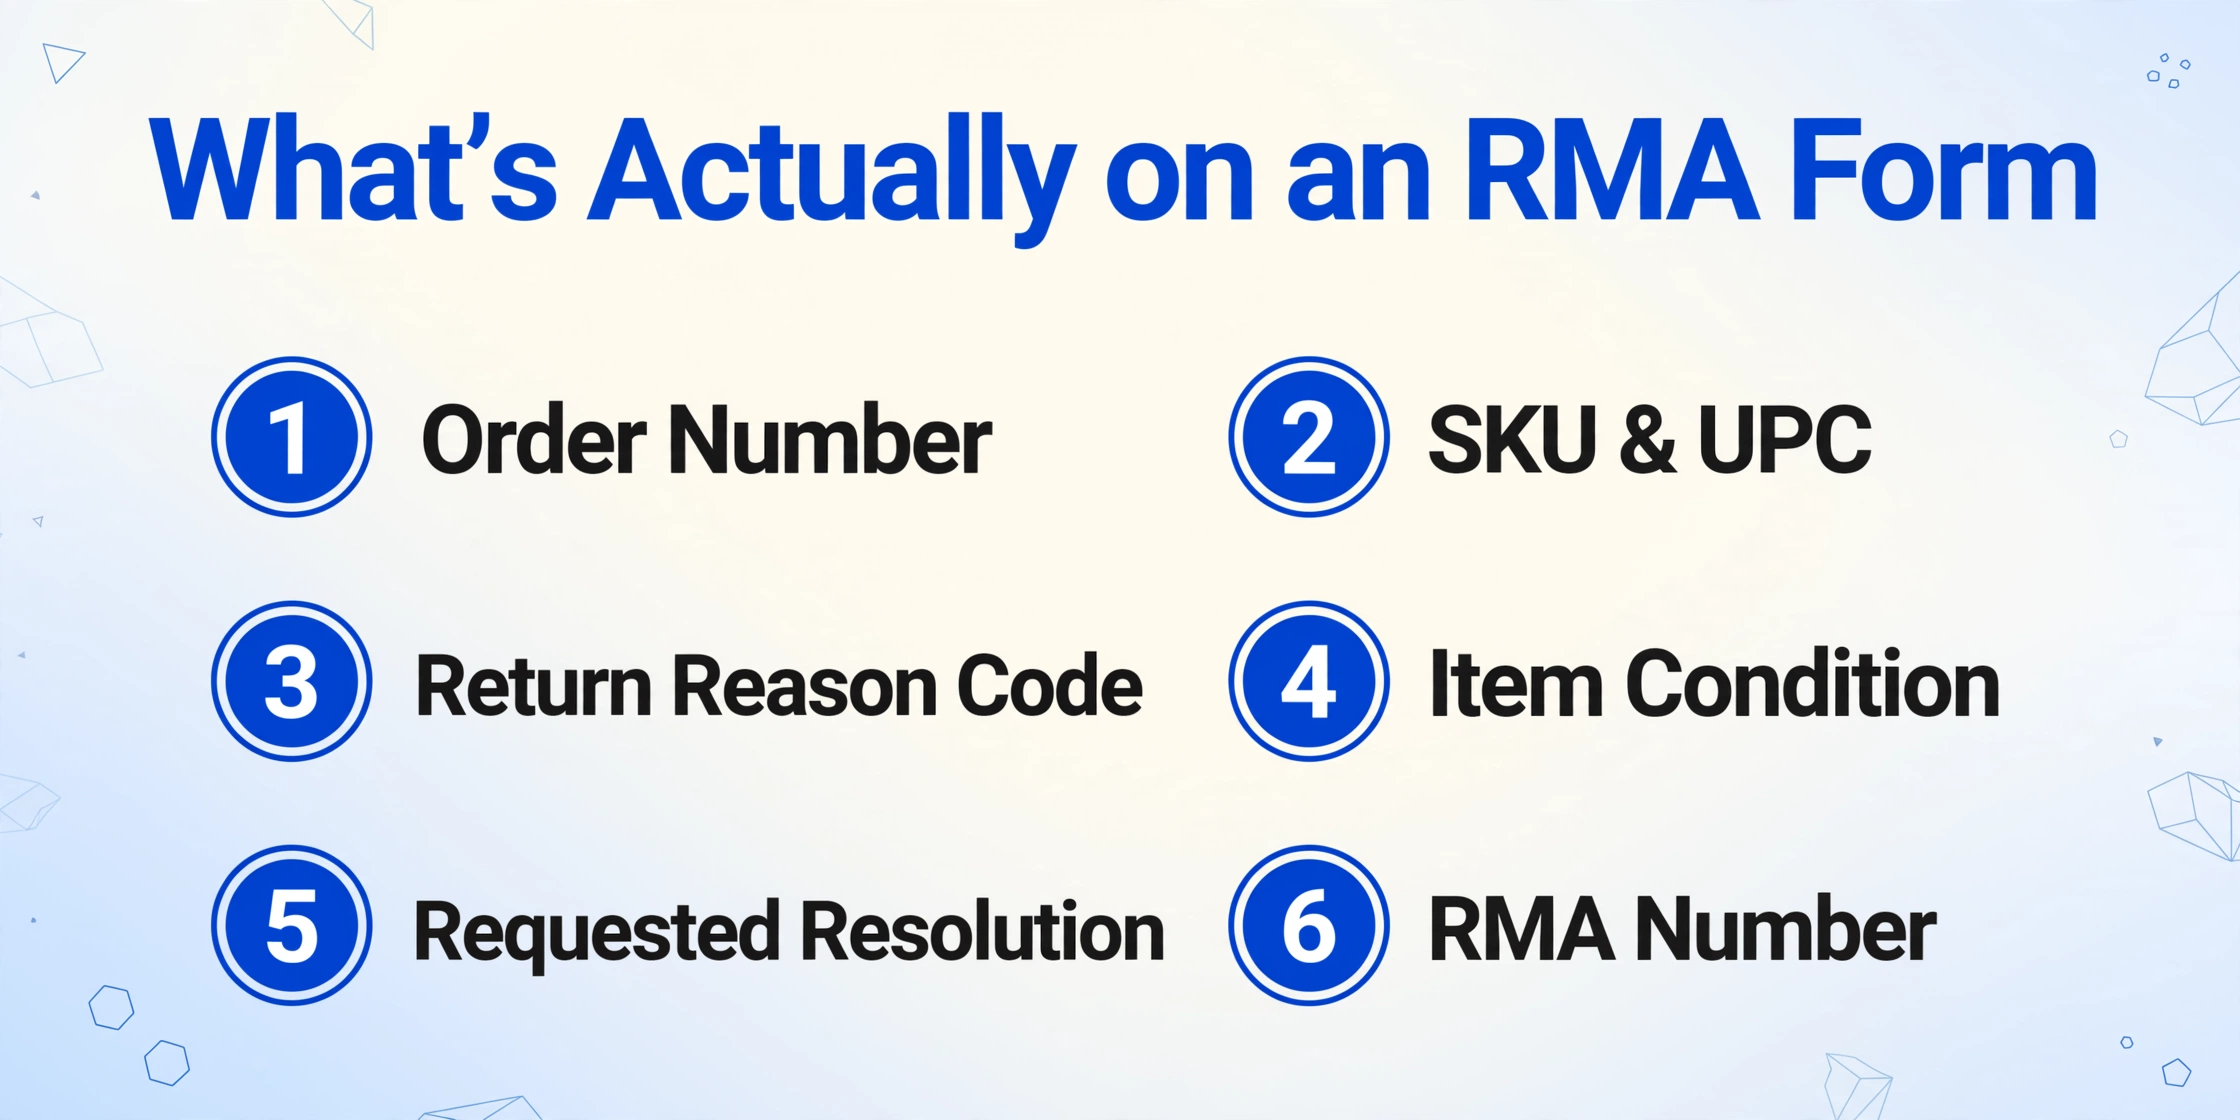
Um formulário de RMA padrão captura mais informações do que a maioria das pessoas imagina. Não é só "cliente quer devolver item". Um formulário de RMA completo inclui número do pedido, SKU e UPC do produto, quantidade devolvida, código de motivo da devolução (defeituoso, tamanho errado, não como descrito, danificado no transporte, mudou de ideia), condição do item na chegada (não aberto, aberto, danificado, acessórios faltando), resolução preferida (reembolso, troca, crédito na loja, reparo) e o número de RMA atribuído. Para devoluções B2B — que dados do IMARC Group mostram que representaram 35,1% da receita de logística reversa em 2024 — o formulário também inclui termos específicos do contrato, referências de nota de crédito e quantidades de devolução em massa.
O campo mais valioso operacionalmente nesse formulário é o código de motivo. Quando "defeituoso" dispara para um SKU específico, isso é um sinal de controle de qualidade. Quando "tamanho errado" domina as devoluções de uma linha de roupas, isso é um problema de guia de tamanhos. A análise de dados de RMA da LateShipment descobriu que o rastreamento no nível do código de motivo revela problemas que as taxas de devolução agregadas escondem — um lançamento de produto que gera uma taxa geral de devolução de 4% pode parecer ok, até você ver que "não como descrito" saltou de 2% para 18% apenas para aquele SKU.
Mas capturar dados de código de motivo em escala exige extraí-los do formulário. Se todo código de motivo de devolução for digitado manualmente — de um PDF, um recibo escaneado ou uma nota manuscrita — os dados chegam atrasados, inconsistentes e, muitas vezes, nem chegam. A pesquisa interna da ReturnPro descobriu que os clientes escolhem desproporcionalmente o primeiro motivo listado em um menu suspenso, o que significa que os dados manuais de formulários voltados ao cliente já estão contaminados. Obter dados precisos de código de motivo exige extração mais lógica estruturada de categorização — algo que a digitação manual não consegue impor.
Como a Extração por IA Lê Formulários de RMA Sem Modelos
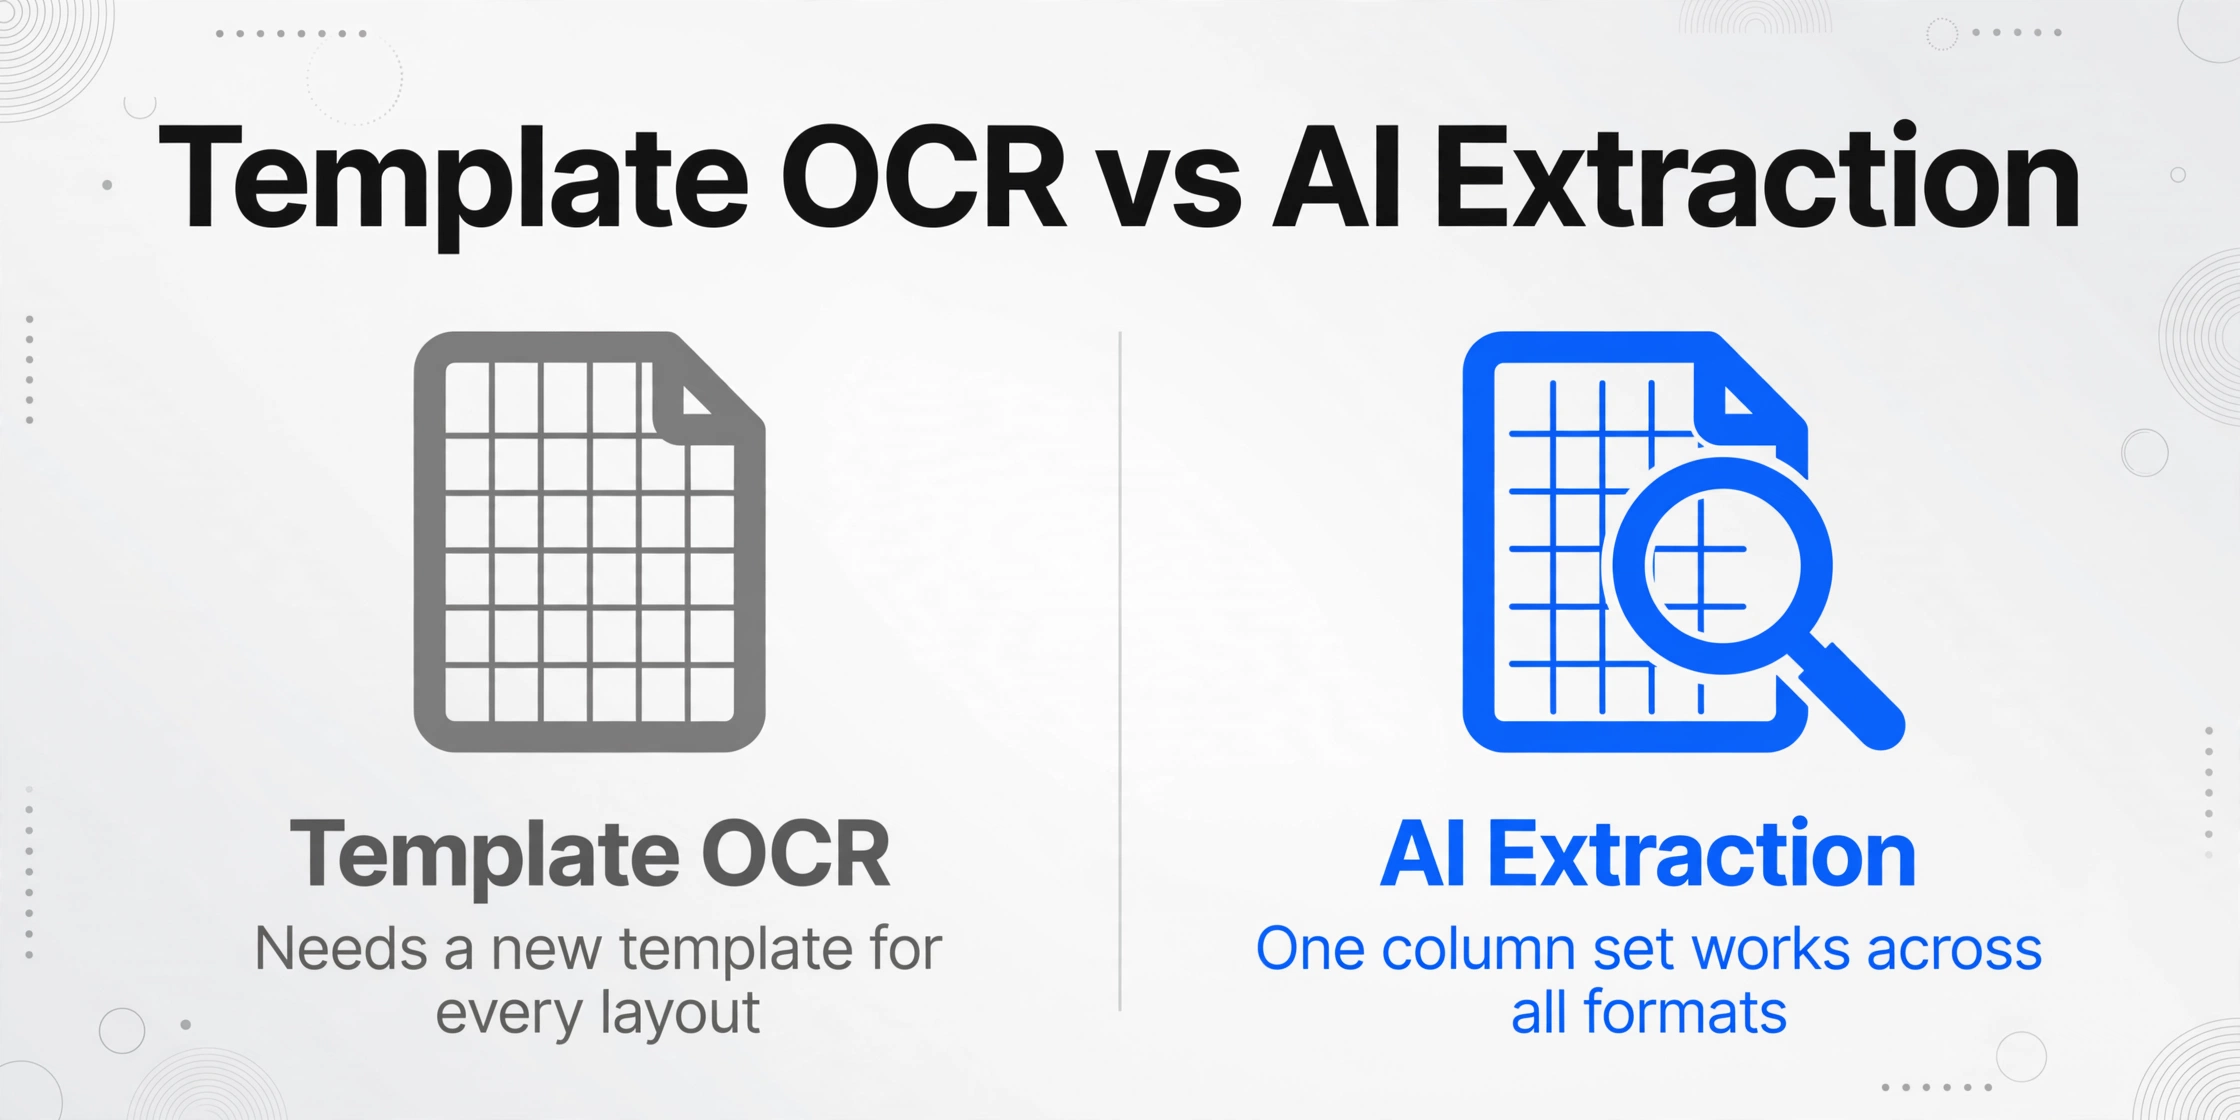
O OCR tradicional processa um documento convertendo imagens de caracteres em um fluxo de texto. Ele não sabe qual texto é o número de RMA e qual é o motivo da devolução — ele apenas entrega uma parede de palavras. Ferramentas baseadas em modelo vão um passo além, permitindo definir coordenadas para cada campo, mas essa abordagem falha assim que o layout de um formulário muda. Um RMA pode chegar como PDF gerado por um portal de devoluções; o próximo, como foto de um formulário manuscrito; o terceiro, como um formulário de autorização B2B digitalizado do sistema ERP de um fornecedor. Cada formato exige um novo modelo — e manter modelos entre variantes de formulários é o que transforma um processo de RMA de dois funcionários em uma necessidade permanente de contratação.
A Extração de Colunas Personalizadas baseada em IA funciona de forma diferente. Em vez de dizer ao sistema onde encontrar cada campo na página, você diz o que está procurando — digitando os nomes das colunas que deseja na sua planilha de saída. "Número de RMA." "Código do Motivo de Devolução." "SKU." "Quantidade." "Resolução Solicitada." A IA lê cada formulário, localiza os valores que correspondem a esses nomes de colunas com base no significado — não nas coordenadas — e os preenche nas colunas correspondentes. O mesmo conjunto de nomes de colunas funciona tanto para um PDF nítido, uma foto torta de um formulário de devolução manuscrito ou um formulário de papel digitalizado de um arquivo de décadas atrás.
Essa é a diferença entre extrair dados e transcrever texto. Um RMA manuscrito que diz "RMA # — 44291 — Motivo: danificado" em caneta borrada é lido da mesma forma que um PDF gerado por portal com campos claramente rotulados: a IA identifica "44291" como o número de RMA porque entende a relação semântica entre um número e seu rótulo, não porque corresponde a uma posição predefinida em um modelo. Para equipes que processam devoluções em vários armazéns, de vários canais de vendas, cada um com formatos diferentes de formulários de RMA, essa abordagem sem modelo é a diferença entre um sistema funcional e um que só lida com os 60% mais limpos dos formulários.
Esse mecanismo não se limita a campos explicitamente escritos no formulário. Você pode definir coluna inferida — por exemplo, uma coluna "Categoria de Destinação" definida como "opções: Reestocar, Reformar, Descartar, Devolver ao Fornecedor." A IA lê a condição do item e o código de motivo e atribui uma destinação provável com base nas suas regras de negócio — mesmo que nenhum campo "Destinação" exista no formulário. Você obtém extração e classificação em uma única passagem.
Passo a Passo: Criando um Pipeline de Dados de RMA do Formulário para a Planilha
A camada de extração fica entre o recebimento de RMAs (como seus clientes ou parceiros enviam devoluções) e sua pilha de operações (WMS, ERP, planilha de rastreamento). Veja como configurá-la especificamente para formulários de RMA.
Defina suas colunas de extração de RMA
Comece com os campos que impulsionam suas operações. Um conjunto padrão de extração de RMA inclui: Número do RMA, Número do Pedido, SKU, Código do Motivo da Devolução, Quantidade Devolvida, Condição do Item, Resolução Solicitada, Nome do Cliente. Se você lida com devoluções B2B, adicione Nome do Fornecedor, Referência da Nota de Crédito e Número do Contrato. Para disposição inferida, adicione Disposição (opções: Repor / Reformar / Liquidar / RTV / Descartar). A IA usa o código do motivo e a condição para atribuir uma disposição automaticamente.
Envie formulários de RMA em qualquer formato
Envie-os conforme chegam — PDFs do seu portal de devoluções, fotos de recibos de devolução manuscritos do serviço de campo, formulários de autorização B2B digitalizados. Sem pré-processamento, sem configuração de modelo por formato. A IA lê entre formatos porque analisa a informação, não o layout. Se você processa devoluções de 3 canais de vendas e 15 formulários de devolução de fornecedores, envie todos no mesmo lote — os nomes das colunas definidos na Etapa 1 se aplicam universalmente.
Processe o lote
A IA processa cada formulário — normalmente de 5 a 10 segundos por página — extraindo os campos definidos e atribuindo automaticamente categorias de disposição onde configurado. O processamento ocorre em paralelo, então um lote de 50 formulários de RMA é concluído em minutos, não em horas. Você verá os resultados aparecerem linha por linha conforme os formulários são finalizados.
Exporte para Excel e encaminhe para sua pilha de operações
Baixe a planilha mesclada — uma linha por formulário de RMA, todas as colunas definidas. A saída é Excel (XLSX) ou CSV, pronta para importação no seu WMS, ERP ou plataforma de gestão de devoluções. Uma coluna de nome do arquivo de origem rastreia cada linha até seu formulário original, fornecendo uma trilha de auditoria do formulário aos dados.
Os arquivos são processados com segurança e não são armazenados.
A demonstração acima usa "Formulário RMA" como tipo de documento — digite seus próprios nomes de colunas e envie um formulário RMA de exemplo para ver a extração em ação. Para lotes de produção com centenas de devoluções por semana, o mesmo fluxo de trabalho escala sem configuração adicional. Sem configuração por formulário, sem biblioteca de modelos para manter. Para a lista completa de campos, fluxo de trabalho em lote com formatos mistos e opções de exportação em um só lugar, veja o conversor de RMA para Excel.
Rastreamento de Dados de Devoluções para Análise de Disposição e Tendências
Quando seus dados de RMA chegam a uma planilha, eles se tornam a base para decisões de logística reversa que impactam diretamente a recuperação de margem. A disposição — a decisão sobre o que acontece com um item devolvido — determina se uma devolução custa dinheiro ou recupera valor. Os caminhos padrão de disposição são: restock (o item volta ao estoque vendável), refurbish (o item precisa de reparo antes da revenda), liquidate (vender com desconto por canais secundários), return to vendor (RTV — devolver ao fornecedor para crédito) ou dispose (o item não tem valor recuperável).
Cada caminho tem um resultado financeiro diferente. Um item restocado a preço cheio recupera valor quase completo, menos o custo de processamento. Um item reformado normalmente recupera 40–60% do valor original. Um palete liquidado pode recuperar 10–20%. A diferença entre encaminhar uma devolução para restock versus liquidação é margem pura — mas depende de ter dados precisos de condição do item e código de motivo no ponto de inspeção para tomar a decisão certa.
Com dados de RMA extraídos em uma planilha, você pode executar a análise que a maioria das operações de devolução ignora:
- Velocidade do código de motivo por SKU. Quais produtos geram o maior número de devoluções "defeituosas"? É um lote específico, um armazém específico que as manipula ou um problema inerente de design? Sem dados de código de motivo normalizados em todas as devoluções, você está adivinhando.
- Distribuição de disposição. Que porcentagem das devoluções vai para restock vs. reforma vs. descarte? Se a taxa de descarte está subindo, algo a montante está mudando — qualidade do fornecedor, embalagem ou mix de motivos de devolução.
- Tempo de processamento por caminho de disposição. Quanto tempo uma devolução leva em cada etapa — da emissão da RMA ao recebimento no armazém até a disposição final? O benchmark de operações de devolução define a meta de 2–7 dias do recebimento à disposição; cada dia além disso corrói o valor residual.
- Comparação entre múltiplos armazéns. Se o Armazém A processa devoluções no dobro da taxa do Armazém B com a mesma equipe, a planilha mostra onde focar a melhoria de processos — ou se a qualidade do formulário de entrada difere entre os locais.
A planilha não substitui um WMS. Ela fecha a lacuna entre os dados que você tem (formulários) e os dados que seu WMS precisa para rotear devoluções corretamente.
Quando o volume de devoluções ultrapassa centenas por semana, o mesmo fluxo de extração escala para processamento em lote de formulários de RMA em uma única planilha de reconciliação de reembolsos — com campos de roteamento e reconciliação incorporados à saída, em vez de adicionados em uma segunda passagem manual.
Integrando Dados de RMA Extraídos com sua Stack de Armazém
A maioria das operações de devolução já possui uma stack de software. A questão não é substituí-la — é como alimentá-la com dados limpos. A camada de extração gera saídas em Excel (XLSX) e CSV, que todos os principais WMS e ERP aceitam para importação. O caminho de integração depende do que você está usando. Para um passo a passo campo a campo do mapeamento de colunas extraídas no schema de importação de um sistema de inventário, consulte nosso guia sobre alimentar dados de devolução RMA no seu sistema de inventário.
NetSuite: Se sua equipe de devoluções já gera registros de RMA no NetSuite, o gargalo é a etapa de entrada de dados — digitar campos de formulário no módulo RMA do NetSuite. A planilha de extração pode ser importada diretamente na ferramenta de importação CSV do NetSuite, mapeando suas colunas extraídas (Número do RMA, SKU, Código de Motivo, Disposição) para os campos RMA do NetSuite. No mesmo tópico do r/Netsuite onde usuários descreveram o problema de RMA com dois funcionários em tempo integral, foi observado que o NetSuite "segurava os registros bem" — o problema sempre foi inserir dados nos registros.
ShipStation / Cin7 / Fishbowl: Essas plataformas WMS lidam com rastreamento de inventário e atendimento de pedidos nativamente, mas o roteamento de devoluções — decidir qual disposição um item devolvido recebe — depende de dados que vêm do formulário de RMA. Importe sua planilha extraída como CSV no módulo de devoluções, e o WMS pode rotear itens para reposição, quarentena, reforma ou zonas RTV com base na coluna de disposição que você gerou durante a extração.
Google Sheets / rastreamento manual: Para operações que funcionam com planilhas, a saída da extração já está no seu formato de trabalho. Exporte para XLSX, abra no Google Sheets, e você substituiu uma etapa de digitação manual por um feed direto — mesma planilha, sem digitação. Esta é a configuração mais comum para 3PLs de pequeno e médio porte e operações de armazém que não têm um WMS formal.
O padrão consistente nas três abordagens é o mesmo: a camada de extração desacopla "ler o formulário" de "agir sobre os dados". Se os dados chegam no NetSuite, ShipStation ou em um Google Sheet compartilhado é uma decisão downstream que não muda como a extração é configurada. Uma configuração de extração funciona em todos os destinos.
FAQ
Isso funciona em formulários RMA manuscritos?
Sim — com as mesmas ressalvas que se aplicam a todo reconhecimento de escrita manual. Se a caligrafia for legível para um leitor humano sob iluminação razoável, a extração por IA normalmente consegue lê-la. Tinta borrada, cursiva extremamente comprimida ou escrita que se mistura a outros campos reduzirão a precisão. A mesma extração baseada em colunas funciona em formulários digitados e manuscritos sem nenhuma alteração de configuração — você não precisa informar ao sistema quais formulários são manuscritos e quais são impressos. Para mais detalhes sobre o desempenho da extração específico para escrita manual, consulte nosso guia para melhorar a precisão da extração de escrita manual.
Posso extrair dados de formulários RMA em diferentes idiomas?
A IA lê o conteúdo do documento no idioma em que ele aparece — se seus formulários RMA estiverem em inglês, espanhol, alemão ou uma mistura, a extração processa cada formulário individualmente. Os nomes das colunas devem estar no idioma em que você deseja a saída. Não há necessidade de pré-traduzir ou normalizar o idioma antes do upload.
E se meus formulários RMA não tiverem todos os mesmos campos?
Esse é o cenário esperado. A Extração de Colunas Personalizadas não exige que todo formulário contenha todos os campos. Se um formulário não tiver um campo que você definiu — um formulário manuscrito que não inclui um "Código de Motivo", por exemplo — essa célula fica em branco na saída. O sistema não adivinha nem fabrica dados para preencher lacunas. Isso é importante especificamente para fluxos de trabalho de RMA, onde formulários de devolução B2B de diferentes fornecedores têm conjuntos de campos diferentes.
Como isso se compara ao uso de uma plataforma dedicada de gerenciamento de devoluções como Loop Returns ou Happy Returns?
Plataformas de devolução dedicadas lidam com o fluxo de trabalho voltado ao cliente — portais personalizados, geração de etiquetas, processamento de reembolsos — e são a ferramenta certa quando você precisa oferecer aos compradores uma experiência de devolução self-service. A camada de extração tem uma função diferente: ela extrai dados de formulários RMA independentemente de onde esses formulários vêm. Se todas as suas devoluções passam por um único portal com captura de dados estruturados, você não precisa de extração — o portal já fornece dados estruturados. Se suas devoluções chegam por vários canais — um portal, e-mail, formulários de fornecedores B2B, formulários em papel — a extração preenche a lacuna que o portal não consegue cobrir.
Qual é a precisão dos códigos de motivo e campos de disposição?
Para formulários RMA impressos e limpos, a precisão em campos estruturados, como números de pedido e SKUs, chega a 99%. Códigos de motivo — que geralmente são rótulos de texto curtos, como "Defeituoso" ou "Tamanho Errado" — têm alta confiança porque possuem vocabulário restrito. A maior variável é a qualidade da entrada: uma foto nítida de um formulário RMA impresso será extraída com mais precisão do que uma foto borrada de um recibo de devolução amassado. Para campos onde um erro é caro — como encaminhar uma devolução para a disposição errada — uma verificação humana rápida da planilha antes da importação é uma salvaguarda prática. Para mais detalhes sobre precisão por tipo de campo, consulte nossa análise em camadas da precisão da extração.
Preciso treinar a IA no formato do meu formulário RMA primeiro?
Não. A extração sem modelo significa que a IA processa qualquer formato de formulário RMA sem treinamento prévio ou anotação de amostras. Você define os nomes das colunas uma vez, e esses mesmos nomes extraem de todos os formatos que você enviar — PDFs de portal, formulários digitalizados de fornecedores, slips manuscritos, fotos tiradas em um armazém. O requisito de zero treinamento é o que torna essa abordagem viável para operações de devolução que lidam com formulários de dezenas de fontes diferentes, cada uma com seu próprio layout.
Fechando a Lacuna de Dados que a Automação de Devoluções Esqueceu
A indústria de logística reversa investiu pesado nas partes visíveis das devoluções — portais do cliente, redes de drop-off, reembolsos instantâneos, detecção de fraude. O que não foi automatizado é o passo mais silencioso e trabalhoso: ler o formulário e digitar os dados. É o passo que fica entre cada ferramenta de software na pilha e as informações reais que essas ferramentas precisam para funcionar.
$849.9 bilhões em devoluções passam por esse passo todos os anos. A diferença entre uma operação de devoluções que vê tendências e uma que adivinha não é um portal melhor, um reembolso mais rápido ou um WMS mais sofisticado. É se os dados no formulário RMA chegam a uma planilha a tempo de importar.
Experimente com seus próprios formulários RMA. Envie um lote e veja se os dados que você digita manualmente aparecem em colunas em 5 segundos, em vez de 5 minutos por formulário.
Sem necessidade de cadastro para demonstração