Comment traiter les données de retours RMA
pour le suivi Excel
Les détaillants américains ont traité 849,9 milliards de dollars de retours en 2025, selon la National Retail Federation. Chacun de ces retours a commencé par un formulaire — un bordereau RMA, un PDF d'autorisation de retour, parfois une note manuscrite glissée dans un colis retourné. L'ironie : les données de ces formulaires sont l'entrée la plus précieuse pour réduire les retours futurs, mais dans la plupart des opérations, elles n'arrivent jamais dans un tableur.

Points clés
- Deux employés à temps plein qui ne font que saisir les champs des formulaires RMA dans des tableurs — et vos données de codes motif arrivent encore trop tard pour repérer un lot défectueux avant l'expédition suivante.
- L'extraction basée sur des modèles casse dès qu'un fournisseur modifie la mise en page de son formulaire — c'est pourquoi vos 15 formats RMA différents garantissent que près de la moitié de vos retours ne seront jamais automatisés, quel que soit le nombre de modèles créés.
- Définissez vos noms de colonnes une fois et la même extraction lit tous les formats — PDF de portail, bordereaux manuscrits, formulaires fournisseurs — sans un seul modèle à maintenir ou à entraîner.
L'angle mort des données RMA : pourquoi les retours s'effondrent entre le formulaire et le tableur
Les logiciels de gestion des retours ont résolu la moitié du processus RMA tournée vers le client. Les portails de Loop Returns, Happy Returns et Narvar permettent aux acheteurs d'initier des retours, d'imprimer des étiquettes et de suivre les remboursements sans jamais écrire au support. Mais cette automatisation s'arrête à la couche de données — le point où les informations d'un formulaire RMA doivent devenir une ligne dans un tableur exploitable par une équipe d'entrepôt, un gestionnaire de retours ou un système ERP.
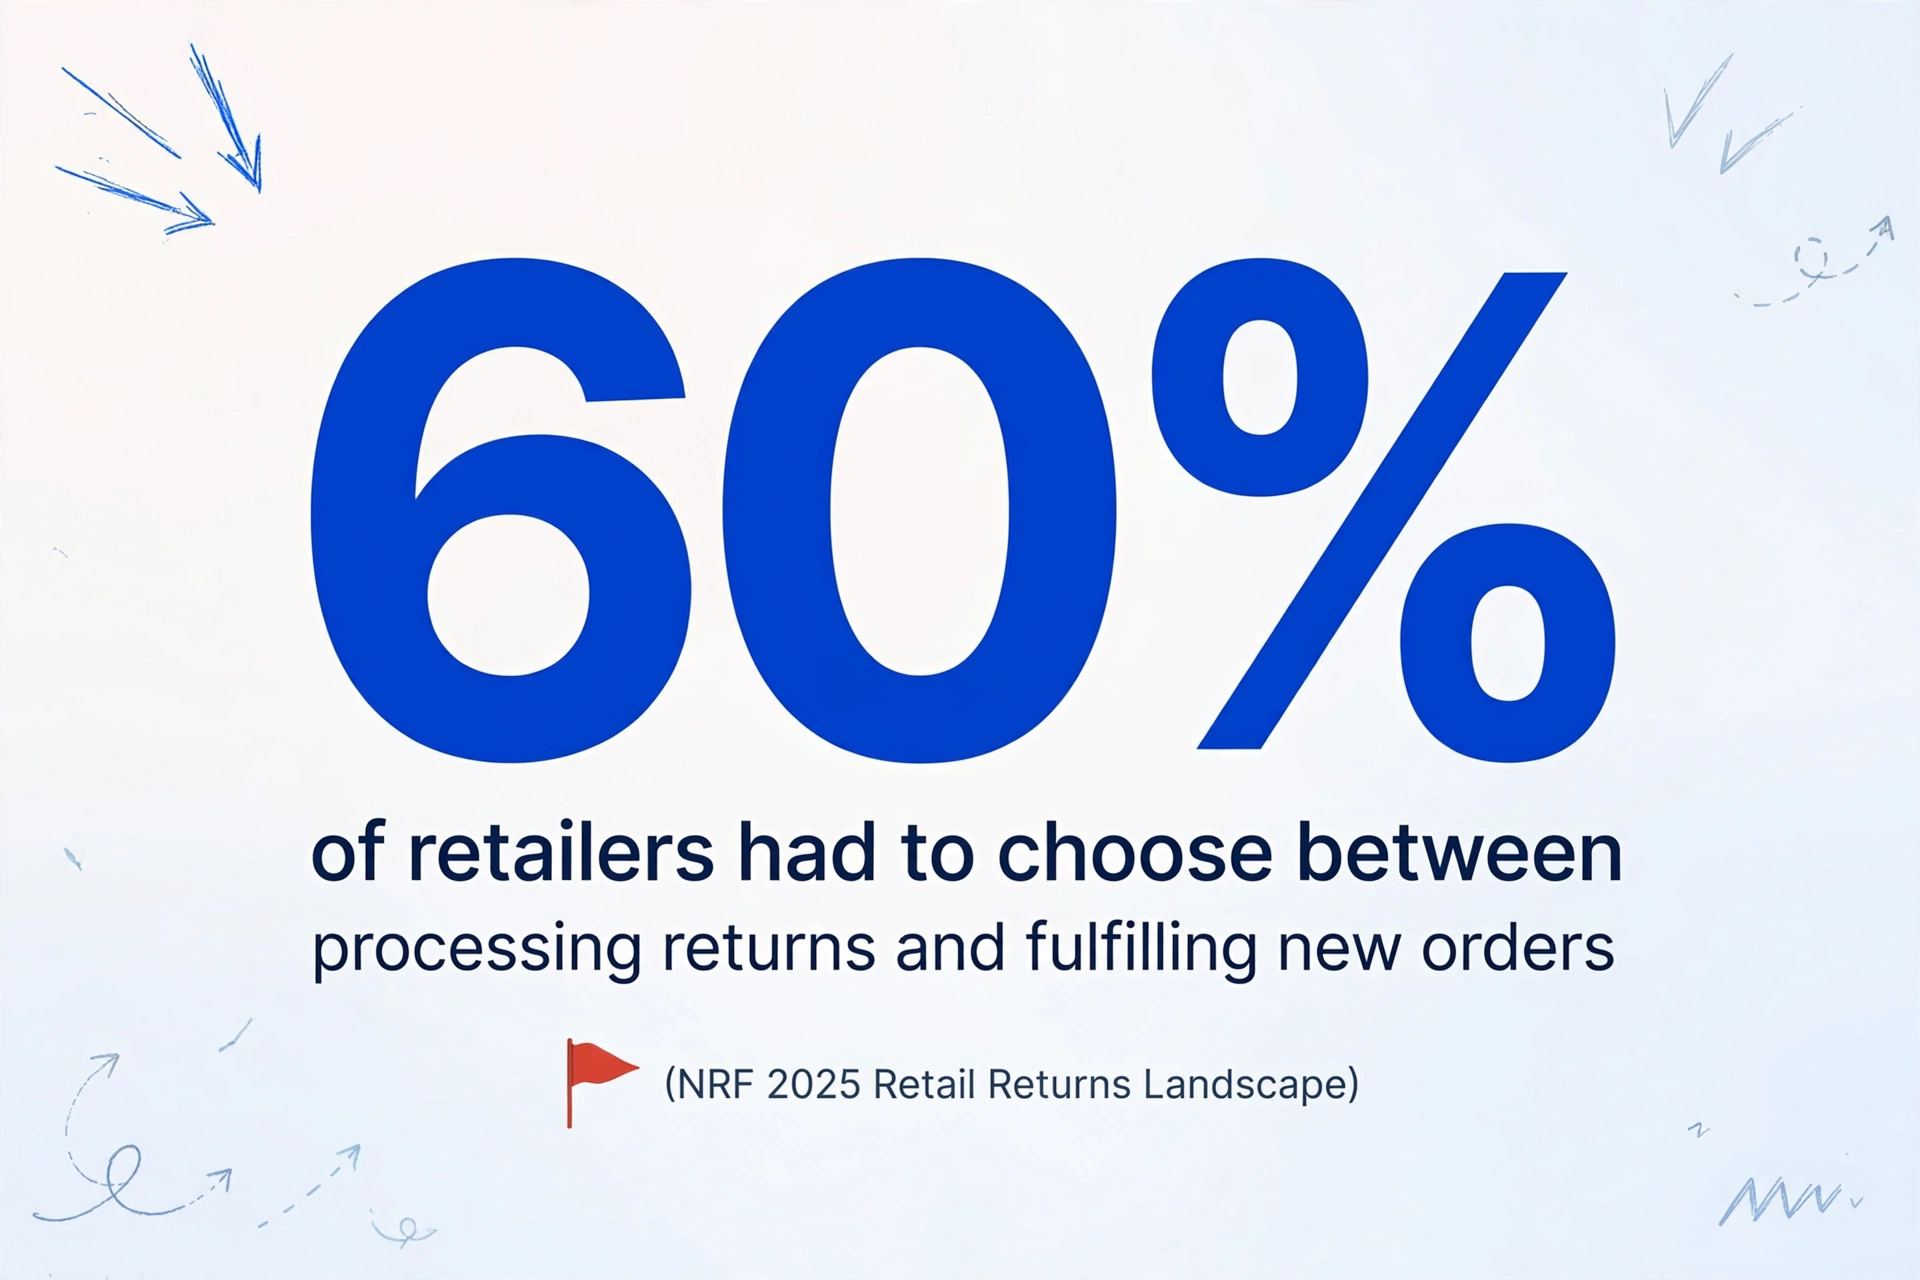
Les chiffres expliquent pourquoi cet écart compte. Le rapport NRF 2025 Retail Returns Landscape, réalisé en partenariat avec Happy Returns (une société de UPS), révèle que 60 % des détaillants ont dû choisir entre traiter les retours et honorer de nouvelles commandes. Neuf pour cent de tous les retours sont classés comme frauduleux — et sans suivi structuré, distinguer un retour légitime d'un retour frauduleux relève de la devinette. La Reverse Logistics Association, qui représente un marché de 3,18 billions de dollars d'ici 2033, a fait de la disposition pilotée par les données son thème central lors de ses récentes conférences annuelles.
Ce qui se trouve entre le portail de retours et le plancher de l'entrepôt est étonnamment peu technologique : quelqu'un ouvre un formulaire RMA — qu'il s'agisse d'un PDF issu d'un portail client, d'un bordereau de retour scanné d'un distributeur B2B ou d'une autorisation manuscrite glissée dans un colis — et saisit manuellement les champs dans un tableur de suivi. Un post sur r/Netsuite décrit exactement la situation : « Le processus RMA est devenu un emploi à plein temps pour deux personnes. Chaque retour commence par un client qui nous envoie un e-mail, quelqu'un qui l'approuve manuellement, puis qui génère manuellement une étiquette. » Un distributeur sur r/supplychain l'a dit plus crûment : son processus de retours le « dévorait vivant » — flux RMA manuels, cauchemars de rapprochement des avoirs fournisseurs et goulots d'étranglement en entrepôt.
La pièce manquante de l'automatisation des retours n'est pas le portail de retours. C'est la couche d'extraction — l'étape qui transforme un formulaire en données structurées.
Ce que contient réellement un formulaire RMA — et pourquoi la saisie manuelle ne passe pas à l'échelle
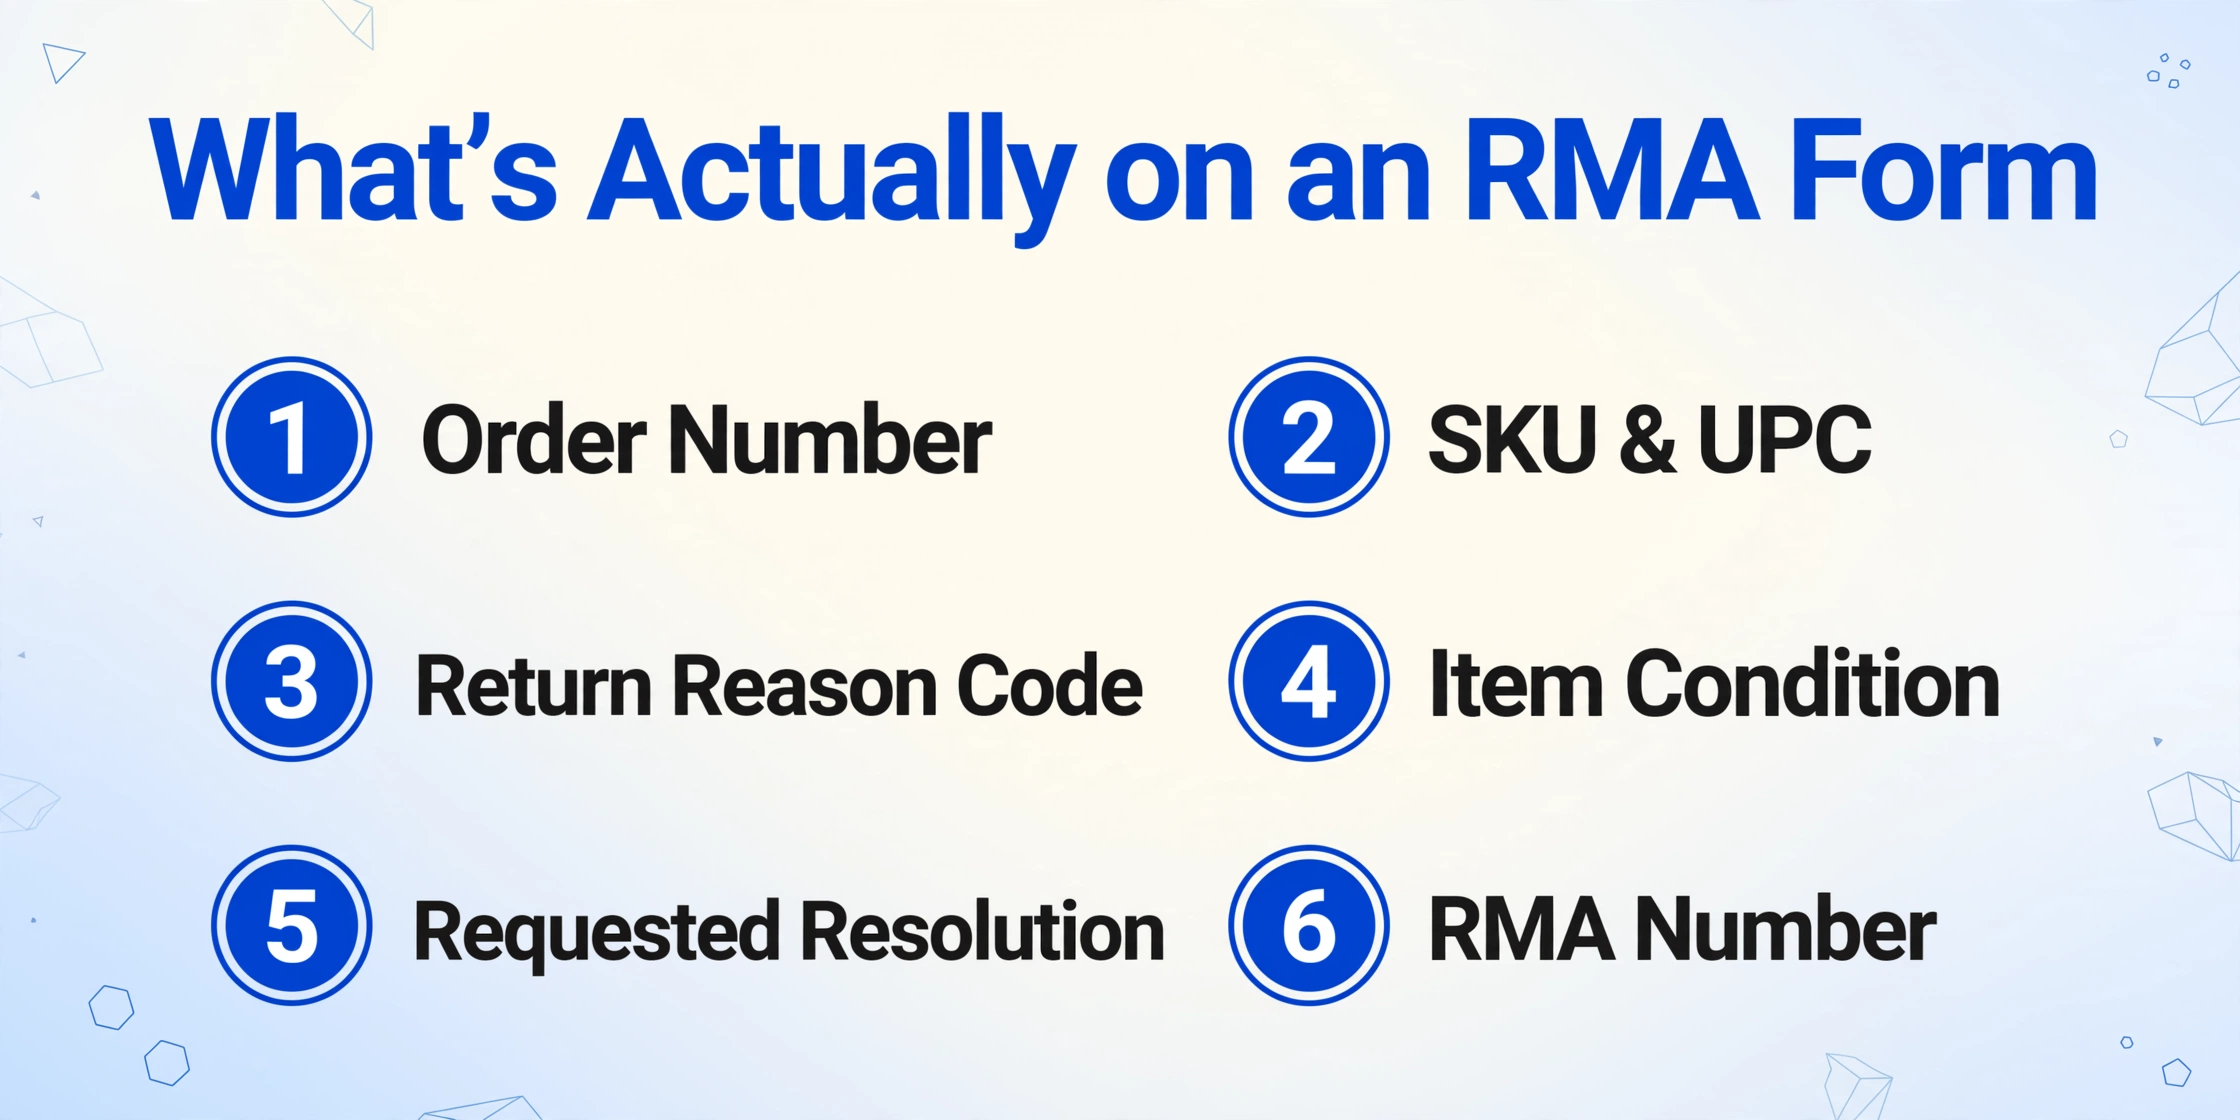
Un formulaire RMA standard capture plus d'informations qu'on ne l'imagine. Il ne s'agit pas simplement de « le client veut retourner un article ». Un formulaire RMA complet comprend le numéro de commande, le SKU et l'UPC du produit, la quantité retournée, le code de motif de retour (défectueux, mauvaise taille, non conforme à la description, endommagé pendant le transport, changement d'avis), l'état de l'article à la réception (non ouvert, ouvert, endommagé, accessoires manquants), la résolution souhaitée (remboursement, échange, avoir, réparation) et le numéro RMA attribué lui-même. Pour les retours B2B — qui, selon les données d'IMARC Group, représentaient 35,1 % des revenus de logistique inverse en 2024 — le formulaire inclut aussi des conditions contractuelles spécifiques, des références d'avoirs et des quantités de retour en gros.
Le champ le plus précieux sur le plan opérationnel de ce formulaire est le code de motif. Quand « défectueux » explose pour un SKU donné, c'est un signal de contrôle qualité. Quand « mauvaise taille » domine les retours d'une gamme de vêtements, c'est un problème de guide des tailles. L'analyse des données RMA de LateShipment a montré que le suivi au niveau du code de motif révèle des problèmes que les taux de retour agrégés masquent — un lancement produit affichant un taux de retour global de 4 % peut sembler correct, jusqu'à ce qu'on voie que « article non conforme à la description » est passé de 2 % à 18 % pour ce seul SKU.
Mais capturer les données de code de motif à grande échelle exige de les extraire du formulaire. Si chaque code de motif de retour est saisi à la main — depuis un PDF, un bordereau scanné ou une note manuscrite — les données arrivent en retard, de façon incohérente, et souvent pas du tout. La recherche interne de ReturnPro a montré que les clients choisissent de manière disproportionnée le premier motif listé dans un menu déroulant, ce qui signifie que les données manuelles issues des formulaires clients sont déjà faussées. Obtenir des données de code de motif exactes nécessite une extraction plus une logique de catégorisation structurée — ce que la saisie manuelle ne peut pas garantir.
Comment l'extraction IA lit les formulaires RMA sans modèle
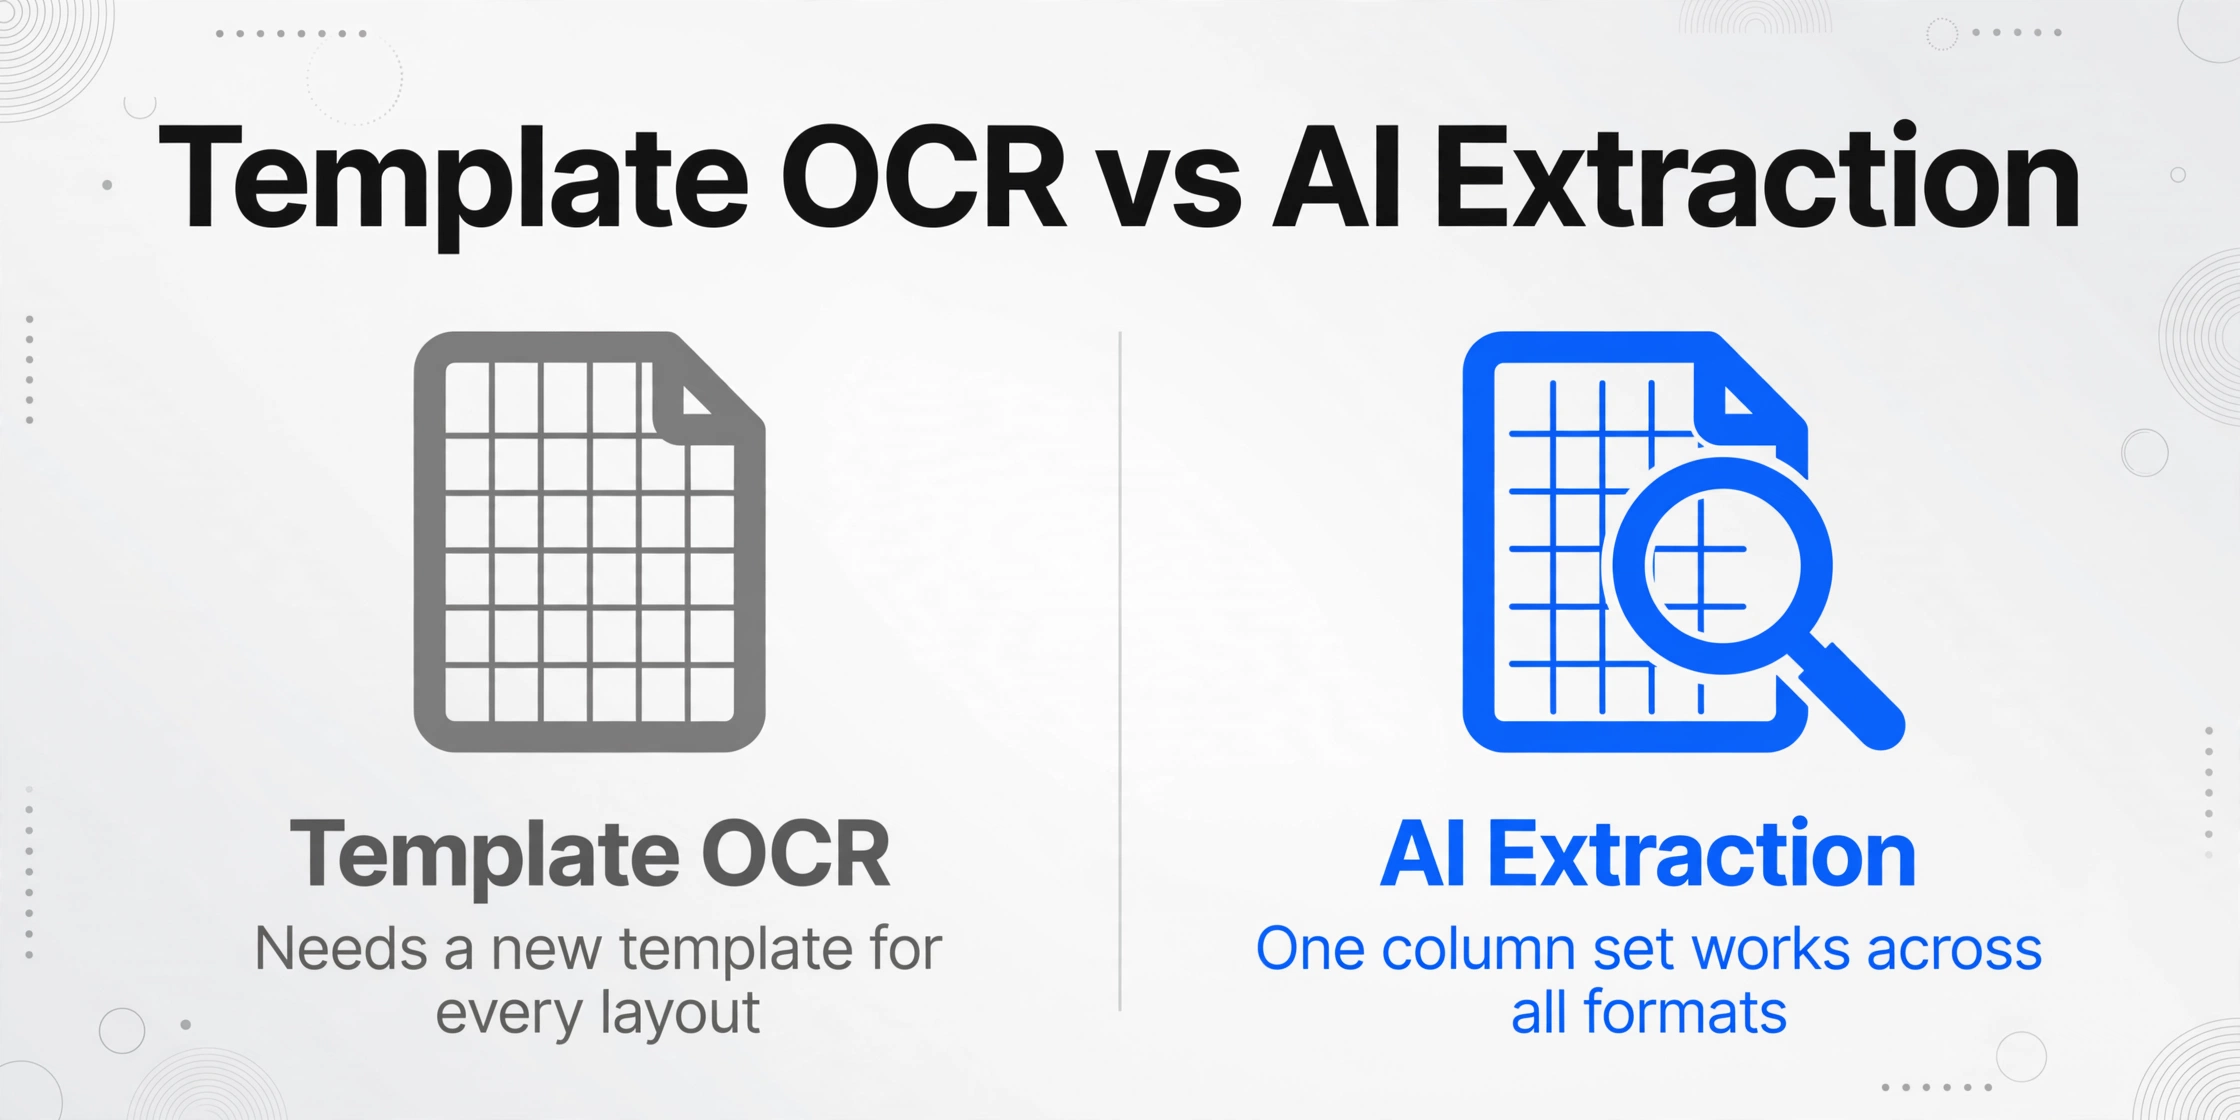
L'OCR traditionnel traite un document en convertissant les images de caractères en un flux de texte. Il ne sait pas quel texte est le numéro RMA et lequel est le motif de retour — il vous livre simplement un mur de mots. Les outils basés sur des modèles vont plus loin en vous permettant de définir des coordonnées pour chaque champ, mais cette approche s'effondre dès que la mise en page d'un formulaire change. Un RMA peut arriver sous forme de PDF généré par un portail de retours ; le suivant sous forme de photo d'un bordereau manuscrit ; le troisième sous forme de formulaire d'autorisation B2B scanné depuis le système ERP d'un fournisseur. Chaque format exige un nouveau modèle — et maintenir des modèles pour toutes les variantes de formulaires, c'est ce qui transforme un processus RMA de deux ETP en un besoin permanent en personnel.
L'Extraction de colonnes personnalisées basée sur l'IA fonctionne différemment. Au lieu d'indiquer au système où trouver chaque champ sur la page, vous lui dites ce que vous recherchez — en saisissant les noms de colonnes souhaités dans votre feuille de calcul de sortie. « Numéro RMA. » « Code de motif de retour. » « SKU. » « Quantité. » « Résolution demandée. » L'IA lit chaque formulaire, localise les valeurs correspondant à ces noms de colonnes d'après leur signification — et non leurs coordonnées — et les remplit dans les colonnes correspondantes. Le même ensemble de noms de colonnes fonctionne que le formulaire soit un PDF net, une photo penchée prise au téléphone d'un bordereau de retour manuscrit, ou un formulaire papier scanné sorti d'une armoire de classement vieille de dix ans.
C'est la différence entre extraire des données et transcrire du texte. Un RMA manuscrit indiquant « RMA # — 44291 — Motif : endommagé » à l'encre baveuse est lu de la même manière qu'un PDF généré par un portail avec des champs clairement étiquetés : l'IA identifie « 44291 » comme le numéro RMA parce qu'elle comprend la relation sémantique entre un numéro et son libellé, et non parce qu'il correspond à une position prédéfinie sur un modèle. Pour les équipes qui traitent des retours sur plusieurs entrepôts, depuis plusieurs canaux de vente, chacun avec des formats de formulaires RMA différents, cette approche sans modèle fait la différence entre un système qui fonctionne et un système qui ne gère que les 60 % de formulaires les plus propres.
Ce mécanisme ne se limite pas aux champs explicitement écrits sur le formulaire. Vous pouvez définir des colonnes inférées — par exemple, une colonne « Catégorie de disposition » définie comme « options : Remettre en stock, Reconditionner, Mettre au rebut, Retour au fournisseur. » L'IA lit l'état de l'article et le code de motif, puis attribue une disposition probable selon vos règles métier — même si aucun champ « Disposition » n'existe sur le formulaire. Vous obtenez l'extraction et la classification en une seule passe.
Étape par étape : construire un pipeline de données RMA du formulaire au tableur
La couche d'extraction se situe entre la réception des RMA (quelle que soit la façon dont vos clients ou partenaires soumettent les retours) et votre pile opérationnelle (WMS, ERP, tableur de suivi). Voici comment la configurer spécifiquement pour les formulaires RMA.
Définissez vos colonnes d'extraction RMA
Commencez par les champs qui pilotent vos opérations. Un ensemble d'extraction RMA standard comprend : RMA Number, Order Number, SKU, Return Reason Code, Quantity Returned, Item Condition, Requested Resolution, Customer Name. Si vous gérez des retours B2B, ajoutez Vendor Name, Credit Note Reference et Contract Number. Pour une disposition inférée, ajoutez Disposition (options: Restock / Refurbish / Liquidate / RTV / Dispose). L'IA utilise le code de motif et l'état pour attribuer automatiquement une disposition.
Importez les formulaires RMA dans n'importe quel format
Importez-les tels qu'ils arrivent — PDF de votre portail de retours, photos de bordereaux de retour manuscrits du service terrain, formulaires d'autorisation B2B scannés. Aucun prétraitement, aucune configuration de modèle par format. L'IA lit tous les formats car elle examine l'information, pas la mise en page. Si vous traitez des retours provenant de 3 canaux de vente et de 15 formulaires de retour fournisseur, importez-les tous dans le même lot — les noms de colonnes définis à l'étape 1 s'appliquent universellement.
Traitez le lot
L'IA traite chaque formulaire — généralement 5 à 10 secondes par page — en extrayant les champs que vous avez définis et en attribuant automatiquement les catégories de disposition lorsque configuré. Le traitement s'effectue en parallèle, donc un lot de 50 formulaires RMA se termine en quelques minutes, pas en heures. Les résultats s'affichent ligne par ligne au fur et à mesure que les formulaires sont traités.
Exportez vers Excel et acheminez vers votre pile opérationnelle
Téléchargez le tableur fusionné — une ligne par formulaire RMA, chaque colonne que vous avez définie. Le résultat est au format Excel (XLSX) ou CSV, prêt à être importé dans votre WMS, ERP ou plateforme de gestion des retours. Une colonne de nom de fichier source permet de retracer chaque ligne jusqu'à son formulaire d'origine, vous offrant une piste d'audit du formulaire aux données.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
La démo ci-dessus utilise « RMA Form » comme type de document — saisissez vos propres noms de colonnes et importez un exemple de formulaire RMA pour voir l'extraction en action. Pour les lots de production avec des centaines de retours par semaine, le même flux de travail s'adapte sans configuration supplémentaire. Aucune configuration par formulaire, aucune bibliothèque de modèles à maintenir. Pour la liste complète des champs, le flux de travail par lots multi-formats et les options d'export en un seul endroit, consultez le convertisseur RMA vers Excel.
Suivi des données de retour pour l'analyse de disposition et de tendance
Une fois vos données RMA dans un tableur, elles deviennent la base des décisions de logistique inverse qui impactent directement la récupération de marge. La disposition — la décision de ce qu'il advient d'un article retourné — détermine si un retour vous coûte de l'argent ou récupère de la valeur. Les voies de disposition standard sont le réapprovisionnement (l'article retourne au stock vendable), la remise en état (l'article doit être réparé avant revente), la liquidation (vente à prix réduit via des canaux secondaires), le retour au fournisseur (RTV — renvoyer au fournisseur pour crédit), ou la mise au rebut (l'article n'a aucune valeur récupérable).
Chaque voie a un résultat financier différent. Un article réapprovisionné au prix de détail complet récupère une valeur quasi complète moins les coûts de traitement. Un article remis en état récupère généralement 40–60 % de sa valeur d'origine. Une palette liquidée peut récupérer 10–20 %. La différence entre acheminer un retour vers le réapprovisionnement plutôt que la liquidation est de la marge pure — mais elle dépend de données précises sur l'état de l'article et le code motif au moment de l'inspection pour prendre la bonne décision.
Avec les données RMA extraites dans un tableur, vous pouvez réaliser l'analyse que la plupart des opérations de retour négligent :
- Vélocité des codes motif par SKU. Quels produits génèrent le plus de retours « défectueux » ? S'agit-il d'un lot spécifique, d'un entrepôt spécifique qui les traite, ou d'un problème de conception inhérent ? Sans données de codes motif normalisées sur tous les retours, vous devinez.
- Répartition des dispositions. Quel pourcentage des retours va au réapprovisionnement vs. remise en état vs. rebut ? Si le taux de rebut augmente, quelque chose change en amont — qualité fournisseur, emballage, ou mix des motifs de retour.
- Temps de traitement par voie de disposition. Combien de temps un retour passe-t-il à chaque étape — de l'émission du RMA à la réception en entrepôt jusqu'à la disposition finale ? Le benchmark des opérations de retour fixe l'objectif à 2–7 jours entre la réception et la disposition ; chaque jour au-delà érode la valeur résiduelle.
- Comparaison multi-entrepôts. Si l'entrepôt A traite les retours deux fois plus vite que l'entrepôt B avec le même effectif, le tableur vous indique où concentrer l'amélioration des processus — ou si la qualité de saisie des formulaires diffère entre les sites.
Le tableur ne remplace pas un WMS. Il comble l'écart entre les données dont vous disposez (formulaires) et les données dont votre WMS a besoin pour acheminer correctement les retours.
Lorsque le volume de retours atteint des centaines par semaine, le même flux d'extraction s'adapte au traitement par lots des formulaires RMA dans une seule feuille de rapprochement des remboursements — avec les champs d'acheminement et de rapprochement intégrés à la sortie plutôt qu'ajoutés lors d'une seconde passe manuelle.
Intégrer les données RMA extraites à votre stack d'entrepôt
La plupart des opérations de retours disposent déjà d'une stack logicielle. La question n'est pas de savoir s'il faut la remplacer, mais comment l'alimenter en données propres. La couche d'extraction produit des fichiers Excel (XLSX) et CSV, que tous les principaux WMS et ERP acceptent à l'import. Le chemin d'intégration dépend de ce que vous utilisez. Pour un guide champ par champ du mappage des colonnes extraites vers le schéma d'import d'un système d'inventaire, consultez notre guide pour alimenter votre système d'inventaire avec les données de retour RMA.
NetSuite : Si votre équipe retours génère déjà des enregistrements RMA dans NetSuite, le goulot d'étranglement est la saisie des données — taper les champs du formulaire dans le module RMA de NetSuite. Le tableur d'extraction peut être importé directement via l'outil d'import CSV de NetSuite, en mappant vos colonnes extraites (RMA Number, SKU, Reason Code, Disposition) aux champs RMA de NetSuite. Le même fil r/Netsuite où des utilisateurs décrivaient le problème RMA à deux ETP notait que NetSuite « tenait bien les enregistrements » — le problème était toujours de faire entrer les données dans les enregistrements.
ShipStation / Cin7 / Fishbowl : Ces plateformes WMS gèrent nativement le suivi des stocks et l'exécution des commandes, mais le routage des retours — décider quelle disposition reçoit un article retourné — dépend de données issues du formulaire RMA. Importez votre tableur extrait au format CSV dans le module retours, et le WMS pourra router les articles vers les zones de remise en stock, quarantaine, reconditionnement ou RTV selon la colonne de disposition générée lors de l'extraction.
Google Sheets / suivi manuel : Pour les opérations qui fonctionnent sur tableur, la sortie d'extraction est déjà dans votre format de travail. Exportez en XLSX, ouvrez dans Google Sheets, et vous avez remplacé une étape de saisie manuelle par un flux direct — même tableur, aucune saisie. C'est la configuration la plus courante pour les 3PL et les opérations d'entrepôt de petite et moyenne taille qui n'ont pas de WMS formel.
Le schéma constant dans ces trois approches est le même : la couche d'extraction découple « lire le formulaire » de « agir sur les données ». Que les données arrivent dans NetSuite, ShipStation ou un Google Sheet partagé est une décision en aval qui ne change pas la façon dont l'extraction est configurée. Une seule configuration d'extraction fonctionne pour toutes les destinations.
FAQ
Cela fonctionne-t-il sur les bordereaux RMA manuscrits ?
Oui — avec les mêmes réserves qui s'appliquent à toute reconnaissance d'écriture manuscrite. Si l'écriture est lisible par un lecteur humain dans un éclairage raisonnable, l'extraction par IA peut généralement la lire. L'encre baveuse, une cursive extrêmement compressée ou une écriture qui empiète sur d'autres champs réduiront la précision. La même extraction par colonne fonctionne sur les formulaires dactylographiés et manuscrits sans aucun changement de configuration — vous n'avez pas besoin d'indiquer au système quels formulaires sont manuscrits et lesquels sont imprimés. Pour en savoir plus sur les performances d'extraction propres à l'écriture manuscrite, consultez notre guide pour améliorer la précision de l'extraction de l'écriture manuscrite.
Puis-je extraire des données de formulaires RMA dans différentes langues ?
L'IA lit le contenu du document dans la langue dans laquelle il apparaît — si vos formulaires RMA sont en anglais, en espagnol, en allemand ou un mélange, l'extraction traite chaque formulaire individuellement. Les noms de colonnes doivent être dans la langue souhaitée pour votre sortie. Il n'est pas nécessaire de pré-traduire ou de normaliser la langue avant le téléversement.
Que faire si mes formulaires RMA n'ont pas tous les mêmes champs ?
C'est le scénario attendu. L'Extraction de colonnes personnalisées n'exige pas que chaque formulaire contienne chaque champ. Si un formulaire ne contient pas un champ que vous avez défini — un bordereau manuscrit sans « Code de motif », par exemple — cette cellule reste vide dans la sortie. Le système ne devine ni ne fabrique de données pour combler les lacunes. C'est particulièrement important pour les flux RMA, où les formulaires de retour B2B de différents fournisseurs ont des ensembles de champs différents.
Comment cela se compare-t-il à l'utilisation d'une plateforme dédiée à la gestion des retours comme Loop Returns ou Happy Returns ?
Les plateformes de retours dédiées gèrent le flux côté client — portails de marque, génération d'étiquettes, traitement des remboursements — et constituent le bon outil lorsque vous devez offrir aux acheteurs une expérience de retours en libre-service. La couche d'extraction remplit une fonction différente : elle extrait les données des formulaires RMA quel que soit leur origine. Si tous vos retours passent par un seul portail avec une saisie de données structurée, vous n'avez pas besoin d'extraction — le portail vous fournit déjà des données structurées. Si vos retours arrivent par plusieurs canaux — un portail, des e-mails, des formulaires fournisseurs B2B, des bordereaux papier — l'extraction comble le vide que le portail ne peut pas couvrir.
Quelle est la précision pour les codes de motif et les champs de disposition ?
Pour les formulaires RMA imprimés et propres, la précision sur les champs structurés comme les numéros de commande et les SKU atteint jusqu'à 99 %. Les codes de motif — généralement de courts libellés textuels comme « Défectueux » ou « Mauvaise taille » — bénéficient d'une confiance élevée car leur vocabulaire est limité. La plus grande variable est la qualité de l'entrée : une photo nette d'un formulaire RMA imprimé sera extraite avec plus de précision qu'une photo floue d'un bordereau de retour froissé. Pour les champs où une erreur coûte cher — comme l'acheminement d'un retour vers la mauvaise disposition — une vérification humaine rapide du tableur avant import constitue une safeguard pratique. Pour en savoir plus sur la précision par type de champ, consultez notre analyse par couches de la précision d'extraction.
Dois-je d'abord entraîner l'IA sur le format de mon formulaire RMA ?
Non. L'extraction sans modèle signifie que l'IA traite n'importe quel format de formulaire RMA sans entraînement préalable ni annotation d'exemple. Vous définissez les noms de colonnes une seule fois, et ces mêmes noms de colonnes sont extraits de tous les formats que vous lui soumettez — PDF de portail, formulaires fournisseurs scannés, bordereaux manuscrits, photos prises dans un entrepôt. L'absence d'entraînement est ce qui rend cette approche viable pour les opérations de retour qui traitent des formulaires provenant de dizaines de sources différentes, chacune avec sa propre mise en page.
Combler le fossé de données que l'automatisation des retours a oublié
L'industrie de la logistique inverse a investi massivement dans les parties visibles des retours — portails clients, réseaux de dépôt, remboursements instantanés, détection de fraude. Ce qui n'a pas été automatisé, c'est l'étape la plus discrète et la plus gourmande en main-d'œuvre : lire le formulaire et saisir les données. C'est l'étape qui se situe entre chaque outil logiciel de la chaîne et les informations réelles dont ces outils ont besoin pour fonctionner.
$849.9 billion de retours passent par cette étape chaque année. La différence entre une opération de retours qui perçoit les tendances et une qui les devine ne réside pas dans un meilleur portail, un remboursement plus rapide ou un WMS plus sophistiqué. Elle réside dans le fait que les données du formulaire RMA arrivent dans un tableur à temps pour être utiles.
Essayez avec vos propres formulaires RMA. Importez un lot et voyez si les données que vous saisissiez à la main apparaissent en colonnes en 5 secondes au lieu de 5 minutes par formulaire.
Aucune inscription requise pour la démo