Cómo procesar datos de devoluciones RMA
para seguimiento en Excel
Los minoristas de EE. UU. gestionaron $849.9 mil millones en devoluciones en 2025, según la National Retail Federation. Cada una de esas devoluciones comenzó con un formulario: un comprobante RMA, un PDF de autorización de devolución, a veces una nota manuscrita metida en la caja devuelta. La ironía: los datos de esos formularios son el insumo más valioso para reducir devoluciones futuras, pero en la mayoría de las operaciones nunca llegan a una hoja de cálculo.

Conclusiones clave
- Dos empleados a tiempo completo que solo escriben campos de formularios RMA en hojas de cálculo, y aun así tus datos de códigos de motivo llegan demasiado tarde para detectar un lote defectuoso antes del próximo envío.
- La extracción basada en plantillas falla en cuanto un proveedor cambia el diseño de su formulario, por eso tus 15 formatos RMA diferentes garantizan que casi la mitad de tus devoluciones nunca se automaticen, sin importar cuántas plantillas crees.
- Define los nombres de tus columnas una sola vez y la misma extracción lee todos los formatos: PDFs de portales, notas manuscritas, formularios de proveedores, sin una sola plantilla que mantener o entrenar.
El punto ciego de los datos RMA: por qué las devoluciones fallan entre el formulario y la hoja de cálculo
El software de gestión de devoluciones ha resuelto la mitad orientada al cliente del proceso RMA. Los portales de Loop Returns, Happy Returns y Narvar permiten a los compradores iniciar devoluciones, imprimir etiquetas y rastrear reembolsos sin tener que enviar correos al soporte. Pero esa automatización se detiene en la capa de datos: el punto donde la información de un formulario RMA debe convertirse en una fila en una hoja de cálculo que un equipo de almacén, un procesador de devoluciones o un sistema ERP pueda utilizar.
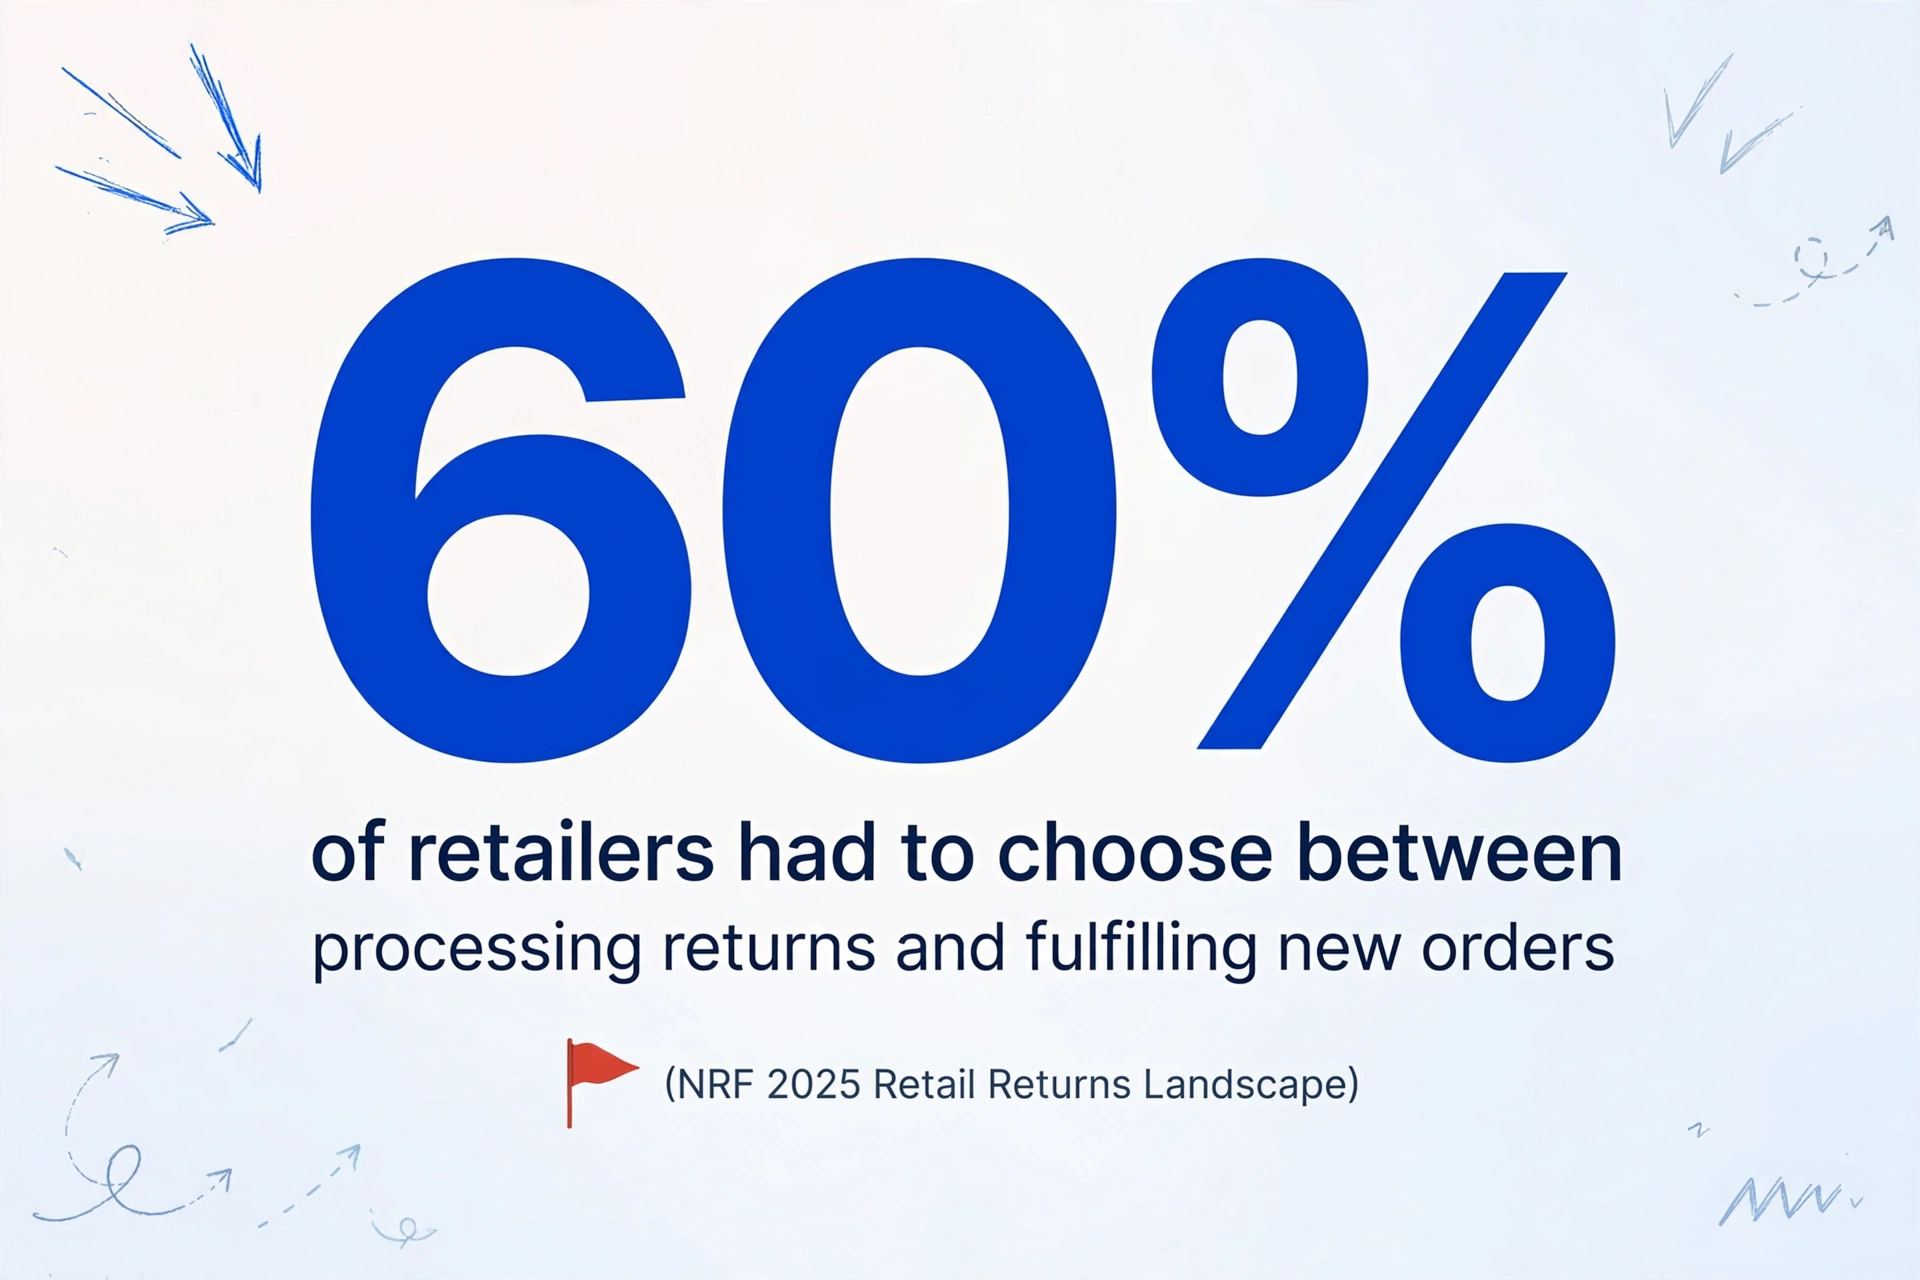
Los números explican por qué esta brecha importa. El informe NRF 2025 Retail Returns Landscape, elaborado en colaboración con Happy Returns (una empresa de UPS), encontró que el 60% de los minoristas ha tenido que elegir entre procesar devoluciones y cumplir con nuevos pedidos. El nueve por ciento de todas las devoluciones se clasifican como fraudulentas — y sin un seguimiento estructurado, distinguir una devolución legítima de una fraudulenta se convierte en una suposición. La Reverse Logistics Association, que representa el mercado de $3.18 billones para 2033 de la industria, ha hecho de la disposición basada en datos su tema central en las conferencias anuales recientes.
Lo que se encuentra entre el portal de devoluciones y el piso del almacén es sorprendentemente de baja tecnología: alguien abre un formulario RMA — ya sea un PDF de un portal de clientes, una nota de devolución escaneada de un distribuidor B2B, o una autorización escrita a mano dentro de una caja — y escribe manualmente los campos en una hoja de cálculo de seguimiento. Una publicación en r/Netsuite describió la situación exactamente: "El proceso RMA se ha convertido en un trabajo de tiempo completo para dos personas. Cada devolución comienza con un cliente enviándonos un correo, alguien aprobándolo manualmente, y luego generando una etiqueta manualmente." Un distribuidor en r/supplychain lo expresó más directamente: su proceso de devoluciones los estaba "consumiendo vivos" — flujos de trabajo RMA manuales, pesadillas de conciliación de créditos de proveedores y cuellos de botella en el almacén.
La pieza que falta en la automatización de devoluciones no es el portal de devoluciones. Es la capa de extracción — el paso que convierte un formulario en datos estructurados.
Qué contiene realmente un formulario RMA — y por qué escribirlo a mano no escala
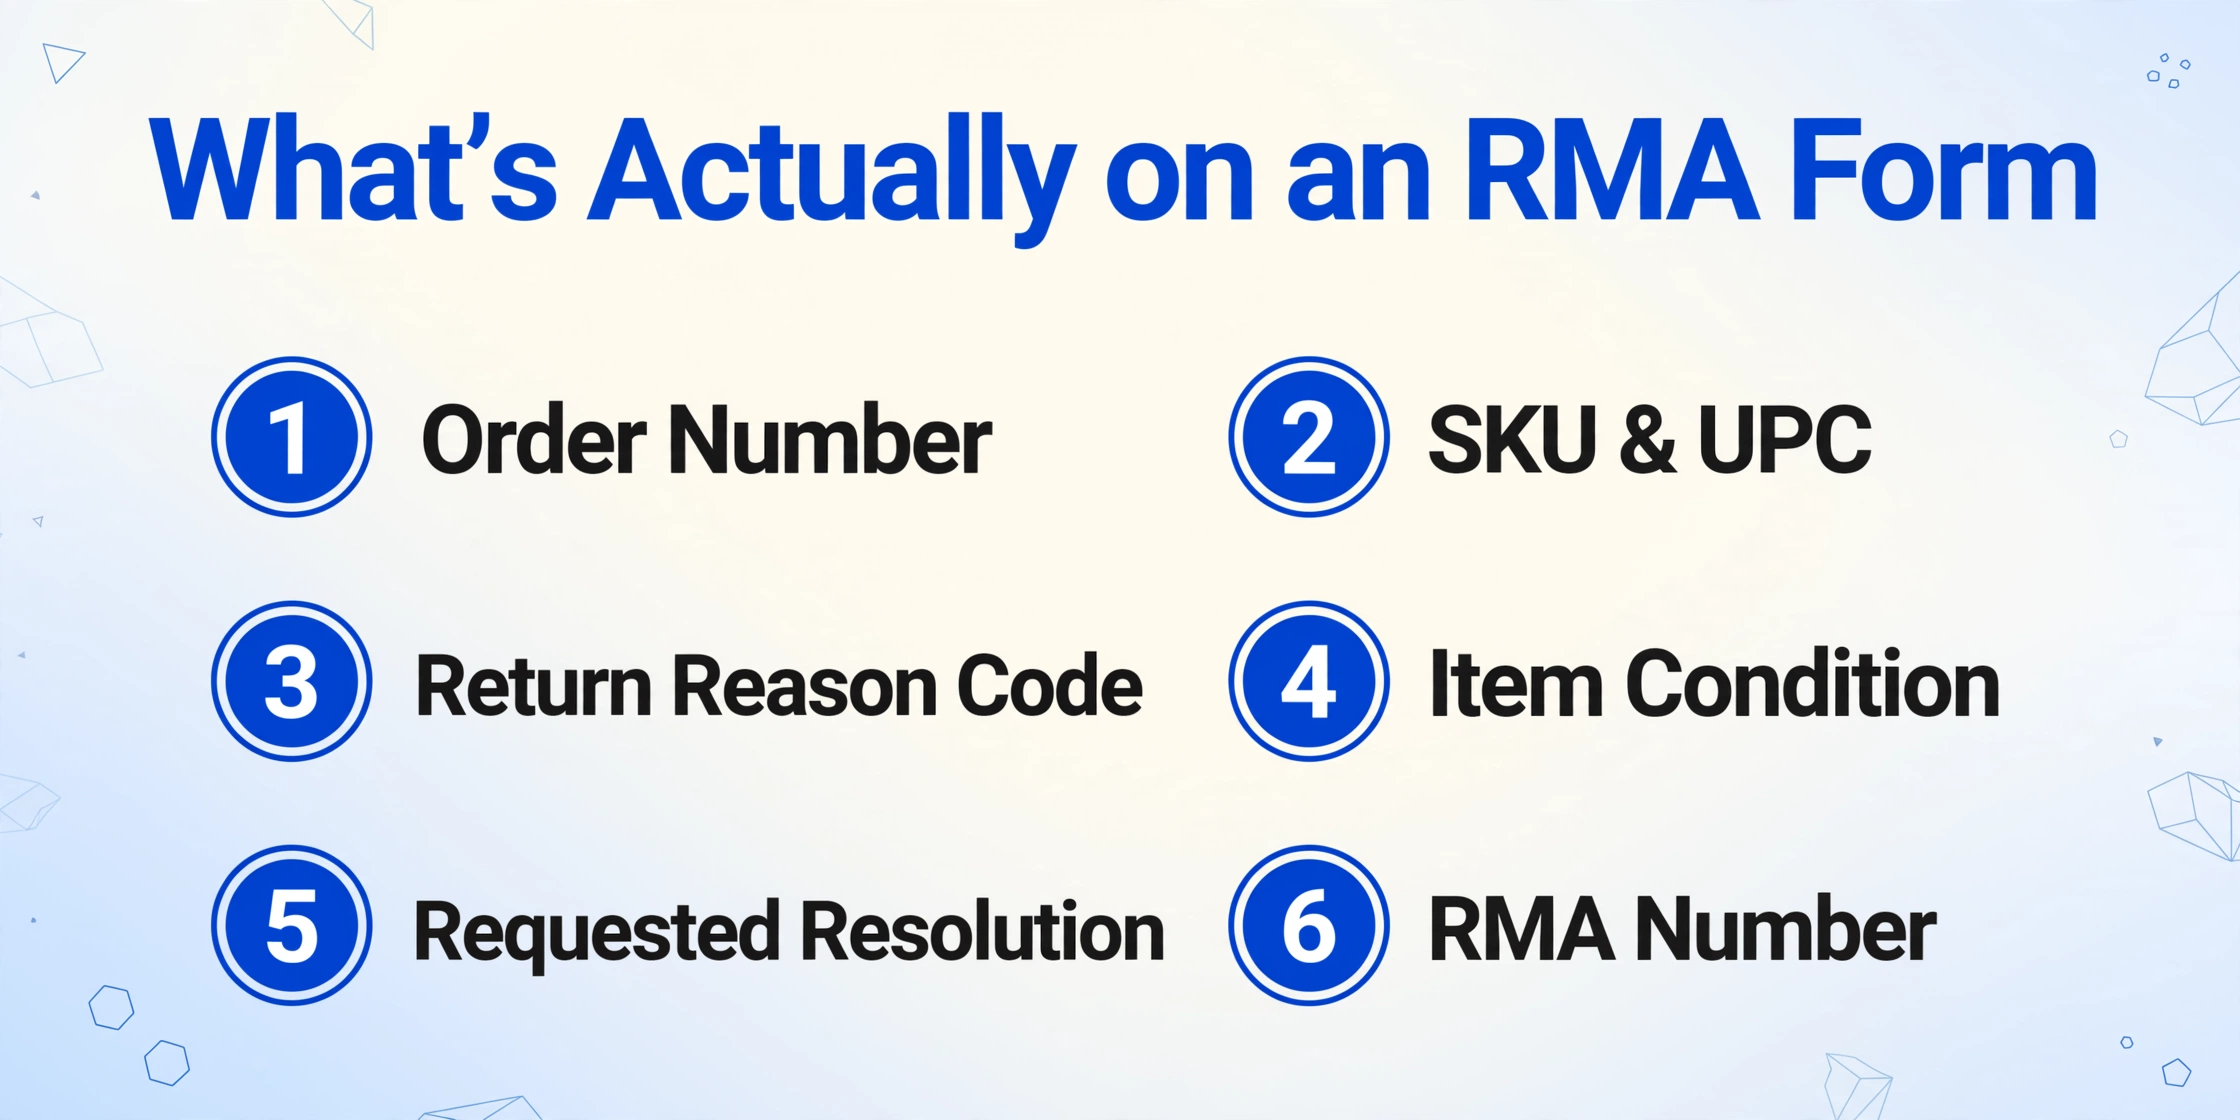
Un formulario RMA estándar captura más información de la que la mayoría cree. No es solo "el cliente quiere devolver el artículo". Un formulario RMA completo incluye número de pedido, SKU y UPC del producto, cantidad devuelta, código de motivo de devolución (defectuoso, talla incorrecta, no coincide con la descripción, dañado en tránsito, cambio de opinión), condición del artículo al llegar (sin abrir, abierto, dañado, accesorios faltantes), resolución preferida (reembolso, cambio, crédito en tienda, reparación) y el número RMA asignado. Para devoluciones B2B — que, según datos de IMARC Group, representaron el 35,1% de los ingresos de logística inversa en 2024 — el formulario también incluye términos específicos del contrato, referencias de notas de crédito y cantidades de devolución a granel.
El campo más valioso operativamente en ese formulario es el código de motivo. Cuando "defectuoso" aumenta para un SKU específico, eso es una señal de control de calidad. Cuando "talla incorrecta" domina las devoluciones de una línea de ropa, eso es un problema de guía de tallas. El análisis de datos RMA de LateShipment encontró que el seguimiento a nivel de código de motivo revela problemas que las tasas de devolución agregadas ocultan — un lanzamiento de producto que genera una tasa de devolución general del 4% puede parecer aceptable, hasta que ves que "no coincide con la descripción" saltó del 2% al 18% solo para ese SKU.
Pero capturar datos de códigos de motivo a escala requiere extraerlos del formulario. Si cada código de motivo de devolución se escribe a mano — desde un PDF, un comprobante escaneado o una nota manuscrita — los datos llegan tarde, de forma inconsistente y a menudo no llegan en absoluto. La investigación interna de ReturnPro encontró que los clientes eligen desproporcionadamente el primer motivo listado en un menú desplegable, lo que significa que los datos manuales de formularios orientados al cliente ya están contaminados. Obtener datos precisos de códigos de motivo requiere extracción más lógica estructurada de categorización — algo que la escritura manual no puede garantizar.
Cómo la extracción con IA lee formularios RMA sin plantillas
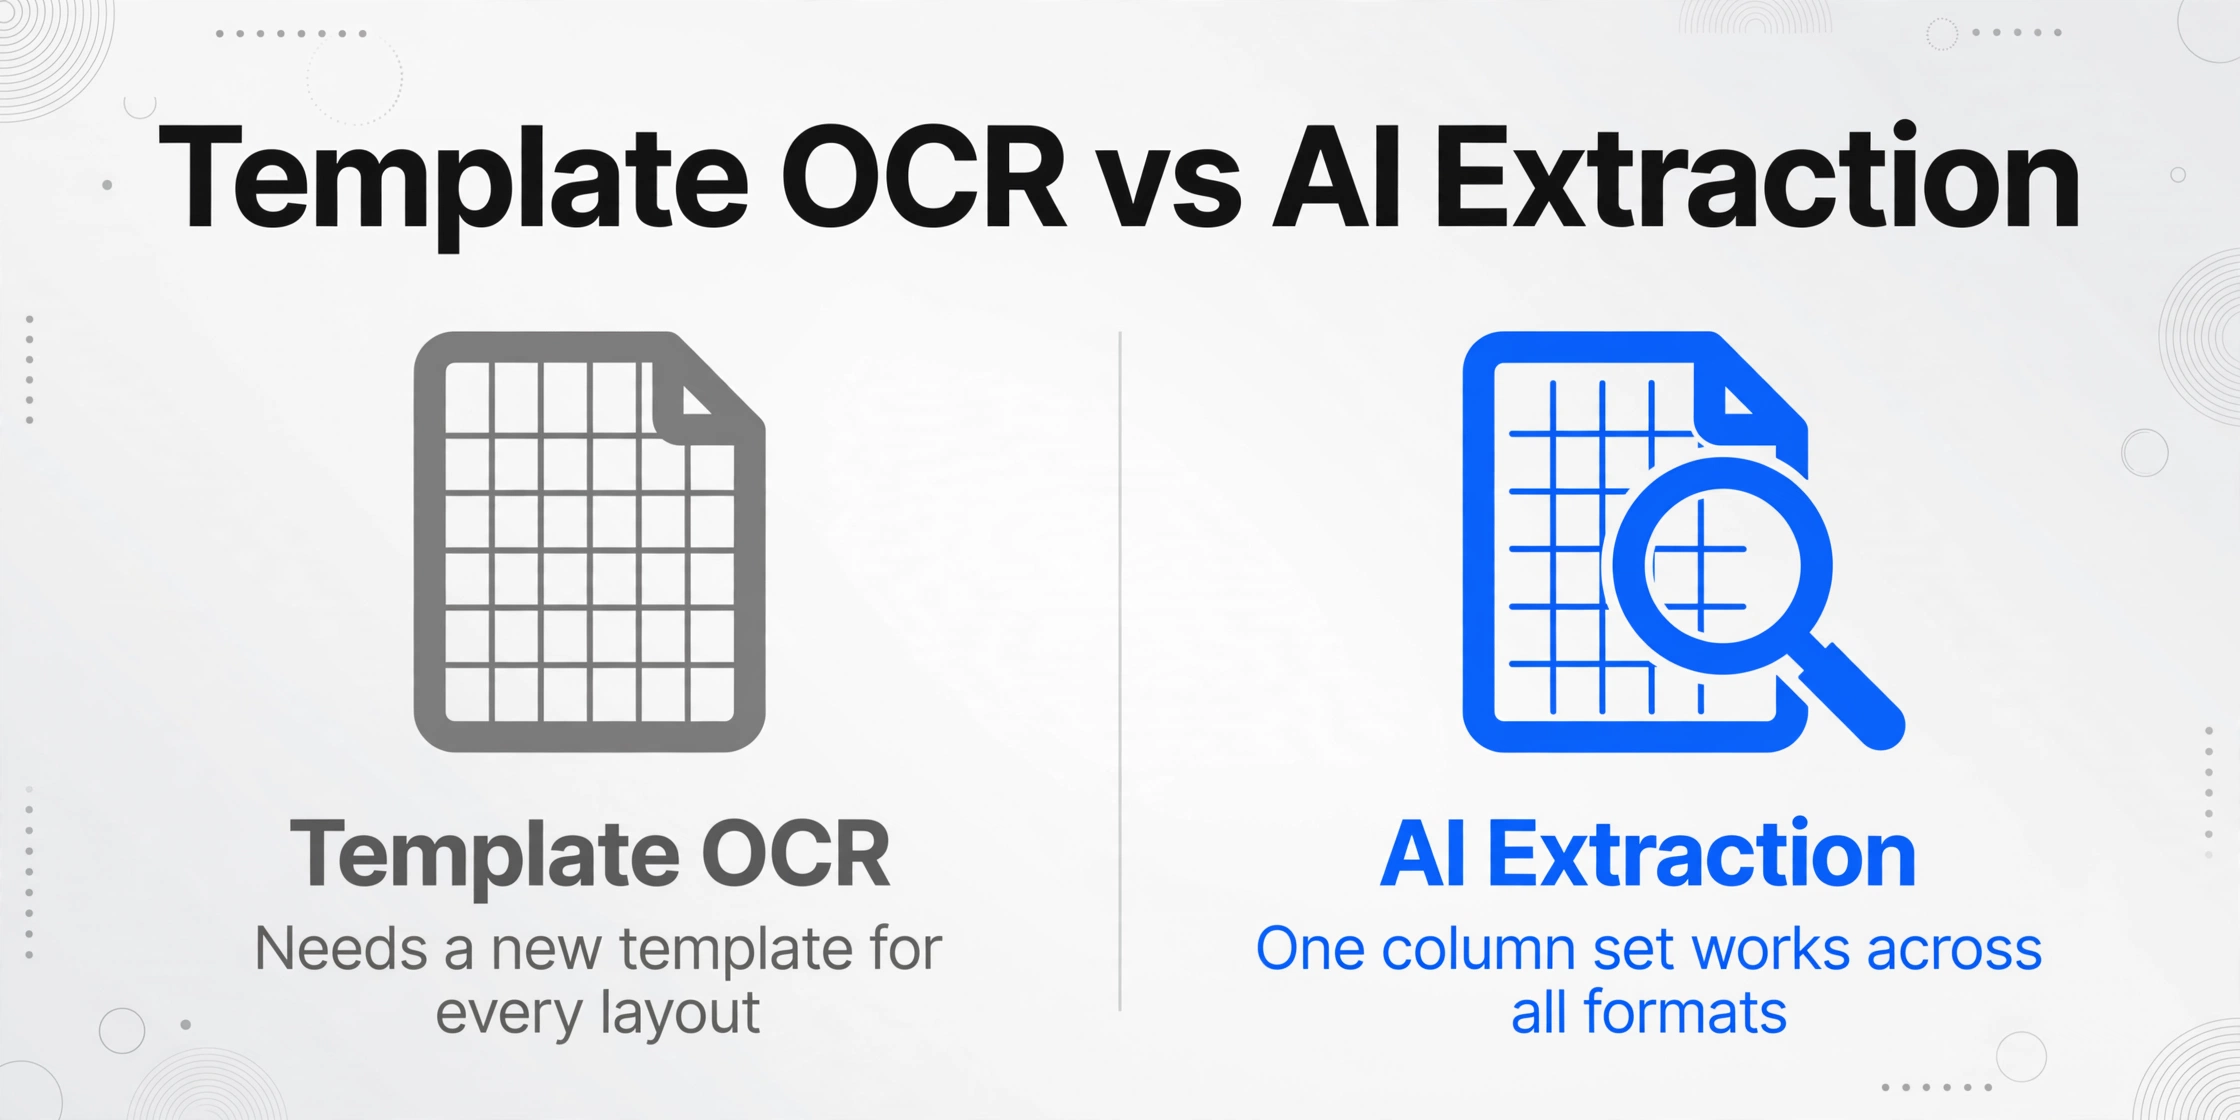
El OCR tradicional procesa un documento convirtiendo imágenes de caracteres en un flujo de texto. No sabe qué texto es el número de RMA y cuál es el motivo de devolución; simplemente te entrega un muro de palabras. Las herramientas basadas en plantillas dan un paso más al permitirte definir coordenadas para cada campo, pero ese enfoque se derrumba en cuanto cambia el diseño de un formulario. Un RMA puede llegar como un PDF generado por un portal de devoluciones; el siguiente como una foto de un formulario manuscrito; el tercero como un formulario de autorización B2B escaneado del sistema ERP de un proveedor. Cada formato requiere una plantilla nueva — y mantener plantillas para las variantes de formularios es lo que convierte un proceso de RMA de dos FTE en un requisito de personal permanente.
La Extracción de Columnas Personalizadas basada en IA funciona de manera diferente. En lugar de decirle al sistema dónde encontrar cada campo en la página, le dices qué buscas — escribiendo los nombres de las columnas que quieres en tu hoja de cálculo de salida. "Número de RMA". "Código de motivo de devolución". "SKU". "Cantidad". "Resolución solicitada". La IA lee cada formulario, localiza los valores que coinciden con esos nombres de columna según su significado — no sus coordenadas — y los rellena en las columnas correspondientes. El mismo conjunto de nombres de columna funciona tanto con un PDF nítido, como con una foto torcida de un formulario de devolución manuscrito, o un formulario de papel escaneado de un archivador con décadas de antigüedad.
Esta es la diferencia entre extraer datos y transcribir texto. Un RMA manuscrito que dice "RMA n.º — 44291 — Motivo: dañado" con tinta borrosa se lee de la misma manera que un PDF generado por un portal con campos claramente etiquetados: la IA identifica "44291" como el número de RMA porque comprende la relación semántica entre un número y su etiqueta, no porque coincida con una posición predefinida en una plantilla. Para equipos que procesan devoluciones en múltiples almacenes, desde múltiples canales de venta, cada uno con formatos de formulario RMA diferentes, este enfoque sin plantilla es la diferencia entre un sistema que funciona y uno que solo maneja el 60 % más limpio de los formularios.
Este mecanismo no se limita a los campos que están escritos explícitamente en el formulario. Puedes definir columna inferida — por ejemplo, una columna "Categoría de disposición" definida como "opciones: Reponer stock, Reacondicionar, Desechar, Devolver al proveedor". La IA lee la condición del artículo y el código de motivo y asigna una disposición probable según tus reglas de negocio — incluso aunque no exista ningún campo de "Disposición" en el formulario. Obtienes extracción y clasificación en una sola pasada.
Paso a paso: Cómo crear un pipeline de datos RMA desde el formulario hasta la hoja de cálculo
La capa de extracción se sitúa entre la recepción de RMA (como tus clientes o socios envíen las devoluciones) y tu stack de operaciones (WMS, ERP, hoja de cálculo de seguimiento). Así se configura específicamente para formularios RMA.
Define tus columnas de extracción RMA
Empieza con los campos que impulsan tus operaciones. Un conjunto estándar de extracción RMA incluye: Número RMA, Número de pedido, SKU, Código de motivo de devolución, Cantidad devuelta, Condición del artículo, Resolución solicitada, Nombre del cliente. Si gestionas devoluciones B2B, añade Nombre del proveedor, Referencia de nota de crédito y Número de contrato. Para la disposición inferida, añade Disposición (opciones: Reponer / Reacondicionar / Liquidar / RTV / Desechar). La IA usa el código de motivo y la condición para asignar una disposición automáticamente.
Sube formularios RMA en cualquier formato
Súbelos tal como llegan: PDFs de tu portal de devoluciones, fotos de formularios de devolución manuscritos del servicio de campo, formularios de autorización B2B escaneados. Sin preprocesamiento, sin configuración de plantilla por formato. La IA lee entre formatos porque se fija en la información, no en el diseño. Si procesas devoluciones de 3 canales de venta y 15 formularios de devolución de proveedores, súbelos todos al mismo lote: los nombres de columna que definiste en el Paso 1 se aplican universalmente.
Procesa el lote
La IA procesa cada formulario (normalmente de 5 a 10 segundos por página), extrayendo los campos que definiste y asignando automáticamente categorías de disposición donde esté configurado. El procesamiento ocurre en paralelo, así que un lote de 50 formularios RMA se completa en minutos, no en horas. Verás los resultados aparecer fila por fila a medida que los formularios se procesan.
Exporta a Excel y dirige a tu stack de operaciones
Descarga la hoja de cálculo combinada: una fila por formulario RMA, cada columna que definiste. La salida es Excel (XLSX) o CSV, lista para importar a tu WMS, ERP o plataforma de gestión de devoluciones. Una columna de nombre de archivo de origen rastrea cada fila hasta su formulario original, dándote un rastro de auditoría del formulario a los datos.
Los archivos se procesan de forma segura y no se almacenan.
La demo anterior funciona con "Formulario RMA" como tipo de documento: escribe tus propios nombres de columnas y sube un formulario RMA de muestra para ver la extracción en acción. Para lotes de producción con cientos de devoluciones por semana, el mismo flujo de trabajo escala sin configuración adicional. Sin configuración por formulario, sin biblioteca de plantillas que mantener. Para ver la lista completa de campos, el flujo de trabajo por lotes de formatos mixtos y las opciones de exportación en un solo lugar, consulta el convertidor de RMA a Excel.
Seguimiento de datos de devoluciones para disposición y análisis de tendencias
Una vez que tus datos de RMA llegan a una hoja de cálculo, se convierten en la base para decisiones de logística inversa que impactan directamente la recuperación de margen. La disposición — la decisión de qué sucede con un artículo devuelto — determina si una devolución te cuesta dinero o recupera valor. Las rutas estándar de disposición son reabastecer (el artículo vuelve al inventario vendible), reacondicionar (el artículo necesita reparación antes de revenderse), liquidar (vender con descuento a través de canales secundarios), devolver al proveedor (RTV — enviar de vuelta al proveedor para crédito) o desechar (el artículo no tiene valor recuperable).
Cada ruta tiene un resultado financiero diferente. Un artículo reabastecido a precio completo recupera casi todo el valor menos el costo de procesamiento. Un artículo reacondicionado típicamente recupera el 40–60% del valor original. Un palé liquidado podría recuperar el 10–20%. La diferencia entre enviar una devolución a reabastecimiento versus liquidación es margen puro — pero depende de tener datos precisos de condición del artículo y código de razón en el punto de inspección para tomar la decisión correcta.
Con datos de RMA extraídos en una hoja de cálculo, puedes ejecutar el análisis que la mayoría de las operaciones de devoluciones omiten:
- Velocidad del código de razón por SKU. ¿Qué productos generan más devoluciones por "defectuoso"? ¿Es un lote específico, un almacén específico que los maneja, o un problema de diseño inherente? Sin datos de código de razón normalizados en todas las devoluciones, estás adivinando.
- Distribución de disposición. ¿Qué porcentaje de devoluciones va a reabastecimiento vs. reacondicionamiento vs. desecho? Si la tasa de desecho está subiendo, algo río arriba está cambiando — calidad del proveedor, empaque o mezcla de razones de devolución.
- Tiempo de procesamiento por ruta de disposición. ¿Cuánto tiempo pasa una devolución en cada etapa — desde la emisión de RMA hasta la recepción en almacén y la disposición final? El punto de referencia de operaciones de devoluciones establece el objetivo en 2–7 días desde la recepción hasta la disposición; cada día adicional erosiona el valor residual.
- Comparación multi-almacén. Si el Almacén A procesa devoluciones al doble de la tasa del Almacén B con el mismo personal, la hoja de cálculo te dice dónde enfocar la mejora de procesos — o si la calidad de captura de formularios difiere entre ubicaciones.
La hoja de cálculo no reemplaza un WMS. Cierra la brecha entre los datos que tienes y los datos que tu WMS necesita para enrutar devoluciones correctamente.
Cuando el volumen de devoluciones supera los cientos por semana, el mismo flujo de extracción escala a procesamiento por lotes de formularios RMA en una sola hoja de conciliación de reembolsos — con campos de enrutamiento y conciliación integrados en la salida en lugar de añadirse en una segunda pasada manual.
Integración de datos RMA extraídos con su stack de almacén
La mayoría de las operaciones de devoluciones ya cuentan con un stack de software. La pregunta no es si reemplazarlo, sino cómo alimentarlo con datos limpios. La capa de extracción genera archivos en Excel (XLSX) y CSV, que todos los principales WMS y ERP aceptan para importación. La ruta de integración depende de lo que esté utilizando. Para un recorrido campo por campo del mapeo de columnas extraídas al esquema de importación de un sistema de inventario, consulte nuestra guía sobre cómo alimentar datos de devoluciones RMA a su sistema de inventario.
NetSuite: Si su equipo de devoluciones ya genera registros RMA en NetSuite, el cuello de botella es el paso de entrada de datos: escribir los campos del formulario en el módulo RMA de NetSuite. La hoja de cálculo de extracción se puede importar directamente en la herramienta de importación CSV de NetSuite, mapeando sus columnas extraídas (Número RMA, SKU, Código de Motivo, Disposición) a los campos RMA de NetSuite. El mismo hilo de r/Netsuite donde los usuarios describieron el problema de RMA con dos FTE señaló que NetSuite "manejaba los registros sin problema" — el problema siempre fue introducir datos en los registros.
ShipStation / Cin7 / Fishbowl: Estas plataformas WMS manejan el seguimiento de inventario y el cumplimiento de pedidos de forma nativa, pero el enrutamiento de devoluciones — decidir qué disposición recibe un artículo devuelto — depende de los datos que provienen del formulario RMA. Importe su hoja de cálculo extraída como CSV al módulo de devoluciones, y el WMS podrá enrutar los artículos a zonas de reposición, cuarentena, reacondicionamiento o RTV según la columna de disposición que generó durante la extracción.
Google Sheets / seguimiento manual: Para operaciones que funcionan con hojas de cálculo, el resultado de la extracción ya está en su formato de trabajo. Exporte a XLSX, ábralo en Google Sheets, y habrá reemplazado un paso de escritura manual con una alimentación directa — misma hoja de cálculo, sin escritura. Esta es la configuración más común para 3PLs pequeños y medianos y operaciones de almacén que no tienen un WMS formal.
El patrón consistente en los tres enfoques es el mismo: la capa de extracción desacopla "leer el formulario" de "actuar sobre los datos". Ya sea que los datos lleguen a NetSuite, ShipStation o una hoja de Google compartida, es una decisión posterior que no cambia cómo se configura la extracción. Una configuración de extracción funciona para todos los destinos.
Preguntas frecuentes
¿Funciona con formularios RMA escritos a mano?
Sí, con las mismas salvedades que se aplican a todo el reconocimiento de escritura manual. Si la escritura es legible para un lector humano con una iluminación razonable, la extracción con IA normalmente puede leerla. La tinta borrosa, la escritura cursiva extremadamente comprimida o la escritura que se extiende a otros campos reducirán la precisión. La misma extracción basada en columnas funciona en formularios escritos a mano y mecanografiados sin ningún cambio de configuración: no es necesario indicar al sistema qué formularios están escritos a mano y cuáles impresos. Para más información sobre el rendimiento de extracción específico de escritura manual, consulte nuestra guía para mejorar la precisión de la extracción de escritura manual.
¿Puedo extraer datos de formularios RMA en diferentes idiomas?
La IA lee el contenido del documento en el idioma en que aparece: si sus formularios RMA están en inglés, español, alemán o una mezcla, la extracción procesa cada formulario individualmente. Los nombres de las columnas deben estar en el idioma en el que desea su salida. No es necesario pre-traducir ni normalizar el idioma antes de subir.
¿Qué pasa si mis formularios RMA no tienen todos los mismos campos?
Ese es el escenario esperado. La Extracción de Columnas Personalizadas no requiere que cada formulario contenga todos los campos. Si un formulario no tiene un campo que usted definió — por ejemplo, una nota manuscrita que no incluye un "Código de Razón" — esa celda se deja en blanco en la salida. El sistema no adivina ni inventa datos para llenar vacíos. Esto es importante específicamente para los flujos de trabajo RMA, donde los formularios de devolución B2B de diferentes proveedores tienen diferentes conjuntos de campos.
¿Cómo se compara esto con usar una plataforma dedicada de gestión de devoluciones como Loop Returns o Happy Returns?
Las plataformas de devoluciones dedicadas gestionan el flujo de trabajo orientado al cliente — portales con marca, generación de etiquetas, procesamiento de reembolsos — y son la herramienta adecuada cuando necesita ofrecer a los compradores una experiencia de devoluciones de autoservicio. La capa de extracción cumple una función diferente: extrae datos de formularios RMA independientemente de dónde provengan esos formularios. Si todas sus devoluciones pasan por un único portal con captura de datos estructurados, no necesita extracción — el portal ya le proporciona datos estructurados. Si sus devoluciones llegan a través de múltiples canales — un portal, correo electrónico, formularios de proveedores B2B, notas en papel — la extracción llena el vacío que el portal no puede cubrir.
¿Qué precisión tienen los códigos de motivo y los campos de disposición?
En formularios RMA impresos y limpios, la precisión en campos estructurados como números de pedido y SKU alcanza hasta el 99%. Los códigos de motivo — que suelen ser etiquetas de texto cortas como "Defectuoso" o "Talla incorrecta" — tienen alta confianza porque su vocabulario es limitado. La mayor variable es la calidad de la entrada: una foto nítida de un formulario RMA impreso se extraerá con más precisión que una foto borrosa de una nota de devolución arrugada. Para campos donde un error es costoso — como enrutar una devolución a la disposición incorrecta — una verificación humana rápida de la hoja de cálculo antes de importar es una salvaguarda práctica. Para más información sobre la precisión por tipo de campo, consulta nuestro análisis en capas de la precisión de extracción.
¿Necesito entrenar la IA con el formato de mi formulario RMA primero?
No. La extracción sin plantilla significa que la IA procesa cualquier formato de formulario RMA sin entrenamiento previo ni anotación de muestras. Defines los nombres de las columnas una vez, y esos mismos nombres de columna se extraen de cualquier formato que le presentes: PDFs de portal, formularios escaneados de proveedores, notas manuscritas, fotos tomadas en un almacén. El requisito de cero entrenamiento es lo que hace viable este enfoque para operaciones de devoluciones que manejan formularios de docenas de fuentes diferentes, cada una con su propio diseño.
Cerrando la Brecha de Datos que la Automatización de Devoluciones Olvidó
La industria de logística inversa ha invertido en las partes visibles de las devoluciones: portales de clientes, redes de entrega, reembolsos instantáneos, detección de fraude. Lo que no se automatizó es el paso más silencioso y laborioso: leer el formulario y escribir los datos. Es el paso que se encuentra entre cada herramienta de software del stack y la información real que esas herramientas necesitan para funcionar.
$849.9 mil millones en devoluciones pasan por ese paso cada año. La diferencia entre una operación de devoluciones que ve tendencias y una que las adivina no es un mejor portal, un reembolso más rápido o un WMS más sofisticado. Es si los datos del formulario RMA llegan a una hoja de cálculo a tiempo para importar.
Pruébalo con tus propios formularios RMA. Sube un lote y comprueba si los datos que has estado escribiendo a mano aparecen en columnas en 5 segundos en lugar de 5 minutos por formulario.
No se requiere registro para la demo