韓国の輸出入
申告データをExcelに抽出する方法(2026年版ガイド)
韓国関税庁(KCS)のUNI-PASSシステムは、2025年に3,000万件以上の電子申告を処理しました。輸出通関は1.5分で完了します。輸入通関は平均1.5時間です。どの指標で見ても、韓国は世界で最も先進的なデジタル税関インフラを運用しています — 世界銀行は6年連続で国境を越えた貿易のしやすさで世界第1位にランク付けしました。それでも、韓国のすべての貿易会社で、誰かが今も申告データを手作業でスプレッドシートに入力しています。
重要なポイント
- UNI-PASSは韓国の輸出申告を90秒で通関しますが、同じデータを貿易コンプライアンス用スプレッドシートに入力するには、手作業で3〜5分かかります。
- 印刷された申告書のレイアウトは、輸出フォームと輸入フォーム、一般手続きと簡易手続き、通関業者の印刷物によって異なります — テンプレートベースのOCRはフォーマットが変わるたびに失敗します。
- カスタム列抽出は、各フィールドがページ上のどこにあるかではなく、その意味(신고번호=申告番号)でデータを読み取ります — 1つの列定義がすべてのUNI-PASSレイアウトで機能します。
UNI-PASSのパラドックス:韓国の世界水準の税関システムが生むデータ入力の盲点
UNI-PASSは、韓国関税庁の完全統合型電子通関プラットフォームです。輸入申告、輸出申告、貨物管理、関税納付、税関監査をカバーする単一窓口システムであり、釜山港や仁川港などで活動するすべての輸出者、輸入者、通関業者からの申告を処理します。95%以上の自動化率と24時間365日の運用を誇り、税関近代化のモデルとして10カ国に輸出されています。
盲点は明白なところに隠れています。UNI-PASSは通関手続きをエンドツーエンドで処理しますが、貿易チームが書類作成に必要とする構造化データファイルは生成しません。出力されるのは、印刷された수출신고서(輸出申告書)または수입신고서(輸入申告書)です。これは、保管され、商業送り状と照合され、貿易コンプライアンス追跡、HSコード台帳の維持、FTA原産地証明書の作成のために、手作業でスプレッドシートに再入力されなければならない紙のフォームまたはPDFです。
韓国の総貿易額は2025年に1.34兆ドルに達し、輸出は7097億ドル、輸入は6317億ドルで、世界第7位の貿易大国です。これらの取引のすべてが税関申告を発生させました。そして、通関後の貿易書類(HSコードの照合、FOBおよびCIF価額の検証、原産地の追跡)を管理するチームにとって、各申告は、UNI-PASSに一度入力されたものの、スプレッドシートに再度入力しなければならないデータとして存在します。貨物を90秒で通関させたシステムが、1件の申告につき3~5分かかる書類作成タスクを生み出しているのです。
月に300件の申告を処理する貿易コンプライアンスチームは、UNI-PASS内にデジタル形式で存在しながら、印刷された書類として机に届くデータの再入力に、毎月15~25時間を費やしています。韓国を税関効率の世界的ベンチマークに押し上げたシステムは、このギャップを埋めなかったどころか、むしろ作り出したのです。
韓国の輸出入申告書(수출입신고서)に実際に含まれるもの
なぜ手作業による再入力が続いているのかを理解するには、典型的な韓国の輸出入申告書に何が含まれているかを知ることが役立ちます。UNI-PASSの申告書式は、韓国の特定の規制および分類要件に適合させたWCOデータモデルに従っています。通関後の書類作成のために貿易チームが必要とする項目は、通関に必要な項目と同じではなく、通関後の出力は書類作成のユースケースに合わせて事前に整理されていません。
| 項目(英語) | 韓国語 | 貿易書類において重要な理由 |
|---|---|---|
| 申告番号(신고번호) | 신고번호(12~15桁) | 貨物と税関記録、インボイス、船荷証券(B/L)、原産地証明書(C/O)を結びつける主要キー |
| 輸出者/輸入者 事業者登録番号 | 수출자/수입자 사업자등록번호(10桁) | VATインボイス発行および取引先照合に必須 |
| HSコード(10桁HSK) | HS코드(HSK 10자리) | 関税率、FTA適格性、規制要件を決定する |
| 品名及び規格(韓国語・英語) | 품명 및 규격 | 原産地証明書(C/O)発行および税務監査準備に必要 |
| 数量 / 正味重量 | 수량 / 중량 | 貨物の確認および割当管理に使用 |
| FOB価額(輸出) | 수출금액(FOB) | 輸出収益報告および保険評価の基準 |
| CIF価額(輸入) | 수입금액(CIF) | 韓国ではCIF価額(商品代金+運賃+保険料)に基づき輸入関税を計算 |
| 原産地(원산지) | 원산지 | FTA特恵関税率の適格性および原産地表示コンプライアンスを決定 |
| 支払条件 | 결제방식(T/T, L/C, D/P 등) | キャッシュフロー計画および貿易金融申請のサポート |
| 運送手段及び経路 | 운송수단 및 경로 | 物流追跡、混載、サプライチェーン書類作成 |
これらの各項目は、UNI-PASS内では構造化データとして存在しています。しかし、貿易コンプライアンス記録用に印刷された申告書を要求する場合——税関業者からの紙のコピーであれ、UNI-PASSポータルからのPDFダウンロードであれ——それは書式化された文書として届きます。その構造は視覚的であり、表形式ではありません。신고번호はある場所に、HSコードは別の場所に、FOB価額はさらに別の場所にあります。出荷台帳やHSコード監査証跡を作成する貿易コンプライアンス担当者にとっては、すべての項目を探し出し、読み取り、再入力しなければなりません。
ここに、韓国の世界クラスのデジタル税関システムと、貿易書類作成業務の日常的な現実との間のギャップが浮き彫りになります。UNI-PASSは通関手続きをデジタル化しました。しかし、貿易書類作成をデジタル化したわけではありません。その仕事は今も、誰かがキーボードの前で行っています。
輸出入申告書が手作業入力を生む3つの理由
貿易チームが感じる不満——「このデータはすでにシステムにあるのに、なぜ再入力するのか?」——には、具体的かつ構造的な原因があります。それを特定することで、問題と症状を切り分けることができます。
1. UNI-PASSは申告書を構造化データの書き出しではなく、フォーマット済み文書として出力する。 このシステムは、人間が読んで税関が保管するための申告書PDFまたはプリントアウトを生成します。提出済み申告書には「Excelに書き出し」ボタンはありません。データは視覚的なレイアウト——太字のハングルで書かれたヘッダー、列見出しに揃えられた値、重ねられた印鑑や署名——の中に閉じ込められており、人間が解析する必要があります。UNI-PASSポータルからのPDFダウンロードも、機械可読なデータファイルではなく、申告フォームの画像です。これは設計によるものです。このシステムは、通関後のデータ移植性よりも、通関スピードと法的完全性を優先しています。
2. 貿易書類はインボイス、船荷証券、原産地証明書との照合が必要である。 申告書は貿易コンプライアンス業務において単独で存在するものではありません。商業インボイス(申告額の検証)、船荷証券(貨物数量の検証)、原産地証明書(FTA適格性の検証)と照合する必要があります。これらの書類はそれぞれ異なる形式で届きます——インボイスはサプライヤーのPDF、船荷証券はフォワーダーのポータルから、原産地証明書はスキャンされた証明書です。出荷台帳を管理する貿易チームは、申告データを抽出するだけでなく、4種類の書類にまたがってデータを統合します。申告書は多くの情報源のうちの1つであり、他の情報源はさらに構造化されていません——そのスタックの韓国インボイス側については、韓国税インボイスのExcel変換ガイドで解説しています。
3. 申告書の形式は、一般通関手続きと簡易通関手続きで異なる。 韓国は二元的な申告制度を採用しています。一般申告(일반수출신고/일반수입신고)には、上記で説明した完全なフィールドセットが含まれます。$2,000未満の貨物に使用される簡易申告(간이수출신고)には、削減されたフィールドセットが含まれます。見本、贈答品、FTA特恵対象の貨物には、追加の記載が必要な場合があります。複数の製品カテゴリーにわたって月200件の申告を処理する貿易チームは、これらの形式が混在したものを扱います——そして、固定レイアウトを想定したテンプレートベースのツールは、形式が変わった瞬間に機能しなくなります。
これら3つの原因に共通するのは、データは存在するが移植可能ではないということです。データは、書類作成用に設計されたテーブルの中ではなく、通関用に設計された申告文書形式の中にあります。データを一方のコンテナから他方へ移すことこそが、手作業入力を生み出しているのです。
韓国申告データにセマンティック抽出が最適な理由
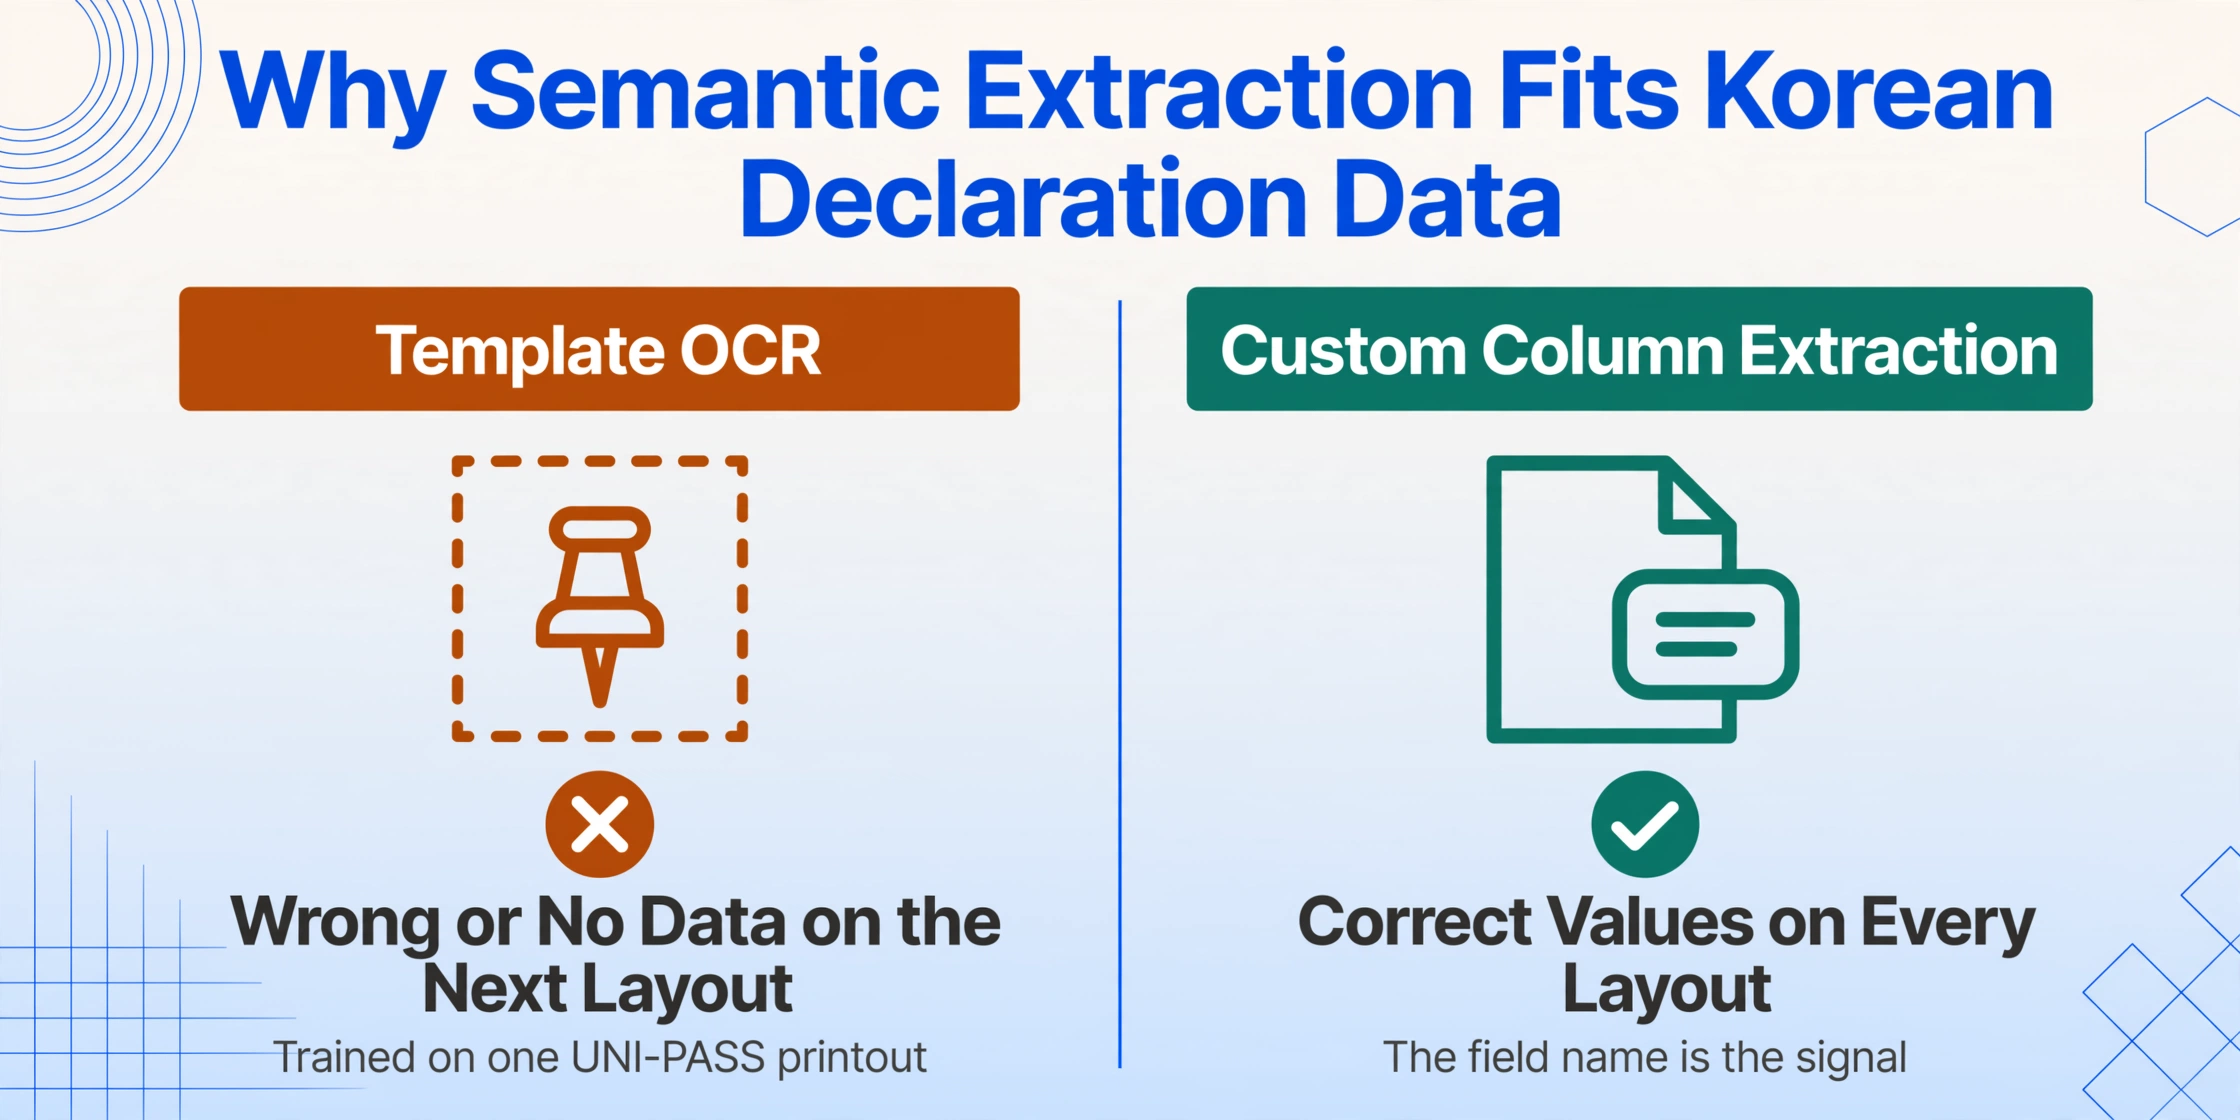
従来のテンプレートベースのOCR(ほとんどの文書抽出ツールが採用するアプローチ)は、UNI-PASSの印刷物上の各フィールドの位置を記憶することでこの問題を解決しようとします。1つの申告レイアウトで学習させると、ブロックAから신고번호を、ブロックBからHSコードを読み取ります。問題は、UNI-PASS申告には複数のレイアウトがあることです。輸出と輸入では様式が異なり、一般申告と簡易申告でも異なり、ポータルから印刷したPDFと通関業者の内部印刷物でも見た目が異なります。あるレイアウトで学習させたテンプレートは、次のレイアウトでは誤ったデータを返すか、データを返しません。
カスタム列抽出(ImageToTable.aiが使用する中核メカニズム)は、この関係を逆転させます。AIにデータがページ上のどこにあるかを教える代わりに、フィールドに名前を付けて何を抽出したいかを指示します。列名「HSコード(10桁)」や「原産国」は、輸出か輸入か、一般か簡易か、ポータルのPDFか通関業者の印刷物かに関わらず、あらゆる申告形式でその特定の値を意味的に特定するようAIに指示します。あなたが定義する列名がシグナルとなり、AIがレイアウトに適応します。
このセマンティックなアプローチが韓国の申告書にとって特に重要なのは、ハングルのフィールドラベルが韓国語以外で学習したOCRエンジンにとって構造的な課題を生み出すためです。韓国語のテキストをネイティブに理解するビジョンAI(신고번호を申告番号、원산지를原産地、수입금액(CIF)をCIF値として読み取る)は、これまで見たことのないレイアウトからも正しい値を抽出できます。ラベルの意味を読み取るのであって、フィールドの位置を読み取るのではないため、UNI-PASS印刷物のすべてのバリエーションで学習する必要はありません。
これは、より広範な通関申告書抽出に関する記事で取り上げているのと同じパラダイムですが、韓国の申告書形式の状況に特化して適用したものです。セマンティック抽出が形式のバリエーションに打ち勝つというグローバルな原則は同じです。韓国での実装には、独自のフィールド構造、規制上の文脈、コンプライアンスのワークフローがあります。
韓国申告データの抽出列を設定する
最初のバッチからデータを抽出する前に、出力構造を定義してください。一度設定した列は、フォーマットの違いに関わらず、アップロードするすべての申告書に適用されます。
通関コンプライアンスチームが事後書類作成に必要とする一般的なフィールドに基づき、以下の列セットを推奨します。
| 列名(抽出に使用) | 抽出内容 | 必要な理由 |
|---|---|---|
Declaration Number | 申告番号(12~15桁) | B/Lやインボイスと照合するための一意の識別子 |
Declaration Type | 輸出または輸入 | 取引の方向でレジストリをフィルタリング |
Exporter Name | 수출자 (상호/성명) | 取引先の特定 |
Importer Name | 수입자 (상호/성명) | 取引先の特定 |
Business Registration Number | 사업자등록번호(10桁) | VATおよび税務インボイスに必須 |
HS Code | HSK 10桁コード | 関税率の決定とFTA適格性の確認 |
Product Description | 품명 및 규격(韓国語と英語) | 原産地証明書や税関監査証跡に必要 |
FOB Value | FOB 금액(輸出の場合) | 輸出収益の記録と保険 |
CIF Value | CIF 금액(輸入の場合) | 輸入関税の基準(韓国はCIFで評価) |
Country of Origin | 원산지 | FTA特恵と原産地表示のコンプライアンス |
Invoice Number | 송장번호 | 商業インボイスとの照合 |
Transport Mode | 운송수단(海上/航空/陸上/郵便) | 物流追跡とSOP文書化 |
これらの列は抽出インターフェースで一度だけ定義してください。アップロードするすべての申告書ファイル(UNI-PASS PDF、ブローカーのスキャン印刷物、写真コピーなど)は、この同じ列セットに対して読み取られます。AIは、テンプレート上の同じピクセル座標をスキャンするのではなく、列名との意味的な一致によって各フィールドを特定します。
この標準セットに加えて、船積港(선적항)、船名(선명)、コンテナ番号(컨테이너번호)などの追加フィールドが必要なチームは、同じインターフェースで列として追加してください。列名のみが設定に必要です。
ステップバイステップ:韓国申告データの抽出
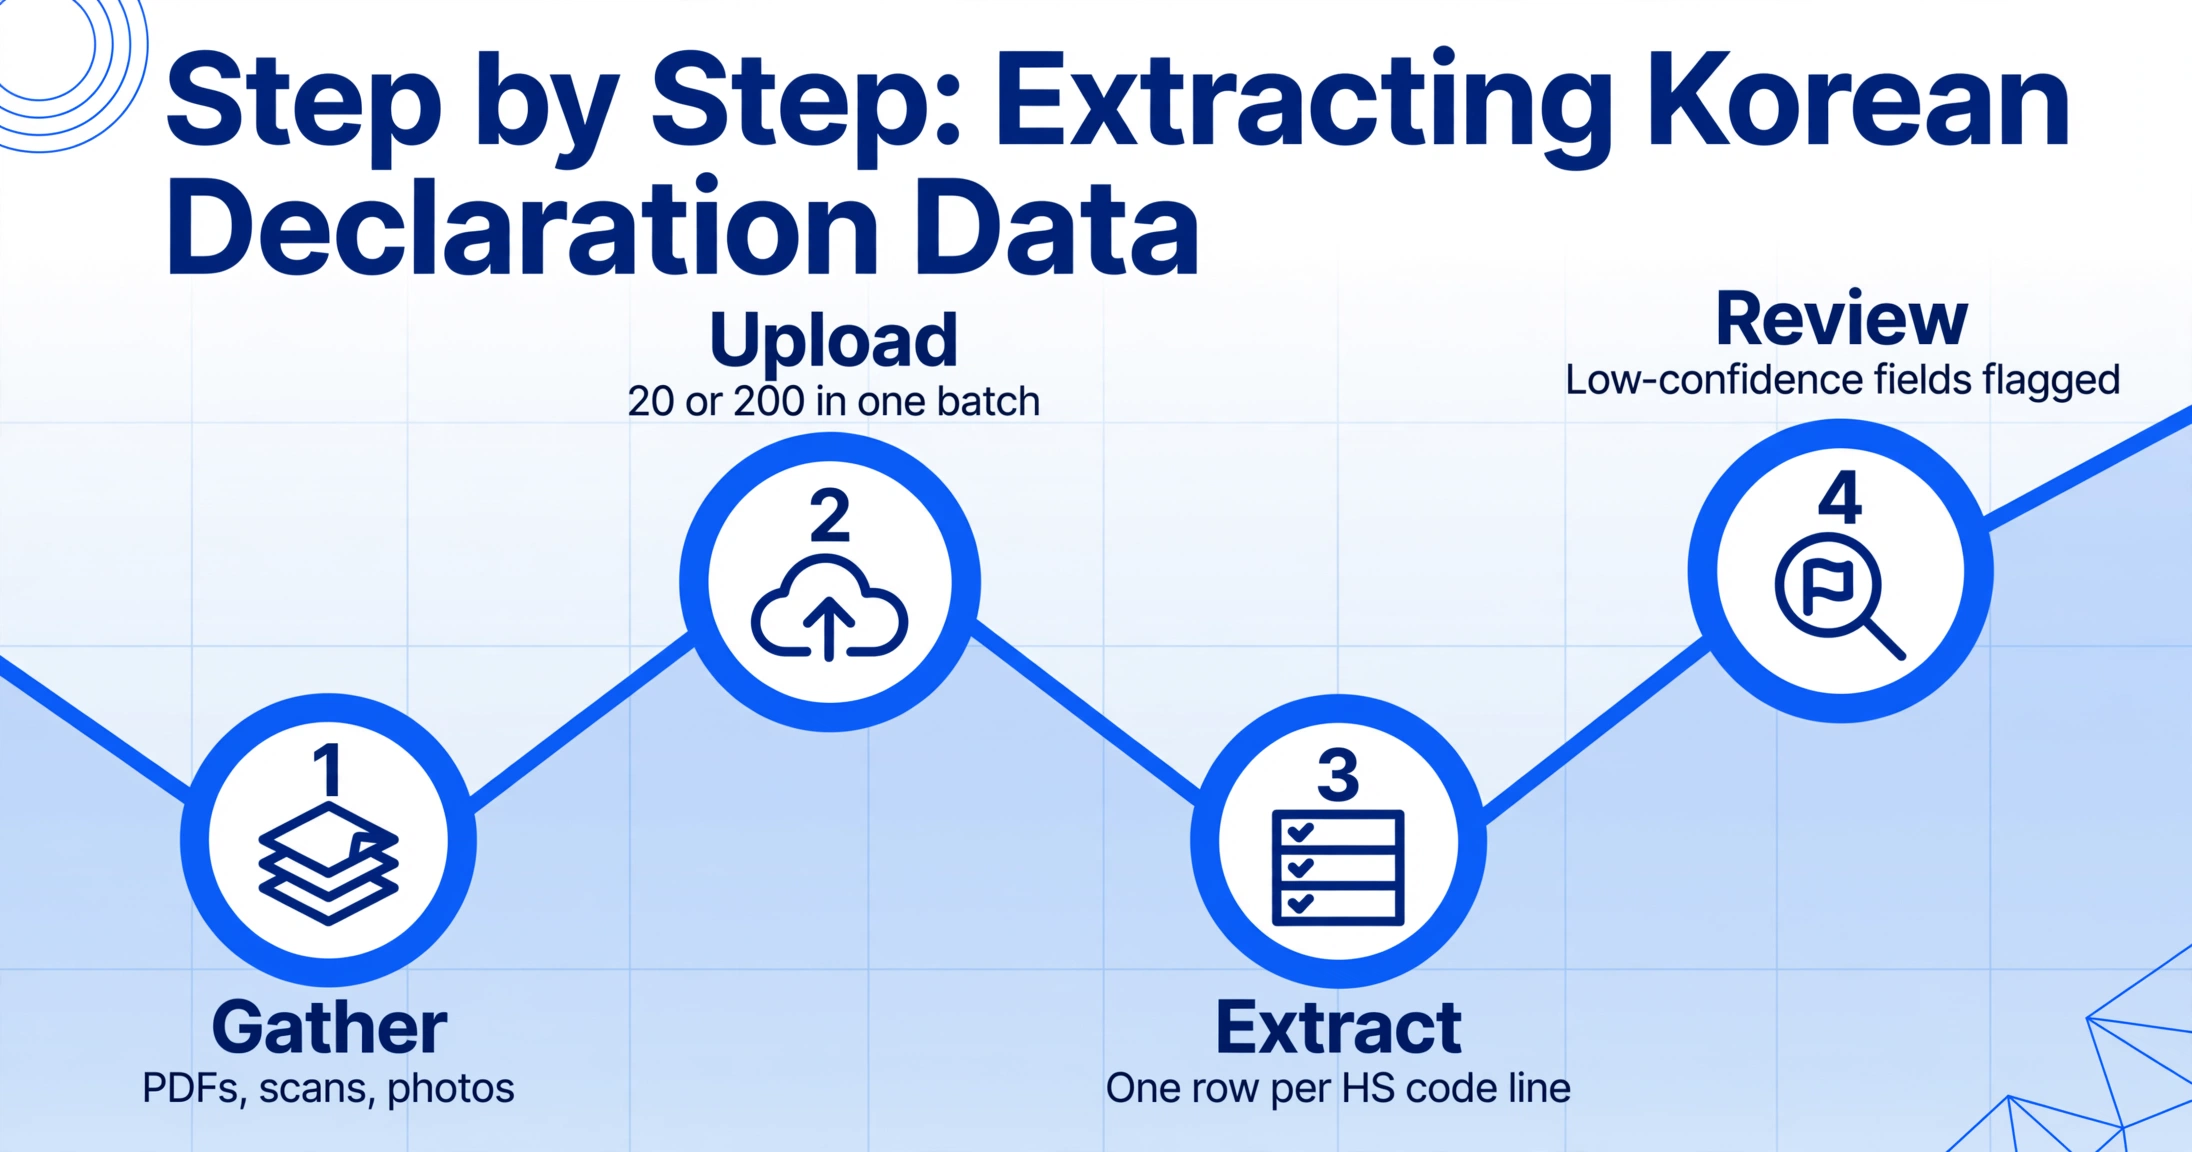
列セットを定義したら、抽出ワークフローは、処理する申告書の数やその入手方法に関係なく、一貫したパターンに従います。実際の流れは次のとおりです。
申告書類を集めます。処理が必要な수출신고서または수입신고서ファイルを収集します。UNI-PASSポータルからダウンロードしたPDF、通関士から受け取った紙のスキャンコピー、印刷された申告書の写真など、形式は問いません。抽出ツールはこれらすべての形式を一括で読み取るため、この段階で電子文書か紙文書かを区別する必要はありません。
1つのバッチにアップロードします。すべての申告書ファイルをまとめてアップロードします。バッチには20件でも200件でも申告書を含めることができ、処理スループットは同じです。システムは追跡用にバッチ名を割り当て、各ファイルがキューに入るとステータスを生成します。輸出申告と輸入申告が混在するチームは、まとめてアップロードしてください。AIは手動での仕分けではなく、文書の内容に基づいて輸出用レイアウトと輸入用レイアウトを自動的に判別します。
定義した列セットに対して抽出を実行します。各申告書はビジョンAIモデルによって読み取られ、定義された列に一致する値が特定・抽出されます。12の品目行を持つ申告書は、HSコードの行ごとに1行が生成されます。AIは複数行の申告書を処理し、各商品ラインごとに行を生成します。出力は、定義した列をヘッダーとし、その下に申告書の各品目行を1行として含む単一のテーブルです。
確認と検証を行います。抽出結果を開き、修正が必要なフィールドがないか確認します。AIは信頼度インジケーター付きで値を返します。信頼度の低いフィールド(かすれたスタンプ、機械印字の上に重ねられた手書き注記など)にはフラグが立てられるため、すべての行を読むことなく、どのセルを検証すべきかがわかります。韓国の申告書で最も一般的なエッジケースは、スタンプで隠れたHSコードの数字、手書きによるCIF価格の修正、スキャン時に一部が切れた申告番号です。
ExcelまたはCSVにエクスポートします。完成したテーブルを、貿易コンプライアンスシステムにインポートするためのExcelファイル(XLSX)またはCSVとしてエクスポートします。エクスポートされたファイルには、すべての列、すべての申告行、および追跡可能な識別子としてのバッチ名が含まれます。Google Sheetsユーザーは、Google Sheetsアドオンを使用すると、結果がアクティブなスプレッドシートに直接書き込まれるため、エクスポートとインポートの手順を完全に省略できます。
ワークフロー全体(50件の申告書ファイルのアップロードから構造化テーブルの完成まで)は、各フィールドを手動で探し、読み取り、入力するのに数時間かかっていた作業が、わずか数分で完了します。ボトルネックはデータ入力の速度から、検証の速度へと移ります。
抽出データで実現できること:貿易コンプライアンスのユースケース
申告データが構造化されたスプレッドシートに格納されると、それは単なる検索の問題ではなくなり、紙のファイルやメールの添付ファイルにデータが散在している場合には困難または不可能な貿易コンプライアンスのワークフローを実現できるようになります。
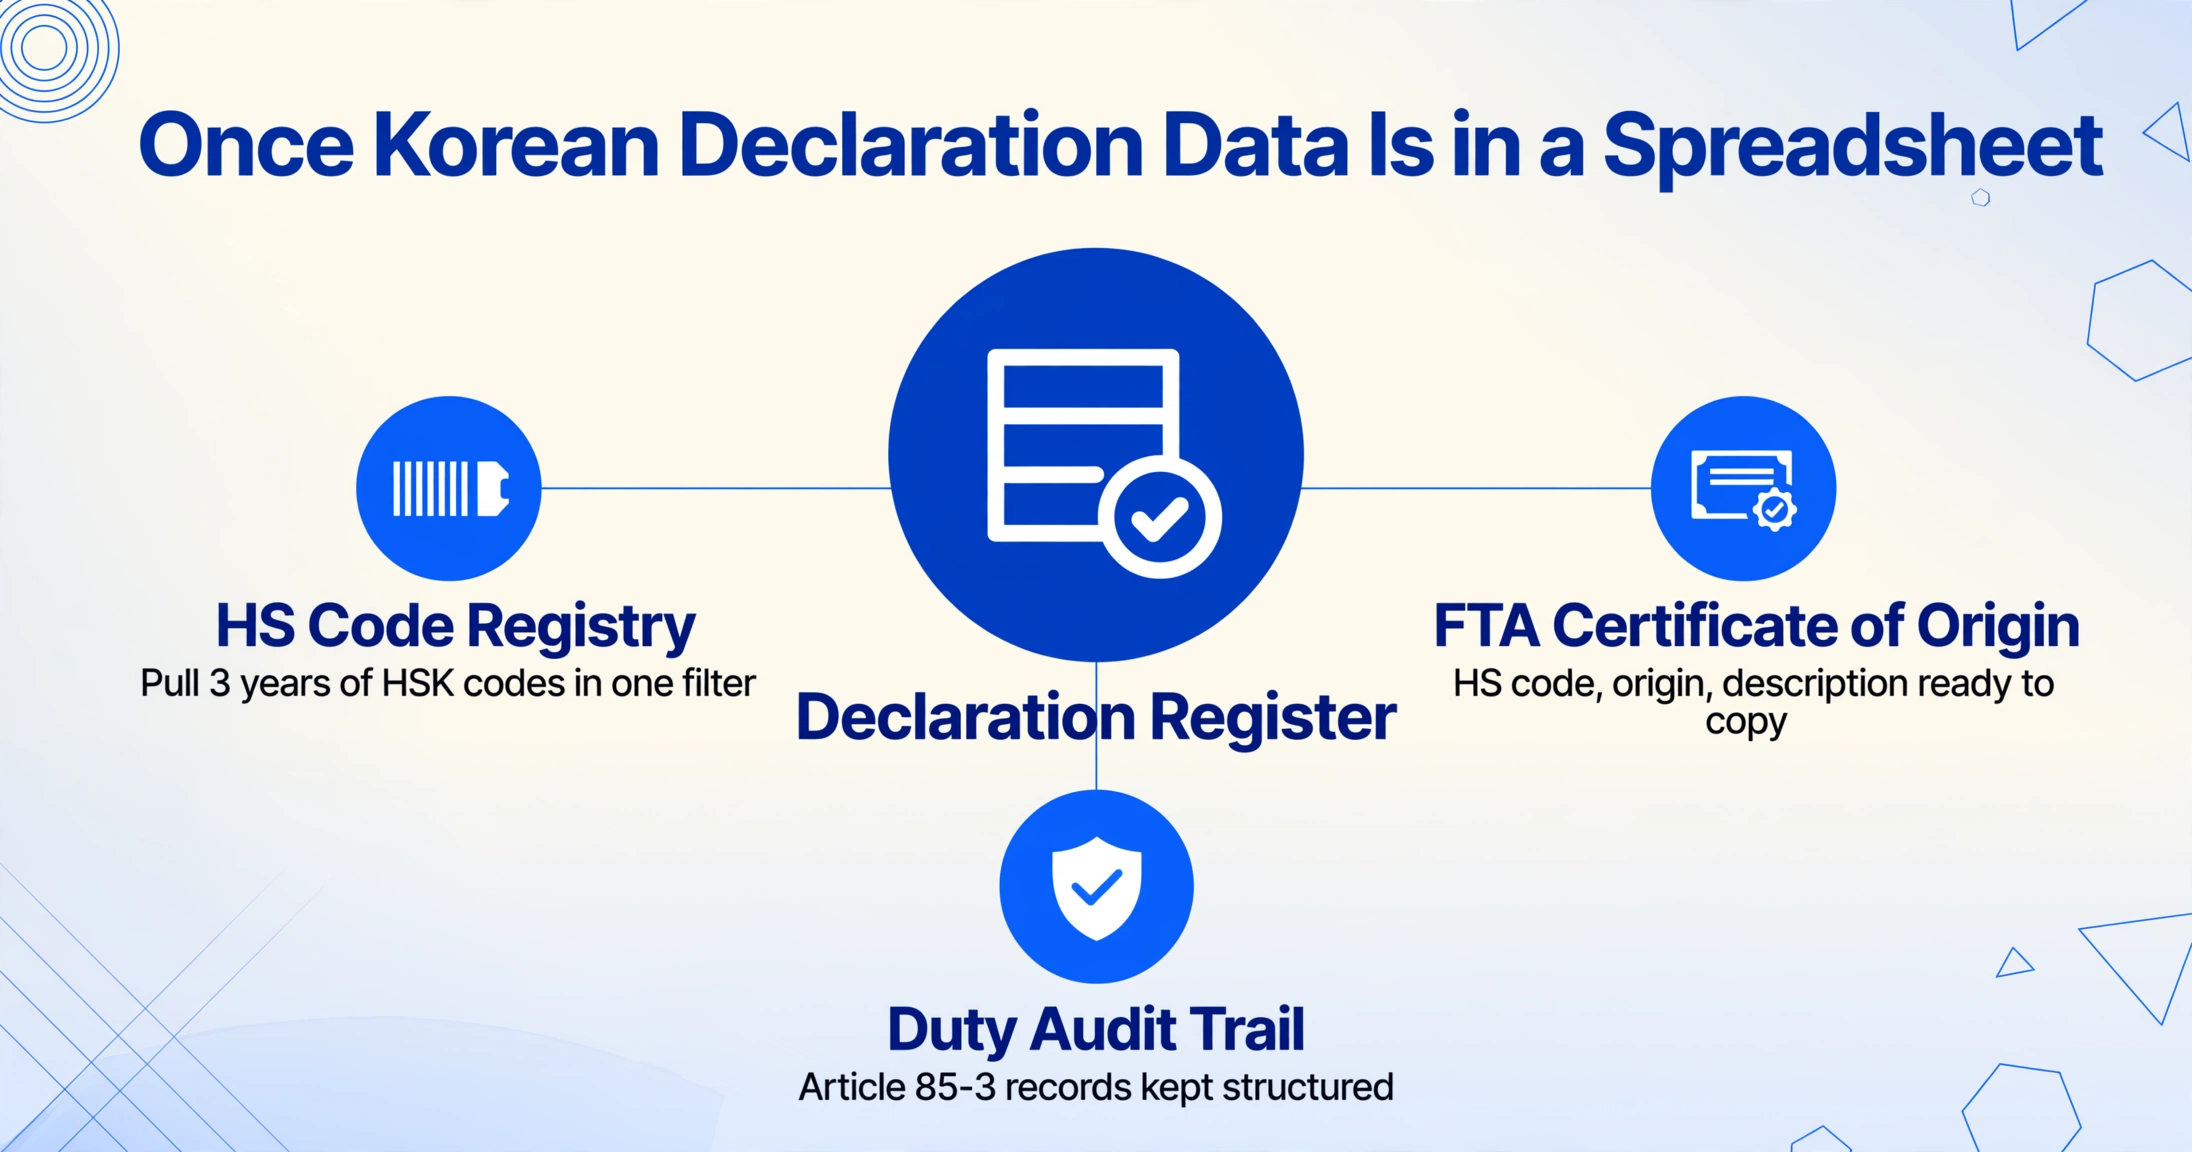
HSコード台帳のメンテナンス。韓国の10桁のHSKコードは5年ごとに更新されます。次の改訂はHS 2027で、2027年に予定されています。コード改訂サイクルの間、輸入業者は前期間にどのHSコードがどの製品に、どの関税率で使用されたかを正確に把握する必要があります。構造化された申告台帳があれば、これはフィルタ操作になります。過去3年間のすべてのHSコードを抽出し、新しいHS 2027分類にマッピングされるコードを特定し、台帳を体系的に更新します。構造化されたデータがない場合、同じタスクは各申告書を個別に開いてコードをコピーする必要があります。
FTA原産地証明書の準備。米韓FTAの下では、貨物の原産地を証明する輸出業者は、HSコード(6桁の国際レベル)、原産地の判定、製品説明を必要とします。これらはすべて輸出申告書に記載されています。申告データがすでにスプレッドシートにある場合、C/O申請の準備は関連する列を引き出し、原産地基準を確認することを意味します。そうでない場合は、申告書を開き、HSコードを見つけ、原産地フィールドを見つけ、C/Oフォームに入力することを意味します。
関税検証と監査証跡。韓国の国税基本法(국세기본법)第85条の3は、取引記録を5年間保管することを推奨しています。韓国関税庁の税関監査は、3年前までの申告書をレビューできます。完全なフィールド履歴(申告番号(신고번호)、HSコード、申告価額、原産地(원산지))を持つ構造化された申告台帳は、紙のファイルにはない監査証跡を提供します。監査人が特定の貨物について質問した場合、台帳を開いて該当する行を見つけます。それがなければ、ファイルを見つけ、その中の申告書を見つけ、監査人の要求に関連するデータを書き写す必要があります。
貿易照合と月次レポート。150件の月次申告書と商業送り状を照合する物流管理者は、並べて表示するビューを必要とします。申告のFOB/CIF値と請求書の金額、HSコードと製品説明を並べます。両方のデータセットがスプレッドシートにある場合、照合はVLOOKUPです。申告データが紙のファイルにある場合、照合は物理的なドキュメントウォークです。場所を特定し、読み、比較し、差異を記録し、次へ進みます。
この方程式のコスト側、つまり手動の申告データ入力が韓国の貿易会社に時間、エラーリスク、そして逃したFTA節約の点で実際にどれだけのコストをもたらすかについての詳細は、韓国の手動税額計算書処理コストに関する記事の分析が、関連する文書タイプについて同じ構造に従っています。申告書の計算も同じパターンに従い、文書間の照合という追加の側面があります。
よくある質問
AIは韓国の輸出申告書と輸入申告書の両方から一度にデータを抽出できますか?
はい。AIは文書の内容を読み取り、フィールドラベルとレイアウトに基づいて수출신고서(輸出申告書)と수입신고서(輸入申告書)を判別します。輸出申告書は主要な価値指標としてFOB値を含み、輸入申告書は関税計算用のCIF値を含みます。同じ列セットにFOB値とCIF値の両方を含めることができ、AIは文書に含まれるフィールドに入力し、もう一方は空白のままにします。後続の「申告種類」列で取引方向ごとに出力をフィルタリングできます。
印刷された申告書の手書きの値やブローカーの注記はどうなりますか?
文書画像を直接処理するVision AI(テキストに変換せず)は、機械印刷テキストに重なる手書きの値やスタンプを読み取ることができます。精度は読みやすさに依存します。クリーンなPDF上の明確なブロック体の手書きは印刷テキストと同等の精度を達成しますが、筆記体の注釈や基になる値を覆い隠すスタンプは信頼度を低下させます。システムは誤った値を静かに返すのではなく、低信頼度フィールドを人間のレビュー用にフラグ付けします。手書きのCIF調整とブローカーの修正スタンプは、韓国の申告書で最も一般的なエッジケースです。
これは私の通関ブローカーやUNI-PASS申告を置き換えますか?
いいえ。抽出は、通関後の貿易書類の文書からスプレッドシートへの変換ステップ、つまり貨物が通関した後に行われる作業を処理します。通関ブローカーは引き続きUNI-PASSを通じて申告を行い、韓国関税庁の通関プロセスは変わりません。抽出は、すでに通関済みの申告書から貿易コンプライアンススプレッドシート、監査ファイル、HSコード台帳へのデータの手動再入力に置き換えます。
同じ抽出バッチに添付書類(インボイス、船荷証券、原産地証明書)を含めることはできますか?
はい。申告書PDFを対応する商業インボイス、パッキングリスト、船荷証券、原産地証明書と一緒に同じバッチにアップロードしてください。抽出は各文書を列定義に基づいて独立して読み取り、1つの統合テーブルを出力します。これは出荷台帳を構築するための実用的なワークフローです:期間または貿易レーンごとに1つのバッチで、4つの文書タイプすべてが同じ構造化出力に供給されます。このアプローチを関税申告書全般に適用する完全なウォークスルーについては、グローバル関税申告書抽出ガイドをご覧ください。
AIは韓国独自の10桁HSKコード形式をどのように処理しますか?
AIは申告書に記載されている10桁のHSKコード全体を読み取ります。6桁の国際プレフィックスと4桁の韓国固有サフィックスの間のダッシュやスペース区切り(例:3304.99.00.00)も含めてです。抽出された値は完全なコードとして1つのセルに保持されます。通常6桁の国際レベルのみを必要とするFTA原産地証明書の場合、抽出されたコードの最初の6文字を専用の列に分離できます。抽出は現在のHSKコード表に対する検証を行いません。これは貿易チームや通関士によるコンプライアンス確認のステップとして残ります。
UNI-PASS申告書の印刷された韓国語ハングルの認識精度はどのくらいですか?
クリーンなUNI-PASS文書(機械生成のPDF、鮮明な印刷コピー)上の印刷された韓国語テキストは、構造化フィールド(申告番号、HSコード、日付、数値)で最大99%の認識精度を達成します。品名(품명)などの自由記述フィールドは、ハングルと英語の製品コードや技術略語が混在する可能性があり、精度はやや低くなりますが、実用範囲内に十分収まります。韓国語文書におけるAI精度の詳細な分析については、AIが韓国の請求書を正確に読み取れるかに関する記事をご覧ください。同じモデルの動作が通関申告書にも適用されます。
複数のHSコード行を含む申告書(複数品目貨物)はどのように処理しますか?
申告書の各HSコード行は、出力テーブルの1行を生成します。12の異なる製品分類がある申告書は12行を生成し、各行に申告番号が繰り返され、行固有のHSコード、製品説明、数量、価値が含まれます。これは複数行の文書抽出の標準的な動作であり、HSコード台帳や関税計算監査に必要な明細項目構造に一致します。申告番号は行全体のグループ化キーとして機能します。
UNI-PASSが数秒で処理するデータを、手作業で再入力するのに数分かかるべきではありません。サンプル申告書でお試しください — 수출신고서または수입신고서のPDFをアップロードし、列を定義して、セマンティック抽出がフォーマット済みの税関文書を構造化された貿易コンプライアンス表に変換する様子をご確認ください。
申告書で試す