韓国事業者登録データをExcelへ抽出する方法
— サプライヤーKYC用
韓国でのサプライヤーオンボーディングは、必ず同じ書類から始まります。それが事業者登録証明書(사업자등록증)です。銀行は法人口座開設の前にこれを要求します。政府調達ポータルは入札書類の一部としてこれを必須とします。ECプラットフォームは販売者アカウントの承認前にこれを求めます。そして、ほとんどのB2Bチームでは、これらの証明書のデータが、サプライヤー名、登録番号、住所、税区分など、一つのフィールドずつ手作業でスプレッドシートにコピーされています — 誰かがスキャンしたPDFやスマートフォンの写真を、列テンプレートと照らし合わせて手動で突合しているのです。証明書自体は法律で標準化されています。そのデータを使えるレコードに変換するプロセスが、これほど遅い必要はないはずです。
重要なポイント
- サプライヤー証明書30件の手入力には90分かかり、バッチごとに5〜7件の誤入力が発生し、フォローアップの電話やメールが必要になります。
- BRNの1桁の誤りで、支払いが誤った事業体に送られる可能性があります — 手入力の本当のコストは入力時間ではなく、コンプライアンスリスクです。
- KYC用の8列を一度定義すれば、50件目の証明書を追加する際の限界コストは、形式に関係なくほぼゼロです。
サプライヤーKYCにおける事業者登録証明書(사업자등록증):その概要とデータが必要な理由
韓国の事業者登録証明書は、韓国で事業を営むすべての事業体にとって基本となる身分証明書です。国税庁(NTS、국세청)が付加価値税法第8条(부가가치세법 제8조)および所得税法第168条(소득세법 제168조)に基づき発行するもので、個人事業主から多国籍企業に至るまで、すべての事業者は事業開始から20日以内に登録し、この証明書を取得しなければなりません。この文書の法的効力は税務行政にとどまりません。韓国の金融実名法(금융실명법、実名金融取引及び秘密保障に関する法律)に基づき、事業者登録証明書はすべての金融取引、銀行取引、商業契約における事業者身分の主要な証明として機能します。
サプライヤーKYCの文脈では、この証明書は取引先候補について以下の8つの情報を示します。
| 項目(英語) | 項目(韓国語) | KYCで重要な理由 |
|---|---|---|
| 事業者登録番号 | 사업자등록번호 | サプライヤーの主要な税務ID — 形式はXXX-XX-XXXXX。BRNとも呼ばれます。すべての税務計算書、契約書、法的検証に必要です。 |
| 商号 | 상호 | 事業の運営名称。銀行口座や発行済み請求書の名称と一致している必要があります。 |
| 代表者名 | 성명 (대표자) | 法定代理人 — CEOまたは取締役に相当します。署名者の検証に不可欠です。 |
| 開業年月日 | 개업연월일 | 事業が正式に開始された日。事業の成熟度の評価や登録の新しさの検証に使用されます。 |
| 事業所所在地 | 사업장소재지 | 登録された事業所の所在地。高度なデューデリジェンス(EDD)における物理的住所確認と照合されます。 |
| 事業の種類/業種コード | 사업의종류 (업종코드) | 業種分類(업태および종목)。サプライヤーが主張する業界で実際に事業を営んでいることを確認します。 |
| 課税類型 | 과세유형 | 一般納税者(일반과세자)、簡易納税者(간이과세자)、免税事業者(면세사업자)。サプライヤーが付加価値税請求書を発行できるかどうかを決定します。 |
| 交付事由 | 교부사유 | 証明書が発行された理由 — 新規登録、再発行、または変更。 |
これら8つの項目は、KYCチームが韓国のサプライヤーを検証するために必要な最小限のデータセットです。しかし実際には、これらはさまざまな形式で届きます。メールに添付されたPDFスキャン、ラミネート加工された証明書のスマートフォン写真、FAXコピー、NTSのHomeTax(홈택스)ポータルからのスクリーンショットなどです。これらの形式はいずれもデータベース入力用に構造化されておらず、ここから抽出の問題が始まります。
ステップバイステップ:事業者登録証明書(사업자등록증)のデータをExcelに抽出する
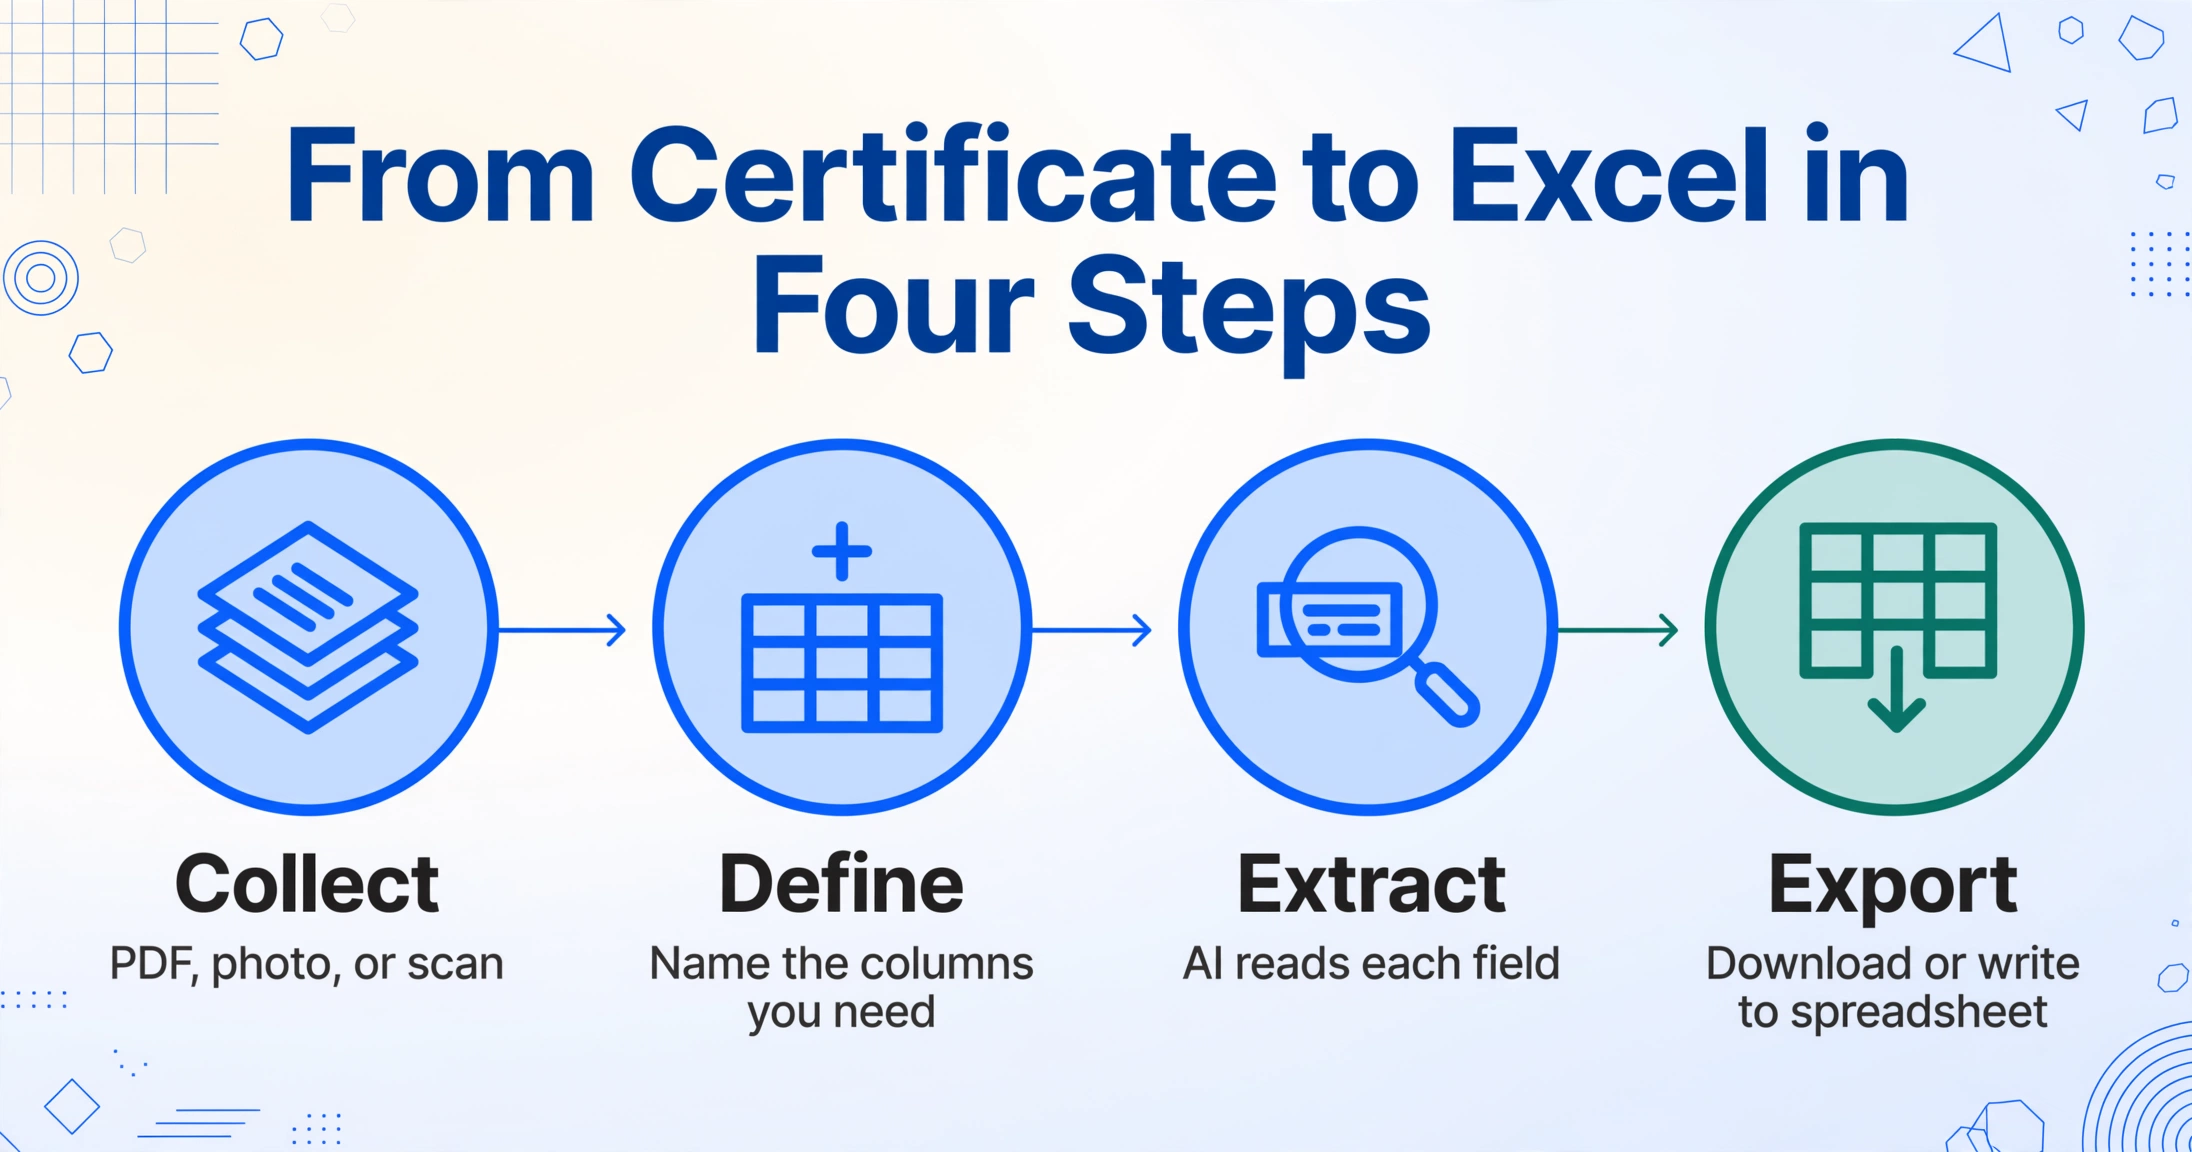
韓国の事業者登録証明書を構造化されたスプレッドシートの行に変換するプロセスは、4つのステップで構成されています。1枚を処理する場合でも50枚を処理する場合でも、セットアップ時間は同じです。これこそが、手動入力ではなく抽出を使用する意義です。
(PDF、写真、スキャン)
特定して読み取る
スプレッドシートに書き込み
ステップ1:証明書を収集する
受け取ったすべての사업자등록증の書類を集めてください。メールの添付ファイル(PDFまたは画像)、現場スタッフによるスマートフォン撮影、サプライヤーポータルからのスキャンコピーなど、形式は問いません。このツールはJPG、PNG、PDF、WebP形式に対応しているため、ファイルの変換や正規化は不要です。すべてまとめて1つのバッチでアップロードしてください。50件のサプライヤー証明書のバッチでも、アップロード時間は1件の場合とほぼ同じで、ファイルの転送に約30〜60秒かかります(サイズによります)。
ステップ2:出力列を定義する
ここがセマンティック抽出とテンプレートベースのOCRの違いです。文書テンプレートに矩形を描く代わりに(次のサプライヤーの証明書のレイアウトが異なると機能しなくなります)、AIに見つけてほしいフィールドに名前を付けるだけで済みます。KYCスプレッドシートに合わせて列名を入力してください:Business Registration Number、Business Name、Representative、Business Address、Tax Classification、Industry Code、Start Date。入力した列名が最終テーブルのヘッダーになります。サプライヤーごとのテンプレート設定は不要です。AIが各証明書を読み取り、座標位置ではなくセマンティックな理解によって一致するフィールドを特定します。
このアプローチはカスタム列抽出と呼ばれ、出力構造を一度定義すれば、発行元、撮影カメラ、スキャンかスクリーンショットかに関係なく、すべての証明書が同じ列にマッピングされます。斜めに撮影された写真を提出したサプライヤーも、NTSポータルからきれいなPDFをアップロードしたサプライヤーも、同じ構造化された行が生成されます。この証明書は韓国の税務文書ファミリーの一員です。韓国税務文書処理ガイドでは、同じ列ファーストのアプローチで税額計算書、現金領収書、納品書を併せて読み取る方法を紹介しています。
ステップ3:AI抽出
ファイルがアップロードされ列が定義されると、抽出エンジンがバッチ内のすべての証明書を同時に処理します。各文書は視覚言語モデルによって分析され、フィールドラベルを識別し、関連する値を読み取り、要求された列にマッピングします。処理時間は1ページあたり5〜10秒で、すべてのファイルが処理されるとバッチが完了します。通常、一般的なサプライヤー数であれば数分以内に完了します。
ステップ4:ExcelまたはCSVにエクスポート
結果は単一のExcel(XLSX)またはCSVファイルとして出力されます。各証明書が1行になり、定義した各列が1列になります。エクスポートされたファイルは、KYCデータベース、ERP(Douzone、Ecount、SAPなど)、またはサプライヤー管理システムへのインポートにそのまま使用できます。手動での再フォーマットは不要です。データ構造はステップ2で定義した列名と一致し、ファイル形式は韓国のすべての会計プラットフォームで受け入れられる標準的なCSVまたはXLSXです。
重要な原則:出力構造は一度だけ定義します。AIはすべての証明書形式に自動的に適応します。これにより、サプライヤーKYCのバッチ抽出が実現可能になります。50社目のサプライヤーをスプレッドシートに追加する限界コストはほぼゼロです。
KYCスプレッドシートに必要な8つの主要フィールド — BRNの読み方
事業者登録番号(사업자등록번호)自体には、KYCチームが別のデータベースを照会せずに迅速なサプライヤー評価に使用できる意味のある情報が含まれています。番号の構造を理解することで、10桁の識別子が即時の検証ツールに変わります。
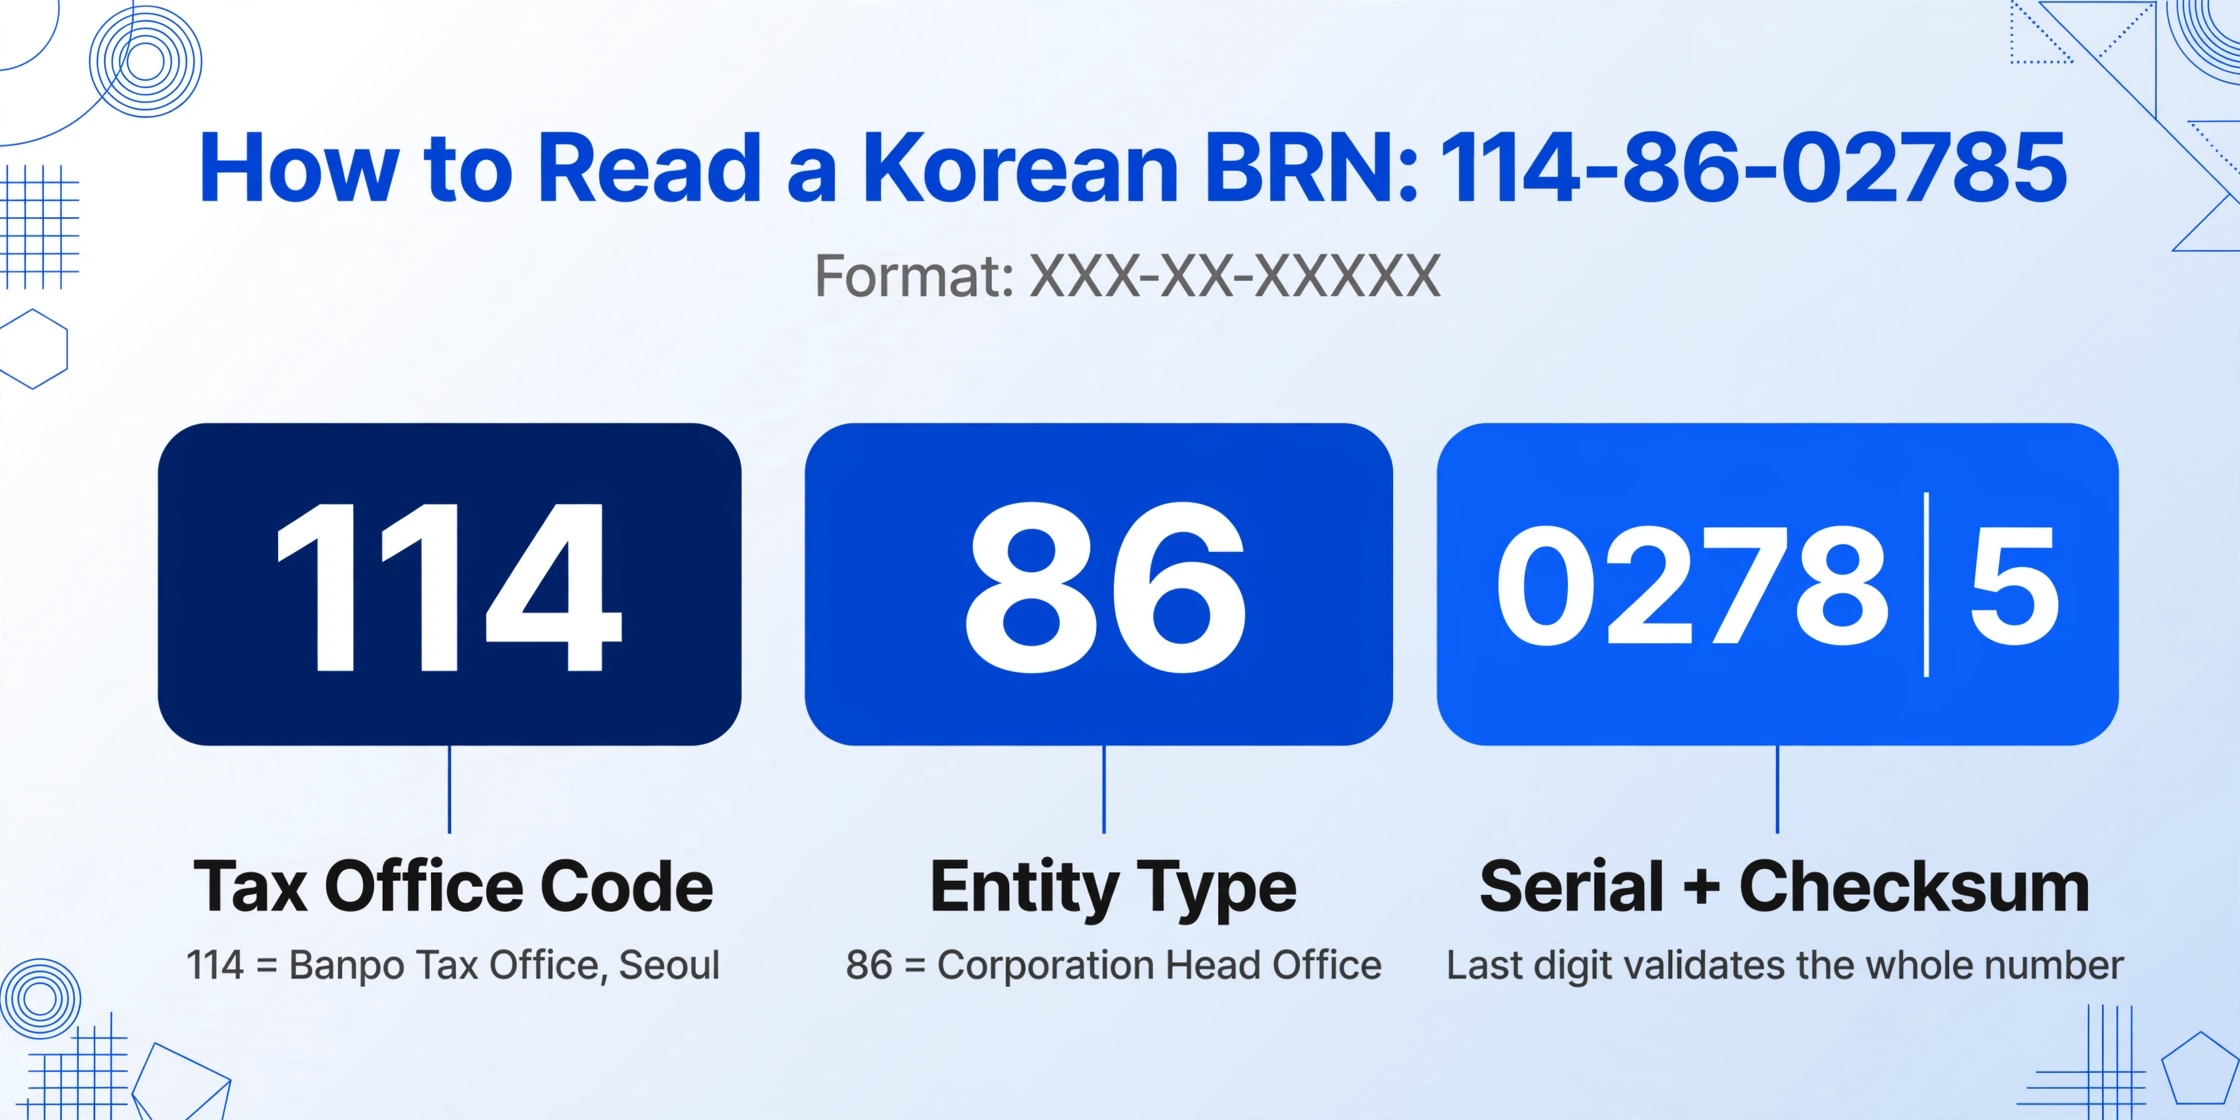
BRN形式XXX-XX-XXXXXの内訳は以下のとおりです:
| 位置 | 例 | 意味 |
|---|---|---|
| 最初の3桁 | 114 | 税務署コード — 番号を発行した管轄税務署(세무서)を識別します。114 = 盤浦税務署(ソウル)。韓国の約80の税務署にはそれぞれ固有のコードがあります。 |
| 中央の2桁 | 86 | 事業者区分コード — 最も有用な検証シグナルです。01–79 = 付加価値税納税義務のある個人事業主、81、86–88 = 営利法人の本店、85 = 営利法人の支店、82 = 非営利法人、83 = 政府機関、84 = 外国法人、89 = 宗教団体、90–99 = 付加価値税免税の個人事業主です。 |
| 最後の5桁 | 02785 | 一連番号(最初の4桁)+ チェックディジット(最後の1桁)— チェックディジットはBRN全体を数学的に検証し、HomeTaxが照会なしで番号の有効性を確認する方法です。 |
中央の2桁を見るだけで、事業者が個人事業主か、法人本店か、支店か、非営利法人か、外国法人かを、データベースを参照せずに判別できます。これは初期KYCトリアージを迅速化するシグナルであり、特に大量の仕入先申請を処理する際に有効です。ほとんどの申請は初期スクリーニングを通過し、例外のみがエスカレーションを必要とします。
完全な8項目のデータセット(BRN、事業者名、代表者、開始日、住所、業種コード、税区分、発行事由)があれば、仕入先マスターレコードを入力するために必要なすべてが揃います。政府、国内ERP、ドル建てAIツールの比較を見ると、韓国国内市場で利用可能なツールはERPサブスクリプションを必要とするか、ページ単位で課金されるかのいずれかであり、どちらの価格モデルも、月に10件の場合もあれば、仕入先更新サイクル中に200件の場合もある、不定期な量の証明書を処理するバッチKYCのユースケースに最適化されていません。
韓国仕入先オンボーディングにおける手動入力が真のボトルネックである理由
仕入先KYCの手動データ入力のコストは、単にタイピングに費やす時間だけではありません。オンボーディングの遅延、すり抜けるエラー、そして誤った仕入先情報に基づいて行動するコンプライアンスリスクも含まれます。
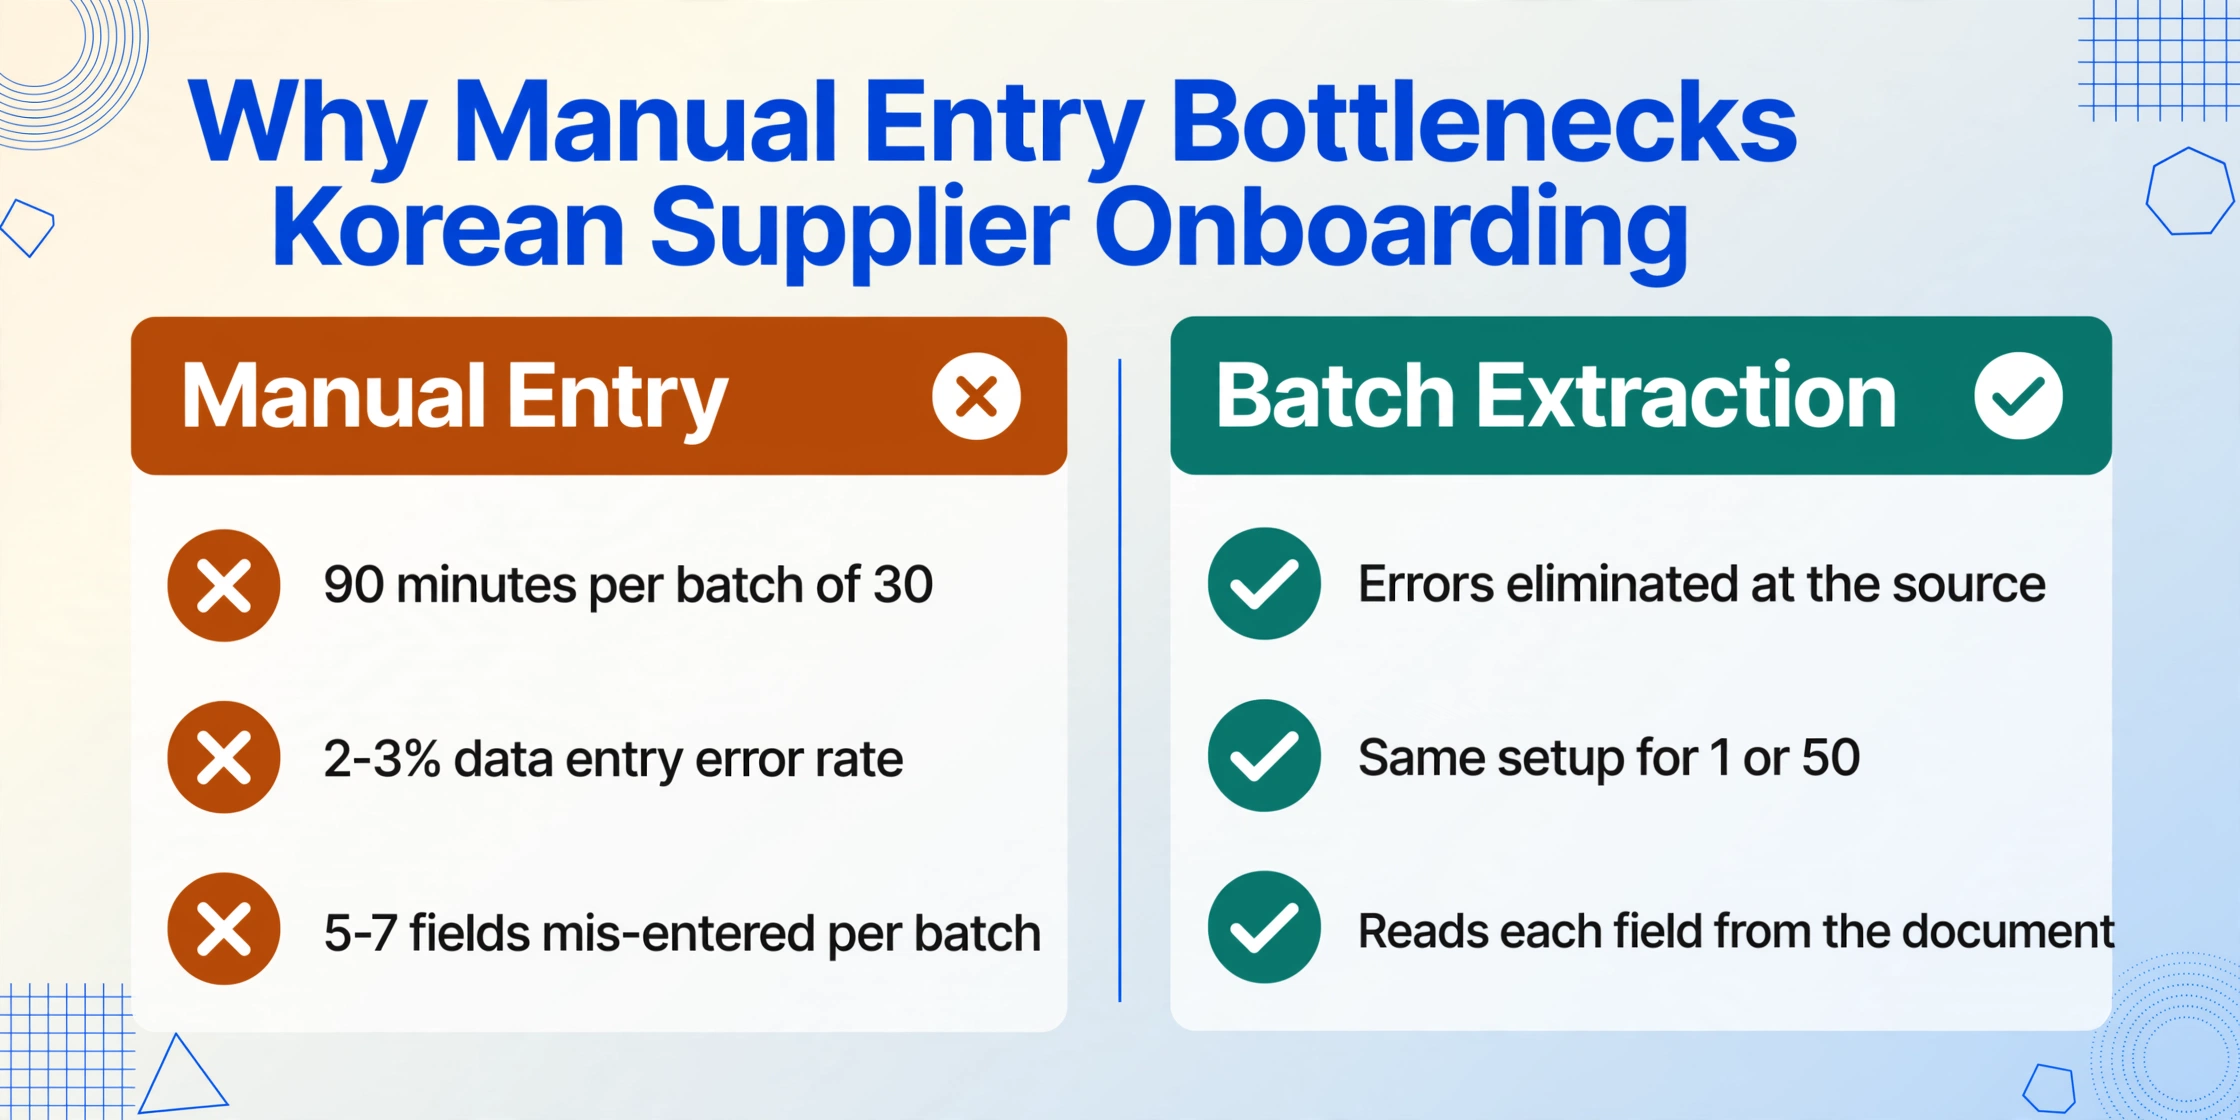
四半期ごとに30社の新しい韓国仕入先をオンボーディングする中規模企業を考えてみましょう。各사업자등록증には8つの主要フィールドが含まれています。これは四半期あたり240のデータポイントです。実際には、コンプライアンスチームが提出日、レビュー担当者、検証ステータス、書類の有効期限も記録するため、各証明書には8つ以上のフィールドが必要です。証明書1件あたり約3分の手動入力は、すべてが順調に進めば30件のバッチあたり90分を意味します。実際にはさらに時間がかかります。タイピストはスマートフォンの写真を拡大してぼやけた登録番号を読んだり、斜めにスキャンされた住所を打ち直したり、「일반과세자」が仕入先にVATインボイスを発行できることを意味するかどうかを照合したりする必要があります(実際には可能ですが、コンプライアンス担当者は内部ポリシーに照らして確認する必要があります)。
2〜3%のデータ入力エラー率を加えると(10桁のBRNの1桁の読み間違いで誤った事業者に支払いが送られる)、手動入力のコストは倍増します。四半期ごとに30件の証明書を処理するコンプライアンスチームの場合、バッチあたり約5〜7フィールドの誤入力が発生することになります。各エラーには仕入先へのフォローアップメールや電話が必要となり、オンボーディングサイクルが数日から数週間遅れます。
バッチ抽出はこれらのエラーを根本から排除します。AIは文書画像から各フィールドを直接読み取り、構造化テキストとして出力します。エラープロファイルは、転記ミス(誤った数字、名前のスペルミス、住所の転置)から解釈のエッジケース(コピーの薄い文字、部分的に隠れた印鑑)へと移行します。これらははるかに頻度が低く、レビュー中に発見するのがはるかに簡単です。
ファイルは安全に処理され、保存されません。
セマンティック抽出が韓国の証明書をどのように処理するか
韓国の事業者登録証明書には、従来のOCRツールではうまく処理できず、セマンティック抽出が直接解決する3つの課題があります。
課題1: 印影の干渉。 사업자등록증には、発行税務署からの複数の公式印(직인)が押されています。これらの印は、印刷されたテキストフィールドと重なることがよくあります。税務署長の印鑑が発行日や税区分を部分的に覆う場合があります。従来のOCRは、テキスト上のインクをノイズとして読み取り、文字化けした文字を出力します。視覚言語モデルは文書を全体的に読み取ります。円形の赤いオーバーレイが印であることを理解し、テキスト認識の目的ではそれを無視して、下の文字を正しく読み取ります。この区別が重要なのは、ほぼすべての사업자등록증に印が存在するためです。それらは文書の特徴であり、異常ではないからです。
課題2: 韓国語、漢字、英語の混在。 韓国の証明書は、ほとんどのフィールドラベルと値にハングル(한글)を使用し、商号と住所には漢字(한자)を使用し、一部の輸出向け証明書では英語を使用します。1つの書記体系に最適化されたツールは、他の書記体系では性能が低下します。セマンティック抽出で使用される視覚モデルは、同じ文書ページ内で3つすべてを同時に処理します。異なるスクリプト用にOCRエンジンを切り替えることはありません。商号に漢字(例:老舗商社の株式会社)が含まれるサプライヤーも、ハングルでエンコードされたフィールドと一緒に正しく読み取られます。
課題3:角度・照明・形式のばらつき。実際の사업자등록증は、フラットベッドスキャン、オフィスの電話で撮影した机の上の写真、ファックスのファックス、HomeTaxポータルのスクリーンショットなど、さまざまな形で届きます。テンプレートベースのOCRでは、文書が所定のゾーン内に配置されている必要があります。20度の角度で撮影した写真では、すべてのフィールドが期待される境界ボックスの外にずれてしまいます。セマンティック抽出はフィールドの位置に依存せず、ラベルの隣にある値を読み取って検出します。ラベルがページのどこにあっても関係ありません。このフォーマット非依存性により、サプライヤーごとの設定手順なしでバッチ処理が可能になります。
実際的な意味合い:30件のサプライヤー証明書のバッチ(スキャンしたPDF、スマートフォンの写真、HomeTaxのスクリーンショットを混在)は、ファイルを整理、名前変更、正規化することなく、1回のパスでアップロード、抽出、エクスポートできます。抽出品質は、クリーンなPDFアップロードと角度付き写真の間で劣化しません。
FAQ
韓国語のみで英語がない事業者登録証明書(사업자등록증)からデータを抽出できますか?
はい。AIはハングルを英語や漢字と同じように自然に読み取ります。韓国語をプラグインとして持つ別のOCRエンジンではありません。抽出テンプレートの列名は英語(例:「Business Name」)にでき、AIは対応する韓国語のフィールドラベル(「상호」)を見つけてその値を抽出します。出力スプレッドシートには、英語の列ヘッダーの下に抽出された韓国語のテキスト値が含まれます。同じ文書に韓国語と英語の両方のテキストが含まれるバイリンガル証明書の場合、AIはフィールドラベルが使用する言語を読み取ります。
サプライヤーの証明書が角度付きまたは照明不良の写真の場合はどうなりますか?
セマンティック抽出は、正面からの位置決めに依存しないため、角度付きの写真や不均一な照明を従来のOCRよりも適切に処理します。ビジョンモデルは人間と同じように文書を解釈します。フィールドラベルと値を固定座標で期待するのではなく、その内容と相対的な配置によって識別します。ぼやけた写真や極端に低解像度の写真では精度が低下する可能性がありますが、最も一般的な状況(標準的なオフィス照明でスマートフォンで撮影した机の上の写真)では、信頼性の高い抽出が得られます。
抽出ツールはBRNが実際の有効な登録であることを検証しますか?
いいえ — ツールは証明書に印刷されたBRNを抽出しますが、NTSデータベースに照会して番号が現在有効であるか、事業がその後閉鎖されていないかを確認することはありません。抽出されたBRNは、NTS HomeTaxポータル(www.hometax.go.kr)または韓国公共データポータル(data.go.kr)APIで照会して検証できます。抽出ステップは構造化データを生成し、別の検証ステップがその現在の有効性を確認します。抽出と検証のこの分離はKYCワークフローで標準的な慣行であり、抽出されたデータは検証プロセスの入力であり、出力ではありません。
証明書にフィールドがない場合はどうなりますか?
特定のフィールドが文書に表示されない場合(たとえば、再発行された証明書に元の事業開始日が表示されない場合)、対応する列のセルは空のままになります。抽出は値を捏造しません — ページ上で見つかったものだけを出力します。この動作はバッチ内のすべての文書で一貫しており、エクスポートされたスプレッドシートで欠落フィールドを簡単に特定し、特定のサプライヤーにフォローアップできます。
個人事業主と大企業の両方の証明書をまとめてバッチ処理できますか?
はい。사업자등록증の形式はNTSによって標準化されています — 同じ文書構造がフリーランサーにもサムスン子会社にも適用されます。どちらもBRN、事業者名、代表者名、住所、税区分を生成します。唯一の違いはBRNの中央2桁の事業者タイプコード(個人事業主は01〜79、法人は81/86〜88)であり、AIはBRNフィールドの一部として抽出します。異なる事業者タイプが混在する単一のバッチは1回のパスで処理されます。
同じタスクにNaver Clova OCRを使用する場合とどう比較しますか?
Naver Clova OCRは韓国語テキストを高い精度(97〜99%)で読み取り、1ページあたり約₩50のコストがかかります。重要な違いはテキスト認識後の処理です:Clova OCRは位置データ付きの生のテキスト文字列を返しますが、どの文字列が事業者名で、どの文字列が代表者名で、どの文字列が住所かを理解しません。構造化フィールドを抽出するには、証明書のレイアウトごとにカスタム解析ロジックを書くか、文書形式ごとにテンプレートを設定する必要があります — 各サプライヤーの証明書に微妙なレイアウトの違いがある場合、バッチ処理の目的が損なわれます。AIセマンティック抽出は、列名にマッピングされた構造化データを返すため、抽出後の解析は不要です。1ページあたりのコスト比較はボリュームに依存します — 韓国文書抽出の価格分析では、1ページあたりのAPIツールと定額抽出の間の損益分岐点を月間ボリューム別に詳しく説明しています。
まだ必要なデータが分からない場合、どの列を含めるべきですか?
まずはこの記事に記載されている8つの標準フィールド(BRN、事業者名、代表者名、開始日、事業所住所、業種コード、税区分、発行事由)から始めてください。これらは、韓国のAML/CFT規制に基づくサプライヤーKYCの最低要件をカバーします。コンプライアンスフレームワークでより詳細な情報(共同代表者情報や事業形態の特定のサブ分類など)が必要な場合は、抽出テンプレートにそれらの列を追加でき、AIが文書上でそれらを検索します。列定義は固定されておらず、KYC要件の変化に応じてバッチ間で調整できます。