Comment extraire les données d'enregistrement d'entreprise coréennes
vers Excel pour le KYC fournisseur
Chaque processus d'intégration de fournisseur en Corée commence par le même document : le certificat d'enregistrement d'entreprise (사업자등록증). Les banques l'exigent avant l'ouverture d'un compte professionnel. Les portails d'approvisionnement gouvernementaux l'exigent dans le dossier de soumission. Les plateformes de commerce électronique le demandent avant d'approuver un compte vendeur. Et dans la plupart des équipes B2B, les données de ces certificats sont copiées dans une feuille de calcul champ par champ — nom du fournisseur, numéro d'enregistrement, adresse, classification fiscale — par quelqu'un qui recoupe manuellement un PDF scanné ou une photo de smartphone avec un modèle de colonnes. Le certificat lui-même est normalisé par la loi. Le processus de transformation de ses données en un enregistrement utilisable ne devrait pas être aussi lent.
Points clés à retenir
- 30 certificats de fournisseurs prennent 90 minutes à saisir manuellement — avec 5 à 7 champs mal saisis par lot nécessitant des appels et des e-mails de suivi.
- Un seul chiffre erroné dans le BRN peut acheminer un paiement vers la mauvaise entité — le coût réel de la saisie manuelle n'est pas le temps de frappe, c'est le risque de conformité.
- Définissez vos 8 colonnes KYC une seule fois — le coût marginal de l'ajout du 50e certificat est quasi nul, quel que soit le format.
Le certificat d'enregistrement d'entreprise (사업자등록증) dans la KYC fournisseur : ce que c'est et pourquoi vous avez besoin de ses données
Le certificat d'enregistrement d'entreprise coréen est le document d'identité fondamental pour toute entité commerciale opérant en Corée du Sud. Délivré par le Service national des impôts (NTS, 국세청) en vertu de l'article 8 de la loi sur la taxe sur la valeur ajoutée (부가가치세법 제8조) et de l'article 168 de la loi sur l'impôt sur le revenu (소득세법 제168조), toute entreprise — qu'il s'agisse d'un travailleur indépendant ou d'une multinationale — doit s'enregistrer et obtenir ce certificat dans les 20 jours suivant le début de ses activités. La portée juridique du document va au-delà de l'administration fiscale : en vertu de la loi coréenne sur les transactions financières à nom réel (금융실명법, loi sur les transactions financières à nom réel et la confidentialité), le 사업자등록증 sert de preuve principale de l'identité commerciale pour toutes les transactions financières, les opérations bancaires et les contrats commerciaux.
Dans un contexte de KYC fournisseur, le certificat vous renseigne sur huit éléments concernant un vendeur potentiel :
| Champ (anglais) | Champ (coréen) | Pourquoi c'est important en KYC |
|---|---|---|
| Numéro d'enregistrement d'entreprise | 사업자등록번호 | Le principal identifiant fiscal du fournisseur — format XXX-XX-XXXXX. Également appelé BRN. Requis pour toutes les factures fiscales, les contrats et la vérification légale. |
| Nom commercial | 상호 | Le nom sous lequel l'entreprise exerce ses activités. Doit correspondre au nom figurant sur les comptes bancaires et les factures émises. |
| Nom du représentant | 성명 (대표자) | Le représentant légal — équivalent du PDG ou du directeur général. Essentiel pour la vérification des signatures. |
| Date de début d'activité | 개업연월일 | Date de début officiel de l'activité. Utilisée pour évaluer la maturité de l'entreprise et vérifier la récence de l'enregistrement. |
| Adresse de l'entreprise | 사업장소재지 | Adresse d'enregistrement de l'entreprise. Recoupée avec la vérification de l'adresse physique lors du devoir de diligence renforcé (EDD). |
| Type d'activité / Code sectoriel | 사업의종류 (업종코드) | Classification sectorielle (up-tae et jong-mok). Confirme que le fournisseur opère dans le secteur qu'il déclare. |
| Classification fiscale | 과세유형 | Assujetti général (일반과세자), assujetti simplifié (간이과세자) ou exonéré (면세사업자). Détermine si le fournisseur peut émettre des factures de TVA. |
| Motif de délivrance | 교부사유 | Raison de la délivrance du certificat — enregistrement initial, réémission ou modification. |
Ces huit champs constituent l'ensemble de données minimal dont toute équipe KYC a besoin pour vérifier un fournisseur coréen. Pourtant, en pratique, ils arrivent dans des formats variés : un scan PDF joint à un e-mail, une photo de smartphone prise sur un certificat plastifié, une copie faxée ou une capture d'écran du portail HomeTax (홈택스) du NTS. Aucun de ces formats n'est structuré pour une saisie en base de données — et c'est là que le problème d'extraction commence.
Étape par étape : Extraire les données du certificat d'enregistrement d'entreprise (사업자등록증) vers Excel
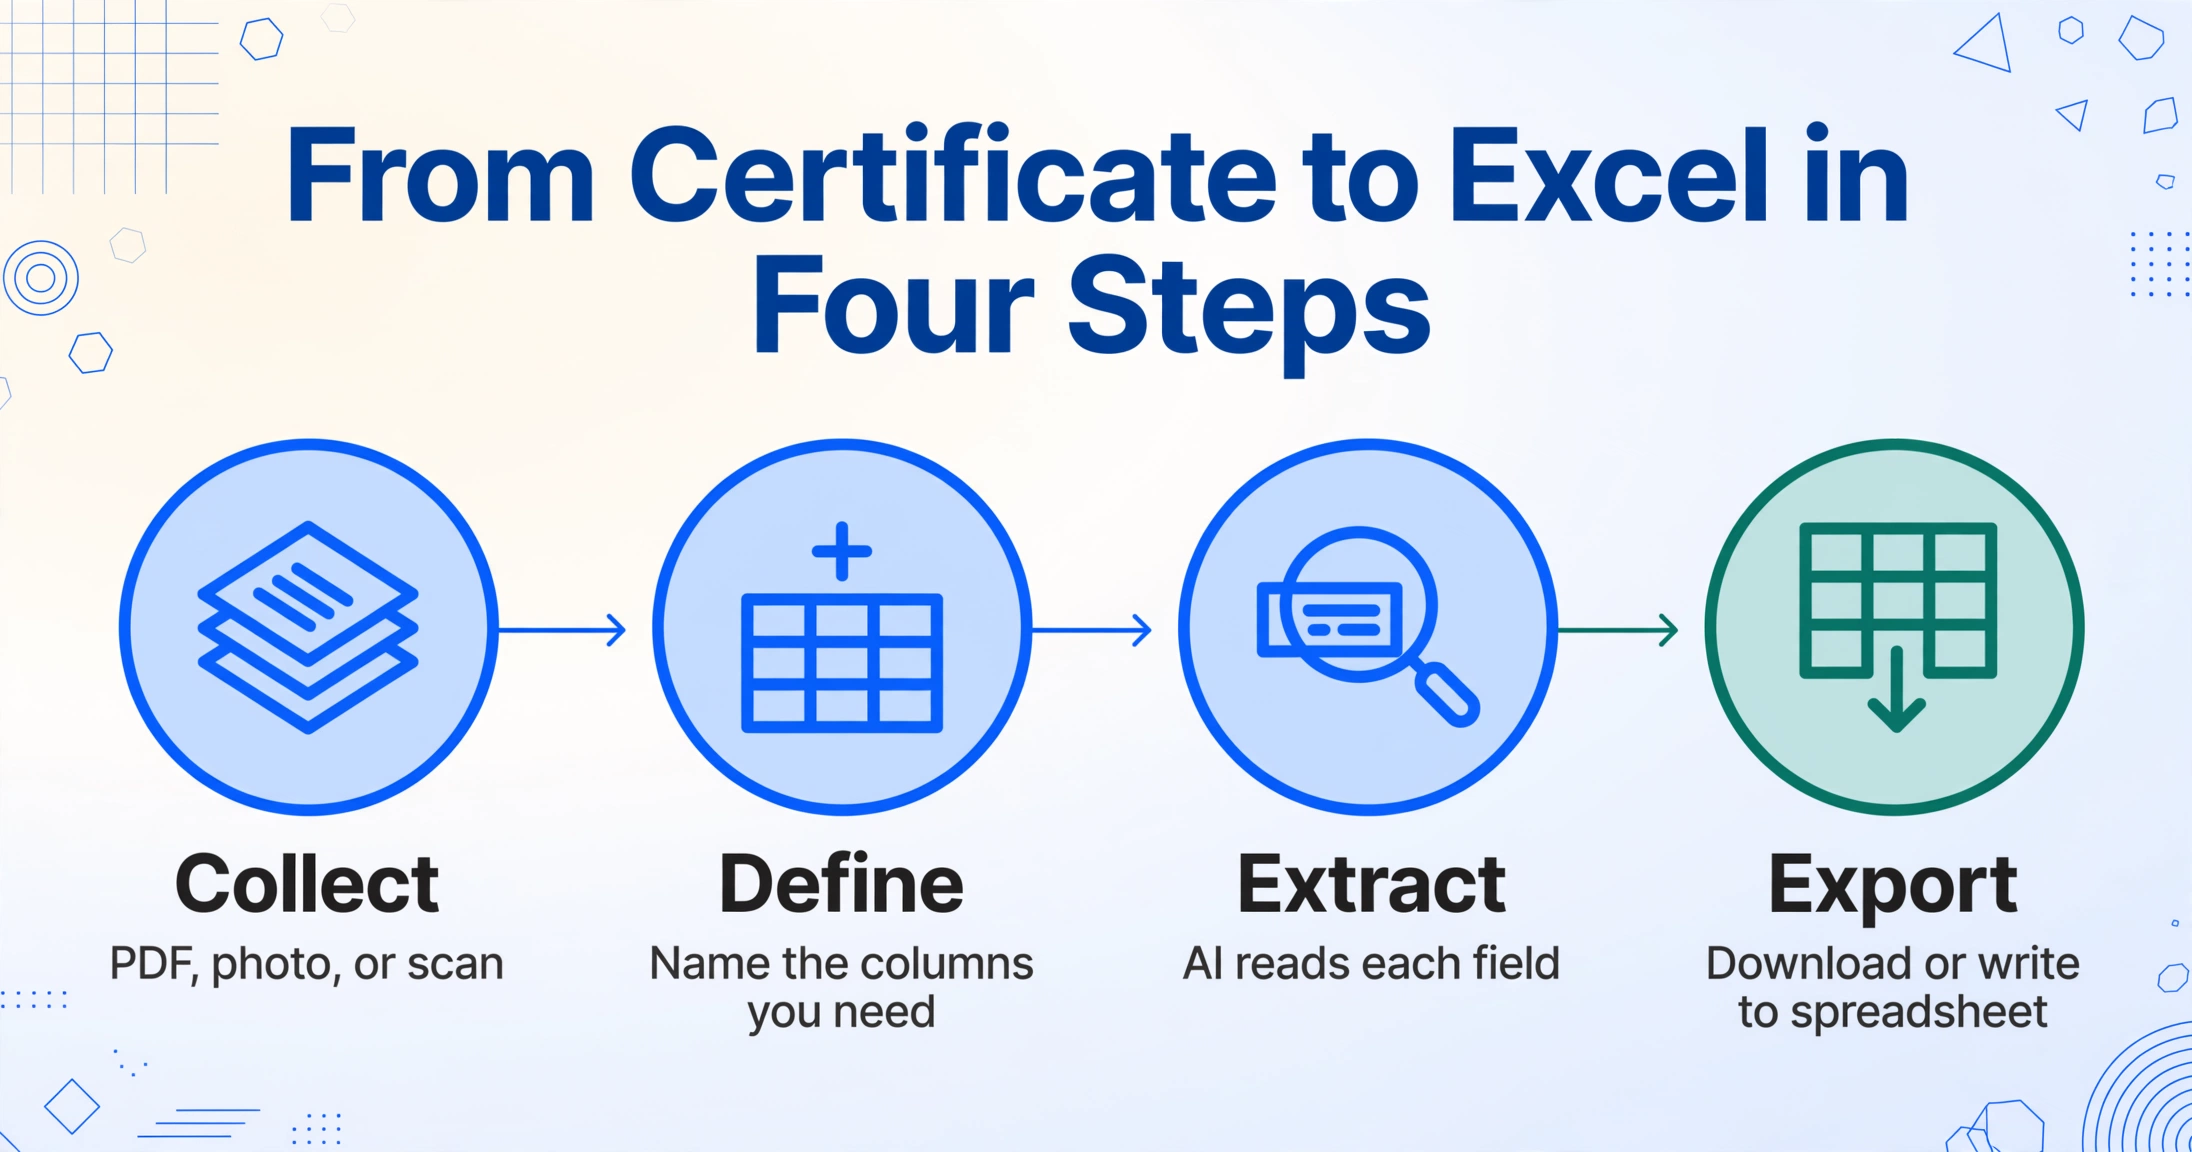
Le processus de transformation d'un certificat d'enregistrement d'entreprise coréen en une ligne de feuille de calcul structurée suit quatre étapes. Le temps de configuration est le même, que vous traitiez un certificat ou cinquante — c'est tout l'intérêt d'utiliser l'extraction plutôt que la saisie manuelle.
(PDF, photo, scan)
dont vous avez besoin
lit chaque champ
dans la feuille de calcul
Étape 1 : Collecter les certificats
Rassemblez tous les documents 사업자등록증 reçus — qu'il s'agisse de pièces jointes par e-mail (PDF ou image), de photos prises par le personnel sur le terrain ou de copies scannées depuis un portail fournisseur. L'outil accepte les formats JPG, PNG, PDF et WebP, il n'est donc pas nécessaire de convertir ou de normaliser les fichiers. Téléversez-les tous en un seul lot. Un lot de 50 certificats fournisseurs prend à peu près le même temps de téléversement qu'un seul — environ 30 à 60 secondes pour le transfert des fichiers, selon leur taille.
Étape 2 : Définir vos colonnes de sortie
C'est ici que l'extraction sémantique diffère de l'OCR basé sur des modèles. Au lieu de dessiner des rectangles sur un modèle de document (ce qui échoue lorsque le certificat du fournisseur suivant a une mise en page différente), il vous suffit de nommer les champs que l'IA doit trouver. Saisissez les noms de colonnes qui correspondent à votre feuille de calcul KYC : Business Registration Number, Business Name, Representative, Business Address, Tax Classification, Industry Code, Start Date. Les noms de colonnes que vous saisissez deviennent les en-têtes de votre tableau final. Aucune configuration de modèle par fournisseur n'est nécessaire — l'IA lit chaque certificat et localise le champ correspondant par compréhension sémantique, et non par position de coordonnées.
Cette approche, appelée Extraction de colonnes personnalisées, signifie que vous définissez la structure de sortie une seule fois et que chaque certificat — quel que soit son émetteur, l'appareil photo ayant pris la photo, ou que le certificat soit un scan ou une capture d'écran — correspond aux mêmes colonnes. Un fournisseur qui soumet une photo prise en angle produit la même ligne structurée que celui qui téléverse un PDF propre depuis le portail NTS. Le certificat est un membre de la famille des documents fiscaux coréens — le guide de traitement des documents fiscaux coréens montre comment la même approche axée sur les colonnes lit les factures fiscales, les reçus de caisse et les bons de livraison en parallèle.
Étape 3 : Extraction par IA
Une fois les fichiers téléchargés et les colonnes définies, le moteur d'extraction traite tous les certificats du lot simultanément. Chaque document est analysé par un modèle de vision-langage qui identifie les étiquettes des champs, lit les valeurs associées et les mappe aux colonnes demandées. Le temps de traitement est de 5 à 10 secondes par page, et le lot se termine une fois que chaque fichier a été traité — généralement en quelques minutes pour des volumes de fournisseurs typiques.
Étape 4 : Export vers Excel ou CSV
Les résultats sont regroupés dans un seul fichier Excel (XLSX) ou CSV. Chaque certificat devient une ligne ; chaque colonne définie devient une colonne. Le fichier exporté est prêt à être importé dans votre base de données KYC, votre ERP (comme Douzone, Ecount ou SAP) ou votre système de gestion des fournisseurs. Aucun reformatage manuel n'est requis — la structure des données correspond aux noms de colonnes que vous avez définis à l'étape 2, et le format de fichier est un CSV ou XLSX standard accepté par toutes les plateformes comptables coréennes.
Le principe clé : vous définissez la structure de sortie une seule fois. L'IA s'adapte automatiquement à chaque format de certificat. C'est ce qui rend l'extraction par lots viable pour le KYC des fournisseurs — le coût marginal d'ajout du 50e fournisseur au tableur est quasi nul.
8 champs clés pour votre tableur KYC — et comment lire le BRN
Le numéro d'enregistrement d'entreprise (사업자등록번호) lui-même encode des informations utiles que les équipes KYC peuvent utiliser pour une évaluation rapide des fournisseurs sans recouper une base de données distincte. Comprendre la structure du numéro transforme un identifiant à dix chiffres en outil de vérification instantanée.
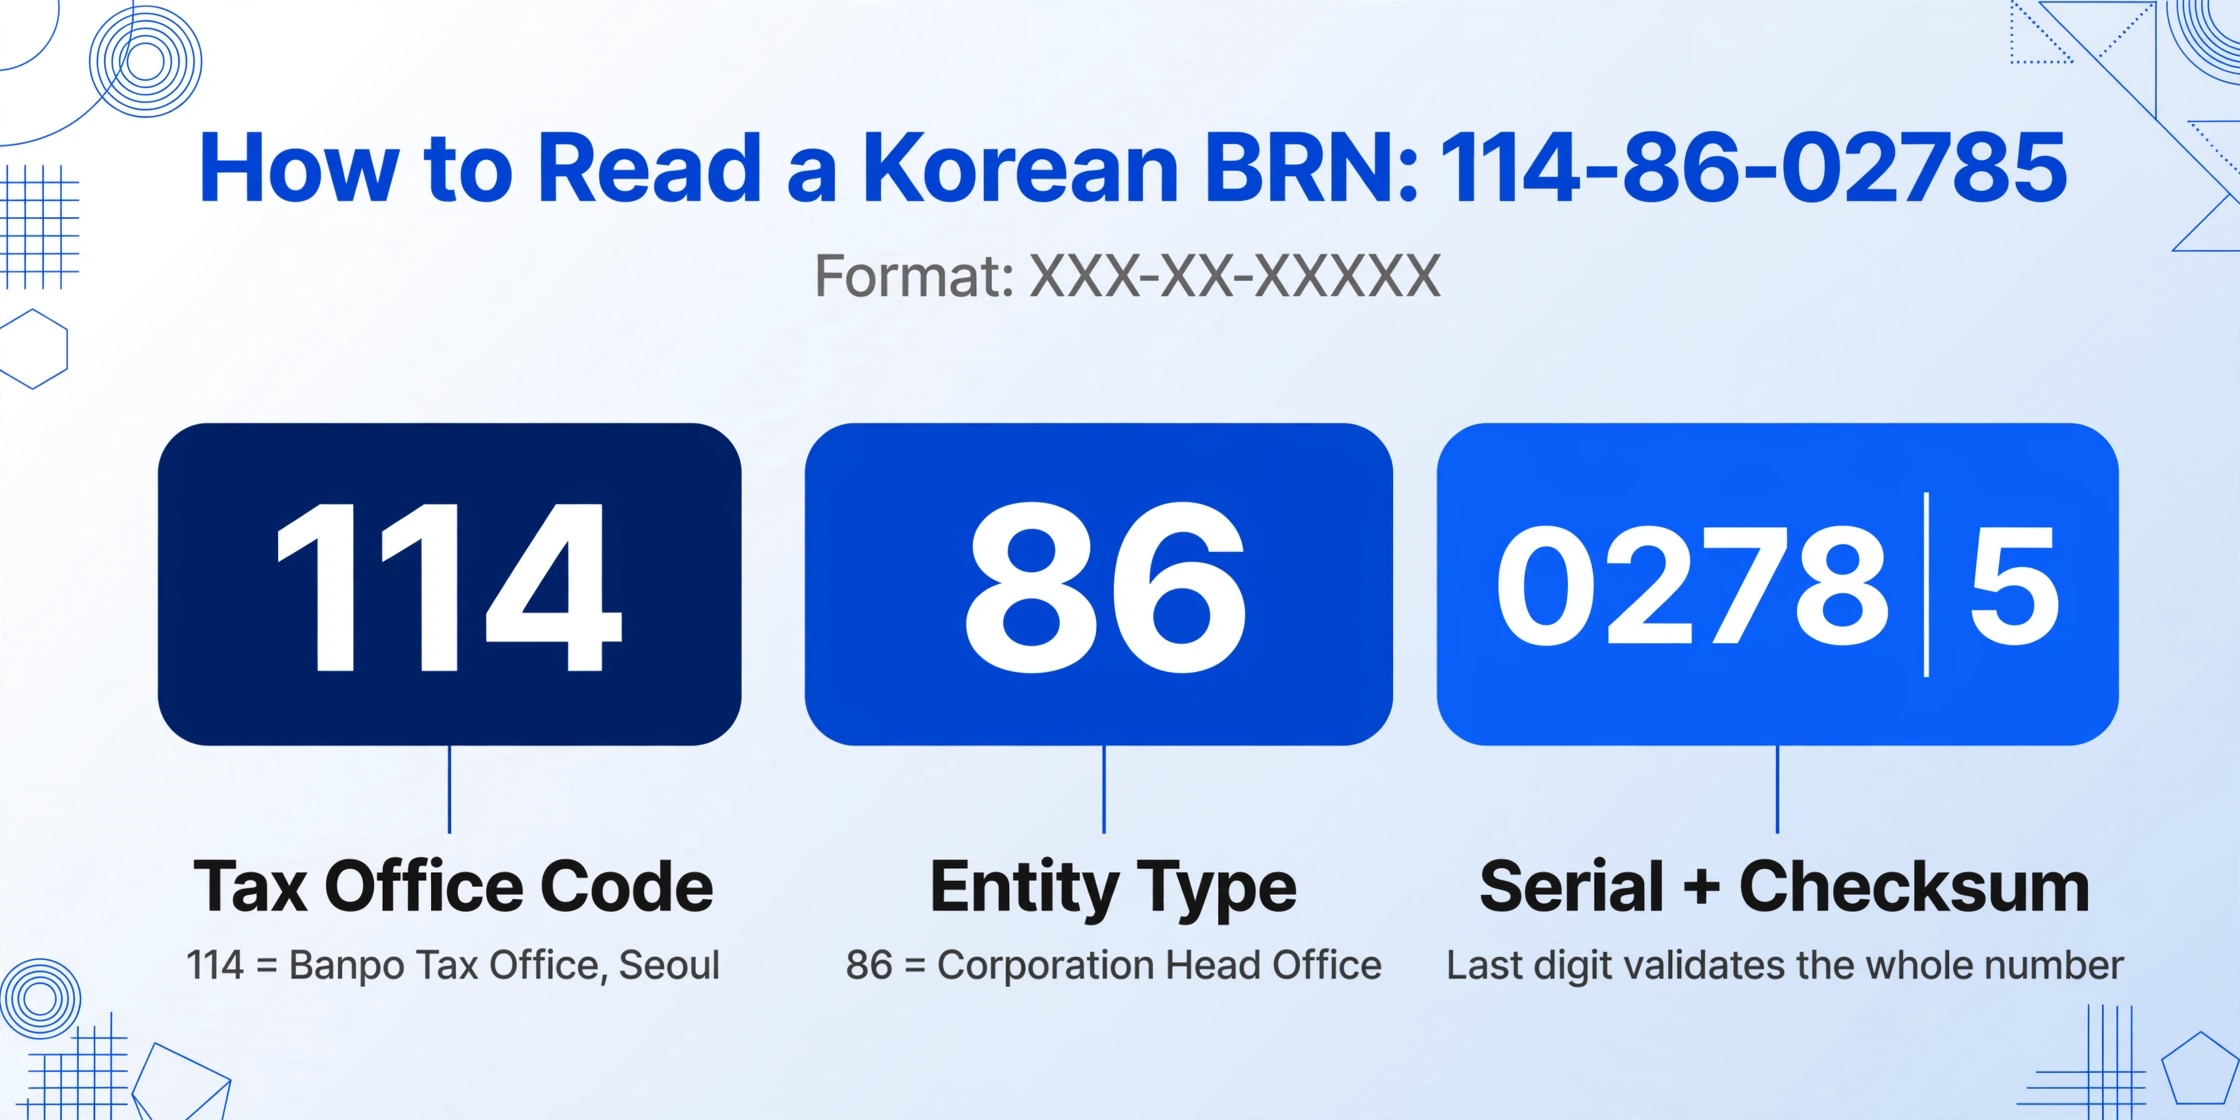
Le format du BRN XXX-XX-XXXXX se décompose comme suit :
| Position | Exemple | Signification |
|---|---|---|
| 3 premiers chiffres | 114 | Code du bureau des impôts — identifie le bureau de district (세무서) qui a délivré le numéro. 114 = bureau des impôts de Banpo (Séoul). Chacun des ~80 bureaux des impôts coréens possède un code unique. |
| 2 chiffres du milieu | 86 | Classificateur de type d'entité — le signal de vérification le plus utile. 01–79 = entrepreneur individuel assujetti à la TVA ; 81, 86–88 = siège social d'une société à but lucratif ; 85 = succursale d'une société à but lucratif ; 82 = organisme à but non lucratif ; 83 = entité gouvernementale ; 84 = société étrangère ; 89 = organisation religieuse ; 90–99 = entrepreneur individuel exonéré de TVA. |
| 5 derniers chiffres | 02785 | Numéro de série (4 premiers) + chiffre de contrôle (1 dernier) — le chiffre de contrôle valide mathématiquement l'ensemble du BRN, c'est ainsi que HomeTax confirme qu'un numéro est valide sans avoir à le rechercher. |
D'un seul coup d'œil sur les deux chiffres du milieu, vous pouvez savoir si un fournisseur est un entrepreneur individuel, un siège social, une succursale, une organisation à but non lucratif ou une entité étrangère — sans consulter aucune base de données. C'est le type de signal qui accélère le tri initial KYC, surtout lors du traitement de grands lots de demandes de fournisseurs où la plupart passent le premier filtrage et seules les exceptions nécessitent une escalade.
Le jeu de données complet de huit champs — BRN, nom de l'entreprise, représentant, date de début, adresse, code d'activité, classification fiscale et motif d'émission — vous donne tout ce qu'il faut pour remplir une fiche fournisseur principale. La comparaison des outils gouvernementaux, ERP nationaux et outils IA au prix en dollars montre que les outils disponibles sur le marché intérieur coréen exigent soit un abonnement ERP, soit facturent par page ; aucun de ces modèles de tarification n'est optimisé pour le cas d'usage KYC par lots où vous devez traiter un volume irrégulier de certificats — parfois 10 par mois, parfois 200 lors d'un cycle de renouvellement des fournisseurs.
Pourquoi la saisie manuelle est le véritable goulot d'étranglement dans l'intégration des fournisseurs coréens
Le coût de la saisie manuelle des données pour le KYC fournisseur ne se limite pas au temps passé à taper. C'est le retard dans l'intégration, les erreurs qui passent à travers, et le risque de conformité lié à l'utilisation d'informations fournisseur incorrectes.
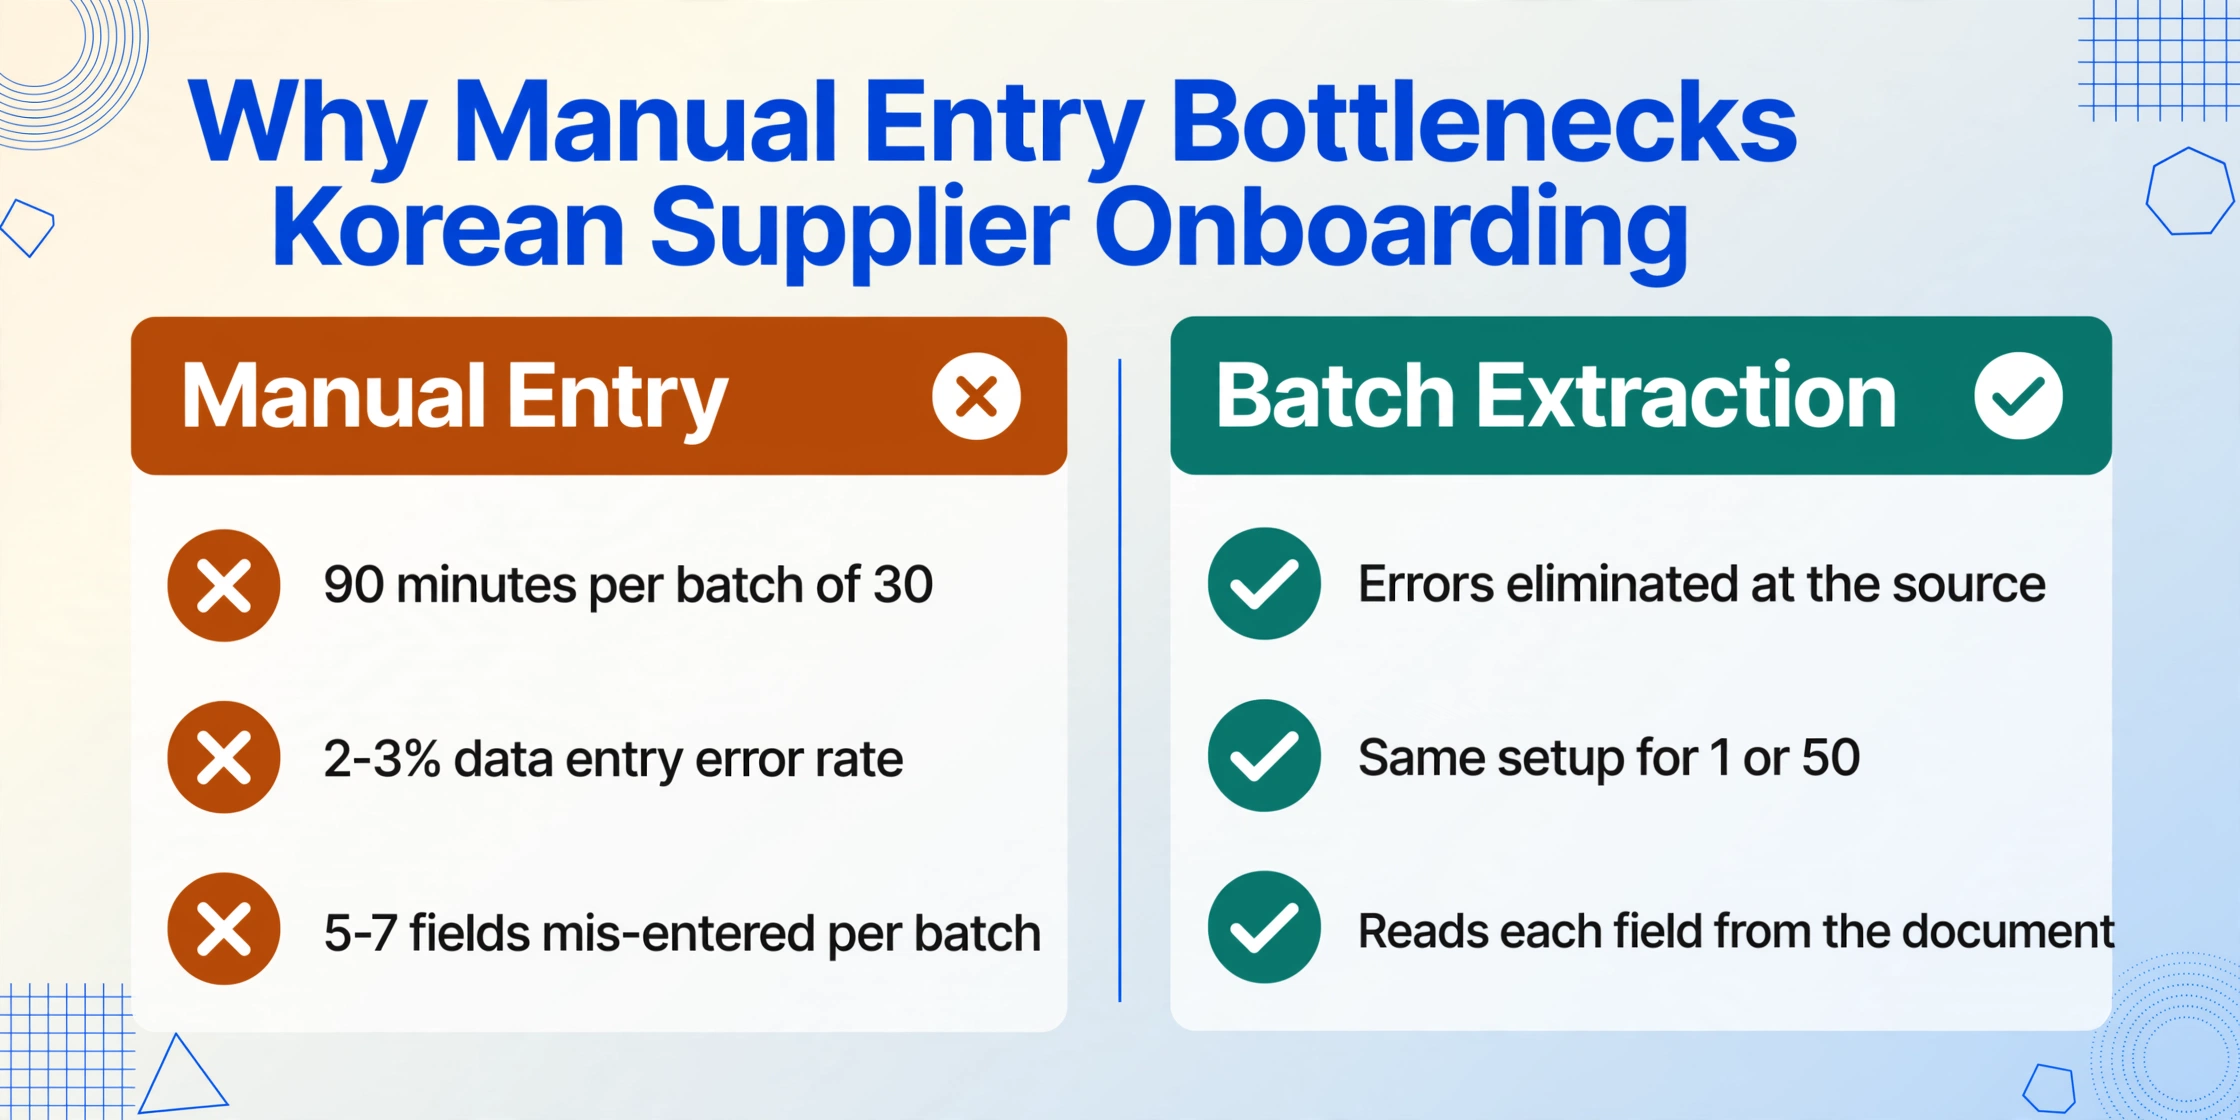
Prenons une entreprise de taille moyenne qui intègre 30 nouveaux fournisseurs coréens par trimestre. Chaque 사업자등록증 contient huit champs clés. Cela représente 240 points de données par trimestre — et en réalité, chaque certificat nécessite plus de huit champs car l'équipe conformité enregistre également la date de soumission, le réviseur, le statut de vérification et la date d'expiration du document. La saisie manuelle à environ trois minutes par certificat signifie 90 minutes par lot de 30 certificats si tout se passe bien. En pratique, cela prend plus de temps : le saisisseur doit zoomer sur une photo de smartphone pour lire un numéro d'enregistrement flou, retaper l'adresse à partir d'un scan incliné, ou vérifier si « 일반과세자 » signifie que le fournisseur peut émettre des factures TVA (c'est le cas, mais l'agent de conformité doit quand même le confirmer par rapport à la politique interne).
Ajoutez un taux d'erreur de saisie de 2 à 3 % — un chiffre mal lu dans un BRN de dix caractères envoie un paiement à la mauvaise entité — et le coût de la saisie manuelle se multiplie. Pour une équipe conformité traitant 30 certificats par trimestre, cela signifie environ 5 à 7 champs mal saisis par lot. Chaque erreur nécessite un e-mail de suivi ou un appel téléphonique au fournisseur, retardant le cycle d'intégration de plusieurs jours ou semaines.
L'extraction par lots élimine ces erreurs à la source. L'IA lit chaque champ directement à partir de l'image du document et le sort sous forme de texte structuré. Le profil d'erreur passe des fautes de transcription (mauvais chiffre, nom mal orthographié, adresse inversée) aux cas limites d'interprétation (texte pâle sur une photocopie, tampon partiellement masqué) — qui sont beaucoup moins fréquents et beaucoup plus faciles à repérer lors de la révision.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Comment l'extraction sémantique traite les certificats coréens
Les certificats d'enregistrement d'entreprise coréens présentent trois difficultés que les outils OCR traditionnels gèrent mal et que l'extraction sémantique résout directement.
Défi 1 : Interférence des tampons. Le 사업자등록증 comporte plusieurs tampons officiels (직인) du bureau de impôt émetteur. Ces tampons chevauchent souvent les champs de texte imprimés — le sceau du chef du bureau des impôts peut partiellement recouvrir la date d'émission ou la classification fiscale. L'OCR traditionnel lit l'encre du tampon comme du bruit et produit des caractères déformés. Un modèle de vision lit le document de manière holistique : il comprend qu'un overlay rouge circulaire est un tampon, l'ignore pour la reconnaissance de texte et lit correctement les caractères sous-jacents. Cette distinction est importante car les tampons sont présents sur presque tous les 사업자등록증 — ils font partie du document, ce n'est pas une anomalie.
Défi 2 : Mélange de coréen, de caractères chinois et d'anglais. Les certificats coréens utilisent le Hangul (한글) pour la plupart des étiquettes et valeurs de champs, le hanja (한자, caractères chinois) dans les noms d'entreprises et les adresses, et l'anglais dans certains certificats orientés export. Un outil optimisé pour un système d'écriture se dégrade sur les autres. Le modèle de vision utilisé dans l'extraction sémantique traite les trois simultanément dans la même page de document — il ne bascule pas entre différents moteurs OCR pour différents scripts. Un fournisseur dont le nom d'entreprise contient du hanja (par exemple, 株式会社 dans une ancienne société de commerce) est lu correctement aux côtés des champs encodés en Hangul.
Défi 3 : Variation d'angle, de luminosité et de format. Les 사업자등록증 réels arrivent sous toutes les formes : un scan à plat, une photo de bureau prise avec un téléphone professionnel, une télécopie d'une télécopie, une capture d'écran du portail HomeTax. L'OCR basé sur des modèles exige que le document soit positionné dans une zone prédéfinie. Une photo prise avec un angle de 20 degrés déplace chaque champ hors de sa zone de délimitation attendue. L'extraction sémantique ne dépend pas de la position du champ — elle trouve la valeur en lisant l'étiquette à côté, quel que soit l'endroit où cette étiquette se trouve sur la page. Cette indépendance du format est ce qui rend le traitement par lots possible sans étape de configuration par fournisseur.
L'implication pratique : un lot de 30 certificats fournisseurs — mélangeant des PDF scannés, des photos de smartphone et des captures d'écran HomeTax — peut être téléchargé, extrait et exporté en une seule passe, sans organiser, renommer ou normaliser aucun fichier. La qualité d'extraction ne se dégrade pas entre le PDF propre et la photo inclinée.
FAQ
Puis-je extraire des données d'un certificat d'enregistrement d'entreprise qui est uniquement en coréen, sans anglais ?
Oui. L'IA lit le hangul aussi naturellement qu'elle lit l'anglais ou le hanja — ce n'est pas un moteur OCR séparé avec le coréen comme module complémentaire. Les noms de colonnes dans votre modèle d'extraction peuvent être en anglais (par exemple, « Business Name »), et l'IA localisera l'étiquette de champ coréenne correspondante (« 상호 ») et en extraira la valeur. La feuille de calcul de sortie contiendra les valeurs de texte coréen extraites sous vos en-têtes de colonnes en anglais. Pour les certificats bilingues qui incluent à la fois du texte coréen et anglais sur le même document, l'IA lit la langue utilisée par l'étiquette du champ.
Et si le certificat du fournisseur est une photo prise en angle ou dans de mauvaises conditions d'éclairage ?
L'extraction sémantique gère mieux les photos inclinées et l'éclairage inégal que l'OCR traditionnel, car elle ne dépend pas d'un positionnement de face. Le modèle de vision interprète le document comme le ferait un humain — il identifie les étiquettes de champ et les valeurs par leur contenu et leur disposition relative, sans les attendre à des coordonnées fixes. Les photos floues ou à très basse résolution peuvent réduire la précision, mais la situation la plus courante (une photo de bureau prise avec un smartphone dans un éclairage de bureau standard) produit une extraction fiable.
L'outil d'extraction valide-t-il que le BRN est un enregistrement réel et actif ?
Non — l'outil extrait le BRN tel qu'il est imprimé sur le certificat, mais il n'interroge pas la base de données du NTS pour confirmer que le numéro est actuellement actif ou que l'entreprise n'a pas fermé depuis. Le BRN extrait peut être vérifié via le portail HomeTax du NTS (www.hometax.go.kr) ou via l'API du portail coréen des données publiques (data.go.kr) pour validation. L'étape d'extraction produit les données structurées ; une étape de vérification distincte confirme leur validité actuelle. Cette séparation entre extraction et vérification est une pratique standard dans les flux de travail KYC, où les données extraites sont l'entrée, et non la sortie, du processus de vérification.
Que se passe-t-il si un champ est manquant sur le certificat ?
Si un champ spécifique n'apparaît pas sur le document (par exemple, un certificat réédité peut ne pas afficher la date de début d'activité d'origine), la cellule de colonne correspondante sera laissée vide. L'extraction n'invente pas de valeurs — elle ne génère que ce qu'elle trouve sur la page. Ce comportement est cohérent sur tous les documents du lot, ce qui facilite la détection des champs manquants dans la feuille de calcul exportée et le suivi avec le fournisseur concerné.
Puis-je traiter par lots des certificats provenant à la fois d'entreprises individuelles et de grandes sociétés ?
Oui. Le format 사업자등록증 est standardisé par le NTS — la même structure de document s'applique à un indépendant solo et à une filiale de Samsung. Les deux produisent un BRN, un nom d'entreprise, un nom de représentant, une adresse et une classification fiscale. La seule différence réside dans le code de type d'entité dans les deux chiffres du milieu du BRN (01–79 pour les entreprises individuelles, 81/86–88 pour les sociétés), que l'IA extrait dans le cadre du champ BRN. Un lot unique avec des types d'entités mixtes est traité en une seule passe.
Comment cela se compare-t-il à l'utilisation de Naver Clova OCR pour la même tâche ?
Naver Clova OCR lit le texte coréen avec une grande précision (97–99 %) et coûte environ ₩50 par page. La différence cruciale réside dans ce qui se passe après la reconnaissance du texte : Clova OCR renvoie des chaînes de texte brutes avec des données de position, mais il ne comprend pas quelle chaîne correspond au nom de l'entreprise par rapport au nom du représentant ou à l'adresse. Pour extraire des champs structurés, vous devriez soit écrire une logique d'analyse personnalisée par mise en page de certificat, soit configurer un modèle par format de document — ce qui va à l'encontre du traitement par lots lorsque chaque certificat de fournisseur peut présenter des différences subtiles de mise en page. L'extraction sémantique par IA renvoie des données déjà structurées mappées à vos noms de colonnes, sans nécessiter d'analyse post-extraction. La comparaison des coûts par page dépend du volume — l'analyse des tarifs d'extraction de documents coréens détaille les points d'équilibre entre les outils API par page et l'extraction à tarif forfaitaire selon différents volumes mensuels.
Quelles colonnes dois-je inclure si je ne sais pas encore quelles données me seront nécessaires ?
Commencez par les huit champs standard listés dans cet article : BRN, nom de l'entreprise, nom du représentant, date de début, adresse de l'entreprise, code d'activité, classification fiscale et motif d'émission. Ces champs couvrent les exigences minimales pour le KYC des fournisseurs en vertu des réglementations coréennes AML/CFT. Si votre cadre de conformité exige plus de détails — comme les informations sur le co-représentant ou une sous-classification spécifique du type d'entreprise — vous pouvez ajouter ces colonnes au modèle d'extraction et l'IA les recherchera sur le document. La définition des colonnes n'est pas fixe ; vous pouvez l'ajuster entre les lots à mesure que vos exigences KYC évoluent.