Cómo extraer datos del registro mercantil coreano
a Excel para el KYC de proveedores
Todo proceso de incorporación de proveedores en Corea comienza con el mismo documento: el certificado de registro mercantil (사업자등록증). Los bancos lo exigen antes de abrir una cuenta corporativa. Los portales de contratación pública lo solicitan como parte del paquete de licitación. Las plataformas de comercio electrónico lo piden antes de aprobar una cuenta de vendedor. Y en la mayoría de los equipos B2B, los datos de estos certificados se copian en una hoja de cálculo campo por campo — nombre del proveedor, número de registro, dirección, clasificación fiscal — por alguien que coteja manualmente un PDF escaneado o una foto del teléfono contra una plantilla de columnas. El certificado en sí está estandarizado por ley. El proceso de convertir sus datos en un registro utilizable no debería ser tan lento.
Conclusiones clave
- 30 certificados de proveedores requieren 90 minutos de escritura manual — con 5 a 7 campos mal introducidos por lote que exigen llamadas y correos de seguimiento.
- Un solo dígito incorrecto en el BRN puede desviar un pago a la entidad equivocada — el costo real de la entrada manual no es el tiempo de escritura, sino el riesgo de cumplimiento.
- Defina sus 8 columnas KYC una sola vez — el costo marginal de añadir el certificado número 50 es casi nulo, independientemente del formato.
El Certificado de Registro de Negocio (사업자등록증) en el KYC de Proveedores: Qué Es y Por Qué Necesita Sus Datos
El certificado de registro de negocio coreano es el documento de identidad fundamental para cualquier entidad comercial que opere en Corea del Sur. Emitido por el Servicio Nacional de Impuestos (NTS, 국세청) conforme al Artículo 8 de la Ley del Impuesto al Valor Agregado (부가가치세법 제8조) y al Artículo 168 de la Ley del Impuesto sobre la Renta (소득세법 제168조), toda empresa — ya sea un propietario único o una corporación multinacional — debe registrarse y obtener este certificado dentro de los 20 días posteriores al inicio de operaciones. La fuerza legal del documento va más allá de la administración tributaria: según la Ley de Nombre Real Financiero de Corea (금융실명법, Ley de Transacciones Financieras con Nombre Real y Confidencialidad), el 사업자등록증 sirve como prueba principal de identidad comercial para todas las transacciones financieras, operaciones bancarias y contratación comercial.
En un contexto de KYC de proveedores, el certificado le indica ocho datos sobre un posible vendedor:
| Campo (inglés) | Campo (coreano) | Por qué es importante en el KYC |
|---|---|---|
| Número de Registro de Negocio | 사업자등록번호 | El ID fiscal principal del proveedor — formato XXX-XX-XXXXX. También llamado BRN. Requerido para todas las facturas fiscales, contratos y verificación legal. |
| Nombre Comercial | 상호 | El nombre operativo de la empresa. Debe coincidir con el nombre en las cuentas bancarias y las facturas emitidas. |
| Nombre del Representante | 성명 (대표자) | El representante legal — equivalente a CEO o director general. Esencial para la verificación de firmas. |
| Fecha de Inicio de Operaciones | 개업연월일 | Cuándo comenzó oficialmente la empresa. Se usa para evaluar la madurez del negocio y validar la actualidad del registro. |
| Dirección del Negocio | 사업장소재지 | Ubicación registrada del negocio. Se contrasta con la verificación física de dirección en la debida diligencia ampliada (EDD). |
| Tipo de Negocio / Código de Industria | 사업의종류 (업종코드) | Clasificación industrial (up-tae y jong-mok). Confirma que el proveedor opera en el sector que declara. |
| Clasificación Fiscal | 과세유형 | Contribuyente general (일반과세자), contribuyente simplificado (간이과세자) o exento de impuestos (면세사업자). Determina si el proveedor puede emitir facturas de IVA. |
| Motivo de Emisión | 교부사유 | Por qué se emitió el certificado — registro original, reemisión o modificación. |
Estos ocho campos son el conjunto mínimo de datos que cualquier equipo de KYC necesita para verificar a un proveedor coreano. Sin embargo, en la práctica llegan en formatos variados: un escaneo en PDF adjunto a un correo electrónico, una foto tomada con un teléfono inteligente de un certificado plastificado, una copia por fax o una captura de pantalla del portal HomeTax (홈택스) del NTS. Ninguno de estos formatos está estructurado para el ingreso en bases de datos — y ahí es donde comienza el problema de la extracción.
Paso a paso: extraer datos del certificado de registro empresarial (사업자등록증) a Excel
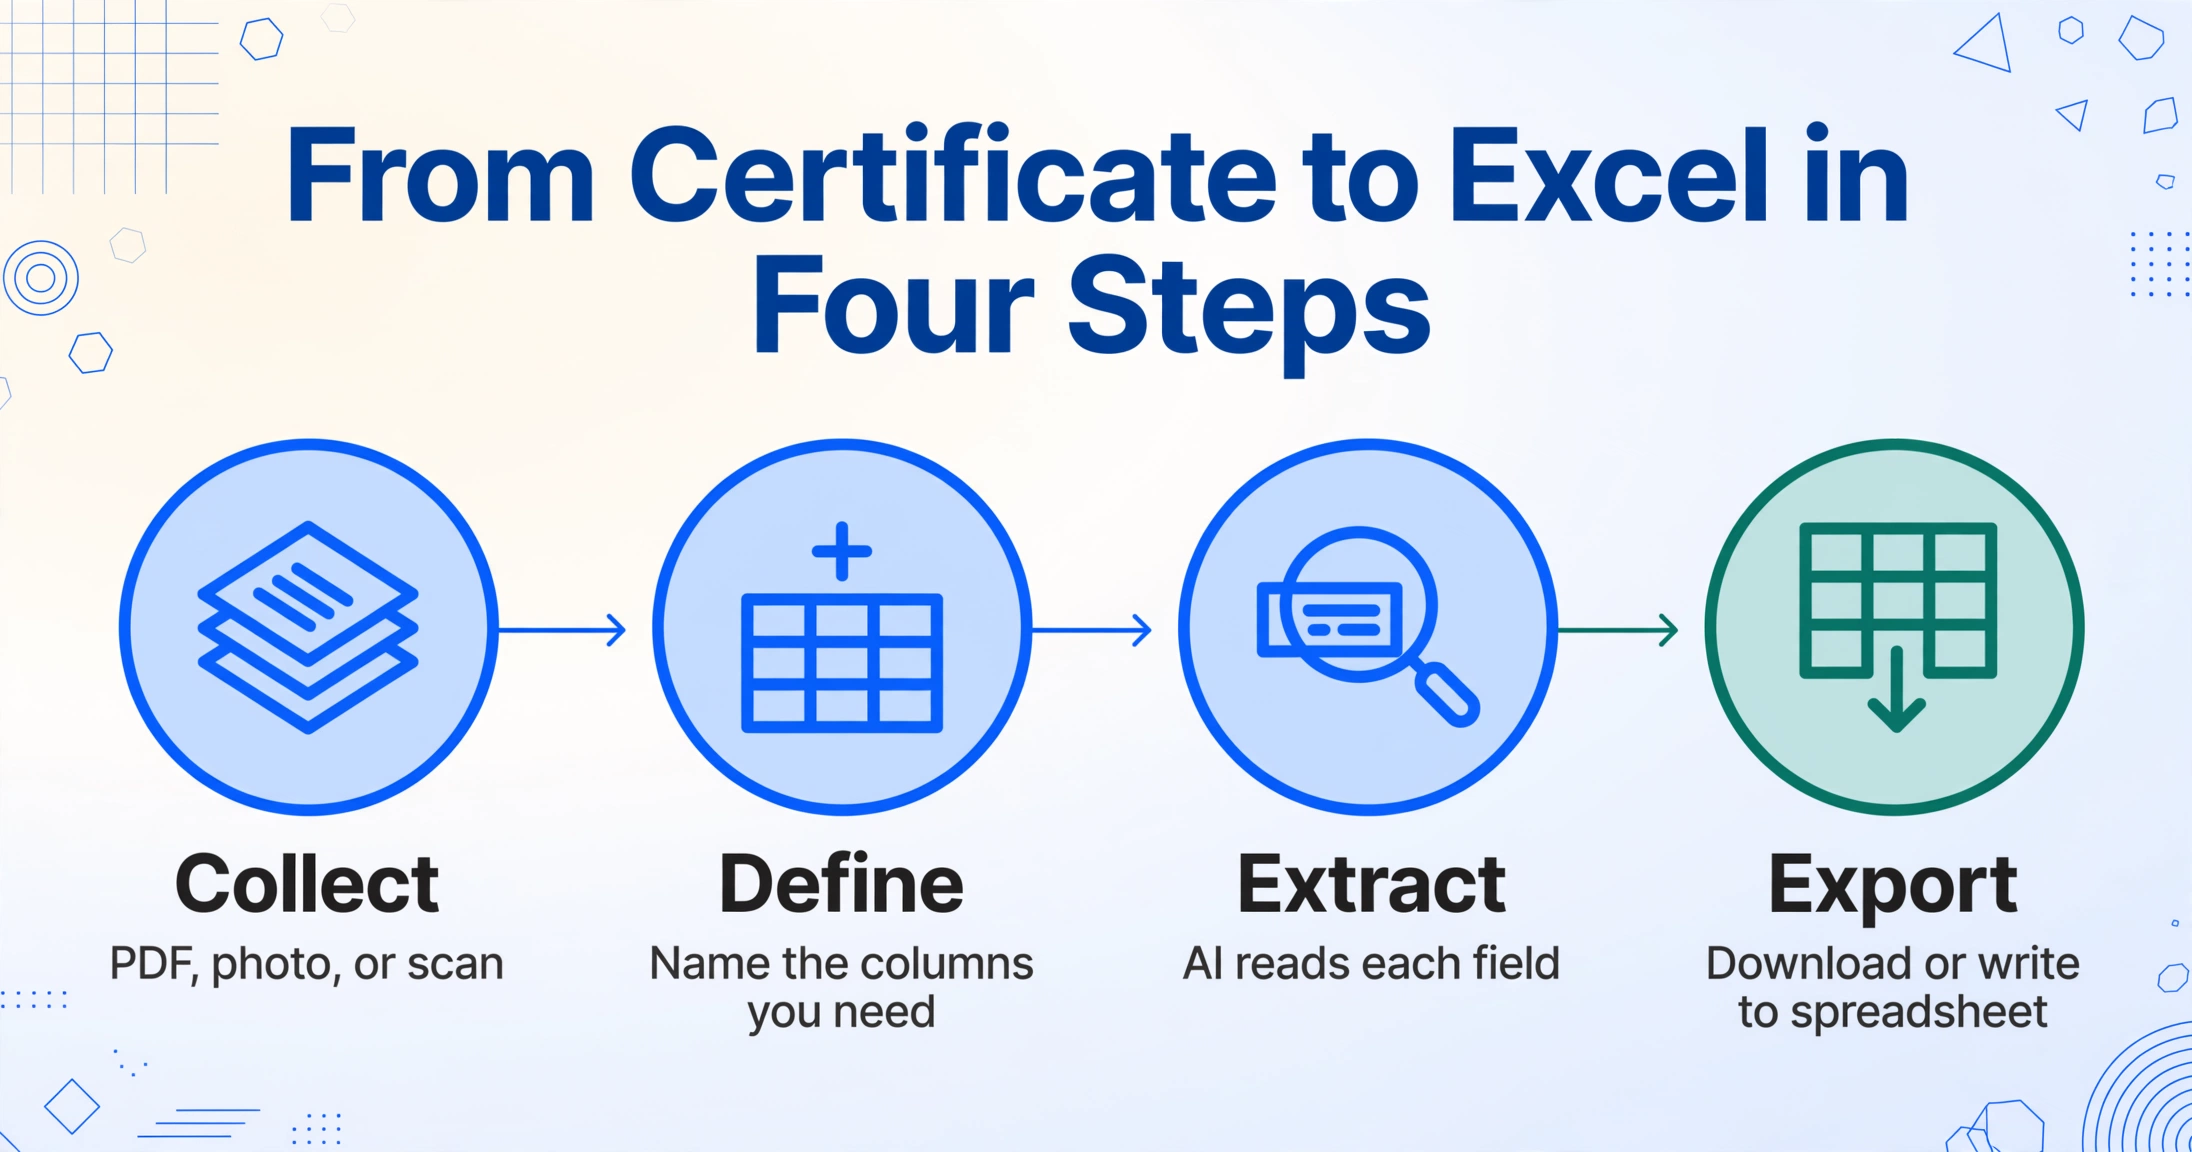
El proceso de convertir un certificado de registro empresarial coreano en una fila estructurada de hoja de cálculo consta de cuatro pasos. El tiempo de configuración es el mismo tanto si procesa un certificado como cincuenta, que es precisamente el objetivo de usar la extracción en lugar de la escritura manual.
(PDF, foto, escaneo)
que necesita
lee cada campo
en la hoja de cálculo
Paso 1: Recopilar los certificados
Reúna todos los documentos de 사업자등록증 recibidos, ya sea que hayan llegado como archivos adjuntos de correo electrónico (PDF o imagen), fotos de teléfonos inteligentes tomadas por el personal de campo o copias escaneadas de un portal de proveedores. La herramienta acepta formatos JPG, PNG, PDF y WebP, por lo que no es necesario convertir ni normalizar archivos. Súbalos todos en un solo lote. Un lote de 50 certificados de proveedores tarda aproximadamente el mismo tiempo de carga que uno solo: entre 30 y 60 segundos para transferir los archivos, según su tamaño.
Paso 2: Definir las columnas de salida
Aquí es donde la extracción semántica se diferencia de la OCR basada en plantillas. En lugar de dibujar rectángulos en una plantilla de documento (lo que falla cuando el certificado del siguiente proveedor tiene un diseño diferente), simplemente nombre los campos que desea que la IA encuentre. Escriba los nombres de las columnas que coinciden con su hoja de cálculo KYC: Business Registration Number, Business Name, Representative, Business Address, Tax Classification, Industry Code, Start Date. Los nombres de columna que ingrese se convierten en los encabezados de su tabla final. No se necesita configuración de plantilla por proveedor: la IA lee cada certificado y localiza el campo correspondiente mediante comprensión semántica, no por posición de coordenadas.
Este enfoque, llamado Extracción de Columnas Personalizadas, significa que define la estructura de salida una sola vez y cada certificado — sin importar quién lo emitió, qué cámara tomó la foto o si el certificado es un escaneo o una captura de pantalla — se asigna a las mismas columnas. Un proveedor que envía una foto tomada en ángulo produce la misma fila estructurada que uno que sube un PDF limpio del portal de NTS. El certificado es un miembro de la familia de documentos fiscales coreanos: la guía de procesamiento de documentos fiscales coreanos muestra cómo el mismo enfoque de columnas prioritarias lee facturas fiscales, recibos de efectivo y notas de entrega junto con él.
Paso 3: Extracción con IA
Una vez que los archivos se cargan y las columnas se definen, el motor de extracción procesa todos los certificados del lote simultáneamente. Cada documento es analizado por un modelo de lenguaje de visión que identifica las etiquetas de los campos, lee los valores asociados y los asigna a las columnas solicitadas. El tiempo de procesamiento es de 5 a 10 segundos por página, y el lote se completa una vez que todos los archivos han sido procesados, normalmente en unos pocos minutos para volúmenes típicos de proveedores.
Paso 4: Exportar a Excel o CSV
Los resultados se entregan en un único archivo Excel (XLSX) o CSV. Cada certificado se convierte en una fila; cada columna definida se convierte en una columna. El archivo exportado está listo para importarse en su base de datos KYC, ERP (como Douzone, Ecount o SAP) o sistema de gestión de proveedores. No se requiere reformateo manual: la estructura de datos coincide con los nombres de columna que definió en el Paso 2, y el formato de archivo es CSV o XLSX estándar, aceptado por todas las plataformas contables coreanas.
El principio clave: usted define la estructura de salida una sola vez. La IA se adapta automáticamente a cada formato de certificado. Esto es lo que hace viable la extracción por lotes para el KYC de proveedores: el costo marginal de añadir al proveedor número 50 a la hoja de cálculo es casi cero.
8 Campos Clave que su Hoja de Cálculo KYC Necesita — y Cómo Leer el BRN
El Número de Registro de Negocio (사업자등록번호) en sí mismo codifica información útil que los equipos de KYC pueden usar para una evaluación rápida de proveedores sin consultar una base de datos separada. Comprender la estructura del número convierte un identificador de diez dígitos en una herramienta de verificación instantánea.
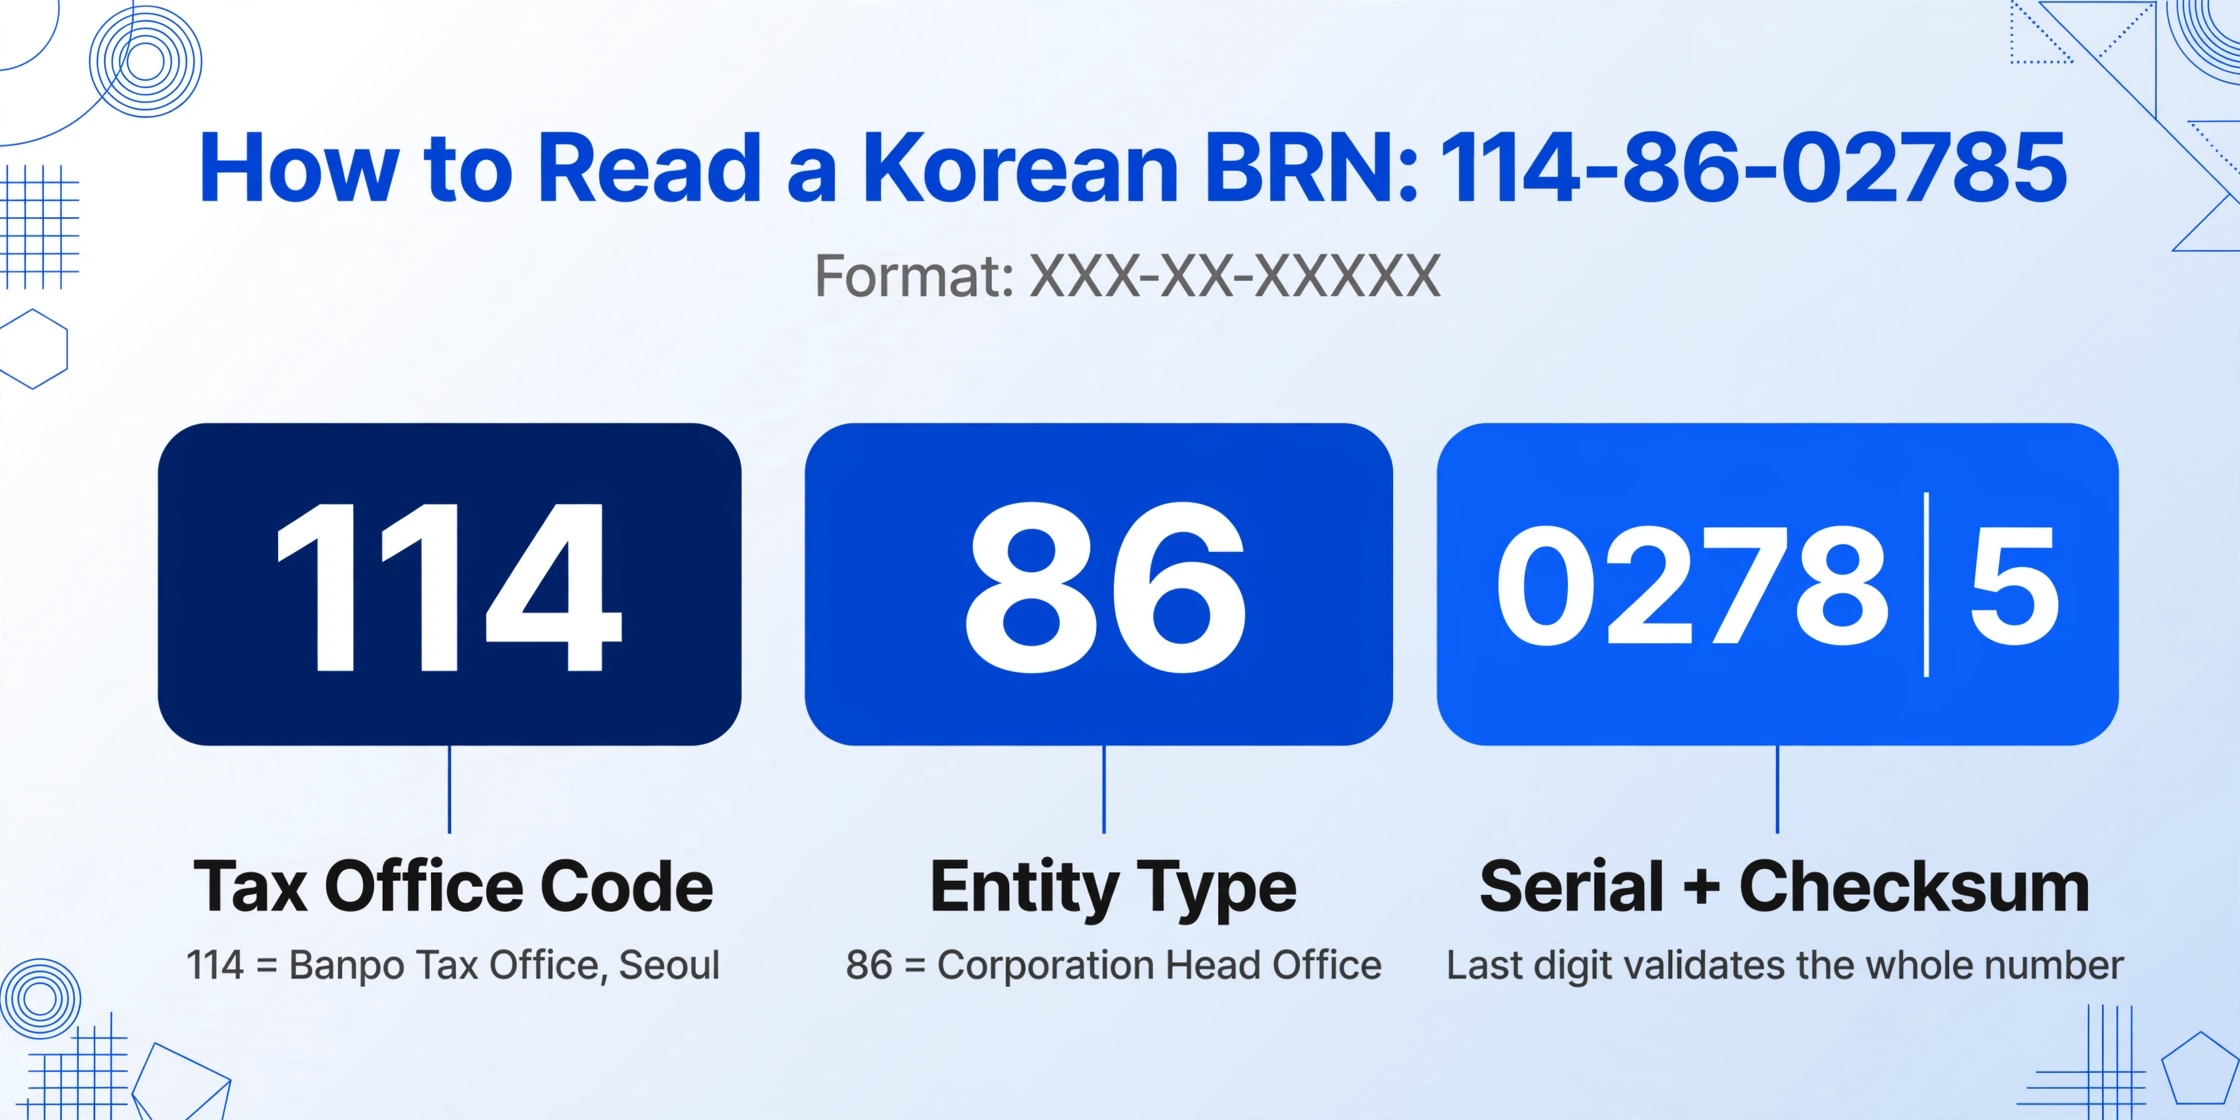
El formato del BRN XXX-XX-XXXXX se desglosa de la siguiente manera:
| Posición | Ejemplo | Significado |
|---|---|---|
| Primeros 3 dígitos | 114 | Código de oficina tributaria: identifica qué oficina tributaria de distrito (세무서) emitió el número. 114 = Oficina Tributaria de Banpo (Seúl). Cada una de las ~80 oficinas tributarias de Corea tiene un código único. |
| 2 dígitos centrales | 86 | Clasificador de tipo de entidad — la señal de verificación más útil. 01–79 = propietario único sujeto a IVA; 81, 86–88 = oficina central de corporación con fines de lucro; 85 = sucursal de corporación con fines de lucro; 82 = sin fines de lucro; 83 = entidad gubernamental; 84 = corporación extranjera; 89 = organización religiosa; 90–99 = propietario único exento de IVA. |
| Últimos 5 dígitos | 02785 | Número de serie (primeros 4) + dígito de verificación (último 1): el dígito de verificación valida matemáticamente todo el BRN, que es como HomeTax confirma que un número es válido sin tener que buscarlo. |
Con solo echar un vistazo a los dos dígitos centrales, se puede saber si un proveedor es un trabajador autónomo, la sede de una corporación, una sucursal, una entidad sin fines de lucro o una entidad extranjera, sin necesidad de consultar ninguna base de datos. Este tipo de señal agiliza el triaje inicial de KYC, especialmente al procesar grandes lotes de solicitudes de proveedores donde la mayoría supera el filtro inicial y solo las excepciones requieren escalado.
El conjunto completo de ocho campos — BRN, nombre comercial, representante, fecha de inicio, dirección, código de industria, clasificación fiscal y motivo de emisión — le brinda todo lo necesario para completar el registro maestro del proveedor. La comparación de herramientas gubernamentales, ERP domésticos y herramientas de IA con precio en dólares muestra que las herramientas disponibles en el mercado doméstico de Corea requieren una suscripción a ERP o cobran por página; ninguno de los dos modelos de precios está optimizado para el caso de uso de KYC por lotes, donde se necesita procesar un volumen irregular de certificados — a veces 10 en un mes, a veces 200 durante un ciclo de actualización de proveedores.
Por qué la Entrada Manual es el Verdadero Cuello de Botella en la Incorporación de Proveedores Coreanos
El costo de la entrada manual de datos para el KYC de proveedores no es solo el tiempo dedicado a escribir. Es la demora en la incorporación, los errores que se cuelan y el riesgo de cumplimiento de actuar con información incorrecta del proveedor.
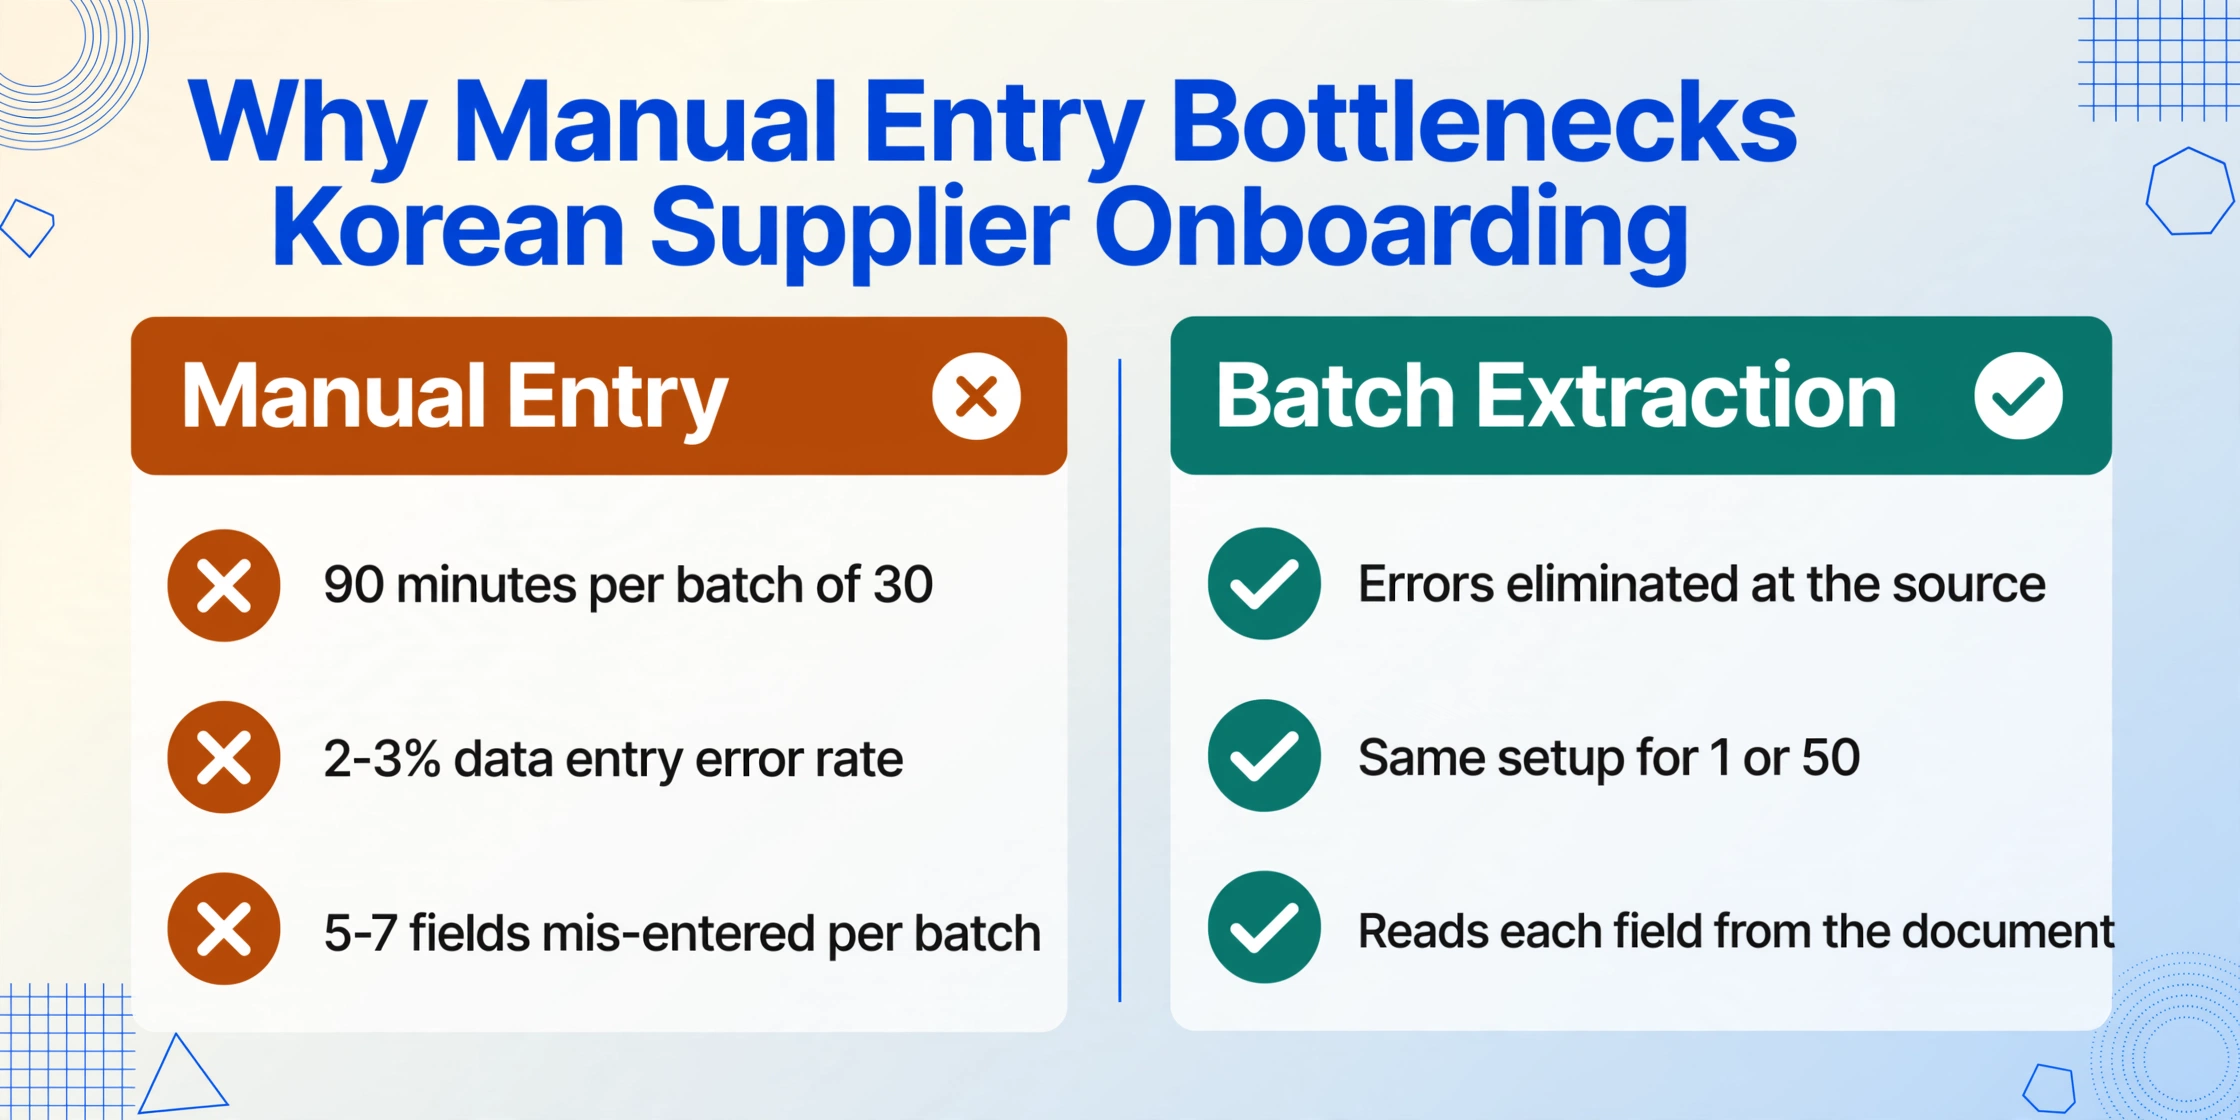
Considere una empresa mediana que incorpora 30 nuevos proveedores coreanos por trimestre. Cada 사업자등록증 contiene ocho campos clave. Eso son 240 puntos de datos por trimestre — y, en realidad, cada certificado requiere más de ocho campos porque el equipo de cumplimiento también registra la fecha de presentación, el revisor, el estado de verificación y la fecha de vencimiento del documento. La entrada manual a aproximadamente tres minutos por certificado significa 90 minutos por lote de 30 certificados si todo sale bien. En la práctica, lleva más tiempo: el transcriptor tiene que hacer zoom en una foto de teléfono inteligente para leer un número de registro borroso, volver a escribir la dirección desde un escaneo inclinado, o verificar si "일반과세자" significa que el proveedor puede emitir facturas de IVA (sí puede, pero el oficial de cumplimiento aún debe confirmarlo según la política interna).
Agregue una tasa de error de entrada de datos del 2–3% — un dígito mal leído en un BRN de diez caracteres envía un pago a la entidad equivocada — y el costo de la entrada manual se multiplica. Para un equipo de cumplimiento que procesa 30 certificados por trimestre, eso significa aproximadamente 5–7 campos mal ingresados por lote. Cada error requiere un correo de seguimiento o una llamada al proveedor, retrasando el ciclo de incorporación por días o semanas.
La extracción por lotes elimina estos errores de raíz. La IA lee cada campo directamente de la imagen del documento y lo genera como texto estructurado. El perfil de error cambia de errores de transcripción (dígito incorrecto, nombre mal escrito, dirección transpuesta) a casos límite de interpretación (texto tenue en una fotocopia, un sello parcialmente oscurecido) — que son mucho menos frecuentes y mucho más fáciles de detectar durante la revisión.
Los archivos se procesan de forma segura y no se almacenan.
Cómo maneja la extracción semántica los certificados coreanos
Los certificados de registro empresarial coreanos presentan tres desafíos que las herramientas OCR tradicionales manejan mal y que la extracción semántica resuelve directamente.
Desafío 1: Interferencia de sellos. El 사업자등록증 lleva múltiples sellos oficiales (직인) de la oficina tributaria emisora. Estos sellos a menudo se superponen con los campos de texto impresos: el sello del jefe de la oficina tributaria puede cubrir parcialmente la fecha de emisión o la clasificación fiscal. El OCR tradicional lee la tinta sobre el texto como ruido y genera caracteres ilegibles. Un modelo de lenguaje visual lee el documento de forma holística: entiende que una superposición circular roja es un sello, lo ignora para el reconocimiento de texto y lee correctamente los caracteres subyacentes. Esta distinción importa porque los sellos están presentes en casi todos los 사업자등록증 — son una característica del documento, no una anomalía.
Desafío 2: Mezcla de coreano, caracteres chinos e inglés. Los certificados coreanos usan Hangul (한글) para la mayoría de las etiquetas y valores de los campos, hanja (한자, caracteres chinos) en nombres comerciales y direcciones, e inglés en algunos certificados orientados a la exportación. Una herramienta optimizada para un sistema de escritura se degrada con los demás. El modelo de visión utilizado en la extracción semántica procesa los tres simultáneamente en la misma página del documento: no cambia entre motores OCR para diferentes escrituras. Un proveedor cuyo nombre comercial contiene hanja (p. ej., 株式会社 en una empresa comercial antigua) se lee correctamente junto con los campos codificados en Hangul.
Desafío 3: Variación de ángulo, iluminación y formato. Los 사업자등록증 del mundo real llegan en todas las formas: un escaneo plano, una foto de escritorio tomada con un teléfono de oficina, un fax de un fax, una captura de pantalla del portal HomeTax. El OCR basado en plantillas requiere que el documento esté posicionado dentro de una zona predefinida. Una foto tomada en un ángulo de 20 grados desplaza cada campo fuera de su cuadro delimitador esperado. La extracción semántica no depende de la posición del campo: encuentra el valor leyendo la etiqueta junto a él, sin importar dónde se encuentre esa etiqueta en la página. Esta independencia del formato es lo que hace viable el procesamiento por lotes sin un paso de configuración por proveedor.
La implicación práctica: un lote de 30 certificados de proveedores —que mezcla PDF escaneados, fotos de teléfonos inteligentes y capturas de pantalla de HomeTax— puede cargarse, extraerse y exportarse en una sola pasada sin organizar, renombrar ni normalizar ningún archivo. La calidad de extracción no se degrada entre la carga del PDF limpio y la foto en ángulo.
Preguntas frecuentes
¿Puedo extraer datos de un Certificado de Registro de Negocio que solo tiene coreano, sin inglés?
Sí. La IA lee el Hangul con la misma naturalidad que el inglés o el hanja: no es un motor OCR separado con el coreano como complemento. Los nombres de columna en su plantilla de extracción pueden estar en inglés (p. ej., "Business Name"), y la IA localizará la etiqueta de campo coreana correspondiente ("상호") y extraerá su valor. La hoja de cálculo de salida contendrá los valores de texto coreano extraídos bajo sus encabezados de columna en inglés. Para certificados bilingües que incluyen texto en coreano e inglés en el mismo documento, la IA lee el idioma que use la etiqueta del campo.
¿Qué pasa si el certificado del proveedor es una foto tomada en ángulo o con poca iluminación?
La extracción semántica maneja fotos en ángulo e iluminación desigual mejor que el OCR tradicional porque no depende de un posicionamiento frontal. El modelo de visión interpreta el documento como lo haría una persona: identifica las etiquetas y valores de campo por su contenido y disposición relativa, no esperándolos en coordenadas fijas. Las fotos borrosas o de muy baja resolución pueden reducir la precisión, pero la situación más común (una foto de escritorio tomada con un teléfono inteligente con iluminación de oficina estándar) produce una extracción fiable.
¿La herramienta de extracción valida que el BRN sea un registro real y activo?
No: la herramienta extrae el BRN tal como aparece impreso en el certificado, pero no consulta la base de datos del NTS para confirmar que el número esté actualmente activo o que la empresa no haya cerrado desde entonces. El BRN extraído puede verificarse en el portal HomeTax del NTS (www.hometax.go.kr) o mediante la API del Portal de Datos Públicos de Corea (data.go.kr). El paso de extracción produce los datos estructurados; un paso de verificación independiente confirma su validez actual. Esta separación entre extracción y verificación es una práctica estándar en los flujos de trabajo KYC, donde los datos extraídos son la entrada, no la salida, del proceso de verificación.
¿Qué ocurre si falta un campo en el certificado?
Si un campo específico no aparece en el documento (por ejemplo, un certificado reemitido puede no mostrar la fecha original de inicio de actividad), la celda correspondiente de la columna quedará vacía. La extracción no inventa valores: solo genera lo que encuentra en la página. Este comportamiento es coherente en todos los documentos del lote, lo que facilita detectar campos faltantes en la hoja de cálculo exportada y hacer el seguimiento con el proveedor correspondiente.
¿Puedo procesar por lotes certificados de autónomos individuales y grandes corporaciones a la vez?
Sí. El formato del 사업자등록증 está estandarizado por el NTS: la misma estructura documental aplica tanto a un freelancer independiente como a una filial de Samsung. Ambos generan un BRN, un nombre comercial, un nombre de representante, una dirección y una clasificación fiscal. La única diferencia es el código de tipo de entidad en los dos dígitos centrales del BRN (01–79 para autónomos, 81/86–88 para corporaciones), que la IA extrae como parte del campo BRN. Un solo lote con tipos de entidad mixtos se procesa en una sola pasada.
¿Cómo se compara esto con usar Naver Clova OCR para la misma tarea?
Naver Clova OCR lee texto coreano con alta precisión (97–99 %) y cuesta aproximadamente ₩50 por página. La diferencia clave está en lo que ocurre después del reconocimiento de texto: Clova OCR devuelve cadenas de texto sin procesar con datos de posición, pero no entiende qué cadena es el nombre comercial, cuál el nombre del representante y cuál la dirección. Para extraer campos estructurados, tendría que escribir lógica de análisis personalizada por diseño de certificado o configurar una plantilla por formato de documento, lo que anula el propósito del procesamiento por lotes cuando cada certificado de proveedor puede tener diferencias sutiles de diseño. La extracción semántica con IA devuelve datos ya estructurados y asignados a sus nombres de columna, sin necesidad de análisis posterior a la extracción. La comparación de coste por página depende del volumen: el análisis de precios de extracción de documentos coreanos desglosa los puntos de equilibrio entre las herramientas de pago por página y la extracción a tarifa plana en distintos volúmenes mensuales.
¿Qué columnas debo incluir si aún no sé qué datos necesito?
Comience con los ocho campos estándar enumerados en este artículo: BRN, nombre de la empresa, nombre del representante, fecha de inicio, dirección comercial, código de industria, clasificación fiscal y motivo de emisión. Estos cubren los requisitos mínimos para el KYC de proveedores según las regulaciones AML/CFT de Corea. Si su marco de cumplimiento requiere más detalle — como información de co-representante o una subclasificación específica del tipo de negocio — puede agregar esas columnas a la plantilla de extracción y la IA las buscará en el documento. La definición de la columna no es fija; puede ajustarla entre lotes a medida que evolucionen sus requisitos de KYC.