Koreanische Unternehmensregistrierungsdaten extrahieren
nach Excel für das Lieferanten-KYC
Jeder Lieferanten-Onboarding-Prozess in Korea beginnt mit demselben Dokument: der Unternehmensregistrierungsbescheinigung (사업자등록증). Banken verlangen sie vor der Eröffnung eines Firmenkontos. Öffentliche Beschaffungsportale fordern sie als Teil des Angebotspakets. E-Commerce-Plattformen verlangen sie vor der Freischaltung eines Verkäuferkontos. Und in den meisten B2B-Teams werden die Daten dieser Bescheinigungen Feld für Feld in eine Tabelle übertragen – Lieferantenname, Registrierungsnummer, Adresse, Steuerklassifizierung – von jemandem, der ein gescanntes PDF oder ein Smartphone-Foto manuell mit einer Spaltenvorlage abgleicht. Die Bescheinigung selbst ist gesetzlich standardisiert. Der Prozess, ihre Daten in einen nutzbaren Datensatz zu überführen, sollte nicht so langsam sein.
Wichtigste Erkenntnisse
- 30 Lieferantenbescheinigungen erfordern 90 Minuten manuelles Abtippen – mit 5–7 falsch eingegebenen Feldern pro Stapel, die Folgeanrufe und E-Mails nach sich ziehen.
- Eine einzige falsche BRN-Ziffer kann eine Zahlung an die falsche Einheit leiten – die tatsächlichen Kosten der manuellen Eingabe sind nicht die Tippzeit, sondern das Compliance-Risiko.
- Definieren Sie Ihre 8 KYC-Spalten einmal – die Grenzkosten für die 50. Bescheinigung sind nahezu null, unabhängig vom Format.
Die Gewerbeanmeldung (사업자등록증) im Lieferanten-KYC: Was sie ist und warum Sie ihre Daten benötigen
Die koreanische Gewerbeanmeldung ist das grundlegende Identitätsdokument für jedes Unternehmen, das in Südkorea tätig ist. Ausgestellt vom National Tax Service (NTS, 국세청) gemäß Artikel 8 des Mehrwertsteuergesetzes (부가가치세법 제8조) und Artikel 168 des Einkommensteuergesetzes (소득세법 제168조), muss sich jedes Unternehmen – ob Einzelunternehmer oder multinationaler Konzern – innerhalb von 20 Tagen nach Aufnahme der Geschäftstätigkeit registrieren und diese Bescheinigung erhalten. Die rechtliche Wirkung des Dokuments geht über die Steuerverwaltung hinaus: Nach dem koreanischen Gesetz über reale Finanztransaktionen (금융실명법, Act on Real Name Financial Transactions and Confidentiality) dient die 사업자등록증 als primärer Nachweis der Geschäftsidentität für alle Finanztransaktionen, Bankgeschäfte und kommerziellen Verträge.
Im Lieferanten-KYC-Kontext gibt Ihnen die Bescheinigung acht Informationen über einen potenziellen Anbieter:
| Feld (Englisch) | Feld (Koreanisch) | Warum es im KYC wichtig ist |
|---|---|---|
| Business Registration Number | 사업자등록번호 | Die primäre Steuernummer des Lieferanten – Format XXX-XX-XXXXX. Auch BRN genannt. Erforderlich für alle Steuerrechnungen, Verträge und rechtliche Überprüfungen. |
| Business Name (Trade Name) | 상호 | Der Firmenname des Unternehmens. Muss mit dem Namen auf Bankkonten und ausgestellten Rechnungen übereinstimmen. |
| Representative Name | 성명 (대표자) | Der gesetzliche Vertreter – vergleichbar mit CEO oder Geschäftsführer. Unerlässlich für die Unterschriftsprüfung. |
| Business Start Date | 개업연월일 | Wann das Unternehmen offiziell gegründet wurde. Wird zur Bewertung der Unternehmensreife und zur Validierung der Registrierungsaktualität verwendet. |
| Business Address | 사업장소재지 | Registrierter Geschäftsstandort. Wird bei der erweiterten Sorgfaltspflicht (EDD) gegen die physische Adressverifizierung abgeglichen. |
| Business Type / Industry Code | 사업의종류 (업종코드) | Branchenklassifizierung (up-tae und jong-mok). Bestätigt, dass der Lieferant in der Branche tätig ist, die er angibt. |
| Tax Classification | 과세유형 | Allgemeiner Steuerpflichtiger (일반과세자), vereinfachter Steuerpflichtiger (간이과세자) oder steuerbefreit (면세사업자). Bestimmt, ob der Lieferant Mehrwertsteuerrechnungen ausstellen kann. |
| Issuance Reason | 교부사유 | Warum die Bescheinigung ausgestellt wurde – Erstregistrierung, Neuausstellung oder Änderung. |
Diese acht Felder sind der Mindestdatensatz, den jedes KYC-Team benötigt, um einen koreanischen Lieferanten zu verifizieren. In der Praxis kommen sie jedoch in unterschiedlichen Formaten an: ein PDF-Scan als E-Mail-Anhang, ein Smartphone-Foto einer laminierten Bescheinigung, eine Faxkopie oder ein Screenshot vom HomeTax-Portal (홈택스) des NTS. Keines dieser Formate ist für die Dateneingabe strukturiert – und genau hier beginnt das Extraktionsproblem.
Schritt für Schritt: Daten aus der Gewerbeanmeldung (사업자등록증) in Excel extrahieren
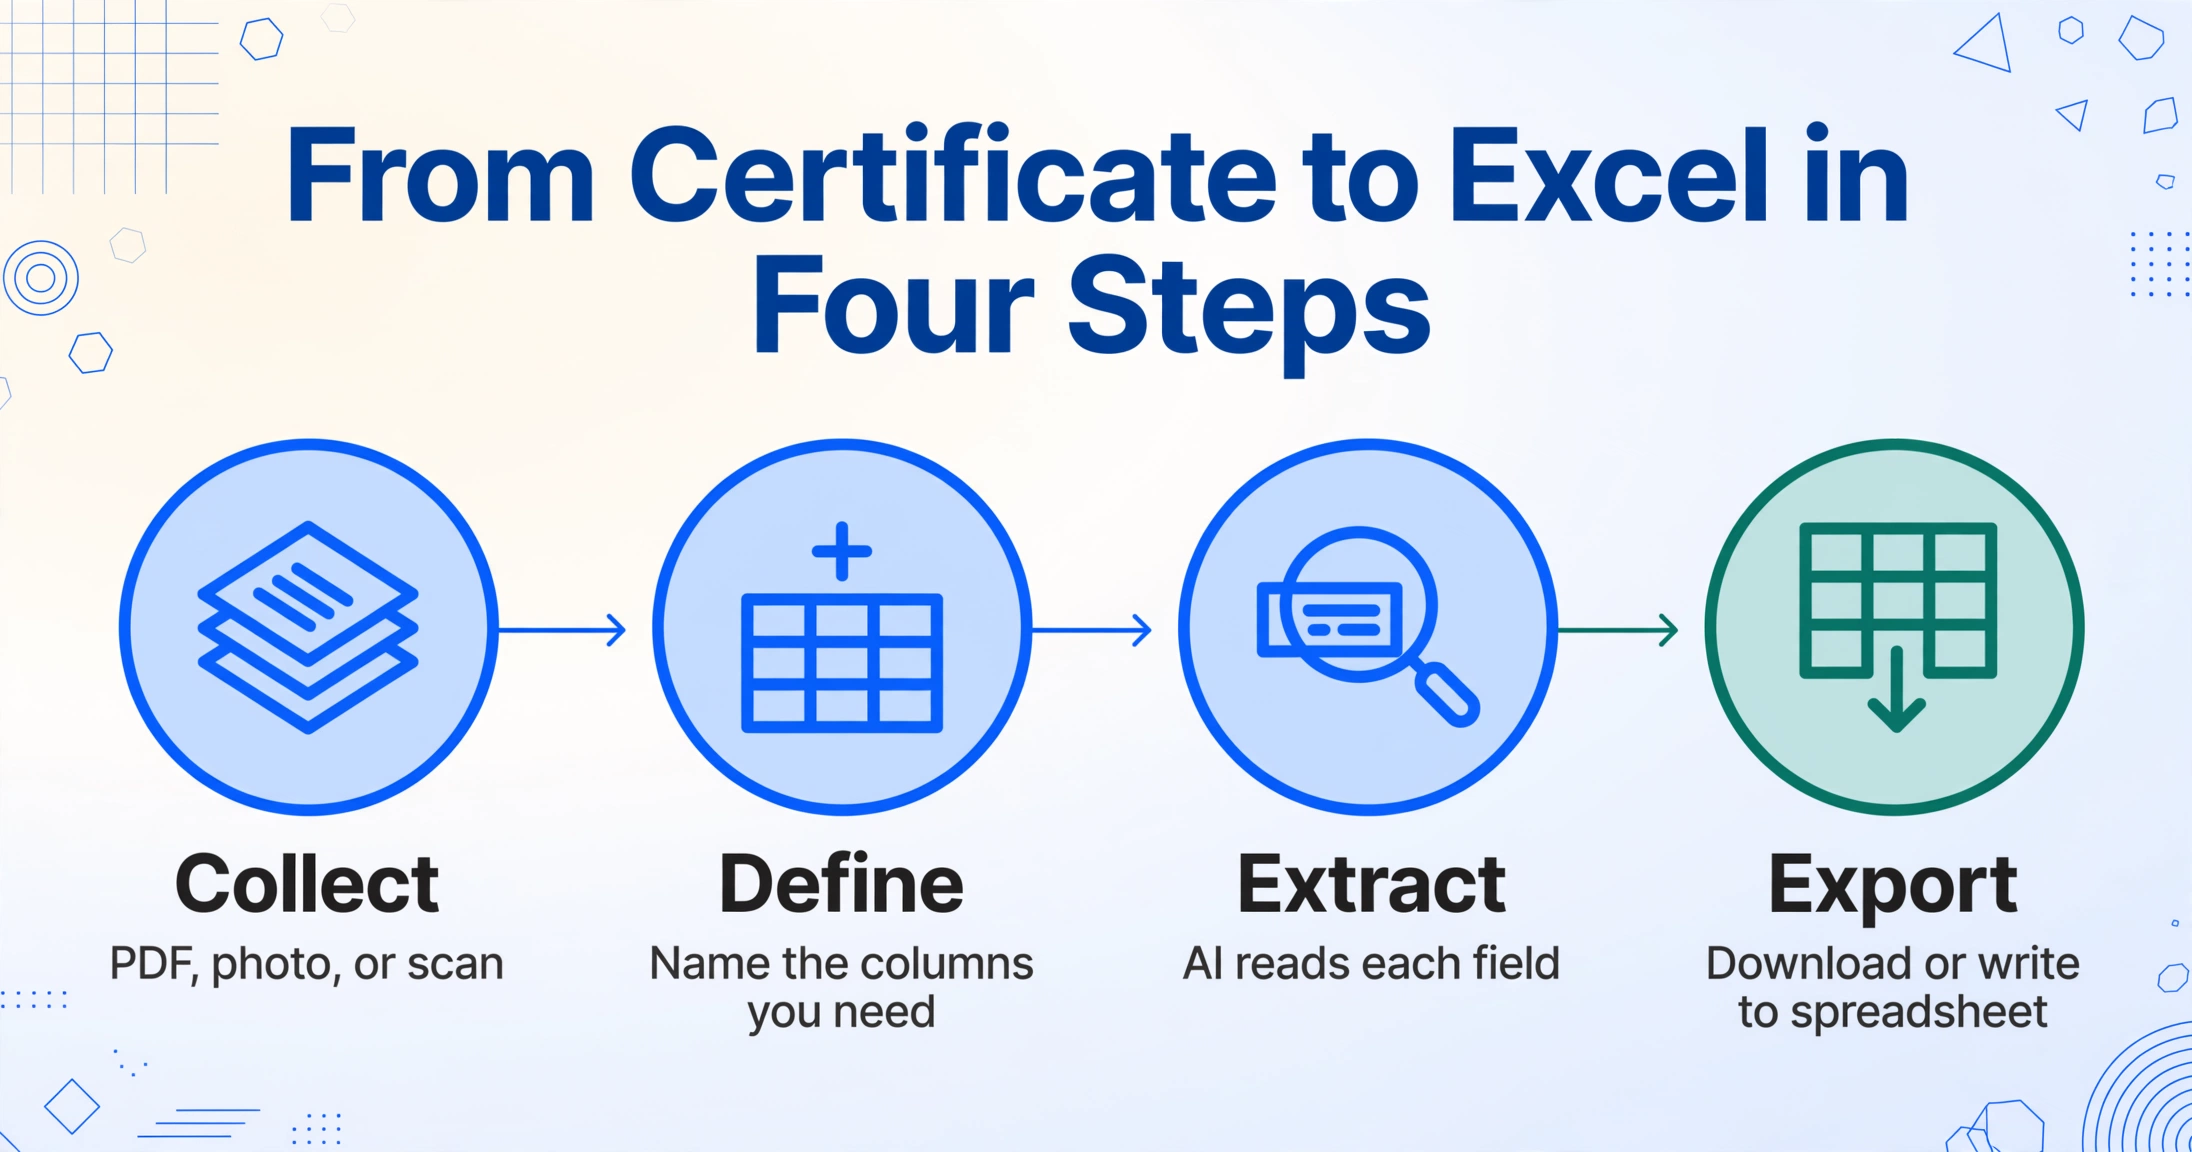
Der Prozess, eine koreanische Gewerbeanmeldung in eine strukturierte Tabellenzeile zu verwandeln, umfasst vier Schritte. Der Einrichtungsaufwand ist derselbe, ob Sie eine Bescheinigung oder fünfzig verarbeiten – genau das ist der Sinn der Extraktion statt manueller Eingabe.
(PDF, Foto, Scan)
benötigten Spalten
liest jedes Feld
Tabellenkalkulation schreiben
Schritt 1: Zertifikate sammeln
Sammeln Sie alle erhaltenen 사업자등록증-Dokumente — egal ob sie als E-Mail-Anhänge (PDF oder Bild), als Smartphone-Fotos von Außendienstmitarbeitern oder als gescannte Kopien aus einem Lieferantenportal eingegangen sind. Das Tool akzeptiert JPG, PNG, PDF und WebP, sodass keine Konvertierung oder Normalisierung der Dateien erforderlich ist. Laden Sie alle in einem einzigen Batch hoch. Ein Batch mit 50 Lieferantenzertifikaten benötigt etwa dieselbe Upload-Zeit wie ein einzelnes — ungefähr 30 bis 60 Sekunden für die Übertragung, je nach Dateigröße.
Schritt 2: Ausgabespalten definieren
Hier unterscheidet sich die semantische Extraktion von der vorlagenbasierten OCR. Statt Rechtecke auf einer Dokumentvorlage zu zeichnen (was scheitert, wenn das nächste Lieferantenzertifikat ein anderes Layout hat), benennen Sie einfach die Felder, die die KI finden soll. Geben Sie die Spaltennamen ein, die zu Ihrer KYC-Tabelle passen: Business Registration Number, Business Name, Representative, Business Address, Tax Classification, Industry Code, Start Date. Die eingegebenen Spaltennamen werden zu den Kopfzeilen Ihrer finalen Tabelle. Keine Vorlagenkonfiguration pro Lieferant ist nötig — die KI liest jedes Zertifikat und findet das passende Feld durch semantisches Verständnis, nicht durch Koordinatenposition.
Dieser Ansatz, genannt Benutzerdefinierte Spaltenextraktion, bedeutet, dass Sie die Ausgabestruktur einmal definieren und jedes Zertifikat — unabhängig davon, wer es ausgestellt hat, welche Kamera das Foto aufgenommen hat oder ob es ein Scan oder ein Screenshot ist — auf dieselben Spalten abbildet. Ein Lieferant, der ein schräg aufgenommenes Foto einreicht, erzeugt dieselbe strukturierte Zeile wie einer, der ein sauberes PDF vom NTS-Portal hochlädt. Das Zertifikat ist ein Mitglied der koreanischen Steuerdokumentfamilie — der Leitfaden zur Verarbeitung koreanischer Steuerdokumente zeigt, wie derselbe spaltenorientierte Ansatz Steuerrechnungen, Kassenbons und Lieferscheine daneben liest.
Schritt 3: KI-Extraktion
Sobald die Dateien hochgeladen und die Spalten definiert sind, verarbeitet die Extraktions-Engine alle Zertifikate im Batch gleichzeitig. Jedes Dokument wird von einem Vision-Language-Modell analysiert, das Feldbezeichnungen identifiziert, die zugehörigen Werte liest und sie den angeforderten Spalten zuordnet. Die Verarbeitungszeit beträgt 5–10 Sekunden pro Seite, und der Batch ist abgeschlossen, sobald jede Datei verarbeitet wurde – normalerweise innerhalb weniger Minuten bei typischen Lieferantenmengen.
Schritt 4: Export nach Excel oder CSV
Die Ergebnisse landen in einer einzigen Excel- (XLSX) oder CSV-Datei. Jedes Zertifikat wird zu einer Zeile; jede definierte Spalte wird zu einer Spalte. Die exportierte Datei ist bereit für den Import in Ihre KYC-Datenbank, Ihr ERP (z. B. Douzone, Ecount oder SAP) oder Ihr Lieferantenmanagementsystem. Keine manuelle Neuformatierung erforderlich – die Datenstruktur entspricht den in Schritt 2 definierten Spaltennamen, und das Dateiformat ist Standard-CSV oder XLSX, das von jeder koreanischen Buchhaltungsplattform akzeptiert wird.
Das Kernprinzip: Sie definieren die Ausgabestruktur einmal. Die KI passt sich automatisch an jedes Zertifikatsformat an. Das macht Batch-Extraktion für Lieferanten-KYC praktikabel – die Grenzkosten für das Hinzufügen des 50. Lieferanten zur Tabelle liegen nahe bei null.
8 Schlüsselfelder für Ihre KYC-Tabelle – und wie man die BRN liest
Die Business Registration Number (사업자등록번호) selbst enthält aussagekräftige Informationen, die KYC-Teams für eine schnelle Lieferantenbewertung nutzen können, ohne eine separate Datenbank abzugleichen. Das Verständnis der Zahlenstruktur verwandelt eine zehnstellige Kennung in ein sofortiges Verifizierungswerkzeug.
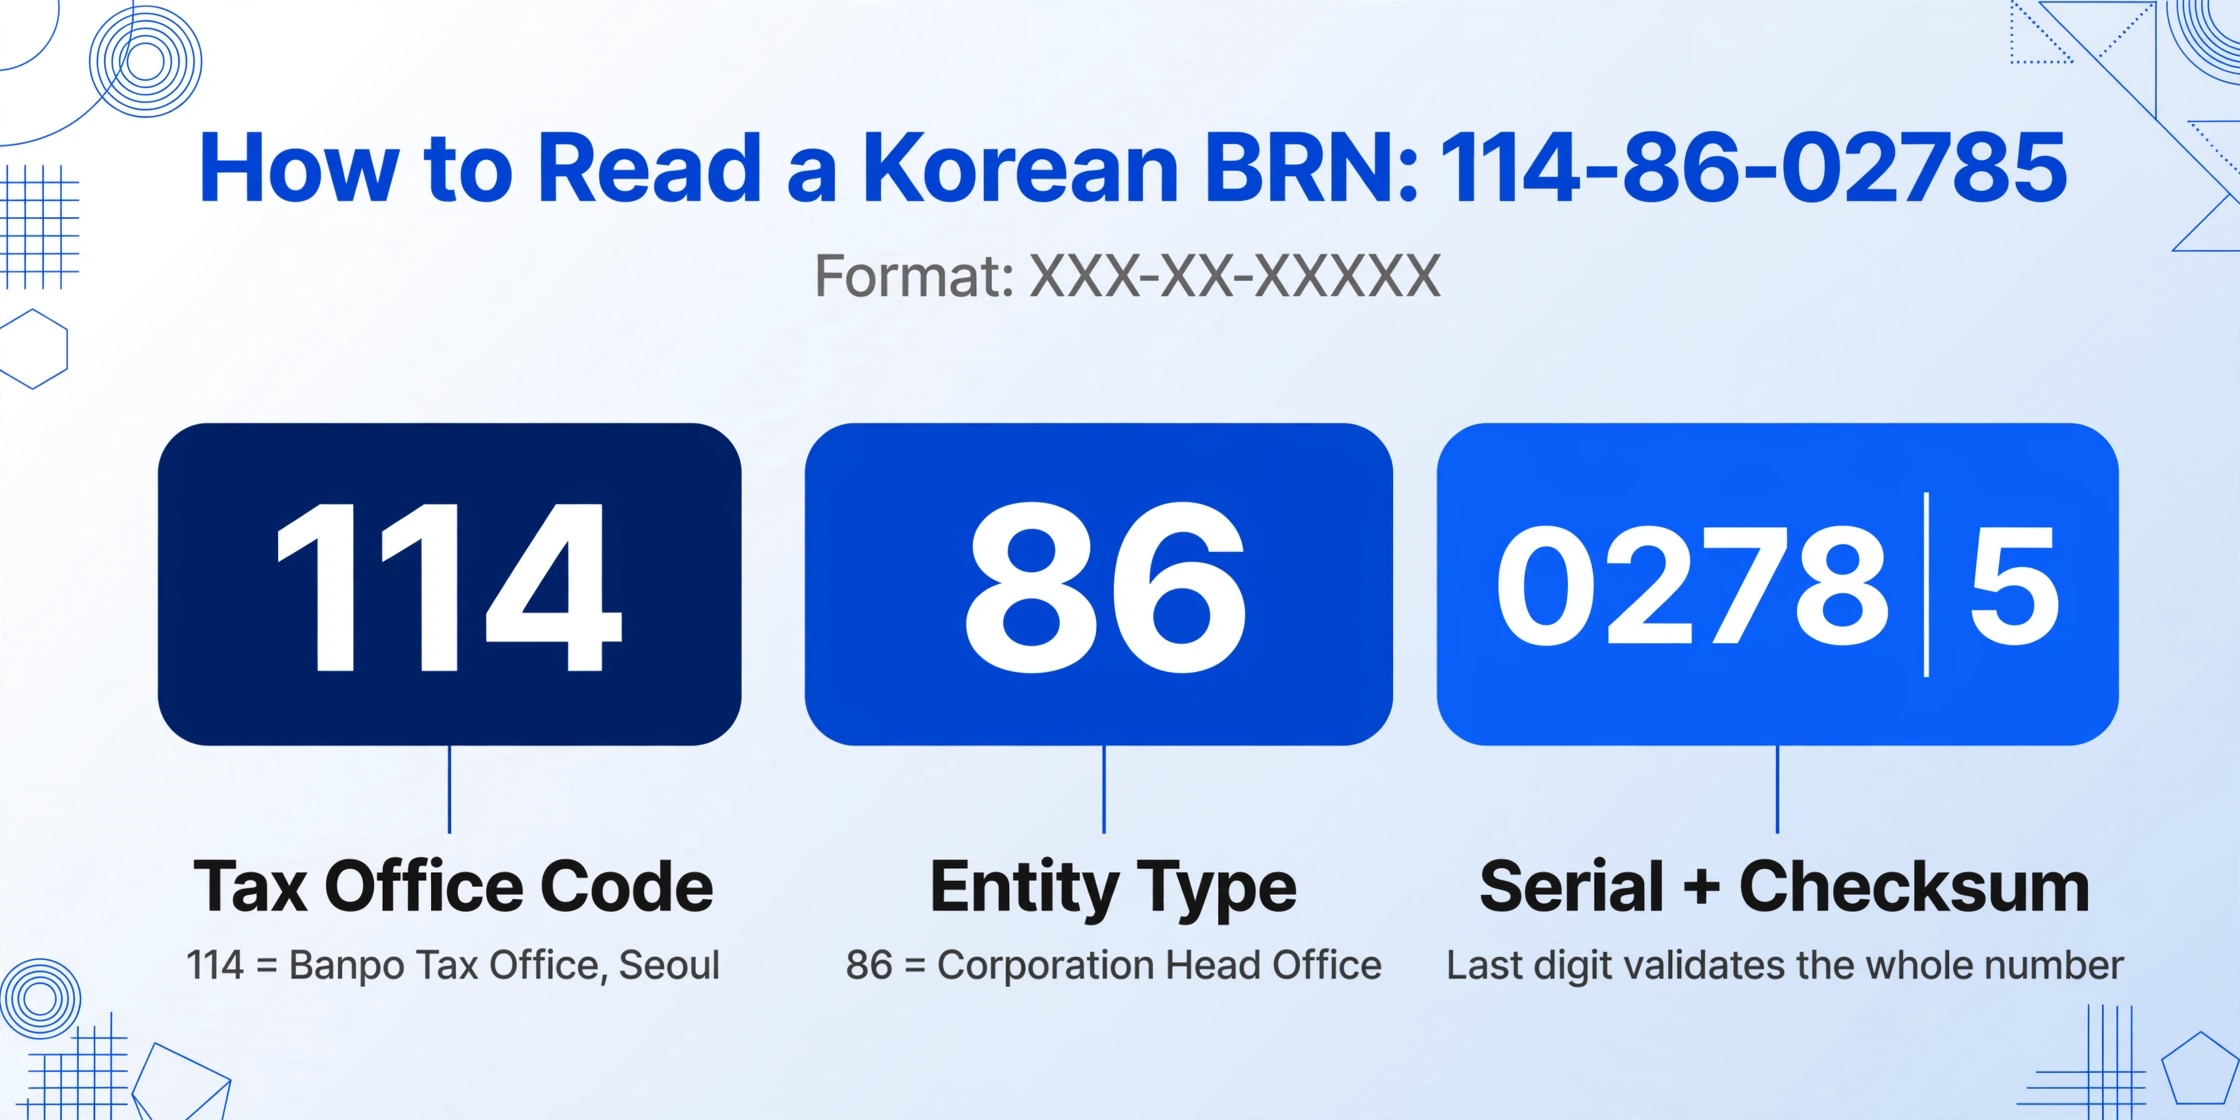
Das BRN-Format XXX-XX-XXXXX setzt sich wie folgt zusammen:
| Position | Beispiel | Bedeutung |
|---|---|---|
| Erste 3 Ziffern | 114 | Finanzamtscode – identifiziert, welches Bezirksfinanzamt (세무서) die Nummer ausgestellt hat. 114 = Finanzamt Banpo (Seoul). Jedes der ~80 Finanzämter Koreas hat einen eindeutigen Code. |
| Mittlere 2 Ziffern | 86 | Unternehmenstyp-Klassifikator – das nützlichste Verifizierungssignal. 01–79 = Einzelunternehmer mit Umsatzsteuerpflicht; 81, 86–88 = Hauptsitz einer gewinnorientierten Kapitalgesellschaft; 85 = Zweigniederlassung einer gewinnorientierten Kapitalgesellschaft; 82 = gemeinnützig; 83 = staatliche Einrichtung; 84 = ausländische Kapitalgesellschaft; 89 = religiöse Organisation; 90–99 = umsatzsteuerbefreiter Einzelunternehmer. |
| Letzte 5 Ziffern | 02785 | Seriennummer (erste 4) + Prüfziffer (letzte 1) – die Prüfziffer validiert die gesamte BRN mathematisch, wodurch HomeTax eine Nummer bestätigen kann, ohne sie nachzuschlagen. |
Mit einem einzigen Blick auf die mittleren zwei Ziffern erkennen Sie, ob ein Lieferant ein Einzelunternehmer, eine Firmenzentrale, eine Zweigniederlassung, eine gemeinnützige Organisation oder ein ausländisches Unternehmen ist — ohne eine Datenbank aufzusuchen. Das ist genau die Art von Signal, die die erste KYC-Ersteinschätzung beschleunigt, insbesondere bei der Verarbeitung großer Chargen von Lieferantenanträgen, bei denen die meisten die erste Prüfung bestehen und nur Ausnahmen eskalieren müssen.
Der vollständige Datensatz mit acht Feldern — BRN, Firmenname, Vertreter, Gründungsdatum, Adresse, Branchencode, Steuerklassifikation und Ausstellungsgrund — liefert alles, was Sie benötigen, um einen Lieferantenstammdatensatz zu befüllen. Der Vergleich von staatlichen, inländischen ERP- und in Dollar bepreisten KI-Tools zeigt, dass die auf dem koreanischen Markt verfügbaren Tools entweder ein ERP-Abonnement erfordern oder pro Seite abrechnen; keines der Preismodelle ist für den Batch-KYC-Anwendungsfall optimiert, bei dem Sie ein unregelmäßiges Volumen an Zertifikaten verarbeiten müssen — manchmal 10 pro Monat, manchmal 200 während eines Lieferantenaktualisierungszyklus.
Warum manuelle Eingabe der eigentliche Engpass beim Onboarding koreanischer Lieferanten ist
Die Kosten der manuellen Dateneingabe für die Lieferanten-KYC sind nicht nur die Zeit, die mit dem Tippen verbracht wird. Es ist die Verzögerung beim Onboarding, die Fehler, die durchrutschen, und das Compliance-Risiko, das entsteht, wenn auf der Grundlage falscher Lieferanteninformationen gehandelt wird.
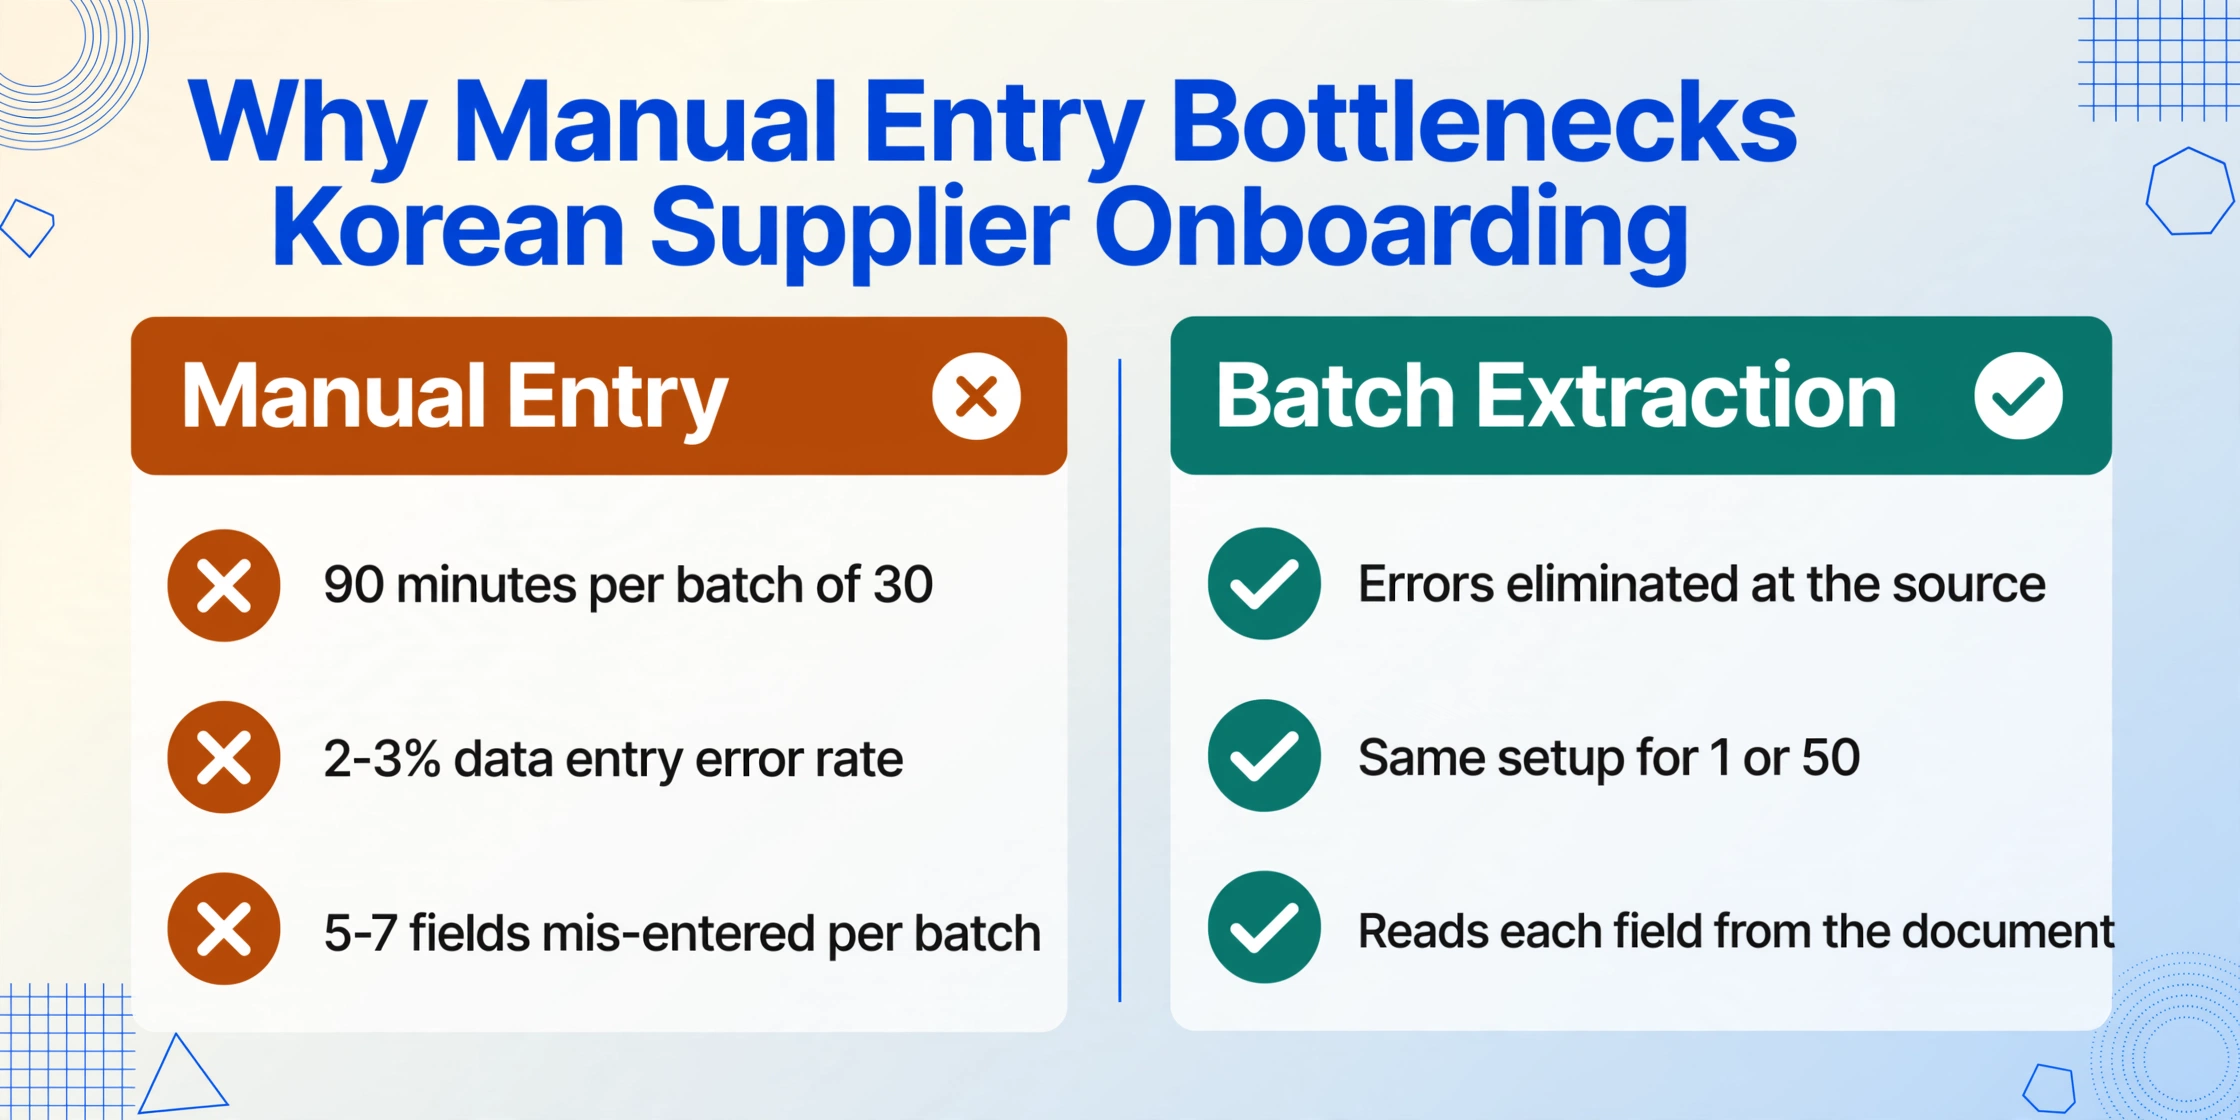
Betrachten Sie ein mittelgroßes Unternehmen, das pro Quartal 30 neue koreanische Lieferanten onboardet. Jede 사업자등록증 enthält acht Schlüsselfelder. Das sind 240 Datenpunkte pro Quartal — und realistisch gesehen erfordert jedes Zertifikat mehr als acht Felder, da das Compliance-Team auch das Einreichungsdatum, den Prüfer, den Verifizierungsstatus und das Ablaufdatum des Dokuments erfasst. Die manuelle Eingabe von etwa drei Minuten pro Zertifikat bedeutet 90 Minuten pro Charge von 30 Zertifikaten, wenn alles reibungslos läuft. In der Praxis dauert es länger: Der Datentypist muss in ein Smartphone-Foto hineinzoomen, um eine unscharfe Registrierungsnummer zu lesen, die Adresse aus einem abgewinkelten Scan neu abtippen oder überprüfen, ob „일반과세자" bedeutet, dass der Lieferant Mehrwertsteuerrechnungen ausstellen kann (das tut er, aber der Compliance-Beauftragte muss es dennoch gegen die interne Richtlinie bestätigen).
Addieren Sie eine Dateneingabefehlerquote von 2–3 % — eine falsch gelesene Ziffer in einer zehnstelligen BRN sendet eine Zahlung an die falsche Einheit — und die Kosten der manuellen Eingabe multiplizieren sich. Für ein Compliance-Team, das 30 Zertifikate pro Quartal verarbeitet, bedeutet das etwa 5–7 falsch eingegebene Felder pro Charge. Jeder Fehler erfordert eine Folge-E-Mail oder einen Anruf beim Lieferanten, was den Onboarding-Zyklus um Tage oder Wochen verzögert.
Die Batch-Extraktion eliminiert diese Fehler an der Quelle. Die KI liest jedes Feld direkt aus dem Dokumentbild und gibt es als strukturierten Text aus. Das Fehlerprofil verschiebt sich von Transkriptionsfehlern (falsche Ziffer, falsch geschriebener Name, vertauschte Adresse) zu Interpretationsgrenzfällen (blasser Text auf einer Kopie, ein teilweise verdeckter Stempel) — die weitaus seltener sind und bei der Überprüfung viel leichter zu erkennen sind.
Dateien werden sicher verarbeitet und nicht gespeichert.
Wie die semantische Extraktion koreanische Zertifikate verarbeitet
Koreanische Gewerbeanmeldungsbescheinigungen stellen drei Herausforderungen dar, die herkömmliche OCR-Tools nur schlecht bewältigen und die die semantische Extraktion direkt löst.
Herausforderung 1: Stempelüberlagerung. 사업자등록증 trägt mehrere offizielle Stempel (직인) des ausstellenden Finanzamts. Diese Stempel überlappen häufig gedruckte Textfelder – der Stempel des Leiters des Finanzamts kann teilweise das Ausstellungsdatum oder die Steuerklassifizierung überdecken. Herkömmliche OCR liest die Tinte über dem Text als Rauschen und gibt verstümmelte Zeichen aus. Ein Vision-Sprachmodell liest das Dokument ganzheitlich: Es versteht, dass eine kreisförmige rote Überlagerung ein Stempel ist, ignoriert sie für die Texterkennung und liest die darunterliegenden Zeichen korrekt. Diese Unterscheidung ist wichtig, da Stempel auf fast jedem 사업자등록증 vorhanden sind – sie sind ein Merkmal des Dokuments, keine Anomalie.
Herausforderung 2: Gemischtes Koreanisch, chinesische Zeichen und Englisch. Koreanische Zertifikate verwenden Hangul (한글) für die meisten Feldbezeichnungen und -werte, Hanja (한자, chinesische Zeichen) in Firmennamen und Adressen sowie Englisch in einigen exportorientierten Zertifikaten. Ein Tool, das auf ein Schriftsystem optimiert ist, verschlechtert sich bei den anderen. Das Vision-Modell, das in der semantischen Extraktion verwendet wird, verarbeitet alle drei gleichzeitig innerhalb derselben Dokumentseite – es wechselt nicht zwischen OCR-Engines für verschiedene Schriften. Ein Lieferant, dessen Firmenname Hanja enthält (z. B. 株式会社 bei einem alteingesessenen Handelsunternehmen), wird korrekt neben Hangul-kodierten Feldern gelesen.
Herausforderung 3: Winkel-, Beleuchtungs- und Formatvariationen. Reale 사업자등록증 liegen in allen möglichen Formen vor: als Flachbettscan, als Schreibtischfoto mit einem Bürotelefon aufgenommen, als Fax eines Faxes, als Screenshot des HomeTax-Portals. Template-basierte OCR setzt voraus, dass das Dokument innerhalb einer vordefinierten Zone positioniert ist. Ein Foto, das in einem 20-Grad-Winkel aufgenommen wurde, verschiebt jedes Feld außerhalb seiner erwarteten Begrenzungsbox. Semantische Extraktion hängt nicht von der Feldposition ab – sie findet den Wert, indem sie das danebenstehende Label liest, unabhängig davon, wo sich dieses Label auf der Seite befindet. Diese Formatunabhängigkeit macht die Batch-Verarbeitung ohne Konfigurationsschritt pro Lieferant möglich.
Die praktische Auswirkung: Ein Stapel von 30 Lieferantenzertifikaten – eine Mischung aus gescannten PDFs, Smartphone-Fotos und HomeTax-Screenshots – kann in einem einzigen Durchgang hochgeladen, extrahiert und exportiert werden, ohne Dateien zu organisieren, umzubenennen oder zu normalisieren. Die Extraktionsqualität verschlechtert sich nicht zwischen dem sauberen PDF-Upload und dem angewinkelten Foto.
FAQ
Kann ich Daten aus einer Business Registration Certificate extrahieren, die nur Koreanisch und kein Englisch enthält?
Ja. Die KI liest Hangul genauso natürlich wie Englisch oder Hanja – es handelt sich nicht um eine separate OCR-Engine mit Koreanisch als Plugin. Spaltennamen in Ihrer Extraktionsvorlage können auf Englisch sein (z. B. „Business Name"), und die KI findet das entsprechende koreanische Feldlabel („상호") und extrahiert dessen Wert. Die Ausgabetabelle enthält die extrahierten koreanischen Textwerte unter Ihren englischen Spaltenüberschriften. Bei zweisprachigen Zertifikaten, die sowohl koreanischen als auch englischen Text auf demselben Dokument enthalten, liest die KI die Sprache, die das Feldlabel verwendet.
Was ist, wenn das Zertifikat des Lieferanten ein Foto ist, das in einem Winkel oder bei schlechter Beleuchtung aufgenommen wurde?
Semantische Extraktion verarbeitet angewinkelte Fotos und ungleichmäßige Beleuchtung besser als herkömmliche OCR, da sie nicht auf eine frontale Positionierung angewiesen ist. Das Vision-Modell interpretiert das Dokument so, wie es ein Mensch tun würde – es identifiziert die Feldlabels und Werte anhand ihres Inhalts und ihrer relativen Anordnung, nicht durch Erwartung an festen Koordinaten. Unscharfe oder extrem niedrig aufgelöste Fotos können die Genauigkeit verringern, aber die häufigste Situation (ein Schreibtischfoto mit einem Smartphone bei normaler Bürobeleuchtung) liefert zuverlässige Extraktion.
Überprüft das Extraktionstool, ob die BRN eine echte, aktive Registrierung ist?
Nein – das Tool extrahiert die BRN so, wie sie auf der Bescheinigung gedruckt ist, fragt jedoch nicht die NTS-Datenbank ab, um zu bestätigen, dass die Nummer derzeit aktiv ist oder das Unternehmen nicht inzwischen geschlossen wurde. Die extrahierte BRN kann über das NTS-HomeTax-Portal (www.hometax.go.kr) oder über die API des Korea Public Data Portal (data.go.kr) zur Überprüfung abgeglichen werden. Der Extraktionsschritt erzeugt die strukturierten Daten; ein separater Verifizierungsschritt bestätigt deren aktuelle Gültigkeit. Diese Trennung von Extraktion und Verifizierung ist in KYC-Workflows Standardpraxis, bei denen die extrahierten Daten die Eingabe – nicht die Ausgabe – des Verifizierungsprozesses sind.
Was passiert, wenn ein Feld auf der Bescheinigung fehlt?
Wenn ein bestimmtes Feld nicht auf dem Dokument erscheint (z. B. kann eine neu ausgestellte Bescheinigung das ursprüngliche Gründungsdatum des Unternehmens nicht zeigen), bleibt die entsprechende Spaltenzelle leer. Die Extraktion erfindet keine Werte – sie gibt nur aus, was sie auf der Seite findet. Dieses Verhalten ist über alle Dokumente im Batch hinweg konsistent, sodass fehlende Felder in der exportierten Tabelle leicht zu erkennen sind und mit dem jeweiligen Lieferanten geklärt werden können.
Kann ich Bescheinigungen von Einzelunternehmern und großen Unternehmen gemeinsam im Batch verarbeiten?
Ja. Das 사업자등록증-Format ist von der NTS standardisiert – dieselbe Dokumentstruktur gilt für einen Solo-Freiberufler und eine Samsung-Tochter. Beide erzeugen eine BRN, einen Firmennamen, einen Vertreternamen, eine Adresse und eine Steuerklassifikation. Der einzige Unterschied ist der Rechtsträgertyp-Code in den mittleren zwei Ziffern der BRN (01–79 für Einzelunternehmer, 81/86–88 für Kapitalgesellschaften), den die KI als Teil des BRN-Felds extrahiert. Ein einzelner Batch mit gemischten Rechtsträgertypen wird in einem Durchgang verarbeitet.
Wie schneidet das im Vergleich zur Verwendung von Naver Clova OCR für dieselbe Aufgabe ab?
Naver Clova OCR liest koreanischen Text mit hoher Genauigkeit (97–99 %) und kostet etwa ₩50 pro Seite. Der entscheidende Unterschied liegt darin, was nach der Texterkennung passiert: Clova OCR liefert rohe Textstrings mit Positionsdaten, versteht aber nicht, welcher String der Firmenname, welcher der Vertretername und welcher die Adresse ist. Um strukturierte Felder zu extrahieren, müssten Sie entweder eigene Parsing-Logik pro Bescheinigungs-Layout schreiben oder eine Vorlage pro Dokumentformat konfigurieren – was den Zweck der Batch-Verarbeitung zunichtemacht, wenn die Bescheinigungen jedes Lieferanten subtile Layout-Unterschiede aufweisen können. Die KI-semantische Extraktion liefert bereits strukturierte Daten, die Ihren Spaltennamen zugeordnet sind, ohne dass eine Nachbearbeitung erforderlich ist. Der Kostenvergleich pro Seite hängt vom Volumen ab – die Analyse der Preise für die Extraktion koreanischer Dokumente schlüsselt die Break-even-Punkte zwischen API-Tools mit Seitenpreis und Pauschalextraktion bei verschiedenen monatlichen Volumina auf.
Welche Spalten sollte ich aufnehmen, wenn ich noch nicht weiß, welche Daten ich benötige?
Beginnen Sie mit den acht Standardfeldern, die in diesem Artikel aufgeführt sind: BRN, Firmenname, Name des Vertreters, Startdatum, Geschäftsadresse, Branchencode, Steuerklassifizierung und Ausstellungsgrund. Diese decken die Mindestanforderungen für die Lieferanten-KYC gemäß den AML/CFT-Vorschriften Koreas ab. Wenn Ihr Compliance-Rahmenwerk weitere Details erfordert – wie Informationen zu Mitvertretern oder eine spezifische Unterklassifizierung des Geschäftstyps – können Sie diese Spalten zur Extraktionsvorlage hinzufügen, und die KI sucht auf dem Dokument danach. Die Spaltendefinition ist nicht festgelegt; Sie können sie zwischen den Batches anpassen, wenn sich Ihre KYC-Anforderungen weiterentwickeln.