スキャンしたドキュメントをWordに変換する方法
表を維持したまま(2026年版ガイド)
「実際に成功した人はいるの?」——この質問、あるいはそれに近い言葉は、r/pdfで頻繁に見かけ、もはや一種のフラストレーション投稿ジャンルとなっています。シナリオはいつも同じです。表を含むスキャンPDF——料金表付きの契約書、3年間の比較グリッドがある財務レポート、結合列ヘッダー付きの研究論文など——をPDFからWordへの変換ツールに入力すると、出力されるドキュメントはテキストはほぼ正しいものの、表はセルのずれ、分割された結合ヘッダー、消えた列境界線の寄せ集めに成り果てています。表を保持する変換ツールを探すことは、より良いツールを見つける問題ではありません。ツールのカテゴリー全体が設計上なぜ表を壊すのかを理解し、実際の代替手段が何かを知ることこそが本質なのです。
重要なポイント
- PDFは表を保存していません——散在する文字座標を保存しているだけであり、従来の変換ツールはすべて、それらを列と行に再構成しようとする推測マシンにすぎません。
- OCR精度98%でも、1ページのテキストから20〜40件の文字レベルのエラーが発生します——それぞれが結合セルの分割、ヘッダーの分離、または5行の表を修復不可能な12行の寄せ集めに変える可能性があります。
- ビジョンAIは人間と同じように表を読み取ります——ページ全体を視覚的なシーンとして捉えるため、「変換後に壊れた表を修正する」という概念は消え去り、ネイティブなWordの表を直接編集できるようになります。
スキャンしたPDFの表がWord変換で必ず崩れる理由
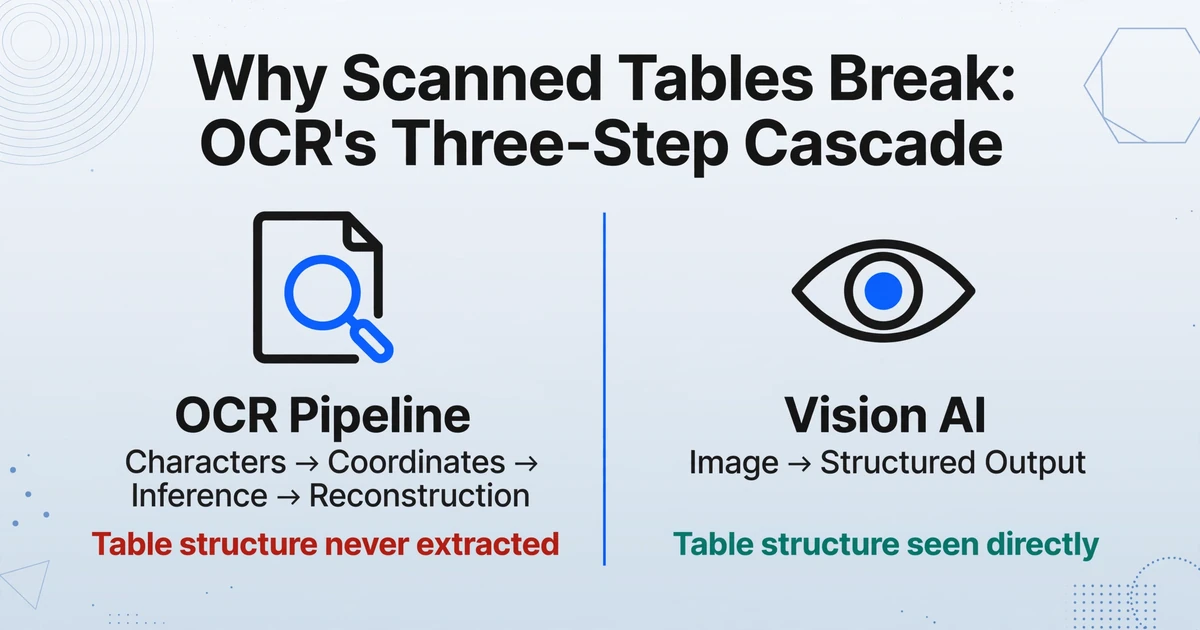
問題は、選択した変換ツールにあるのではありません。問題はPDF形式そのもの、そして光学文字認識(OCR)が関わるときに何が起こるかにあります。
PDFファイルは、ISO 32000-2:2020国際標準規格によれば、段落や表、見出しとしてではなく、個別に配置されたオブジェクトのフラットな集合としてドキュメントを保存します。各文字は固定のX/Y座標に、各線は独立したグラフィック命令として描画されます。この形式は、どの画面やプリンタでもページが同一に見えること——視覚的な忠実性——を保証しますが、それらのオブジェクト間の論理的な関係は保存しません。PDF内の表は、ファイル形式にとっては表ではありません。人間の目には表に見える、配置された文字と罫線のグリッドにすぎないのです。
Wordや他の作成ツールから直接作成されたデジタルPDFの場合、文字の座標はファイルに埋め込まれています。しかしスキャンされたドキュメント——AIIM 2025 IDP調査によると、インテリジェント文書処理ワークフローの61%には依然として紙が含まれています——の場合、テキストは選択可能な文字として存在しません。画像内のピクセルとして存在するだけです。Word変換が行われる前に、OCRがそれらのピクセルを文字に戻す必要があります。そして、そこで表構造への本当の損傷が始まるのです。詳細は、PDFからWordへの書式変換の損失が多くのユーザーが認識する以上に深刻である理由に関する詳細な解説で説明しています。
OCRは3段階のカスケードで動作します。ステップ1:スキャン画像から個々の文字を認識します。ステップ2:近接性に基づいて文字を単語と行にグループ化します。ステップ3:グループ間の空間的関係から高次構造——どの単語がどのセルに属するか、どのセルがどの行を形成するか、どの行がどの表を形成するか——を推論します。各ステップでエラーが発生し、各ステップのエラーが次のステップに影響を与えます。ステップ1での文字認識ミスはステップ2での単語グループ化ミスを生み、それがステップ3で列の分離を推論するために使用される空間的境界をずらします。変換ツールがWordの表を構築しようとする頃には、元のドキュメント構造ではなく、連鎖的な不正確さを扱っていることになります。
理想的な条件下でも、印刷テキストに対する従来のOCR精度は、大規模デジタル化プログラムで確立されたベンチマークによると、文字誤り率1〜2%(98〜99%の精度)が上限です(Docsumo OCR精度分析)。2,000文字のページの場合、20〜40文字の誤認識が発生します——それぞれが単語の境界をわずかにずらし、後続のレイアウト再構築を混乱させる可能性があります。そしてこれは良好なシナリオです。低品質のスキャン、かすれた印刷、複雑なマルチカラムレイアウトの場合、CERは急激に上昇します。
根本的な問題はOCRの精度ではありません。OCRは文字と座標しか出力できず、表構造を決して出力できないことです。出力内の表インテリジェンスのすべてのバイトは、不完全でエラーが混在する可能性のある座標マップに対して推測作業を行う変換ツールによって推論されたものです。
テーブルが崩れる5つのパターン — OCRでは解決できない理由
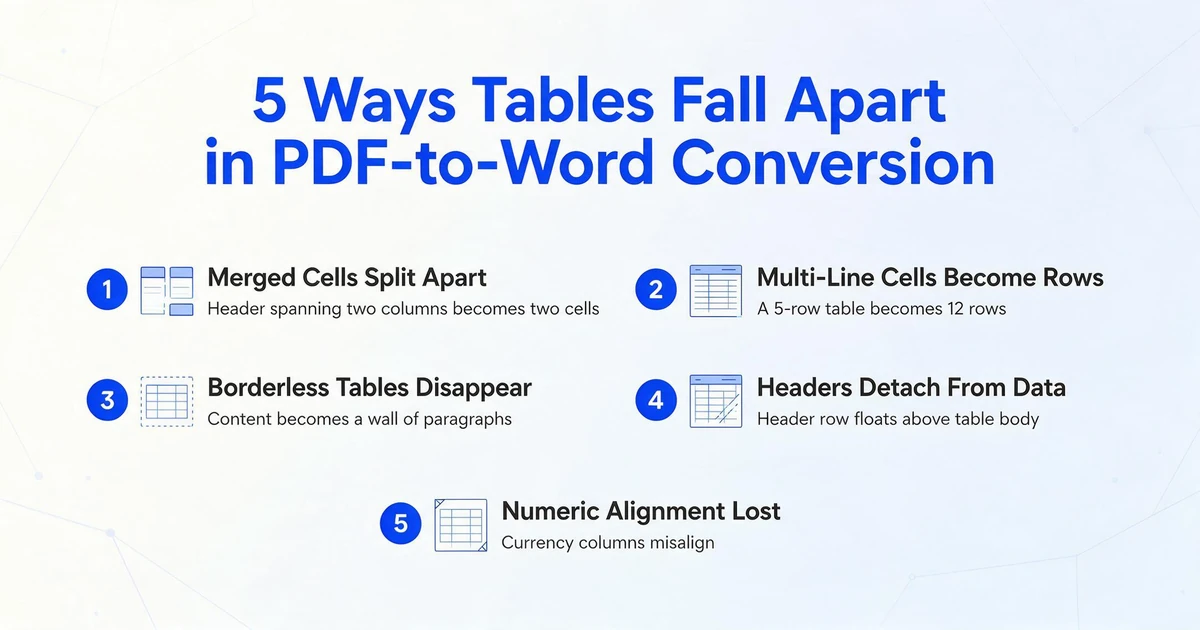
PDFツールを30年以上手がけるMapsoft社は、PDFからWordへの変換時にテーブルがどのように崩れるかを詳細に解説した、数少ない技術分析を公開しています (Mapsoft, 2025)。彼らが分類した5つの再発する障害パターンは、フォーラムでユーザーが日常的に経験している問題を的確に捉えています。
これらは例外的なケースではありません。表を一度も保存したことのないファイル形式から、ソフトウェアに論理構造(表)を再構築させた結果として予測可能な問題です。そして、この失敗は連鎖します。変換されたWord文書を開き、5行の表がヘッダー分割と列のずれを起こして12行になっているのを発見したとき、あなたは一つのエラーを修正しているのではありません。最初のミス(結合セルの分割)が2番目のミス(切り離されたヘッダー)の特定すら困難にしている、連鎖的なエラーの連なりを修正しているのです。
Mapsoftの制作アドバイスは率直です。「重要な表(財務諸表、規制当局への提出書類、構造化データ表)については、可能な限りPDFから変換しないでください。元のWord、Excel、CSVファイルを入手してください。」しかし、このアドバイスが有効なのは、元のファイルがある場合だけです。スキャン文書(署名済み契約書、アーカイブされたレポート、元の作成ファイルが何年も前に失われた研究論文)には、元のファイルはありません。スキャンこそが元のファイルなのです。
Vision AIが表を読む方法 vs. OCRが表を推測する方法
あらゆるOCRベースの変換におけるボトルネックは、常に同じステップ、すなわち再構築です。OCRは表を文字と座標に分解し、コンバーターにそれらの断片を元の形に似せて再構成するよう求めます。このプロセスは本質的に破壊的です。表構造(どのセルが結合されているか、どの行が一緒に属するか、どの線が列の境界を形成するか)に関する情報はそもそも抽出されていないため、空間的な関係性のみから推測されなければなりません。
Vision AI — 現代の画像から構造化データへのツールを支えるモデルのクラス — は、根本的に異なるアプローチをとります。文字を一文字ずつ読み取り、座標の近接性から構造を再構築しようとする代わりに、ビジョンモデルはページ全体を視覚的なシーンとして捉えます。人間と同じように、行と列を含む境界のある長方形が表であること、2列にまたがるセルが結合セルであること、最上行の太字テキストがヘッダーであることを、視覚的理解の単一パスですべて認識します。
この違いは漸進的なものではありません。再構築ステップを完全に排除します。モデルは画像→構造化出力へと、OCRを脆弱にする文字→座標→推論のカスケードを経由することなく移行します。特に表に関しては、結合セルは結合されたまま、複数行のセル内容は一つのセルに留まり、枠線のない表も消失しません。モデルが散在するテキスト断片から表構造を推測しようとするのではなく、視覚的に捉えたからです。
IBM ResearchがDocling/TableFormerモデルで発表したベンチマークは、特殊化されたML表抽出でさえも限界があることを示しています。PubTablesベンチマークで平均精度93.6% — 印象的ですが、それでも6.4%のセルが誤っています (Kramer, 2025年ベンチマーク)。従来のツールであるTabulaとCamelotは、同じベンチマークでそれぞれ67.9%と73.0%のスコアでした。68%と94%の精度の差は、「ほとんどの表は手直しすれば使える」と「ほとんどの表は修復不可能なほど壊れている」の違いです。そして、完全精度までの6.4%のギャップこそが、壊れたパラダイム内での漸進的な精度向上よりも、表を理解しようとする前に断片化しない正しいアーキテクチャが重要である理由なのです。
視覚モデルがドキュメント構造をどのように理解するかについての完全な概要は、AIがドキュメントを読み取り理解する仕組みの解説をご覧ください。テーブル保持の重要なポイントは、視覚モデルが視覚的セマンティクス(境界線、配置、空白、フォントの太さ)に基づいて動作し、座標の近接性には基づかないことです。列A〜Cにまたがる結合セルは、人間の読者にとっても視覚モデルにとっても結合セルとして見えます。なぜなら、両者ともそれを散在するテキスト断片ではなく、単一の視覚オブジェクトとして認識するからです。
ステップバイステップ:スキャンしたドキュメントをテーブルを保持したまま編集可能なWordに変換する
テーブルが壊れる理由を理解することは一つのことです。スキャンしたドキュメントを、テーブルが実際に機能する編集可能なWordファイルに変換することはまた別のことです。以下がそのプロセスです。
文書に抽出したい表形式のデータと保持したいレイアウトの両方がある場合、これらは異なるアプローチを必要とする2つの異なる問題です。文書変換と文書抽出のガイドでは、それぞれをいつ使うべきかを説明しています。表の多い文書を編集用にWordへ変換することは、分析用に表のデータをスプレッドシートへ抽出することとは根本的に異なるタスクなのです。
ファイルは安全に処理され、保存されることはありません。
元のソースファイルを失った場合の対処法
スキャン文書からWordへの変換で最も一般的なシナリオは、同時に最も無力なシナリオでもあります。PDFを生成した元のWord、Excel、InDesignファイルが存在しない場合です。5年前に署名されスキャンされた契約書。退職したコンサルタントがPDFでメール送信した財務報告書。コピーとしてのみ存在する研究論文。「ソースファイル」に頼ることはできません。
ここで、OCRとビジョンAIの違いは学術的なものではなくなります。スキャンされたPDFしかなく元のファイルがない場合、従来の変換ツールはすべて同じOCR→文字→座標→推論→再構築のパイプラインを強制されます。出力にはエラーが含まれ、そのエラーは構造が最も重要となる文書要素(表)に集中します。壊れた表の修正に費やす時間は、見積もりによっては最初から打ち直すよりも長くなるでしょう。
ビジョンAIのアプローチは、スキャンを実際の姿、つまり文書の写真として扱います。モデルは表を見て、その構造を視覚的に理解し、Wordにマッピングします。PDF内でテキストが「選択可能」である必要はありません。元の作成ファイルも必要ありません。表がどこにあるか、列がいくつあるかを指示する必要もありません。ページを見るだけでいいのです——あなたが見ているのと同じページを。
どの変換ツールがどの文書シナリオに最適かを幅広く知りたい場合は、2026年の最高のPDFからWordへの変換ツールまとめで、無料のオンラインツールからビジョンAIまで、各カテゴリが何を保持でき、何を保持できないかについて正直な評価を交えて全体像を解説しています。
従来の変換ツールとビジョンAIの比較
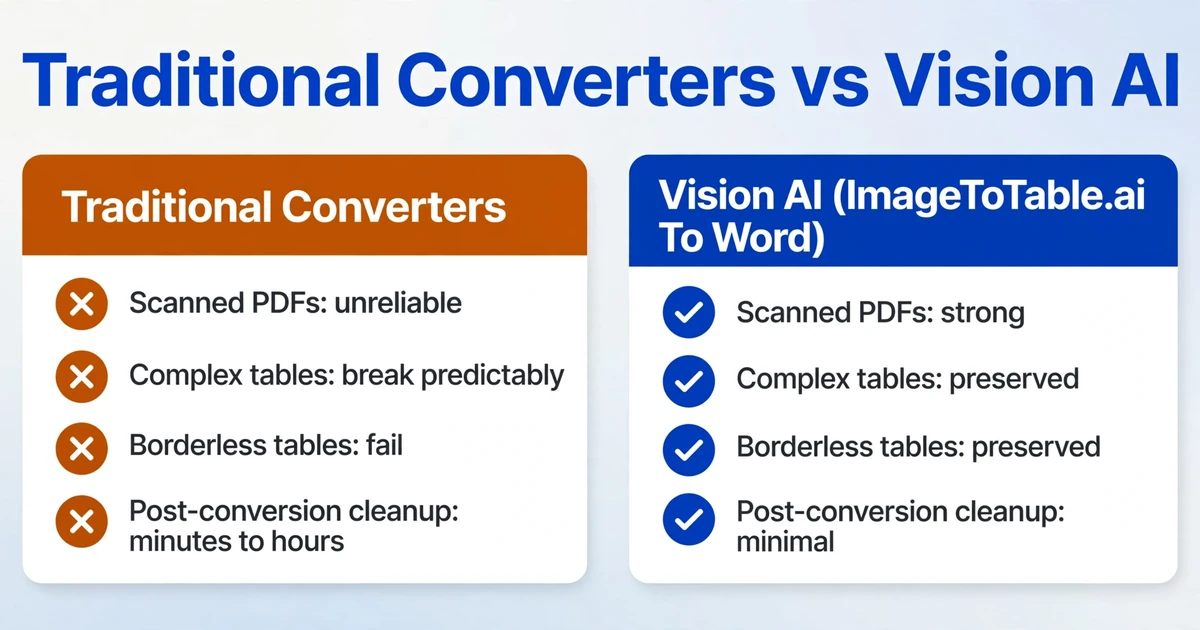
| 機能 | 従来の変換ツール (Adobe Acrobat、Word、オンラインツール) | ビジョンAI (ImageToTable.ai Wordに変換) |
|---|---|---|
| デジタルPDF(テキスト選択可能) | 良好 — ファイル内に文字データが存在 | 優れている — ページ全体の構造を認識 |
| スキャンPDF(画像のみ) | 不安定 — OCRの連鎖的な処理でテーブル構造が劣化 | 強力 — 視覚的なページから直接読み取り |
| シンプルなテーブル(ヘッダー行1行、結合なし) | 良好 — 基本的なグリッド推論が機能 | 優れている — 視覚的なマッピングを直接実行 |
| 複雑なテーブル(セル結合、複数レベルのヘッダー) | 予測どおりに崩れる — 結合セルが分割され、ヘッダーが分離 | 保持される — 結合を視覚オブジェクトとして認識 |
| 枠線のないテーブル | 失敗 — グリッド推論の視覚的手がかりがない | 保持される — 配置から表形式のレイアウトを識別 |
| 複数カラムのページレイアウト | 不安定 — カラムが予測不能に結合・分割される | 保持される — カラムの流れを認識 |
| 必要な設定 | シンプルな変換は不要。スキャンの場合はOCR言語の選択が必要 | 不要 — アップロードしてWordに変換モードを選択し処理するだけ |
| 変換後の修正作業 | テーブルの複雑さに応じて数分から数時間 | 最小限 — 結合と複数行セルを確認する程度 |
従来の変換ツールにも役割があります。テキスト中心のシンプルな書式のデジタルPDF(メモ、単一カラムのレポート、レターなど)であれば、Wordの組み込み変換機能やAdobe Acrobatの書き出し機能で十分な結果が得られるでしょう。しかし、テーブルが登場した瞬間、特にスキャン文書では、OCR再構築パイプラインがボトルネックになります。そして、保存しようとしている構造そのものを最初に取り除いてしまうパラダイムは、OCRの精度をどれだけ段階的に向上させても修正することはできません。
レイアウトを保持したドキュメントからWordへの変換完全ガイドでは、PDFの内部構造から実用的なツール選定まで、知識の全領域を網羅しており、このトピッククラスターの中心的なハブとなっています。
FAQ
スキャンしたPDFをMicrosoft Wordで直接開くことはできますか?
試すことはできますが、Wordの組み込みPDF変換機能はスキャンしたPDFからテキストを抽出できません。ファイル内にテキストが存在せず、テキストの画像しかないためです。Wordは画像を編集不可のピクチャとして開くか、空白のドキュメントを生成します。変換前にOCRまたはビジョンAIを使用してスキャン画像からテキストを抽出する必要があります。OCRを使用しても、前述の理由によりWordの変換機能はテーブルで苦戦します。スキャンしたPDFからWordへの変換では、単一のテーブルセルを再構築する前にページ画像を読み取る必要があるため、デジタル生成ファイルよりもツール選定が重要になります。
Adobe Acrobat ProはスキャンしたPDFをWordに変換する際にテーブルを保持しますか?
Adobe Acrobat Proには組み込みのOCRが搭載されており、Wordへの書き出し前に自動的に実行されます。明確な境界線と結合セルのないシンプルなテーブルでは、結果は多くの場合許容範囲です。複雑なテーブル(結合セル、複数レベルのヘッダー、境界線のないレイアウト)では、同じOCR再構築の制限が適用されます。Acrobatはテーブル構造を認識できず、OCR出力から推測するしかなく、推測は不安定です。
「Wordに変換」モードと「テーブルに変換」モードの違いは何ですか?
Wordに変換モードは、テキスト、テーブル、画像、列、書式を含むドキュメント全体を、元の外観を保った編集可能なWord(.docx)ファイルとして保持します。ドキュメント自体を編集する必要がある場合に使用します。テーブルに変換モードは、1つ以上のドキュメントから特定のデータポイント(請求書番号や日付など)を抽出し、スプレッドシートにまとめます。複数のドキュメントにわたるデータを分析する必要がある場合に使用し、1つのドキュメントを編集する場合には使用しません。スキャンしたドキュメントをテーブルがそのまま維持される編集可能な形式に変換することが目的であれば、Wordに変換が適切な選択肢です。
ビジョンAIはスキャン文書内の手書き表を処理できますか?
ビジョンAIは手書きのテキストや表の構造を認識できますが、精度は手書きの読みやすさに依存します。罫線が明確で、整列が一貫している表はうまく変換できます。行が不均一な走り書きや、筆記体が強い手書きは信頼性が低くなります。同じ視覚的理解の原則が適用されます(モデルはあなたと同じようにページを見ます)が、手書きには印刷テキストにはないばらつきが生じます。
スキャン文書の変換にはどのくらい時間がかかりますか?
ビジョンAIツールを使用すると、スキャンした1ページの処理は通常5〜10秒かかります。手動での再入力が平均3分かかるのに対し、約18倍の効率向上です。複数ページの文書では、各ページが順番に処理されます。表が密集した複雑なページは少し時間がかかる場合がありますが、合計時間は手動での再構築に必要な時間のほんの一部です。
表を維持したままスキャンPDFをWordに無料で変換する方法はありますか?
OCRを備えた無料のオンライン変換ツール(Smallpdf、PDF2Go、Xodo)はスキャンPDFからテキストを抽出できますが、表の保持は一貫性がなく、特にセル結合や罫線のない表を含む複雑なレイアウトでは品質が低いことがよくあります。Adobe Acrobat Proの書き出しはより良い結果を生み出しますが、サブスクリプション(月額約$15)が必要です。ビジョンAIツールは無料プランを提供しており、契約前に自分の文書で変換品質をテストできます。