Cómo convertir documentos escaneados a Word
Con tablas intactas (Guía 2026)
«¿Alguien lo ha logrado realmente?». Esa pregunta, o algo parecido, aparece en r/pdf con la frecuencia suficiente como para haberse convertido en un género propio de publicaciones frustradas. El escenario es siempre el mismo: un PDF escaneado que contiene tablas —quizá un contrato con un calendario de tarifas, un informe financiero con una cuadrícula comparativa de tres años, un artículo de investigación con encabezados de columnas combinadas— se introduce en un conversor de PDF a Word, y lo que sale es un documento donde el texto está mayormente bien, pero la tabla se ha reducido a un revoltijo de celdas desalineadas, encabezados combinados divididos y límites de columna desaparecidos. La búsqueda de un conversor que preserve las tablas no es cuestión de encontrar una mejor herramienta. Es cuestión de entender por qué toda la categoría de herramientas rompe las tablas por diseño —y cuál es la alternativa real.
Conclusiones clave
- Su PDF no almacena una tabla — almacena coordenadas de caracteres dispersas, y todo conversor tradicional es una máquina de adivinación que intenta reensamblarlas en columnas y filas.
- Con una precisión de OCR del 98 %, una página de texto genera entre 20 y 40 errores a nivel de carácter — cada uno capaz de dividir una celda combinada, desprender un encabezado o convertir una tabla de 5 filas en un revoltijo irreparable de 12 filas.
- La IA visual lee una tabla como lo haría usted — viendo la página completa como una escena visual — de modo que el concepto de «arreglar una tabla rota después de la conversión» desaparece y usted comienza a editar tablas nativas de Word.
Por qué las tablas escaneadas en PDF siempre se rompen al convertir a Word
El fallo no está en el convertidor que eligió. Está en el propio formato PDF — y en lo que ocurre cuando interviene el reconocimiento óptico de caracteres.
Un archivo PDF, según el estándar internacional ISO 32000-2:2020, almacena un documento no como párrafos, tablas y encabezados, sino como una colección plana de objetos posicionados individualmente: cada carácter en una coordenada X/Y fija, cada línea dibujada como una instrucción gráfica separada. El formato garantiza que una página se vea idéntica en cualquier pantalla o impresora — fidelidad visual — pero no almacena las relaciones lógicas entre esos objetos. Una tabla en un PDF no es una tabla para el formato de archivo. Es una cuadrícula de caracteres posicionados y líneas de regla que parecen una tabla a los ojos humanos.
Para PDF digitales creados directamente desde Word u otra herramienta de autoría, las coordenadas de los caracteres están incrustadas en el archivo. Pero para documentos escaneados — y el 61% de los flujos de trabajo de procesamiento inteligente de documentos aún incluyen papel, según la Encuesta IDP 2025 de AIIM — el texto no existe como caracteres seleccionables en absoluto. Existe como píxeles en una imagen. Antes de que pueda realizarse cualquier conversión a Word, el OCR debe convertir esos píxeles nuevamente en caracteres — y ahí es donde comienza el daño real a la estructura de la tabla, como se explica en nuestro análisis detallado sobre por qué la pérdida de formato al convertir PDF a Word es peor de lo que la mayoría de los usuarios cree.
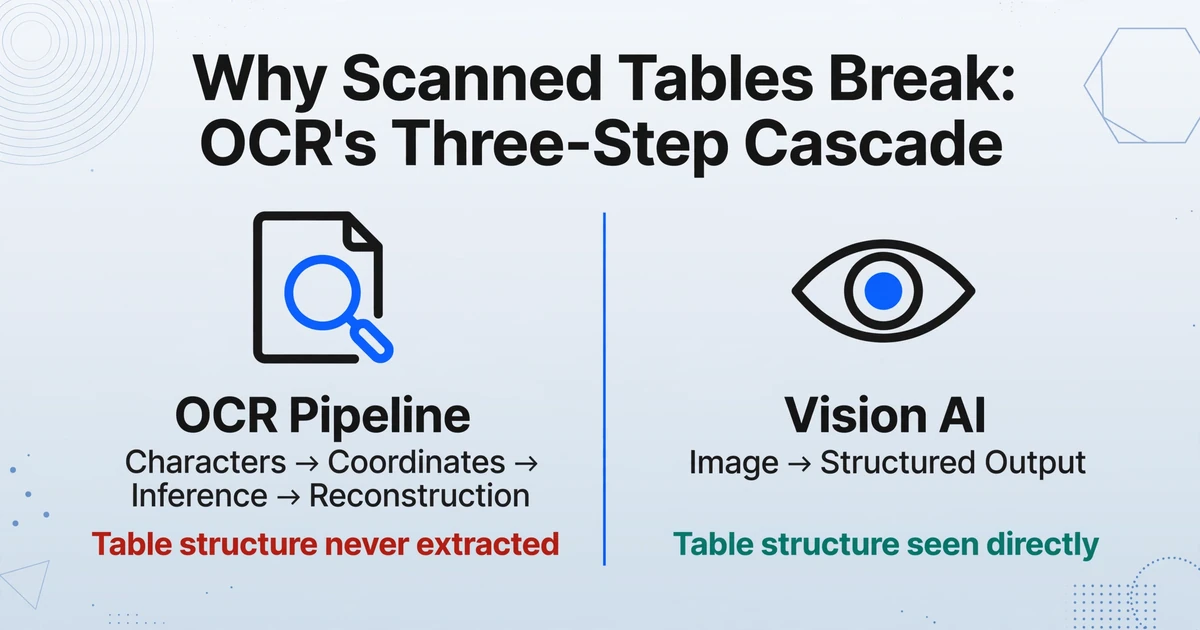
El OCR funciona en una cascada de tres pasos. Paso uno: reconocer caracteres individuales de la imagen escaneada. Paso dos: agrupar esos caracteres en palabras y líneas según su proximidad. Paso tres: inferir la estructura de nivel superior — qué palabras pertenecen a qué celda, qué celdas forman qué fila, qué filas forman qué tabla — a partir de las relaciones espaciales entre esos grupos. Cada paso introduce errores, y los errores de cada paso alimentan al siguiente. Un carácter mal reconocido en el paso uno produce una palabra mal agrupada en el paso dos, lo que desplaza el límite espacial utilizado para inferir la separación de columnas en el paso tres. Para cuando el convertidor intenta construir una tabla de Word, está trabajando con imprecisiones en cascada — no con la estructura del documento original.
Incluso en condiciones ideales, la precisión tradicional del OCR para texto impreso alcanza un máximo de tasa de error de caracteres del 1–2% (98–99% de precisión), según los puntos de referencia establecidos en programas de digitalización a gran escala (análisis de precisión de OCR de Docsumo). Para una página con 2.000 caracteres, eso supone entre 20 y 40 caracteres mal leídos — cada uno de los cuales podría desplazar un límite de palabra lo suficiente como para confundir la reconstrucción del diseño posterior. Y ese es el escenario bueno. Para escaneos de menor calidad, texto desvaído o diseños complejos de varias columnas, la tasa de error de caracteres aumenta drásticamente.
El problema central no es la precisión del OCR. Es que el OCR solo puede generar caracteres y coordenadas — nunca estructura de tabla. Cada byte de inteligencia de tabla en el resultado fue inferido por un convertidor que realiza conjeturas fundamentadas sobre un mapa de coordenadas incompleto y potencialmente plagado de errores.
Cinco formas en que las tablas se descomponen — y por qué el OCR no puede solucionarlas
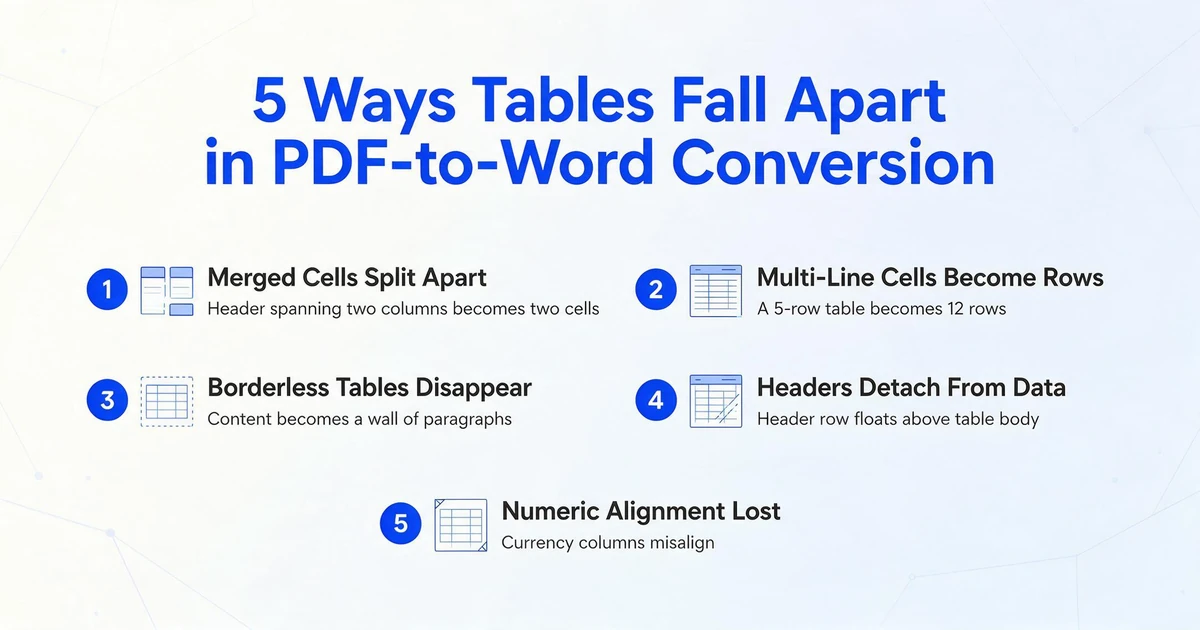
Mapsoft, una empresa de herramientas PDF con más de 30 años de experiencia en el formato, publicó uno de los pocos análisis técnicos detallados sobre cómo fallan exactamente las tablas durante la conversión de PDF a Word (Mapsoft, 2025). Su taxonomía de cinco modos de fallo recurrentes captura lo que los usuarios experimentan a diario en los foros:
No son casos excepcionales. Son el resultado predecible de pedirle a un software que reconstruya una estructura lógica —una tabla— a partir de un formato de archivo que nunca almacenó una. Y el fallo se agrava: cuando abres un documento de Word convertido y descubres que una tabla de 5 filas se ha convertido en 12 filas con encabezados divididos y columnas desalineadas, no estás corrigiendo un error. Estás corrigiendo una cascada de errores donde el primer fallo (división de celdas combinadas) hace que el segundo (encabezados desprendidos) sea aún más difícil de identificar.
El consejo de producción de Mapsoft es tajante: "Para tablas importantes —estados financieros, presentaciones regulatorias, tablas de datos estructurados— no conviertas desde PDF si puedes evitarlo. Consigue el archivo fuente de Word, Excel o CSV." Pero ese consejo solo funciona cuando tienes el archivo fuente. Para documentos escaneados —contratos firmados, informes archivados, artículos de investigación cuyo archivo original se perdió hace años— no hay archivo fuente. El escaneo es la fuente.
Cómo lee una tabla la IA de Visión vs. Cómo la adivina el OCR
El cuello de botella en toda conversión basada en OCR es siempre el mismo paso: la reconstrucción. El OCR reduce una tabla a caracteres y coordenadas, y luego le pide a un conversor que reensamble esos fragmentos en algo que se parezca al original. El proceso es inherentemente destructivo: la información sobre la estructura de la tabla (qué celdas están combinadas, qué filas van juntas, qué líneas forman los bordes de las columnas) nunca se extrajo en primer lugar, por lo que debe inferirse únicamente a partir de relaciones espaciales.
La IA de Visión —la clase de modelos que impulsa las herramientas modernas de imagen a datos estructurados— sigue un camino fundamentalmente diferente. En lugar de leer texto carácter por carácter y luego intentar reconstruir la estructura a partir de la proximidad de coordenadas, un modelo de visión ve la página completa como una escena visual. Entiende una tabla como lo haría un humano: reconociendo que un rectángulo con bordes que contiene filas y columnas es una tabla, que una celda que abarca dos columnas es una celda combinada, y que el texto en negrita en la fila superior es un encabezado —todo en una sola pasada de comprensión visual.
Esta diferencia no es incremental. Elimina el paso de reconstrucción por completo. El modelo pasa de imagen → salida estructurada sin pasar nunca por la cascada carácter→coordenada→inferencia que hace frágil al OCR. Para las tablas en concreto, esto significa que las celdas combinadas siguen combinadas, el contenido de celdas con varias líneas permanece en una sola celda, y las tablas sin bordes no desaparecen —porque el modelo vio la estructura de la tabla, en lugar de intentar deducirla a partir de fragmentos de texto dispersos.
Un punto de referencia publicado por IBM Research sobre su modelo Docling/TableFormer ilustra el techo incluso de la extracción especializada de tablas con ML: 93.6% de precisión media en el benchmark PubTables —impresionante, pero aún deja un 6.4% de celdas incorrectas (Kramer, benchmark 2025). Herramientas tradicionales como Tabula y Camelot obtuvieron un 67.9% y un 73.0% respectivamente en los mismos benchmarks. La diferencia entre un 68% y un 94% de precisión es la diferencia entre "la mayoría de las tablas son utilizables con una limpieza" y "la mayoría de las tablas están rotas sin reparación". Y el 6.4% de distancia hasta la perfección es la razón por la que la arquitectura correcta —una que no fragmente la tabla antes de intentar entenderla— importa más que las mejoras incrementales de precisión dentro de un paradigma roto.
Para obtener una visión general completa de cómo los modelos de visión comprenden la estructura de los documentos, consulte nuestro artículo explicativo sobre cómo la IA lee y comprende documentos. La idea clave para la preservación de tablas es que los modelos de visión operan sobre semántica visual — bordes, alineación, espacios en blanco, grosor de fuente — no sobre proximidad de coordenadas. Una celda combinada que abarca las columnas A–C se ve como una celda combinada para un modelo de visión, igual que para un lector humano, porque ambos la perciben como un único objeto visual en lugar de fragmentos de texto dispersos que casualmente comparten el mismo ancho de columna.
Paso a paso: Convierta un documento escaneado a Word editable con tablas intactas
Entender por qué las tablas se rompen es una cosa. Lograr que un documento escaneado se convierta en un archivo de Word editable donde las tablas realmente funcionen es otra. Este es el proceso.
Si su documento contiene tanto datos tabulares que necesita extraer y un diseño que necesita conservar, son dos problemas distintos con dos enfoques distintos. Nuestra guía sobre conversión de documentos frente a extracción de documentos explica cuándo usar cada uno — y por qué convertir un documento con muchas tablas a Word para editarlo es una tarea fundamentalmente diferente de extraer datos tabulares a una hoja de cálculo para analizarlos.
Los archivos se procesan de forma segura y no se almacenan.
Qué hacer cuando se pierde el archivo original
El escenario más común en la conversión de documentos escaneados a Word es también el más desalentador: el archivo original de Word, Excel o InDesign que generó el PDF ya no existe. El contrato se firmó y escaneó hace cinco años. El informe financiero fue enviado por correo electrónico como PDF por un consultor que dejó la empresa. El artículo de investigación solo existe como fotocopia. No hay ningún «archivo fuente» al que recurrir.
Aquí es donde la distinción entre OCR e IA visual deja de ser académica. Con solo un PDF escaneado y sin archivo original, todo conversor tradicional le obliga a pasar por el mismo proceso de OCR→carácter→coordenada→inferencia→reconstrucción. El resultado tendrá errores, y esos errores se concentrarán en los elementos del documento — las tablas — donde la estructura importa más. Pasará más tiempo corrigiendo tablas rotas que el que habría dedicado a reescribirlas desde cero, según algunas estimaciones.
El enfoque de IA visual trata el escaneo como lo que realmente es: una fotografía de un documento. El modelo ve la tabla, comprende su estructura visualmente y la asigna a Word. No necesita que el texto sea «seleccionable» en el PDF. No necesita el archivo de creación original. No necesita que usted le indique dónde están las tablas ni cuántas columnas tienen. Solo necesita ver la página — la misma página que usted está viendo.
Para una visión más amplia de qué herramientas de conversión manejan mejor cada escenario documental, nuestro análisis de los mejores conversores de PDF a Word en 2026 cubre todo el panorama, desde herramientas gratuitas en línea hasta IA visual — con evaluaciones honestas de lo que cada categoría puede y no puede conservar.
Comparación de sus opciones: convertidores tradicionales frente a la IA visual
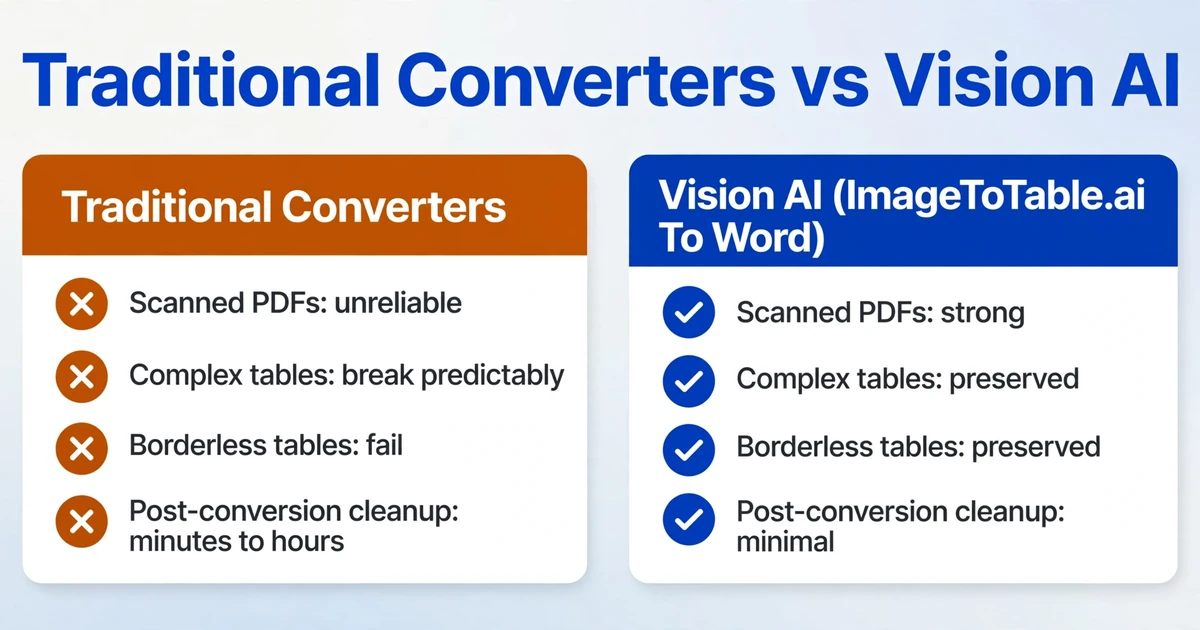
| Capacidad | Convertidores tradicionales (Adobe Acrobat, Word, herramientas en línea) | IA visual (ImageToTable.ai A Word) |
|---|---|---|
| PDF digitales (texto seleccionable) | Bueno — los datos de caracteres están disponibles en el archivo | Excelente — ve la estructura completa de la página |
| PDF escaneados (solo imagen) | Poco fiable — la cascada de OCR degrada la estructura de la tabla | Sólido — lee directamente desde la página visual |
| Tablas simples (una fila de encabezado, sin fusiones) | Bueno — la inferencia básica de cuadrícula funciona | Excelente — mapeo visual directo |
| Tablas complejas (celdas fusionadas, encabezados de varios niveles) | Se rompen de forma predecible — las celdas fusionadas se dividen, los encabezados se desprenden | Preservadas — ve las fusiones como objetos visuales |
| Tablas sin bordes | Falla — no hay señal visual para la inferencia de cuadrícula | Preservadas — identifica la disposición tabular por la alineación |
| Diseños de página de varias columnas | Inconsistente — las columnas se fusionan o se dividen de forma impredecible | Preservados — reconoce el flujo de columnas |
| Configuración necesaria | Ninguna para conversión simple; selección de idioma de OCR para escaneos | Ninguna — cargue, seleccione el modo A Word, procese |
| Limpieza posterior a la conversión | De minutos a horas según la complejidad de la tabla | Mínima — verifique fusiones y celdas de varias líneas |
Los convertidores tradicionales tienen su lugar. Si tiene un PDF digital de un documento con mucho texto y formato simple — un memorando, un informe de una sola columna, una carta — el convertidor integrado de Word o la exportación de Adobe Acrobat probablemente producirán un resultado aceptable. Pero en el momento en que las tablas entran en escena, especialmente en documentos escaneados, el pipeline de reconstrucción por OCR se convierte en el cuello de botella — y ninguna mejora incremental en la precisión del OCR puede corregir un paradigma que comienza eliminando precisamente la estructura que usted intenta preservar.
The guía completa para la conversión de documentos a Word conservando el diseño abarca todo el espectro de conocimiento, desde los aspectos internos de los PDF hasta la selección práctica de herramientas, y es el centro principal de este grupo temático.
Preguntas frecuentes
¿Puedo abrir un PDF escaneado directamente en Microsoft Word?
Puede intentarlo, pero el convertidor integrado de Word no puede extraer texto de un PDF escaneado porque no hay texto en el archivo, solo una imagen de texto. Word abrirá la imagen como una imagen no editable o generará un documento en blanco. Necesita OCR o IA visual para extraer texto de la imagen escaneada antes de la conversión. Incluso con OCR, el convertidor de Word tendrá dificultades con las tablas por las razones descritas anteriormente. La conversión de PDF escaneados a Word tiene que leer la imagen de la página antes de poder reconstruir una sola celda de tabla, por lo que la herramienta que elija importa más aquí que para archivos creados digitalmente.
¿Adobe Acrobat Pro conserva las tablas al convertir PDF escaneados a Word?
Adobe Acrobat Pro incluye OCR integrado que se ejecuta automáticamente antes de exportar a Word. Para tablas simples con bordes claros y sin celdas combinadas, los resultados suelen ser aceptables. Para tablas complejas (celdas combinadas, encabezados de varios niveles, diseños sin bordes), se aplican las mismas limitaciones de reconstrucción por OCR. Acrobat no puede ver la estructura de la tabla; solo puede inferirla a partir de la salida del OCR, y la inferencia es frágil.
¿Cuál es la diferencia entre el modo "A Word" y el modo "A Tabla"?
El modo A Word conserva todo el documento (texto, tablas, imágenes, columnas y formato) como un archivo de Word (.docx) editable que se parece al original. Es para cuando necesita editar el documento en sí. El modo A Tabla extrae puntos de datos específicos (como números de factura o fechas) de uno o más documentos y los compila en una hoja de cálculo. Es para cuando necesita analizar datos de varios documentos, no editar uno solo. Si su objetivo es convertir un documento escaneado a un formato editable donde las tablas permanezcan intactas, A Word es la opción correcta.
¿La IA visual puede manejar tablas escritas a mano en documentos escaneados?
La IA visual puede reconocer texto escrito a mano y estructuras de tablas, pero la precisión depende de la legibilidad de la escritura. Una tabla claramente escrita con bordes visibles o una alineación consistente se convertirá bien. Las notas garabateadas en filas irregulares o la escritura muy cursiva serán menos fiables. Se aplica el mismo principio de comprensión visual — el modelo ve la página como usted la ve — pero la escritura a mano introduce variabilidad que el texto impreso no tiene.
¿Cuánto tiempo se tarda en convertir un documento escaneado?
Con una herramienta de IA visual, procesar una sola página escaneada suele tardar entre 5 y 10 segundos, en comparación con un promedio de 3 minutos para volver a teclear manualmente — una ganancia de eficiencia de aproximadamente 18x. Para documentos de varias páginas, cada página se procesa de forma secuencial. Las páginas complejas con tablas densas pueden tardar un poco más, pero el tiempo total seguirá siendo una pequeña fracción de lo que requeriría la reconstrucción manual.
¿Existe una forma gratuita de convertir PDFs escaneados a Word con tablas intactas?
Los convertidores gratuitos en línea con OCR (Smallpdf, PDF2Go, Xodo) pueden extraer texto de PDFs escaneados, pero la preservación de tablas es inconsistente y a menudo deficiente — especialmente para diseños complejos con celdas combinadas o tablas sin bordes. La exportación de Adobe Acrobat Pro produce mejores resultados, pero requiere una suscripción (~$15/mes). Las herramientas de IA visual ofrecen un nivel gratuito que le permite probar la calidad de conversión en sus propios documentos antes de comprometerse.