So konvertieren Sie gescannte Dokumente in Word
mit intakten Tabellen (Leitfaden 2026)
„Hat das schon mal jemand tatsächlich geschafft?“ Diese Frage oder ähnliche Worte tauchen in r/pdf so häufig auf, dass sie zu einem eigenen Genre frustrierter Beiträge geworden sind. Das Szenario ist immer dasselbe: Ein gescanntes PDF mit Tabellen — vielleicht ein Vertrag mit Gebührenordnung, ein Finanzbericht mit Dreijahresvergleichsraster, eine Forschungsarbeit mit verbundenen Spaltenüberschriften — wird in einen PDF-zu-Word-Konverter gegeben, und heraus kommt ein Dokument, in dem der Text größtenteils stimmt, die Tabelle aber zu einem Durcheinander aus falsch ausgerichteten Zellen, getrennten verbundenen Überschriften und verschwundenen Spaltengrenzen reduziert wurde. Die Suche nach einem Konverter, der Tabellen erhält, ist keine Frage eines besseren Tools. Es geht darum zu verstehen, warum die gesamte Kategorie von Tools Tabellen konstruktionsbedingt zerstört — und was die Alternative tatsächlich ist.
Wichtigste Erkenntnisse
- Ihr PDF speichert keine Tabelle — es speichert verstreute Zeichenkoordinaten, und jeder herkömmliche Konverter ist eine Ratemaschine, die versucht, sie wieder zu Spalten und Zeilen zusammenzusetzen.
- Bei 98 % OCR-Genauigkeit erzeugt eine Textseite 20–40 Fehler auf Zeichenebene — jeder einzelne kann eine verbundene Zelle trennen, eine Überschrift ablösen oder eine 5-zeilige Tabelle in ein nicht reparierbares 12-zeiliges Durcheinander verwandeln.
- Vision-KI liest eine Tabelle so wie Sie — indem sie die ganze Seite als visuelle Szene sieht — sodass das Konzept „eine kaputte Tabelle nach der Konvertierung reparieren“ verschwindet und Sie stattdessen native Word-Tabellen bearbeiten.
Warum gescannte PDF-Tabellen bei der Word-Konvertierung immer kaputtgehen
Das Problem liegt nicht am Konverter, den Sie gewählt haben. Es liegt am PDF-Format selbst — und daran, was passiert, wenn OCR ins Spiel kommt.
Eine PDF-Datei speichert ein Dokument gemäß der internationalen Norm ISO 32000-2:2020 nicht als Absätze, Tabellen und Überschriften, sondern als flache Sammlung einzeln positionierter Objekte: jedes Zeichen an einer festen X/Y-Koordinate, jede Linie als separate grafische Anweisung gezeichnet. Das Format garantiert, dass eine Seite auf jedem Bildschirm und Drucker identisch aussieht — visuelle Treue —, aber es speichert nicht die logischen Beziehungen zwischen diesen Objekten. Eine Tabelle in einer PDF ist für das Dateiformat keine Tabelle. Sie ist ein Raster aus positionierten Zeichen und Linien, das für das menschliche Auge zufällig wie eine Tabelle aussieht.
Bei digitalen PDFs, die direkt aus Microsoft Word oder einem anderen Autorentool erstellt wurden, sind die Zeichenkoordinaten in der Datei eingebettet. Bei gescannten Dokumenten jedoch — und 61 % der Workflows zur intelligenten Dokumentenverarbeitung enthalten noch immer Papier, laut AIIM 2025 IDP Survey — existiert der Text überhaupt nicht als auswählbare Zeichen. Er existiert als Pixel in einem Bild. Bevor eine Word-Konvertierung stattfinden kann, muss OCR diese Pixel wieder in Zeichen umwandeln — und genau dort beginnt der eigentliche Schaden an der Tabellenstruktur, wie in unserem Deep Dive dazu erläutert, warum der Formatverlust bei PDF-zu-Word schlimmer ist, als die meisten Nutzer ahnen.
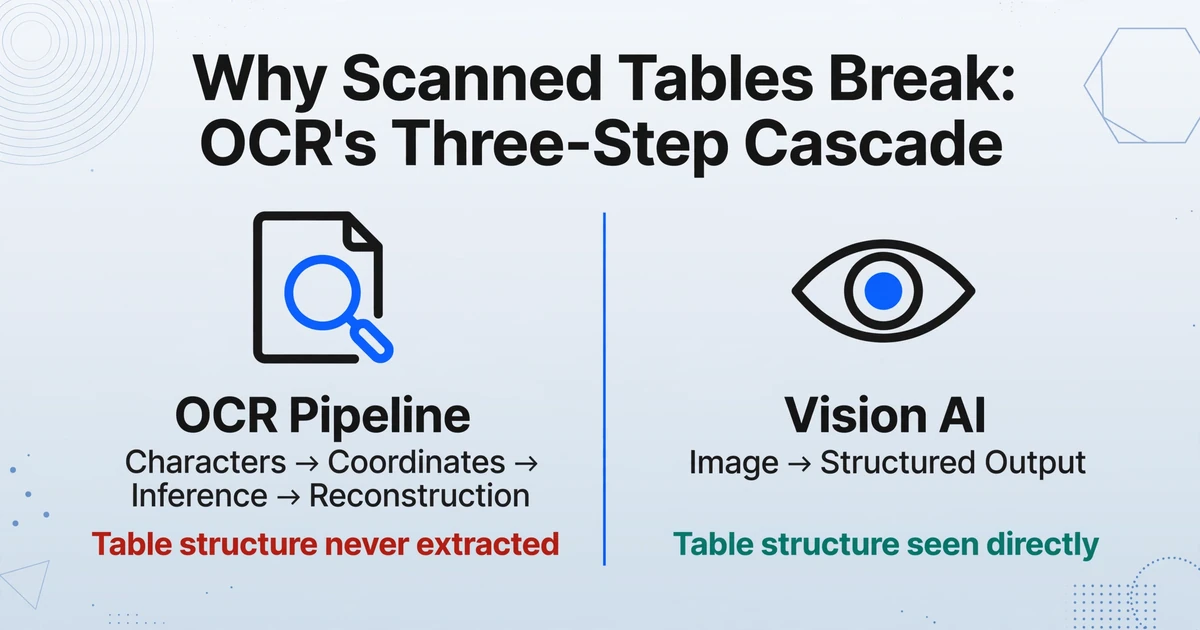
OCR arbeitet in einer dreistufigen Kaskade. Schritt eins: einzelne Zeichen aus dem gescannten Bild erkennen. Schritt zwei: diese Zeichen anhand ihrer Nähe zu Wörtern und Zeilen gruppieren. Schritt drei: übergeordnete Strukturen ableiten — welche Wörter zu welcher Zelle gehören, welche Zellen welche Zeile bilden, welche Zeilen welche Tabelle bilden — aus den räumlichen Beziehungen zwischen diesen Gruppen. Jeder Schritt führt Fehler ein, und die Fehler jedes Schritts fließen in den nächsten ein. Ein falsch erkanntes Zeichen in Schritt eins erzeugt ein falsch gruppiertes Wort in Schritt zwei, was die räumliche Grenze verschiebt, die zur Ableitung der Spaltentrennung in Schritt drei dient. Wenn der Konverter dann versucht, eine Word-Tabelle aufzubauen, arbeitet er mit kaskadierten Ungenauigkeiten — nicht mit der ursprünglichen Dokumentstruktur.
Selbst unter idealen Bedingungen erreicht die Genauigkeit herkömmlicher OCR bei gedrucktem Text maximal eine Zeichenfehlerrate von 1–2 % (98–99 % genau), laut Benchmarks aus groß angelegten Digitalisierungsprogrammen (Docsumo OCR-Genauigkeitsanalyse). Bei einer Seite mit 2.000 Zeichen sind das 20–40 falsch gelesene Zeichen — jedes einzelne kann eine Wortgrenze gerade so weit verschieben, dass die nachgelagerte Layout-Rekonstruktion verwirrt wird. Und das ist das gute Szenario. Bei Scans minderer Qualität, verblasstem Druck oder komplexen mehrspaltigen Layouts steigt die CER stark an.
Das Kernproblem ist nicht die OCR-Genauigkeit. Es ist, dass OCR nur Zeichen und Koordinaten ausgeben kann — niemals Tabellenstruktur. Jedes Byte Tabellenintelligenz in der Ausgabe wurde von einem Konverter durch mehr oder weniger fundiertes Raten auf einer unvollständigen, potenziell fehlerbehafteten Koordinatenkarte abgeleitet.
Fünf Arten, wie Tabellen auseinanderfallen — und warum OCR sie nicht reparieren kann
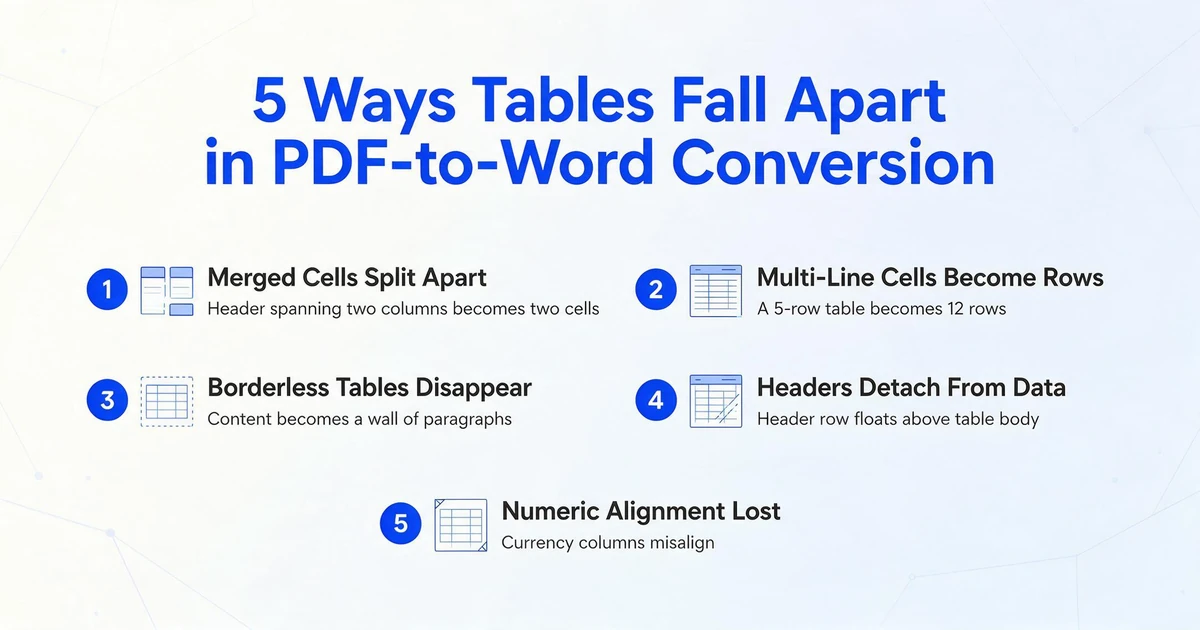
Mapsoft, ein PDF-Tooling-Unternehmen mit über 30 Jahren Erfahrung in diesem Format, hat eine der seltenen technischen Analysen veröffentlicht, die genau zeigt, wie Tabellen bei der PDF-zu-Word-Konvertierung scheitern (Mapsoft, 2025). Ihre Taxonomie von fünf wiederkehrenden Fehlermustern erfasst, was Nutzer in Foren täglich erleben:
Das sind keine Randfälle. Sie sind das vorhersehbare Ergebnis davon, Software zu bitten, eine logische Struktur – eine Tabelle – aus einem Dateiformat zu rekonstruieren, das nie eine gespeichert hat. Und der Fehler summiert sich: Wenn Sie ein konvertiertes Word-Dokument öffnen und feststellen, dass aus einer 5-zeiligen Tabelle 12 Zeilen mit getrennten Kopfzeilen und verschobenen Spalten geworden sind, beheben Sie nicht einen Fehler. Sie beheben eine Kaskade von Fehlern, bei der der erste Fehler (geteilte verbundene Zelle) den zweiten (abgelöste Kopfzeilen) schwerer erkennbar macht.
Die Produktionsempfehlung von Mapsoft ist unverblümt: „Bei Tabellen, auf die es ankommt – Finanzberichte, regulatorische Einreichungen, strukturierte Datentabellen – konvertieren Sie nicht aus PDF, wenn Sie es vermeiden können. Holen Sie sich die Word-, Excel- oder CSV-Quelldatei." Doch dieser Rat hilft nur, wenn Sie die Quelldatei haben. Bei gescannten Dokumenten – unterzeichnete Verträge, archivierte Berichte, Forschungsarbeiten, deren ursprüngliche Autorendatei vor Jahren verloren ging – gibt es keine Quelldatei. Der Scan ist die Quelle.
Wie Vision-KI eine Tabelle liest vs. wie OCR eine errät
Der Engpass bei jeder OCR-basierten Konvertierung ist derselbe Schritt: die Rekonstruktion. OCR reduziert eine Tabelle auf Zeichen und Koordinaten und bittet dann einen Konverter, diese Fragmente wieder zu etwas zusammenzusetzen, das dem Original ähnelt. Der Prozess ist von Natur aus destruktiv – Informationen über die Tabellenstruktur (welche Zellen verbunden sind, welche Zeilen zusammengehören, welche Linien Spaltengrenzen bilden) wurden nie extrahiert, sodass sie allein aus räumlichen Beziehungen abgeleitet werden müssen.
Vision-KI – die Klasse von Modellen, die moderne Bild-zu-strukturierte-Daten-Tools antreibt – geht einen grundlegend anderen Weg. Statt Text Zeichen für Zeichen zu lesen und dann zu versuchen, die Struktur aus der Nähe der Koordinaten wieder aufzubauen, sieht ein Vision-Modell die gesamte Seite als visuelle Szene. Es versteht eine Tabelle so, wie ein Mensch es tut: indem es erkennt, dass ein umrandetes Rechteck mit Zeilen und Spalten eine Tabelle ist, dass eine Zelle, die sich über zwei Spalten erstreckt, eine verbundene Zelle ist, und dass fetter Text in der obersten Zeile eine Kopfzeile ist – alles in einem einzigen Durchgang visuellen Verstehens.
Dieser Unterschied ist nicht graduell. Er beseitigt den Rekonstruktionsschritt vollständig. Das Modell gelangt von Bild → strukturierte Ausgabe, ohne jemals die Kaskade Zeichen→Koordinate→Schlussfolgerung zu durchlaufen, die OCR fragil macht. Speziell bei Tabellen bedeutet das: Verbundene Zellen bleiben verbunden, mehrzeiliger Zellinhalt bleibt in einer Zelle, und rahmenlose Tabellen verschwinden nicht – weil das Modell die Tabellenstruktur gesehen hat, statt zu versuchen, sie aus verstreuten Textfragmenten abzuleiten.
Ein von IBM Research zu ihrem Docling/TableFormer-Modell veröffentlichter Benchmark veranschaulicht die Obergrenze selbst spezialisierter ML-Tabellenextraktion: 93,6 % durchschnittliche Genauigkeit beim PubTables-Benchmark – beeindruckend, aber es bleiben immer noch 6,4 % der Zellen falsch (Kramer, Benchmark 2025). Traditionelle Tools wie Tabula und Camelot erzielten bei denselben Benchmarks 67,9 % bzw. 73,0 %. Die Lücke zwischen 68 % und 94 % Genauigkeit ist der Unterschied zwischen „die meisten Tabellen sind mit Bereinigung nutzbar" und „die meisten Tabellen sind irreparabel kaputt". Und die 6,4 % Lücke zur Perfektion sind der Grund, warum die richtige Architektur – eine, die die Tabelle nicht fragmentiert, bevor sie versucht, sie zu verstehen – mehr zählt als schrittweise Genauigkeitsverbesserungen innerhalb eines kaputten Paradigmas.
Einen vollständigen Überblick darüber, wie Vision-Modelle Dokumentstrukturen verstehen, finden Sie in unserem Erklärartikel dazu, wie KI Dokumente liest und erfasst. Die zentrale Erkenntnis für den Tabellenerhalt ist, dass Vision-Modelle auf visueller Semantik basieren — Rahmen, Ausrichtung, Leerraum, Schriftstärke — und nicht auf Koordinatennähe. Eine verbundene Zelle, die die Spalten A–C umfasst, sieht für ein Vision-Modell wie eine verbundene Zelle aus, genau wie für einen menschlichen Leser, weil beide sie als ein einzelnes visuelles Objekt wahrnehmen und nicht als verstreute Textfragmente, die zufällig dieselbe spaltenübergreifende Breite haben.
Schritt für Schritt: Ein gescanntes Dokument in bearbeitbares Word mit intakten Tabellen umwandeln
Zu verstehen, warum Tabellen kaputtgehen, ist das eine. Ein gescanntes Dokument in eine bearbeitbare Word-Datei zu bringen, in der die Tabellen tatsächlich funktionieren, ist etwas anderes. Hier ist der Ablauf.
Wenn Ihr Dokument sowohl tabellarische Daten enthält, die Sie extrahieren müssen, als auch ein Layout, das Sie erhalten müssen, handelt es sich um zwei verschiedene Probleme mit zwei verschiedenen Ansätzen. Unser Leitfaden zu Dokumentkonvertierung vs. Dokumentextraktion erklärt, wann welcher Ansatz sinnvoll ist — und warum die Konvertierung eines tabellenlastigen Dokuments nach Word zur Bearbeitung eine grundlegend andere Aufgabe ist als die Extraktion von Tabellen-daten in eine Tabellenkalkulation zur Analyse.
Dateien werden sicher verarbeitet und nicht gespeichert.
Was tun, wenn die ursprüngliche Quelldatei verloren ist
Das häufigste Szenario bei der Konvertierung gescannter Dokumente nach Word ist zugleich das hilfloseste: Die ursprüngliche Word-, Excel- oder InDesign-Datei, aus der das PDF erzeugt wurde, ist nicht mehr vorhanden. Der Vertrag wurde vor fünf Jahren unterschrieben und gescannt. Der Finanzbericht wurde als PDF von einem Berater per E-Mail verschickt, der die Firma verlassen hat. Die Forschungsarbeit existiert nur als Fotokopie. Es gibt keine „Quelldatei“, auf die Sie zurückgreifen könnten.
Hier wird der Unterschied zwischen OCR und Vision-KI alles andere als akademisch. Wenn nur ein gescanntes PDF und keine Originaldatei vorliegt, zwingt jeder traditionelle Konverter Sie durch dieselbe Pipeline: OCR→Zeichen→Koordinate→Schlussfolgerung→Rekonstruktion. Die Ausgabe wird Fehler enthalten, und diese Fehler konzentrieren sich auf die Dokumentelemente — Tabellen —, bei denen die Struktur am wichtigsten ist. Schätzungen zufolge verbringen Sie mehr Zeit mit der Reparatur kaputter Tabellen, als Sie für das Neuabtippen von Grund auf gebraucht hätten.
Der Vision-KI-Ansatz behandelt den Scan als das, was er tatsächlich ist: ein Foto eines Dokuments. Das Modell sieht die Tabelle, versteht ihre Struktur visuell und überträgt sie nach Word. Es benötigt keinen „auswählbaren“ Text im PDF. Es benötigt keine ursprüngliche Autorendatei. Es benötigt nicht Ihre Anweisung, wo die Tabellen sind oder wie viele Spalten sie haben. Es muss nur die Seite sehen — dieselbe Seite, die Sie vor sich haben.
Für einen breiteren Überblick darüber, welche Konvertierungstools welche Dokumentenszenarien am besten bewältigen, deckt unsere Übersicht der besten PDF-zu-Word-Konverter 2026 die gesamte Bandbreite ab — von kostenlosen Online-Tools bis hin zu Vision-KI — mit ehrlichen Einschätzungen dazu, was jede Kategorie erhalten kann und was nicht.
Ihre Optionen im Vergleich: Traditionelle Konverter vs. Vision-KI
| Funktion | Traditionelle Konverter (Adobe Acrobat, Word, Online-Tools) | Vision-KI (ImageToTable.ai Nach Word) |
|---|---|---|
| Digitale PDFs (Text auswählbar) | Gut — Zeichendaten in der Datei verfügbar | Ausgezeichnet — erkennt die vollständige Seitenstruktur |
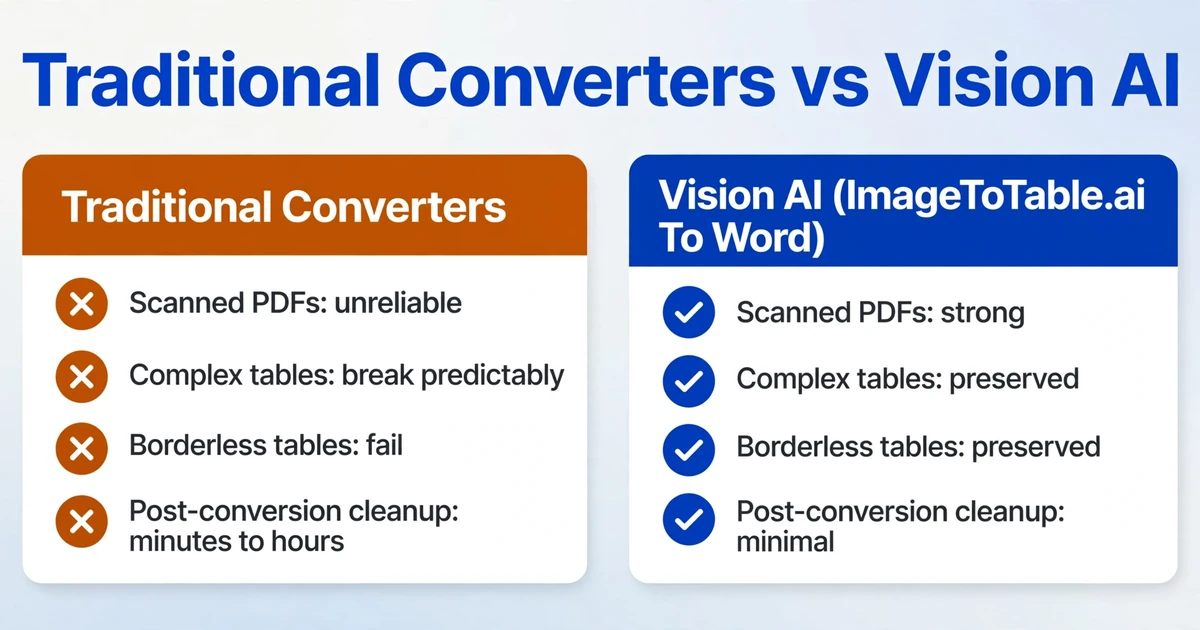
| Gescannte PDFs (nur Bild) | Unzuverlässig — OCR-Kaskade beeinträchtigt die Tabellenstruktur | Stark — liest direkt von der visuellen Seite |
| Einfache Tabellen (eine Kopfzeile, keine Zusammenführungen) | Gut — grundlegende Rastererkennung funktioniert | Ausgezeichnet — direkte visuelle Zuordnung |
| Komplexe Tabellen (verbundene Zellen, mehrstufige Kopfzeilen) | Bricht vorhersehbar — verbundene Zellen werden getrennt, Kopfzeilen lösen sich | Erhalten — erkennt Zusammenführungen als visuelle Objekte |
| Rahmenlose Tabellen | Schlägt fehl — kein visueller Hinweis für die Rastererkennung | Erhalten — identifiziert tabellarisches Layout anhand der Ausrichtung |
| Mehrspaltige Seitenlayouts | Inkonsistent — Spalten werden unvorhersehbar zusammengeführt oder getrennt | Erhalten — erkennt den Spaltenfluss |
| Erforderliche Einrichtung | Keine für einfache Konvertierung; OCR-Sprachauswahl für Scans | Keine — hochladen, Nach Word-Modus wählen, verarbeiten |
| Nachbearbeitung nach der Konvertierung | Minuten bis Stunden je nach Tabellenkomplexität | Minimal — Zusammenführungen und mehrzeilige Zellen stichprobenartig prüfen |
Traditionelle Konverter haben ihre Berechtigung. Wenn Sie ein digitales PDF eines textlastigen Dokuments mit einfacher Formatierung haben — ein Memo, einen einspaltigen Bericht, einen Brief —, liefert der integrierte Konverter von Word oder der Export von Adobe Acrobat wahrscheinlich ein brauchbares Ergebnis. Doch sobald Tabellen ins Spiel kommen, insbesondere in gescannten Dokumenten, wird die OCR-Rekonstruktionspipeline zum Engpass — und keine noch so große schrittweise Verbesserung der OCR-Genauigkeit kann ein Paradigma beheben, das damit beginnt, genau die Struktur zu entfernen, die Sie bewahren möchten.
Der vollständige Leitfaden zur layoutgetreuen Konvertierung von Dokumenten nach Word deckt das gesamte Wissensspektrum ab – von PDF-Interna bis zur praktischen Tool-Auswahl – und ist der zentrale Hub für diesen Themencluster.
FAQ
Kann ich ein gescanntes PDF einfach direkt in Microsoft Word öffnen?
Sie können es versuchen, aber der integrierte PDF-Konverter von Word kann keinen Text aus einem gescannten PDF extrahieren, weil in der Datei kein Text vorhanden ist – nur ein Bild von Text. Word öffnet entweder das Bild als nicht bearbeitbares Bild oder erzeugt ein leeres Dokument. Sie benötigen OCR oder Vision-KI, um Text aus dem gescannten Bild zu extrahieren, bevor die Konvertierung erfolgt. Selbst mit OCR wird der Konverter von Word aus den oben beschriebenen Gründen mit Tabellen zu kämpfen haben. Die Konvertierung gescannter PDFs nach Word muss das Seitenbild lesen, bevor eine einzelne Tabellenzelle wiederhergestellt werden kann – deshalb ist die Wahl des Tools hier wichtiger als bei digital erzeugten Dateien.
Behält Adobe Acrobat Pro Tabellen bei der Konvertierung gescannter PDFs nach Word bei?
Adobe Acrobat Pro enthält eine integrierte OCR, die vor dem Export nach Word automatisch ausgeführt wird. Bei einfachen Tabellen mit klaren Rändern und ohne verbundene Zellen sind die Ergebnisse oft akzeptabel. Bei komplexen Tabellen – verbundene Zellen, mehrstufige Kopfzeilen, randlose Layouts – gelten dieselben Einschränkungen bei der OCR-Rekonstruktion. Acrobat kann die Tabellenstruktur nicht sehen; es kann sie nur aus der OCR-Ausgabe ableiten, und diese Ableitung ist fragil.
Was ist der Unterschied zwischen dem Modus „Nach Word" und dem Modus „Nach Tabelle"?
Der Modus Nach Word bewahrt das gesamte Dokument – Text, Tabellen, Bilder, Spalten und Formatierung – als bearbeitbare Word-Datei (.docx), die wie das Original aussieht. Er ist für Fälle gedacht, in denen Sie das Dokument selbst bearbeiten müssen. Der Modus Nach Tabelle extrahiert bestimmte Datenpunkte (wie Rechnungsnummern oder Datumsangaben) aus einem oder mehreren Dokumenten und fasst sie in einer Tabellenkalkulation zusammen. Er ist für Fälle gedacht, in denen Sie Daten über mehrere Dokumente hinweg analysieren und nicht ein einzelnes Dokument bearbeiten möchten. Wenn Ihr Ziel darin besteht, ein gescanntes Dokument in ein bearbeitbares Format zu bringen, in dem Tabellen intakt bleiben, ist Nach Word die richtige Wahl.
Kann Vision-KI handschriftliche Tabellen in gescannten Dokumenten verarbeiten?
Vision-KI kann handschriftlichen Text und Tabellenstrukturen erkennen, doch die Genauigkeit hängt von der Lesbarkeit der Handschrift ab. Eine klar geschriebene Tabelle mit sichtbaren Rändern oder gleichmäßiger Ausrichtung lässt sich gut konvertieren. Gekritzelte Notizen in ungleichmäßigen Zeilen oder stark kursiver Handschrift sind weniger zuverlässig. Es gilt dasselbe Prinzip des visuellen Verständnisses – das Modell sieht die Seite so wie Sie –, doch Handschrift bringt eine Variabilität mit sich, die gedruckter Text nicht hat.
Wie lange dauert die Konvertierung eines gescannten Dokuments?
Mit einem Vision-KI-Tool dauert die Verarbeitung einer einzelnen gescannten Seite in der Regel 5–10 Sekunden, verglichen mit durchschnittlich 3 Minuten für manuelles Abtippen – ein Effizienzgewinn von etwa dem 18-Fachen. Bei mehrseitigen Dokumenten wird jede Seite nacheinander verarbeitet. Komplexe Seiten mit dichten Tabellen können etwas länger dauern, doch die Gesamtzeit bleibt ein Bruchteil dessen, was eine manuelle Rekonstruktion erfordern würde.
Gibt es eine kostenlose Möglichkeit, gescannte PDFs mit intakten Tabellen nach Word zu konvertieren?
Kostenlose Online-Konverter mit OCR (Smallpdf, PDF2Go, Xodo) können Text aus gescannten PDFs extrahieren, doch die Tabellenerhaltung ist uneinheitlich und oft schlecht – besonders bei komplexen Layouts mit verbundenen Zellen oder randlosen Tabellen. Der Export von Adobe Acrobat Pro liefert bessere Ergebnisse, erfordert jedoch ein Abonnement (~$15/Monat). Vision-KI-Tools bieten eine kostenlose Stufe, mit der Sie die Konvertierungsqualität an Ihren eigenen Dokumenten testen können, bevor Sie sich festlegen.