Como Converter Documentos Digitalizados em Word
com Tabelas Intactas (Guia 2026)
"Alguém já conseguiu fazer isso de verdade?" Essa pergunta, ou algo próximo disso, aparece no r/pdf com frequência suficiente para se tornar um gênero próprio de post frustrado. O cenário é sempre o mesmo: um PDF digitalizado contendo tabelas — talvez um contrato com uma tabela de tarifas, um relatório financeiro com uma grade comparativa de três anos, um artigo científico com cabeçalhos de colunas mescladas — é inserido em um conversor de PDF para Word, e o que sai é um documento onde o texto está quase todo certo, mas a tabela foi reduzida a um amontoado de células desalinhadas, cabeçalhos mesclados divididos e limites de colunas que sumiram. A busca por um conversor que preserve tabelas não é uma questão de encontrar uma ferramenta melhor. É uma questão de entender por que toda a categoria de ferramentas quebra tabelas por design — e qual é a alternativa de fato.
Principais Conclusões
- Seu PDF não armazena uma tabela — ele armazena coordenadas dispersas de caracteres, e todo conversor tradicional é uma máquina de adivinhação tentando remontá-las em colunas e linhas.
- Com 98% de precisão de OCR, uma página de texto gera 20–40 erros em nível de caractere — cada um capaz de dividir uma célula mesclada, desprender um cabeçalho ou transformar uma tabela de 5 linhas em um amontoado irrecuperável de 12 linhas.
- A IA visual lê uma tabela como você — vendo a página inteira como uma cena visual — então o conceito de "consertar uma tabela quebrada após a conversão" desaparece e você começa a editar tabelas nativas do Word.
Por que tabelas de PDF digitalizado sempre quebram na conversão para Word
A falha não está no conversor que você escolheu. Está no próprio formato PDF — e no que acontece quando o Reconhecimento Óptico de Caracteres entra em cena.
Um arquivo PDF, segundo a norma internacional ISO 32000-2:2020, armazena um documento não como parágrafos, tabelas e títulos, mas como uma coleção plana de objetos posicionados individualmente: cada caractere em uma coordenada X/Y fixa, cada linha desenhada como uma instrução gráfica separada. O formato garante que uma página pareça idêntica em qualquer tela ou impressora — fidelidade visual —, mas não armazena as relações lógicas entre esses objetos. Uma tabela em um PDF não é uma tabela para o formato do arquivo. É uma grade de caracteres posicionados e linhas de régua que por acaso se parecem com uma aos olhos humanos.
Para PDFs digitais criados diretamente no Word ou em outra ferramenta de autoria, as coordenadas dos caracteres estão incorporadas no arquivo. Mas para documentos digitalizados — e 61% dos fluxos de trabalho de processamento inteligente de documentos ainda incluem papel, segundo a Pesquisa IDP 2025 da AIIM —, o texto não existe como caracteres selecionáveis. Ele existe como pixels em uma imagem. Antes que qualquer conversão para Word possa acontecer, o OCR precisa transformar esses pixels de volta em caracteres — e é aí que começa o verdadeiro dano à estrutura da tabela, como explicado em nosso aprofundamento sobre por que a perda de formatação de PDF para Word é pior do que a maioria dos usuários imagina.
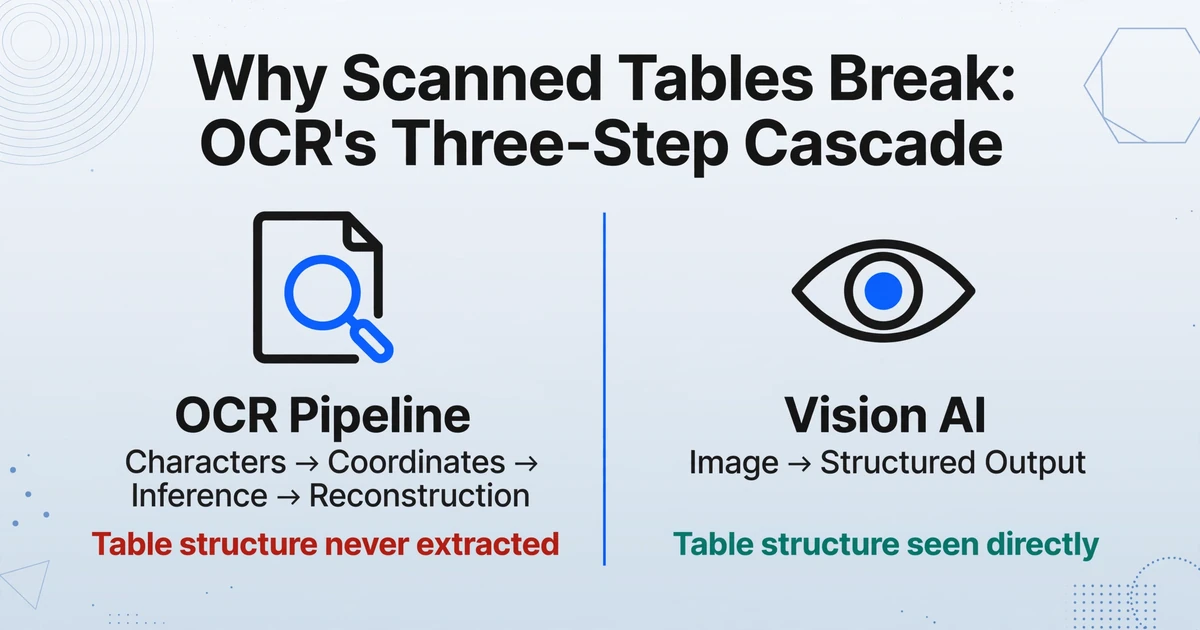
O OCR funciona em uma cascata de três etapas. Etapa um: reconhecer caracteres individuais da imagem digitalizada. Etapa dois: agrupar esses caracteres em palavras e linhas com base na proximidade. Etapa três: inferir a estrutura de nível superior — quais palavras pertencem a qual célula, quais células formam qual linha, quais linhas formam qual tabela — a partir das relações espaciais entre esses grupos. Cada etapa introduz erros, e os erros de cada etapa alimentam a próxima. Um caractere mal reconhecido na etapa um produz uma palavra mal agrupada na etapa dois, o que desloca o limite espacial usado para inferir a separação de colunas na etapa três. Quando o conversor tenta construir uma tabela do Word, ele está trabalhando com imprecisões em cascata — não com a estrutura original do documento.
Mesmo em condições ideais, a precisão do OCR tradicional para texto impresso atinge no máximo uma Taxa de Erro de Caractere de 1–2% (98–99% de precisão), segundo benchmarks estabelecidos em programas de digitalização em larga escala (análise de precisão de OCR da Docsumo). Para uma página com 2.000 caracteres, isso representa 20–40 caracteres mal lidos — cada um potencialmente deslocando um limite de palavra o suficiente para confundir a reconstrução de layout subsequente. E esse é o cenário bom. Para digitalizações de qualidade inferior, impressão desbotada ou layouts complexos de várias colunas, a CER sobe acentuadamente.
O problema central não é a precisão do OCR. É que o OCR só pode produzir caracteres e coordenadas — nunca a estrutura da tabela. Cada byte de inteligência de tabela na saída foi inferido por um conversor fazendo suposições fundamentadas em um mapa de coordenadas incompleto e potencialmente cheio de erros.
Cinco formas como as tabelas se desintegram — e por que o OCR não consegue corrigi-las
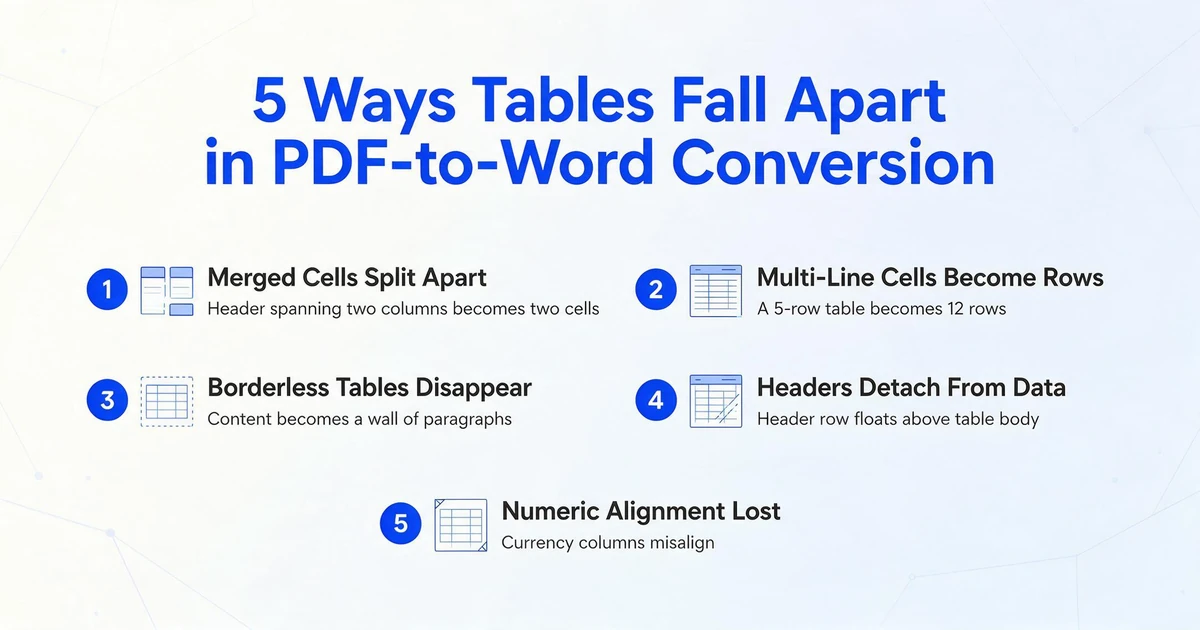
A Mapsoft, empresa de ferramentas de PDF com mais de 30 anos de experiência no formato, publicou uma das raras análises técnicas de exatamente como as tabelas falham durante a conversão de PDF para Word (Mapsoft, 2025). Sua taxonomia de cinco modos de falha recorrentes captura o que os usuários em fóruns vivenciam diariamente:
Esses não são casos isolados. São o resultado previsível de pedir a um software que reconstrua uma estrutura lógica — uma tabela — a partir de um formato de arquivo que nunca a armazenou. E a falha se acumula: quando você abre um documento do Word convertido e descobre que uma tabela de 5 linhas virou 12 linhas com cabeçalhos divididos e colunas desalinhadas, você não está corrigindo um erro. Está corrigindo uma cascata de erros em que o primeiro erro (célula mesclada dividida) torna o segundo (cabeçalhos separados) ainda mais difícil de identificar.
O conselho de produção da Mapsoft é direto: "Para tabelas que importam — demonstrações financeiras, envios regulatórios, tabelas de dados estruturados — não converta do PDF se puder evitar. Obtenha o arquivo de origem em Word, Excel ou CSV." Mas esse conselho só funciona quando você tem o arquivo de origem. Para documentos digitalizados — contratos assinados, relatórios arquivados, artigos de pesquisa cujo arquivo de autoria original se perdeu anos atrás — não há arquivo de origem. A digitalização é a origem.
Como a IA visual lê uma tabela vs. como o OCR tenta adivinhá-la
O gargalo em toda conversão baseada em OCR é a mesma etapa: a reconstrução. O OCR reduz uma tabela a caracteres e coordenadas e, em seguida, pede a um conversor que remonte esses fragmentos em algo que se pareça com o original. O processo é inerentemente destrutivo — as informações sobre a estrutura da tabela (quais células estão mescladas, quais linhas pertencem juntas, quais linhas formam os limites das colunas) nunca foram extraídas em primeiro lugar, então precisam ser inferidas apenas a partir de relações espaciais.
A IA visual — a classe de modelos que alimenta as ferramentas modernas de imagem para dados estruturados — segue um caminho fundamentalmente diferente. Em vez de ler o texto caractere por caractere e depois tentar reconstruir a estrutura pela proximidade das coordenadas, um modelo visual enxerga a página inteira como uma cena visual. Ele entende uma tabela como um humano: reconhecendo que um retângulo com bordas contendo linhas e colunas é uma tabela, que uma célula que abrange duas colunas é uma célula mesclada e que o texto em negrito na linha superior é um cabeçalho — tudo em uma única passada de compreensão visual.
Essa diferença não é incremental. Ela elimina completamente a etapa de reconstrução. O modelo vai de imagem → saída estruturada sem nunca passar pela cascata caractere→coordenada→inferência que torna o OCR frágil. Para tabelas especificamente, isso significa que células mescladas permanecem mescladas, o conteúdo de várias linhas permanece em uma única célula e tabelas sem bordas não desaparecem — porque o modelo viu a estrutura da tabela, em vez de tentar deduzi-la a partir de fragmentos de texto dispersos.
Um benchmark publicado pela IBM Research sobre seu modelo Docling/TableFormer ilustra o teto até mesmo da extração de tabelas por ML especializado: 93,6% de precisão média no benchmark PubTables — impressionante, mas ainda deixando 6,4% das células erradas (Kramer, benchmark de 2025). Ferramentas tradicionais como Tabula e Camelot pontuaram 67,9% e 73,0%, respectivamente, nos mesmos benchmarks. A diferença entre 68% e 94% de precisão é a diferença entre "a maioria das tabelas é utilizável com limpeza" e "a maioria das tabelas está quebrada sem conserto". E a diferença de 6,4% para a perfeição é o motivo pelo qual a arquitetura correta — uma que não fragmenta a tabela antes de tentar entendê-la — importa mais do que melhorias incrementais de precisão dentro de um paradigma quebrado.
Para uma visão completa de como os modelos de visão entendem a estrutura de documentos, consulte nosso explicador sobre como a IA lê e compreende documentos. O insight principal para a preservação de tabelas é que os modelos de visão operam com semântica visual — bordas, alinhamento, espaços em branco, peso da fonte — e não com proximidade de coordenadas. Uma célula mesclada que abrange as colunas A–C parece uma célula mesclada para um modelo de visão, assim como para um leitor humano, porque ambos a percebem como um único objeto visual, e não como fragmentos de texto dispersos que por acaso compartilham a mesma largura de abrangência de colunas.
Passo a Passo: Converter um Documento Digitalizado em Word Editável com Tabelas Intactas
Entender por que as tabelas se quebram é uma coisa. Colocar um documento digitalizado em um arquivo Word editável onde as tabelas realmente funcionam é outra. Veja o processo.
Se o seu documento tem dados tabulares que você precisa extrair e um layout que você precisa preservar, esses são dois problemas diferentes com duas abordagens diferentes. Nosso guia sobre conversão de documentos vs. extração de documentos explica quando usar cada um — e por que converter um documento com muitas tabelas para Word para edição é uma tarefa fundamentalmente diferente de extrair os dados de tabelas para uma planilha para análise.
Os arquivos são processados com segurança e não são armazenados.
O que fazer quando o arquivo de origem original foi perdido
O cenário mais comum para conversão de documento digitalizado em Word é também o mais desamparador: o arquivo original do Word, Excel ou InDesign que gerou o PDF não existe mais. O contrato foi assinado e digitalizado há cinco anos. O relatório financeiro foi enviado por e-mail como PDF por um consultor que deixou a empresa. O artigo de pesquisa existe apenas como fotocópia. Não há "arquivo de origem" para recorrer.
É aqui que a distinção entre OCR e IA visual deixa de ser acadêmica. Com apenas um PDF digitalizado e sem o arquivo original, todo conversor tradicional força você pelo mesmo pipeline de OCR→caractere→coordenada→inferência→reconstrução. A saída terá erros, e esses erros se concentrarão nos elementos do documento — as tabelas — onde a estrutura mais importa. Você gastará mais tempo corrigindo tabelas quebradas do que teria gasto digitando-as do zero, segundo algumas estimativas.
O caminho da IA visual trata o digitalizado como o que ele realmente é: uma fotografia de um documento. O modelo vê a tabela, entende sua estrutura visualmente e a mapeia para o Word. Ele não precisa que o texto seja "selecionável" no PDF. Não precisa do arquivo de autoria original. Não precisa que você diga onde estão as tabelas ou quantas colunas elas têm. Ele só precisa ver a página — a mesma página que você está vendo.
Para uma visão mais ampla de quais ferramentas de conversão lidam melhor com cada cenário de documento, nossa seleção dos melhores conversores de PDF para Word em 2026 cobre todo o panorama, de ferramentas online gratuitas a IA visual — com avaliações honestas do que cada categoria pode e não pode preservar.
Comparando suas opções: conversores tradicionais vs. IA visual
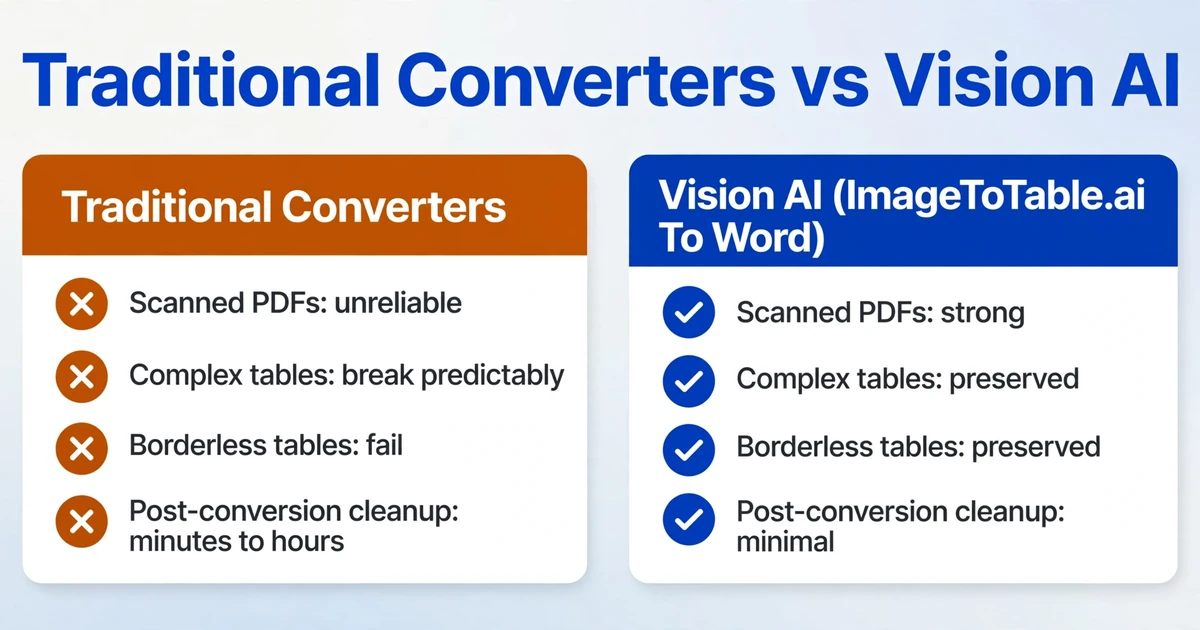
| Recurso | Conversores tradicionais (Adobe Acrobat, Word, ferramentas online) | IA visual (ImageToTable.ai Para Word) |
|---|---|---|
| PDFs digitais (texto selecionável) | Bom — dados de caracteres disponíveis no arquivo | Excelente — enxerga a estrutura completa da página |
| PDFs digitalizados (somente imagem) | Não confiável — a cascata de OCR degrada a estrutura da tabela | Forte — lê diretamente da página visual |
| Tabelas simples (uma linha de cabeçalho, sem mesclagens) | Bom — a inferência básica de grade funciona | Excelente — mapeamento visual direto |
| Tabelas complexas (células mescladas, cabeçalhos multinível) | Quebra previsivelmente — células mescladas se dividem, cabeçalhos se desprendem | Preservadas — enxerga mesclagens como objetos visuais |
| Tabelas sem bordas | Falha — sem pista visual para inferência de grade | Preservadas — identifica o layout tabular pelo alinhamento |
| Layouts de página com várias colunas | Inconsistente — colunas se mesclam ou se dividem de forma imprevisível | Preservados — reconhece o fluxo das colunas |
| Configuração necessária | Nenhuma para conversão simples; seleção de idioma do OCR para digitalizações | Nenhuma — envie, selecione o modo Para Word, processe |
| Limpeza pós-conversão | De minutos a horas, dependendo da complexidade da tabela | Mínima — verifique mesclagens e células com várias linhas |
Os conversores tradicionais têm seu lugar. Se você tem um PDF digital de um documento com muito texto e formatação simples — um memorando, um relatório de coluna única, uma carta — o conversor integrado do Word ou a exportação do Adobe Acrobat provavelmente produzirão um resultado utilizável. Mas no momento em que as tabelas entram em cena, especialmente em documentos digitalizados, o pipeline de reconstrução por OCR se torna o gargalo — e nenhum ganho incremental de precisão do OCR consegue corrigir um paradigma que começa removendo justamente a estrutura que você está tentando preservar.
O guia completo para conversão de documentos em Word com preservação de layout cobre todo o espectro de conhecimento — dos detalhes internos do PDF à seleção prática de ferramentas — e é o hub central deste cluster de tópicos.
Perguntas frequentes
Posso simplesmente abrir um PDF digitalizado diretamente no Microsoft Word?
Você pode tentar, mas o conversor de PDF integrado do Word não consegue extrair texto de um PDF digitalizado porque não há texto no arquivo — apenas uma imagem de texto. O Word abrirá a imagem como uma figura não editável ou produzirá um documento em branco. Você precisa de OCR ou IA visual para extrair texto da imagem digitalizada antes da conversão. Mesmo com OCR, o conversor do Word terá dificuldades com tabelas pelos motivos descritos acima. A conversão de PDFs digitalizados para Word precisa ler a imagem da página antes de conseguir reconstruir uma única célula de tabela, e é por isso que a ferramenta escolhida importa mais aqui do que para arquivos nativos digitais.
O Adobe Acrobat Pro preserva tabelas ao converter PDFs digitalizados para Word?
O Adobe Acrobat Pro inclui OCR integrado que é executado automaticamente antes de exportar para Word. Para tabelas simples, com bordas nítidas e sem células mescladas, os resultados costumam ser aceitáveis. Para tabelas complexas — células mescladas, cabeçalhos de vários níveis, layouts sem bordas — aplicam-se as mesmas limitações de reconstrução por OCR. O Acrobat não consegue ver a estrutura da tabela; ele só pode inferi-la a partir da saída do OCR, e a inferência é frágil.
Qual é a diferença entre o modo "Para Word" e o modo "Para Tabela"?
O modo Para Word preserva o documento inteiro — texto, tabelas, imagens, colunas e formatação — como um arquivo Word (.docx) editável que se parece com o original. É para quando você precisa editar o próprio documento. O modo Para Tabela extrai pontos de dados específicos (como números de nota fiscal ou datas) de um ou mais documentos e os compila em uma planilha. É para quando você precisa analisar dados em vários documentos, não editar um documento. Se o seu objetivo é colocar um documento digitalizado em um formato editável onde as tabelas permaneçam intactas, Para Word é a escolha certa.
O Vision AI consegue lidar com tabelas manuscritas em documentos digitalizados?
O Vision AI consegue reconhecer texto manuscrito e estruturas de tabela, mas a precisão depende da legibilidade da caligrafia. Uma tabela escrita com clareza, com bordas visíveis ou alinhamento consistente, será convertida bem. Anotações rabiscadas em linhas irregulares ou caligrafia muito cursiva serão menos confiáveis. O mesmo princípio de compreensão visual se aplica — o modelo vê a página como você — mas a caligrafia introduz uma variabilidade que o texto impresso não tem.
Quanto tempo leva para converter um documento digitalizado?
Com uma ferramenta de IA visual, processar uma única página digitalizada normalmente leva de 5 a 10 segundos, em comparação com uma média de 3 minutos para redigitar manualmente — um ganho de eficiência de aproximadamente 18x. Para documentos com várias páginas, cada página é processada sequencialmente. Páginas complexas com tabelas densas podem levar um pouco mais de tempo, mas o tempo total ainda será uma pequena fração do que a reconstrução manual exigiria.
Existe uma forma gratuita de converter PDFs digitalizados para Word com as tabelas intactas?
Conversores online gratuitos com OCR (Smallpdf, PDF2Go, Xodo) conseguem extrair texto de PDFs digitalizados, mas a preservação de tabelas é inconsistente e muitas vezes ruim — especialmente para layouts complexos com células mescladas ou tabelas sem bordas. A exportação do Adobe Acrobat Pro produz resultados melhores, mas exige uma assinatura (~$15/mês). As ferramentas de IA visual oferecem um nível gratuito que permite testar a qualidade da conversão nos seus próprios documentos antes de se comprometer.