点検報告書データ抽出の
完全ガイド(2026年版)
5つの現場を同時に運営する請負業者であれば、毎月数百枚の完了済み点検フォームが簡単に蓄積されます。安全パトロール、設備の始業前点検、コンクリート打設の検査、溶接品質記録などです。そのすべてに、合格・不合格のステータスを持つチェックリスト項目、手書きの是正措置メモ、埋め込まれた写真証拠が含まれており、最終的にはコンプライアンスダッシュボードやCMMSに反映させる必要があります。このガイドでは、点検報告書データ抽出の全体像を解説します。これらのフォームが請求書や発注書とどう違うのか、従来のOCRがなぜ不十分なのか、業界を問わず重要となるフィールドは何か、そしてそれらを処理できると謳うツールをどう評価すべきかについて説明します。
点検報告書のデータ抽出とは
点検報告書のデータ抽出とは、記入済みの点検フォーム(クリップボードに手書きで記入された印刷チェックリスト、モバイル点検アプリからのPDF書き出し、スキャンした複数ページの冊子など)を、分析・保存・コンプライアンスや保守システムへの連携が可能な構造化された行と列に変換する自動化プロセスです。
請求書や発注書とは異なり、点検報告書は主に金額に関するものではありません。重要なのは状態の分類です。チェックリストの項目は合格か不合格か、指摘事項は未解決か解決済みか、チェックボックスはチェック済みか空欄か。データの価値は個々の数字よりもパターンにあります。どの資産が最も頻繁に不合格になるか、どの点検員が最も多くの指摘事項を報告するか、どの現場で四半期を通じて安全上の問題が繰り返し発生するか、といったことです。
点検報告書は幅広い業界と形式にわたります。
- 建設現場の安全パトロール — 日次の危険源点検(OSHA 1926)、クレーン使用前点検、足場点検、閉鎖空間入場許可証(建設現場の安全点検ワークフローをご覧ください)
- 製造業のQC点検 — 初品検査、工程内寸法チェック、最終品質監査、ISO 9001で要求される検査記録
- 施設の安全点検 — 消火器の月次点検(NFPA 10)、非常灯の試験(NFPA 101)、洗眼器の週次確認(ANSI Z358.1)
- 車両点検 — DOT運転者車両点検報告書(DVIR)、予防保守点検、フォークリフトの日次点検(OSHA 1910.178)
- 飲食店の衛生点検 — HACCP温度記録、衛生チェックリスト、害虫駆除点検記録、アレルゲン交差汚染確認フォーム
- 設備保守点検 — 振動分析レポート、サーモグラフィー点検記録、潤滑ルートチェックリスト
これらすべてに共通する抽出の課題は同じです。ページ上の情報は、印刷されたラベル、手書きの値、手描きのチェックマーク、チェック済みのボックスや丸で囲まれた回答、埋め込まれた写真が混在しており、そのレイアウトはフォームの設計者や現場、時には点検員によって異なります。印刷されたテキストだけを読み取るシステムでは、データの半分を見逃してしまいます。
核心的な洞察: 点検報告書の抽出は文字認識の問題ではありません。構造分類の問題です。AIはフォーム上のどの項目が互いに関連しているか、ボックスがマークされているか空欄かを理解し、余白の手書きメモがどのチェックリスト項目に対する注釈なのかを判断する必要があります。これは、請求書から日付や金額を抽出するのとは根本的に異なる技術要件です。
手作業による点検報告書処理が高コストな理由
手作業による点検報告書処理の最も目に見えるコストは、紙のデータをスプレッドシートやCMMSに入力するのにかかる時間です。点検フォームは通常の文書よりも入力に時間がかかります。各行で項目を探し、ステータスを読み取り、所見と是正措置を入力する必要があるからです。手作業での入力が通常1ページあたり3分かかるとして、週に50件の報告書を処理する施設では、データ入力に週約2.5時間を費やします。1年では約130時間、つまりフルタイム勤務の3週間以上に相当します。
しかし、タイピングにかかる時間はコストの中で最も小さい部分です。より大きなコストは、報告書が紙やスキャンしたPDFのまま残っている場合に複合的に発生する3つのカテゴリに隠れています。
1. 見逃された点検所見とコンプライアンスのギャップ
点検報告書は、何を確認したかの記録ではありません。何が見つかったかの記録です。報告書の価値は所見にあります。つまり、不合格となった項目、指摘された不備、割り当てられた是正措置です。点検結果が紙のままだと、時間と場所をまたいだ所見のパターンは、誰かがすべてのページを手作業で読み、結果を集計するまで見えません。
5つのサイトから週20件の点検報告書を受け取る安全管理者は、データセットを構築するために午後を費やさなければ、サイト3のロックアウト/タグアウト違反が3か月間増加し続けていることに気づけません。パターンが発見される頃には、コンプライアンスのギャップはすでに四半期分拡大しています。そして、苦情や記録すべきインシデントをきっかけにOSHAの査察が行われる場合、完全で整理された点検記録を数日ではなく数時間で提出できる能力は、利便性ではなく規制要件です。
OSHA 29 CFR 1910および1926は、使用者に対し、「職場、材料、および機器の頻繁かつ定期的な点検」(1926.20)を有資格者が実施することを義務付けています。それらの点検記録は、要求に応じて提出できなければなりません。ファイルキャビネットに積まれたクリップボードのチェックリストは、要件の文言は満たしていますが、その意図を満たしていません。データは、誰かが転記するまで検索できず、分析できず、実行可能でもないからです。
2. 監査準備の労力
ISO 9001認証を取得している組織、OSHAに準拠している組織、またはFDA、FAA、DOTの規制を受ける組織は、定められた期間、点検記録を保持する必要があります。例えばISO 9001:2015監査では、点検・試験記録(条項8.5.1および8.6)が存在し、完全であり、検索可能であることを組織が実証することが求められます。OSHAの調査では、5年分の点検ログ(OSHA 300)— または30年分の従業員ばく露記録 — の提出を要求されることがあります。
監査シーズンが到来すると、紙の点検報告書が5,000枚ある企業は、単純な算数の問題に直面します。各報告書を日付、サイト、種類ごとに特定し、保管場所から取り出し、完全性を検証し、是正措置と所見を照合する作業は、記録準備を数日がかりの仕事に変えます。複数のサイトを運営する工場では、労力は直線的に増加し、生産コストとは異なり、監査準備には収益の相殺効果は一切ありません。
3. 手動チェックリスト再入力とそのエラー
最も厄介なコストは、進歩しているように感じられるもの、つまり報告書をスプレッドシートに入力してデジタル化することです。完了したチェックリストを再入力することは、見落としやすい形でエラーが発生しやすくなります。チェックマークが1つ上の行に入ってしまう、誤って「合格」と入力された「不合格」、間違った項目に添付されたコメントなどです。30項目のチェックリスト項目(それぞれにステータス(合格/不合格/該当なし)とコメントがある)を持つ点検フォームでは、エラーの発生余地は非常に大きく、1つのチェックマークの位置ずれが誤ったトレンドデータに連鎖します。
毎月200件の点検記録をSAP PMやIBM MaximoなどのCMMS(コンピュータ化保守管理システム)に入力している施設保守管理者を考えてみましょう。控えめに見積もっても3%のエラー率と仮定すると、毎月6件の誤った記録が発生することになります。合格した設備が不合格と表示されたり、是正措置が誤った資産に割り当てられたり、合格率が実際よりも低く見えたりします。各エラーは発見して修正するのに時間がかかり、中には決して発見されず、数か月から数年にわたって保守データセットを静かに劣化させるものもあります。
手動処理の計算: 1件あたり3分 × 週50件 = 単一施設で年間約130時間のデータ入力。さらに監査準備、エラー修正、所見分析が加わります。自動抽出により、その入力時間は機械処理時間に変わります。
点検報告書の抽出に特有の主要な課題
点検報告書は、請求書や発注書、その他のビジネス文書とは異なり、データ抽出を根本的に難しくする特徴があります。これらの違いを理解することは、適切なアプローチを選択または評価するために不可欠です。
1. チェックボックス / ラジオボタン / チェックマーク認識
これは点検報告書の抽出における最も重要な技術的課題であり、ほとんどの汎用文書抽出ツールが解決に失敗している点です。
点検フォームは、チェックリスト項目をリストまたはテーブルとして提示し、各行に項目の説明と状態インジケータ(通常は点検者が合格、不合格、該当なしを示すためにマークするチェックボックス)を含みます。マークはチェックマーク(✓)、×(✗)、塗りつぶした円(●)、丸で囲んだ回答、取り消し線の場合があります。濃くてはっきりしている場合もあれば、薄い場合、印刷されたチェックボックスの枠線に重なっている場合、ボックス内ではなく脇の余白に走り書きされている場合もあります。
従来のOCR(テキスト形状の検出により文字を抽出する技術)は、これらのマークを読み取ることができません。チェックされたボックスはテキストではありません。それは空間的なマークであり、その意味は存在するかしないかに依存し、それが表す文字には依存しません。点検フォームをスキャンするOCRエンジンは、チェックボックス領域を完全に無視するか、せいぜいノイズ(ページ上の迷い線)として報告するだけで、意味的解釈は行いません。
一方、Vision AIは人間と同じようにチェックボックスを解釈します。ボックスを認識し、その中にマークが存在するかどうかを判断し、ステータスをチェック済み(合格)、交差(不合格)、空(未チェック / 該当なし)として分類します。OCRシステムはボックスがチェックされたかどうかを教えてくれません。なぜなら、そのように設計されたことがないからです。より優れたOCRでもこのギャップを埋めることはできません。それはこの作業には適さない種類のツールです。点検報告書の抽出への影響は明確です。OCRのみに依存するツールは、チェックボックスまたはラジオボタンを使用するフォーム(事実上すべての点検フォーム)に対して不正確な結果を生成します。
2. 手書きメモと印刷チェックリストの混在
点検帳票には、印刷データだけが記載されていることはほとんどありません。点検者は所見を書き込み、余白に是正措置を走り書きし、「不良」ラベルを丸で囲み、下部に署名と日付を記入します。文字は、きれいなブロック体から現場の速記体まで様々で、多くの場合、印刷されたチェックリスト表の周囲の限られた余白に書かれます。
点検帳票から手書き文字を抽出するには、AIが印刷された帳票の文字と手書きの追記を区別し、各手書きメモを正しいチェックリスト項目に関連付ける必要があります。項目17の横に走り書きされたメモは、その上の項目16や下部の総評欄ではなく、項目17にリンクされなければなりません。この空間的な関連付けは、人間の読者は無意識に行いますが、OCRベースの抽出では、ページ上のすべてのテキストをフラットなストリームとして扱うため、完全に失われてしまいます。
手書き文字認識自体は近年大幅に向上しています。現代のAIベースの手書き文字認識(HTR:Handwritten Text Recognition)は、特に筆跡が一貫しており、帳票が各回答欄に明確な境界を提供している場合、筆記体をかなりの精度で読み取ります。しかし、点検報告書にとってより難しい課題は関連付け、すなわち、近接性とレイアウトの手がかりの両方を用いて、どの手書きメモがどのチェックリスト行に属するかを把握することです。
3. PDFレポートに埋め込まれた写真
多くの点検報告書(特に建設現場のウォークスルー、不動産状態評価、設備点検記録)には、証拠として写真が含まれています。安全点検報告書には、危険、違反、是正後の状態、設備の状態を記録した10~30枚の写真が含まれることがあります。これらの写真は、テキストのチェックリストとともにPDFレポートに埋め込まれています。
データ抽出において、埋め込まれた写真は2つの問題を引き起こします。第一に、写真自体に記録すべき情報が含まれている可能性があります。例えば、溶接部のひび割れ、腐食した配管、無防備なベルト駆動装置の写真は、所見の要約に記載されるべき特定の故障を記録しています。テキストのみの抽出システムは、所見の文章による説明を取得しますが、点検者が決定的な記録とみなした視覚的証拠を見逃します。
第二に、より実用的な問題として、埋め込まれた写真は、「抽出するコンテンツ」と「保存する視覚的証拠」を区別するように訓練されていない抽出ツールを混乱させる可能性があります。PDF内のすべての画像からテキストをOCRで読み取ろうとするツールは、写真の内容から誤った読み取りを生成し、例えば写真内の配管ラベルをチェックリスト項目として解釈する可能性があります。
4. マルチセクション・マルチページフォーム
点検報告書が1ページだけで完結することはほとんどありません。大規模な施設点検では、一般情報(サイト、日付、点検者)、安全点検チェックリスト、設備別チェックリスト、指摘事項の要約、是正措置計画、署名欄など、5〜15ページにわたって異なるセクションが含まれるのが一般的です。各セクションには独自のレイアウト、独自の回答形式、そして報告書全体との独自の関係性があります。建設業界の支払申請書であるAIA G702/G703フォームも同じ親子構造を共有しています。詳細な続紙から集約されるサマリーページという構造であり、抽出の原則も同じです。
マルチセクションフォームからのデータ抽出では、各ページのテキストを独立して読むだけでなく、文書の構造を再構築する必要があります。7ページ目の「電気安全」の項目に記載された指摘事項は、1ページ目に記録された同じ点検セッションに紐付ける必要があり、9ページ目に記載された是正措置の期限もその指摘事項に紐付ける必要があります。この構造理解こそが、本格的な抽出ツールとページ単位のOCRビューアを分けるポイントです。
同じ問題のより一般的なバージョンもあります。報告書が別々の画像として届くケースです。12ページの施設点検が1ページずつスキャンされたり、両面チェックリストが表面・裏面で撮影されたり、下請け業者が各シートを個別ファイルで送ってきたりします。単純に抽出すると、1件にまとめたいところが12行になってしまいます。マルチページマージはこれをテンプレートレベルで処理します。追跡対象の列の値が変わるたびに新しい報告書を開始する(新しいサイト、新しい点検日)か、バッチ全体で参照番号を共有するすべてのページを照合するか、固定数のアップロードをグループ化するか、ページのグループ化方法を指定します。AIは一致するページを1行に統合します。フィールドはそれを保持するページから入力され、サイトIDのような繰り返し値はすべての明細項目に引き継がれ、2つのページで異なる方法で記録されたフィールドは、最初の値・最後の値・連結・分割のいずれかで解決されます。バラバラのページをアップロードすれば、統合された報告書がスプレッドシートに反映されます。
5. 規制コンプライアンスの複雑さ
業界、規制機関、点検の種類によって、記録・保存すべき内容に関する要件は異なります。あるコンプライアンス体制で機能する抽出ツールでも、別の体制では必須項目を見落とす可能性があります。
以下の表は、点検報告書の抽出が対応すべき主要なコンプライアンスフレームワークをまとめたものです。
| フレームワーク | 適用対象 | 主要な点検記録要件 | 保存期間 |
|---|---|---|---|
| OSHA 29 CFR 1910 | 一般産業(製造、倉庫、施設) | ロックアウト/タグアウト点検(1910.147)、フォークリフト日常点検(1910.178)、PPEアセスメント(1910.132)、有害物質コミュニケーション計画 | 5年間(OSHA 300ログ); 30年間(ばく露・医療記録) |
| OSHA 29 CFR 1926 | 建設 | 有資格者による点検(1926.20)、クレーン点検(1926.1412)、足場点検、掘削作業の日常点検(1926.651) | 5年間(OSHA 300ログ); プロジェクト期間+所管基準で定められた保存期間 |
| NFPA 25 / NFPA 101 | 防火、生命安全 | 火災スプリンクラー点検(NFPA 25)、消火器の月次点検(NFPA 10)、非常照明テスト(NFPA 101)、非常口標識の点検 | 同種の次回点検から1年間; 受入記録はシステムの存続期間 |
| ISO 9001:2015 | 品質マネジメントシステム | 検査・試験記録(条項8.5.1、8.6)、不適合・是正処置記録(条項10.2.2)、校正記録(条項7.1.5) | 組織の文書保存方針に基づく(通常3〜7年間) |
| FDA 21 CFR Part 117 / HACCP | 食品加工、食品サービス | 衛生モニタリング記録、温度管理ログ、アレルゲン交差汚染の検証、是正処置記録 | 2年間(製品の賞味期限と同等以上) |
| DOT / FMCSA | 商用車両フリート | 運転者車両点検報告書(DVIR)、年次車両点検、定期整備記録 | 90日間(原本のDVIR); 14ヶ月間(年次点検報告書) |
抽出への影響として、ツールがフィールドレベルの意味的な区別を尊重しなければならないことが挙げられます。DOT DVIRの「点検者名」フィールドは、QA初回品点検の同じフィールドとは規制上の重みが異なります。データは同じでも、その保存と形式を規定するコンプライアンスフレームワークは異なるのです。
従来の方法とAI抽出の比較:点検報告書の場合
点検報告書の抽出が、例えば請求書処理とは根本的に異なる技術的アプローチを必要とする理由を理解するには、各手法が何を処理できて何を処理できないかを直接比較するのが早道です。
従来のOCRが点検フォームで失敗する理由
OCR(光学文字認識)は、テキスト画像を機械が読み取れる文字に変換します。ファックスで送られた注文書やタイプされた契約書など、明確で均一な文字の印刷文書には有効です。しかし点検フォームでは、OCRは3つの構造的な限界に直面します。
- チェックボックス内にテキストがない。チェック済みのボックスには、OCRが認識できる文字がありません。システムはそれを無視するか、実装によっては空文字列を返すだけです。どちらにせよ、項目の状態はわかりません。
- 構造を認識しない。OCRはテキストを読み順(上から下、左から右)で抽出します。項目4の状態チェックボックスが項目説明の左側にあり、項目5のチェックボックスが右側にあるようなチェックリスト表では、状態と説明が互いに関連付けられずに混在したテキストストリームが生成されます。どの状態がどの項目に属するかを再構築するには後処理ロジックが必要ですが、ほとんどのOCRツールには含まれていません。
- 手書き文字に対応できない。標準のOCRエンジンは印刷文字で学習されています。筆記体の手書き文字は、きれいな筆記体であっても、文字単位の認識エラーが発生し、出力が使い物になりません。手書き文字専用のOCRも存在しますが、複雑さとコストが増し、それでもフィールドとの関連付けには苦労します。
Vision AIがテンプレートなしで点検報告書を読み取る仕組み
Vision AI — 具体的には、画像を全体的に理解するビジョン大規模モデル(VLM)クラスのAI — は、点検フォームの処理方法が異なります。ピクセル座標でテキストを探したり、すべての文字をOCRしようとしたりするわけではありません。代わりに、文書全体を1つの視覚的なシーンとして解釈します。フォームの構造を特定し、各チェックリスト項目を特定し、ステータス表示のマークを検出し、関連する手書き文字を読み取り、すべてを行ごとに構造化された出力にマッピングします。
AIが25項目の点検チェックリストを見ると、暗黙的に次のことを行います。テーブルまたはリスト構造があることを特定し、項目ラベルをステータスフィールドやコメント列から分離し、各ステータス表示をチェック済みか未チェックかに分類し、手書きの是正措置メモを正しい行に関連付けて読み取り、各行が1つのチェックリスト項目とそのステータスおよびコメントであるテーブルを生成します。
これが文字認識と文書理解の違いです。AIはすべてのピクセルを読み取ろうとしているのではなく、フォームの意図を理解しようとしています。つまり、点検者がどの情報を記録したか、どこに記録したか、そしてそれが何を意味するかです。
Vision AIが従来の文書処理アプローチとどう異なるかについての詳細は、メーター読み取り抽出の完全ガイドをご覧ください。このガイドでは、メーターやゲージのフォームに適用された同じパラダイムを説明しています。これは、従来のOCRでは不十分なもう1つの文書タイプです。
直接比較:各手法の概要
| 手法 | チェックボックス(チェック済み/未チェック)の読み取り | 手書き文字の読み取り | 埋め込み写真の処理 | 複数セクション構造の維持 | フォームタイプごとの設定 |
|---|---|---|---|---|---|
| 手動データ入力 | ✓ | ✓ | ✓(手動レビュー) | ✓ | 不要 |
| 従来のOCR | ✗(マークを検出できない) | ✗ | ✗(画像を無視または誤認識) | ✗(フラットなテキストストリーム) | フォームレイアウトごと |
| テンプレート / ゾーンOCR | ✗(固定ゾーンはフォームのバリエーションで破綻) | ✗(アドオンで部分的に対応) | ✗ | 部分的(ゾーン単位) | フォームテンプレートごと |
| モバイル点検アプリ | ✓(アプリネイティブのデジタルフォーム) | ✓(デジタル入力) | ✓(アプリネイティブの写真撮影) | ✓ | フォームごとにアプリ設定 |
| Vision AI写真抽出 | ✓ | ✓ | ✓(証拠として保存) | ✓(フォーム構造を理解) | 不要(ゼロ設定) |
モバイル点検アプリ(SafetyCulture / iAuditor、Fulcrum、ProntoForms、GoCanvas)は有力な代替手段です。紙の帳票を完全に廃し、構造化データをネイティブに取得するデジタルチェックリストに置き換えます。点検プログラムをゼロから構築する組織には最適な選択肢です。しかし、既存の紙の問題は解決しません。5,000枚の完了済み点検票がファイルキャビネットにある場合や、下請け業者が紙のチェックリストを提出し、それをデジタル化しなければならない場合、モバイルアプリは役に立ちません。Vision AI抽出がそれを解決します。紙の帳票をそのまま読み取り、モバイルアプリが取得時点で生成したであろう同じ構造化出力を生成します。
実用的な違い:モバイル点検アプリは紙の発生を防ぎます。Vision AI抽出は既存の紙を変換します。ほとんどの組織は両方を必要とします。新規点検にはアプリを、バックログや外部からの報告書には抽出を。
点検報告書から抽出すべき重要項目
点検報告書は業界や目的によって大きく異なりますが、重要な項目は一貫したパターンに従います。以下の表は、完全な点検報告書抽出で取得すべき標準的なデータポイントのセットを定義しています。
| 項目グループ | 項目 | 説明 | 例 |
|---|---|---|---|
| ヘッダー | 点検日 | 点検が実施された日付 | 2026-06-15 |
| 点検者名/ID | 点検を実施した担当者 | J. Rodriguez (Cert #8172) | |
| 現場/資産/場所 | 点検が行われた場所 — 建物名、資産タグ、車両VIN、機器ID | ボイラー室B、資産BR-0042 | |
| チェックリスト項目 | 項目番号 | 行またはチェックリスト項目の識別子 | 14 |
| 項目説明 | 点検対象 — チェックリストの質問または基準 | 緊急洗眼器 — 週次フラッシュテスト実施 | |
| ステータス | 合格/不合格/該当なし/未確認 — チェックボックスまたはラジオボタンのマークから判定 | 合格 (✓) | |
| 所見/観察 | 点検者の記入メモ — 観察された内容、状態に関するコメント | 水圧低下 — フラッシュ持続時間わずか12秒 | |
| 是正措置/推奨事項 | 所見に対処するために必要な措置と期限 | 配管工による配管点検 — 6/22までに完了 | |
| サマリー | 総合結果 | 合格/不合格/条件付き合格 — 点検全体の結果 | 条件付き合格(所見3件、うち重大2件) |
| 署名 | 点検者署名 | 点検者および/または確認者による署名済みの承認 | 電子的に取得またはスキャンされた署名画像 |
これらのフィールドは、カスタム列抽出をサポートする抽出ツールで列テンプレートとして定義できます。抽出したいフィールド名を入力すると、AIが各フィールドの意味を意味論的に理解してフォーム上の各値を特定します。ピクセル座標の照合ではありません。このアプローチは、AIがフィールドの意味(チェックリスト項目の説明、ステータスマーカー、観察メモ)を探すため、異なるフォームレイアウトでも機能します。ページ上の位置ではありません。
指摘の重大度や是正措置の期限フィールドは、推論列の例です。重大度レベル(Critical / Major / Minor)はフォームに明示的にラベル付けされていない場合もありますが、検査員のメモや指摘の性質から推論できます。検査員が手書きで「URGENT — 至急修正」と指摘の横に書いた場合、AIはそれを読み取り、フォームに専用の重大度チェックボックスがなくてもCriticalに分類できます。同様に、是正措置メモに記載された期限(「06/22までに完了」)を抽出して、別の期限列に配置できます。
複数のサイトで検査データを管理している組織では、フォームのレイアウトに関係なく、同じ列テンプレートがすべてのレポートに適用されます。Site/Asset列とInspection Date列は、それらのフィールドがすべてのレポートから一貫して抽出されている限り、フィルタリング、トレンド分析、コンプライアンスレポートの複合キーになります。
抽出は、各値が信頼できなければ意味がありません。検査業務こそ、それが最も重要です。Pass/Failの読み取りミスが1つあるだけで、または間違ったチェックリスト行に添付された是正措置メモが1つあるだけで、コンプライアンスのトレンドが静かに歪みます。レビューモードは、チェックを理論ではなく実践的なものにします。抽出されたセルにホバーすると、元のスキャン済みフォームで値の出所が正確にハイライトされます。リンクは双方向なので、画像上の領域をクリックするとテーブルの該当行にジャンプします。レビュアーがフィールドを修正した場合、1クリックでAIの元の読み取り値に戻せるため、変更は追跡可能なままです。12ページのレポートを読み直して抽出をスポットチェックする代わりに、重要な行を開いてページと照合して確認できます。
バッチ処理:複数拠点の報告書からコンプライアンスダッシュボードへ
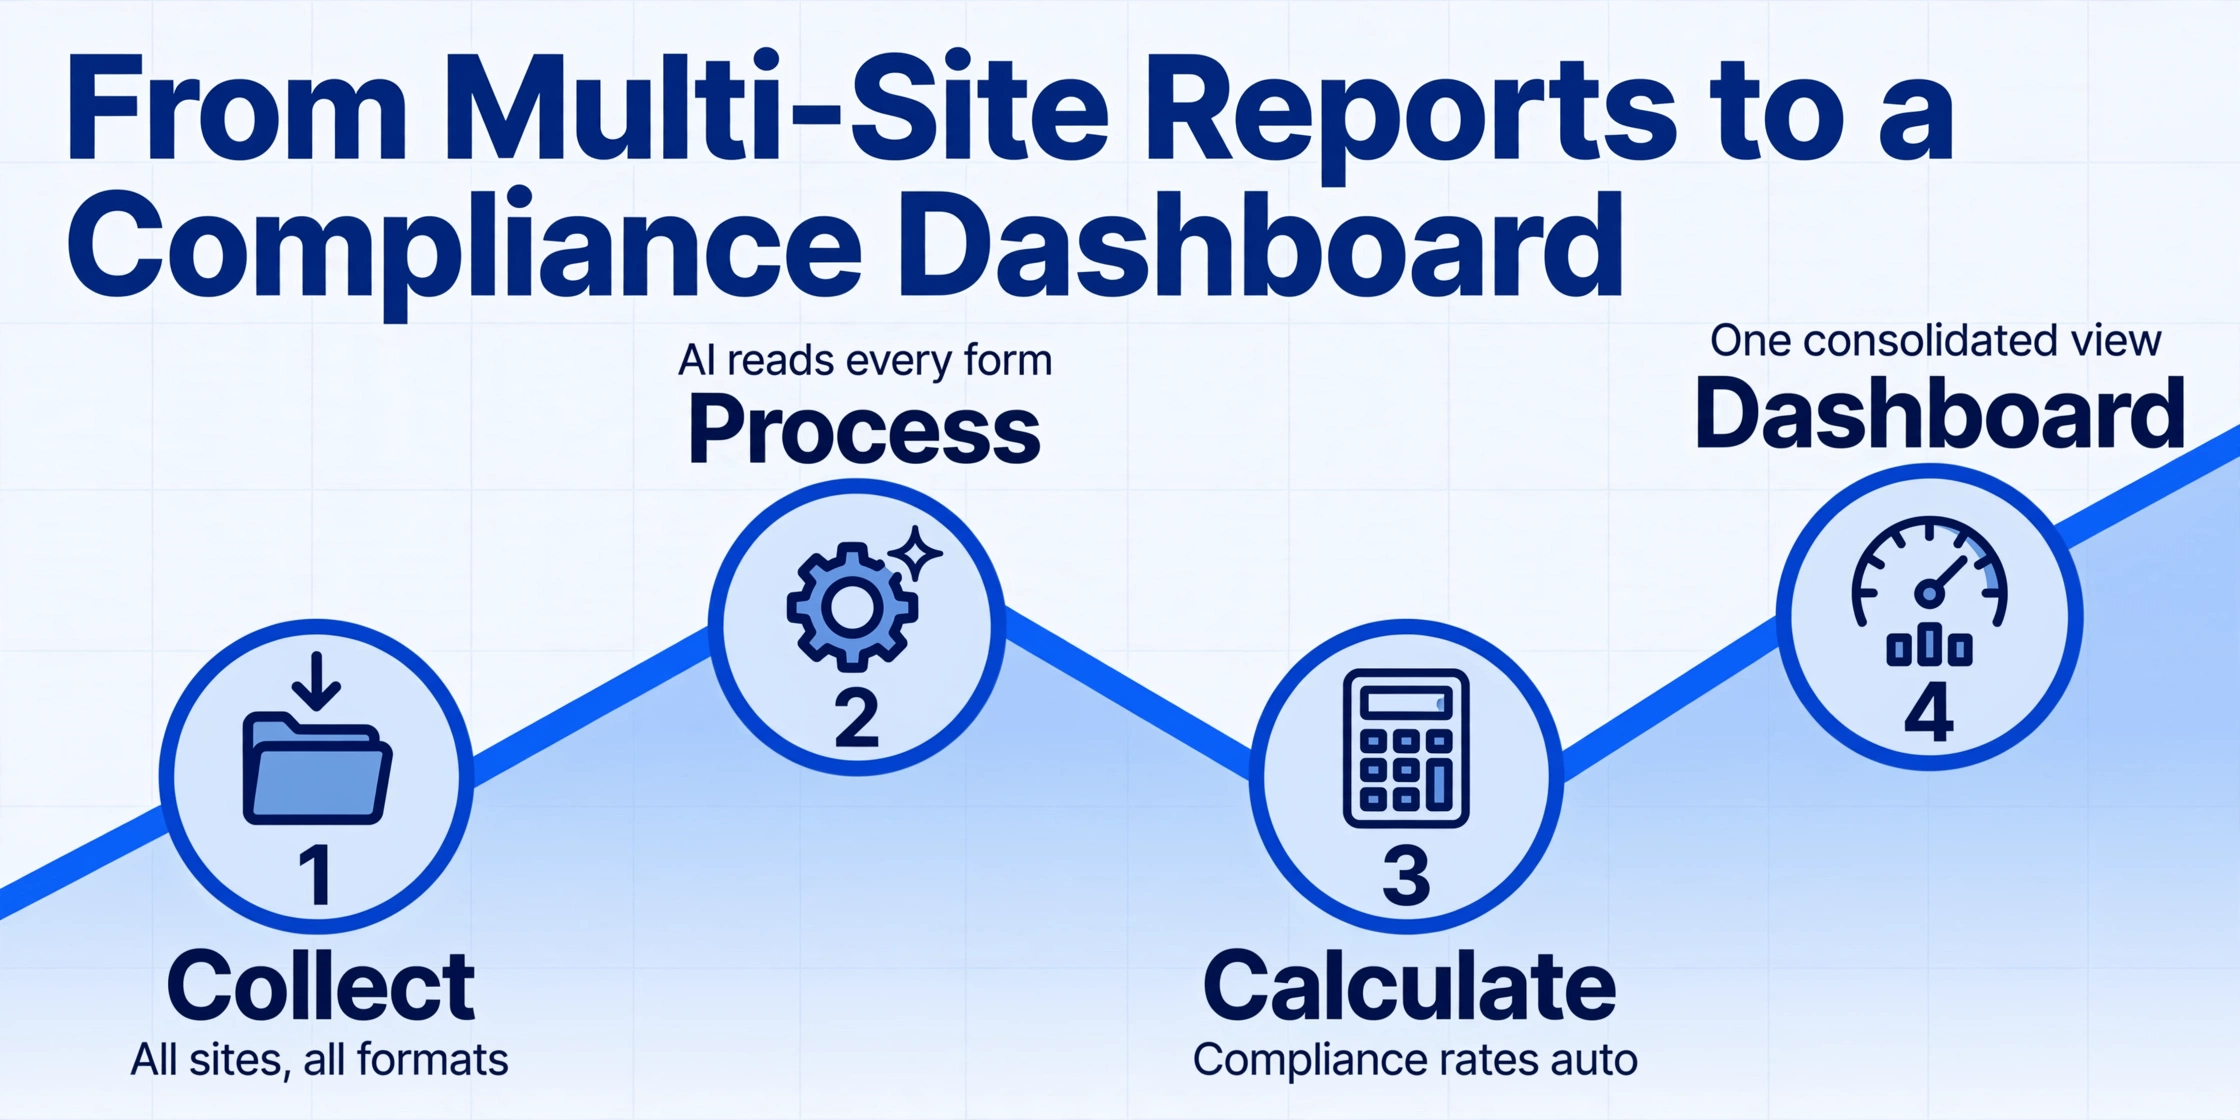
検査データを抽出できるツールと、実際に時間を節約できるツールの違いは、バッチ処理にあります。検査フォームを1枚読み取って出力ファイルを1つ得るのはデモにすぎません。5つの異なる拠点から50枚の検査フォームを読み取り、1つの統合スプレッドシートを得る——それがワークフローです。
バッチでの点検報告書抽出は、次のように機能します:
- 報告書の収集。記入済みの検査フォームは、スキャンした紙のチェックリスト、モバイル検査アプリからのPDF書き出し、記入済みフォームの写真が添付されたメールなど、あらゆるソースから集められます。フォーマットやソースに関係なく、1つのフォルダ、受信トレイ、またはアップロードキューに蓄積されます。
- バッチアップロード。すべての報告書がまとめてアップロードされます——1回のドラッグ&ドロップ操作で20〜200ファイル。システムはこれらを、検査期間またはプロジェクト名でラベル付けされたバッチにグループ化します。
- 一括AI処理。同じ列テンプレートがすべての報告書に適用されます。AIは各フォームを個別に読み取り、フォーム構造を識別し、チェックリスト項目とステータスを抽出し、報告書ごとに1行を生成します(複数のページに分かれて届いた報告書は、まず1行にまとめられます)。拠点間のフォームレイアウトの違いは問題になりません。AIはテンプレート照合ではなく、理解によって読み取るからです。
- 計算列によるコンプライアンススコアの算出。テンプレートに「合格率」や「未解決指摘件数」などのフィールドが含まれている場合、これらは計算列を使用して抽出中に自動計算されます。たとえば、「コンプライアンス率」フィールドが合格項目の割合を総項目数で割ったものとして定義されている場合、報告書ごとに計算され、バッチ全体で集計されます——そのため、出力には報告書ごとのコンプライアンススコアとサイト全体の平均の両方が含まれます。
- 1つのファイルに書き出し。バッチ全体が、検査報告書ごとに1行(または詳細分析用にチェックリスト項目ごとに1行)の単一のExcelファイルとして書き出されます。列には、抽出されたすべてのデータに加えて、計算されたコンプライアンス指標が含まれます。
その結果、以前は毎週丸1日かけて検査報告書を転記し、紙からコンプライアンス率を計算していた安全管理者が、今では報告書をアップロードし、AI処理に10〜15分待つだけで、次のことがわかるスプレッドシートを開けます:どの拠点が90%のコンプライアンス基準を下回っているか、どの検査項目が全拠点で最も頻繁に不合格になっているか、どの検査員が一貫して最も多くの指摘を報告しているか、どの是正措置が期限を過ぎているか。複数の工事現場にわたるこの同じバッチワークフローの建設業向けの詳細な手順——OSHA 300/300A記録管理を含む——については、複数の工事現場からの建設検査報告書のバッチ処理に関するガイドをご覧ください。
当社の現場・産業用ドキュメント抽出ツールのベスト総まとめでは、検査および現場データのこの種のバッチワークフローをサポートするプラットフォームを、フォームタイプと写真条件にわたる実際のテスト結果とともに紹介しています。
エクスポートと統合:データをアクションを起こすシステムへ
抽出された点検データは、是正措置が管理され、コンプライアンスが追跡され、メンテナンスがスケジュールされるシステムに届いて初めて価値を生みます。統合の方法は、対象システムと運用規模によって異なります。
ExcelおよびCSVエクスポート
ほとんどの中小規模の運用では、抽出された点検データはExcelまたはCSVにエクスポートされ、CMMSまたはコンプライアンス追跡ツールに手動でインポートされます。これは月に数百件までのレポートを処理する施設で有効です。エクスポートには、レポートごとに1行の全抽出フィールドに加え、コンプライアンス率や指摘件数の計算列が含まれます。列ヘッダーは対象システムのインポート形式に合わせて設定されているため、インポート手順は直接マッピングするだけで、手動での再フォーマットは不要です。
Google Sheetsアドオン
Google Sheetsで点検データを管理しているチーム向けに、ImageToTable.aiはGoogle Sheetsサイドバーアドオンを提供しています。スプレッドシート内から直接点検レポートをアップロードし、抽出結果をアクティブなシートに追加できます。これにより、エクスポートとインポートの手順が完全に不要になります。点検データは、コンプライアンスダッシュボードや月次安全レビューに使用される同じシートに直接反映されます。
CMMSおよびEAM統合
大規模な産業運用では、通常、設備点検のシステムオブレコードとしてCMMS(コンピュータ化保守管理システム)またはEAM(エンタープライズ資産管理)プラットフォームを運用しています:
- SAP PM(プラントメンテナンス)は、点検計画、保守オーダー、設備履歴を管理します。紙のフォームから抽出された点検結果は、SAPのバッチデータ移行ツール(トランザクション
LSMWまたはCG3Z)または標準のPM通知ワークフローを通じてアップロードできます。是正措置が必要な抽出された指摘事項は、PM通知または保守オーダーに直接マッピングされます。 - IBM Maximoは、検査/テストモジュールを通じて設備点検を管理します。抽出されたデータ(チェックリスト項目ごとの合格/不合格ステータス、観察メモ、是正措置の割り当て)は、最小限の変換でMaximoの点検結果レコードにマッピングされます。
- Fiix、UpKeep、Maintenance Connectionは、点検データ取り込み用のCSVインポートとREST APIエンドポイントを提供しています。バッチのレポートから抽出された結果は、API経由で自動インポートをスケジュールできます。
- Procore(建設)およびCorrigo(施設管理)は、それぞれのAPIまたはファイルインポート機能を通じて点検データを受け入れ、紙のレポートのパンチリスト項目や指摘事項をデジタルプロジェクト管理ワークフローに取り込むことができます。
ほとんどの組織にとって実用的な統合パターンは次のとおりです:AIで点検レポートを抽出 → 対象システム用にフォーマットされたCSVにエクスポート → システムのバッチアップロードインターフェースでインポート。これにより、カスタムAPI開発を回避しながら、アクションを起こす保守およびコンプライアンスシステムに構造化データを届けることができます。
点検報告書抽出ツールに求めるべき条件
すべてのデータ抽出ツールが点検報告書を効果的に処理できるわけではありません。点検フォームに重要な基準 — チェックボックス、手書き文字、写真添付、複数セクションのフォーム — は、請求書やレシートに重要な基準とは異なります。以下は評価のための実用的なチェックリストです:
これらの基準を満たすツールの詳細な比較については、製造業向けベスト文書抽出ツール2026のまとめをご覧ください。このまとめでは、生産環境におけるQC点検フォーム、チェックリスト、コンプライアンス文書の処理能力に基づいてプラットフォームを評価しています。
点検報告書データ抽出に関するFAQ
AIは点検フォームのチェック済みチェックボックスと未チェックのチェックボックスを区別できますか?
はい、ただし従来のOCRではなくVision AIのみが可能です。ビジョンモデルはチェックボックス領域を視覚的に解釈し、記入済み(チェック、×印、丸印)か空欄かを分類します。OCRベースのシステムは、チェックボックスに認識できる文字が含まれていないため、この区別ができません。ツールを評価する際、これが最も重要な質問です:チェックボックスを視覚的に理解できるか、それともテキスト認識のみに依存しているか?
AIは印刷テキストだけでなく手書きの点検メモも処理できますか?
最新の手書き文字認識(HTR)は大幅に向上しましたが、その精度は筆記者と画像に大きく依存します:平らなスキャン上の整ったブロック体は、腕を伸ばして撮影した写真内の現場速度の筆記体よりもはるかに確実に認識されます。より困難な課題は、手書きメモを正しいチェックリスト項目に関連付けることであり、特にメモが専用のコメント欄ではなく余白や行の間に書かれている場合です。優れた点検抽出ツールは、認識と関連付けの両方を個別のステップではなく抽出プロセスの一部として処理します。重要な指摘事項については、抽出されたテキストを元のフォーム画像と常に照合してください。各値がページ上のどこから取得されたかを強調表示するレビューモードがあれば、それが迅速にできます:フォーム全体を読み直す代わりに、重要なフィールドだけを確認できます。
ツールはPDF点検報告書に埋め込まれた写真からデータを抽出できますか?
ツールによって異なります。一部の抽出システムは埋め込み画像を完全に無視し、視覚的証拠を失います。他のシステムは画像内のテキストをOCR処理しようとし、写真に写った機器ラベルや標識から誤った読み取りを生じる可能性があります。理想的なアプローチは、フォーム自体からテキストを抽出しながら、写真を出力ファイルの添付ファイルまたは参照として保存することです — 写真内からのデータ抽出を試みるのではありません。抽出されたチェックリストデータとともに、Excelエクスポートに写真参照を含められるかどうかをツールに確認してください。
点検報告書の抽出は、異なる現場からの異なるレイアウトのフォームをどのように処理しますか?
Vision AIベースの抽出は、位置マッチングではなく理解によって読み取るため、レイアウトのバリエーションを自然に処理します。サイトAの2列テーブルを使用した安全チェックリストと、サイトBの同じチェックリストの縦型リストは、どちらも正しく処理されます — AIは各ページのフォーム構造を個別に識別します。対照的に、テンプレートベースのOCRツールは、各レイアウトごとに別個のテンプレートが必要です。複数の現場、下請け業者、または第三者検査員から点検報告書を受け取る場合、テンプレート不要のアプローチが唯一の実用的な選択肢です。
1回のバッチで何件の点検報告書を処理できますか?
実際的なバッチサイズはツールと報告書の複雑さによって異なります。ImageToTable.aiは、1回のバッチで最大数百件のドキュメントを処理でき(正確なバッチ上限はプランによって異なります)、ページあたりおよそ5〜10秒です。100件の単一ページ点検報告書のバッチは、約10〜15分で完了します。複数ページの報告書(各5〜15ページ)はより長い時間がかかりますが、同じバッチで実行されます — AIが各ページを処理し、複数ページのフォーム構造を自動的に再構築します。
点検報告書の抽出は手書きの署名にも対応していますか?
署名は画像(署名のグラフィック)としても、メタデータ(フォームに印刷された署名者名)としても抽出できます。コンプライアンス目的で使用可能な画像として署名を抽出することは簡単です。署名をテキストとして読み取る(筆記体の署名から「John Smith」を特定する)ことは信頼性が低く、本人確認に依存すべきではありません。監査目的には、署名画像と印刷された名前フィールドで十分な証拠となります。
同じ抽出ツールで安全点検、QCチェックリスト、車両DVIRレポートを処理できますか?
はい、Vision AIとカスタム列抽出を使用するツールであれば可能です。同じ「項目説明/ステータス/指摘事項/是正措置」テンプレートが3つのフォームタイプすべてに適用できます。これらは同じ基本構造(各項目に評価結果が付いたリスト)を共有しているためです。安全点検用、QC用、DVIR用に別々のテンプレートは不要で、列を一度定義すればAIが各フォームのレイアウトに自動的に適応します。これが大きなコストメリットです。1つの列テンプレートがフォームタイプごとのテンプレートではなく、検査プログラム全体に対応します。
規制対象の検査記録にAI抽出を使用する場合、コンプライアンス上のリスクはありますか?
コンプライアンス上のリスクは抽出自体ではなく、その後のデータの扱い方にあります。AI抽出がコンプライアンスダッシュボードにデータを供給し、元の検査フォームが破棄される場合、それはリスクです。規制当局(OSHA、ISO監査人、FDA)は元の署名済み文書の提示を求める場合があります。正しいアプローチは、分析と報告にはAI抽出を使用し、法的拘束力のある記録として元のPDFまたは紙のフォームを保持することです。抽出結果は、監査可能な原本の上に重なる検索可能で分析可能なレイヤーとなります。原本が必要な保存期間保持されていれば、ほとんどの規制当局はこの二重記録アプローチを受け入れます。
点検報告書の抽出は、モバイル点検アプリの使用とどう違いますか?
モバイル点検アプリ(SafetyCulture、Fulcrum、ProntoForms、GoCanvas、Device Magic)は、取得時点で点検プロセスをデジタル化します。点検担当者が電話やタブレットでデジタルフォームに記入し、データは即座に構造化形式で保存されます。これは新しい点検には理想的なアプローチです。一方、抽出は、組織がデジタルフォームを採用する前に完了した既存の紙またはPDFレポート、または独自の紙フォームを使用する第三者から提出されたレポートを処理します。この2つのアプローチは補完的です。将来を見据えたデジタル取得にはモバイルアプリを、既存記録の遡及的デジタル化にはAI抽出を使用します。デジタルトランスフォーメーションを進める組織は、紙のバックログが処理されモバイルプログラムが展開される最初の12〜24か月間、通常両方を実行します。
点検データはすでに収集されています。あとは読み取るだけです。
紙のチェックリストの束、PDFの点検報告書フォルダ、下請け業者からメールで届くフォームの山 — 点検データがどのような形であっても、AI抽出を使えば数分で構造化された分析可能なコンプライアンス対応スプレッドシートに変換できます。テンプレート不要、トレーニング不要、手入力も不要です。