Le guide complet de
l'extraction des données de rapports d'inspection (2026)
Un entrepreneur exploitant cinq chantiers actifs peut facilement accumuler des centaines de formulaires d'inspection remplis par mois — visites de sécurité, contrôles avant démarrage d'équipement, inspections de coulage de béton, registres de qualité de soudage. Chacun d'eux contient des éléments de liste de contrôle avec des statuts conforme/non conforme, des notes manuscrites d'actions correctives et des preuves photographiques intégrées qui doivent finir par alimenter un tableau de bord de conformité ou un CMMS. Ce guide couvre l'ensemble du paysage de l'extraction des données de rapports d'inspection : ce qui distingue ces formulaires des factures ou des bons de commande, pourquoi l'OCR traditionnel est insuffisant, quels champs comptent selon les secteurs, et comment évaluer les outils qui prétendent les traiter.
Qu'est-ce que l'extraction de données de rapports d'inspection ?
L'extraction de données de rapports d'inspection est le processus automatisé qui consiste à convertir des formulaires d'inspection remplis — qu'il s'agisse de listes de contrôle imprimées remplies à la main sur un porte-bloc, d'exports PDF d'une application d'inspection mobile ou de livrets numérisés de plusieurs pages — en lignes et colonnes structurées pouvant être analysées, archivées et intégrées dans des systèmes de conformité ou de maintenance.
Contrairement aux factures ou aux bons de commande, les rapports d'inspection ne portent pas principalement sur des chiffres financiers. Ils portent sur la classification d'état : un élément de liste de contrôle est soit Conforme, soit Non conforme, une constatation est Ouverte ou Fermée, une case à cocher est cochée ou vide. La valeur des données réside moins dans les chiffres individuels que dans les tendances — quels équipements échouent le plus souvent, quels inspecteurs signalent le plus de constatations, quels sites présentent des problèmes de sécurité récurrents d'un trimestre à l'autre.
Les rapports d'inspection couvrent un large éventail de secteurs et de formats :
- Visites de sécurité sur les chantiers de construction — inspections quotidiennes des dangers (OSHA 1926), vérifications avant utilisation des grues, inspections d'échafaudages, permis d'entrée en espace confiné (voir le flux de travail d'inspection de sécurité sur les chantiers)
- Inspections QC en fabrication — inspections de première pièce, contrôles dimensionnels en cours de production, audits qualité finaux, enregistrements d'inspection exigés par l'ISO 9001
- Inspections de sécurité des installations — vérifications mensuelles des extincteurs (NFPA 10), tests d'éclairage de secours (NFPA 101), vérifications hebdomadaires des douches oculaires (ANSI Z358.1)
- Inspections de véhicules de flotte — rapports d'inspection de véhicule par le conducteur DOT (DVIR), inspections de maintenance préventive, vérifications quotidiennes des chariots élévateurs (OSHA 1910.178)
- Inspections sanitaires des restaurants — relevés de température HACCP, listes de contrôle de salubrité, enregistrements d'inspection de lutte antiparasitaire, formulaires de vérification des contacts croisés d'allergènes
- Inspections de maintenance des équipements — rapports d'analyse vibratoire, enregistrements d'inspection thermographique, listes de contrôle des tournées de lubrification
Le défi d'extraction est le même pour tous : les informations sur la page sont un mélange d'étiquettes imprimées, de valeurs manuscrites, de coches dessinées à la main, de cases cochées ou de réponses entourées, et de photographies intégrées — le tout disposé selon une mise en page qui varie selon le concepteur du formulaire, le site et parfois l'inspecteur. Un système qui ne lit que le texte imprimé manquera la moitié des données.
Point clé : L'extraction de rapports d'inspection n'est pas un problème de reconnaissance de caractères. C'est un problème de classification structurelle — l'IA doit comprendre quels éléments d'un formulaire vont ensemble, si une case est cochée ou vide, et comment une note manuscrite dans la marge se rapporte à l'élément de liste de contrôle qu'elle annote. C'est une exigence technique fondamentalement différente de l'extraction d'une date ou d'un montant en dollars sur une facture.
Pourquoi le traitement manuel des rapports d'inspection coûte cher
Le coût le plus visible du traitement manuel des rapports d'inspection est le temps nécessaire pour transcrire les données du papier vers un tableur ou un CMMS. Un formulaire d'inspection est plus lent à saisir qu'un document ordinaire, car chaque ligne implique de localiser l'élément, de lire son statut et de saisir la constatation ainsi que toute action corrective. À raison de trois minutes par page, durée typique d'une saisie manuelle, un site traitant 50 rapports par semaine consacre environ deux heures et demie par semaine à la saisie de données. Sur une année, cela représente environ 130 heures, soit plus de trois semaines de travail à temps plein, pour un seul site.
Mais le temps de frappe est la plus petite part du coût. Les coûts les plus importants se cachent dans trois catégories qui s'accumulent lorsque les rapports restent sur papier ou sous forme de PDF scannés.
1. Constatations d'inspection manquées et lacunes de conformité
Un rapport d'inspection n'est pas un relevé de ce qui a été vérifié. C'est un relevé de ce qui a été constaté. La valeur du rapport réside dans les constatations : les éléments non conformes, les déficiences relevées, les actions correctives assignées. Lorsque les résultats d'inspection restent sur papier, la tendance des constatations dans le temps et selon les sites est invisible tant que quelqu'un ne lit pas manuellement chaque page pour compiler les résultats.
Un responsable sécurité disposant de 20 rapports d'inspection hebdomadaires provenant de cinq sites ne peut pas voir que les infractions de consignation/déconsignation du site 3 augmentent depuis trois mois sans d'abord passer un après-midi à constituer le jeu de données. Au moment où la tendance est repérée, la lacune de conformité s'est déjà creusée pendant un trimestre. Et si l'OSHA se présente pour une inspection — déclenchée par une plainte ou un incident enregistrable —, la capacité à produire des dossiers d'inspection complets et organisés en quelques heures plutôt qu'en quelques jours relève d'une exigence réglementaire, non d'une commodité.
Les normes OSHA 29 CFR 1910 et 1926 exigent des employeurs qu'ils procèdent à des « inspections fréquentes et régulières des chantiers, des matériaux et de l'équipement » (1926.20), réalisées par une personne compétente. Les dossiers de ces inspections doivent pouvoir être produits sur demande. Une pile de listes de contrôle à pince dans une armoire remplit la lettre de l'exigence mais en trahit l'esprit : les données ne sont ni consultables, ni analysables, ni exploitables tant que quelqu'un ne les transcrit pas.
2. Main-d'œuvre de préparation des audits
Toute organisation certifiée ISO 9001, conforme OSHA ou réglementée par la FDA, la FAA ou le DOT doit conserver ses enregistrements d'inspection pendant des durées définies. Un audit ISO 9001:2015 exige par exemple que l'organisation démontre que les enregistrements d'inspection et d'essai (articles 8.5.1 et 8.6) existent, sont complets et sont récupérables. Une enquête OSHA peut exiger cinq ans de journaux d'inspection (OSHA 300) — ou 30 ans d'enregistrements d'exposition des employés.
Quand la saison des audits arrive, une entreprise disposant de 5 000 rapports d'inspection papier fait face à un simple problème arithmétique. Localiser chaque rapport par date, site et type, le sortir du stockage, vérifier son exhaustivité et recouper les constats avec les actions correctives transforme la préparation des enregistrements en un travail de plusieurs jours. Pour une usine exploitant plusieurs sites, la main-d'œuvre augmente linéairement et, contrairement aux coûts de production, la préparation des audits n'offre aucune compensation de revenus.
3. La ressaisie manuelle des listes de contrôle et ses erreurs
Le coût le plus insidieux est celui qui donne l'impression de progresser : numériser les rapports en les saisissant dans un tableur. Ressaisir une liste de contrôle remplie est source d'erreurs d'une manière facile à manquer : une coche décalée d'une ligne vers le haut, un « Échec » saisi comme « Réussi », un commentaire rattaché au mauvais élément. Pour un formulaire d'inspection comportant 30 éléments de liste de contrôle, chacun avec un statut (Réussi/Échec/NA) et un commentaire, la surface d'erreur est énorme, et une seule coche mal placée se répercute en données de tendance erronées.
Prenons un responsable de maintenance d'installation qui saisit 200 enregistrements d'inspection par mois dans un CMMS (système de gestion de la maintenance assistée par ordinateur) comme SAP PM ou IBM Maximo. Avec un taux d'erreur modeste de 3 %, cela fait six enregistrements erronés chaque mois : des équipements signalés en panne alors qu'ils fonctionnaient, des actions correctives affectées au mauvais actif, des taux de réussite qui semblent plus faibles qu'ils ne sont. Chaque erreur prend du temps à trouver et à corriger, et certaines ne sont jamais détectées, dégradant silencieusement le jeu de données de maintenance pendant des mois et des années.
L'arithmétique du traitement manuel : 3 minutes par rapport × 50 rapports par semaine = environ 130 heures de saisie par an pour une seule installation, avant d'y ajouter la préparation des audits, la correction des erreurs et l'analyse des constats. L'extraction automatisée transforme ce temps de saisie en temps de traitement machine.
Défis clés propres à l'extraction de rapports d'inspection
Les rapports d'inspection diffèrent des factures, bons de commande et autres documents professionnels d'une manière qui rend l'extraction de données fondamentalement plus difficile. Comprendre ces différences est essentiel pour choisir — ou évaluer — la bonne approche.
1. Reconnaissance des cases à cocher / boutons radio / marques
Il s'agit du défi technique le plus important dans l'extraction de rapports d'inspection, et celui que la plupart des outils d'extraction de documents génériques ne parviennent pas à résoudre.
Un formulaire d'inspection présente ses éléments de liste de contrôle sous forme de liste ou de tableau, chaque ligne contenant une description de l'élément et un indicateur de statut — généralement une case à cocher que l'inspecteur marque pour indiquer Conforme, Non conforme ou Non applicable. La marque peut être une coche (✓), un X (✗), un cercle rempli (●), une réponse entourée ou un texte barré. Elle peut être sombre et nette, ou pâle, ou chevaucher la bordure imprimée de la case à cocher, ou être griffonnée dans la marge à côté de la case plutôt qu'à l'intérieur.
L'OCR traditionnel — qui extrait les caractères en détectant les formes du texte — ne peut pas lire ces marques. Une case cochée n'est pas du texte. C'est une marque spatiale dont le sens dépend de sa présence ou de son absence, et non du caractère qu'elle représente. Un moteur OCR qui analyse un formulaire d'inspection ignorera entièrement la zone de la case à cocher ou, au mieux, la signalera comme du bruit — un trait parasite sur la page — sans aucune interprétation sémantique.
Vision AI, en revanche, interprète les cases à cocher comme le ferait un humain : il voit une case, détermine si une marque est présente à l'intérieur, et classe le statut comme cochée (Conforme), croisée (Non conforme) ou vide (Non cochée / Non applicable). Un système OCR ne peut pas vous dire si une case a été cochée, car il n'a jamais été conçu pour cela. Un meilleur OCR ne comble pas cet écart ; ce n'est tout simplement pas le bon outil. L'implication pour l'extraction de rapports d'inspection est claire : tout outil qui repose uniquement sur l'OCR produira des résultats incorrects pour tout formulaire utilisant des cases à cocher ou des boutons radio, c'est-à-dire pratiquement tous les formulaires d'inspection.
2. Notes manuscrites mêlées à des listes de contrôle imprimées
Les formulaires d'inspection ne contiennent presque jamais uniquement des données imprimées. L'inspecteur inscrit ses constats, griffonne une action corrective dans la marge, entoure la mention « Défaillant », signe et date le bas du document. L'écriture peut aller des majuscules soignées à la cursive rapide du terrain, souvent dans l'espace blanc limité autour du tableau de liste de contrôle imprimé.
Extraire l'écriture manuscrite d'un formulaire d'inspection exige que l'IA distingue le texte imprimé du formulaire des ajouts manuscrits, puis associe chaque note manuscrite à la bonne case de la liste de contrôle. Une note griffonnée à côté du point 17 doit être liée au point 17, et non au point 16 au-dessus ni à la section de commentaires généraux en bas. Cette association spatiale, un lecteur humain l'effectue inconsciemment — mais une extraction basée sur l'OCR la perd totalement en traitant tout le texte de la page comme un flux plat.
La reconnaissance de l'écriture manuscrite s'est nettement améliorée ces dernières années. La reconnaissance moderne de l'écriture manuscrite par IA (souvent appelée HTR — Handwritten Text Recognition) lit la cursive avec une précision raisonnable, en particulier lorsque l'écriture est régulière et que le formulaire délimite clairement chaque champ de réponse. Mais le défi plus difficile pour les rapports d'inspection est l'association : savoir quelle note manuscrite appartient à quelle ligne de la liste de contrôle, en s'appuyant à la fois sur la proximité et sur les indices de mise en page.
3. Photos intégrées dans les rapports PDF
De nombreux rapports d'inspection — notamment les visites de chantier, les évaluations de l'état des biens et les registres d'inspection d'équipements — incluent des photographies comme preuves. Un rapport d'inspection de sécurité peut contenir 10 à 30 photos documentant des dangers, des infractions, des situations corrigées et l'état des équipements. Ces photos sont intégrées au rapport PDF aux côtés de la liste de contrôle textuelle.
Pour l'extraction de données, les photos intégrées posent un double problème. D'abord, les photos elles-mêmes peuvent contenir des informations à consigner — la photo d'une soudure fissurée, d'un tuyau corrodé ou d'un entraînement par courroie non protégé documente une défaillance précise qui devrait figurer dans le résumé des constats. Un système d'extraction purement textuel capture la description écrite du constat mais manque la preuve visuelle que l'inspecteur considérait comme le document de référence.
Ensuite, et plus concrètement, les photos intégrées peuvent perturber les outils d'extraction qui ne sont pas entraînés à distinguer le « contenu à extraire » de la « preuve visuelle à préserver ». Un outil qui tente d'appliquer l'OCR au texte de chaque image du PDF peut produire des lectures hallucinées à partir du contenu des photos — en interprétant par exemple l'étiquette d'un tuyau visible sur une photo comme une case de la liste de contrôle.
4. Formulaires multi-sections et multipages
Les rapports d'inspection sont rarement des documents d'une seule page. Une inspection complète d'installations peut couvrir 5 à 15 pages réparties en sections distinctes : informations générales (site, date, inspecteur), liste de contrôle de sécurité, listes de contrôle par équipement, synthèse des constats, plan d'action corrective et validation. Chaque section a sa propre mise en page, son propre format de réponse et son propre lien avec le rapport global. Les demandes de paiement de construction comme les formulaires AIA G702/G703 partagent cette même structure parent-enfant — une page de synthèse alimentée par des feuilles de continuation détaillées — et les mêmes principes d'extraction s'appliquent.
L'extraction de données à partir de formulaires multi-sections doit reconstruire la structure du document — pas simplement lire le texte de chaque page indépendamment. Un constat listé en page 7 sous « Sécurité électrique » doit être relié à la même session d'inspection enregistrée en page 1, et l'échéance d'action corrective inscrite en page 9 doit être reliée à ce constat. Cette compréhension structurelle distingue les outils d'extraction sérieux des visionneuses OCR page par page.
Il existe une seconde version, plus banale, du même problème : le rapport arrive sous forme d'images séparées. Une inspection de 12 pages est numérisée page par page, une liste de contrôle recto-verso est photographiée face avant et face arrière, et un sous-traitant envoie chaque feuille dans son propre fichier. Extrait naïvement, cela donne douze lignes là où vous en vouliez une. Multi-Page Merge gère cela au niveau du modèle : vous indiquez comment les pages doivent être regroupées, soit en démarrant un nouveau rapport chaque fois que la valeur d'une colonne suivie change (un nouveau site, une nouvelle date d'inspection), soit en associant toutes les pages partageant un numéro de référence dans le lot, soit en regroupant un nombre fixe de fichiers importés. L'IA fusionne ensuite les pages correspondantes en une seule ligne : les champs se remplissent depuis la page qui les porte, les valeurs récurrentes comme l'ID du site se propagent à chaque ligne d'article, et un champ enregistré différemment sur deux pages se résout par première valeur, dernière valeur, concaténation ou division. Vous importez les pages en vrac ; le rapport fusionné est ce qui arrive dans la feuille de calcul.
5. Complexité de la conformité réglementaire
Différents secteurs, différents organismes de réglementation et différents types d'inspection ont des exigences différentes quant à ce qui doit être enregistré et conservé. Un outil d'extraction qui fonctionne pour un régime de conformité peut manquer des champs obligatoires pour un autre.
Le tableau ci-dessous résume les principaux référentiels de conformité que l'extraction de rapports d'inspection doit prendre en compte :
| Référentiel | S'applique à | Exigences clés des enregistrements d'inspection | Durée de conservation |
|---|---|---|---|
| OSHA 29 CFR 1910 | Industrie générale (fabrication, entreposage, installations) | Inspection de consignation/déconsignation (1910.147), vérifications quotidiennes des chariots élévateurs (1910.178), évaluation des EPI (1910.132), programme de communication des dangers | 5 ans (registre OSHA 300) ; 30 ans (dossiers d'exposition/médicaux) |
| OSHA 29 CFR 1926 | Construction | Inspections par une personne compétente (1926.20), inspections des grues (1926.1412), inspections des échafaudages, vérifications quotidiennes des excavations (1926.651) | 5 ans (registre OSHA 300) ; durée du projet + conservation exigée par la norme applicable |
| NFPA 25 / NFPA 101 | Protection incendie, sécurité des personnes | Inspections des sprinklers (NFPA 25), vérifications mensuelles des extincteurs (NFPA 10), tests d'éclairage de secours (NFPA 101), inspections des panneaux de sortie | 1 an après l'inspection suivante du même type ; durée de vie du système pour les enregistrements de réception |
| ISO 9001:2015 | Systèmes de management de la qualité | Enregistrements d'inspection et d'essai (article 8.5.1, 8.6), enregistrements de non-conformité et d'action corrective (article 10.2.2), enregistrements d'étalonnage (article 7.1.5) | Selon la politique de conservation des documents de l'organisation (généralement 3 à 7 ans) |
| FDA 21 CFR Part 117 / HACCP | Transformation alimentaire, restauration | Enregistrements de surveillance de l'assainissement, journaux de contrôle de température, vérification des contacts croisés d'allergènes, enregistrements d'actions correctives | 2 ans (au moins aussi longtemps que la durée de conservation du produit) |
| DOT / FMCSA | Flotte de véhicules commerciaux | Rapports d'inspection des véhicules par le conducteur (DVIR), inspections annuelles des véhicules, enregistrements de maintenance périodique | 90 jours (DVIR original) ; 14 mois (rapport d'inspection annuelle) |
L'implication pour l'extraction est que l'outil doit respecter les distinctions sémantiques au niveau des champs. Un champ « Nom de l'inspecteur » sur un DVIR du DOT a un poids réglementaire différent du même champ sur une inspection de premier article en assurance qualité. Les données peuvent être identiques ; le référentiel de conformité qui régit leur conservation et leur format ne l'est pas.
Méthodes traditionnelles vs extraction par IA pour les rapports d'inspection
Comprendre pourquoi l'extraction des rapports d'inspection exige une approche technique fondamentalement différente de, disons, le traitement des factures commence par une comparaison directe de ce que chaque méthode peut ou ne peut pas gérer.
Pourquoi l'OCR traditionnel échoue sur les formulaires d'inspection
La reconnaissance optique de caractères (OCR) convertit les images de texte en caractères lisibles par machine. Elle fonctionne bien pour les documents imprimés au texte clair et uniforme — pensez aux bons de commande faxés ou aux contrats dactylographiés. Sur un formulaire d'inspection, l'OCR se heurte à trois limites structurelles :
- Aucun texte dans les cases à cocher. Une case cochée ne contient aucun caractère que l'OCR puisse reconnaître. Le système l'ignore ou, dans certaines implémentations, renvoie une chaîne vide — ni l'un ni l'autre ne vous indique le statut de l'élément.
- Aucune conscience de la structure. L'OCR extrait le texte dans l'ordre de lecture (de haut en bas, de gauche à droite). Un tableau de liste de contrôle où la case à cocher du statut de l'élément 4 se trouve à gauche de la description de l'élément, et celle de l'élément 5 à droite, produit un flux de texte où statuts et descriptions s'entremêlent sans aucun lien. Reconstituer quel statut appartient à quel élément nécessite une logique de post-traitement que la plupart des outils OCR n'incluent pas.
- Aucune capacité d'écriture manuscrite. Les moteurs OCR standard sont entraînés sur des caractères imprimés. L'écriture manuscrite cursive, même soignée, produit des erreurs de reconnaissance caractère par caractère qui rendent le résultat inutilisable. Il existe des OCR spécialisés en écriture manuscrite, mais ils ajoutent complexité et coût, et peinent encore à associer les champs.
Comment Vision AI lit les rapports d'inspection sans modèle
Vision AI — plus précisément la classe de grands modèles de vision (VLM) capables de comprendre les images de façon holistique — traite les formulaires d'inspection différemment. Il ne cherche pas du texte à des coordonnées de pixels et ne tente pas d'OCRiser chaque caractère. Il interprète plutôt le document comme une scène visuelle globale : il identifie la structure du formulaire, localise chaque élément de la liste de contrôle, détecte la marque dans l'indicateur de statut, lit l'écriture manuscrite associée et mappe le tout dans une sortie structurée, ligne par ligne.
Lorsque l'IA voit une liste de contrôle d'inspection comportant 25 éléments, elle effectue implicitement les opérations suivantes : elle identifie qu'il existe une structure de tableau ou de liste, sépare les libellés d'éléments des champs de statut et des colonnes de commentaires, classe chaque indicateur de statut comme coché ou non coché, lit les notes manuscrites d'action corrective en les associant à la bonne ligne, et produit un tableau où chaque ligne correspond à un élément de la liste de contrôle avec son statut et son commentaire.
C'est là toute la différence entre la reconnaissance de caractères et la compréhension de document. L'IA ne cherche pas à lire chaque pixel — elle cherche à comprendre l'intention du formulaire : quelles informations l'inspecteur a consignées, où il les a consignées et ce qu'elles signifient.
Pour une discussion plus approfondie sur la différence entre Vision AI et les approches traditionnelles de traitement de documents, consultez notre guide complet de l'extraction de relevés de compteurs, qui explique le même paradigme appliqué aux formulaires de comptage et de jauges — un autre type de document où l'OCR traditionnel montre ses limites.
Comparaison directe : les méthodes en un coup d'œil
| Méthode | Lit les cases à cocher (cochée/non cochée) | Lit l'écriture manuscrite | Gère les photos intégrées | Préserve la structure multi-sections | Configuration par type de formulaire |
|---|---|---|---|---|---|
| Saisie manuelle des données | ✓ | ✓ | ✓ (vérification manuelle) | ✓ | Aucune |
| OCR traditionnel | ✗ (ne détecte pas les marques) | ✗ | ✗ (ignore ou confond les images) | ✗ (flux de texte plat) | Selon la mise en page du formulaire |
| OCR par modèle / zonal | ✗ (les zones fixes cassent avec les variations de formulaire) | ✗ (partiel avec un module complémentaire) | ✗ | Partiel (zone par zone) | Selon le modèle de formulaire |
| Applications mobiles d'inspection | ✓ (formulaires numériques natifs de l'application) | ✓ (saisie numérique) | ✓ (prise de photo native de l'application) | ✓ | Configuration de l'application par formulaire |
| Extraction photo par Vision AI | ✓ | ✓ | ✓ (conservée comme preuve) | ✓ (comprend la structure du formulaire) | Aucune (zéro configuration) |
Les applications d'inspection mobiles (SafetyCulture / iAuditor, Fulcrum, ProntoForms, GoCanvas) constituent une alternative notable — elles remplacent entièrement les formulaires papier par des listes de contrôle numériques qui capturent les données nativement dans un format structuré. Elles sont la meilleure option pour les organisations qui construisent un programme d'inspection à partir de zéro. Mais elles ne résolvent pas le problème du papier existant. Si vous avez une armoire de classement contenant 5 000 formulaires d'inspection remplis, ou si vos sous-traitants soumettent des listes de contrôle papier que vous devez numériser, les applications mobiles ne vous aident pas. L'extraction par Vision AI, si : elle lit les formulaires papier tels quels et produit la même sortie structurée que l'application mobile aurait générée au moment de la saisie.
La distinction pratique : Les applications d'inspection mobiles empêchent la création de papier. L'extraction par Vision AI convertit le papier qui existe déjà. La plupart des organisations ont besoin des deux — l'application pour les nouvelles inspections, l'extraction pour l'arriéré et pour les rapports tiers entrants.
Champs critiques à extraire d'un rapport d'inspection
Les rapports d'inspection varient considérablement selon le secteur et l'objectif, mais les champs qui comptent suivent un schéma cohérent. Le tableau ci-dessous définit l'ensemble standard de points de données que toute extraction complète de rapport d'inspection doit capturer :
| Groupe de champs | Champ | Description | Exemple |
|---|---|---|---|
| En-tête | Date d'inspection | Date à laquelle l'inspection a été effectuée | 2026-06-15 |
| Nom / ID de l'inspecteur | Personne ayant réalisé l'inspection | J. Rodriguez (Cert #8172) | |
| Site / Actif / Emplacement | Lieu de l'inspection — nom du bâtiment, étiquette d'actif, NIV du véhicule, ID de l'équipement | Boiler Room B, Asset BR-0042 | |
| Éléments de la liste de contrôle | Numéro d'élément | Identifiant de ligne ou d'élément de la liste de contrôle | 14 |
| Description de l'élément | Ce qui a été inspecté — la question ou le critère de la liste de contrôle | Emergency eyewash station — weekly flush test performed | |
| Statut | Réussi / Échoué / NA / Non vérifié — déterminé à partir de la marque de la case à cocher ou du bouton radio | Réussi (✓) | |
| Constat / Observation | Note écrite de l'inspecteur — ce qui a été observé, tout commentaire sur l'état | Water pressure low — flush lasted only 12 seconds | |
| Action corrective / Recommandation | Ce qui doit être fait pour remédier au constat, et pour quand | Plumber to inspect line — complete by 06/22 | |
| Résumé | Résultat global | Réussi / Échoué / Réussi sous conditions — le résultat global de l'inspection | Réussi sous conditions (3 constats, 2 critiques) |
| Validation | Signature de l'inspecteur | Accusé de réception signé par l'inspecteur et/ou le réviseur | Signature capturée électroniquement ou image de signature numérisée |
Ces champs peuvent être définis comme un modèle de colonne dans un outil d'extraction prenant en charge l'Extraction de colonnes personnalisées — vous saisissez les noms de champs souhaités, et l'IA localise chaque valeur sur le formulaire en comprenant la signification sémantique de chaque champ, et non en faisant correspondre des coordonnées de pixels. Cette approche fonctionne sur différentes mises en page de formulaires, car l'IA recherche le sens d'un champ (description d'un élément de liste de contrôle, marqueur de statut, note d'observation), et non sa position sur la page.
Les champs Finding Severity ou Corrective Action Deadline sont des exemples de colonnes inférées — le niveau de gravité (Critical / Major / Minor) peut ne pas être explicitement indiqué sur le formulaire, mais peut être déduit des notes de l'inspecteur ou de la nature du constat. Une IA qui lit la mention manuscrite « URGENT — fix immediately » à côté d'un constat peut le classer comme Critical sans qu'une case à cocher dédiée à la gravité soit présente sur le formulaire. De même, une échéance mentionnée dans une note d'action corrective (« complete by 06/22 ») peut être extraite et placée dans une colonne d'échéance distincte.
Pour les organisations qui gèrent des données d'inspection sur plusieurs sites, le même modèle de colonne s'applique à chaque rapport, quelle que soit la mise en page du formulaire. La colonne Site/Asset et la colonne Inspection Date constituent la clé composite pour le filtrage, l'analyse des tendances et les rapports de conformité, à condition que ces champs soient extraits de manière cohérente depuis chaque rapport.
L'extraction n'a de valeur que si chaque valeur est fiable, et le travail d'inspection est précisément le domaine où cela compte le plus : un seul Pass/Fail mal lu, ou une note d'action corrective rattachée à la mauvaise ligne de la liste de contrôle, fausse silencieusement une tendance de conformité. Le Review Mode rend cette vérification concrète plutôt que théorique. Survolez n'importe quelle cellule extraite et le formulaire scanné d'origine met en évidence l'emplacement exact d'où provient la valeur ; le lien fonctionne dans les deux sens, donc cliquer sur une zone de l'image vous ramène à sa ligne dans le tableau. Lorsqu'un réviseur corrige un champ, un clic restaure la lecture d'origine de l'IA afin que la modification reste traçable. Au lieu de relire un rapport de 12 pages pour vérifier l'extraction par échantillonnage, vous ouvrez les lignes qui comptent et les confirmez par rapport à la page.
Traitement par lots : des rapports multi-sites à un tableau de bord de conformité
La différence entre un outil qui peut extraire des données d'inspection et un outil qui vous fait réellement gagner du temps, c'est le traitement par lots. Lire un seul formulaire d'inspection et obtenir un fichier de sortie unique, c'est une démo. Lire 50 formulaires d'inspection issus de cinq sites différents et obtenir un seul tableur consolidé — voilà un workflow.
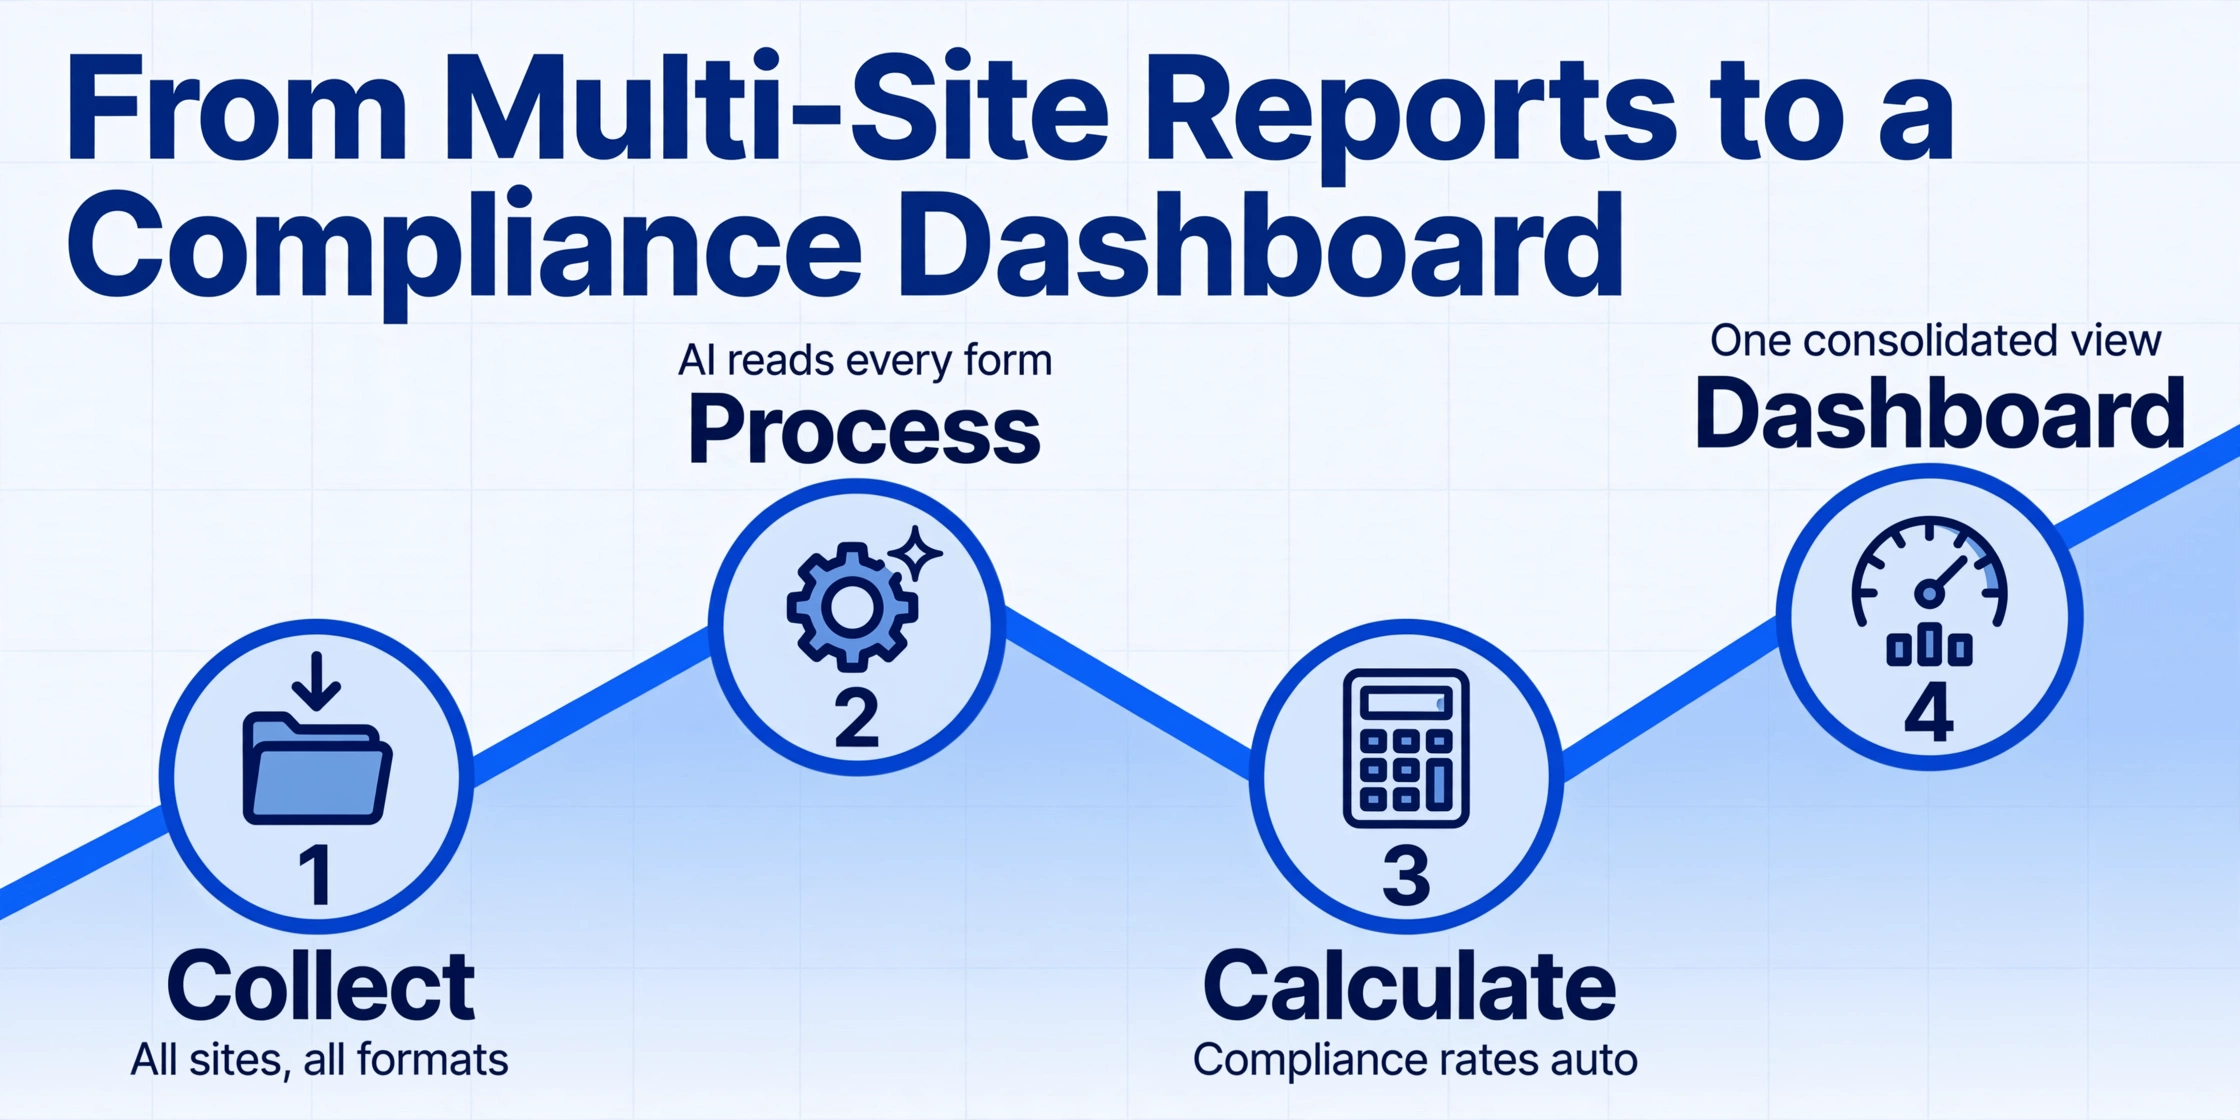
L'extraction par lots de rapports d'inspection fonctionne comme suit :
- Collecte des rapports. Les formulaires d'inspection remplis sont rassemblés depuis toutes les sources — listes de contrôle papier scannées, exports PDF d'applications mobiles d'inspection, pièces jointes photo envoyées par e-mail. Ils s'accumulent dans un seul dossier, une boîte de réception ou une file d'attente de téléversement, quel que soit le format ou la source.
- Téléversement par lots. Tous les rapports sont téléversés ensemble — 20 à 200 fichiers en une seule opération de glisser-déposer. Le système les regroupe en un lot étiqueté avec la période d'inspection ou le nom du projet.
- Traitement IA en masse. Le même modèle de colonnes est appliqué à chaque rapport. L'IA lit chaque formulaire indépendamment, identifie la structure du formulaire, extrait les éléments de la liste de contrôle et leurs statuts, et produit une ligne par rapport (un rapport arrivé en plusieurs pages distinctes est d'abord fusionné en une seule ligne). Les différences de mise en page entre les sites n'ont pas d'importance, car l'IA lit par compréhension, et non par correspondance de modèle.
- Calcul du score de conformité via les colonnes calculées. Si le modèle inclut des champs comme « Taux de réussite » ou « Nombre de constats ouverts », ceux-ci sont calculés automatiquement lors de l'extraction à l'aide de colonnes calculées. Par exemple, un champ « Taux de conformité » défini comme le pourcentage d'éléments conformes divisé par le total des éléments est calculé par rapport et agrégé sur l'ensemble du lot — la sortie inclut donc à la fois le score de conformité par rapport et la moyenne à l'échelle du site.
- Export vers un seul fichier. L'ensemble du lot est exporté sous forme d'un unique fichier Excel avec une ligne par rapport d'inspection (ou une ligne par élément de liste de contrôle pour une analyse granulaire). Les colonnes incluent toutes les données extraites ainsi que les métriques de conformité calculées.
Résultat : un responsable sécurité qui passait auparavant une journée entière chaque semaine à retranscrire des rapports d'inspection et à calculer des taux de conformité à partir de papier téléverse désormais les rapports, attend 10-15 minutes le traitement IA, puis ouvre un tableur qui indique : quels sites sont sous le seuil de conformité de 90 %, quels éléments d'inspection échouent le plus fréquemment sur tous les sites, quels inspecteurs signalent systématiquement le plus de constats, et quelles actions correctives ont dépassé leur échéance. Pour un exemple concret dans le secteur de la construction de ce même workflow par lots sur plusieurs chantiers — y compris la tenue des registres OSHA 300/300A — consultez notre guide sur le traitement par lots des rapports d'inspection de construction issus de plusieurs chantiers.
Notre comparatif des meilleurs outils d'extraction de documents terrain et industriels couvre les plateformes qui prennent en charge ce type de workflow par lots pour les données d'inspection et de terrain, avec des résultats de tests réels sur différents types de formulaires et conditions de prise de vue.
Export et intégration : alimenter les systèmes qui agissent sur les données
Les données d'inspection extraites ne créent de la valeur que lorsqu'elles atteignent les systèmes où les actions correctives sont gérées, la conformité est suivie et la maintenance est planifiée. Le chemin d'intégration dépend du système cible et de la taille de l'exploitation.
Export Excel et CSV
Pour la plupart des petites et moyennes exploitations, les données d'inspection extraites sont exportées vers Excel ou CSV, puis importées manuellement dans un CMMS ou un outil de suivi de conformité. Cela fonctionne pour les sites traitant jusqu'à quelques centaines de rapports par mois. L'export contient une ligne par rapport avec tous les champs extraits, plus des colonnes calculées pour les taux de conformité et le nombre de constats. Les en-têtes de colonnes sont configurés pour correspondre au format d'import du système cible, de sorte que l'étape d'import devient un mappage direct sans reformatage manuel.
Module complémentaire Google Sheets
Pour les équipes qui gèrent leurs données d'inspection dans Google Sheets, ImageToTable.ai propose un module complémentaire en barre latérale Google Sheets qui permet aux utilisateurs de téléverser des rapports d'inspection directement depuis leur feuille de calcul et d'ajouter les résultats extraits à la feuille active. Cela élimine entièrement l'étape d'export-import — les données d'inspection arrivent dans la même feuille qui alimente le tableau de bord de conformité ou la revue de sécurité mensuelle.
Intégration CMMS et EAM
Les grandes exploitations industrielles utilisent généralement un CMMS (Computerised Maintenance Management System) ou une plateforme EAM (Enterprise Asset Management) comme système de référence pour les inspections d'équipements :
- SAP PM (Plant Maintenance) gère les plans d'inspection, les ordres de maintenance et les historiques d'équipements. Les résultats d'inspection extraits de formulaires papier peuvent être téléversés via les outils de migration de données par lots de SAP (transaction
LSMWouCG3Z) ou via le workflow standard de notification PM. Les constats extraits nécessitant une action corrective correspondent directement aux notifications PM ou aux ordres de maintenance. - IBM Maximo gère les inspections d'actifs via son module Inspection/Testing. Les données extraites — statut conforme/non conforme par élément de la liste de contrôle, notes d'observation, affectations d'actions correctives — correspondent aux enregistrements de résultats d'inspection de Maximo avec une transformation minimale.
- Fiix, UpKeep et Maintenance Connection offrent des points de terminaison d'import CSV et d'API REST pour l'ingestion des données d'inspection. Les résultats extraits d'un lot de rapports peuvent être programmés pour un import automatisé via API.
- Procore (construction) et Corrigo (gestion des installations) acceptent les données d'inspection via leurs capacités respectives d'API ou d'import de fichiers, permettant aux éléments de liste de réserves et aux constats issus de rapports papier d'alimenter les workflows numériques de gestion de projet.
Le schéma d'intégration pratique pour la plupart des organisations est le suivant : extraire les rapports d'inspection via l'IA → exporter au format CSV adapté au système cible → importer via l'interface de téléversement par lots du système. Cela évite le développement d'API personnalisées tout en fournissant des données structurées aux systèmes de maintenance et de conformité qui agissent dessus.
Critères de choix d'un outil d'extraction de rapports d'inspection
Tous les outils d'extraction de données ne traitent pas efficacement les rapports d'inspection. Les critères qui comptent pour les formulaires d'inspection — cases à cocher, écriture manuscrite, photos jointes, formulaires à sections multiples — diffèrent de ceux qui comptent pour les factures ou les reçus. Voici une liste de contrôle pratique pour l'évaluation :
Pour une comparaison détaillée des outils qui répondent à ces critères, consultez notre sélection des meilleurs outils d'extraction de documents pour l'industrie 2026, qui évalue les plateformes sur leur capacité à traiter les formulaires d'inspection QC, les listes de contrôle et la documentation de conformité en environnement de production.
FAQ sur l'extraction des données de rapport d'inspection
L'IA peut-elle distinguer une case à cocher cochée d'une case non cochée sur un formulaire d'inspection ?
Oui — mais seul Vision AI le peut, pas l'OCR traditionnel. Un modèle de vision interprète visuellement la zone de la case à cocher et la classe comme marquée (cochée, barrée, entourée) ou vide. Les systèmes basés sur l'OCR ne peuvent pas faire cette distinction, car les cases à cocher ne contiennent aucun caractère textuel à reconnaître. Lors de l'évaluation d'un outil, c'est la question la plus importante à poser : comprend-il les cases à cocher visuellement ou s'appuie-t-il uniquement sur la reconnaissance de texte ?
L'IA gère-t-elle les notes d'inspection manuscrites aussi bien que le texte imprimé ?
La reconnaissance moderne de l'écriture manuscrite (HTR) s'est beaucoup améliorée, mais sa précision dépend fortement du rédacteur et de l'image : des majuscules soignées sur un scan à plat passent bien plus fiablement qu'une cursive tracée à la hâte sur un terrain, sur une photo prise à bout de bras. Le défi plus difficile est d'associer la note manuscrite à la bonne case de la liste de contrôle, surtout lorsque les notes sont écrites dans les marges ou entre les lignes plutôt que dans des champs de commentaire dédiés. Un bon outil d'extraction d'inspection gère à la fois la reconnaissance et l'association dans la même passe d'extraction, et non en étapes séparées. Pour les constats critiques, vérifiez toujours le texte extrait par rapport à l'image du formulaire original. Un mode de révision qui met en évidence l'origine de chaque valeur sur la page rend cela rapide : vous vérifiez les champs qui comptent au lieu de relire tout le formulaire.
L'outil peut-il extraire des données à partir de photos intégrées dans un rapport d'inspection PDF ?
Cela dépend de l'outil. Certains systèmes d'extraction ignorent complètement les images intégrées, perdant ainsi les preuves visuelles. D'autres tentent d'appliquer l'OCR au texte contenu dans les images, ce qui peut produire des lectures erronées à partir d'étiquettes d'équipement ou de panneaux visibles sur la photo. L'approche idéale consiste à conserver les photos comme pièces jointes ou références dans le fichier de sortie tout en extrayant le texte du formulaire lui-même — sans tenter d'extraire des données depuis l'intérieur des photos. Demandez si l'outil peut inclure des références de photos dans l'export Excel aux côtés des données de liste de contrôle extraites.
Comment l'extraction de rapport d'inspection gère-t-elle des formulaires aux mises en page différentes selon les sites ?
L'extraction basée sur Vision AI gère naturellement la variation de mise en page, car elle lit par compréhension et non par correspondance de position. Une liste de contrôle de sécurité du site A qui utilise un tableau à deux colonnes et la même liste de contrôle du site B qui utilise une liste verticale sont toutes deux traitées correctement — l'IA identifie la structure du formulaire sur chaque page indépendamment. Les outils OCR basés sur des modèles, en revanche, nécessitent un modèle distinct pour chaque mise en page. Si votre organisation reçoit des rapports d'inspection de plusieurs sites, sous-traitants ou inspecteurs tiers, une approche sans modèle est la seule option pratique.
Combien de rapports d'inspection peuvent être traités en un seul lot ?
Les tailles de lot pratiques dépendent de l'outil et de la complexité des rapports. ImageToTable.ai traite des lots allant jusqu'à quelques centaines de documents à la fois (le plafond exact par lot dépend de votre plan) à raison d'environ 5 à 10 secondes par page. Un lot de 100 rapports d'inspection d'une page se termine en environ 10 à 15 minutes. Les rapports multipages (5 à 15 pages chacun) prennent plus de temps mais s'exécutent dans le même lot — l'IA traite chaque page et reconstruit automatiquement la structure du formulaire multipage.
L'extraction des rapports d'inspection fonctionne-t-elle avec les signatures manuscrites ?
Les signatures peuvent être extraites sous forme d'images (le graphique de la signature) et de métadonnées (le nom du signataire s'il est également imprimé sur le formulaire). Extraire la signature sous forme d'image exploitable à des fins de conformité est simple. Lire la signature comme du texte — identifier « John Smith » à partir d'une signature en cursive — est moins fiable et ne doit pas servir à vérifier l'identité. À des fins d'audit, l'image de la signature et le champ du nom imprimé constituent des preuves suffisantes.
Le même outil d'extraction peut-il traiter les inspections de sécurité, les listes de contrôle QC et les rapports DVIR de véhicules ?
Oui, si l'outil utilise la Vision AI avec l'Extraction de colonnes personnalisées. Le même modèle « Description de l'élément / Statut / Constat / Action corrective » s'applique aux trois types de formulaires, car ils partagent la même structure essentielle : une liste d'éléments, chacun avec un résultat d'évaluation. L'outil n'a pas besoin d'un modèle distinct pour la sécurité, le QC ou le DVIR — vous définissez les colonnes une fois et l'IA s'adapte automatiquement à la mise en page de chaque formulaire. C'est un avantage de coût majeur : un seul modèle de colonnes sert tout votre programme d'inspection, et non un modèle par type de formulaire.
Y a-t-il un risque de conformité à utiliser l'extraction par IA pour des enregistrements d'inspection réglementés ?
Le risque de conformité ne réside pas dans l'extraction elle-même, mais dans ce que vous faites des données ensuite. Si l'extraction par IA alimente un tableau de bord de conformité et que les formulaires d'inspection originaux sont jetés, c'est un risque — les autorités de régulation (OSHA, auditeurs ISO, FDA) peuvent vouloir voir les documents signés originaux. La bonne approche consiste à utiliser l'extraction par IA pour l'analyse et le reporting tout en conservant les formulaires PDF ou papier originaux comme enregistrements juridiquement contraignants. Le résultat de l'extraction devient la couche interrogeable et analysable au-dessus des documents originaux auditables. La plupart des autorités de régulation acceptent cette approche à double enregistrement, à condition que les originaux soient conservés pendant la durée de conservation requise.
En quoi l'extraction des rapports d'inspection diffère-t-elle de l'utilisation d'une application mobile d'inspection ?
Les applications mobiles d'inspection (SafetyCulture, Fulcrum, ProntoForms, GoCanvas, Device Magic) numérisent le processus d'inspection au moment de la saisie — l'inspecteur remplit un formulaire numérique sur un téléphone ou une tablette, et les données sont stockées immédiatement dans un format structuré. C'est l'approche idéale pour les nouvelles inspections. L'extraction, en revanche, traite les rapports papier ou PDF existants qui ont été remplis avant que l'organisation n'adopte les formulaires numériques, ou les rapports soumis par des tiers qui utilisent leurs propres formulaires papier. Les deux approches sont complémentaires : utilisez les applications mobiles pour la saisie numérique prospective, et l'extraction par IA pour la numérisation rétrospective des enregistrements existants. Les organisations en pleine transformation numérique font généralement les deux pendant les 12 à 24 premiers mois, le temps de traiter le stock de documents papier et de déployer le programme mobile.
Vos données d'inspection sont déjà collectées. Il ne reste plus qu'à les lire.
Une pile de listes de contrôle papier, un dossier de rapports d'inspection PDF ou un lot de formulaires envoyés par courriel par des sous-traitants — quelle que soit la forme de vos données d'inspection, l'extraction par IA peut les transformer en un tableur structuré, analysable et prêt pour la conformité en quelques minutes. Sans modèle, sans entraînement, sans saisie manuelle.