クライアント受付データ抽出
再入力ループなしで
見込みクライアントは、氏名、住所、相手方の氏名、紛争の簡単な説明を受付フォームやメールに入力します。その後、パラリーガルが同じ詳細をClioに入力します。最初の入力で情報が失われることはありません。データはフォームフィールドやメールスレッド内に構造化された形で届き、2回目の入力は純粋な再入力です。この再入力こそ、クライアント受付の中で請求書に載ることのない部分であり、利益相反チェックが相談の前に行われるか後に行われるかを左右するステップでもあります。
重要ポイント
- 弁護士の1日の請求可能時間の上限は平均2.5時間で、その周辺の非請求可能時間の48%が受付データの再入力などの事務作業に費やされています。
- クライアントはすでに一度それらの詳細を入力しているため、事務所は別の担当者に同じ氏名を再入力させており、この2回目の入力で利益相反チェック用の名前が誤ってしまうのです。
- 受付メールと転送されたフォームを1つのシートに読み込むことで2回目の入力が不要になり、相手方当事者の列が最初に確認すべき項目になります。
クライアント受付はフォームではなく引き渡しで滞る
小規模事務所の受付問題は、ほとんど常にデータを収集するツールではなく、その後に続く引き渡しにあります。Clio GrowとMyCaseはどちらもオンラインフォームの送信を取得し、そこから連絡先と案件を作成します。その経路は機能します。難しいのは、受付の一部だけがその方法で届くということです。新しい案件が実際にどのように届くかを考えてみてください。ある案件ではウェブフォーム、別の案件ではクライアントがメール本文で紛争を説明するメール、返信に添付されたスキャンまたは撮影された受付シート、パラリーガルがメモとして書き起こす電話連絡。それぞれ形が異なり、どれも単独では事務所の業務管理システムに自動的に入りません。
その引き渡しの規模は、事務所がすでに報告している数字に記録されています。Clioの2025年法務動向レポートによると、弁護士の平均請求可能時間は1日2.5時間、稼働率は37パーセントです。その以前の調査では、弁護士の非請求可能時間の48パーセントが事務管理、請求、回収などの事務作業に費やされていることが判明しました。受付の再入力はその部分に含まれており、請求可能な時間と直接競合します。
見落としがちな2つ目のコストがあります。利益相反チェックは検索できる名前と同じ速さでしか機能せず、その名前はクライアントおよび元クライアントのリストと照合する前に、使用可能な名前レベルの形式になっている必要があります。相手方当事者の名前がPDFとパラリーガルの記憶の中にある場合、チェックは待たされます。それが受付において再入力が単なる煩わしさではなくリスクになり始める部分です。
クライアント受付が実際に生み出すもの
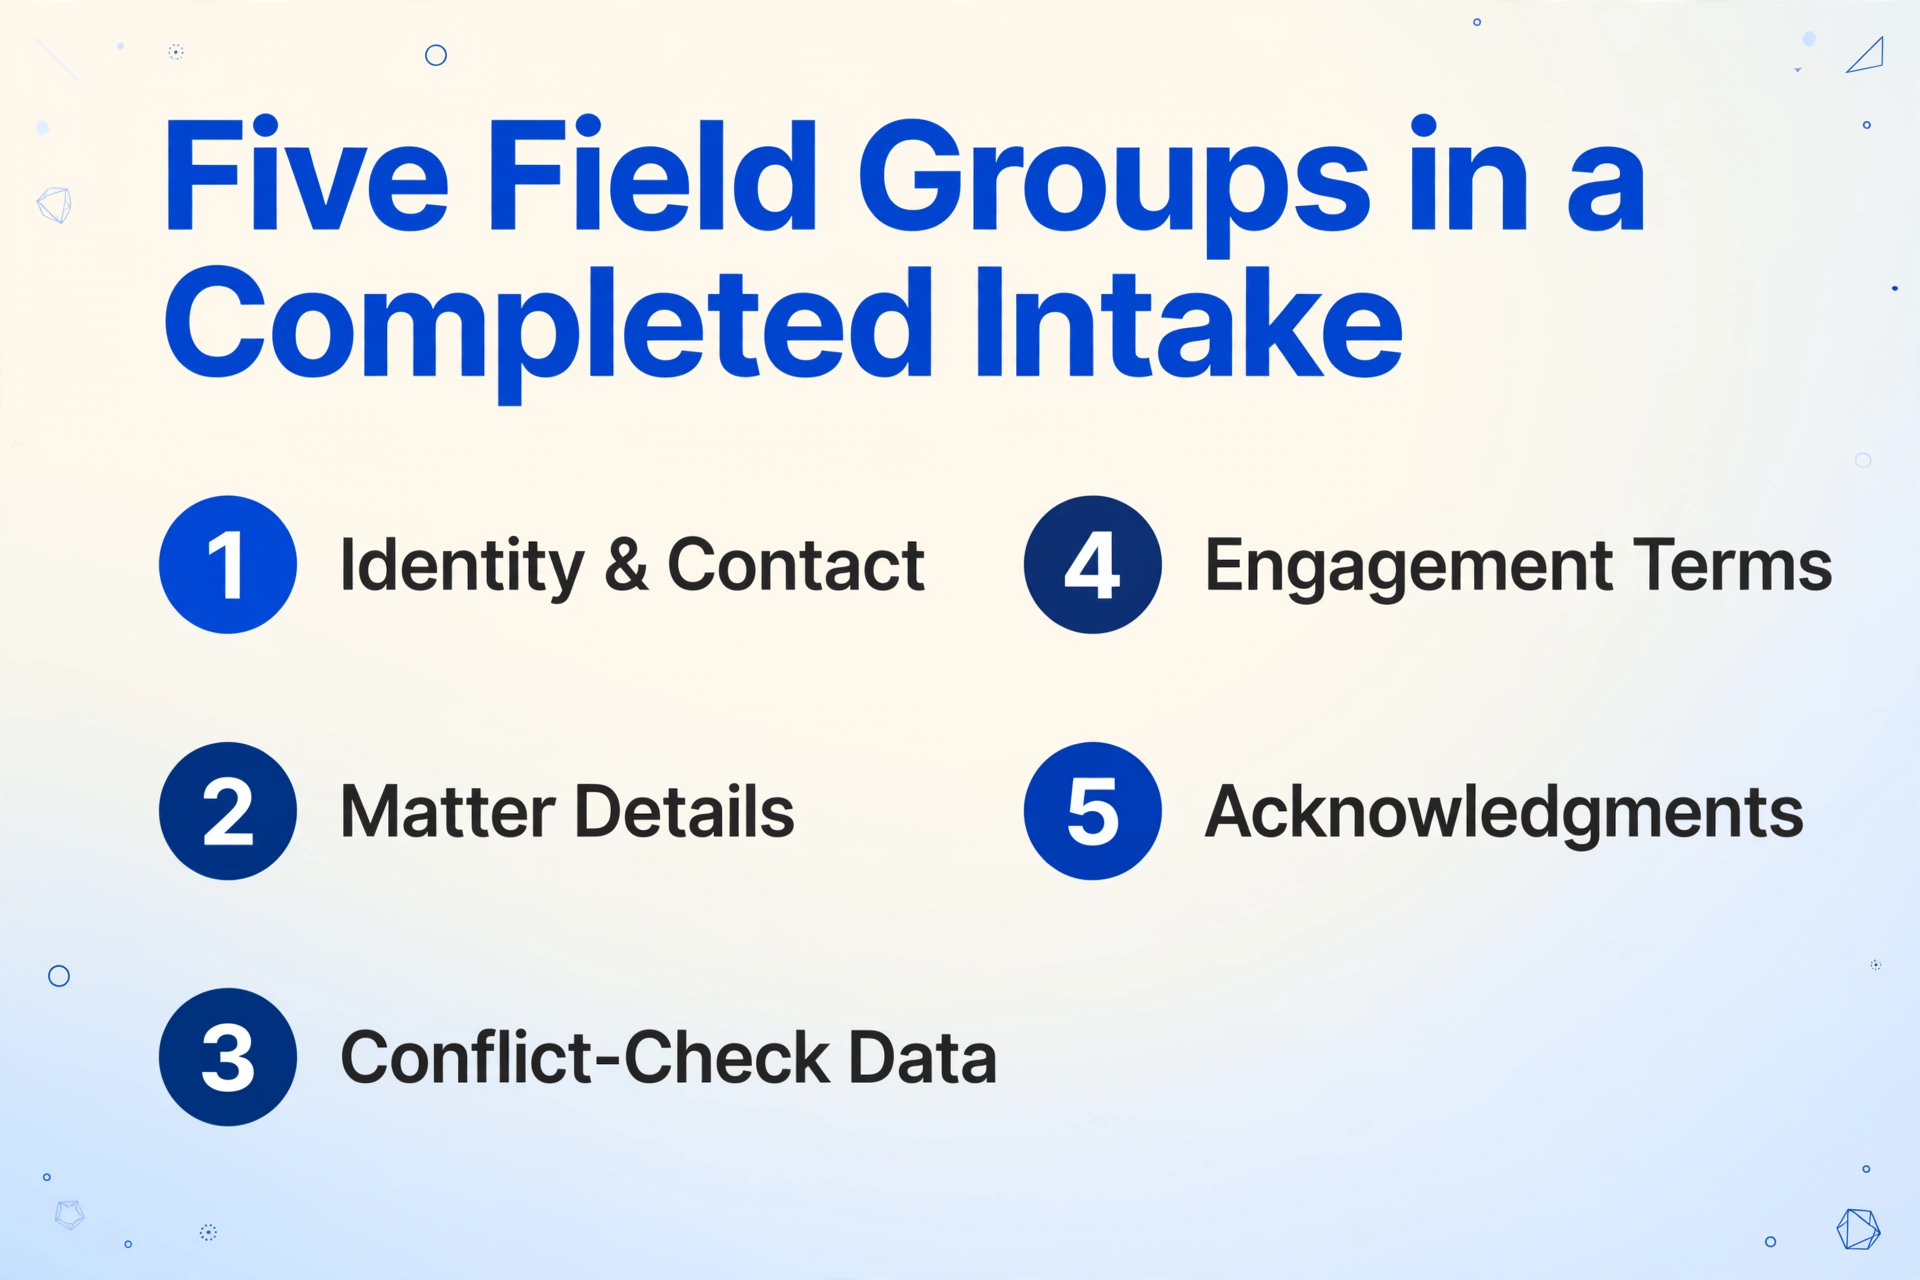
完了した受付は1つのレコードではありません。5つのフィールドグループで構成され、そのうち2つは事務所を利益相反から守るためだけに存在します。最初のグループは本人確認・連絡先です。クライアントの正式な法的氏名と使用された他の名前、郵送先住所、電話番号、メールアドレス、生年月日、紹介元が含まれます。2つ目は案件自体です。業務分野または案件種別、紛争の簡単な説明、時効や裁判所の期限を含む重要な日付です。
3つ目のグループは、受付が単なる管理ではなく規制される理由です。利益相反チェック用データには、すべての相手方当事者、その他のすべての関与当事者、そして検索を確実にする関連名を含める必要があります。ABAの受付と利益相反チェックのプロセスに関する新人弁護士向けガイダンスはこれについて具体的です。法人の場合は正式な法的氏名、別名、設立州、本社所在地が必要です。対立する案件の場合は、相手方当事者、相手方弁護士、法廷、および対象事項が必要です。ABA GPSolo部門の利益相反チェックの基本ガイドには、事務所自身の利益相反データベースが保持すべきものが列挙されています。現クライアント、元クライアント、相手方当事者、見込みクライアント、各案件の簡単な説明、開始日と終了日、関連会社、そしてクライアントの役員、取締役、主要株主です。
4つ目のグループは委任条件です。料金体系、着手金、委任範囲が含まれます。5つ目は確認事項で、主に、記入済みフォームが弁護士・クライアント関係と誤認されないようにする非委任免責事項です。
利益相反チェック用の名前は、有効期間が最も短いフィールドです。間違った日付は後で修正できます。相手方当事者の綴り間違いや欠落は、事務所が辞退すべき案件を受任してしまう原因となります。
その重みは、単なる良い慣行ではなく、ルールに明記されています。Model Rule 1.7のコメント[3]は、弁護士は事務所の規模と種類に適した合理的な手続きを採用して、関与する人物と問題を特定すべきだと述べており、その手続きを導入しなかったことによる無知は違反の言い訳にはならないと付け加えています。Model Rule 1.18は、最終的に委任を受けなかった見込みクライアントにも保護を拡大し、ABAのFormal Opinion 510(2024年3月)は、事務所が利益相反を事務所内の全弁護士に帰属させることを避けたい場合の「合理的な措置」の意味を明確にしています。これらすべてから実践的な順序が導き出されます。まず名前、次に経緯です。
クライアント受付データがコピー&ペーストのワークフローに適さない理由
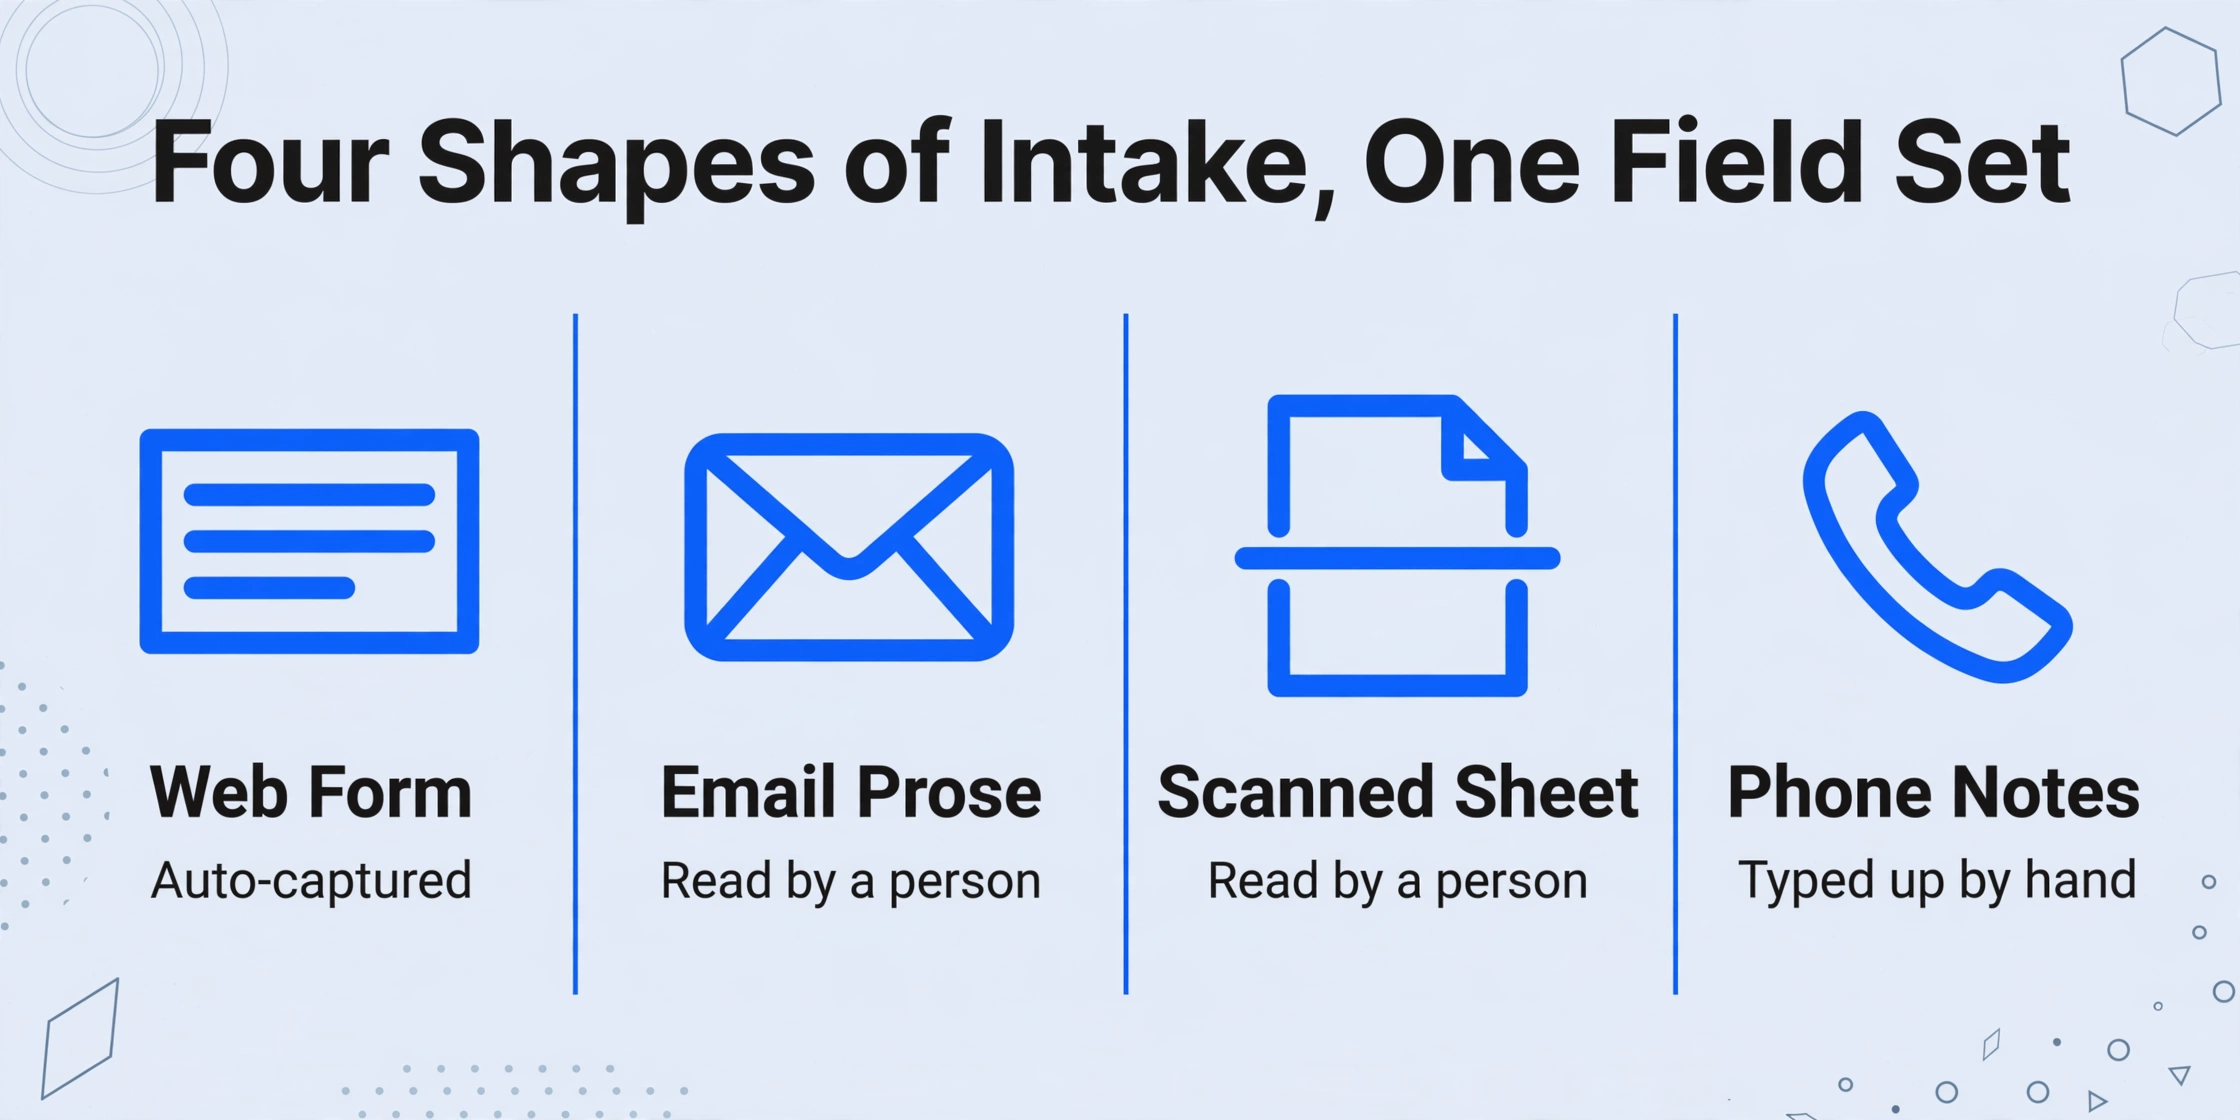
クライアント受付データを人を介して送ることは、フォーマット調整のステップではありません。同じフィールドが3、4種類の形式で3、4回読まれる場所であり、利益相反チェック用の名前の間違いは誰も気づかない類のものです。断片化が最初の理由です。名前、相手方当事者、期限という同一のフィールドセットが、Webフォームの通知、メール本文、スキャンされた手書きシート、電話メモとして届きます。パラリーガルがそれらすべてを1つの案件レコードに統合します。つまり、事務所はチャネル間の統合レイヤーとして人間に費用を支払っていることになります。
2番目の理由は、メール本文ではフィールドがきれいにラベル付けされることはほとんどないことです。クライアントが「もう一人の運転手、R. Alvarezという男性が、信号を無視した」と書きます。その一文を相手方当事者として認識し、「R. Alvarez」を検索可能な名前として取得することは読解タスクであり、まさに急いだ再入力がミドルネームのイニシャルを落としたり、名前を別の利益相反対象者ではなくクライアント自身の連絡先として記録したりするタスクなのです。
3つ目の理由は、2つのチャネルの分離です。ネイティブの受付フォームはフォームを経由するフローを十分にカバーしており、それを利用するクライアントにとっては本当の解決策です。メール経路はマニュアルのままで、標準的な法律事務所の管理システムで受信メールを読み取ってフィールドに変換する機能はありません。事務所はその結果を自分の言葉で表現しています。手動のクライアント受付に関するr/legaltechのスレッドで、ある事務所は手順を一つずつ書いていました。「見込み客がメールを送ってきます。それから、その情報を手でClioまたはMyCaseに入力します。次に、手動で利益相反をチェックします。」別の事務所は、受付フォーム自動化に関するr/LawFirmの議論で、データが「.csv形式で保存されるのではなくメッセージとして」届き、アシスタントが名前、相手方当事者、住所、生年月日をフォームに手で入力していると説明しました。
データはすでにクライアントによって一度入力されています。事務所はそのデータを二度目に入力するコストを負担しており、二度目の入力こそが間違う可能性がある部分です。
ここが、受付とその他の法的文書処理が分岐する点です。受付は、事務所が何かにコミットする前に正しくなければならない少数のフィールドであり、それらを運ぶ文書はクライアントが所有するあらゆる形式で届きます。案件が開始された後の抽出ステップは関連しているものの別の問題であり、そのため、ここではなく小規模法律事務所の文書抽出に関するガイドの質問に属します。
解決策:受付メールを読み取り、フィールドを抽出する
再入力を排除するステップは、クライアントが記入する別のフォームではなく、受付チャネル自体を対象とした抽出です。2つの機能を組み合わせて使用し、その両方を具体的に理解しておく価値があります。
1つ目はEmail Inboxです。これはアカウントに紐づく専用アドレスで、クライアントの受付メールを転送したり、電話を受けるパラリーガルとアドレスを共有したりできます。添付ファイルはアップロードページを開くことなく処理キューに届きます。テンプレートをバインドして自動処理を有効にすると、メールが届いた瞬間に処理が開始されます。送信者ホワイトリストにより、信頼できるアドレスだけが受信トレイに限定されるため、無関係なメールがキューに入ることはありません。また、クライアントがパスワード保護PDFを送信した場合、保存済みパスワードが自動的に試されます。
受付にとって最も重要な設定は、受信トレイが何を読み取るかです。デフォルトでは添付ファイルのみを処理し、メール本文は無視します。これは請求書や明細書には適切な選択です。受付は例外で、フィールドデータが添付ファイルなしでメール本文にあることが頻繁にあります。クライアントが単に「ここに私の詳細があります」と入力して送信するからです。その場合、モードを本文のみ、または添付ファイルと本文の両方に切り替えると、受付の文章が元文書になります。
2つ目の機能はカスタム列抽出です。固定レイアウトにボックスを描く代わりに、希望する列名を入力すると、ビジョンモデルが各文書またはメールを読み取り、意味に基づいて一致する値を検索します。受付ファイルでは、「相手方当事者」という列名が、メールが「相手のドライバー」と書いていても、フォームが「被告」と印刷していても、スキャンしたシートに「opposing party」と書かれていても見つかります。AIは保存された位置ではなく意味を読み取るため、同じ列リストが転送されたフォーム、手書きの受付シートの写真、プレーンなメールテキストのすべてで機能します。
5つのフィールドグループをカバーする列リストは次のようになります。
| 受付列 | 取得内容 |
|---|---|
| クライアントの正式な法的氏名 | 案件に記載される正式な法的氏名 |
| その他の使用名 | 別名、旧姓、DBA、以前の氏名(利益相反チェック用) |
| 電話 / メール / 郵送先住所 | 連絡先情報と連絡方法の希望 |
| 生年月日 | 本人確認用。同姓同名を区別する一般的な情報 |
| 案件種別 | 振り分け用の業務分野または案件カテゴリ |
| 相手方当事者 | 受付に記載されたすべての相手方当事者 |
| その他の関与当事者 | 証人、共同所有者、保険会社、融資機関、関連法人、配偶者 |
| 以前または現在の弁護士 | 当該案件ですでに相談されている他の事務所 |
| 紹介元 | クライアントが事務所を知った経路 |
| 重要期限 | 受付に記載された時効または裁判所の期日 |
| 料金体系 / 着手金 | 受付時に話し合われた委任条件 |
このツールはバッチ優先のため、1週間分の受付はファイルのフォルダではなく、見込みクライアントごとに1行が割り当てられた1つのスプレッドシートとして届きます。そのシートを確認し、法的な重みを持つフィールド、つまり相手方当事者とその他の関与当事者を最初にチェックします。Bbox verificationを使用して、任意のセルから元のメールまたはスキャン上の値の正確な場所にジャンプできます。
ファイルは安全に処理され、保存されません。
これが行わないこと、および手動のまま残ること
正直な境界線は、これがスプレッドシートを生成するものであり、Clioのレコードではないということです。ImageToTable.aiは受付文書とメールを読み取り、Excel、CSV、またはJSONをエクスポートします。ネイティブ連携を通じてClioやMyCaseに書き込むことはありません。確認されたフィールドは、担当者がClioのカスタムフィールドまたはMyCaseのケースノートに入力するか、シートから貼り付けます。APIを通じて誰も触れることなく案件を作成するフォーム送信をお求めの場合は、それは別のカテゴリのツールであり、正直な推奨として、このページがそれを行うと想定するのではなく、独自の条件で比較することをお勧めします。
2つ目の境界線は、弁護士にとって最も重要なものです。抽出は利益相反チェックを実行しません。相手方当事者と関与当事者の名前を列に入れて、検索可能な形式で名前が存在するようにします。これはRule 1.7に基づくチェックの前提条件です。それらの名前を御社の現クライアントおよび元クライアントの記録と照合し、ヒットが何を意味するかを判断することは、御社のシステムと判断に委ねられています。同じことが、抽出された名前が表面化させるのに役立つが解決はできない、元クライアントとのModel Rule 1.9の利益相反にも当てはまります。
3つ目に、抽出は案件を受任するかどうか、委任状を作成するかどうか、またはクライアントの信頼性を評価するかどうかを決定しません。これらは法的判断であり、抽出されたシートはそれらへの入力であり、代替ではありません。
受付スプレッドシートは中立的なデータではありません。Rule 1.18(b)に基づき、見込みクライアントが共有する情報は、事務所が案件を受けなくても保護されるため、シートは管理されていないドライブではなく、御社の守秘義務の取り扱いの中に属します。
最後に、スキャンされた文書に適用されるのと同じ制限がここにも適用されます。明確なタイプ入力の受付フォームとメールテキストはきれいに抽出されます。薄い手書き、映り込みのある写真撮影されたシート、または重なり合うフィールドのある窮屈なフォームは劣化し、これらは信頼するのではなく確認する値です。より高い処理ティアは、より密度の高い手書きと乱雑なスキャンを処理し、ティアはバッチごとに設定されるため、難しい受付はより高いティアで実行でき、クリーンなメール受付は経済的なままです。受付と並行して契約審査も実行する事務所にとって、フィールド単位のアプローチは、個人弁護士向けの契約抽出ガイドに記載されているものと同じであり、より広範な審査の質問は、小規模事務所向けの文書審査ソフトウェアとAI抽出の比較でカバーされています。
午後には設定できるワークフロー
5つの設定と1つの列リストで、1週間分の受付メールが確認可能なシートに変わります。各ステップは一般的な約束ではなく、具体的なコントロールに対応しています。
受付列を一度だけ定義する
上記のフィールドリストを使用します:Client Full Legal Name、Other Names Used、Phone、Email、Mailing Address、Date of Birth、Matter Type、Adverse Party、Other Involved Parties、Prior or Current Counsel、Referral Source、Key Deadline、Fee Structure。入力した列名が出力シートのヘッダーになるので、クライアントごとにフォーマットを作り直すのではなく、すべての受付チャネルで一度決めておきましょう。
受付チャネルをEmail Inboxアドレスに向ける
受付を転送する担当者にアドレスを共有するか、自分でクライアントメールを転送します。送信者ホワイトリストを有効にして、既知のチャネルのみがキューに届くようにし、設定で一般的な添付ファイルのパスワードを保存します。
受信トレイが読むものを設定し、テンプレートをバインドする
受付フィールドはメール本文にあることが多いため、処理モードを「本文と添付ファイル」に設定するか、クライアントが添付しない場合は「本文のみ」に設定します。受付列テンプレートを受信トレイにバインドし、自動処理を有効にしてメールが届いたらすぐに処理されるようにします。
利益相反チェック用の名前フィールドを最初に確認する
バッチシートを開き、Adverse Party、Other Involved Parties、Prior or Current Counselを最初に確認します。疑わしいセルにホバーすると、元のメールやスキャンのどこから値が来たかが正確に表示されるので、必要に応じて修正し、元の値が正しければAIの値に戻すことができます。
エクスポートしてClioまたはMyCaseに入力し、チェックを実行する
ExcelまたはCSVにエクスポートし、確認済みのフィールドをClioのカスタムフィールドまたはMyCaseのケースノートに貼り付けるか入力し、クライアントおよび元クライアントのリストに対して利益相反チェックを実行します。抽出が入力を代替し、検索と判断は引き続き御社のものです。
受付がすでに完全にオンライン化されており、クライアントからのメールが少ない場合は、ネイティブの受付フォームでほとんど対応でき、ここでの価値は小さくなります。このワークフローは、受付の相当な部分がメール、転送されたスキャン、手書きシートとして届く場合に力を発揮します。なぜなら、その部分にはフォームツールが届かないからです。これらの受付文書が後により広範な文書業務に使われる場合は、契約抽出の完全ガイドと法的証拠開示の文書抽出ガイドが次の段階を引き継ぎます。
FAQ
ClioやMyCaseに直接接続しますか?
いいえ、その点は明確にしておく価値があります。このツールは受付メールと文書を読み取り、Excel、CSV、またはJSONをエクスポートします。その後、担当者が確認済みフィールドをClioのカスタムフィールドまたはMyCaseのケースノートに入力または貼り付けます。受付からの再入力を排除しますが、ネイティブAPIを通じて案件レコードを作成するわけではありません。フォーム送信で案件を自動的に開く必要がある事務所は、別のカテゴリの連携製品を検討しています。
利益相反チェックを実行してくれますか?
いいえ。相手方当事者、関与当事者、以前の弁護士の名前を列に抽出して検索可能にします。これはRule 1.7が事務所に求める能力です。検索自体は御社のシステム内の現クライアントおよび元クライアントの記録に対して実行され、一致が何を意味するかはRules 1.7および1.9に基づく御社の判断です。
クライアントの受付詳細がメール本文にあり、添付ファイルがありません。機能しますか?
はい。Email Inboxのデフォルトは添付ファイルのみで、本文は無視されますが、本文のみ、または添付ファイルと本文の両方に切り替えることができます。詳細をメールに直接入力するクライアントにとって、そのモードがメッセージを元文書に変えるものです。
クライアントが撮影した、または手書きの受付フォームを送ってきた場合はどうなりますか?
画像自体からビジョンモデルによって読み取られるため、印刷されたフォームの鮮明な写真はうまく機能します。手書きはより高い処理ティアで最も良く抽出され、濃い筆記体や薄い鉛筆は確認項目として扱う必要があります。手作業で確認する価値が最も高いフィールドは常に同じで、相手方当事者と利益相反検索を左右する名前です。
見込みクライアントの受付データをこの方法で処理しても安全ですか?
ファイルは転送中に処理され、保存されず、モデル学習にも使用されません。守秘義務の問題はツールよりも広範です。Model Rule 1.18(b)に基づき、見込みクライアントが共有する情報は、委任が成立しない場合でも保護されます。したがって、抽出された受付シートは御社の守秘義務およびデータ保持方針に基づいて処理されるべきであり、クライアントまたは弁護士会が課す制限がある事務所は、それらの要件に対して処理モデルを最初に確認する必要があります。
英語以外の言語での受付も処理できますか?
はい。ビジョンモデルは複数の言語を読み取り、フィールドテキストを元の言語のまま保持します。これは、クライアントがスペイン語、フランス語、ドイツ語、ポルトガル語、日本語、または韓国語で受付メールを書く事務所にとって重要です。複数言語が混在する受付もサポートされていますが、文書の言語が切り替わる境界に位置する値は、再確認する価値があります。
有用な考え方は、受付は法的問題になる前にデータ取得問題であるということです。 クライアントはすでに質問に回答しています。事務所は単に二重に支払っているだけであり、一度はクライアントの時間で、もう一度はパラリーガルの時間で、その2回目の作業で利益相反名が間違う可能性があります。受付メールと転送されたフォームを構造化されたシートに変換することで、弁護士が必要とする部分に触れることなく、2回目の作業を排除します。
サンプルの受付メールを自分宛に送信して、結果を確認してください。 受付を1件処理して、相手方当事者の列を自分で確認してください。