USCIS通知書のデータ抽出を
移民申請受付で、仕分け不要で実現
移民案件において最も緊急性の高い書類は、スキャンされた書類の山の中で気づかれずに埋もれがちなものです。それが証拠提出要求(RFE)です。USCISポリシーマニュアルによると、標準的な回答期間はほとんどのフォームで84日間、一部のフォームでは30日間で、郵送で通知が届く場合はさらに3日間が加算されます。印刷された期限を逃した申請者は、案件が放棄されたものとして却下されるリスクがあります。その期限は、多数の通知書の中の1枚に記載された日付であり、事務所の郵便物とスキャンの処理方法が、期限内に誰かがそれに気づくかどうかを左右します。
重要なポイント
- RFEへの回答期間は標準で84日間であり、これを逃すと案件が放棄されたものとして却下される可能性があります。
- 期限の見落としは、通常、カレンダー登録のミスではなく、混在するスタックに埋もれた通知書がカレンダーに到達しなかったことが原因です。
- 列を一度定義し、モデルに仕分けされていないスタック全体を読み取らせ、元の通知書の期限と受領番号のみを確認します。
RFEの期限超過は、カレンダー管理の問題ではなく、書類対応の問題です
RFEの回答期限を過ぎてしまった場合、その原因は「誰もメモしていなかった」ということではありません。通知書が最初の1週間を混在した書類の山の中で過ごしたからです。領収書通知書や生体認証予約通知書と同じPDFにスキャンされ、別の依頼者のファイルに綴じられ、期限ページが真ん中に埋もれた状態で順番無視で撮影された。期限は通知書に印刷されていましたが、書類が適切な担当者の目に届かなかったため、カレンダーに反映されることはありませんでした。
移民書類受付チームは、この障害形態をよく知っています。USCIS書類の自動受付に関するr/legaltechの議論で、あるコメンテーターは実務のパラリーガルのようにテストを定義しました。「現実的な混合セットで試すでしょう。USCIS通知書、RFE、領収書、翻訳文書、そして人間が通常立ち止まる原因となる複数文書スキャンです。」別のコメントは、その自動化の安全なバージョンに含めるべきものを付け加えました。「不確かな項目をレビュー用バケットに振り分け、何をどのような理由で決定したかの明確な記録を残すかどうか。」
両方のコメントの暗黙の前提は、仕分けステップが最もコストのかかる部分であるということです。そのスレッドで議論されているツールは、すべてのドキュメントを分類し、自動的に関連する案件にファイルする「AI Mailroom」を販売しています。これは分類とルーティングであり、本記事で説明するものとは異なります。本記事では、よりシンプルで安全なバージョンについて説明します。抽出が読み取りを行い、タイプタグがチームのトリアージを支援し、人間が不確かな項目を確認します。
受付スタッフが実際に大量の通知書をどう処理するか
USCISは、自ら認める以上に多くの紙を送り届けています。2025会計年度に同機関は約1,369万件の申請・請願を受け付け、約1,173万件を処理しましたが、純残件数は約628万件にまで増加し、前年比65%増となりました(USCIS 2025会計年度年次報告書)。これらの申請のそれぞれが、処理過程で少なくとも1通の通知を生み出し、多くは複数通を生み出します。受領通知、予約案内、RFE、承認通知などです。数百件の未処理案件を抱える事務所では、受付デスクが毎週これらを大量に処理しています。
この作業は日常的で、ほとんどが手作業です。誰かが郵便物を開封し、紙の書類をスキャンし、各書類を読んで内容を判断します。パラリーガルがケースファイルと追跡用スプレッドシートに項目を入力します。受領番号、通知種別、サービスセンター、受領日、ケース番号、あれば優先日、RFEの場合は応答期限です。このステップの専門的基準は明確です。American Immigration CouncilのRFE応答に関する実務ヒントでは、まず期限を確認してカレンダーに記入するよう実務者に指示しており、多くの弁護士過誤保険会社は期限を2つの別々の場所に記録することを義務付けていると述べています。
この日常業務の各項目には出典があります。受領番号は通知書に記載された13桁の追跡番号で、EAC、LIN、SRC、WAC、IOEなどの3文字のサービスセンターコードで始まり、事務所がオンラインでステータスを確認するために使用します。通知種別が重要なのは、I-797ファミリーにいくつかの意味が隠されているためです。I-797Cは受領、予約、転送を伝え、I-797Eは証拠を要求する通知です。この2つを混同すると、事務所が次に行う対応が変わります。優先日は家族・雇用ベースの請願のI-797に記載され、毎月のVisa Bulletinに基づいてビザ番号がいつ利用可能になるかを決定します。それぞれが小さな読解作業であり、単独ではどれも難しいものではありません。
通知書類一式の読み取りが失敗する箇所
この失敗は構造的なものであり、スタッフの努力の問題ではありません。クライアントへの郵便物をまとめてスキャンすると、受領通知、RFE、翻訳済みの婚姻証明書が順に並んだ1つのPDFが生成されます。それを開いたパラリーガルは、頭の中でそれらを区別する必要があります。そして、中央のページにある期限は、資料管理システムでページが誤ったフォルダに添付された場合に、最も誤ってファイル整理される可能性が高い値です。
同じ情報が、I-797の各バリエーションで異なるレイアウト規則で表示されるため、位置ベースのテンプレートは頻繁に失敗します。日付は機械で印刷されたり、誰かが添付したカバーレターに手書きで記入されたりします。翻訳が英語の原本の隣に置かれ、入力担当スタッフが外国語を読めない場合があります。同じ受領番号が、異なる処置を説明する2つの通知に表示されることがあり、これは追跡シートの重複行とまったく同じように見えます。フォーム準備時間に関するr/paralegalスレッドでは、移民パラリーガルが、クライアントが事前にすべての書類を提出しない場合、自社ではフォーム1件につき1時間半から2時間が標準であると報告しています。その時間のほとんどはタイピングではありません。ケースファイルにまだ何が欠けているかを見つけるために書類一式を読むことです。
エラーのコストは一方向に増幅します。申立人の名前の綴り間違いは、書簡で修正できます。RFEの期限を逃すとケースは却下され、応答期間を規則で延長することはできません。そのリスクを伴うフィールドは、抽出が最初に正確に行わなければならないものです。
必要な列を指定し、AIに書類一式を読ませる
ここでの主要な仕組みはカスタム列抽出です。各通知レイアウトのテンプレートを作成する代わりに、必要な列名を入力すると、ビジョンモデルがアップロードされた各ドキュメントを読み取り、意味に基づいて各列に適合する値を返します。入力した列名が出力スプレッドシートのヘッダーになるため、事務所はケースファイルの語彙を一度定義するだけで、すべての通知が同じ構造を満たします。モデルはドキュメントの種類を知らなくても読むことができるため、事前の並べ替え手順は不要です。目の前にあるものから、指定したフィールドを読み取ります。
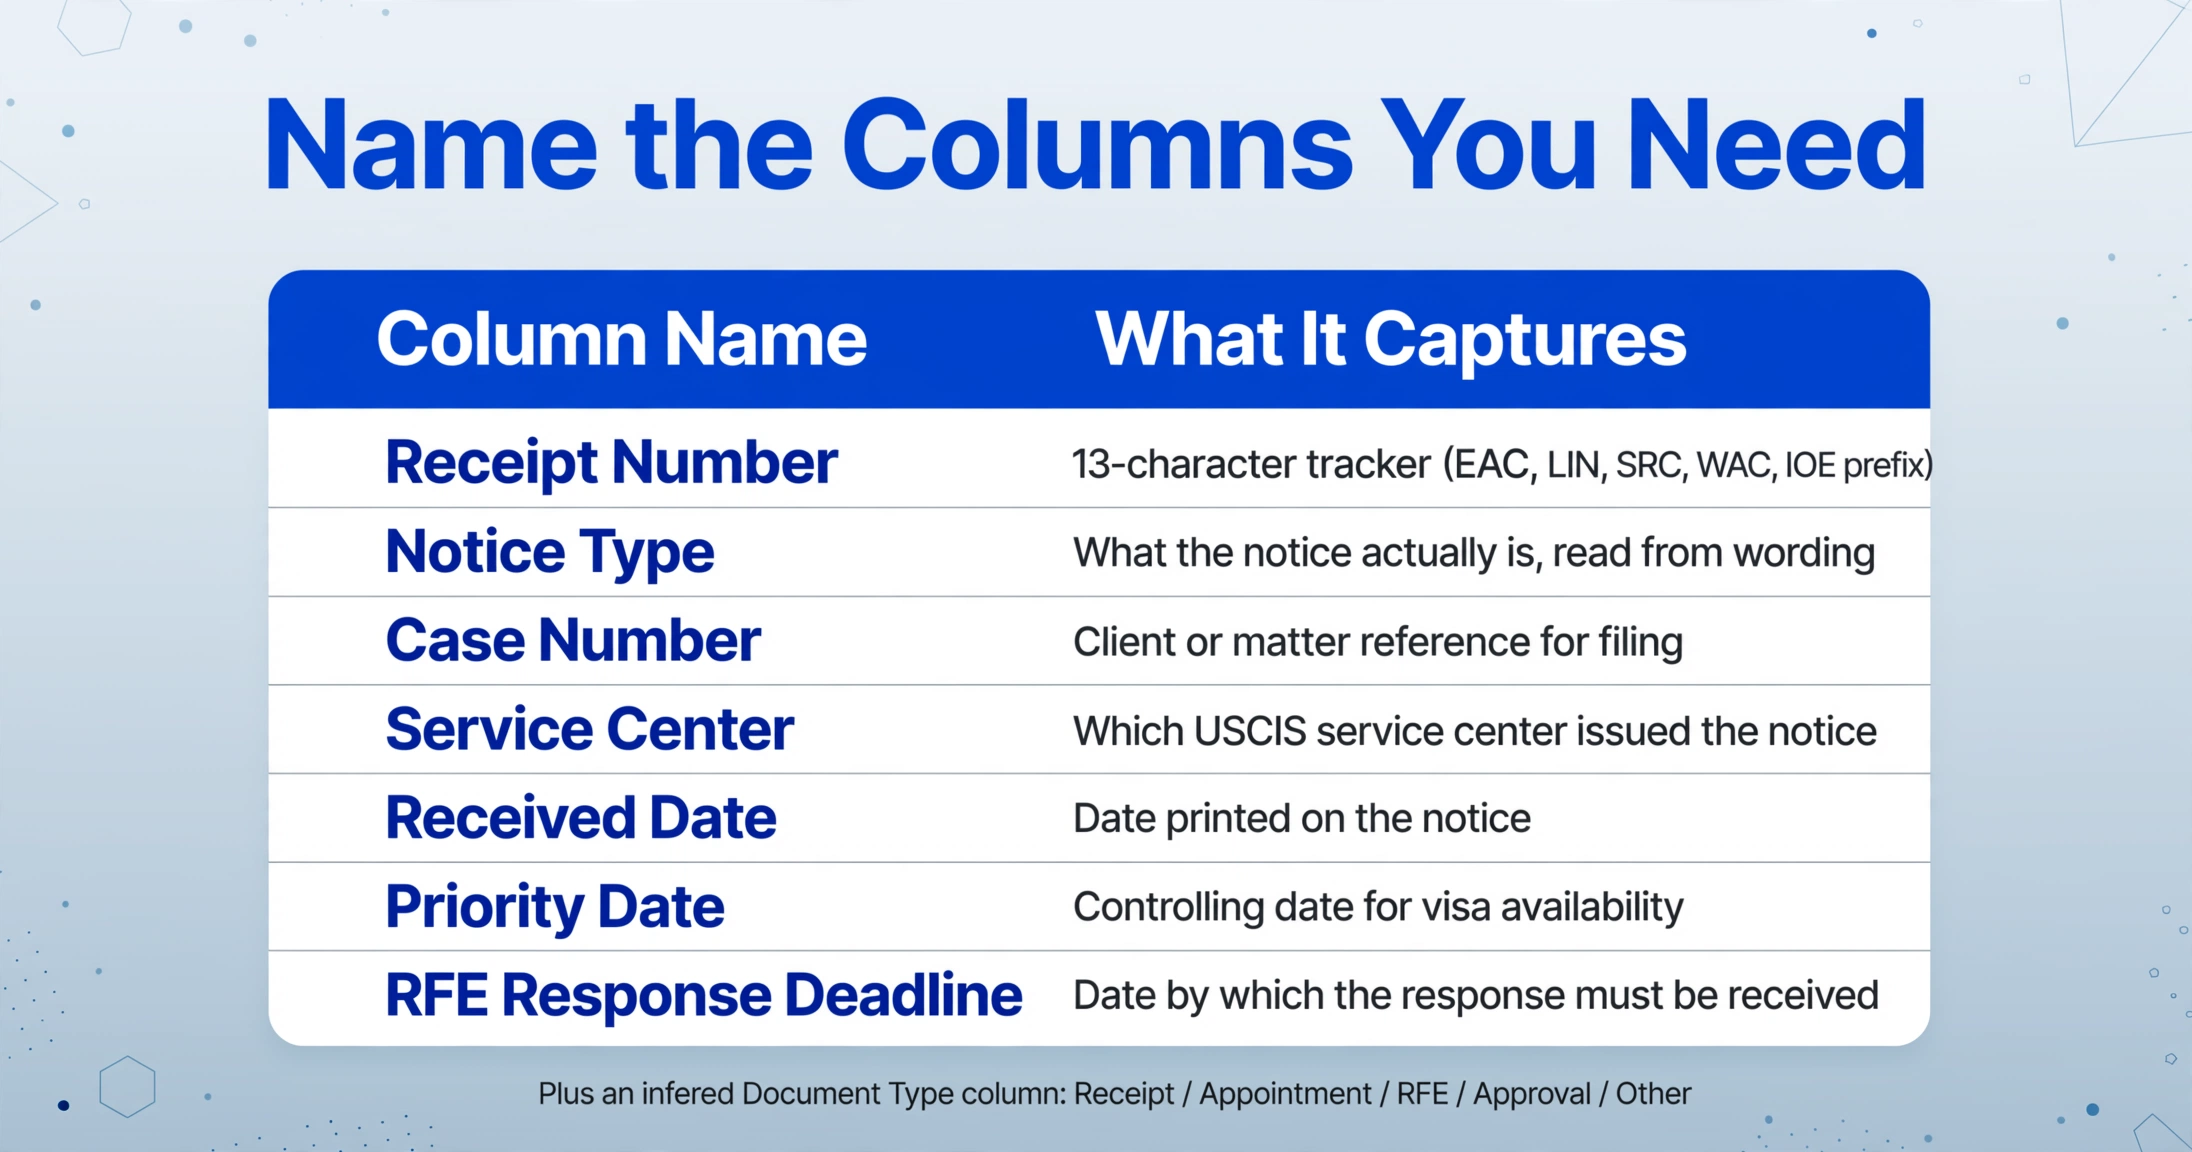
USCISの通知書類一式に有効な列リストは、次のようになります。
```| 列名 | 取得内容 |
|---|---|
| Receipt Number | ステータス確認に使う13桁のトラッカー(EAC、LIN、SRC、WAC、IOEプレフィックス) |
| Notice Type | 通知の種類。「領収書」や「証拠請求」などの文言から判別 |
| Case Number | 通知が紐づくクライアントまたは案件の参照番号 |
| Service Center | 通知を発行したUSCISサービスセンター |
| Received Date | 通知に記載された日付。期限やステータス確認の基準となる |
| Priority Date | 家族・雇用請願におけるビザ取得可能時期を左右する基準日 |
| RFE Response Deadline | RFEに記載された回答期限日 |
2つの追加機能により、抽出結果は単なるデータの羅列ではなく、受付時のトリアージとして活用できます。まず、Document Type(選択肢:Receipt / Appointment / RFE / Approval / Other)という推論列では、AIが各ドキュメントの内容からカテゴリを自動判定します。タグは専用の列に返されるため、ドキュメントの扱いを左右することはありません。パラリーガルはこの列でフィルタリングでき、Document Typeで並べ替えれば、RFEの行とその期限が一目で確認できます。スキャン済みフォームから特定フィールドを抽出する方法については、こちらのガイドで、複数レイアウトを1回のアップロードで処理する方法を含む、混合バッチの仕組みを詳しく解説しています。
2つ目の追加機能は、r/legaltechのコメント投稿者が求めたレビュー経路です。Review ModeとBbox検証により、抽出したセルにカーソルを合わせると、元の通知書のどこから値が取得されたかが正確に表示され、逆に画像上の領域をクリックすると該当セルにジャンプできます。これにより、確認作業は全通知の再読込ではなく、案件を左右する値(特にRFE期限とReceipt Number)のスポットチェックで済みます。受付現場で問題となる低品質スキャンには、より高性能な処理ティアでバッチを強力なモデルに実行できます。スキャン品質の観点については、法律文書向けOCRガイドをご参照ください。
ファイルは安全に処理され、保存されることはありません。
これが行わないこと:ファイル分割なし、ルーティングなし
境界が重要なのは、あのリーガルテックのスレッドで宣伝されている代替手段がより完全に見えるからです。ImageToTable.aiは書類の山を分類して各ドキュメントを別のフォルダ、案件、またはシステムにルーティングするわけではありません。複数ドキュメントのスキャンを別々のファイルに分割することもなく、Clio、Docketwise、INSZoomに行を書き込むこともありません。複数の書類が1つのPDFにスキャンされた場合、アップロードごとに1行が生成され、各列が1つの通知を保持するように分離するのは人間が先に行うステップです。その種の前処理が受付ルーチンの一部である場合、当社のバッチ抽出ワークフローは書類が分割された後に適用されます。
推論列からのタイプタグはトリアージのヒントです。それ自体がドキュメントの所属先を決定するわけではありません。モデルがOtherとラベル付けしたドキュメント、または期限を明確に読み取れなかったRFEは、何かを信頼する前に人の手に渡すべき行です。レビューパスは不確実性が黙殺されるのではなく可視化されるために存在します。これはディスカバリーの文脈での小規模法律事務所向けバッチ抽出が引く同じ正直な線であり、ディスカバリーは異なるワークフローです。移民受付版はドキュメントコーパスではなく期限フィールドに信頼性を集中させます。
法的判断は法律事務所に委ねられます。抽出は通知の内容を伝えるものであり、そこに記載された破れた証拠チェーンに対して何をすべきかを指示するものではなく、出力のいずれも法的助言ではありません。クライアント移民ファイルの機密性の取り扱いは依然としてスプレッドシートとスキャンの保存場所を左右し、クライアントまたは弁護士会が課すベンダー制限の対象となる事務所は、まずそれらの要件に対して処理および保持モデルを確認する必要があります。スタッフが案件を担うフィールドを確認し、このツールの価値はその週の読み取りとタイピングの部分を圧縮することであり、確認を置き換えることではありません。
インテーク抽出ワークフローの設定
このワークフローは半日で完了し、各ステップを約束ではなく1つのコントロールに対応付けます。設定は次のようになります:
通知の列を一度だけ定義する
上記のフィールドリストを使用します:Receipt Number、Notice Type、Case Number、Service Center、Received Date、Priority Date、RFE Response Deadline。カテゴリオプションを指定してDocument Typeの推論列を追加します。これらの列名がスプレッドシートのヘッダーになるため、すべてのインテークチャネルで一度合意してください。
仕分けせずにスタック全体をアップロードする
クライアントフォルダのスキャンを1つのバッチに入れます。順序は問わず、フォーマットが混在しても構いません。バッチは通知ごとに1行のスプレッドシートを生成し、これがトラッキングシートとケースファイルに供給される統合データとなります。
Document TypeでフィルタリングしてRFE行を見つける
Document Type列で出力を並べ替えます。RFEとNOIDの行が期限と並んで表示され、受領行が予約行から分離されるため、スキャンを読み直す必要はありません。
原本で期限と受領番号を確認する
Review Modeを開き、ケースを動かす行のRFE Response DeadlineとReceipt Numberのセルにカーソルを合わせます。Bboxが各値の取得元を正確にハイライトするため、通知を一目見るだけで確認でき、再読込の必要はありません。
エクスポートして期限を2か所に記録する
ExcelまたはCSVにエクスポートします。確認済みフィールドをマターファイルとカレンダーに入力し、医療過誤保険の慣行に従ってリマインダーを設定します。抽出により読み取りと入力が不要になり、二重記録は安全策として残ります。
インテークをさらに進めたい事務所は、これをアップロードしたドキュメントをスプレッドシートに変換する機能と組み合わせて、証拠書類のレターや翻訳文書を処理できます。同じ列テンプレートが英語の原本と翻訳コピーの両方を扱えるため、追加設定は不要です。法的なディスカバリ作業との明確な境界線についてはディスカバリデータ抽出ガイドで説明しています:ドキュメントの母集団は異なりますが、基盤となる抽出は同じです。
FAQ
何も入力する前に、領収書通知とRFEを区別できますか?
はい、受付に重要な意味で可能です。Document Type列が各通知にカテゴリをタグ付けするため、RFEの行を誰かがすべてのスキャンを読む前に並べ替えて確認できます。タグはトリアージ用の提案に過ぎず、ドキュメントの所属先を決定するものではありません。モデルが「その他」バケットに分類したドキュメントは担当者に回され、各RFE行の期限はReview Modeで確認されてから信頼されます。
RFEの期限は通知に印刷された日付から取得されますか?
はい。Response Deadline列は通知に印刷された期限から読み取られます。これはUSCIS Policy Manualに基づく基準日です。期限はReview Modeで元画像と照合されるため、カレンダーに値が入る前に誤読やOCRのアーティファクトを検出できます。
スキャンが1つのPDFに複数のドキュメントを混在させています。対応できますか?
部分的に対応可能で、明確にしておく価値があります。ツールはアップロードされたドキュメントをそのまま読み取るため、複数ドキュメントのPDFはアップロード全体として1行を返します。別々の通知が1つのファイルにスキャンされた場合、担当者が先に分離してからバッチを実行します。未分類のトピックは未結合のものほど重要ではありません。バッチ内の通知の順序は抽出に影響しません。
Clio、Docketwise、またはケース管理システムに書き込まれますか?
いいえ、それは意図的です。ツールはExcel、CSV、またはJSONをエクスポートし、確認済みのフィールドは担当者がケース管理システムに入力します。ドキュメントを異なる案件にルーティングしたり、自動的にファイルしたりすることはありません。分類・ルーティング動作を約束するツールは別のカテゴリであり、それを求めるチームは独自の基準で評価すべきです。
スキャンの品質が低い場合やページの一部が切れている場合はどうなりますか?
品質の低いスキャンはレビューに戻されます。より高い処理ティアは、密度の高い文書や劣化した文書に適した強力なモデルを使用し、Review Modeは不確かなセルを黙って通すのではなく可視化します。スキャン品質の上限は、あらゆる法務文書処理ワークフローが直面するものであり、実践的な対応も同じです。フラグを立て、確認し、修正する。
有用な考え方として、受付は入力の問題である前に読み取りの問題です。パラリーガルが通知の山に費やす1時間は、各ドキュメントが何であるか、ケースファイルにまだ必要なフィールドはどれかを把握することにほとんど使われます。列に一度名前を付け、ビジョンモデルにスタック全体を読み取らせ、各ドキュメントのタイプをトリアージ用にタグ付けすることで、その読み取りをレビューパスに圧縮し、ケースを実際に危険にさらす可能性のある期限は、担当者が確認するまで独自の列に表示され続けます。
ご自身の通知スキャンを1つ実行して、期限列を自分で確認してください。机の上にある実際のRFEでお試しください。