USCIS Notice Data Extraction für
Immigration Intake, ohne vorheriges Sortieren
Das Dokument mit der kürzesten Frist in einem Einwanderungsfall ist auch dasjenige, das am wahrscheinlichsten unbemerkt in einem Stapel von Scans liegt: ein Request for Evidence (RFE). Gemäß dem USCIS Policy Manual beträgt die Standardantwortzeit 84 Tage für die meisten Formulare, 30 für einige andere, mit drei zusätzlichen Tagen, wenn die Mitteilung per Post eintrifft. Ein Antragsteller, der die aufgedruckte Frist versäumt, riskiert, dass der Fall als aufgegeben abgelehnt wird. Diese Frist ist ein Datum auf einer Mitteilung unter vielen, und alles, wie die Post und die Scans einer Kanzlei behandelt werden, bestimmt, ob jemand sie rechtzeitig sieht.
Wichtigste Erkenntnisse
- 84 Tage sind das Standardfenster, um auf einen RFE zu antworten, und das Versäumen kann dazu führen, dass der Fall als aufgegeben abgelehnt wird.
- Eine versäumte Frist ist in der Regel kein Kalenderfehler, sondern eine Mitteilung, die in einem gemischten Stapel vergraben war und nie einen Kalender erreicht hat.
- Benennen Sie die Spalten einmal, lassen Sie das Modell den gesamten unsortierten Stapel lesen und bestätigen Sie dann nur die Frist und die Empfangsnummer auf der ursprünglichen Mitteilung.
Verpasste RFE-Fristen sind ein Dokumentenbearbeitungsfehler, kein Kalenderproblem
Wenn eine RFE-Antwortfrist verpasst wird, liegt es meist nicht daran, dass niemand sie notiert hat. Sondern daran, dass die Mitteilung ihre erste Woche in einem gemischten Stapel verbrachte: in dieselbe PDF eingescannt wie eine Empfangsbestätigung und ein Biometrie-Terminbrief, unter dem falschen Mandanten abgelegt oder in falscher Reihenfolge fotografiert, mit der Fristseite in der Mitte vergraben. Die Frist stand auf der Mitteilung, aber sie erreichte nie einen Kalender, weil das Dokument nie die richtige Person erreichte.
Intake-Teams in der Einwanderungsbranche kennen dieses Fehlermuster genau. In einer r/legaltech-Diskussion über automatisierte Erfassung von USCIS-Dokumenten formulierte ein Kommentator den Test, wie es eine erfahrene Paralegal tun würde: „Ich würde den Test mit einer realistischen Mischung durchführen: USCIS-Mitteilungen, RFEs, Empfangsbestätigungen, Übersetzungen und alle mehrseitigen Scans, die normalerweise Menschen zögern lassen." Ein anderer ergänzte, was die sichere Version dieser Automatisierung enthalten muss: „ob sie unsichere Elemente in einen Prüfbereich weiterleitet und eine klare Spur hinterlässt, was sie entschieden hat und warum."
Der unausgesprochene Teil beider Kommentare ist, dass der Sortierschritt der teure ist. Das in diesem Thread diskutierte Tool vermarktet eine „KI-Poststelle", die jedes Dokument klassifiziert und automatisch der richtigen Akte zuordnet. Das ist Klassifizierung plus Weiterleitung, und das ist nicht das, was dieser Artikel beschreibt. Dieser Artikel beschreibt die einfachere, sicherere Version: Die Extraktion übernimmt das Lesen, ein Typ-Tag hilft Ihrem Team bei der Priorisierung, und ein Mensch bestätigt die unsicheren Elemente.
Was die Intake-Mitarbeiter tatsächlich mit einem Stapel Bescheiden tun
USCIS versendet weit mehr Papier, als es zugibt. Im Haushaltsjahr 2025 erhielt die Behörde etwa 13,69 Millionen Anträge und Petitionen und bearbeitete etwa 11,73 Millionen, während der Netto-Rückstau auf rund 6,28 Millionen Fälle anwuchs – ein Anstieg von 65 Prozent gegenüber dem Vorjahr (USCIS-Jahresbericht FY 2025). Jede dieser Einreichungen erzeugt auf dem Weg mindestens eine Mitteilung, die meisten erzeugen mehrere: eine Eingangsbestätigung, ein Terminschreiben, ein RFE, eine Genehmigung. Für eine Kanzlei mit einigen hundert offenen Fällen verarbeitet die Intake-Abteilung jede Woche einen Stapel davon.
Der Arbeitsablauf ist routiniert und weitgehend manuell. Jemand öffnet die Post, scannt, was auf Papier ist, und liest jedes Dokument, um zu entscheiden, was es ist. Ein Paralegal trägt die Felder in die Fallakte und die Tracking-Tabelle ein: Receipt Number, Notice Type, Service Center, Received Date, Case Number, Priority Date, falls vorhanden, und bei einem RFE die Antwortfrist. Der professionelle Standard für diesen Schritt ist klar. Der Practice Tip des American Immigration Council zur Beantwortung eines RFE rät den Praktikern, zuerst das Fälligkeitsdatum zu ermitteln und im Kalender zu vermerken, und weist darauf hin, dass viele Berufshaftpflichtversicherer verlangen, dass Fristen an zwei getrennten Orten erfasst werden.
Jedes Feld in dieser Routine hat eine Quelle. Die Receipt Number ist der 13-stellige Tracker auf der Mitteilung, beginnend mit einem dreistelligen Service-Center-Code wie EAC, LIN, SRC, WAC oder IOE, den die Kanzlei verwendet, um den Status online zu prüfen. Der Notice Type ist wichtig, weil die I-797-Familie mehrere Bedeutungen verbirgt: Eine I-797C kommuniziert Eingang, Termin oder Übertragung, während eine I-797E die Mitteilung ist, die Beweise anfordert – und die Verwechslung der beiden ändert, was die Kanzlei als Nächstes tut. Die Priority Date erscheint auf I-797 für Familien- und Beschäftigungspetitionen und steuert, wann eine Visanummer gemäß dem monatlichen Visa Bulletin verfügbar wird. Jede dieser Aufgaben ist eine kleine Leseaufgabe, und keine davon ist für sich genommen schwierig.
Wo das Lesen eines Bescheidstapels schiefgeht
Die Fehler sind struktureller Natur und nicht eine Frage des Aufwands der Mitarbeiter. Ein Scanner, der den gesamten Posteingang eines Mandanten bündelt, erzeugt eine PDF mit einer Eingangsbestätigung, einem RFE und einer übersetzten Heiratsurkunde in Folge. Die Paralegal, die sie öffnet, muss sie gedanklich trennen, und die Frist auf der mittleren Seite ist genau der Wert, der am wahrscheinlichsten falsch abgelegt wird, wenn die Seiten im Matter-Management-System an den falschen Ordner angehängt werden.
Dieselben Informationen erscheinen mit unterschiedlichen Layout-Konventionen in den I-797-Varianten, sodass positionsbasierte Vorlagen regelmäßig versagen. Daten werden maschinell gedruckt oder handschriftlich auf einem beigefügten Begleitschreiben markiert. Eine Übersetzung liegt neben dem englischen Original, und das Aufnahmepersonal liest die Fremdsprache möglicherweise nicht. Dieselbe Receipt Number kann auf zwei Bescheiden erscheinen, die unterschiedliche Maßnahmen beschreiben, was genau wie eine doppelte Zeile im Tracking-Blatt aussieht. In einem r/paralegal-Thread zur Formularvorbereitungszeit berichtete eine Einwanderungs-Paralegal, dass eineinhalb bis zwei Stunden pro Formular in ihrer Kanzlei die Norm sind, wenn Mandanten nicht alle Dokumente im Voraus liefern. Der meiste Teil dieser Zeit ist nicht Tippen. Es ist das Lesen des Stapels, um herauszufinden, welche Felder in der Fallakte noch fehlen.
Die Kosten eines Fehlers wirken in eine Richtung. Eine falsche Schreibweise eines Antragstellernamens ist mit einem Brief korrigierbar. Eine versäumte RFE-Frist ist ein abgelehnter Fall, und das Antwortfenster kann nicht per Verordnung verlängert werden. Das Feld, das dieses Risiko trägt, ist das, das die Extraktion zuerst richtig machen muss.
Benennen Sie die benötigten Spalten und lassen Sie die KI den gesamten Stapel lesen
Der Kernmechanismus hier ist Benutzerdefinierte Spaltenextraktion. Statt für jedes Bescheid-Layout eine Vorlage zu erstellen, geben Sie die gewünschten Spaltennamen ein, und ein Vision-Modell liest jedes hochgeladene Dokument und gibt den Wert zurück, der jeder Spalte inhaltlich entspricht. Die von Ihnen eingegebenen Spaltennamen werden zu den Kopfzeilen der Ausgabetabelle, sodass die Kanzlei ihr Fallakten-Vokabular einmal definiert und jeder Bescheid dieselbe Struktur ausfüllt. Kein Sortierschritt kommt zuerst, denn das Modell muss den Dokumenttyp nicht kennen, bevor es lesen kann: Es liest die von Ihnen benannten Felder aus dem, was vor ihm liegt.
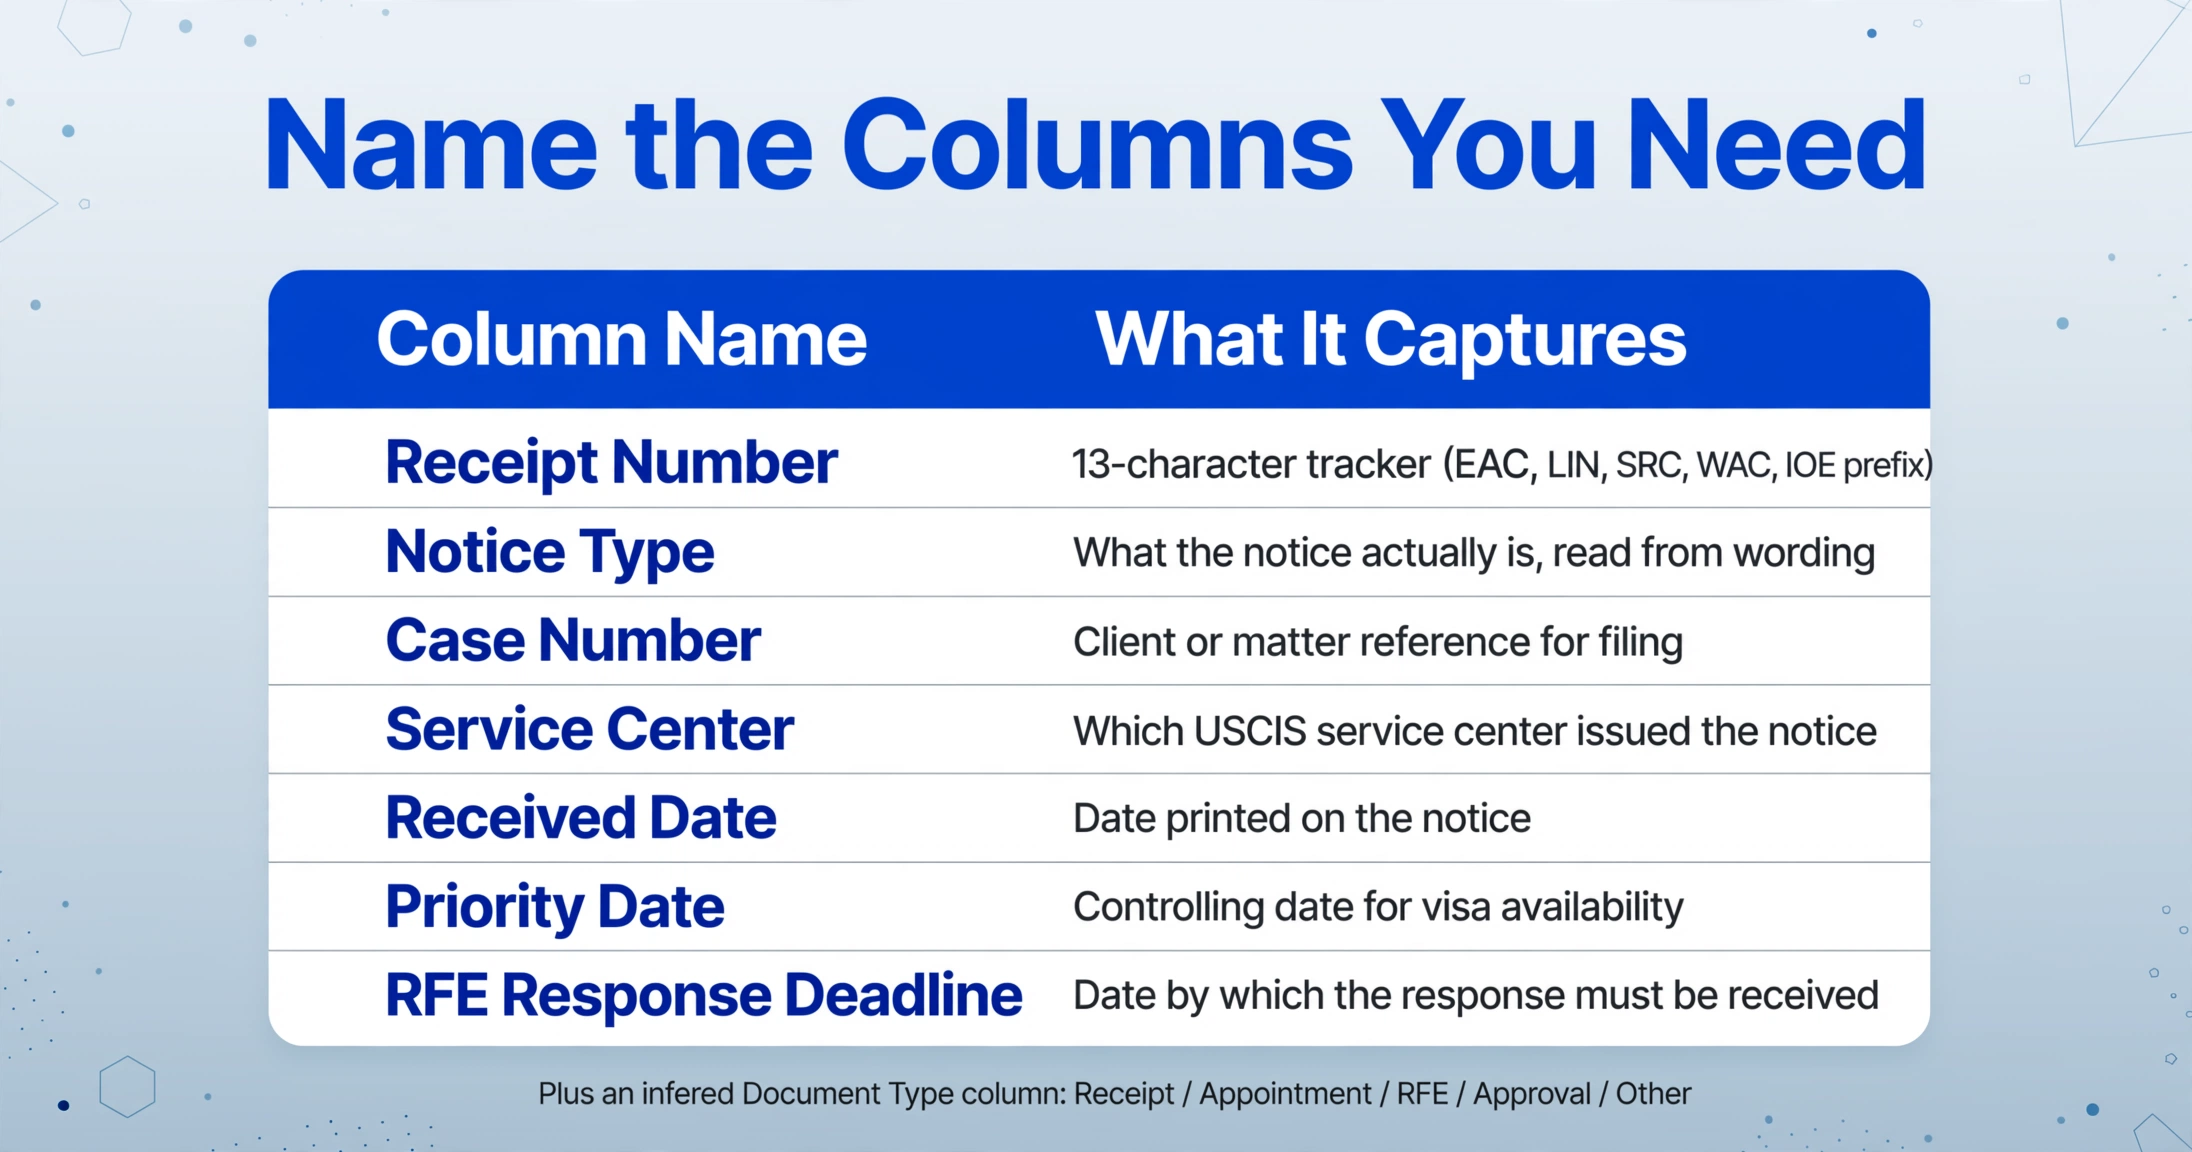
Eine praktikable Spaltenliste für einen USCIS-Bescheidstapel sieht so aus:
| Spaltenname | Was erfasst wird |
|---|---|
| Receipt Number | Der 13-stellige Tracker (Präfix EAC, LIN, SRC, WAC, IOE) für Statusabfragen |
| Notice Type | Was die Mitteilung tatsächlich ist, abgelesen aus Formulierungen wie „receipt" oder „request for evidence" |
| Case Number | Das Mandanten- oder Vorgangsreferenzkennzeichen, unter dem die Mitteilung abgelegt ist |
| Service Center | Welches USCIS Service Center die Mitteilung ausgestellt hat |
| Received Date | Das auf der Mitteilung aufgedruckte Datum, das Fristen und Statusabfragen verankert |
| Priority Date | Das maßgebliche Datum für die Visumverfügbarkeit bei Familien- und Beschäftigungsanträgen |
| RFE Response Deadline | Das auf dem RFE aufgedruckte Datum, bis zu dem die Antwort eingegangen sein muss |
Zwei Ergänzungen machen die Extraktion zu einem brauchbaren Eingangs-Triage-Werkzeug und nicht nur zu einem Datendump. Eine abgeleitete Spalte namens Document Type (Optionen: Receipt / Appointment / RFE / Approval / Other) fordert die KI auf, jedes Dokument mit einer aus seinem Inhalt abgeleiteten Kategorie zu kennzeichnen. Da das Tag in einer eigenen Spalte zurückgegeben wird, entscheidet es nicht über das Schicksal des Dokuments. Es gibt der Paralegal eine filterbare Spalte: Nach Document Type sortieren, und die RFE-Zeilen tauchen mit ihren Fristen daneben auf. Unser Leitfaden zum Extrahieren bestimmter Felder aus gescannten Formularen behandelt die hier wirkende Mixed-Batch-Mechanik, einschließlich der Handhabung mehrerer Layouts in einem Upload.
Die zweite Ergänzung ist der Prüfpfad, auf dem der r/legaltech-Kommentator bestanden hat. Review Mode mit Bbox-Verifizierung ermöglicht es jedem, über eine extrahierte Zelle zu fahren, um genau zu sehen, woher der Wert auf der ursprünglichen Mitteilung stammt, und umgekehrt auf den Bildbereich zu klicken, um zur Zelle zurückzuspringen. Das verwandelt den Bestätigungsschritt in eine Stichprobenprüfung der Werte, die den Fall tragen – insbesondere der RFE-Frist und der Receipt Number – statt einer vollständigen Neuerfassung jeder Mitteilung. Für die minderwertigen Scans, die die Eingangsabteilungen plagen, verarbeitet eine höhere Verarbeitungsstufe den Batch mit einem stärkeren Modell – das ist die Option, die der Leitfaden zur OCR für Rechtsdokumente auf der Scan-Qualitätsseite abdeckt.
Dateien werden sicher verarbeitet und nicht gespeichert.
Was dieses Tool nicht leistet: Keine Dateiaufteilung, kein Routing
Die Abgrenzung ist wichtig, gerade weil die Alternative, die in diesem Legaltech-Thread beworben wird, umfassender klingt. ImageToTable.ai klassifiziert keinen Stapel und leitet dann jedes Dokument in einen anderen Ordner, Fall oder ein anderes System weiter. Es teilt einen Scan mit mehreren Dokumenten nicht in separate Dateien auf und schreibt auch keine Zeilen in Clio, Docketwise oder INSZoom. Wenn mehrere Dokumente in eine PDF-Datei gescannt wurden, erhalten Sie eine Zeile pro Upload. Das Trennen, sodass jede Zeile eine Mitteilung enthält, ist ein Schritt, den zuerst eine Person durchführt. Wenn diese Art der Vorverarbeitung Teil Ihrer Eingangsroutine ist, kommt unser Batch-Extraktions-Workflow nach der Aufteilung der Dokumente zum Einsatz.
Das Typ-Tag aus der abgeleiteten Spalte ist ein Hinweis für die Sortierung. Es entscheidet nicht allein, wohin ein Dokument gehört. Ein Dokument, das das Modell als „Andere" kennzeichnet, oder ein RFE, dessen Frist es nicht sauber lesen konnte, ist genau die Zeile, die zuerst einer Person vorgelegt werden sollte, bevor man sich darauf verlässt. Der Prüfpfad existiert, damit Unsicherheit sichtbar statt still ist. Dies ist dieselbe ehrliche Linie, die Batch-Extraktion für kleine Anwaltskanzleien im Discovery-Kontext zieht, und Discovery ist ein anderer Workflow; die Einwanderungs-Intake-Version konzentriert ihre Zuverlässigkeit auf das Fristenfeld statt auf einen Dokumentenkorpus.
Die rechtliche Beurteilung verbleibt bei der Kanzlei. Die Extraktion sagt Ihnen, was eine Mitteilung besagt, nicht, was Sie gegen die beschriebene unterbrochene Beweiskette tun sollen, und nichts in der Ausgabe ist Rechtsberatung. Der vertrauliche Umgang mit Mandanten-Einwanderungsakten regelt weiterhin, wo die Tabelle und die Scans gespeichert werden. Kanzleien, die mandanten- oder berufsrechtlichen Anbieterbeschränkungen unterliegen, sollten das Verarbeitungs- und Aufbewahrungsmodell zuerst mit diesen Anforderungen abgleichen. Mitarbeiter bestätigen die Felder, die den Fall tragen, und der Wert des Tools liegt darin, den Lese- und Tippaufwand dieser Woche zu reduzieren, nicht darin, die Bestätigung zu ersetzen.
Einrichtung des Intake-Extraktions-Workflows
Der Workflow passt in einen Nachmittag und ordnet jeden Schritt einer konkreten Steuerung zu, statt Versprechungen zu machen. So sieht die Konfiguration aus:
Die Bescheidspalten einmal festlegen
Verwenden Sie die Feldliste oben: Receipt Number, Notice Type, Case Number, Service Center, Received Date, Priority Date, RFE Response Deadline. Fügen Sie die abgeleitete Spalte Document Type mit den Kategorieoptionen hinzu. Diese Spaltennamen werden zu Ihren Tabellenkopfzeilen – legen Sie sie daher einmal für jeden Intake-Kanal fest.
Den gesamten Stapel hochladen, nicht die vorsortierte Auswahl
Legen Sie die Scans des Mandantenordners in einen Batch. Die Reihenfolge spielt keine Rolle, und die Formate können gemischt sein. Der Batch erzeugt eine Tabelle mit einer Zeile pro Bescheid – das ist die Konsolidierung, die das Tracking-Sheet und die Fallakte speist.
Nach Document Type filtern, um die RFE-Zeilen zu finden
Sortieren Sie die Ausgabe nach der Spalte Document Type. Die RFE- und NOID-Zeilen erscheinen mit ihren Fristen direkt daneben, und die Empfangsbestätigungszeilen trennen sich von den Terminzeilen, ohne dass jemand die Scans erneut lesen muss.
Frist und Receipt Number am Original überprüfen
Öffnen Sie Review Mode und fahren Sie mit der Maus über die Zellen für RFE Response Deadline und Receipt Number in den Zeilen, die einen Fall voranbringen. Bbox hebt genau hervor, woher jeder Wert stammt – so genügt ein Blick auf den Bescheid statt einer erneuten Durchsicht.
Exportieren und die Frist an zwei Stellen erfassen
Exportieren Sie nach Excel oder CSV. Tragen Sie die bestätigten Felder in die Fallakte und Ihren Kalender ein, wie es die Malpractice-Versicherungskonvention verlangt, und setzen Sie dann die Erinnerung. Die Extraktion hat das Lesen und Tippen übernommen; die doppelte Erfassung bleibt als Sicherheitsnetz bestehen.
Kanzleien, die den Intake weiter ausbauen möchten, können dies mit der Umwandlung eines beliebigen hochgeladenen Dokuments in eine Tabelle für die begleitenden Nachweis- und Übersetzungsschreiben kombinieren – dieselbe Spaltenvorlage verarbeitet sowohl englische Originale als auch übersetzte Kopien ohne zweite Einrichtung. Die klare Abgrenzung zu juristischen Discovery-Arbeiten wird in der Anleitung zur Discovery-Datenextraktion behandelt: andere Dokumentbestände, dieselbe zugrunde liegende Extraktion.
FAQ
Kann das System eine Eingangsbestätigung von einem RFE unterscheiden, bevor etwas eingegeben wurde?
Ja, in dem Sinne, der für die Erfassung wichtig ist: Die Spalte Document Type kennzeichnet jede Mitteilung mit ihrer Kategorie, sodass die RFE-Zeilen sortiert und geprüft werden können, ohne dass zuerst jeder Scan gelesen werden muss. Die Kennzeichnung ist nur ein Vorschlag für die Sortierung; sie entscheidet nicht darüber, wohin ein Dokument gehört. Ein Dokument, das das Modell in die Kategorie „Andere" einordnet, wird an eine Person weitergeleitet, und die Frist in jeder RFE-Zeile wird im Review Mode geprüft, bevor man sich darauf verlässt.
Wird die RFE-Frist aus dem auf der Mitteilung aufgedruckten Datum übernommen?
Ja. Die Spalte Response Deadline wird aus der auf der Mitteilung aufgedruckten Frist gelesen, also dem Datum, das gemäß USCIS Policy Manual maßgeblich ist. Da die Frist im Review Mode auch mit dem Originalbild abgeglichen wird, kann die Kanzlei einen Lesefehler oder ein OCR-Artefakt erkennen, bevor der Wert im Kalender landet.
Unsere Scans enthalten mehrere Dokumente in einer PDF-Datei. Funktioniert das?
Teilweise, und das sollte klar gesagt sein: Das Tool liest Dokumente so, wie sie hochgeladen wurden. Eine PDF mit mehreren Dokumenten liefert daher eine Zeile für den gesamten Upload. Wenn separate Mitteilungen in eine Datei gescannt wurden, trennt eine Person sie zuerst, und dann läuft der Batch. Die unsortierte Reihenfolge ist weniger problematisch als die ungetrennte: Die Reihenfolge der Mitteilungen innerhalb des Batches hat keinen Einfluss auf die Extraktion.
Schreibt das Tool in Clio, Docketwise oder unser Fallverwaltungssystem?
Nein, und das ist beabsichtigt. Das Tool exportiert Excel, CSV oder JSON, und die bestätigten Felder werden von einer Person in das Fallverwaltungssystem eingegeben. Es leitet Dokumente nicht an verschiedene Vorgänge weiter und legt sie nicht automatisch ab. Tools, die ein Klassifizieren-und-Weiterleiten-Verhalten versprechen, sind eine andere Kategorie, und ein Team, das das möchte, sollte dies für sich bewerten.
Was ist, wenn der Scan von schlechter Qualität ist oder ein Teil der Seite abgeschnitten ist?
Schlechte Scans kommen zur Überprüfung zurück. Eine höhere Verarbeitungsstufe verwendet ein stärkeres Modell, das besser für dichte oder beschädigte Dokumente geeignet ist, und der Review Mode macht unsichere Zellen sichtbar, statt sie still zu übergehen. Die Qualitätsgrenze des Scans ist dieselbe, an die jeder Workflow zur Verarbeitung juristischer Dokumente stößt, und die praktische Antwort ist dieselbe: kennzeichnen, bestätigen, korrigieren.
Das hilfreiche Denkmodell ist, dass die Erfassung zuerst ein Leseproblem und erst dann ein Tippproblem ist. Die Stunde der Paralegal an einem Stapel Mitteilungen besteht größtenteils daraus, herauszufinden, um welches Dokument es sich handelt und welche Felder die Fallakte noch benötigt. Die Spalten einmal zu benennen, ein Vision-Modell den gesamten Stapel lesen zu lassen und den Typ jedes Dokuments für die Sortierung zu kennzeichnen, komprimiert dieses Lesen in einen Prüfdurchgang, während die Frist, die einen Fall tatsächlich gefährden kann, in ihrer eigenen Spalte sichtbar bleibt, bis eine Person sie bestätigt.
Lassen Sie einen Ihrer eigenen Mitteilungsscans durchlaufen und prüfen Sie die Fristenspalte selbst. Testen Sie es mit einem echten RFE von Ihrem Schreibtisch.