Bestimmte Daten aus gescannten Formularen extrahieren:
Ein feldweiser Leitfaden
Ein gescanntes Formular ist kein Dokument – es ist ein Foto eines Dokuments, verpackt in einem PDF-Container. Traditionelle OCR behandelt es wie jedes andere Bild: Pixel in Text umwandeln, alles ausgeben. Aber gescannte Formulare haben ihre eigenen Fehlerquellen – schiefe Seiten, verblasste Tinte, Kaffeeflecken, Aufnahmen mit niedriger Auflösung – und die vorlagenbasierte Extraktion fügt eine weitere hinzu: Sobald sich das Layout eines Formulars ändert, bricht die Vorlage. Das Extrahieren bestimmter Felder aus gescannten Formularen erfordert einen Ansatz, der weder von sauberen Scans noch von festen Layouts abhängt.
Wichtigste Erkenntnisse
- 95 % Zeichengenauigkeit bedeutet 10 Fehler auf jedem 200-Zeichen-gescannten Formular – und wenn diese Fehler im Geburtsdatum oder im Betragsfeld landen, ist Ihre Extraktion bei den Daten, die Sie tatsächlich benötigen, zu 0 % zuverlässig.
- Die vorlagenbasierte Extraktion war nie für die reale Welt gedacht – eine Klinik mit drei Versionen des Aufnahmeformulars benötigt drei separate Vorlagen, und jede bricht stillschweigend, sobald sich das Layout verschiebt.
- ImageToTable.ai extrahiert Formulare nach Feldbedeutung, nicht nach Pixelposition – definieren Sie Ihre Spalten einmal danach, was jedes Feld darstellt, und dieselbe Extraktion verarbeitet jede Formularversion, jeden Scanwinkel und jede Qualität im Batch.
Warum gescannte Formulare die traditionelle OCR überfordern
Die traditionelle OCR funktioniert, indem sie Textzeichen vor einem kontrastierenden Hintergrund erkennt. Dunkle Tinte auf weißem Papier, gut ausgerichtet, bei angemessener Auflösung – unter diesen Bedingungen kann die OCR-Genauigkeit 98 %+ erreichen. Gescannte Formulare erfüllen diese Bedingungen jedoch selten. Ein Umfrageformular, das vor Ort ausgefüllt wurde, könnte in einem ungünstigen Winkel bei schlechter Beleuchtung fotografiert worden sein. Ein medizinisches Aufnahmeformular könnte eine Fotokopie der dritten Generation mit grauem Hintergrund und verschmolzenen Zeichen sein. Ein Regierungsformular könnte vor zehn Jahren mit 150 DPI gescannt und als komprimiertes JPEG in einer PDF-Datei gespeichert worden sein.
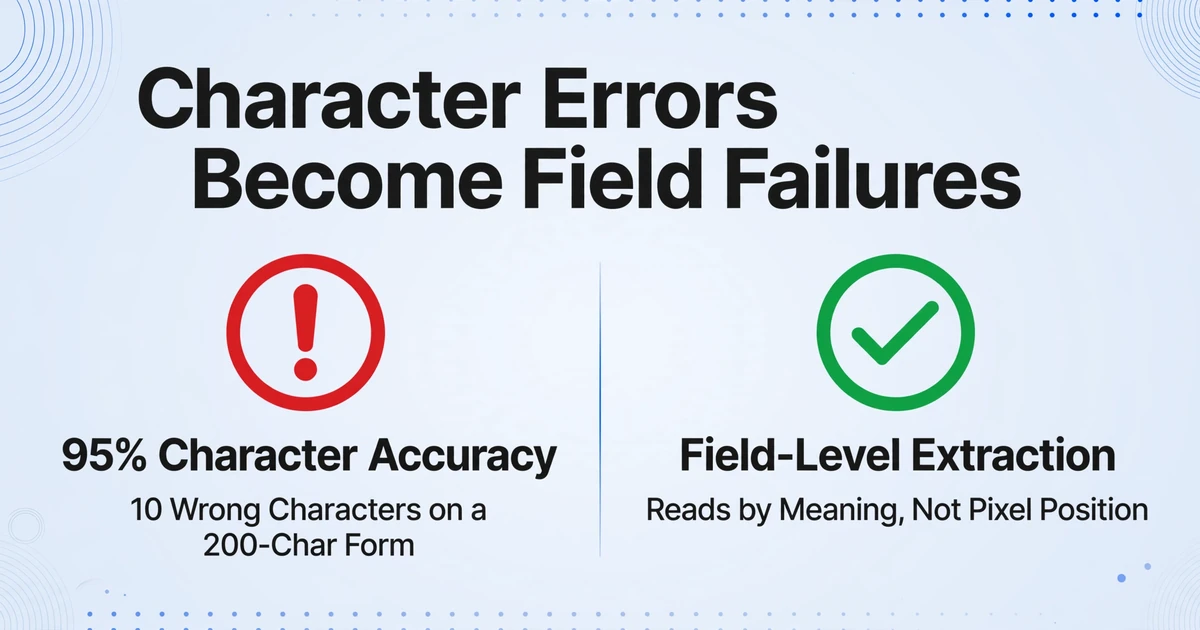
Jedes dieser Degradationsmuster – Schräglage, geringer Kontrast, Auflösungsverlust, Hintergrundrauschen – reduziert die Zeichengenauigkeit der OCR, und Fehler auf Zeichenebene summieren sich zu Fehlern auf Feldebene. Eine Zeichengenauigkeit von 95 % bei einem Formular mit 200 Zeichen bedeutet 10 falsche Zeichen. Wenn diese 10 Fehler in den Feldern „Geburtsdatum“ oder „Betrag“ landen, ist die gesamte Extraktion unzuverlässig.
Die vorlagenbasierte Extraktion verschärft das Problem. Vorlagen setzen konsistente Formularlayouts voraus, aber gescannte Formulare stammen aus verschiedenen Quellen, Versionen und Epochen. Eine Klinik mit drei Versionen eines Aufnahmeformulars aus drei verschiedenen Druckauflagen benötigt drei Vorlagen – und bei jeder davon kann die Extraktion auf Feldebene fehlschlagen.
Die Alternative: Spaltennamenextraktion, die Formulare nach der Bedeutung der Felder liest, nicht nach der Pixelposition. Sie definieren die gewünschten Felder – „Vollständiger Name“, „Geburtsdatum“, „Versicherungs-ID“, „Hauptbeschwerde“ – und die KI lokalisiert jeden Wert, indem sie versteht, was er darstellt, nicht wo er sich befindet. Dies eliminiert sowohl die Abhängigkeit von der Scanqualität (die KI kann aus Teiltexten ableiten) als auch den Wartungsaufwand für Vorlagen (eine Felddefinition funktioniert für alle Formularversionen).
Feldweise Extraktionsstrategie
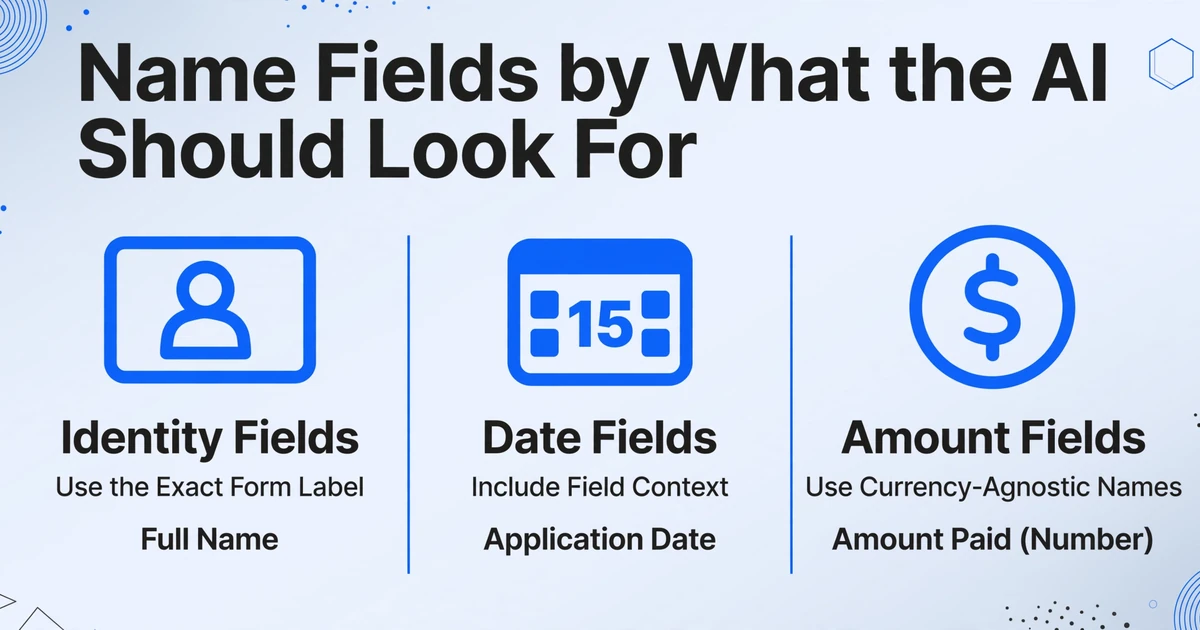
Die Benennung Ihrer Spalten bestimmt, wonach die KI sucht und wie präzise sie dabei vorgeht. Hier sind Strategien zur Feldbenennung für häufige Szenarien mit gescannten Formularen:
Für den vollständigen End-to-End-Workflow – von einem Stapel ausgefüllter Formulare bis zu einem sauberen Excel-Blatt, einschließlich Kontrollkästchen, bedingter Felder und Sammellinks – lesen Sie unseren Leitfaden zum Extrahieren von Formulardaten in Excel, ohne ein einziges Feld neu einzutippen.
| Feldtyp | Beispiele | Benennungsstrategie |
|---|---|---|
| Identitätsfelder | Vollständiger Name, Geburtsdatum, SSN, Mitarbeiter-ID | Verwenden Sie die genaue Bezeichnung, die im Formular erscheint. „Vollständiger Name" funktioniert besser als „Name", da es von „Firmenname" unterscheidet. |
| Kontrollkästchenfelder | Geschlecht (M/W), Versicherung (Ja/Nein), Einwilligung erteilt | Verwenden Sie das Format „Kontrollkästchen: [Bezeichnung]". Beispiel: „Geschlecht (männlich/weiblich Kontrollkästchen)". Die KI identifiziert die markierte Option. |
| Datumsfelder | Einreichungsdatum, Ablaufdatum, Unterschriftsdatum | Geben Sie den Feldkontext an. „Antragsdatum" statt „Datum" – gescannte Formulare enthalten oft mehrere Datumsfelder. |
| Betragsfelder | Gesamtbetrag, Steuerbetrag, Anzahlung geleistet | Verwenden Sie währungsneutrale Namen. „Bezahlter Betrag (Zahl)" teilt der KI mit, das „$" zu entfernen und nur den Zahlenwert zurückzugeben. |
| Freitextfelder | Grund des Besuchs, Besondere Anweisungen, Kommentare | Verwenden Sie die genaue Formularbezeichnung. Die KI extrahiert den gesamten Textblock einschließlich Zeilenumbrüchen. |
| Unterschriftsfelder | Unterschrift Antragsteller, Unterschrift Arzt | Verwenden Sie „Unterschrift: [Rolle] vorhanden (Ja/Nein)". Die KI bestätigt das Vorhandensein, überprüft aber nicht die Identität. |
Wie die Scan-Qualität die Extraktion beeinflusst – und wie Sie sie ausgleichen können
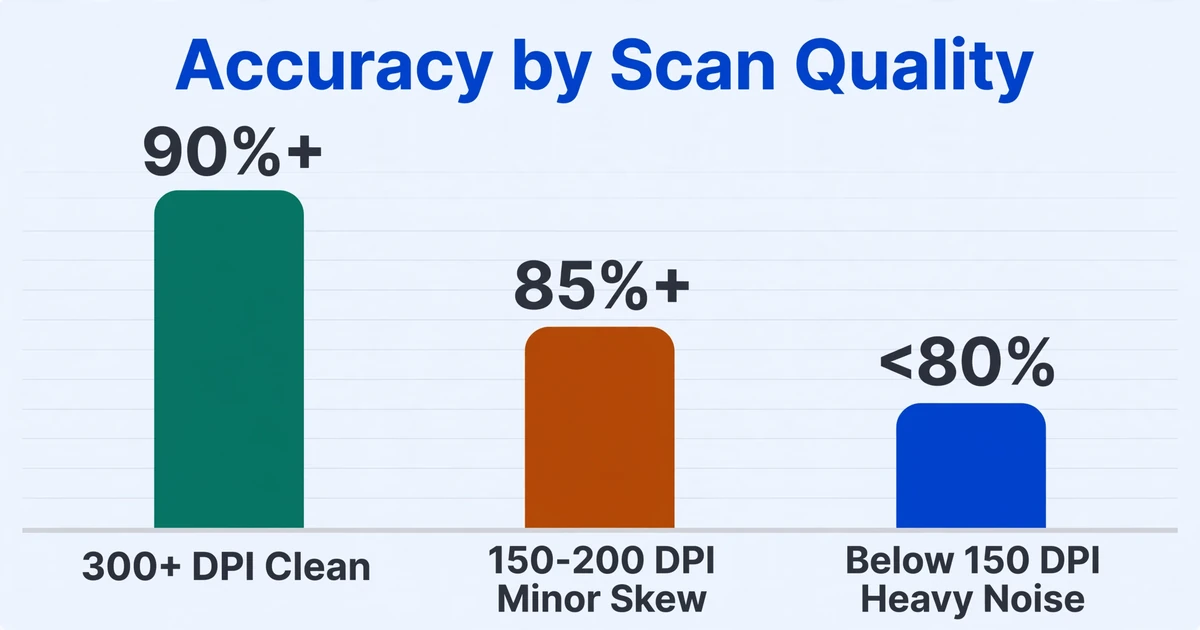
Die Genauigkeit der Feldextraktion nimmt mit der Scan-Qualität vorhersehbar ab. Wenn Sie die Schwellenwerte kennen, können Sie entscheiden, wann ein Formular wahrscheinlich gut extrahiert wird und wann es eine Vorverarbeitung oder manuelle Überprüfung benötigt:
- 300+ DPI, sauber, ohne Schräglage: Nahezu identisch mit der Genauigkeit digitaler Dokumente. Gedruckte Textfelder erreichen eine Genauigkeit von 90 %+. Handschriftliche Felder hängen von der Lesbarkeit ab, sind aber für das KI-Visionsmodell lesbar.
- 150-200 DPI, leichte Schräglage (<10°), leicht verblasst: Gedruckter Text bleibt zuverlässig (85 %+). Handschriftliche Felder beginnen an Qualität zu verlieren. Die Kontrollkästchen-Erkennung bleibt genau, da Kontrollkästchen strukturell und nicht zeichenbasiert sind.
- Unter 150 DPI, starke Schräglage, erhebliches Hintergrundrauschen: Die Genauigkeit von gedrucktem Text fällt unter 80 %. Handschriftliche Felder werden unzuverlässig. Erwägen Sie, wenn möglich, einen erneuten Scan; wenn nicht, behandeln Sie die KI-Ausgabe als ersten Entwurf, der eine manuelle Überprüfung erfordert.
Praktischer Tipp: Wenn Sie Formulare speziell für die KI-Extraktion scannen, scannen Sie mit 300 DPI in Graustufen (nicht in Schwarz-Weiß). Graustufen bewahren die subtilen Kontrastunterschiede, die der KI helfen, blassen Text von Hintergrundrauschen zu unterscheiden. Die Schwarz-Weiß-Schwellenwertbildung führt oft dazu, dass benachbarte Zeichen verschmelzen oder blasse Zeichen ganz verloren gehen.
Verarbeitung gemischter Formular-Batches
Die Formularverarbeitung in der Praxis betrifft selten nur einen einzigen Formulartyp. Eine Arztpraxis erhält Aufnahmeformulare, Versicherungsprüfungsformulare und Laboranforderungsformulare – oft gemischt im selben Batch. Eine Personalabteilung erhält Bewerbungsformulare, Referenzprüfungsformulare und Onboarding-Unterlagen – jeweils mit unterschiedlichen Feldern.
Mit der Spaltennamenextraktion verarbeiten Sie gemischte Batches, indem Sie einen Spaltensatz definieren, der alle Felder abdeckt, die Sie über alle Formulartypen hinweg benötigen. Die KI verarbeitet jedes Formular unabhängig: Felder, die in einem bestimmten Formular vorhanden sind, werden extrahiert; Felder, die nicht erscheinen, bleiben leer. Die Ausgabe ist eine einzige Tabelle mit konsistenten Spalten über alle Zeilen hinweg, unabhängig davon, welcher Formulartyp jede Zeile erzeugt hat. Diese Scan-zu-Excel-Ausgabe, eine Zeile pro Formular, ist dieselbe, egal ob die Eingabe über einen Flachbettscanner oder als Handyfoto kam.
Für beste Ergebnisse mit gemischten Formular-Batches fügen Sie eine Spalte „Formulartyp“ in Ihre Definitionen ein. Die KI kann den Formulartyp oft anhand des Titels oder der Struktur identifizieren, sodass Sie beim Überprüfen der Ausgabe eine Spalte zum Filtern haben.
Praxisnaher Arbeitsablauf: Ein Bauunternehmen erhält täglich Sicherheitsinspektionsformulare, Geräte-Checklisten und Unfallberichte – alle gescannt, alle mit unterschiedlichen Layouts. Statt drei separate Extraktionsvorlagen zu pflegen und eingehende Scans manuell zu sortieren, definieren sie einen Spaltensatz (Name des Prüfers, Datum, Standort, Geräte-ID, Befund, Schweregrad, Erforderliche Maßnahme) und laden die gesamten Tages-Scans in einem Batch hoch. Formulare ohne relevante Felder erzeugen leere Zellen; Formulare mit relevanten Feldern füllen ihre Spalten. Eine Tabelle am Ende des Tages, sortiert nach Formulartyp.
Dateien werden sicher verarbeitet und nicht gespeichert.
Häufig gestellte Fragen
Kann die KI handschriftliche Formularfelder lesen?
Ja, aber mit geringerer Genauigkeit als bei gedrucktem Text. Bei klar geschriebenen Druckbuchstaben und Zahlen liegt die Genauigkeit zwischen 65 und 85 %. Handschrift in Schreibschrift, hastige Kritzeleien oder stark stilisierte Schrift führen zu geringerer Genauigkeit. Die Stärke der KI bei Handschrift liegt in der kontextuellen Schlussfolgerung – selbst wenn einzelne Zeichen mehrdeutig sind, kann sie den korrekten Wert oft durch die Auswertung des Feldkontexts ermitteln (ein Datumsfeld sollte ein Datum enthalten, ein Telefonnummernfeld sollte Ziffern enthalten). Bei Formularen, bei denen handschriftliche Felder kritisch sind (medizinische Aufnahme, juristische eidesstattliche Erklärungen), planen Sie eine manuelle Prüfung der Ausgabe ein.
Was ist mit Formularen mit Kontrollkästchen – kann die KI erkennen, welches Kästchen angekreuzt ist?
Ja. Die KI erkennt Kontrollkästchen anhand ihrer visuellen Struktur (ein kleines Quadrat oder ein Kreis, typischerweise mit einer Markierung darin, wenn angekreuzt) und gibt den Status zurück. Bei einem Feld namens „Versicherungstyp (Kontrollkästchen: Öffentlich/Privat/Keine)“ gibt die KI die angekreuzte Option zurück. Bei Mehrfachauswahl-Kontrollkästchen (z. B. „Symptom-Checkliste“) erscheint jedes angekreuzte Element je nach Ihrer Spaltendefinition als separate Zeile oder als kommagetrennte Liste.
Wie geht die KI mit Formularen um, deren Felder in verschiedenen Versionen unterschiedlich beschriftet sind?
Semantischer Abgleich übernimmt die Behandlung von Beschriftungsvarianten. Wenn Version 1 eines Formulars „Geburtsdatum" sagt und Version 2 „Geb." sagt, ordnet die KI beides Ihrer Spalte „Geburtsdatum" zu. Wenn Version 3 an einer völlig anderen Stelle „Geburtstag" sagt, ordnet die KI es dennoch zu, weil sie die semantische Gleichwertigkeit versteht. Dies ist der grundlegende Unterschied zur vorlagenbasierten Extraktion, die alle drei als unterschiedliche Felder behandeln und separate Vorlagenregeln erfordern würde.
Ob Ihre Formulare als Scans, PDFs oder Fotos eintreffen, der Scanned-PDF-zu-Excel-Konverter wendet denselben feldweisen Extraktionsansatz an – definieren Sie Ihre Spalten einmal und verarbeiten Sie gemischte Format-Batches ohne formularspezifische Vorlagen. Wenn Ihre Formulare Kontrollkästchen, Handschrift oder bedingte Felder enthalten, verarbeitet das Formulardatenextraktionstool diese Elementtypen im selben Durchgang.