スキャン済みフォームから特定データを抽出:
フィールド単位のガイド
スキャン済みフォームはドキュメントではありません。PDFコンテナに包まれたドキュメントの写真です。従来のOCRは他の画像と同じように扱います。ピクセルをテキストに変換し、すべてを出力するだけです。しかし、スキャン済みフォームには独自の失敗モードがあります。傾いたページ、かすれたインク、コーヒーの染み、低解像度のキャプチャなどです。さらにテンプレートベース抽出には別の問題があります。フォームのレイアウトが変わった瞬間にテンプレートが壊れてしまうのです。スキャン済みフォームから特定のフィールドを抽出するには、きれいなスキャンや固定レイアウトに依存しないアプローチが必要です。
重要ポイント
- 95%の文字精度でも、200文字のスキャン済みフォームには10個のエラーが残ります。そのエラーが生年月日や金額フィールドに発生した場合、実際に必要なデータの抽出信頼性は0%になります。
- テンプレートベース抽出は現実世界向けに設計されていません。3つのバージョンがある診療所の申込フォームには3つのテンプレートが必要で、レイアウトが少しでも変わるとそれぞれが静かに壊れます。
- ImageToTable.aiはピクセル位置ではなくフィールドの意味でフォームを抽出します。各フィールドが何を表すかで列を一度定義すれば、同じ抽出がバッチ内のすべてのフォームバージョン、スキャン角度、品質に対応します。
スキャン済みフォームが従来のOCRを壊す理由
従来のOCRは、コントラストのある背景に対して文字を検出することで機能します。白い紙に濃いインク、位置が揃っていて、解像度も十分——こうした条件下では、OCRの精度は98%以上に達します。しかし、スキャン済みフォームがこうした条件を満たすことはほとんどありません。現場で記入された調査フォームは、照明が悪い中で斜めから撮影されているかもしれません。医療用の受付フォームは、3世代目のコピーで背景が灰色に濁り、文字がつぶれているかもしれません。政府のフォームは、10年前に150 DPIでスキャンされ、PDF内に圧縮JPEGとして保存されているかもしれません。
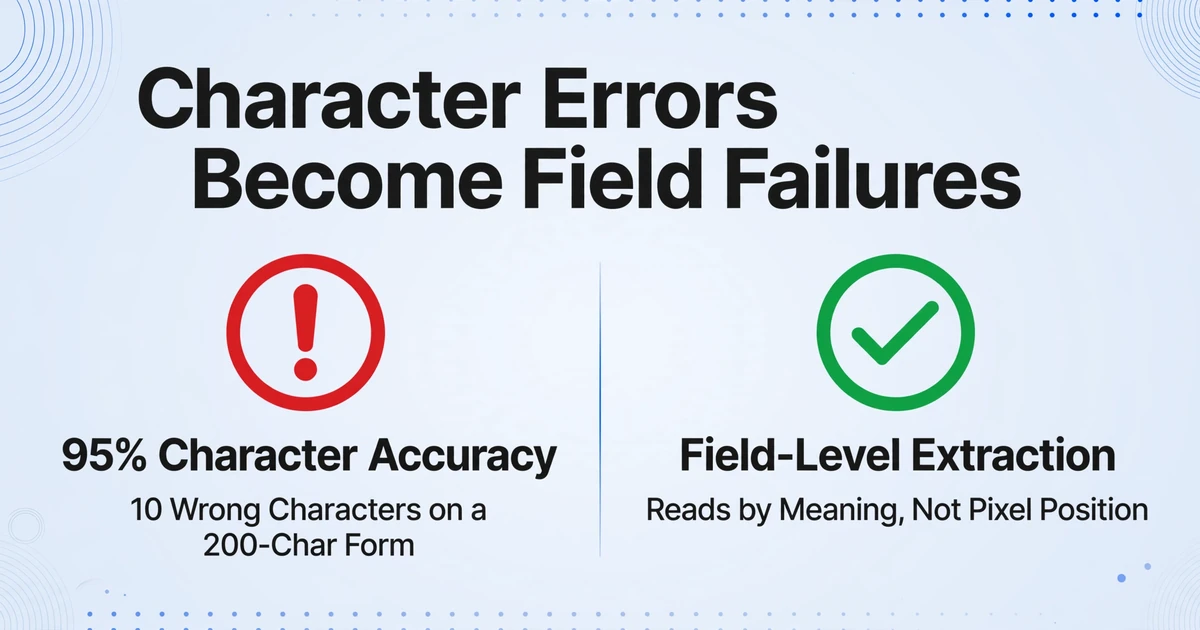
こうした劣化パターン——傾き、低コントラスト、解像度低下、背景ノイズ——はそれぞれOCRの文字精度を低下させ、文字レベルのエラーがフィールドレベルの障害に積み重なります。200文字のフォームで文字精度95%ということは、10文字が誤っているということです。その10個のエラーが「生年月日」や「金額」フィールドに該当すれば、抽出結果全体が信頼できなくなります。
テンプレートベース抽出は問題をさらに悪化させます。テンプレートは一貫したフォームレイアウトを前提としていますが、スキャン済みフォームは異なる出所、異なるバージョン、異なる時代のものが混在します。3つの異なる印刷ロットから作られた3バージョンの受付フォームを使うクリニックは、3つのテンプレートを必要とします——そして、そのいずれかでフィールド単位の抽出障害が発生する可能性があります。
代替アプローチ:ピクセル位置ではなくフィールドの意味でフォームを読み取るカラム名抽出です。「患者名」「生年月日」「保険ID」「主訴」など、必要なフィールドを定義すれば、AIは値がどこにあるかではなく、何を表しているかを理解して各値を特定します。これにより、スキャン品質への依存(AIは部分的なテキストから推論できます)とテンプレート保守の負担(1つのフィールド定義が全バージョンのフォームで機能します)の両方が解消されます。
フィールド単位の抽出戦略
列の名前の付け方によって、AIが何を探し、どの程度正確に抽出するかが決まります。ここでは、一般的なスキャン済みフォームのシナリオにおけるフィールド命名戦略を紹介します。
記入済みフォームの束から1枚のクリーンなExcelシートまで、チェックボックス、条件付きフィールド、コレクションリンクを含む完全なエンドツーエンドのワークフローについては、1つのフィールドも再入力せずにフォームデータをExcelに抽出するガイドをご覧ください。
| フィールドタイプ | 例 | 命名戦略 |
|---|---|---|
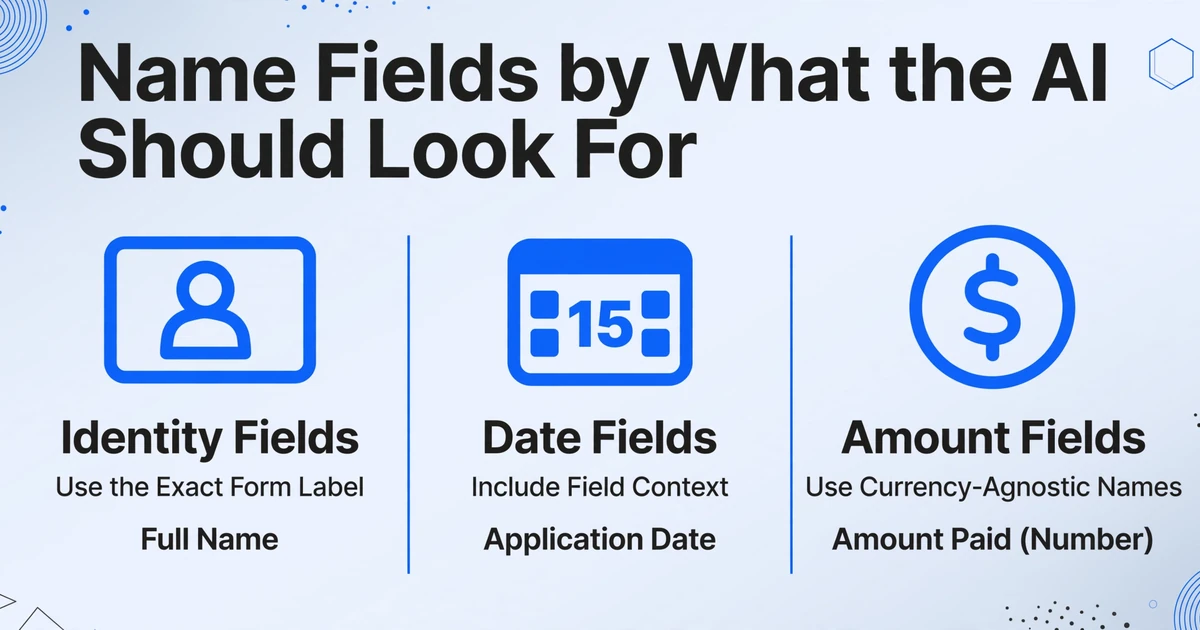
| 本人確認フィールド | 氏名、生年月日、SSN(社会保障番号)、従業員ID | フォームに表示されている正確なラベルを使用します。「氏名」は「会社名」と区別できるため、「名前」よりも効果的です。 |
| チェックボックスフィールド | 性別(男性/女性)、保険(あり/なし)、同意済み | 「チェックボックス:[ラベル]」の形式を使用します。例:「性別(男性/女性チェックボックス)」。AIが選択された項目を識別します。 |
| 日付フィールド | 提出日、有効期限日、署名日 | フィールドの文脈を含めます。スキャン済みフォームには複数の日付フィールドがあることが多いため、「日付」ではなく「申請日」とします。 |
| 金額フィールド | 合計請求額、税額、支払済み預託金 | 通貨に依存しない名前を使用します。「支払金額(数値)」と指定すると、AIは「$」を除去して数値のみを返します。 |
| 自由記述フィールド | 来院理由、特別な指示、コメント | フォームの正確なラベルを使用します。AIは改行を含むテキストブロック全体を抽出します。 |
| 署名フィールド | 申請者署名、医師署名 | 「署名:[役割] あり(はい/いいえ)」の形式を使用します。AIは署名の存在を確認しますが、本人確認は行いません。 |
スキャン品質が抽出に与える影響とその補正方法
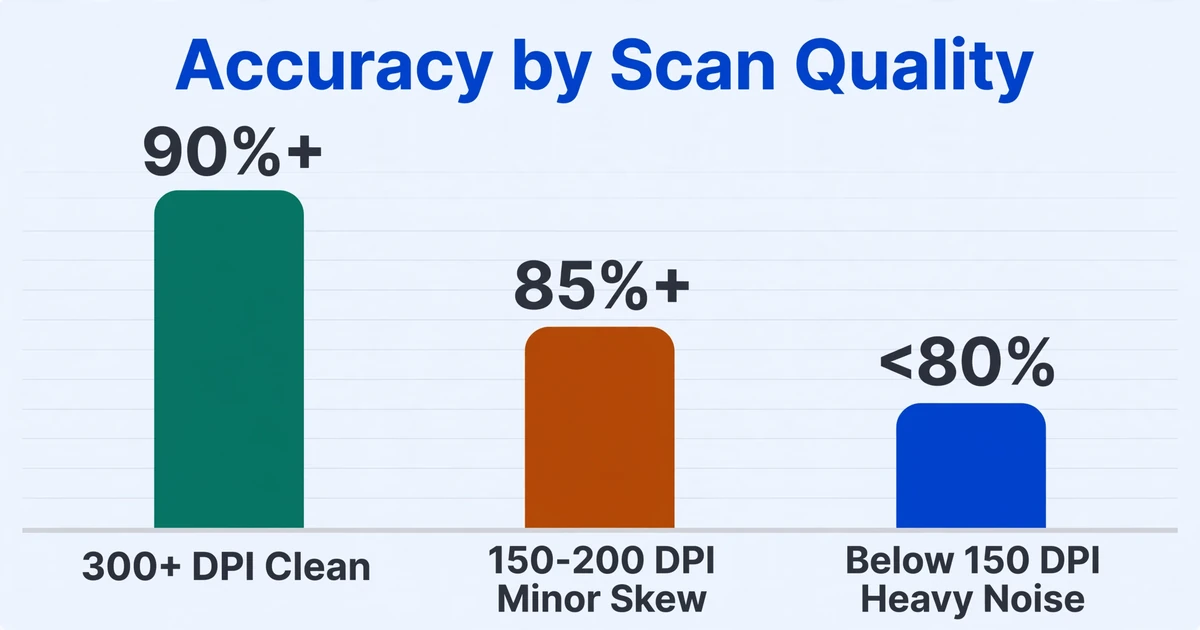
フィールド単位の抽出精度は、スキャン品質に応じて予測可能な形で低下します。しきい値を把握しておくことで、どのフォームが問題なく抽出できるか、前処理や手動レビューが必要かを判断できます。
- 300 DPI以上、クリーン、傾きなし:デジタルドキュメントの精度にほぼ匹敵します。印刷テキストのフィールドは90%以上の精度を達成。手書きフィールドは読みやすさに依存しますが、AIのビジョンモデルで判読可能です。
- 150-200 DPI、わずかな傾き(10°未満)、軽いかすれ:印刷テキストは引き続き信頼性が高い(85%以上)。手書きフィールドは劣化し始めます。チェックボックスは構造に基づく認識のため、文字認識ではなく、精度は維持されます。
- 150 DPI未満、大きな傾き、顕著な背景ノイズ:印刷テキストの精度は80%未満に低下します。手書きフィールドは信頼性を失います。可能であれば再スキャンを検討し、不可能な場合はAI出力を手動検証が必要な初稿として扱ってください。
実用的なヒント:AI抽出専用にフォームをスキャンする場合は、グレースケール(白黒ではなく)で300 DPIに設定してください。グレースケールは、AIがかすかなテキストと背景ノイズを区別するのに役立つ微妙なコントラストの差を保持します。白黒のしきい値処理では、隣接する文字が結合したり、かすかな文字が完全に欠落したりすることがよくあります。
複数種類のフォームが混在するバッチの処理
実際のフォーム処理では、単一のフォームタイプだけを扱うことはほとんどありません。診療所では、受付フォーム、保険確認フォーム、検査依頼書を受け取りますが、これらは同じバッチに混在することがよくあります。採用部門では、応募フォーム、推薦状確認フォーム、入社書類を受け取りますが、それぞれ異なるフィールドがあります。
カラム名抽出では、すべてのフォームタイプに必要なすべてのフィールドをカバーする列セットを定義することで、混在バッチを処理します。AIは各フォームを個別に処理します。特定のフォームに存在するフィールドは抽出され、存在しないフィールドは空白のままになります。出力は、各行がどのフォームタイプから生成されたかに関係なく、全行で一貫した列を持つ1つのスプレッドシートになります。そのスキャンからExcel出力、フォームごとに1行は、フラットベッドスキャナーで入力された場合も、スマートフォンの写真で入力された場合も同じです。
混在フォームのバッチで最良の結果を得るには、定義に「フォームタイプ」列を含めてください。AIはタイトルや構造からフォームタイプを識別できることが多く、出力をレビューする際にフィルタリングするための列が得られます。
実際のワークフロー:建設会社が毎日の安全点検フォーム、機器チェックリスト、インシデントレポートを受け取るとします。すべてスキャンされ、すべてレイアウトが異なります。3つの別々の抽出テンプレートを維持し、スキャンを手動で仕分ける代わりに、1つの列セット(検査員名、日付、場所、機器ID、所見、重大度、要対応事項)を定義し、その日のスキャンをすべて1つのバッチでアップロードします。関連フィールドのないフォームは空白セルを生成し、関連フィールドのあるフォームはその列に入力されます。1日の終わりには、フォームタイプで並べ替えられた1つのスプレッドシートができあがります。
ファイルは安全に処理され、保存されることはありません。
よくある質問
AIは手書きのフォーム欄を読み取れますか?
はい、ただし印刷文字よりも精度は低くなります。明確に書かれたブロック体の文字や数字の場合、精度は65〜85%の範囲です。筆記体、走り書き、または装飾の多い書き方は精度が低下します。手書きに対するAIの強みは文脈推論です。個々の文字が曖昧でも、フィールドの文脈(日付欄には日付、電話番号欄には数字)を評価することで正しい値を判別できることがよくあります。手書き欄が重要なフォーム(医療用問診票、法定宣誓書など)では、出力に対する手動レビュー工程を計画してください。
チェックボックス付きのフォームでは、AIはどのボックスがチェックされているかを判別できますか?
はい。AIはチェックボックスをその視覚的な構造(小さな四角または丸で、通常チェック時には内側に印がある)によって識別し、その状態を返します。「保険タイプ(チェックボックス:公的/民間/なし)」というフィールド名の場合、AIはチェックされた選択肢を返します。複数選択のチェックボックス(例:「症状チェックリスト」)の場合、チェックされた各項目は、列定義に応じて個別の行またはカンマ区切りのリストとして表示されます。
AIは、バージョンごとにフィールドのラベルが異なるフォームをどのように処理しますか?
意味的マッチングがラベルのバリエーションを処理します。フォームのバージョン1に「生年月日」と記載され、バージョン2に「DOB」と記載されている場合、AIは両方を「生年月日」列にマッピングします。バージョン3で「Birthdate」がまったく異なる場所に記載されている場合でも、AIは意味的な等価性を理解するため、マッピングできます。これは、テンプレートベース抽出が3つすべてを異なるフィールドとして扱い、それぞれに個別のテンプレートルールを必要とするのとは根本的に異なります。
フォームがスキャン、PDF、写真のいずれで届いても、スキャンPDFからExcelへの変換ツールは同じフィールド単位の抽出アプローチを適用します。列を一度定義すれば、フォームごとのテンプレートなしで混合形式のバッチを処理できます。フォームにチェックボックス、手書き、条件付きフィールドが含まれる場合も、フォームデータ抽出ツールが同じ1回のパスでこれらの要素タイプを処理します。