Extraiga datos específicos de formularios escaneados:
Una guía campo por campo
Un formulario escaneado no es un documento: es una fotografía de un documento envuelta en un contenedor PDF. El OCR tradicional lo trata como cualquier otra imagen: convierte píxeles en texto y lo extrae todo. Pero los formularios escaneados tienen sus propios modos de fallo — páginas inclinadas, tinta desvanecida, manchas de café, capturas de baja resolución — y la extracción basada en plantillas añade otro más: en el momento en que el diseño de un formulario cambia, la plantilla se rompe. Extraer campos específicos de formularios escaneados requiere un enfoque que no dependa de escaneos limpios ni de diseños fijos.
Conclusiones clave
- Una precisión de caracteres del 95% deja 10 errores en cada formulario escaneado de 200 caracteres — y cuando esos errores caen en la Fecha de nacimiento o el campo de Importe, su extracción es 0% confiable en los datos que realmente necesita.
- La extracción basada en plantillas nunca fue diseñada para el mundo real — una clínica con tres versiones de formulario de admisión necesita tres plantillas separadas, y cada una se rompe silenciosamente en cuanto cualquier diseño cambia.
- ImageToTable.ai extrae formularios por el significado del campo, no por la posición de los píxeles — defina sus columnas una vez según lo que representa cada campo, y la misma extracción maneja cada versión de formulario, ángulo de escaneo y calidad del lote.
Por qué los formularios escaneados rompen el OCR tradicional
El OCR tradicional funciona detectando caracteres de texto sobre un fondo de contraste. Tinta oscura sobre papel blanco, bien alineado y con una resolución razonable: en estas condiciones, la precisión del OCR puede alcanzar el 98%+. Los formularios escaneados rara vez cumplen estas condiciones. Un formulario de encuesta completado en el campo podría fotografiarse en ángulo y con poca luz. Un formulario de admisión médica podría ser una fotocopia de tercera generación con fondos grises y caracteres fusionados. Un formulario gubernamental podría haberse escaneado a 150 DPI hace diez años y almacenado como JPEG comprimido dentro de un PDF.
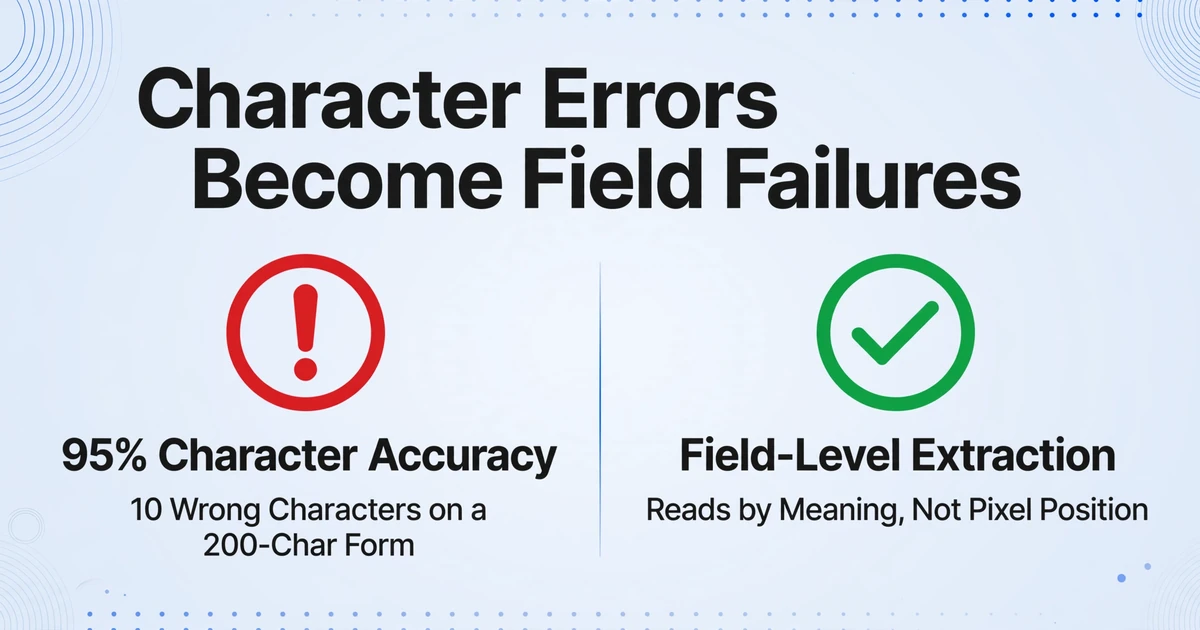
Cada uno de estos patrones de degradación (inclinación, bajo contraste, pérdida de resolución, ruido de fondo) reduce la precisión de caracteres del OCR, y los errores a nivel de carácter se acumulan en fallos a nivel de campo. Una tasa de precisión de caracteres del 95% en un formulario de 200 caracteres significa 10 caracteres incorrectos. Si esos 10 errores caen en los campos "Fecha de nacimiento" o "Importe", toda la extracción no es fiable.
La extracción basada en plantillas agrava el problema. Las plantillas asumen diseños de formulario consistentes, pero los formularios escaneados provienen de diferentes fuentes, versiones y épocas. Una clínica con tres versiones de formulario de admisión de tres tiradas de impresión diferentes necesita tres plantillas, y una falla de extracción a nivel de campo en cualquiera de ellas.
La alternativa: extracción por nombre de columna que lee los formularios por el significado del campo, no por la posición de los píxeles. Usted define los campos que desea ("Nombre completo", "Fecha de nacimiento", "ID de seguro", "Motivo principal de consulta") y la IA localiza cada valor al comprender qué representa, no dónde se encuentra. Esto elimina tanto la dependencia de la calidad del escaneo (la IA puede inferir a partir de texto parcial) como la carga de mantenimiento de plantillas (una definición de campo funciona en todas las versiones del formulario).
Estrategia de extracción campo por campo
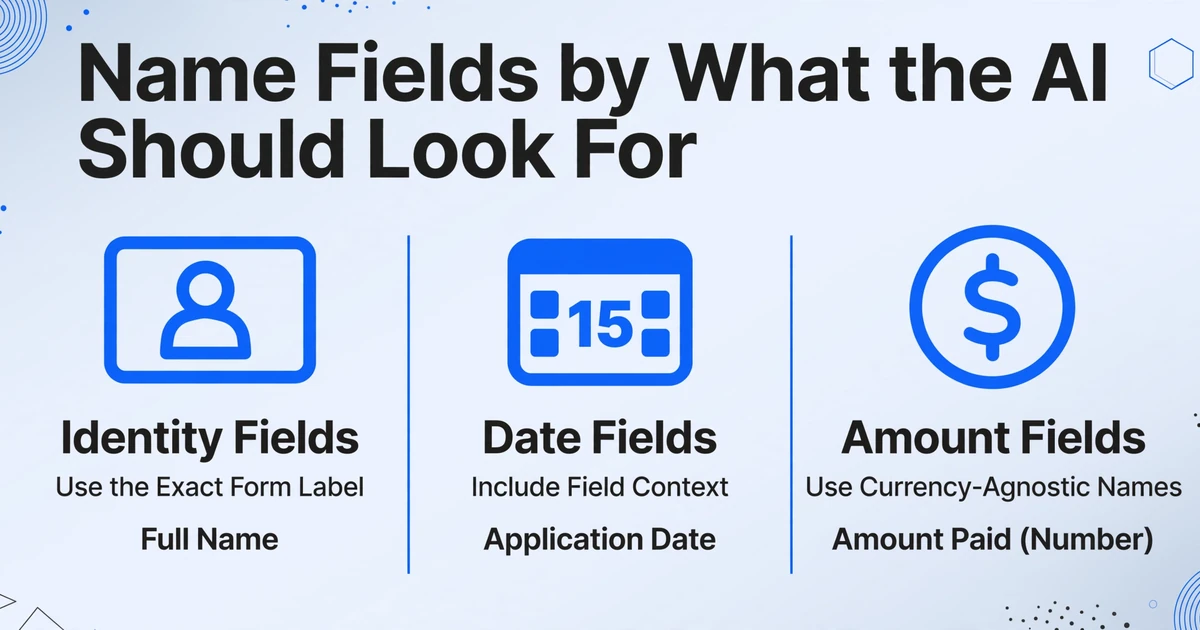
La forma en que nombra sus columnas determina qué busca la IA y con qué precisión. Estas son estrategias de nombres de campos para escenarios comunes de formularios escaneados:
Para el flujo de trabajo completo de principio a fin — desde una pila de formularios completados hasta una hoja de Excel limpia, incluyendo casillas de verificación, campos condicionales y enlaces de recopilación — consulte nuestra guía sobre cómo extraer datos de formularios a Excel sin volver a escribir un solo campo.
| Tipo de campo | Ejemplos | Estrategia de nombres |
|---|---|---|
| Campos de identidad | Nombre completo, Fecha de nacimiento, SSN, ID de empleado | Use la etiqueta exacta que aparece en el formulario. «Nombre completo» funciona mejor que «Nombre» porque lo distingue de «Nombre de la empresa». |
| Casillas de verificación | Género (M/F), Seguro (Sí/No), Consentimiento otorgado | Use el formato «Casilla de verificación: [etiqueta]». Ejemplo: «Género (casilla de verificación Masculino/Femenino)». La IA identifica la opción marcada. |
| Campos de fecha | Fecha de envío, Fecha de vencimiento, Fecha de firma | Incluya el contexto del campo. «Fecha de solicitud» en lugar de «Fecha» — los formularios escaneados suelen tener múltiples campos de fecha. |
| Campos de importe | Total a pagar, Importe de impuestos, Depósito pagado | Use nombres independientes de la moneda. «Importe pagado (Número)» le indica a la IA que omita el «$» y devuelva solo el valor numérico. |
| Campos de texto libre | Motivo de la visita, Instrucciones especiales, Comentarios | Use la etiqueta exacta del formulario. La IA extrae el bloque de texto completo, incluidos los saltos de línea. |
| Campos de firma | Firma del solicitante, Firma del médico | Use «Firma: [rol] Presente (Sí/No)». La IA confirma la presencia pero no verifica la identidad. |
Cómo afecta la calidad del escaneo a la extracción — y cómo compensarla
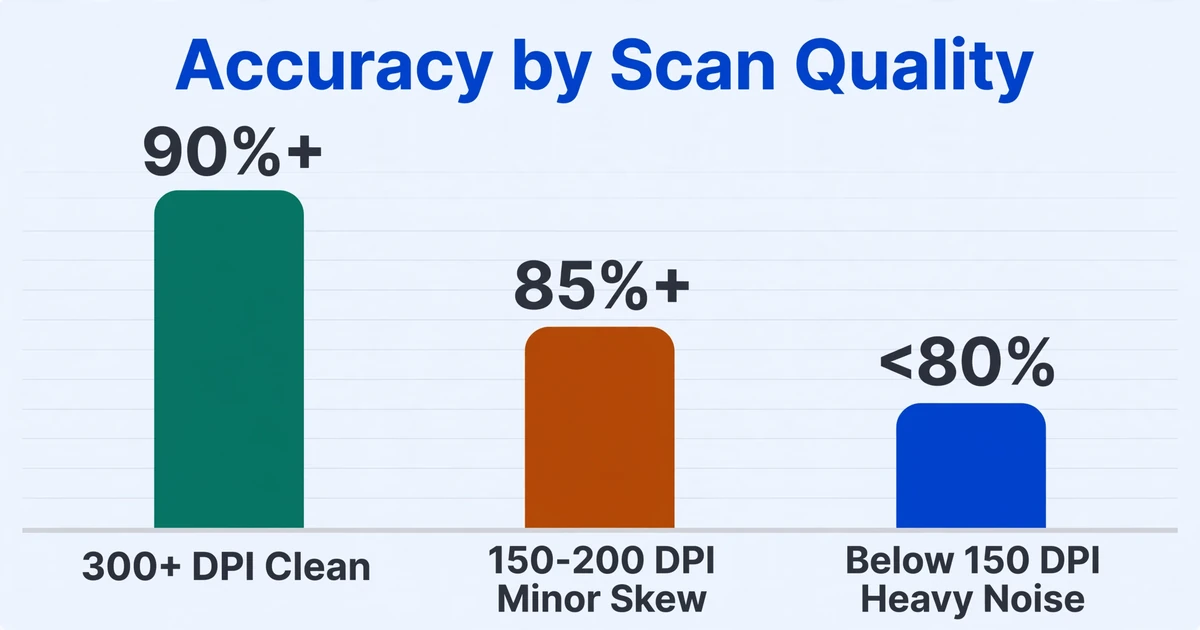
La precisión de la extracción a nivel de campo se degrada de forma predecible con la calidad del escaneo. Conocer los umbrales le ayuda a decidir cuándo un formulario se extraerá bien y cuándo necesita preprocesamiento o revisión manual:
- 300+ DPI, limpio, sin inclinación: Casi idéntico a la precisión de un documento digital. Los campos de texto impreso alcanzan una precisión del 90%+. Los campos manuscritos dependen de la legibilidad, pero el modelo de visión de la IA puede leerlos.
- 150-200 DPI, inclinación leve (<10°), ligero desvanecimiento: El texto impreso sigue siendo fiable (85%+). Los campos manuscritos comienzan a degradarse. El reconocimiento de casillas de verificación sigue siendo preciso, ya que las casillas son estructurales, no basadas en caracteres.
- Por debajo de 150 DPI, inclinación pronunciada, ruido de fondo significativo: La precisión del texto impreso cae por debajo del 80%. Los campos manuscritos se vuelven poco fiables. Considere volver a escanear si es posible; si no, trate la salida de la IA como un primer borrador que requiere verificación manual.
Consejo práctico: Si escanea formularios específicamente para extracción con IA, escanee a 300 DPI en escala de grises (no en blanco y negro). La escala de grises conserva las diferencias sutiles de contraste que ayudan a la IA a distinguir texto tenue del ruido de fondo. El umbralizado en blanco y negro a menudo fusiona caracteres adyacentes o elimina por completo los tenues.
Procesamiento de lotes mixtos de formularios
El procesamiento de formularios en el mundo real rara vez involucra un solo tipo de formulario. Una consulta médica recibe formularios de admisión, formularios de verificación de seguro y solicitudes de laboratorio — a menudo mezclados en el mismo lote. Un departamento de contratación recibe solicitudes de empleo, formularios de verificación de referencias y papeleo de incorporación — cada uno con campos diferentes.
Con la extracción por nombre de columna, maneja lotes mixtos definiendo un conjunto de columnas que cubra todos los campos que necesita en todos los tipos de formulario. La IA procesa cada formulario de forma independiente: los campos que existen en un formulario determinado se extraen; los campos que no aparecen se dejan en blanco. El resultado es una sola hoja de cálculo con columnas consistentes en todas las filas, independientemente del tipo de formulario que haya producido cada fila. Ese resultado de escaneo a Excel, una fila por formulario, es el mismo tanto si la entrada llegó por un escáner de cama plana como si fue una foto tomada con el teléfono.
Para obtener los mejores resultados con lotes de formularios mixtos, incluya una columna "Tipo de formulario" en sus definiciones. La IA a menudo puede identificar el tipo de formulario por su título o estructura, lo que le da una columna para filtrar al revisar el resultado.
Flujo de trabajo real: Una empresa de construcción recibe formularios diarios de inspección de seguridad, listas de verificación de equipos e informes de incidentes — todos escaneados, todos con diseños diferentes. En lugar de mantener tres plantillas de extracción separadas y clasificar manualmente los escaneos entrantes, definen un conjunto de columnas (Nombre del inspector, Fecha, Ubicación, ID del equipo, Hallazgo, Gravedad, Acción requerida) y suben todos los escaneos del día en un solo lote. Los formularios sin campos relevantes producen celdas en blanco; los formularios con campos relevantes completan sus columnas. Una sola hoja de cálculo al final del día, ordenada por Tipo de formulario.
Los archivos se procesan de forma segura y no se almacenan.
Preguntas frecuentes
¿Puede la IA leer campos de formularios escritos a mano?
Sí, pero con menor precisión que el texto impreso. Para letras de molde y números claramente escritos, la precisión oscila entre el 65 y el 85 %. La escritura cursiva, los garabatos apresurados o la escritura muy estilizada producirán una menor precisión. La fortaleza de la IA con la escritura a mano es la inferencia contextual: incluso si los caracteres individuales son ambiguos, a menudo puede determinar el valor correcto evaluando el contexto del campo (un campo de fecha debe contener una fecha, un campo de número de teléfono debe contener dígitos). Para formularios donde los campos escritos a mano son críticos (admisión médica, declaraciones juradas legales), planifique una revisión manual de los resultados.
¿Qué pasa con los formularios con casillas de verificación? ¿Puede la IA saber qué casilla está marcada?
Sí. La IA identifica las casillas de verificación por su estructura visual (un cuadrado o círculo pequeño, normalmente con una marca dentro si está marcado) y devuelve el estado. Para un campo llamado "Tipo de seguro (casilla de verificación: Público/Privado/Ninguno)", la IA devuelve la opción marcada. Para las casillas de verificación de selección múltiple (p. ej., "Lista de síntomas"), cada elemento marcado aparece como una fila separada o como una lista separada por comas, según la definición de su columna.
¿Cómo maneja la IA los formularios cuyos campos están etiquetados de forma diferente en distintas versiones?
La coincidencia semántica gestiona las variaciones de etiquetas. Si la Versión 1 de un formulario dice "Fecha de nacimiento" y la Versión 2 dice "DOB", la IA asigna ambas a su columna "Fecha de nacimiento". Si la Versión 3 dice "Birthdate" en una ubicación completamente distinta, la IA igualmente la asigna porque comprende la equivalencia semántica. Esta es la diferencia fundamental con la extracción basada en plantillas, que trataría las tres como campos diferentes que requieren reglas de plantilla separadas.
Ya sea que sus formularios lleguen como escaneos, PDF o fotos, el convertidor de PDF escaneado a Excel aplica el mismo enfoque de extracción campo por campo: defina sus columnas una vez y procese lotes de formatos mixtos sin plantillas por formulario. Si sus formularios incluyen casillas de verificación, escritura a mano o campos condicionales, la herramienta de extracción de datos de formularios maneja esos tipos de elementos en la misma pasada única.