Extração de Dados de Avisos do USCIS para
Triagem de Imigração, Sem Ordenar Primeiro
O documento com o prazo mais curto em um caso de imigração também é o que tem maior probabilidade de passar despercebido dentro de uma pilha de digitalizações: um Pedido de Evidências. De acordo com o Manual de Políticas do USCIS, o tempo padrão de resposta é de 84 dias para a maioria dos formulários, 30 para alguns outros, com três dias adicionais se o aviso chegar pelo correio. Um solicitante que perde o prazo impresso corre o risco de o caso ser negado como abandonado. Esse prazo é uma data em um aviso entre muitos, e tudo sobre como os e-mails e as digitalizações de um escritório são tratados determina se alguém o verá a tempo.
Principais Conclusões
- 84 dias é o prazo padrão para responder a um RFE, e perdê-lo pode fazer o caso ser negado como abandonado.
- Um prazo perdido geralmente não é um erro de calendário, é um aviso enterrado em uma pilha mista que nunca chegou a um calendário.
- Nomeie as colunas uma vez, deixe o modelo ler toda a pilha não ordenada e confirme apenas o prazo e o número de recibo no aviso original.
Prazos de RFE Perdidos São uma Falha no Tratamento de Documentos, Não uma Falha de Agenda
Quando um prazo de resposta a um RFE é perdido, a explicação geralmente não é que ninguém o anotou. É que o aviso passou a primeira semana dentro de uma pilha mista: digitalizado no mesmo PDF que um aviso de recebimento e uma carta de agendamento biométrico, arquivado no cliente errado, ou fotografado fora de ordem com a página do prazo enterrada no meio. O prazo estava impresso no aviso, mas nunca chegou a uma agenda porque o documento nunca chegou à atenção da pessoa certa.
As equipes de triagem de imigração conhecem esse modo de falha pelo nome. Em uma discussão no r/legaltech sobre triagem automatizada de documentos do USCIS, um comentarista colocou o teste da forma que um paralegal experiente faria: "Eu rodaria o teste em uma mistura realista: avisos do USCIS, RFEs, recibos, traduções e qualquer digitalização de vários documentos que normalmente faz os humanos hesitarem." Outro acrescentou o que a versão segura dessa automação precisa incluir: "se ela encaminha itens incertos para uma pasta de revisão e deixa um rastro claro do que decidiu e por quê."
A parte não dita de ambos os comentários é que a etapa de classificação é a cara. A ferramenta discutida naquele tópico comercializa um "AI Mailroom" que classifica cada documento e o arquiva no processo correto automaticamente. Isso é classificação mais roteamento, e não é o que este artigo descreve. Este artigo descreve a versão mais simples e segura: a extração faz a leitura, uma etiqueta de tipo ajuda sua equipe a fazer a triagem, e um humano confirma os itens incertos.
O Que a Equipe de Triagem Realmente Faz com uma Pilha de Avisos
O USCIS envia muito mais papel do que admite existir. No ano fiscal de 2025, a agência recebeu cerca de 13,69 milhões de aplicações e petições e processou cerca de 11,73 milhões, enquanto o acúmulo líquido de casos cresceu para aproximadamente 6,28 milhões, um aumento de 65% em relação ao ano anterior (relatório anual do USCIS de 2025). Cada um desses registros gera pelo menos um aviso ao longo do processo, e a maioria gera vários: um aviso de recebimento, uma carta de agendamento, um RFE, uma aprovação. Para um escritório com algumas centenas de casos ativos, a mesa de triagem processa uma pilha desses documentos toda semana.
O fluxo de trabalho é rotineiro e, em grande parte, manual. Alguém abre a correspondência, digitaliza o que está em papel e lê cada documento para decidir o que é. Um paralegal insere os campos no arquivo do caso e na planilha de acompanhamento: número do recibo, tipo de aviso, centro de serviço, data de recebimento, número do caso, data de prioridade, se houver, e, para um RFE, o prazo de resposta. O padrão profissional para essa etapa é simples. A dica prática do American Immigration Council sobre como responder a um RFE orienta os profissionais a localizar e registrar a data de vencimento primeiro, e observa que muitas seguradoras de responsabilidade profissional exigem que os prazos sejam registrados em dois locais separados.
Cada campo dessa rotina tem uma origem. O número do recibo é o identificador de 13 caracteres no aviso, começando com um código de três letras do centro de serviço, como EAC, LIN, SRC, WAC ou IOE, que o escritório usa para verificar o status online. O tipo de aviso é importante porque a família I-797 esconde vários significados: um I-797C comunica recebimento, agendamento ou transferência, enquanto um I-797E é o aviso que solicita evidências, e confundir os dois muda o que o escritório faz em seguida. A data de prioridade aparece nos I-797 para petições familiares e de emprego e controla quando um número de visto fica disponível de acordo com o Visa Bulletin mensal. Cada um é uma pequena tarefa de leitura, e nenhum deles é difícil isoladamente.
Onde a Leitura de uma Pilha de Avisos Dá Errado
As falhas são estruturais, e não uma questão de esforço da equipe. Um scanner que agrupa toda a correspondência de um cliente produz um único PDF com um aviso de recebimento, um RFE e uma certidão de casamento traduzida em sequência. O paralegal que o abre precisa separá-los mentalmente, e o prazo na página do meio é exatamente o valor com maior probabilidade de ser arquivado incorretamente quando as páginas são anexadas à pasta errada no sistema de gerenciamento de processos.
A mesma informação aparece com convenções de layout diferentes entre as variantes do I-797, então modelos baseados em posição falham regularmente. Datas aparecem impressas por máquina ou marcadas à mão em uma carta de apresentação anexada por alguém. Uma tradução fica ao lado do original em inglês, e a equipe de triagem pode não ler o idioma estrangeiro. O mesmo número de recibo pode aparecer em dois avisos que descrevem ações diferentes, o que uma linha duplicada na planilha de acompanhamento parecerá exatamente. Em um tópico do r/paralegal sobre tempo de preenchimento de formulários, um paralegal de imigração relatou que uma hora e meia a duas horas por formulário é a norma em seu escritório quando os clientes não fornecem todos os documentos antecipadamente. A maior parte desse tempo não é de digitação. É de leitura da pilha para descobrir quais campos ainda faltam no arquivo do caso.
O custo de um erro se acumula em uma única direção. Uma grafia errada do nome do requerente é corrigível com uma carta. Um prazo de RFE perdido é um caso negado, e a janela de resposta não pode ser estendida por regulamento. O campo que carrega esse risco é o que a extração deve acertar primeiro.
Nomeie as Colunas de que Você Precisa e Deixe a IA Ler a Pilha Inteira
O mecanismo central aqui é a Extração de Colunas Personalizadas. Em vez de criar um modelo para cada layout de aviso, você digita os nomes das colunas desejadas, e um modelo de visão lê cada documento enviado e retorna o valor que se encaixa em cada coluna pelo significado. Os nomes das colunas que você insere se tornam os cabeçalhos da planilha de saída, então o escritório define seu vocabulário de arquivo de caso uma vez, e cada aviso preenche a mesma estrutura. Nenhuma etapa de classificação vem primeiro, porque o modelo não precisa saber o tipo de documento antes de lê-lo: ele lê os campos que você nomeou a partir do que está à sua frente.
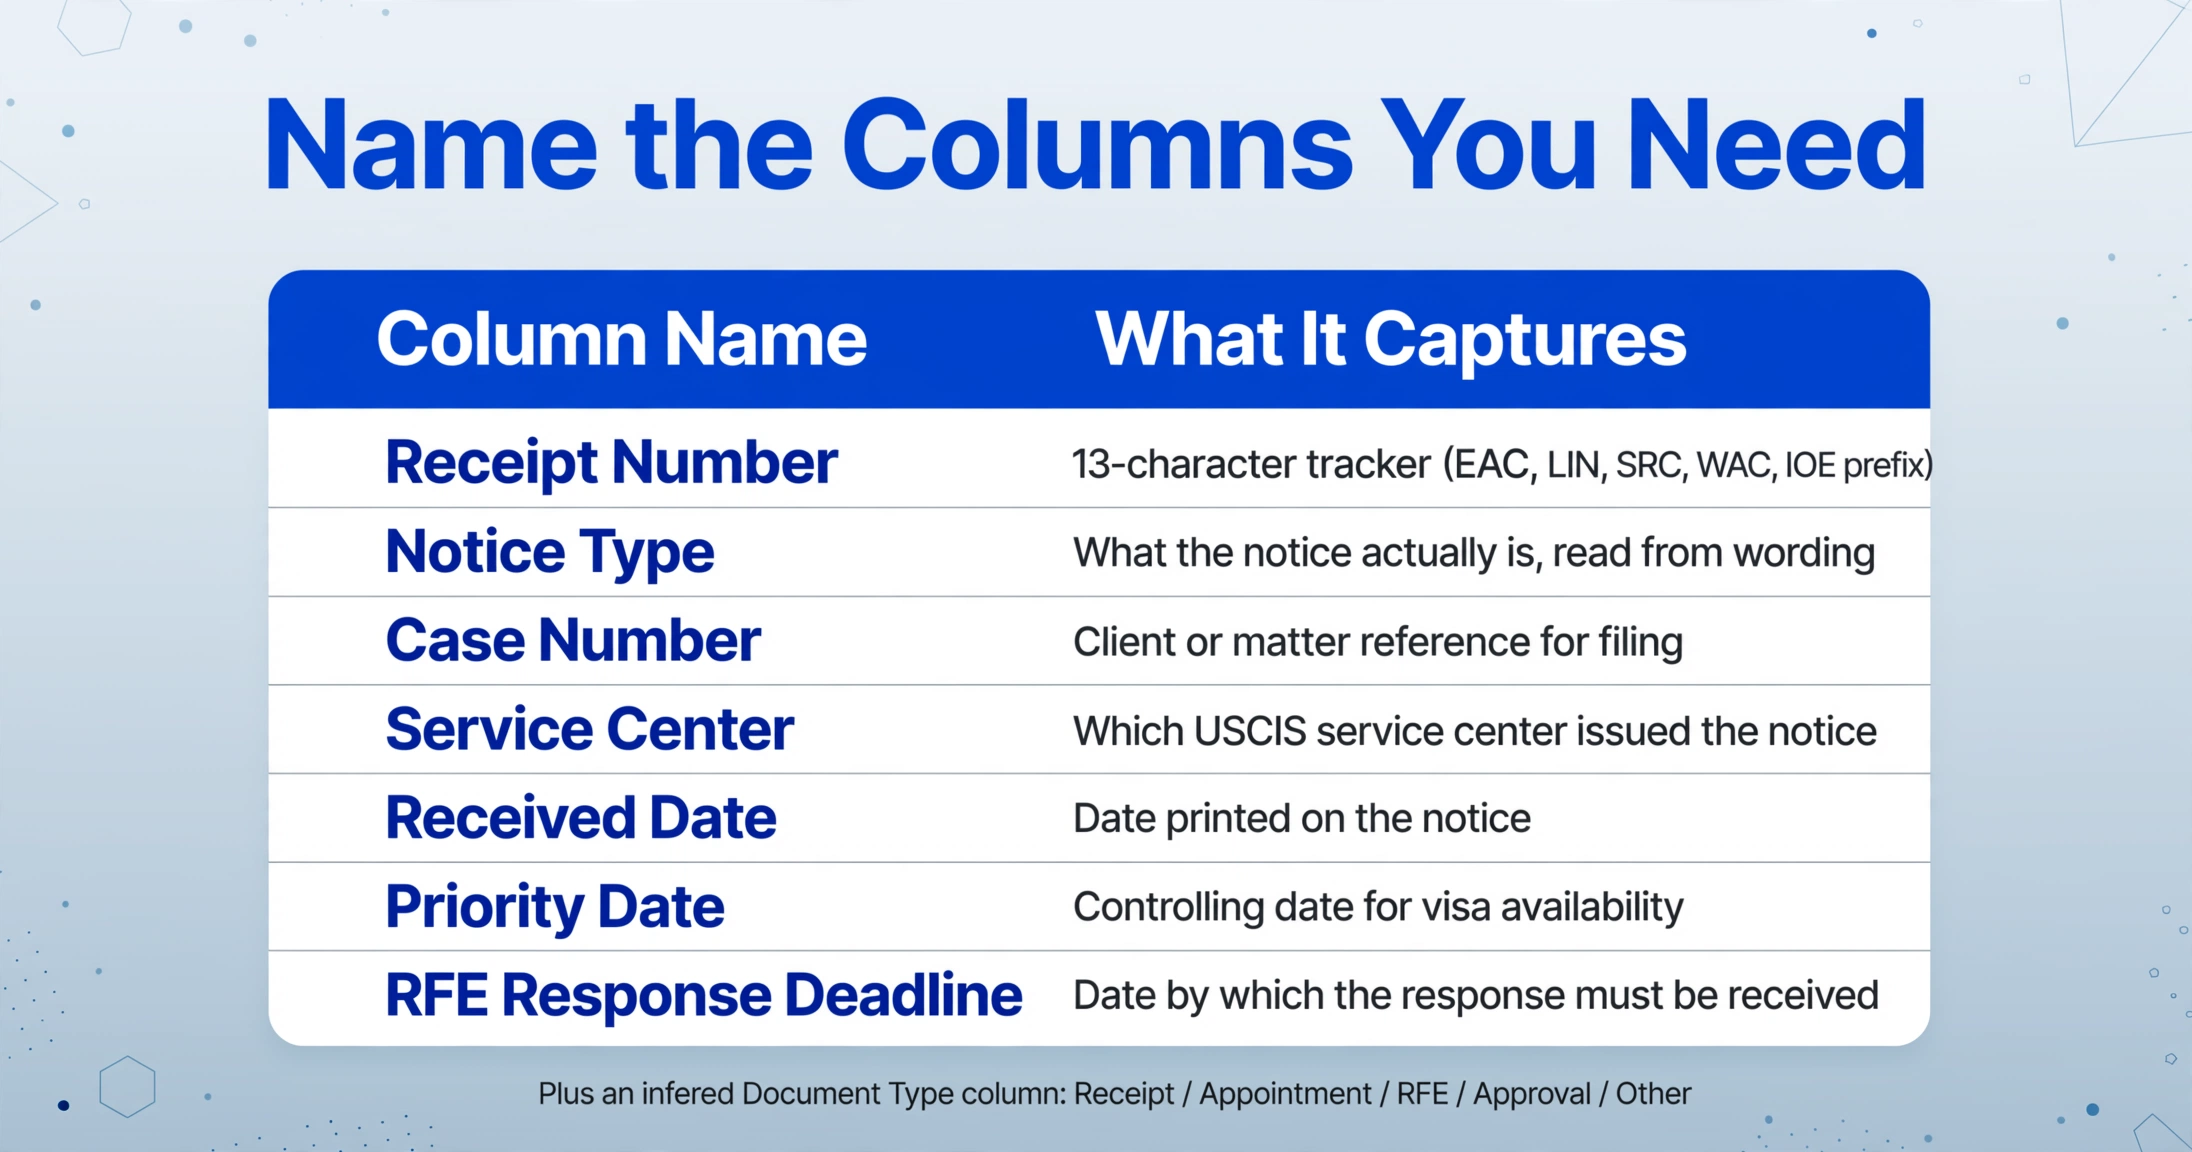
Uma lista de colunas viável para uma pilha de avisos do USCIS é assim:
| Nome da coluna | O que ela captura |
|---|---|
| Receipt Number | O rastreador de 13 caracteres (prefixo EAC, LIN, SRC, WAC, IOE) usado para consultas de status |
| Notice Type | O que o aviso realmente é, identificado pelo texto, como "receipt" ou "request for evidence" |
| Case Number | A referência do cliente ou do assunto sob a qual o aviso é arquivado |
| Service Center | Qual centro de atendimento do USCIS emitiu o aviso |
| Received Date | A data impressa no aviso, que ancora prazos e consultas de status |
| Priority Date | A data determinante para a disponibilidade de visto em petições familiares e de emprego |
| RFE Response Deadline | A data impressa no RFE até a qual a resposta deve ser recebida |
Duas adições tornam a extração utilizável como triagem de recebimento, e não apenas como um despejo de dados. Uma coluna inferida chamada Document Type (options: Receipt / Appointment / RFE / Approval / Other) pede que a IA categorize cada documento com base no conteúdo. Como a etiqueta é retornada em sua própria coluna, ela não decide o destino do documento. Ela dá ao paralegal um campo filtrável: ordene por Document Type, e as linhas de RFE aparecem com seus prazos ao lado. Nosso guia sobre extração de campos específicos de formulários digitalizados aborda a mecânica de lote misto em ação aqui, incluindo como lidar com vários layouts em um único upload.
A segunda adição é o caminho de revisão que o comentarista do r/legaltech exigiu. Review Mode with Bbox verification permite que qualquer pessoa passe o mouse sobre uma célula extraída para ver exatamente de onde o valor veio no aviso original e, inversamente, clique na região da imagem para voltar à célula. Isso transforma a etapa de confirmação em uma verificação pontual dos valores que sustentam o caso, especialmente o prazo do RFE e o número do recibo, em vez de uma releitura completa de cada aviso. Para digitalizações de baixa qualidade que assolam as mesas de recebimento, um nível de processamento superior executa o lote com um modelo mais forte, que é a opção que o guia de OCR para documentos jurídicos aborda no lado da qualidade da digitalização.
Os arquivos são processados com segurança e não são armazenados.
O Que Isto Não Faz: Sem Divisão de Arquivos, Sem Roteamento
O limite importa precisamente porque a alternativa divulgada naquele tópico de legaltech parece mais completa. O ImageToTable.ai não classifica uma pilha e depois roteia cada documento para uma pasta, assunto ou sistema diferente. Ele não divide uma digitalização com vários documentos em arquivos separados e não grava linhas no Clio, Docketwise ou INSZoom em seu nome. Se vários documentos foram digitalizados em um único PDF, você receberá uma linha por upload, e separá-los para que cada linha contenha um aviso é uma etapa que um humano realiza primeiro. Quando esse tipo de pré-processamento faz parte da sua rotina de triagem, nosso fluxo de extração em lote se aplica após a divisão dos documentos.
A etiqueta de tipo da coluna inferida é uma dica para a triagem. Ela não decide sozinha onde um documento pertence. Um documento que o modelo rotula como Other, ou um RFE cujo prazo ele não conseguiu ler com clareza, é exatamente a linha que deve ir para uma pessoa antes que qualquer coisa seja utilizada. O caminho de revisão existe para que a incerteza fique visível em vez de silenciosa. Esta é a mesma linha honesta que a extração em lote para pequenos escritórios de advocacia no contexto de discovery traça, e discovery é um fluxo de trabalho diferente; a versão de triagem de imigração concentra sua confiança no campo de prazo, em vez de em um corpus de documentos.
O julgamento jurídico permanece com o escritório. A extração informa o que um aviso diz, não o que fazer sobre a cadeia de evidências quebrada que ele descreve, e nada na saída é aconselhamento jurídico. O tratamento de confidencialidade dos arquivos de imigração dos clientes continua a reger onde a planilha e as digitalizações ficam armazenadas, e escritórios sujeitos a restrições de fornecedores impostas pelo cliente ou pela ordem dos advogados devem confirmar o modelo de processamento e retenção em relação a esses requisitos primeiro. A equipe confirma os campos que carregam o caso, e o valor da ferramenta é comprimir a parte de leitura e digitação daquela semana, não substituir a confirmação.
Configurando o Fluxo de Extração de Intake
O fluxo cabe em uma tarde e mapeia cada etapa para um controle, em vez de uma promessa. É assim que a configuração se parece:
Defina as colunas do aviso uma única vez
Use a lista de campos acima: Receipt Number, Notice Type, Case Number, Service Center, Received Date, Priority Date, RFE Response Deadline. Adicione a coluna inferida Document Type com as opções de categoria. Esses nomes de coluna se tornam os cabeçalhos da sua planilha, então alinhe-os uma única vez para cada canal de intake.
Carregue a pilha inteira, não a pasta organizada
Coloque os scans da pasta do cliente em um único lote. A ordem não importa e os formatos podem se misturar. O lote produz uma planilha com uma linha por aviso, que é a consolidação que alimenta a planilha de acompanhamento e o arquivo do caso.
Filtre por Document Type para encontrar as linhas de RFE
Classifique a saída pela coluna Document Type. As linhas de RFE e NOID aparecem com seus prazos ao lado, e as linhas de recibos se separam das linhas de agendamento sem que ninguém precise reler os scans.
Verifique o prazo e o número do recibo no original
Abra o Review Mode e passe o cursor sobre as células de RFE Response Deadline e Receipt Number nas linhas que podem mover um caso. O Bbox destaca exatamente de onde veio cada valor, então a confirmação leva apenas uma olhada no aviso, em vez de uma segunda leitura completa.
Exporte e registre o prazo em dois lugares
Exporte para Excel ou CSV. Insira os campos confirmados no arquivo do assunto e no seu calendário, conforme exige a convenção do seguro contra erros profissionais, e então defina o lembrete. A extração eliminou a leitura e a digitação; o registro duplo permanece como rede de segurança.
Os escritórios que quiserem avançar ainda mais no intake podem combinar isso com a conversão de qualquer documento enviado em uma planilha para as cartas de evidência de suporte e documentos traduzidos, e o mesmo modelo de coluna lida tanto com originais em inglês quanto com cópias traduzidas, sem uma segunda configuração. A distinção clara em relação ao trabalho de descoberta legal é abordada em o guia de extração de dados de descoberta: populações de documentos diferentes, mesma extração subjacente.
FAQ
Ele consegue distinguir um aviso de recebimento de um RFE antes que qualquer coisa seja inserida?
Sim, no sentido que importa para a triagem: a coluna Document Type marca cada aviso com sua categoria, permitindo que as linhas de RFE sejam classificadas e revisadas sem que alguém leia cada digitalização primeiro. A marcação é apenas uma sugestão para triagem; ela não decide onde um documento pertence. Um documento que o modelo coloca na categoria "Outros" vai para uma pessoa, e o prazo em cada linha de RFE é verificado no Review Mode antes de ser utilizado.
O prazo do RFE é extraído da data impressa no aviso?
Sim. A coluna Response Deadline é lida a partir do prazo impresso no aviso, que é a data que prevalece de acordo com o USCIS Policy Manual. Como o prazo também é verificado em relação à imagem original no Review Mode, o escritório pode identificar um erro de leitura ou um artefato de OCR antes que o valor seja inserido no calendário.
Nossas digitalizações misturam vários documentos em um único PDF. Isso funciona?
Parcialmente, e vale ser explícito: a ferramenta lê os documentos conforme são enviados, então um PDF com vários documentos retorna uma linha para o envio como um todo. Se avisos separados foram digitalizados em um único arquivo, uma pessoa os separa primeiro e depois o lote é processado. A ordem dos avisos no lote não faz diferença para a extração.
Isso grava diretamente no Clio, Docketwise ou no nosso sistema de gestão de casos?
Não, e isso é proposital. A ferramenta exporta Excel, CSV ou JSON, e os campos confirmados são inseridos no sistema de gestão de casos por uma pessoa. Ela não encaminha documentos para diferentes assuntos nem os arquiva automaticamente. Ferramentas que prometem comportamento de classificar-e-encaminhar são uma categoria diferente, e uma equipe que deseja isso deve avaliá-la por seus próprios méritos.
E se a digitalização for de baixa qualidade ou parte da página estiver cortada?
Digitalizações ruins voltam para revisão. Um nível de processamento superior usa um modelo mais robusto, mais adequado para documentos densos ou degradados, e o Review Mode torna as células incertas visíveis em vez de silenciosas. O limite de qualidade da digitalização é aquele que todo fluxo de trabalho de processamento de documentos jurídicos enfrenta, e a resposta prática é a mesma: sinalizar, confirmar, corrigir.
O modelo mental útil é que a triagem é um problema de leitura antes de ser um problema de digitação. A hora do paralegal em uma pilha de avisos é gasta principalmente descobrindo o que cada documento é e quais campos o arquivo do caso ainda precisa. Nomear as colunas uma vez, deixar um modelo de visão ler a pilha inteira e marcar o tipo de cada documento para triagem comprime essa leitura em uma etapa de revisão, enquanto o prazo que pode realmente prejudicar um caso permanece visível em sua própria coluna até que uma pessoa o confirme.
Execute uma de suas próprias digitalizações de avisos e verifique você mesmo a coluna de prazo. Experimente com um RFE real da sua mesa.