Extracción de datos de avisos del USCIS para
admisiones de inmigración, sin ordenar primero
El documento con el plazo más corto en un caso de inmigración es también el que con mayor probabilidad pasa desapercibido dentro de una pila de escaneos: una Solicitud de Evidencia. Según el Manual de Políticas del USCIS, el tiempo de respuesta estándar es de 84 días para la mayoría de los formularios, 30 para algunos otros, con tres días adicionales si el aviso llega por correo. Un solicitante que no cumpla con la fecha límite impresa corre el riesgo de que el caso sea denegado por abandono. Esa fecha límite es una fecha en un aviso entre muchos, y todo lo relacionado con el manejo del correo y los escaneos de una firma determina si alguien la ve a tiempo.
Conclusiones clave
- 84 días es el plazo estándar para responder a una RFE, y no cumplirlo puede resultar en la denegación del caso por abandono.
- Una fecha límite no cumplida generalmente no es un error de calendario, sino un aviso enterrado en una pila mixta que nunca llegó a un calendario.
- Defina las columnas una vez, deje que el modelo lea toda la pila sin ordenar y luego confirme solo la fecha límite y el número de recibo en el aviso original.
Los plazos de RFE incumplidos son una falla en el manejo de documentos, no en el calendario
Cuando se incumple el plazo de respuesta a una RFE, la explicación generalmente no es que nadie lo haya anotado. Es que el aviso pasó su primera semana dentro de una pila mixta: escaneado en el mismo PDF que un aviso de recepción y una carta de cita biométrica, archivado en el expediente del cliente equivocado, o fotografiado fuera de orden con la página del plazo enterrada en el medio. El plazo estaba impreso en el aviso, pero nunca llegó al calendario porque el documento nunca llegó a la atención de la persona correcta.
Los equipos de recepción de inmigración conocen este tipo de falla por su nombre. En una discusión de r/legaltech sobre la recepción automatizada de documentos de USCIS, un comentarista planteó la prueba como lo haría un asistente legal en ejercicio: "Probaría el ensayo con una mezcla realista: avisos de USCIS, RFE, recibos, traducciones y cualquier escaneo de múltiples documentos que normalmente haga que las personas se detengan". Otro añadió lo que la versión segura de esa automatización debe incluir: "si enruta los elementos inciertos a un grupo de revisión y deja un rastro claro de lo que decidió y por qué".
La parte no expresada de ambos comentarios es que el paso de clasificación es el costoso. La herramienta que se discute en ese hilo comercializa un "AI Mailroom" que clasifica cada documento y lo archiva automáticamente en el asunto correcto. Eso es clasificación más enrutamiento, y no es lo que describe este artículo. Este artículo describe la versión más simple y segura: la extracción hace la lectura, una etiqueta de tipo ayuda a su equipo a clasificar, y una persona confirma los elementos inciertos.
Lo que el personal de admisión hace realmente con una pila de avisos
USCIS envía mucho más papel del que admite que existe. En el año fiscal 2025, la agencia recibió aproximadamente 13.69 millones de solicitudes y peticiones y procesó alrededor de 11.73 millones, mientras que el atraso neto creció a aproximadamente 6.28 millones de casos, un aumento del 65 por ciento respecto al año anterior (informe anual del USCIS del año fiscal 2025). Cada una de esas presentaciones genera al menos un aviso en el proceso, y la mayoría genera varios: un aviso de recepción, una carta de cita, un RFE, una aprobación. Para un despacho con unos cientos de casos abiertos, el escritorio de admisión procesa una pila de estos cada semana.
El flujo de trabajo es rutinario y mayormente manual. Alguien abre el correo, escanea lo que está en papel y lee cada documento para decidir qué es. Un asistente legal ingresa los campos en el expediente del caso y en la hoja de cálculo de seguimiento: número de recibo, tipo de aviso, centro de servicio, fecha de recepción, número de caso, fecha de prioridad si la hay, y para un RFE la fecha límite de respuesta. El estándar profesional para ese paso es claro. La práctica recomendada del American Immigration Council sobre cómo responder a un RFE indica a los profesionales localizar y calendarizar primero la fecha de vencimiento, y señala que muchas aseguradoras de negligencia exigen que las fechas límite se registren en dos lugares separados.
Cada campo en esa rutina tiene una fuente. El número de recibo es el rastreador de 13 caracteres en el aviso, que comienza con un código de centro de servicio de tres letras como EAC, LIN, SRC, WAC o IOE, que el despacho utiliza para verificar el estado en línea. El tipo de aviso importa porque la familia I-797 oculta varios significados: un I-797C comunica recepción, cita o transferencia, mientras que un I-797E es el aviso que solicita evidencia, y confundir los dos cambia lo que el despacho hace a continuación. La fecha de prioridad aparece en los I-797 para peticiones familiares y de empleo y controla cuándo un número de visa está disponible según el Visa Bulletin mensual. Cada uno es una pequeña tarea de lectura, y ninguno es difícil de forma aislada.
Dónde falla la lectura de un lote de avisos
Los fallos son estructurales y no una cuestión de esfuerzo del personal. Un escáner que procesa todo el correo de un cliente produce un único PDF con un aviso de recepción, una RFE y un certificado de matrimonio traducido en secuencia. El asistente legal que lo abre tiene que separarlos mentalmente, y la fecha límite que aparece en la página central es exactamente el valor que tiene más probabilidades de archivarse incorrectamente cuando las páginas se adjuntan a la carpeta equivocada en el sistema de gestión de expedientes.
La misma información aparece con diferentes convenciones de diseño en las variantes del I-797, por lo que las plantillas basadas en la posición fallan con regularidad. Las fechas aparecen impresas por máquina o marcadas a mano en una carta de presentación que alguien adjuntó. Una traducción se encuentra junto al original en inglés, y el personal de admisión puede no leer el idioma extranjero. El mismo número de recibo puede aparecer en dos avisos que describen acciones diferentes, lo que una fila duplicada en la hoja de seguimiento parecerá exactamente. En un hilo de r/paralegal sobre el tiempo de preparación de formularios, un asistente legal de inmigración informó que una hora y media a dos horas por formulario es la norma en su despacho cuando los clientes no aportan todos los documentos por adelantado. La mayor parte de ese tiempo no es de mecanografía. Es leer el lote para encontrar qué campos faltan aún en el expediente.
El coste de un error se acumula en una sola dirección. Una ortografía incorrecta del nombre del peticionario se puede corregir con una carta. Una fecha límite de RFE incumplida es un caso denegado, y el plazo de respuesta no se puede ampliar por normativa. El campo que conlleva ese riesgo es el que la extracción debe acertar primero.
Nombre las columnas que necesita y deje que la IA lea todo el lote
El mecanismo central aquí es Custom Column Extraction. En lugar de crear una plantilla para cada diseño de aviso, usted escribe los nombres de las columnas que desea, y un modelo de visión lee cada documento cargado y devuelve el valor que se ajusta a cada columna por significado. Los nombres de columna que introduce se convierten en los encabezados de la hoja de cálculo de salida, de modo que el despacho define su vocabulario de expediente una sola vez y cada aviso rellena la misma estructura. No hay ningún paso de ordenación previo, porque el modelo no necesita saber el tipo de documento antes de poder leerlo: lee los campos que usted ha nombrado de lo que tenga delante.
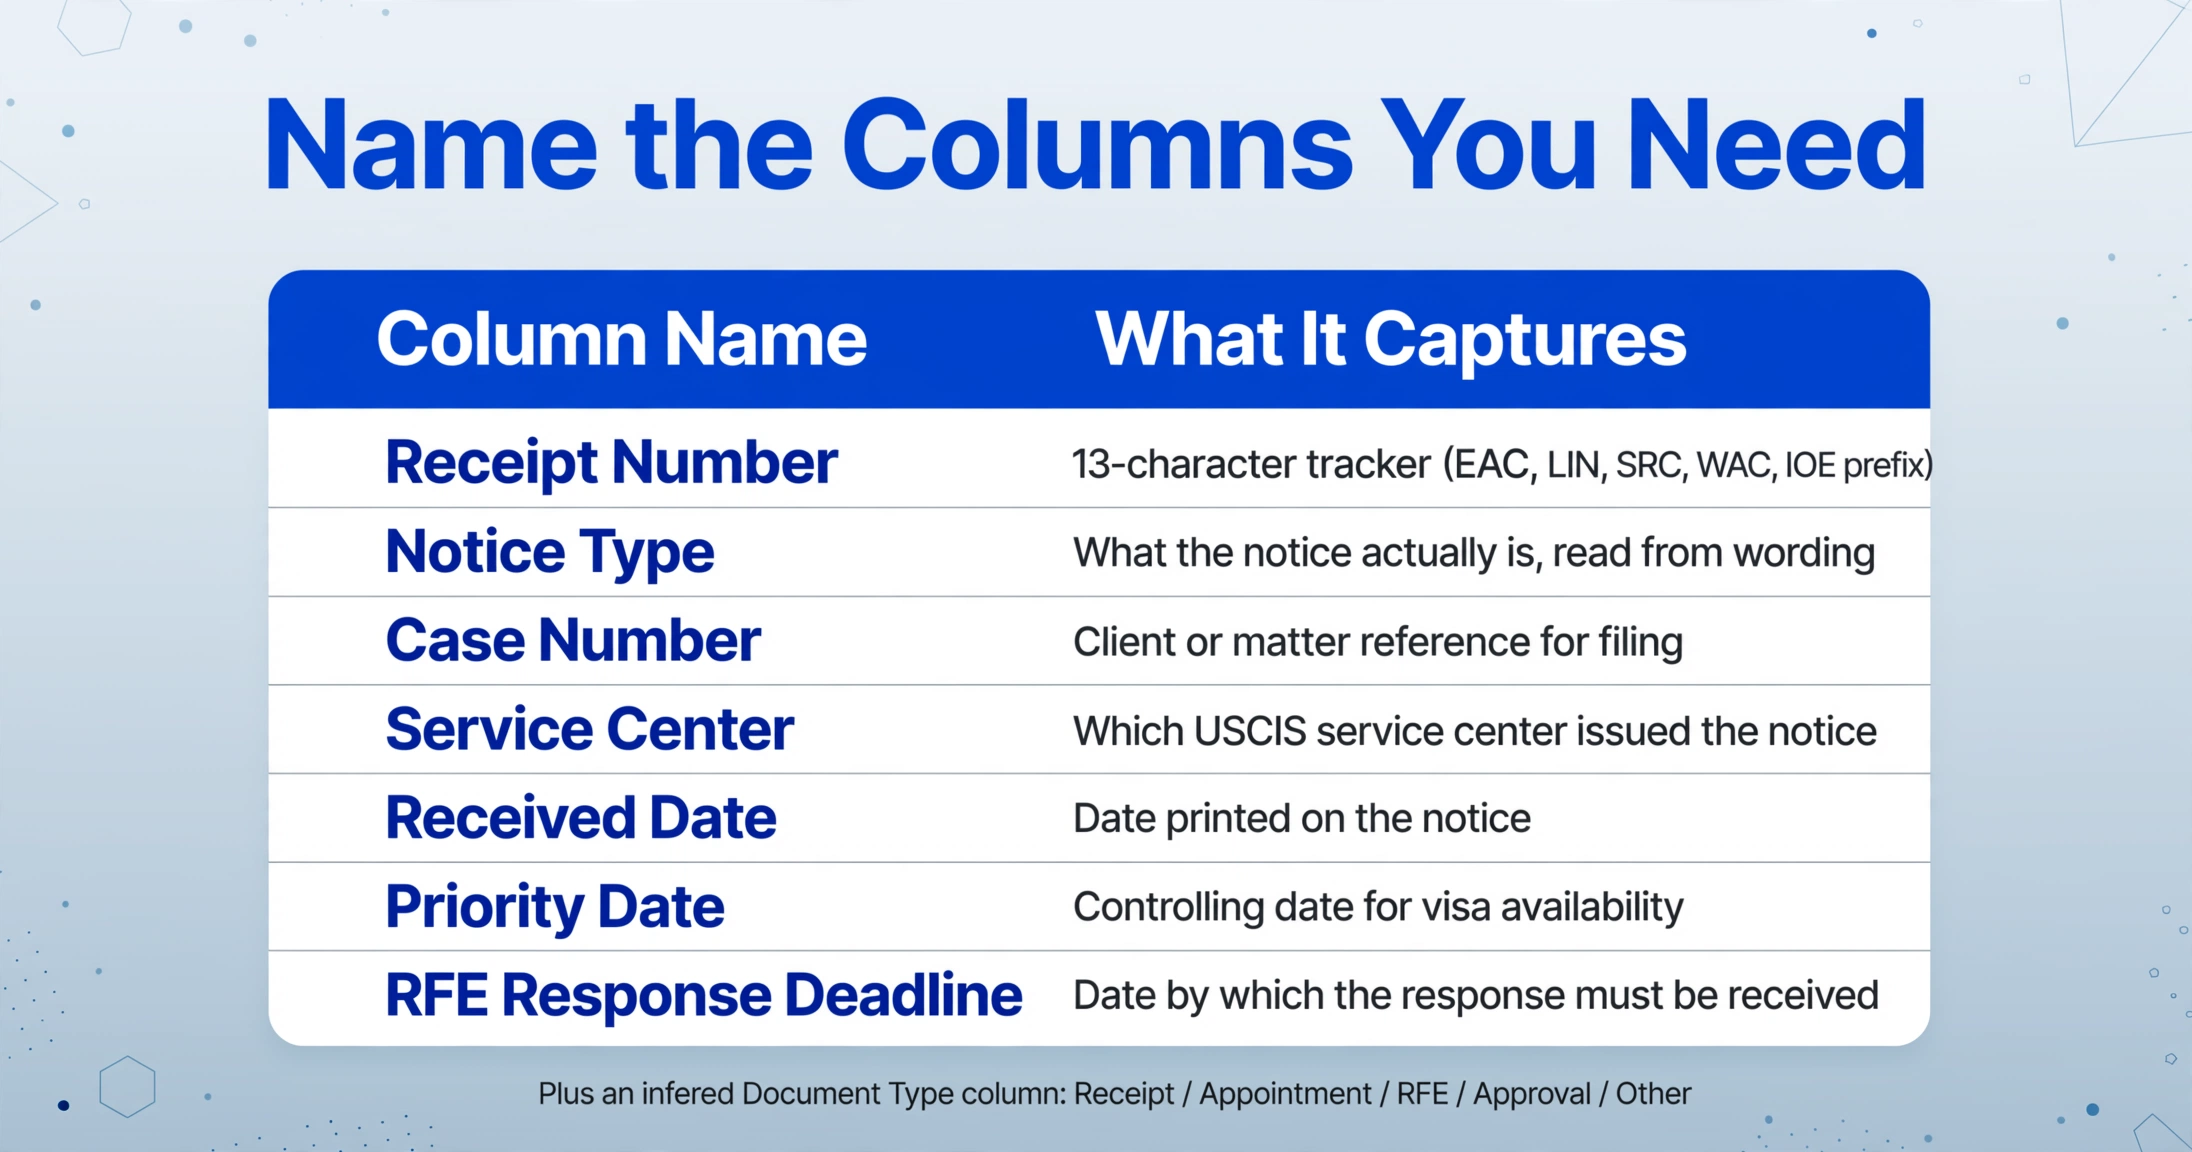
Una lista de columnas práctica para un lote de avisos de USCIS tiene este aspecto:
| Nombre de la columna | Qué captura |
|---|---|
| Receipt Number | El rastreador de 13 caracteres (prefijo EAC, LIN, SRC, WAC, IOE) utilizado para las verificaciones de estado |
| Notice Type | Qué es realmente el aviso, leído a partir de redacciones como "receipt" o "request for evidence" |
| Case Number | La referencia del cliente o del asunto bajo la cual se presenta el aviso |
| Service Center | Qué centro de servicio de USCIS emitió el aviso |
| Received Date | La fecha impresa en el aviso, que ancla los plazos y las verificaciones de estado |
| Priority Date | La fecha determinante para la disponibilidad de visas en peticiones familiares y de empleo |
| RFE Response Deadline | La fecha impresa en el RFE antes de la cual debe recibirse la respuesta |
Dos adiciones hacen que la extracción sea útil como triaje de ingreso, y no solo como un volcado de datos. Una columna inferida denominada Document Type (opciones: Receipt / Appointment / RFE / Approval / Other) pide a la IA que etiquete cada documento con una categoría derivada de su contenido. Como la etiqueta se devuelve en su propia columna, no decide el destino del documento. Le brinda al asistente legal un campo filtrable: ordene por Document Type y las filas de RFE aparecerán con sus plazos al lado. Nuestra guía sobre extracción de campos específicos de formularios escaneados cubre la mecánica de lotes mixtos que interviene aquí, incluido cómo manejar múltiples diseños en una sola carga.
La segunda adición es la ruta de revisión que exigió el comentarista de r/legaltech. Review Mode con verificación Bbox permite que cualquier persona pase el cursor sobre una celda extraída para ver exactamente de dónde proviene el valor en el aviso original y, a la inversa, haga clic en la región de la imagen para volver a la celda. Esto convierte el paso de confirmación en una verificación puntual de los valores que sustentan el caso, especialmente el plazo del RFE y el número de recibo, en lugar de una relectura completa de cada aviso. Para los escaneos de baja calidad que afectan a los escritorios de ingreso, un nivel de procesamiento superior ejecuta el lote con un modelo más potente, que es la opción que cubre la guía de OCR para documentos legales en el aspecto de la calidad del escaneo.
Los archivos se procesan de forma segura y no se almacenan.
Lo que esto no hace: sin división de archivos, sin enrutamiento
El límite importa precisamente porque la alternativa que se comercializa en ese hilo de legaltech suena más completa. ImageToTable.ai no clasifica un lote y luego enruta cada documento a una carpeta, asunto o sistema diferente. No divide un escaneo de varios documentos en archivos separados, y no escribe filas en Clio, Docketwise o INSZoom en su nombre. Si varios documentos fueron escaneados en un solo PDF, recibirá una fila por carga, y separarlos para que cada fila contenga un aviso es un paso que una persona realiza primero. Cuando ese tipo de preprocesamiento forma parte de su rutina de admisión, nuestro flujo de extracción por lotes se aplica después de que los documentos se hayan dividido.
La etiqueta de tipo de la columna inferida es una pista para el triaje. No decide por sí sola dónde pertenece un documento. Un documento que el modelo etiqueta como Other, o una RFE cuya fecha límite no pudo leer correctamente, es exactamente la fila que debe ir a una persona antes de que se confíe en ella. La ruta de revisión existe para que la incertidumbre sea visible en lugar de silenciosa. Esta es la misma línea honesta que la extracción por lotes para pequeños bufetes en el contexto de discovery traza, y discovery es un flujo de trabajo diferente; la versión de admisión de inmigración concentra su confianza en el campo de fecha límite en lugar de en un corpus de documentos.
El criterio legal permanece en el bufete. La extracción le dice lo que dice un aviso, no qué hacer con la cadena de evidencia rota que describe, y nada en el resultado es asesoramiento legal. El manejo de confidencialidad para los archivos de inmigración de clientes sigue rigiendo dónde se almacenan la hoja de cálculo y los escaneos, y los bufetes sujetos a restricciones de proveedores impuestas por el cliente o por el colegio de abogados deben confirmar el modelo de procesamiento y retención según esos requisitos primero. El personal confirma los campos que respaldan el caso, y el valor de la herramienta es comprimir la parte de lectura y escritura de esa semana, no reemplazar la confirmación.
Configuración del flujo de trabajo de extracción de admisión
El flujo de trabajo se ajusta a una tarde y asigna cada paso a un control en lugar de a una promesa. Así es como se ve la configuración:
Defina las columnas de avisos una sola vez
Use la lista de campos anterior: Receipt Number, Notice Type, Case Number, Service Center, Received Date, Priority Date, RFE Response Deadline. Agregue la columna inferida Document Type con las opciones de categoría. Estos nombres de columna se convierten en los encabezados de su hoja de cálculo, así que acuérdelos una vez para cada canal de admisión.
Cargue el expediente completo, no la pila ordenada
Coloque los escaneos de la carpeta del cliente en un solo lote. El orden no importa y los formatos pueden mezclarse. El lote produce una hoja de cálculo con una fila por aviso, que es la consolidación que alimenta la hoja de seguimiento y el expediente del caso.
Filtre por Document Type para encontrar las filas de RFE
Ordene el resultado por la columna Document Type. Las filas de RFE y NOID aparecen con sus fechas límite justo al lado, y las filas de recibos se separan de las filas de citas sin que nadie tenga que volver a leer los escaneos.
Verifique la fecha límite y el número de recibo en el original
Abra Review Mode y pase el cursor sobre las celdas de RFE Response Deadline y Receipt Number en las filas que moverán un caso. Bbox resalta exactamente de dónde proviene cada valor, por lo que confirmar requiere un vistazo al aviso en lugar de una segunda lectura completa.
Exporte y registre la fecha límite en dos lugares
Exporte a Excel o CSV. Ingrese los campos confirmados en el expediente del asunto y en su calendario según lo exige la convención del seguro contra negligencia, y luego establezca el recordatorio. La extracción eliminó la lectura y la escritura; el doble registro permanece como red de seguridad.
Los despachos que quieran llevar la admisión más lejos pueden combinar esto con convertir cualquier documento cargado en una hoja de cálculo para las cartas de evidencia de respaldo y los documentos traducidos, y la misma plantilla de columna maneja tanto los originales en inglés como las copias traducidas sin una segunda configuración. La línea distintiva contra el trabajo de descubrimiento legal se cubre en la guía de extracción de datos de descubrimiento: diferentes poblaciones de documentos, misma extracción subyacente.
Preguntas frecuentes
¿Puede distinguir un aviso de recepción de un RFE antes de introducir cualquier dato?
Sí, en el sentido que importa para la recepción de documentos: la columna Document Type etiqueta cada aviso con su categoría, de modo que las filas de RFE pueden ordenarse y revisarse sin que nadie tenga que leer cada escaneo primero. La etiqueta es solo una sugerencia para la clasificación inicial; no decide dónde pertenece un documento. Un documento que el modelo coloca en la categoría "Other" pasa a una persona, y el plazo de cada fila de RFE se verifica en Review Mode antes de utilizarse.
¿El plazo de respuesta del RFE se extrae de la fecha impresa en el aviso?
Sí. La columna Response Deadline se lee del plazo impreso en el aviso, que es la fecha que rige según el USCIS Policy Manual. Dado que el plazo también se verifica contra la imagen original en Review Mode, el despacho puede detectar una lectura incorrecta o un artefacto de OCR antes de que el valor llegue al calendario.
Nuestros escaneos combinan varios documentos en un solo PDF. ¿Eso funciona?
Parcialmente, y conviene ser explícito: la herramienta lee los documentos tal como se cargan, por lo que un PDF con varios documentos devuelve una fila para la carga en su conjunto. Si se escanearon avisos separados en un solo archivo, una persona los separa primero y luego se ejecuta el lote. El orden de los avisos dentro del lote no afecta a la extracción.
¿Esto escribe en Clio, Docketwise o en nuestro sistema de gestión de casos?
No, y eso es deliberado. La herramienta exporta Excel, CSV o JSON, y los campos confirmados los introduce una persona en el sistema de gestión de casos. No enruta documentos a distintos asuntos ni los archiva automáticamente. Las herramientas que prometen un comportamiento de clasificar y enrutar son una categoría diferente, y un equipo que quiera eso debe evaluarla según sus propios méritos.
¿Qué ocurre si el escaneo es de baja calidad o parte de la página está cortada?
Los escaneos deficientes vuelven a revisión. Un nivel de procesamiento superior utiliza un modelo más potente, más adecuado para documentos densos o degradados, y Review Mode hace visibles las celdas inciertas en lugar de pasarlas por alto. El límite de calidad del escaneo es el mismo al que se enfrenta todo flujo de procesamiento de documentos legales, y la respuesta práctica es la misma: marcar, confirmar, corregir.
El modelo mental útil es que la recepción de documentos es un problema de lectura antes que de escritura. La hora del asistente legal ante una pila de avisos se dedica sobre todo a averiguar qué es cada documento y qué campos necesita aún el expediente. Nombrar las columnas una vez, dejar que un modelo de visión lea toda la pila y etiquetar el tipo de cada documento para la clasificación inicial comprime esa lectura en una pasada de revisión, mientras que el plazo que realmente puede poner en riesgo un caso permanece visible en su propia columna hasta que una persona lo confirma.
Pase uno de sus propios escaneos de avisos por la herramienta y compruebe usted mismo la columna de plazos. Pruébela con un RFE real de su escritorio.