Extracción de datos de recepción de clientes
Sin el bucle de reingreso
Un cliente potencial escribe su nombre, dirección, el nombre de la otra parte y una breve descripción de la disputa en su formulario de recepción o correo. Luego, un asistente legal ingresa los mismos datos en Clio. Nada se perdió en la primera pasada. Los datos llegaron estructurados, en un campo de formulario o en un hilo de correo, y la segunda pasada es puro reingreso. Ese reingreso es la parte de la recepción de clientes que nunca llega a una factura, y también es el paso que decide si su verificación de conflictos de interés se ejecuta antes de la consulta o después.
Conclusiones clave
- 2.5 horas facturables al día es el límite promedio de un abogado, y el 48% del tiempo no facturable que lo rodea se destina a trabajo administrativo como el reingreso de la recepción de clientes.
- El cliente ya escribió esos datos una vez, por lo que el bufete paga a una segunda persona para que reingrese los mismos nombres, y esa segunda pasada es donde los nombres de conflictos salen mal.
- Leer el correo de recepción de clientes y el formulario reenviado en una sola hoja elimina esa segunda pasada, y la columna de parte adversa se convierte en lo primero que usted revisa.
La recepción de clientes se interrumpe en la transferencia, no en el formulario
El problema de la recepción de clientes en un bufete pequeño casi nunca es la herramienta que recopila los datos. Es la transferencia que le sigue. Clio Grow y MyCase ambos capturan un envío de formulario en línea y crean el contacto y el asunto a partir de él, y ese camino funciona. La dificultad es que solo parte de su recepción llega de esa manera. Piense en cómo un nuevo asunto realmente llega a usted: un formulario web para un asunto, un correo donde el cliente describe la disputa en el cuerpo, una hoja de recepción escaneada o fotografiada adjunta a una respuesta, una llamada telefónica que un asistente legal redacta como notas. Cada uno tiene una forma diferente, y ninguno llega por sí solo a su sistema de gestión de prácticas.
La magnitud de esa transferencia está documentada en los números que los bufetes ya reportan. El Informe de Tendencias Legales 2025 de Clio sitúa al abogado promedio en 2.5 horas facturables al día, una tasa de utilización del 37 por ciento. Su estudio anterior encontró que el 48 por ciento del tiempo no facturable de un abogado se destina a trabajo administrativo como administración de oficina, facturación y cobros. El reingreso de la recepción vive dentro de esa porción, y compite directamente con las horas que usted puede facturar.
Hay un segundo costo que es más fácil de pasar por alto. Una verificación de conflictos de interés es tan rápida como los nombres que puede buscar, y esos nombres tienen que estar en una forma utilizable, a nivel de nombre, antes de que alguien pueda compararlos con su lista de clientes y clientes anteriores. Cuando el nombre de la parte adversa está en un PDF y en la memoria de un asistente legal, la verificación espera. Esa es la parte de la recepción donde el reingreso deja de ser una molestia y comienza a ser un riesgo.
Lo que una Recepción de Clientes Realmente Debe Producir
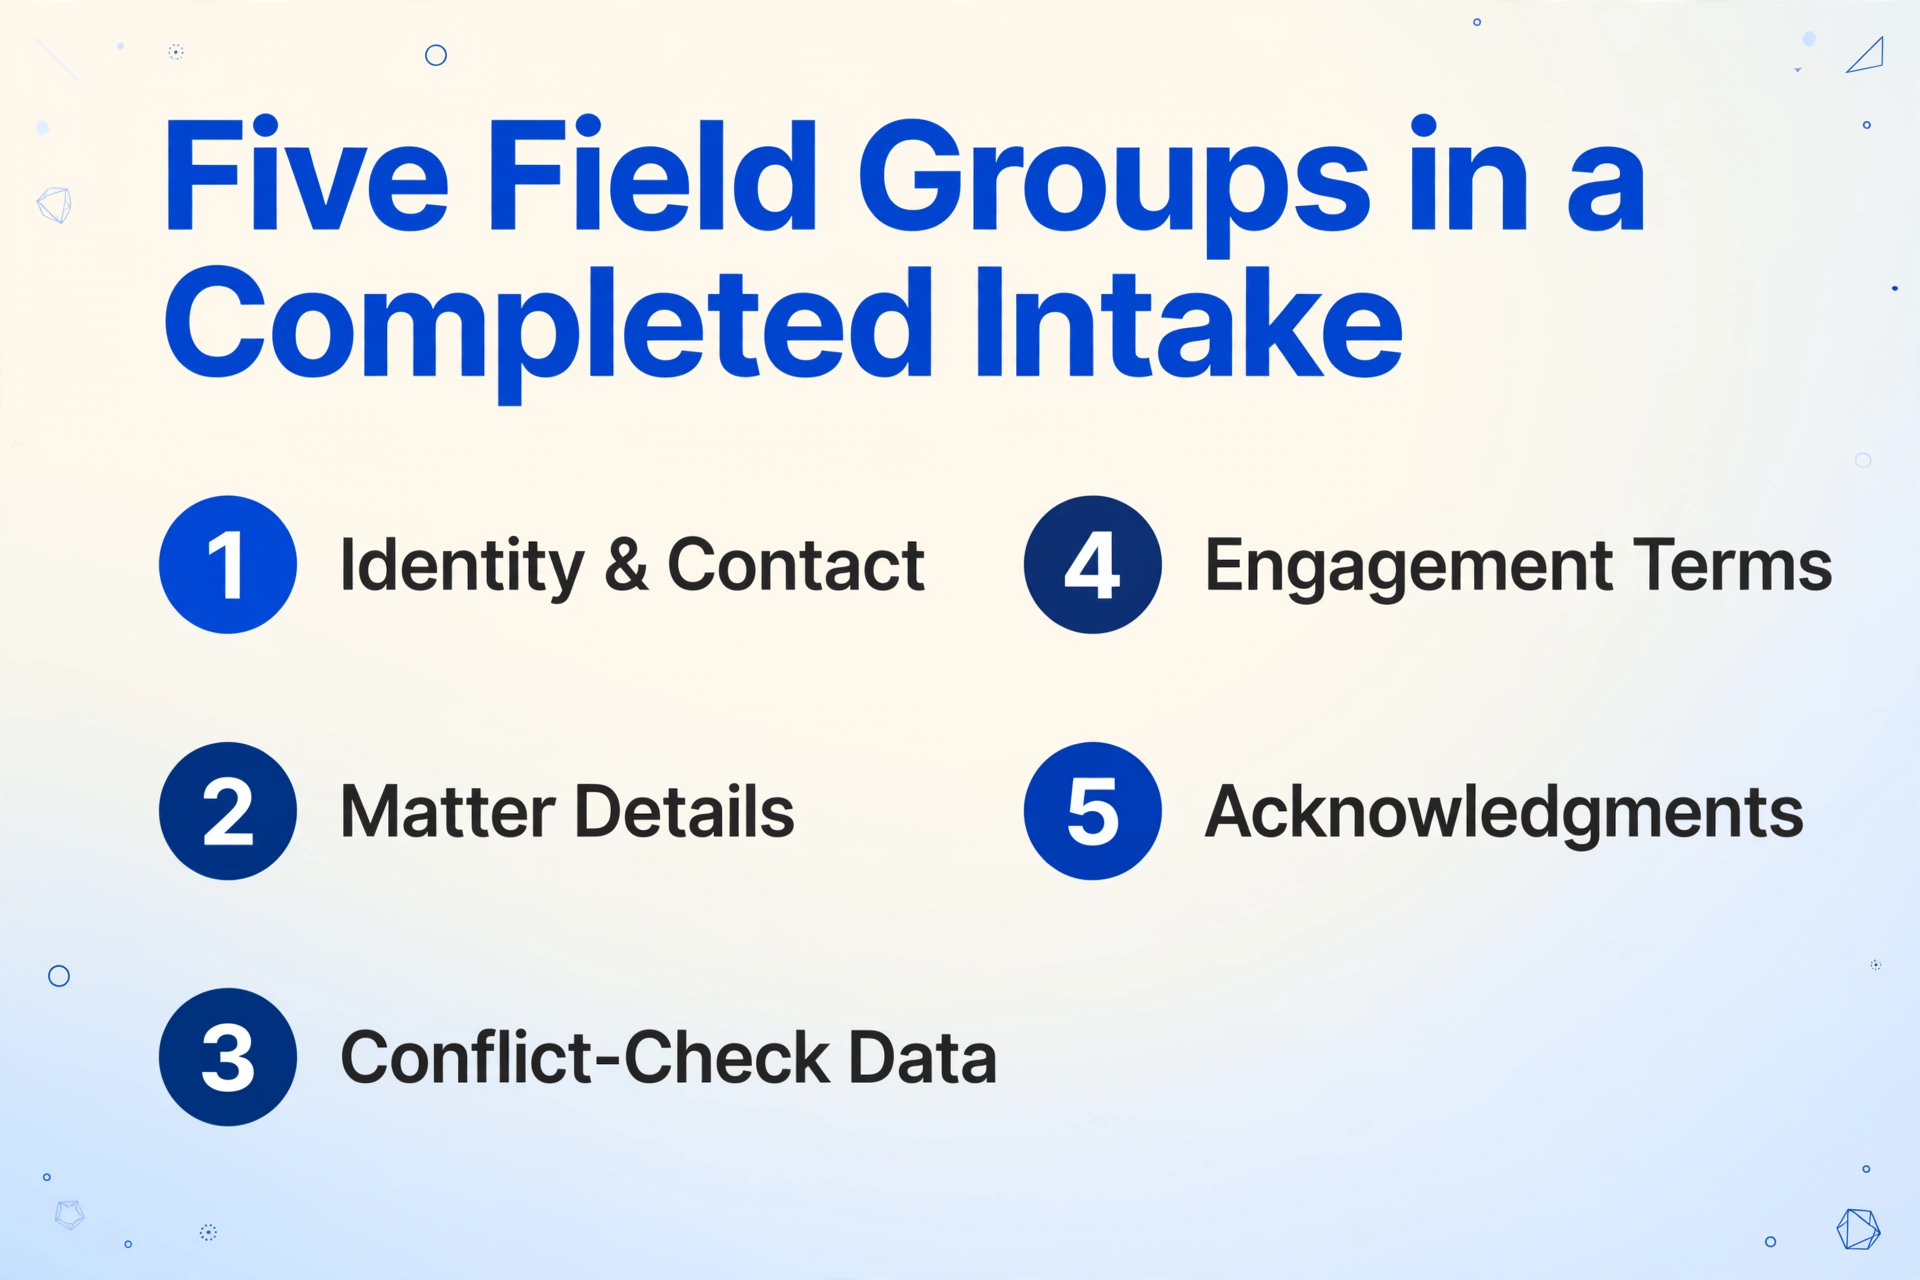
Una recepción de clientes completa no es un solo registro. Son cinco grupos de campos, y dos de ellos existen únicamente para mantener al bufete fuera de un conflicto. El primer grupo es identidad y contacto: el nombre legal completo del cliente y cualquier otro nombre utilizado, dirección postal, teléfono, correo electrónico, fecha de nacimiento y fuente de referencia. El segundo es el asunto en sí: área de práctica o tipo de asunto, una breve descripción de la disputa y las fechas relevantes, incluido cualquier plazo de prescripción o plazo judicial.
El tercer grupo es la razón por la cual la recepción de clientes está regulada y no solo gestionada. Los datos de verificación de conflictos deben incluir a toda parte adversa, a todas las demás personas involucradas y los nombres relacionados que hacen que una búsqueda sea confiable. La guía de la ABA para abogados nuevos sobre el proceso de recepción de clientes y verificación de conflictos es específica al respecto: para una entidad se necesita el nombre legal completo, los alias, el estado de incorporación y la sede; para un asunto contencioso se necesita la parte contraria, el abogado contrario, el foro y el objeto del asunto. La guía práctica de verificación de conflictos de la división GPSolo de la ABA enumera lo que la base de datos de conflictos del bufete debe contener: clientes actuales, clientes anteriores, personas adversas, clientes potenciales, una breve descripción de cada asunto, las fechas de inicio y fin de cada uno, afiliados, y los directivos, directores y accionistas principales de los clientes.
El cuarto grupo son los términos del encargo: estructura de honorarios, monto del anticipo y el alcance de la representación. El quinto son los reconocimientos, principalmente el aviso de no representación que evita que un formulario completado se confunda con una relación abogado-cliente.
Los nombres para la verificación de conflictos son los campos con la vida útil más corta. Una fecha incorrecta puede corregirse después. Una parte adversa mal escrita o faltante es lo que permite que el bufete acepte un asunto que debería haber rechazado.
Ese peso está escrito en las reglas, no solo en las buenas prácticas. El comentario [3] de la Model Rule 1.7 señala que un abogado debe adoptar procedimientos razonables, adecuados al tamaño y tipo de bufete, para determinar las personas y los asuntos involucrados, y añade que la ignorancia causada por no instituir esos procedimientos no excusará una violación. La Model Rule 1.18 extiende la protección al cliente potencial que nunca llega a ser contratado, y la Formal Opinion 510 (marzo de 2024) de la ABA precisa qué significan "medidas razonables" cuando un bufete quiere evitar que el conflicto se impute a todos sus abogados. El orden práctico se deriva de todo esto: primero los nombres, después la historia.
Por qué los datos de recepción de clientes se resisten a un flujo de copiar y pegar
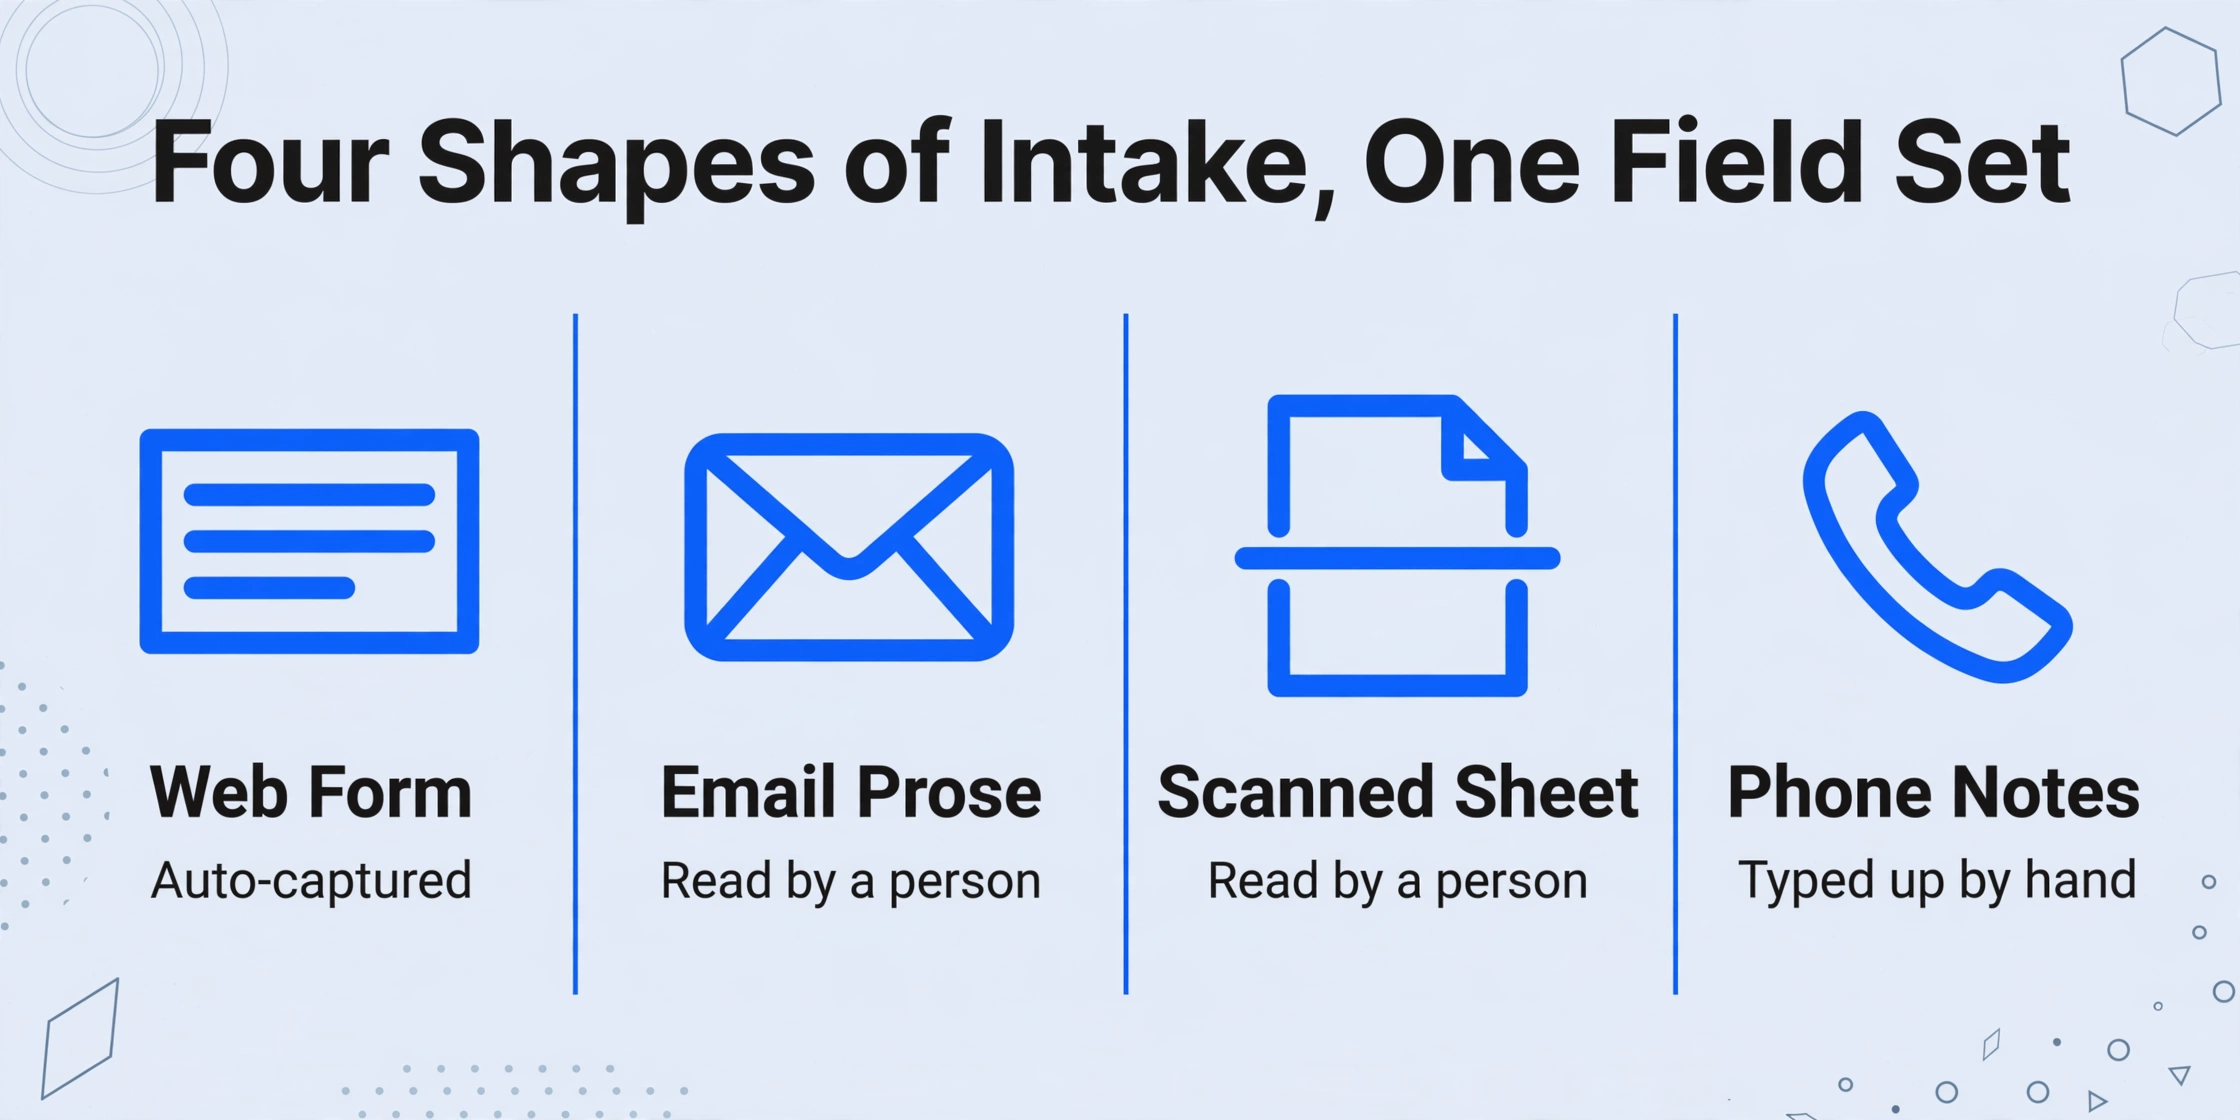
Hacer pasar los datos de recepción de clientes por una persona no es un paso de formato. Es donde los mismos campos se leen tres o cuatro veces en tres o cuatro formatos, y los errores en los nombres de los conflictos son los que nadie detecta. La fragmentación es la primera razón. El mismo conjunto de campos —nombre, parte adversa y fecha límite— llega como notificación de formulario web, como prosa en un correo, como hoja manuscrita escaneada y como notas telefónicas. Un asistente legal concilia todo en un solo registro de asunto, lo que significa que el bufete paga a una persona para que sirva como capa de integración entre canales.
La segunda razón es que la prosa de los correos casi nunca etiqueta los campos de forma ordenada. Un cliente escribe: "el otro conductor, un hombre llamado R. Alvarez, se pasó el semáforo en rojo". Reconocer esa línea como una parte adversa y capturar "R. Alvarez" como un nombre buscable es una tarea de lectura, y es exactamente la tarea en la que un reingreso apresurado omite la inicial del segundo nombre o registra el nombre en el contacto del propio cliente en lugar de como un sujeto de conflicto separado.
The third reason is the split between the two channels. Native intake forms cover the form path well, and that is a real solution for the clients who use them. The email path is the one that stays manual, because nothing in a standard practice management setup reads an inbound email and turns it into fields. Firms describe the result in their own words. In an hilo de r/legaltech sobre la recepción manual de clientes, one firm wrote it out step by step: "A lead sends us an email. Then, we enter their information into Clio or MyCase by hand. Next, we check for conflicts manually." Another, in an discusión de r/LawFirm sobre la automatización de formularios de recepción, described the data arriving "as a msg instead of stored in a .csv format," with assistants typing names, adverse parties, addresses, and dates of birth into forms by hand.
The data was already typed once, by the client. The firm is paying to type it a second time, and the second typing is the one that can be wrong.
This is the point where intake and the rest of legal document work diverge. Intake is a small number of fields that must be correct before the firm commits to anything, and the documents carrying them arrive in every format a client owns. The extraction step that comes after a matter is open is a related but separate problem, which is why it belongs with the questions in our guide to extracción de documentos para bufetes pequeños rather than here.
La solución: leer el correo de recepción y extraer los campos
The step that removes the retyping is extraction aimed at the intake channel itself, not another form for clients to fill in. It uses two capabilities together, and both are worth understanding concretely.
The first is Email Inbox, a dedicated address attached to your account. You can forward a client's intake email to it, or share the address with the paralegal who takes the calls, and the attachments land in your processing queue without anyone opening an upload page. Turn on auto-process with a template bound to it and processing starts the moment mail arrives. A sender whitelist limits the inbox to the addresses you trust, so unrelated mail never enters the queue, and if a client sends a password-protected PDF, saved passwords are tried against it automatically.
The setting that matters most for intake is what the inbox reads. By default it processes attachments only and ignores the email body, which is the right choice for invoices and statements. Intake is the exception. The field data frequently lives in the body of the email with no attachment at all, because the client simply types "here are my details" and sends it. For that case you switch the mode to body only, or to attachments and body together, and the intake prose becomes the source document.
The second capability is Custom Column Extraction. Instead of drawing boxes on a fixed layout, you type the column names you want and a vision model reads each document or email to find the matching value by meaning. On an intake file, a column named "Adverse Party" is found whether the email says "the other driver," the form prints "Defendant," or a scanned sheet writes "opposing party." Because the AI reads the meaning rather than a saved position, the same column list works across a forwarded form, a photographed handwritten intake sheet, and plain email text.
A column list that covers the five field groups looks like this:
| Columna de recepción de clientes | Qué captura |
|---|---|
| Nombre legal completo del cliente | Nombre legal tal como debe aparecer en el asunto |
| Otros nombres utilizados | Alias, apellidos de soltera, nombres comerciales (DBA), nombres anteriores para la verificación de conflictos de interés |
| Teléfono / Correo electrónico / Dirección postal | Datos de contacto y preferencias de comunicación |
| Fecha de nacimiento | Confirmación de identidad; separador común para nombres duplicados |
| Tipo de asunto | Área de práctica o categoría del asunto para el direccionamiento |
| Parte adversa | Toda parte contraria mencionada en la recepción de clientes |
| Otras partes involucradas | Testigos, copropietarios, aseguradoras, prestamistas, entidades relacionadas, cónyuges |
| Abogado anterior o actual | Otros bufetes ya consultados sobre el asunto |
| Fuente de referencia | Cómo encontró el cliente al bufete |
| Fecha límite clave | Plazo de prescripción o fecha judicial indicada en la recepción de clientes |
| Estructura de honorarios / Monto del anticipo | Términos del encargo discutidos en la recepción de clientes |
Dado que la herramienta prioriza el lote, una semana de recepciones de clientes llega como una sola hoja de cálculo con una fila por cliente potencial, en lugar de como una carpeta de archivos. Usted revisa esa hoja, y los campos que tienen peso legal, las partes adversas y otras partes involucradas, son los que verifica primero, usando Bbox verification para saltar desde cualquier celda al lugar exacto donde el valor provino en el correo original o el escaneo.
Los archivos se procesan de forma segura y no se almacenan.
Lo que esto no hace y lo que sigue siendo manual
El límite honesto es que esto produce una hoja de cálculo, no un registro de Clio. ImageToTable.ai lee documentos de recepción de clientes y correos electrónicos y exporta Excel, CSV o JSON. No escribe en Clio ni en MyCase a través de una integración nativa. Los campos confirmados se ingresan en los campos personalizados de Clio o en las notas del caso de MyCase por una persona, o se pegan desde la hoja. Si lo que desea es un envío de formulario que cree un asunto a través de una API sin que nadie lo toque, esa es una categoría diferente de herramienta, y la recomendación honesta es compararla por sus propios méritos en lugar de asumir que esta página lo hace.
El segundo límite es el que más le importa a un abogado. La extracción no ejecuta la verificación de conflictos de interés. Coloca los nombres de las partes adversas y las partes involucradas en columnas para que los nombres existan en un formato que pueda buscar, lo cual es la condición previa para la verificación según la Regla 1.7. Comparar esos nombres con sus registros de clientes actuales y anteriores, y decidir qué significa una coincidencia, sigue siendo su sistema y su criterio. Lo mismo se aplica a los conflictos con clientes anteriores según la Regla Modelo 1.9, que los nombres extraídos ayudan a detectar pero no pueden resolver.
Tercero, la extracción no decide si aceptar el asunto, redactar la carta de encargo ni evaluar la credibilidad del cliente. Esas son decisiones legales, y la hoja extraída es un insumo para ellas, no un sustituto.
Una hoja de cálculo de recepción de clientes no es un dato neutral. Según la Regla 1.18(b), la información que comparte un cliente potencial está protegida incluso si el bufete nunca acepta el caso, por lo que la hoja pertenece dentro de su manejo de confidencialidad, no en una unidad no administrada.
Finalmente, los mismos límites que se aplican a cualquier documento escaneado se aplican aquí. Los formularios de recepción de clientes mecanografiados y claros y el texto de los correos electrónicos se extraen limpiamente. La letra manuscrita tenue, una hoja fotografiada con reflejos o un formulario abarrotado con campos superpuestos se degradan, y esos son los valores que debe revisar en lugar de confiar. Un nivel de procesamiento superior maneja letra manuscrita más densa y escaneos más desordenados, y el nivel se establece por lote, por lo que la recepción de clientes difícil puede procesarse en un nivel superior mientras que las recepciones de clientes por correo electrónico limpias se mantienen económicas. Para los bufetes que también realizan revisión de contratos junto con la recepción de clientes, el enfoque campo por campo es el mismo que se establece en nuestra guía de extracción de contratos para abogados independientes, y la pregunta de revisión más amplia se cubre en la comparación de software de revisión de documentos y extracción con IA para bufetes pequeños.
Un flujo de trabajo que puede configurar en una tarde
Cinco ajustes y una lista de columnas convierten una semana de correos de recepción de clientes en una hoja de cálculo revisable. Cada paso corresponde a un control específico, no a una promesa general.
Defina las columnas de recepción de clientes una sola vez
Use la lista de campos anterior: Client Full Legal Name, Other Names Used, Phone, Email, Mailing Address, Date of Birth, Matter Type, Adverse Party, Other Involved Parties, Prior or Current Counsel, Referral Source, Key Deadline, Fee Structure. Los nombres de columna que ingrese se convierten en los encabezados de la hoja de salida, así que decídalos una vez para cada canal de recepción de clientes en lugar de reconstruir un formato por cliente.
Dirija los canales de recepción de clientes a la dirección del Email Inbox
Comparta la dirección con quien reenvía la recepción de clientes, o reenvíe usted mismo los correos de los clientes. Active la lista blanca de remitentes para que solo los canales conocidos lleguen a la cola, y guarde las contraseñas comunes de archivos adjuntos en la configuración.
Configure lo que lee la bandeja de entrada y vincule la plantilla
Como los campos de recepción de clientes suelen estar en el cuerpo del mensaje, configure el modo de procesamiento en cuerpo y archivos adjuntos, o solo cuerpo si los clientes nunca adjuntan nada. Vincule la plantilla de columnas de recepción de clientes a la bandeja de entrada y luego active el procesamiento automático para que el correo se gestione al llegar.
Revise primero los campos de nombres para verificación de conflictos
Abra la hoja del lote y revise Adverse Party, Other Involved Parties y Prior or Current Counsel antes que cualquier otra cosa. Pase el cursor sobre una celda sospechosa para ver exactamente de dónde proviene el valor en el correo o escaneo original, corríjalo si es necesario y revierta al valor de IA si el original era correcto.
Exporte, ingrese en Clio o MyCase y luego ejecute la verificación
Exporte a Excel o CSV, pegue o ingrese los campos confirmados en los campos personalizados de Clio o en las notas del caso de MyCase, y ejecute la verificación de conflictos de interés contra su lista de clientes actuales y anteriores. La extracción reemplazó el reingreso; la búsqueda y la decisión siguen siendo suyas.
Si su recepción de clientes ya es totalmente en línea y pocos clientes le escriben por correo, los formularios nativos de recepción cubren la mayor parte y el valor aquí es menor. Este flujo de trabajo vale la pena cuando una parte real de la recepción de clientes llega como correo, escaneos reenviados y hojas manuscritas, porque esa parte es la que ninguna herramienta de formularios alcanza. Cuando esos documentos de recepción alimentan más adelante un trabajo documental más amplio, la guía completa de extracción de contratos y la guía de extracción de documentos de descubrimiento de pruebas continúan con la siguiente etapa.
Preguntas frecuentes
¿Se conecta directamente con Clio o MyCase?
No, y vale la pena ser claros al respecto. La herramienta lee los correos y documentos de recepción de clientes y exporta Excel, CSV o JSON. Luego, una persona ingresa o pega los campos confirmados en los campos personalizados de Clio o en las notas del caso de MyCase. Elimina el reingreso de la recepción de clientes; no crea el registro del asunto mediante una API nativa. Los bufetes que necesitan que un formulario abra un asunto automáticamente están buscando una categoría diferente de producto de integración.
¿Ejecutará nuestra verificación de conflictos de interés por nosotros?
No. Extrae los nombres de la parte adversa, las partes involucradas y el abogado anterior o actual en columnas para que puedan buscarse, que es lo que la Regla 1.7 exige que un bufete pueda hacer. La búsqueda en sí se ejecuta contra sus registros de clientes y clientes anteriores, en su sistema, y lo que significa una coincidencia es su criterio según las Reglas 1.7 y 1.9.
Los datos de recepción de clientes están en el cuerpo del correo, sin archivo adjunto. ¿Eso funciona?
Sí. El valor predeterminado de Email Inbox es solo archivos adjuntos, que ignora el cuerpo, pero puede cambiarlo a solo el cuerpo o a archivos adjuntos y cuerpo juntos. Para un cliente que escribe sus datos directamente en el correo, ese modo es el que convierte el mensaje en el documento fuente.
¿Qué pasa si el cliente envía un formulario de recepción de clientes fotografiado o escrito a mano?
Un modelo de visión lo lee directamente de la imagen, por lo que una foto clara de un formulario impreso funciona bien. La escritura a mano se extrae mejor en un nivel de procesamiento superior, y la letra cursiva densa o el lápiz tenue deben tratarse como un elemento de revisión. Los campos que más vale la pena revisar manualmente son siempre los mismos: las partes adversas y cualquier nombre que impulse la búsqueda de conflictos.
¿Es seguro procesar los datos de recepción de clientes potenciales de esta manera?
Los archivos se procesan en tránsito y no se almacenan, ni se utilizan para el entrenamiento del modelo. La cuestión de la confidencialidad es más amplia que la herramienta. Según la Regla Modelo 1.18(b), la información que comparte un cliente potencial está protegida incluso cuando no se formaliza un encargo, por lo que la hoja de recepción de clientes extraída debe gestionarse conforme a la política de confidencialidad y retención de datos de su bufete, y los bufetes con restricciones impuestas por el cliente o por el colegio de abogados deben confirmar primero el modelo de procesamiento con esos requisitos.
¿Maneja la recepción de clientes en idiomas distintos del inglés?
Sí. El modelo de visión lee varios idiomas y mantiene el texto del campo en el idioma en que aparece, lo cual es importante para los bufetes cuyos clientes escriben correos de recepción de clientes en español, francés, alemán, portugués, japonés o coreano. Se admite la recepción de clientes en varios idiomas, aunque un valor que se encuentre justo donde un documento cambia de idioma merece una segunda revisión.
El modelo mental útil es que la recepción de clientes es un problema de captura de datos antes que un problema legal. El cliente ya ha respondido las preguntas; el bufete simplemente paga dos veces, una con el tiempo del cliente y otra con el del asistente legal, y es en la segunda pasada donde los nombres de conflictos pueden fallar. Convertir el correo de recepción de clientes y el formulario reenviado en una hoja estructurada elimina la segunda pasada sin tocar la parte que requiere un abogado.
Envíese un correo de recepción de cliente de muestra y vea lo que devuelve. Procese una recepción de cliente y revise la columna de parte adversa usted mismo.