Extração de Dados de Recepção de Clientes
Sem o Ciclo de Redigitação
Um cliente em potencial digita nome, endereço, o nome da outra parte e uma breve descrição da disputa no seu formulário de recepção ou e-mail. Um paralegal então digita os mesmos detalhes no Clio. Nada se perdeu na primeira etapa. Os dados chegaram estruturados, em um campo de formulário ou em uma conversa de e-mail, e a segunda etapa é pura reentrada. Essa reentrada é a parte da recepção de clientes que nunca chega a uma fatura, e também é a etapa que decide se a sua verificação de conflitos de interesse acontece antes da consulta ou depois dela.
Principais Conclusões
- 2,5 horas faturáveis por dia é o teto médio de um advogado, e 48% do tempo não faturável ao redor disso vai para trabalho administrativo, como redigitar a recepção de clientes.
- O cliente já digitou esses detalhes uma vez, então o escritório paga uma segunda pessoa para redigitar os mesmos nomes, e é nessa segunda etapa que os nomes de conflito saem errados.
- Ler o e-mail de recepção e o formulário encaminhado em uma única planilha elimina essa segunda etapa, e a coluna de parte adversa se torna a primeira coisa que você verifica.
A recepção de clientes quebra na transferência, não no formulário
O problema de recepção de clientes em um escritório pequeno quase nunca é a ferramenta que coleta os dados. É a transferência que vem depois. O Clio Grow e o MyCase ambos capturam um envio de formulário online e criam o contato e o caso a partir dele, e esse caminho funciona. A dificuldade é que apenas parte da sua recepção chega dessa forma. Pense em como um novo caso realmente chega até você: um formulário web em um caso, um e-mail em que o cliente descreve a disputa no corpo, uma ficha de recepção escaneada ou fotografada anexada a uma resposta, uma ligação que um paralegal registra como notas. Cada uma é um formato diferente, e nenhuma delas chega ao seu sistema de gestão de prática por conta própria.
A escala dessa transferência está documentada nos números que os escritórios já relatam. O Relatório de Tendências Legais 2025 da Clio coloca o advogado médio em 2,5 horas faturáveis por dia, uma taxa de utilização de 37 por cento. Seu estudo anterior descobriu que 48 por cento do tempo não faturável de um advogado vai para trabalho administrativo como administração do escritório, faturamento e cobranças. A redigitação na recepção está dentro dessa fatia, e compete diretamente com as horas que você pode faturar.
Há um segundo custo que é mais fácil de ignorar. Uma verificação de conflitos de interesse é tão rápida quanto os nomes que ela pode pesquisar, e esses nomes precisam estar em uma forma utilizável, em nível de nome, antes que alguém possa compará-los com sua lista de clientes e ex-clientes. Quando o nome da parte adversa está em um PDF e na memória de um paralegal, a verificação espera. Essa é a parte da recepção em que a redigitação deixa de ser um incômodo e começa a ser um risco.
O que uma Recepção de Clientes Realmente Deve Produzir
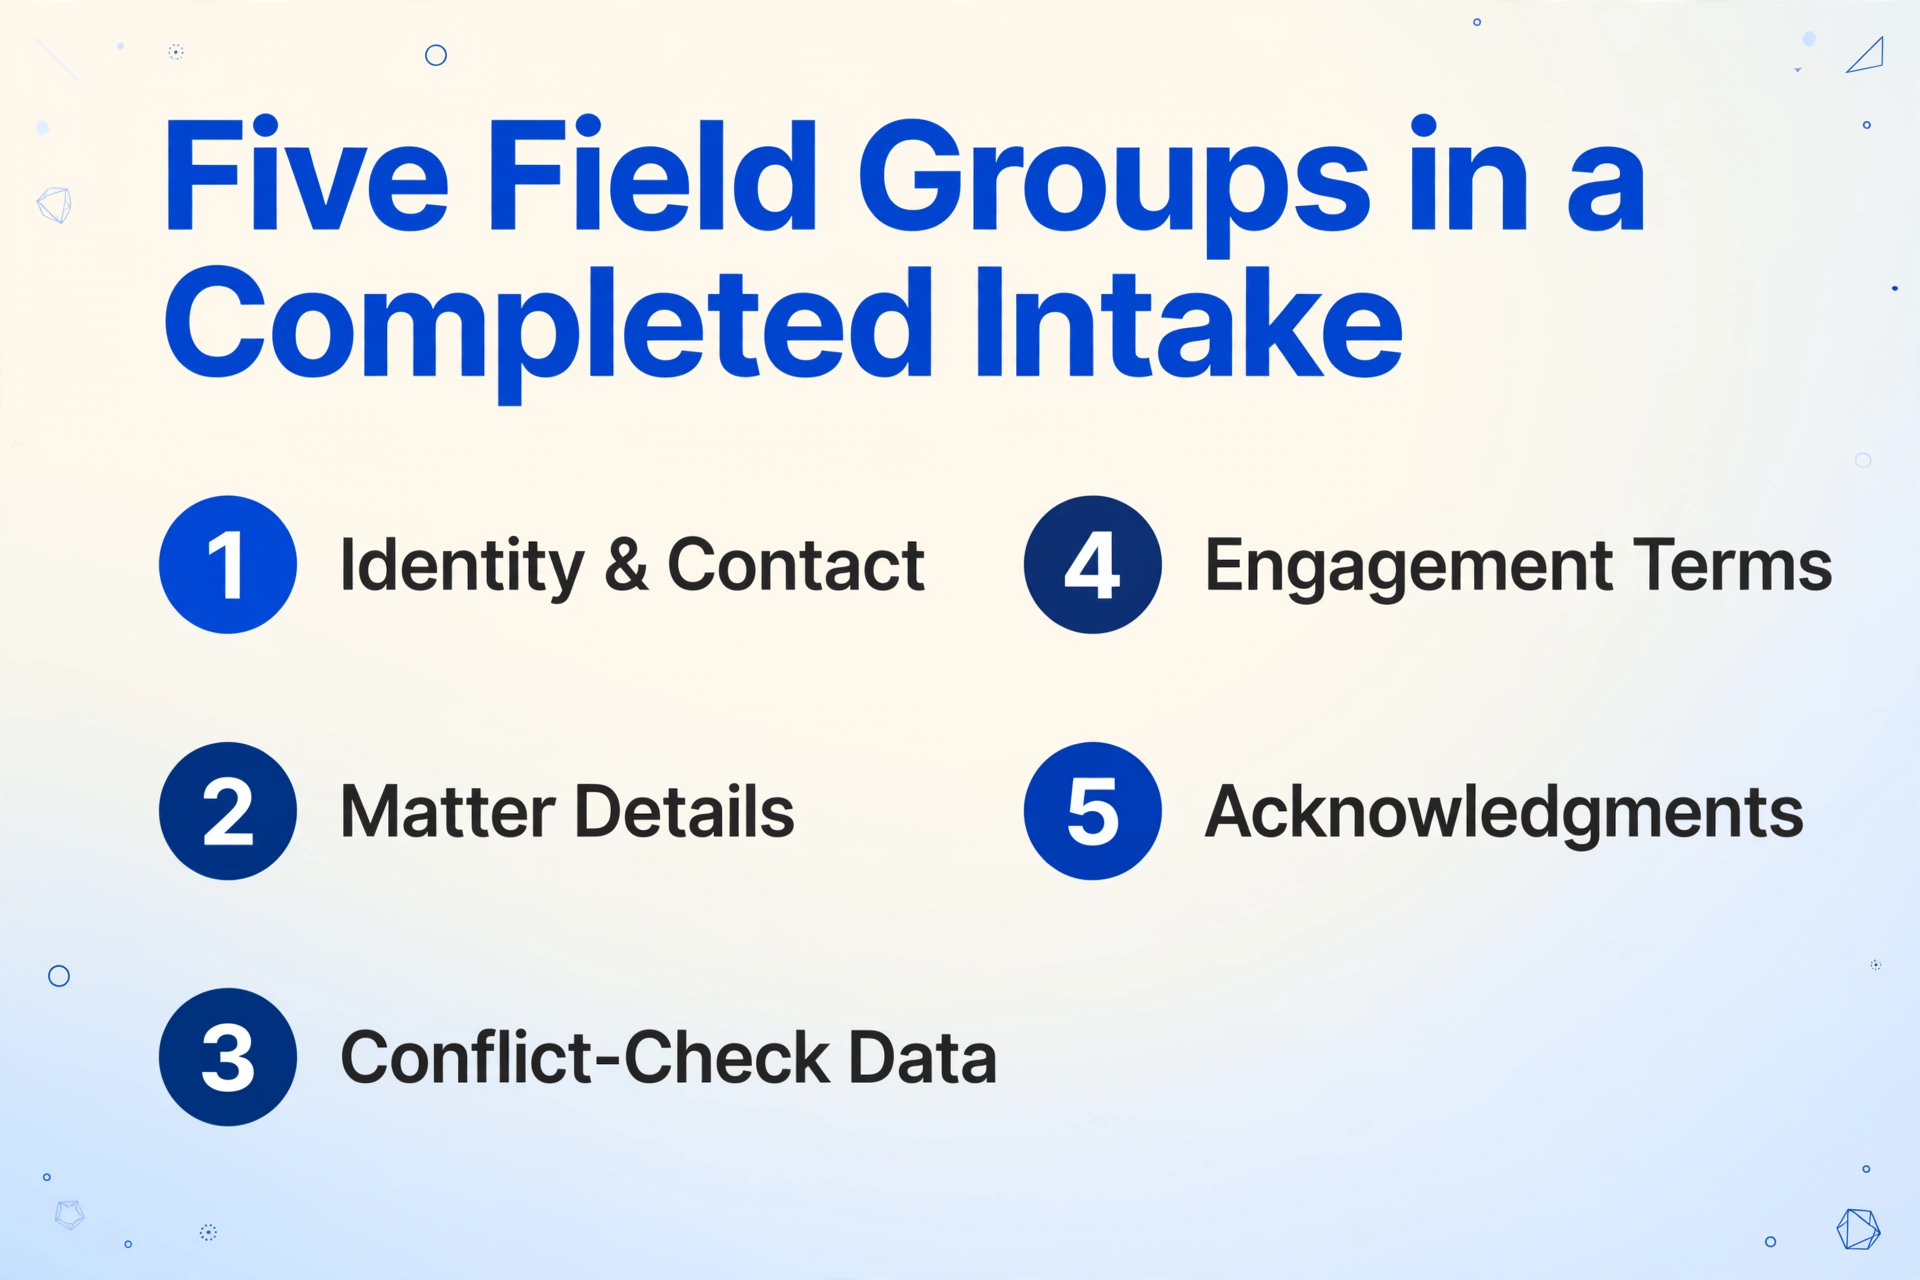
Uma recepção de clientes completa não é um único registro. São cinco grupos de campos, e dois deles existem apenas para manter o escritório fora de um conflito. O primeiro grupo é identidade e contato: o nome legal completo do cliente e quaisquer outros nomes usados, endereço postal, telefone, e-mail, data de nascimento e fonte de indicação. O segundo é o caso em si: área de prática ou tipo de caso, uma breve descrição da disputa e as datas que importam, incluindo qualquer prazo prescricional ou prazo judicial.
O terceiro grupo é a razão pela qual a recepção de clientes é regulamentada em vez de apenas gerenciada. Os dados de verificação de conflitos têm que incluir toda parte adversa, todas as outras partes envolvidas e os nomes relacionados que tornam uma busca confiable. A orientação da ABA para novos advogados sobre o processo de recepção de clientes e verificação de conflitos é específica sobre isso: para uma entidade, você quer o nome legal completo, alias, estado de incorporação e sede; para um caso adversarial, você quer a parte oponente, o advogado oponente, o foro e o objeto do caso. O guía prático de verificação de conflitos da divisão GPSolo da ABA lista o que o banco de dados de conflitos do próprio escritório tem que conter: clientes atuais, ex-clientes, pessoas adversas, clientes em potencial, uma breve descrição de cada caso, as datas de início e término de cada um, afiliados e os diretores, executivos e principais acionistas dos clientes.
O quarto grupo são os termos de engajamento: estrutura de honorários, valor do adiantamento e o escopo da representação. O quinto são os reconhecimentos, principalmente o aviso de não representação que evita que um formulário preenchido seja confundido com uma relação advogado-cliente.
Os nomes para verificação de conflitos são os campos com a vida útil mais curta. Uma data errada pode ser corrigida depois. Um parte adversa mal escrita ou ausente é o que faz o escritório aceitar um caso que deveria ter recusado.
Esse peso está escrito nas regras, não apenas nas boas práticas. O Comentário [3] da Model Rule 1.7 diz que o advogado deve adotar procedimentos razoáveis, adequados ao tamanho e ao tipo do escritório, para identificar as pessoas e as questões envolvidas, e acrescenta que a ignorância causada pela falha em instituir esses procedimentos não desculpa uma violação. A Model Rule 1.18 estende a proteção ao cliente em potencial que nunca chega a ser contratado, e a Formal Opinion 510 (março de 2024) da ABA refina o que significam "medidas razoáveis" quando um escritório quer evitar que o conflito seja atribuído a todos os advogados dele. A ordem prática decorre de tudo isso: primeiro os nomes, depois a história.
Por que os Dados de Recepção de Clientes Resistem a um Fluxo de Copiar e Colar
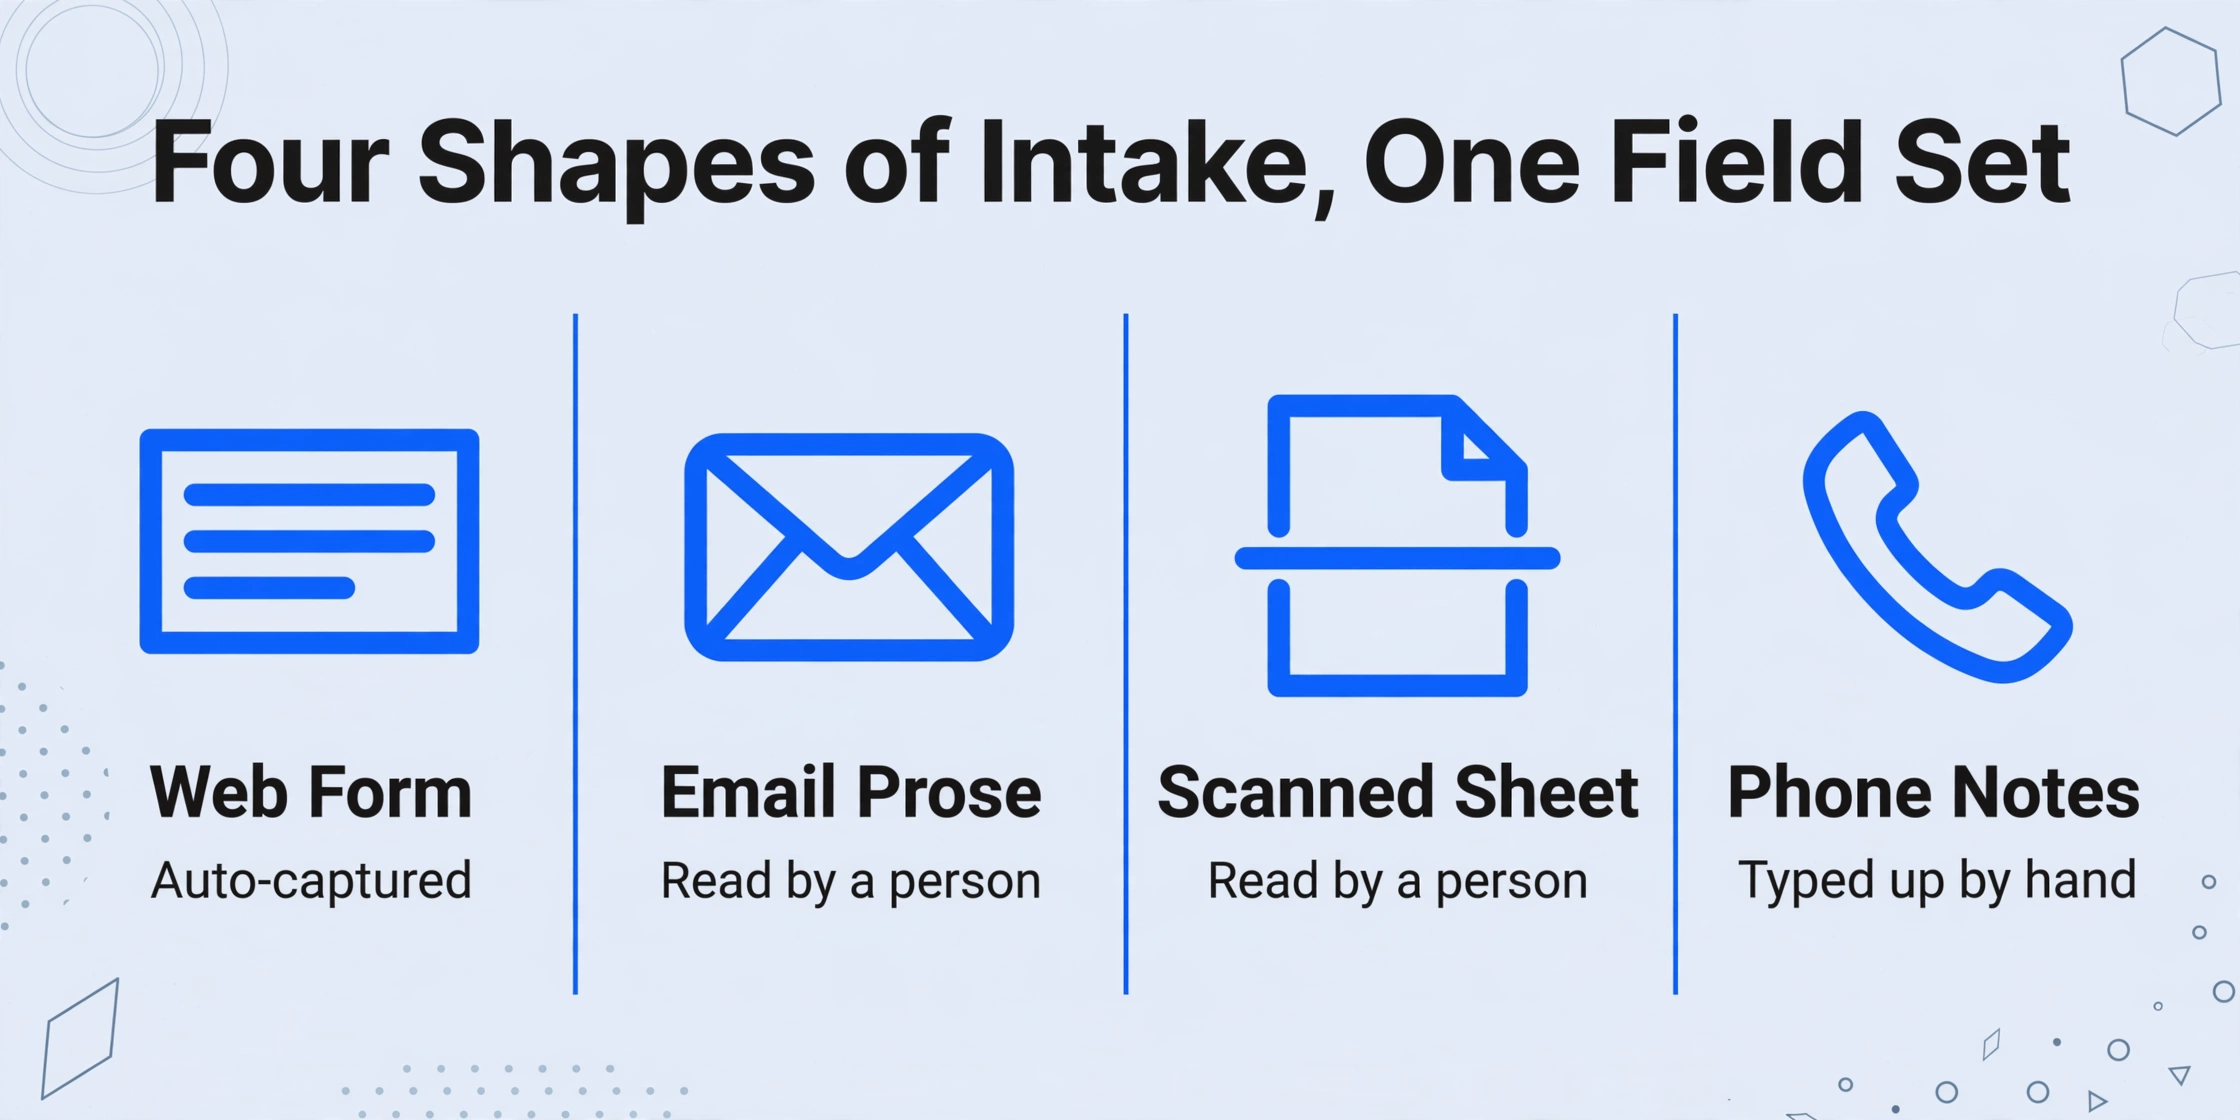
Enviar os dados de recepção de clientes por uma pessoa não é uma etapa de formatação. É onde os mesmos campos são lidos três ou quatro vezes em três ou quatro formatos, e os erros nos nomes de conflito são os que ninguém percebe. A fragmentação é o primeiro motivo. O mesmo conjunto de campos — nome, parte adversa e prazo — chega como notificação de formulário web, como texto de e-mail, como ficha manuscrita digitalizada e como anotações telefônicas. Um paralegal concilia tudo isso em um único registro de caso, o que significa que o escritório está pagando para um humano servir como a camada de integração entre os canais.
O segundo motivo é que o texto de e-mail quase nunca rotula os campos de forma organizada. Um cliente escreve: "o outro motorista, um homem chamado R. Alvarez, furou o sinal." Reconhecer essa frase como uma parte adversa e capturar "R. Alvarez" como um nome pesquisável é uma tarefa de leitura, e é exatamente a tarefa em que uma redigitação apressada elimina a inicial do meio ou registra o nome no contato do próprio cliente em vez de em um assunto de conflito separado.
The third reason is the split between the two channels. Native intake forms cover the form path well, and that is a real solution for the clients who use them. The email path is the one that stays manual, because nothing in a standard practice management setup reads an inbound email and turns it into fields. Firms describe the result in their own words. In an r/legaltech thread on manual client intake, one firm wrote it out step by step: "A lead sends us an email. Then, we enter their information into Clio or MyCase by hand. Next, we check for conflicts manually." Another, in an r/LawFirm discussion of intake form automation, described the data arriving "as a msg instead of stored in a .csv format," with assistants typing names, adverse parties, addresses, and dates of birth into forms by hand.
The data was already typed once, by the client. The firm is paying to type it a second time, and the second typing is the one that can be wrong.
This is the point where intake and the rest of legal document work diverge. Intake is a small number of fields that must be correct before the firm commits to anything, and the documents carrying them arrive in every format a client owns. The extraction step that comes after a matter is open is a related but separate problem, which is why it belongs with the questions in our guide to small law firm document extraction rather than here.
The Fix: Read the Intake Email, Extract the Fields
The step that removes the retyping is extraction aimed at the intake channel itself, not another form for clients to fill in. It uses two capabilities together, and both are worth understanding concretely.
The first is Email Inbox, a dedicated address attached to your account. You can forward a client's intake email to it, or share the address with the paralegal who takes the calls, and the attachments land in your processing queue without anyone opening an upload page. Turn on auto-process with a template bound to it and processing starts the moment mail arrives. A sender whitelist limits the inbox to the addresses you trust, so unrelated mail never enters the queue, and if a client sends a password-protected PDF, saved passwords are tried against it automatically.
The setting that matters most for intake is what the inbox reads. By default it processes attachments only and ignores the email body, which is the right choice for invoices and statements. Intake is the exception. The field data frequently lives in the body of the email with no attachment at all, because the client simply types "here are my details" and sends it. For that case you switch the mode to body only, or to attachments and body together, and the intake prose becomes the source document.
The second capability is Custom Column Extraction. Instead of drawing boxes on a fixed layout, you type the column names you want and a vision model reads each document or email to find the matching value by meaning. On an intake file, a column named "Adverse Party" is found whether the email says "the other driver," the form prints "Defendant," or a scanned sheet writes "opposing party." Because the AI reads the meaning rather than a saved position, the same column list works across a forwarded form, a photographed handwritten intake sheet, and plain email text.
A column list that covers the five field groups looks like this:
| Coluna de recepção de clientes | O que ela captura |
|---|---|
| Nome legal completo do cliente | Nome legal como deve aparecer no caso |
| Outros nomes usados | Apelidos, nomes de solteira, DBAs, nomes anteriores para a verificação de conflitos |
| Telefone / E-mail / Endereço postal | Dados de contato e preferências de comunicação |
| Data de nascimento | Confirmação de identidade; separador comum para nomes duplicados |
| Tipo de caso | Área de atuação ou categoria do caso para encaminhamento |
| Parte adversa | Toda parte contrária mencionada na recepção de clientes |
| Outras partes envolvidas | Testemunhas, coproprietários, seguradoras, credores, entidades relacionadas, cônjuges |
| Advogado anterior ou atual | Outros escritórios já consultados sobre o caso |
| Fonte de indicação | Como o cliente encontrou o escritório |
| Prazo-chave | Prazo prescricional ou data judicial informada na recepção de clientes |
| Estrutura de honorários / Valor do adiantamento | Termos de engajamento discutidos na recepção de clientes |
Como a ferramenta é primeiro o lote, uma semana de recepção de clientes chega como uma única planilha com uma linha por cliente em potencial, em vez de uma pasta de arquivos. Você revisa essa planilha, e os campos que têm peso legal, as partes adversas e outras partes envolvidas, são os que você verifica primeiro, usando Bbox verification para saltar de qualquer célula de volta ao local exato de onde o valor veio no e-mail ou na digitalização original.
Os arquivos são processados com segurança e não são armazenados.
O que isto não faz, e o que permanece manual
O limite honesto é que isto produz uma planilha, não um registro no Clio. O ImageToTable.ai lê documentos de recepção de clientes e e-mails e exporta Excel, CSV ou JSON. Ele não grava no Clio ou no MyCase por meio de uma integração nativa. Os campos confirmados são inseridos nos campos personalizados do Clio ou nas notas do caso do MyCase por uma pessoa, ou colados da planilha. Se o que você quer é um envio de formulário que crie um caso por meio de uma API sem que ninguém toque nele, essa é uma categoria diferente de ferramenta, e a recomendação honesta é compará-la em seus próprios termos, em vez de presumir que esta página faz isso.
O segundo limite é o que mais importa para um advogado. A extração não executa a verificação de conflitos de interesse. Ela coloca os nomes das partes adversas e das partes envolvidas em colunas para que os nomes existam em um formato que você possa pesquisar, o que é a pré-condição para a verificação sob a Regra 1.7. Comparar esses nomes com seus registros de clientes atuais e ex-clientes, e decidir o que uma correspondência significa, continua sendo do seu sistema e do seu julgamento. O mesmo se aplica aos conflitos com ex-clientes sob a Model Rule 1.9, que os nomes extraídos ajudam a revelar, mas não podem resolver.
Terceiro, a extração não decide se deve aceitar o caso, redigir a carta de contratação ou avaliar a credibilidade do cliente. Essas são decisões legais, e a planilha extraída é um insumo para elas, não um substituto.
Uma planilha de recepção de clientes não é um dado neutro. Sob a Regra 1.18(b), as informações que um cliente em potencial compartilha são protegidas mesmo que o escritório nunca aceite o caso, então a planilha pertence ao seu tratamento de confidencialidade, não a um drive não gerenciado.
Por fim, os mesmos limites que se aplicam a qualquer documento digitalizado se aplicam aqui. Formulários de recepção de clientes datilografados claros e texto de e-mail são extraídos com precisão. Letra cursiva fraca, uma folha fotografada com reflexo ou um formulário apertado com campos sobrepostos degradam a qualidade, e esses são os valores a revisar em vez de confiar. Um nível de processamento superior lida com letras mais densas e digitalizações mais bagunçadas, e o nível é definido por lote, então a recepção de clientes difícil pode ser processada em um nível superior enquanto as recepções por e-mail limpas permanecem econômicas. Para práticas que também fazem revisão de contratos junto com a recepção de clientes, a abordagem campo a campo é a mesma descrita em nosso guia de extração de contratos para advogados autônomos, e a questão da revisão mais ampla é abordada na comparação de software de revisão de documentos e extração por IA para pequenos escritórios.
Um Fluxo de Trabalho que Você Configura em uma Tarde
Cinco configurações e uma lista de colunas transformam uma semana de e-mails de recepção de clientes em uma planilha revisável. Cada etapa corresponde a um controle específico, e não a uma promessa genérica.
Defina as colunas de recepção de clientes uma única vez
Use a lista de campos acima: Client Full Legal Name, Other Names Used, Phone, Email, Mailing Address, Date of Birth, Matter Type, Adverse Party, Other Involved Parties, Prior or Current Counsel, Referral Source, Key Deadline, Fee Structure. Os nomes das colunas que você inserir se tornam os cabeçalhos da planilha de saída, então defina-os uma vez para cada canal de recepção de clientes, em vez de reconstruir um formato para cada cliente.
Aponte os canais de recepção de clientes para o endereço do Email Inbox
Compartilhe o endereço com quem encaminha a recepção de clientes, ou encaminhe você mesmo os e-mails dos clientes. Ative a lista branca de remetentes para que apenas canais conhecidos cheguem à fila e salve as senhas comuns de anexos nas configurações.
Defina o que a caixa de entrada lê e vincule o modelo
Como os campos de recepção de clientes costumam estar no corpo da mensagem, defina o modo de processamento para corpo e anexos, ou apenas corpo, se os clientes nunca anexam nada. Vincule o modelo de colunas de recepção de clientes à caixa de entrada e ative o processamento automático para que os e-mails sejam tratados na chegada.
Revise primeiro os campos de nomes para verificação de conflitos
Abra a planilha do lote e verifique Adverse Party, Other Involved Parties e Prior or Current Counsel antes de qualquer outra coisa. Passe o mouse sobre uma célula suspeita para ver exatamente de onde veio o valor no e-mail ou na digitalização original, corrija se necessário e reverta para o valor da IA se o original estivesse certo.
Exporte, insira no Clio ou MyCase e execute a verificação
Exporte para Excel ou CSV, cole ou insira os campos confirmados nos campos personalizados do Clio ou nas notas do caso do MyCase e execute a verificação de conflitos de interesse em relação à sua lista de clientes e ex-clientes. A extração substituiu a digitação; a busca e a decisão continuam sendo suas.
Se a sua recepção de clientes já é totalmente online e poucos clientes enviam e-mails, os formulários nativos de recepção de clientes cobrem a maior parte do processo, e o valor aqui é menor. O fluxo de trabalho se justifica quando uma parcela real da recepção de clientes chega por e-mail, digitalizações encaminhadas e planilhas manuscritas, porque essa parcela é a parte que nenhuma ferramenta de formulário alcança. Quando esses documentos de recepção de clientes alimentam depois um trabalho documental mais amplo, o guia completo para extração de contratos e o guia para extração de documentos de descoberta de provas assumem a próxima etapa.
FAQ
Isso se conecta diretamente ao Clio ou ao MyCase?
Não, e vale a pena deixar isso claro. A ferramenta lê e-mails de recepção de clientes e documentos e exporta Excel, CSV ou JSON. Uma pessoa então insere ou cola os campos confirmados nos campos personalizados do Clio ou nas notas do caso no MyCase. Isso elimina a redigitação na recepção de clientes; não cria o registro do caso por meio de uma API nativa. Escritórios que precisam que um envio de formulário abra um caso automaticamente estão procurando uma categoria diferente de produto de integração.
Ele fará nossa verificação de conflitos de interesse?
Não. Ele extrai os nomes da parte adversa, das partes envolvidas e do advogado anterior ou atual em colunas para que possam ser pesquisados, que é o que a Regra 1.7 exige que um escritório seja capaz de fazer. A pesquisa em si é feita nos seus registros de clientes e ex-clientes, no seu sistema, e o que uma correspondência significa é seu julgamento de acordo com as Regras 1.7 e 1.9.
Os detalhes da recepção de clientes estão no corpo do e-mail, sem anexo. Isso funciona?
Sim. O padrão do Email Inbox é apenas anexos, o que ignora o corpo, mas você pode alternar para apenas corpo ou para anexos e corpo juntos. Para um cliente que digita os detalhes diretamente no e-mail, esse modo é o que transforma a mensagem no documento de origem.
E se o cliente enviar um formulário de recepção de clientes fotografado ou manuscrito?
Ele é lido por um modelo de visão a partir da própria imagem, então uma foto nítida de um formulário impresso funciona bem. A caligrafia é extraída melhor em um nível de processamento superior, e letra cursiva densa ou lápis fraco devem ser tratados como item de revisão. Os campos que mais valem a pena verificar manualmente são sempre os mesmos: as partes adversas e qualquer nome que conduza a busca por conflitos.
Os dados de recepção de clientes em potencial são seguros para processar dessa forma?
Os arquivos são processados em trânsito e não são armazenados, nem usados para treinamento do modelo. A questão da confidencialidade é mais ampla do que a ferramenta. De acordo com a Regra 1.18(b) do Modelo, as informações compartilhadas por um cliente em potencial são protegidas mesmo quando não há contratação, portanto a ficha de recepção extraída deve ser tratada de acordo com a política de confidencialidade e retenção de dados do seu escritório, e escritórios com restrições impostas por clientes ou pela ordem dos advogados devem confirmar o modelo de processamento em relação a esses requisitos primeiro.
Isso lida com recepção de clientes em outros idiomas além do inglês?
Sim. O modelo de visão lê vários idiomas e mantém o texto do campo no idioma em que aparece, o que é importante para escritórios cujos clientes escrevem e-mails de recepção em espanhol, francês, alemão, português, japonês ou coreano. Recepção em idiomas mistos é suportada, embora um valor que esteja exatamente onde um documento muda de idioma mereça uma segunda olhada.
O modelo mental útil é que a recepção de clientes é um problema de captura de dados antes de ser um problema legal. O cliente já respondeu às perguntas; o escritório está simplesmente pagando duas vezes, uma no tempo do cliente e outra no de um paralegal, e é na segunda passagem que os nomes de conflitos podem dar errado. Transformar o e-mail de recepção e o formulário encaminhado em uma planilha estruturada elimina a segunda passagem sem tocar na parte que precisa de um advogado.
Envie a si mesmo um e-mail de recepção de cliente de exemplo e veja o que retorna. Processe uma recepção de cliente e verifique a coluna de parte adversa você mesmo.