Extraction des données d'accueil client
Sans la boucle de ressaisie
Un client potentiel saisit son nom, son adresse, le nom de la partie adverse et une brève description du litige dans votre formulaire d'accueil ou par e-mail. Un assistant juridique saisit ensuite les mêmes informations dans Clio. Rien n'a été perdu lors du premier passage. Les données sont arrivées structurées, dans un champ de formulaire ou un fil de discussion, et le second passage est une pure ressaisie. Cette ressaisie est la partie de l'accueil client qui n'atteint jamais une facture, et c'est aussi l'étape qui détermine si votre vérification des conflits d'intérêts s'effectue avant la consultation ou après.
Points clés à retenir
- 2,5 heures facturables par jour est le plafond moyen d'un avocat, et 48 % du temps non facturable qui l'entoure est consacré au travail administratif comme la ressaisie des accueils clients.
- Le client a déjà saisi ces informations une fois, donc le cabinet paie une seconde personne pour ressaisir les mêmes noms, et c'est ce second passage qui fait déraper les noms dans la vérification des conflits.
- Lire l'e-mail d'accueil et le formulaire transféré dans une seule feuille élimine ce second passage, et la colonne partie adverse devient la première chose à vérifier.
L'accueil du client se brise au transfert, pas au formulaire
Le problème d'accueil du client dans un petit cabinet n'est presque jamais l'outil qui collecte les données. C'est le transfert qui suit. Clio Grow et MyCase capturent tous deux une soumission de formulaire en ligne et créent le contact et le dossier à partir de celle-ci, et ce chemin fonctionne. La difficulté est que seule une partie de votre accueil arrive de cette façon. Pensez à la manière dont un nouveau dossier vous parvient réellement : un formulaire web pour un dossier, un e-mail où le client décrit le litige dans le corps du message, une feuille d'accueil scannée ou photographiée jointe à une réponse, un appel téléphonique qu'un assistant juridique consigne sous forme de notes. Chacun a une forme différente, et aucun n'atterrit seul dans votre logiciel de gestion de cabinet.
L'ampleur de ce transfert est documentée dans les chiffres que les cabinets déclarent déjà. Le rapport 2025 sur les tendances juridiques de Clio situe l'avocat moyen à 2,5 heures facturables par jour, soit un taux d'utilisation de 37 pour cent. Son étude précédente a constaté que 48 pour cent du temps non facturable d'un avocat est consacré à du travail administratif comme l'administration du bureau, la facturation et les recouvrements. La ressaisie des données d'accueil se trouve dans cette part et concurrence directement les heures que vous pouvez facturer.
Il y a un deuxième coût plus facile à manquer. Une vérification des conflits d'intérêts n'est aussi rapide que les noms qu'elle peut rechercher, et ces noms doivent être sous une forme exploitable, au niveau du nom, avant que quiconque puisse les comparer à votre liste de clients et d'anciens clients. Lorsque le nom de la partie adverse se trouve dans un PDF et dans la mémoire d'un assistant juridique, la vérification attend. C'est la partie de l'accueil où la ressaisie cesse d'être une contrariété et devient un risque.
Ce qu'un accueil du client doit réellement produire
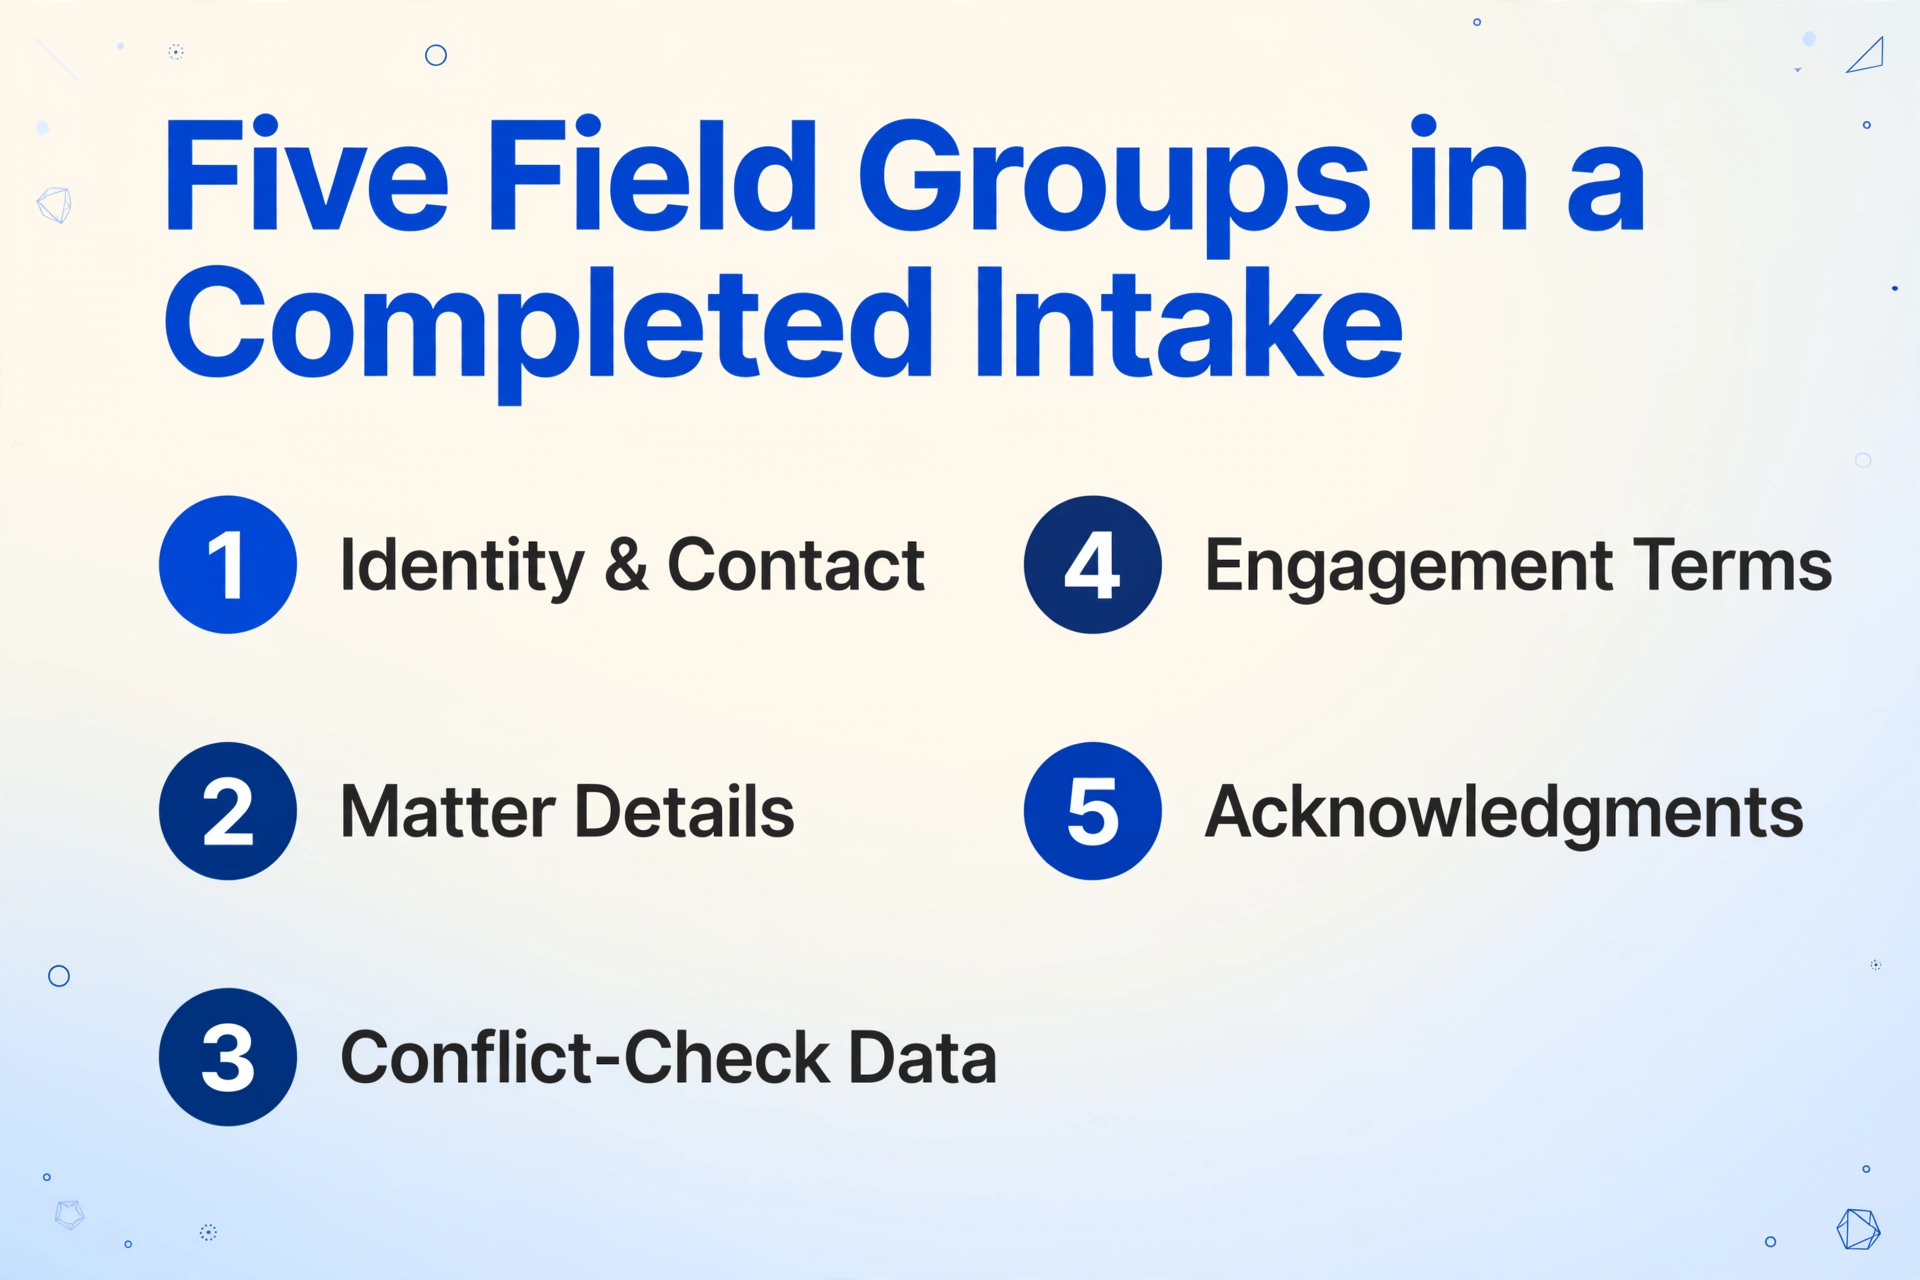
Un accueil client terminé n'est pas un simple enregistrement. C'est cinq groupes de champs, et deux d'entre eux n'existent que pour protéger le cabinet d'un conflit d'intérêts. Le premier groupe est l'identité et les coordonnées : le nom légal complet du client et tout autre nom utilisé, l'adresse postale, le téléphone, l'e-mail, la date de naissance et la source de référencement. Le deuxième concerne le dossier lui-même : le domaine de pratique ou le type de dossier, une brève description du litige et les dates importantes, y compris tout délai de prescription ou délai judiciaire.
Le troisième groupe est la raison pour laquelle l'accueil client est réglementé plutôt que simplement géré. Les données de vérification des conflits doivent inclure chaque partie adverse, toutes les autres personnes impliquées et les noms associés qui rendent une recherche fiable. Les conseils de l'ABA pour les nouveaux avocats sur le processus d'accueil client et de vérification des conflits sont précis à ce sujet : pour une entité, il faut le nom légal complet, les alias, l'État de constitution et le siège social ; pour une affaire contentieuse, il faut la partie adverse, le conseil adverse, le tribunal et l'objet du litige. Le guide pratique sur les conflits d'intérêts de la division GPSolo de l'ABA énumère ce que la base de données de conflits du cabinet doit contenir : les clients actuels, les anciens clients, les personnes adverses, les clients potentiels, une brève description de chaque dossier, les dates de début et de fin, les sociétés affiliées, ainsi que les dirigeants, administrateurs et principaux actionnaires des clients.
Le quatrième groupe concerne les conditions d'engagement : la structure d'honoraires, le montant de la provision et l'étendue de la représentation. Le cinquième concerne les accusés de réception, principalement l'avertissement de non-engagement qui évite qu'un formulaire rempli soit confondu avec une relation avocat-client.
Les noms pour la vérification des conflits sont les champs dont la durée de vie utile est la plus courte. Une date erronée peut être corrigée plus tard. Une partie adverse mal orthographiée ou manquante est celle qui permet au cabinet d'accepter un dossier qu'il aurait dû refuser.
Ce poids est inscrit dans les règles, et pas seulement dans les bonnes pratiques. Le commentaire [3] de la Model Rule 1.7 précise qu'un avocat doit adopter des procédures raisonnables, adaptées à la taille et au type de cabinet, pour déterminer les personnes et les questions impliquées, et il ajoute que l'ignorance due à l'absence de ces procédures n'excuse pas une violation. La Model Rule 1.18 étend la protection au client potentiel qui n'est jamais retenu, et l'avis officiel 510 (mars 2024) de l'ABA précise ce que signifient des « mesures raisonnables » lorsqu'un cabinet souhaite éviter que le conflit soit imputé à chacun de ses avocats. L'ordre pratique découle de tout cela : les noms d'abord, l'histoire ensuite.
Pourquoi les données d'accueil du client résistent à un flux de copier-coller
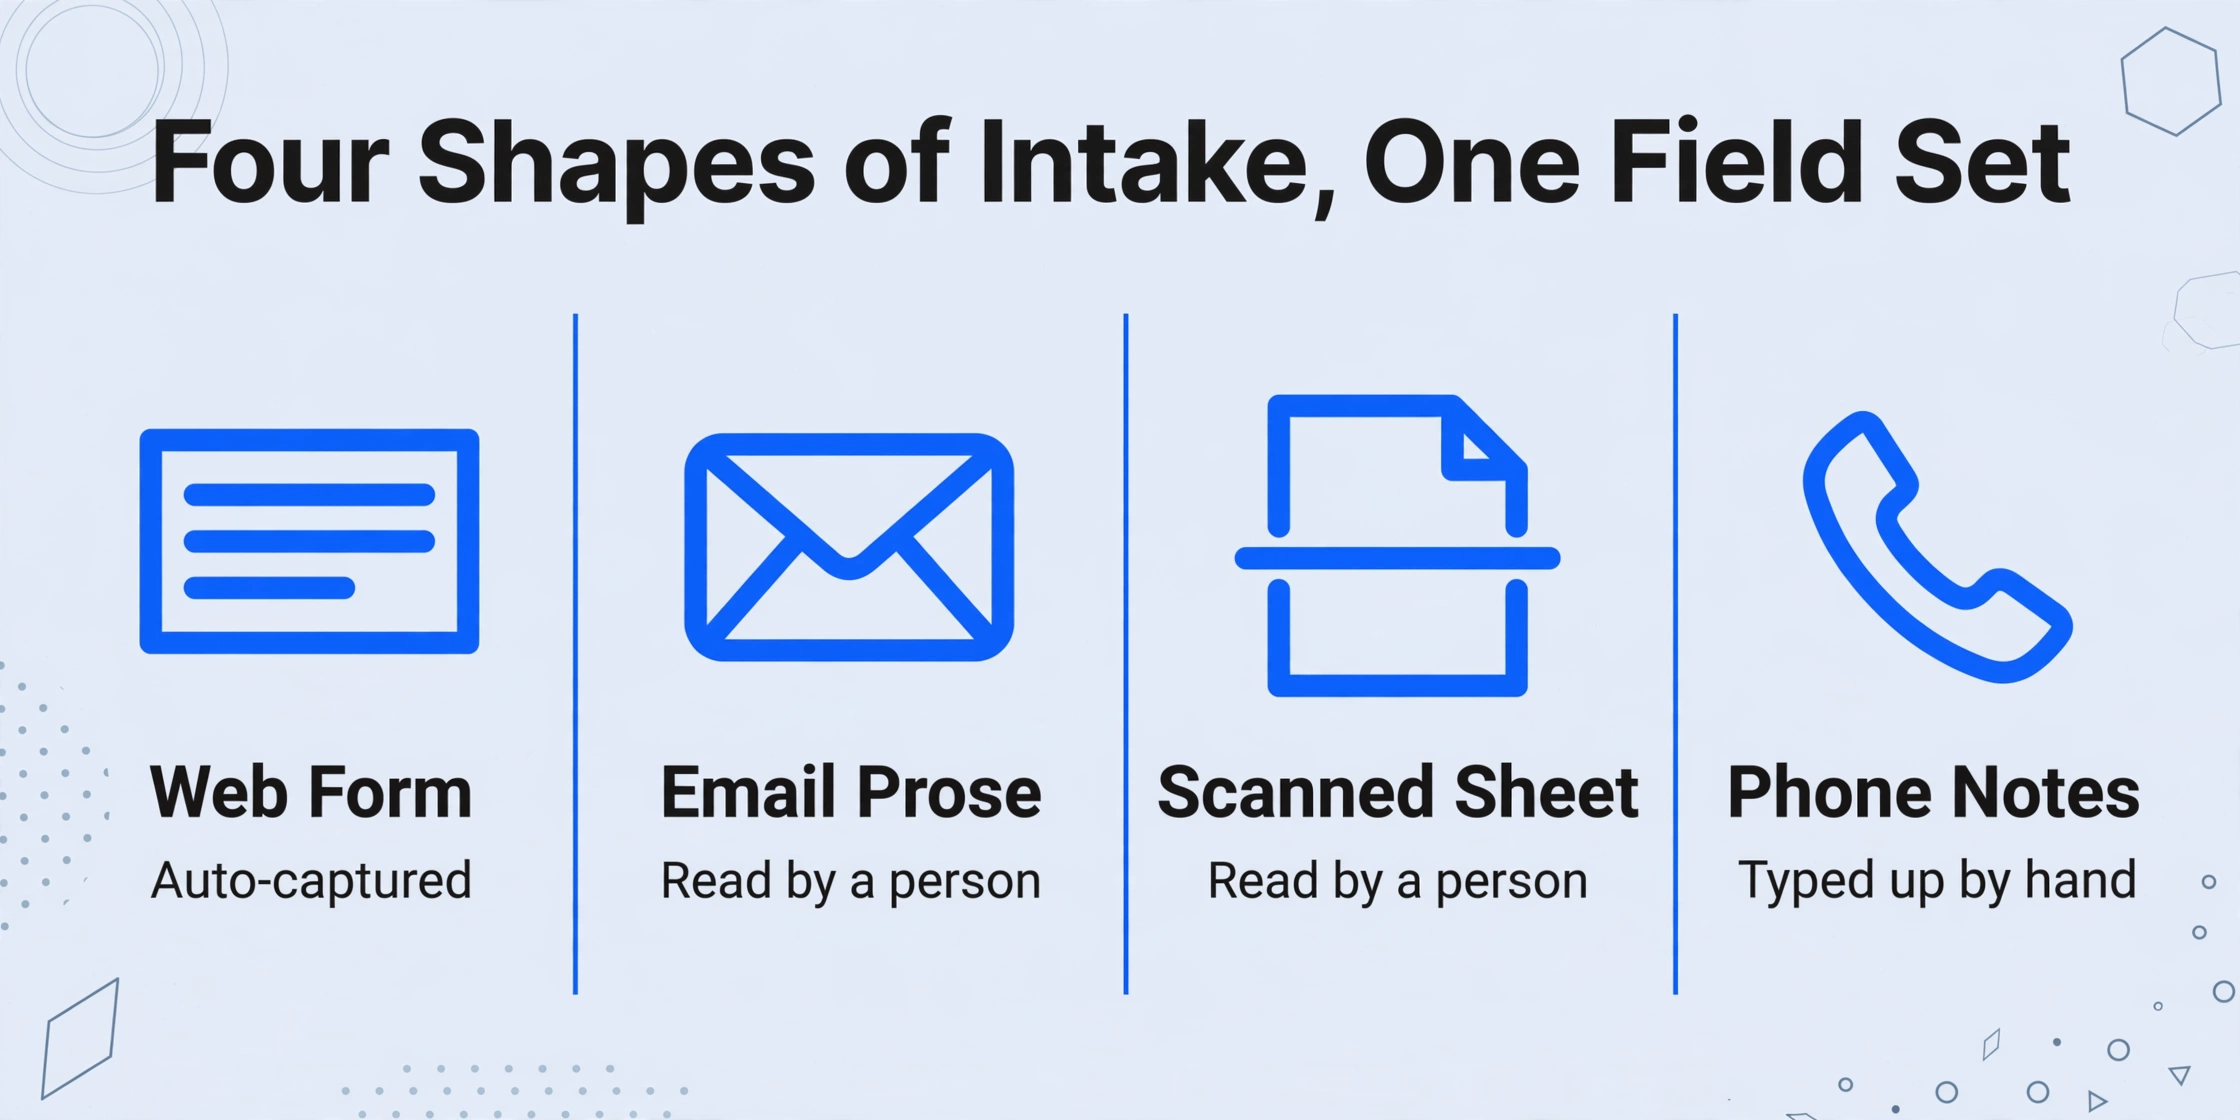
Faire passer les données d'accueil du client par une personne n'est pas une étape de mise en forme. C'est là que les mêmes champs sont lus trois ou quatre fois sous trois ou quatre formes, et que les erreurs dans les noms des conflits sont celles que personne ne remarque. La fragmentation est la première raison. Le même ensemble de champs — nom, partie adverse et échéance — arrive sous forme de notification de formulaire web, de prose d'e-mail, de feuille manuscrite scannée et de notes téléphoniques. Une assistante juridique concilie le tout dans un seul dossier, ce qui signifie que le cabinet paie un humain pour servir de couche d'intégration entre les canaux.
La deuxième raison est que la prose d'e-mail n'étiquette presque jamais les champs proprement. Un client écrit : « l'autre conducteur, un homme nommé R. Alvarez, a brûlé le feu rouge. » Reconnaître cette ligne comme une partie adverse et capturer « R. Alvarez » comme un nom recherchable est une tâche de lecture, et c'est précisément la tâche où une ressaisie précipitée omet l'initiale du deuxième prénom ou enregistre le nom sous le contact du client lui-même au lieu d'un sujet de conflit distinct.
The third reason is the split between the two channels. Native intake forms cover the form path well, and that is a real solution for the clients who use them. The email path is the one that stays manual, because nothing in a standard practice management setup reads an inbound email and turns it into fields. Firms describe the result in their own words. In an r/legaltech thread on manual client intake, one firm wrote it out step by step: "A lead sends us an email. Then, we enter their information into Clio or MyCase by hand. Next, we check for conflicts manually." Another, in an r/LawFirm discussion of intake form automation, described the data arriving "as a msg instead of stored in a .csv format," with assistants typing names, adverse parties, addresses, and dates of birth into forms by hand.
The data was already typed once, by the client. The firm is paying to type it a second time, and the second typing is the one that can be wrong.
This is the point where intake and the rest of legal document work diverge. Intake is a small number of fields that must be correct before the firm commits to anything, and the documents carrying them arrive in every format a client owns. The extraction step that comes after a matter is open is a related but separate problem, which is why it belongs with the questions in our guide to small law firm document extraction rather than here.
The Fix: Read the Intake Email, Extract the Fields
The step that removes the retyping is extraction aimed at the intake channel itself, not another form for clients to fill in. It uses two capabilities together, and both are worth understanding concretely.
The first is Email Inbox, a dedicated address attached to your account. You can forward a client's intake email to it, or share the address with the paralegal who takes the calls, and the attachments land in your processing queue without anyone opening an upload page. Turn on auto-process with a template bound to it and processing starts the moment mail arrives. A sender whitelist limits the inbox to the addresses you trust, so unrelated mail never enters the queue, and if a client sends a password-protected PDF, saved passwords are tried against it automatically.
The setting that matters most for intake is what the inbox reads. By default it processes attachments only and ignores the email body, which is the right choice for invoices and statements. Intake is the exception. The field data frequently lives in the body of the email with no attachment at all, because the client simply types "here are my details" and sends it. For that case you switch the mode to body only, or to attachments and body together, and the intake prose becomes the source document.
The second capability is Custom Column Extraction. Instead of drawing boxes on a fixed layout, you type the column names you want and a vision model reads each document or email to find the matching value by meaning. On an intake file, a column named "Adverse Party" is found whether the email says "the other driver," the form prints "Defendant," or a scanned sheet writes "opposing party." Because the AI reads the meaning rather than a saved position, the same column list works across a forwarded form, a photographed handwritten intake sheet, and plain email text.
A column list that covers the five field groups looks like this:
| Colonne d'accueil client | Ce qu'elle capture |
|---|---|
| Nom légal complet du client | Nom légal tel qu'il doit apparaître sur le dossier |
| Autres noms utilisés | Alias, noms de jeune fille, noms commerciaux, noms antérieurs pour la vérification des conflits |
| Téléphone / E-mail / Adresse postale | Coordonnées et préférences de communication |
| Date de naissance | Confirmation d'identité ; séparateur courant pour les noms en double |
| Type de dossier | Domaine de pratique ou catégorie de dossier pour l'acheminement |
| Partie adverse | Toute partie adverse nommée dans l'accueil client |
| Autres parties impliquées | Témoins, copropriétaires, assureurs, prêteurs, entités liées, conjoints |
| Conseil antérieur ou actuel | Autres cabinets déjà consultés sur le dossier |
| Source de référencement | Comment le client a trouvé le cabinet |
| Échéance clé | Délai de prescription ou date d'audience indiqué dans l'accueil client |
| Structure d'honoraires / Montant de la provision | Conditions d'engagement discutées lors de l'accueil client |
Parce que l'outil privilégie le traitement par lots, une semaine d'accueil client arrive sous forme d'une seule feuille de calcul avec une ligne par client potentiel, plutôt que comme un dossier de fichiers. Vous examinez cette feuille, et les champs qui ont un poids juridique — les parties adverses et les autres parties impliquées — sont ceux que vous vérifiez en premier, en utilisant la vérification Bbox pour passer de n'importe quelle cellule à l'endroit exact d'où provient la valeur sur l'e-mail ou le scan d'origine.
Les fichiers sont traités de manière sécurisée et ne sont pas stockés.
Ce que cet outil ne fait pas, et ce qui reste manuel
La limite honnête est que cet outil produit une feuille de calcul, pas un enregistrement Clio. ImageToTable.ai lit les documents d'accueil client et les e-mails et exporte en Excel, CSV ou JSON. Il n'écrit pas dans Clio ou MyCase via une intégration native. Les champs confirmés sont saisis dans les champs personnalisés de Clio ou les notes de dossier de MyCase par une personne, ou collés depuis la feuille. Si ce que vous voulez est une soumission de formulaire qui crée un dossier via une API sans intervention humaine, c'est une catégorie d'outil différente, et la recommandation honnête est de la comparer selon ses propres critères plutôt que de supposer que cette page le fait.
La deuxième limite est celle qui compte le plus pour un avocat. L'extraction ne fait pas la vérification des conflits d'intérêts. Elle place les noms des parties adverses et des parties impliquées dans des colonnes pour que ces noms existent sous une forme consultable, ce qui est la condition préalable à la vérification en vertu de la règle 1.7. La mise en correspondance de ces noms avec vos dossiers de clients actuels et anciens, et la décision de ce qu'un résultat signifie, restent votre système et votre jugement. Il en va de même pour les conflits avec les anciens clients en vertu de la règle modèle 1.9, que les noms extraits aident à mettre en évidence mais ne peuvent pas résoudre.
Troisièmement, l'extraction ne décide pas si vous devez accepter le dossier, rédiger la lettre de mission ou évaluer la crédibilité du client. Ce sont des décisions juridiques, et la feuille extraite est une donnée d'entrée pour celles-ci, pas un substitut.
Une feuille de calcul d'accueil client n'est pas une donnée neutre. En vertu de la règle 1.18(b), les informations partagées par un client potentiel sont protégées même si le cabinet ne prend jamais le dossier, donc la feuille doit être intégrée à votre gestion de la confidentialité, pas sur un lecteur non géré.
Enfin, les mêmes limites qui s'appliquent à tout document scanné s'appliquent ici. Les formulaires d'accueil client dactylographiés clairs et le texte des e-mails s'extraient proprement. L'écriture manuscrite pâle, une feuille photographiée avec un reflet, ou un formulaire exigu avec des champs qui se chevauchent se dégradent, et ce sont ces valeurs qu'il faut vérifier plutôt que de leur faire confiance. Un niveau de traitement supérieur gère une écriture plus dense et des scans plus brouillons, et le niveau est défini par lot, donc l'accueil client difficile peut être traité à un niveau supérieur tandis que les e-mails d'accueil propres restent économiques. Pour les cabinets qui font aussi de l'examen de contrat en plus de l'accueil client, l'approche champ par champ est la même que celle décrite dans notre guide d'extraction de contrats pour avocats indépendants, et la question de l'examen plus large est couverte dans la comparaison des logiciels d'examen de documents et de l'extraction par IA pour les petits cabinets.
Un flux de travail que vous pouvez configurer en un après-midi
Cinq paramètres et une liste de colonnes transforment une semaine d'e-mails d'accueil client en une feuille à vérifier. Chaque étape correspond à un contrôle précis plutôt qu'à une promesse générale.
Définissez les colonnes d'accueil une fois pour toutes
Utilisez la liste de champs ci-dessus : Client Full Legal Name, Other Names Used, Phone, Email, Mailing Address, Date of Birth, Matter Type, Adverse Party, Other Involved Parties, Prior or Current Counsel, Referral Source, Key Deadline, Fee Structure. Les noms de colonnes que vous saisissez deviennent les en-têtes de la feuille de sortie : décidez-les une fois pour chaque canal d'accueil plutôt que de reconstruire un format par client.
Dirigez les canaux d'accueil vers l'adresse Email Inbox
Partagez l'adresse avec ceux qui transfèrent les accueils, ou transférez vous-même les e-mails des clients. Activez la liste blanche d'expéditeurs pour que seuls les canaux connus atteignent la file de traitement, et enregistrez les mots de passe courants des pièces jointes dans les paramètres.
Définissez ce que la boîte de réception lit et liez le modèle
Comme les champs d'accueil se trouvent souvent dans le corps du message, réglez le mode de traitement sur corps et pièces jointes, ou sur corps uniquement si les clients ne joignent jamais rien. Liez le modèle de colonnes d'accueil à la boîte de réception, puis activez le traitement automatique pour que les e-mails soient traités à leur arrivée.
Vérifiez d'abord les champs de noms pour la vérification des conflits
Ouvrez la feuille du lot et vérifiez Adverse Party, Other Involved Parties et Prior or Current Counsel avant toute autre chose. Survolez une cellule suspecte pour voir exactement d'où vient la valeur sur l'e-mail ou le scan d'origine, corrigez-la si nécessaire, et rétablissez la valeur IA si l'original était correct.
Exportez, saisissez dans Clio ou MyCase, puis lancez la vérification
Exportez vers Excel ou CSV, collez ou saisissez les champs confirmés dans les champs personnalisés de Clio ou les notes de dossier de MyCase, puis lancez la vérification des conflits d'intérêts par rapport à votre liste de clients et d'anciens clients. L'extraction a remplacé la ressaisie ; la recherche et la décision vous appartiennent toujours.
Si votre accueil client est déjà entièrement en ligne et que peu de clients vous écrivent, les formulaires d'accueil natifs couvrent l'essentiel et la valeur ajoutée ici est moindre. Ce flux de travail prend tout son sens lorsqu'une part réelle des accueils arrive par e-mail, scans transférés et feuilles manuscrites, car c'est cette part qu'aucun outil de formulaire n'atteint. Lorsque ces documents d'accueil alimentent ensuite un travail documentaire plus large, le guide complet sur l'extraction de contrats et le guide sur l'extraction de documents pour la divulgation de pièces prennent le relais à l'étape suivante.
FAQ
Est-ce que cela se connecte directement à Clio ou MyCase ?
Non, et il vaut la peine d'être clair à ce sujet. L'outil lit les e-mails d'accueil client et les documents, puis exporte en Excel, CSV ou JSON. Une personne saisit ou colle ensuite les champs confirmés dans les champs personnalisés de Clio ou les notes de dossier de MyCase. Cela élimine la ressaisie lors de l'accueil du client ; cela ne crée pas le dossier via une API native. Les cabinets qui ont besoin qu'une soumission de formulaire ouvre automatiquement un dossier recherchent une catégorie différente de produit d'intégration.
Les détails d'accueil du client sont dans le corps de l'e-mail, sans pièce jointe. Est-ce que cela fonctionne ?
Oui. La Email Inbox par défaut est réglée sur pièces jointes uniquement, ce qui ignore le corps, mais vous pouvez la passer en corps uniquement ou en pièces jointes et corps ensemble. Pour un client qui saisit ses détails directement dans l'e-mail, ce mode est celui qui transforme le message en document source.
Et si le client envoie un formulaire d'accueil photographié ou manuscrit ?
Il est lu par un modèle de vision à partir de l'image elle-même, donc une photo nette d'un formulaire imprimé fonctionne bien. L'écriture manuscrite s'extrait mieux à un niveau de traitement supérieur, et l'écriture cursive dense ou le crayon pâle doivent être traités comme un élément à vérifier. Les champs les plus utiles à vérifier à la main sont toujours les mêmes : les parties adverses et tout nom qui alimente la recherche de conflits d'intérêts.
Les données d'accueil des clients potentiels sont-elles sûres à traiter de cette façon ?
Les fichiers sont traités en transit et non stockés, et ne sont pas utilisés pour l'entraînement du modèle. La question de la confidentialité est plus large que l'outil. En vertu de la Model Rule 1.18(b), les informations qu'un client potentiel partage sont protégées même lorsqu'aucun engagement ne s'ensuit, donc la feuille d'accueil extraite doit être traitée selon la politique de confidentialité et de conservation des données de votre cabinet, et les cabinets soumis à des restrictions imposées par le client ou le barreau doivent d'abord confirmer le modèle de traitement par rapport à ces exigences.
Cet outil gère-t-il l'accueil du client dans d'autres langues que l'anglais ?
Oui. Le modèle de vision lit plusieurs langues et conserve le texte des champs dans la langue où il apparaît, ce qui importe pour les cabinets dont les clients rédigent des e-mails d'accueil en espagnol, français, allemand, portugais, japonais ou coréen. L'accueil en langues mélangées est pris en charge, même si une valeur située exactement là où un document change de langue mérite un second regard.
Le modèle mental utile est que l'accueil du client est un problème de capture de données avant d'être un problème juridique. Le client a déjà répondu aux questions ; le cabinet paie simplement deux fois, une fois en temps du client et une autre en temps d'un assistant juridique, et c'est lors du second passage que les noms de conflits peuvent poser problème. Transformer l'e-mail d'accueil et le formulaire transféré en une feuille structurée élimine le second passage sans toucher à la partie qui nécessite un avocat.
Envoyez-vous un e-mail d'accueil client d'exemple et voyez ce qui revient. Traitez un accueil client et vérifiez vous-même la colonne partie adverse.