手頃な価格の契約データ抽出
独立系弁護士が実際に確認する10の項目に対応
ABA GPSolo部会の報告によると、弁護士の約3分の2が個人事務所または5人以下の事務所で働いています。契約AI市場(Kira、Diligen、Ironclad、Luminance)は、すべての主力製品を残りの3分の1向けに価格設定していました。月額500ドルの価格ページを見た後に「手頃な契約データ抽出」を検索する独立系弁護士は、業界がまだ答えていない質問をしています:フル機能のNLP分析スイートではなく、各契約から10の特定項目だけが必要で、月500件ではなく30件の契約を処理する場合、どうすればいいのか?
重要ポイント
- 月額500ドル。それがエンタープライズ向け契約AIの導入価格です。これは1万件の契約をレビューするAmLaw 200のデューデリジェンスチーム向けに設計された価格であり、30件の契約をレビューする独立系弁護士向けではありません。
- 月30件の契約。各10項目。しかし、500ドルのエンタープライズツールには、条項プレイブック比較、義務追跡、SSOがバンドルされており、一人事務所では絶対に使わない機能です。
- ImageToTable.aiは月額19ドルで、実際に必要な10項目を抽出します — 列名を一度入力すれば、同じリストがNDA(秘密保持契約)、雇用契約、ベンダー契約で使用でき、契約ごとに異なるテンプレートを用意する必要はありません。
$500の壁:独立系弁護士が絶対に使わないエンタープライズ向け契約AIのバンドル機能
Kira Systemsはユーザー1人あたり月額約$500からです。Diligen(現在はLiteraの一部)は月額約$300です。IroncladのCLMプラットフォームは月額$600以上から始まります。LuminanceとLawGeexは「お問い合わせ」ボタン経由の価格設定で、リーガルテック市場では、その表記は確実に月額4桁を意味します。これらは本格的なボリューム向けに作られた本格的なツールであり、その価格設定は彼らがサービスを提供する組織を反映しています。M&Aデューデリジェンス中に数万件の契約をレビューするAmLaw 200の法律事務所、数十の事業部門にわたって数百件のアクティブな契約を管理する企業法務部門などです。主要ツールの価格がどこにあるのかを完全に比較したもの(独立開業向けの価格設定のツールを含む)は、最高の契約抽出ツール総集編をご覧ください。
この価格は恣意的なものではありません。エンタープライズ向け契約分析ツールは通常、以下をバンドルしています:
| 機能 | 概要 | 1〜3名の弁護士からなる独立開業に必要か? |
|---|---|---|
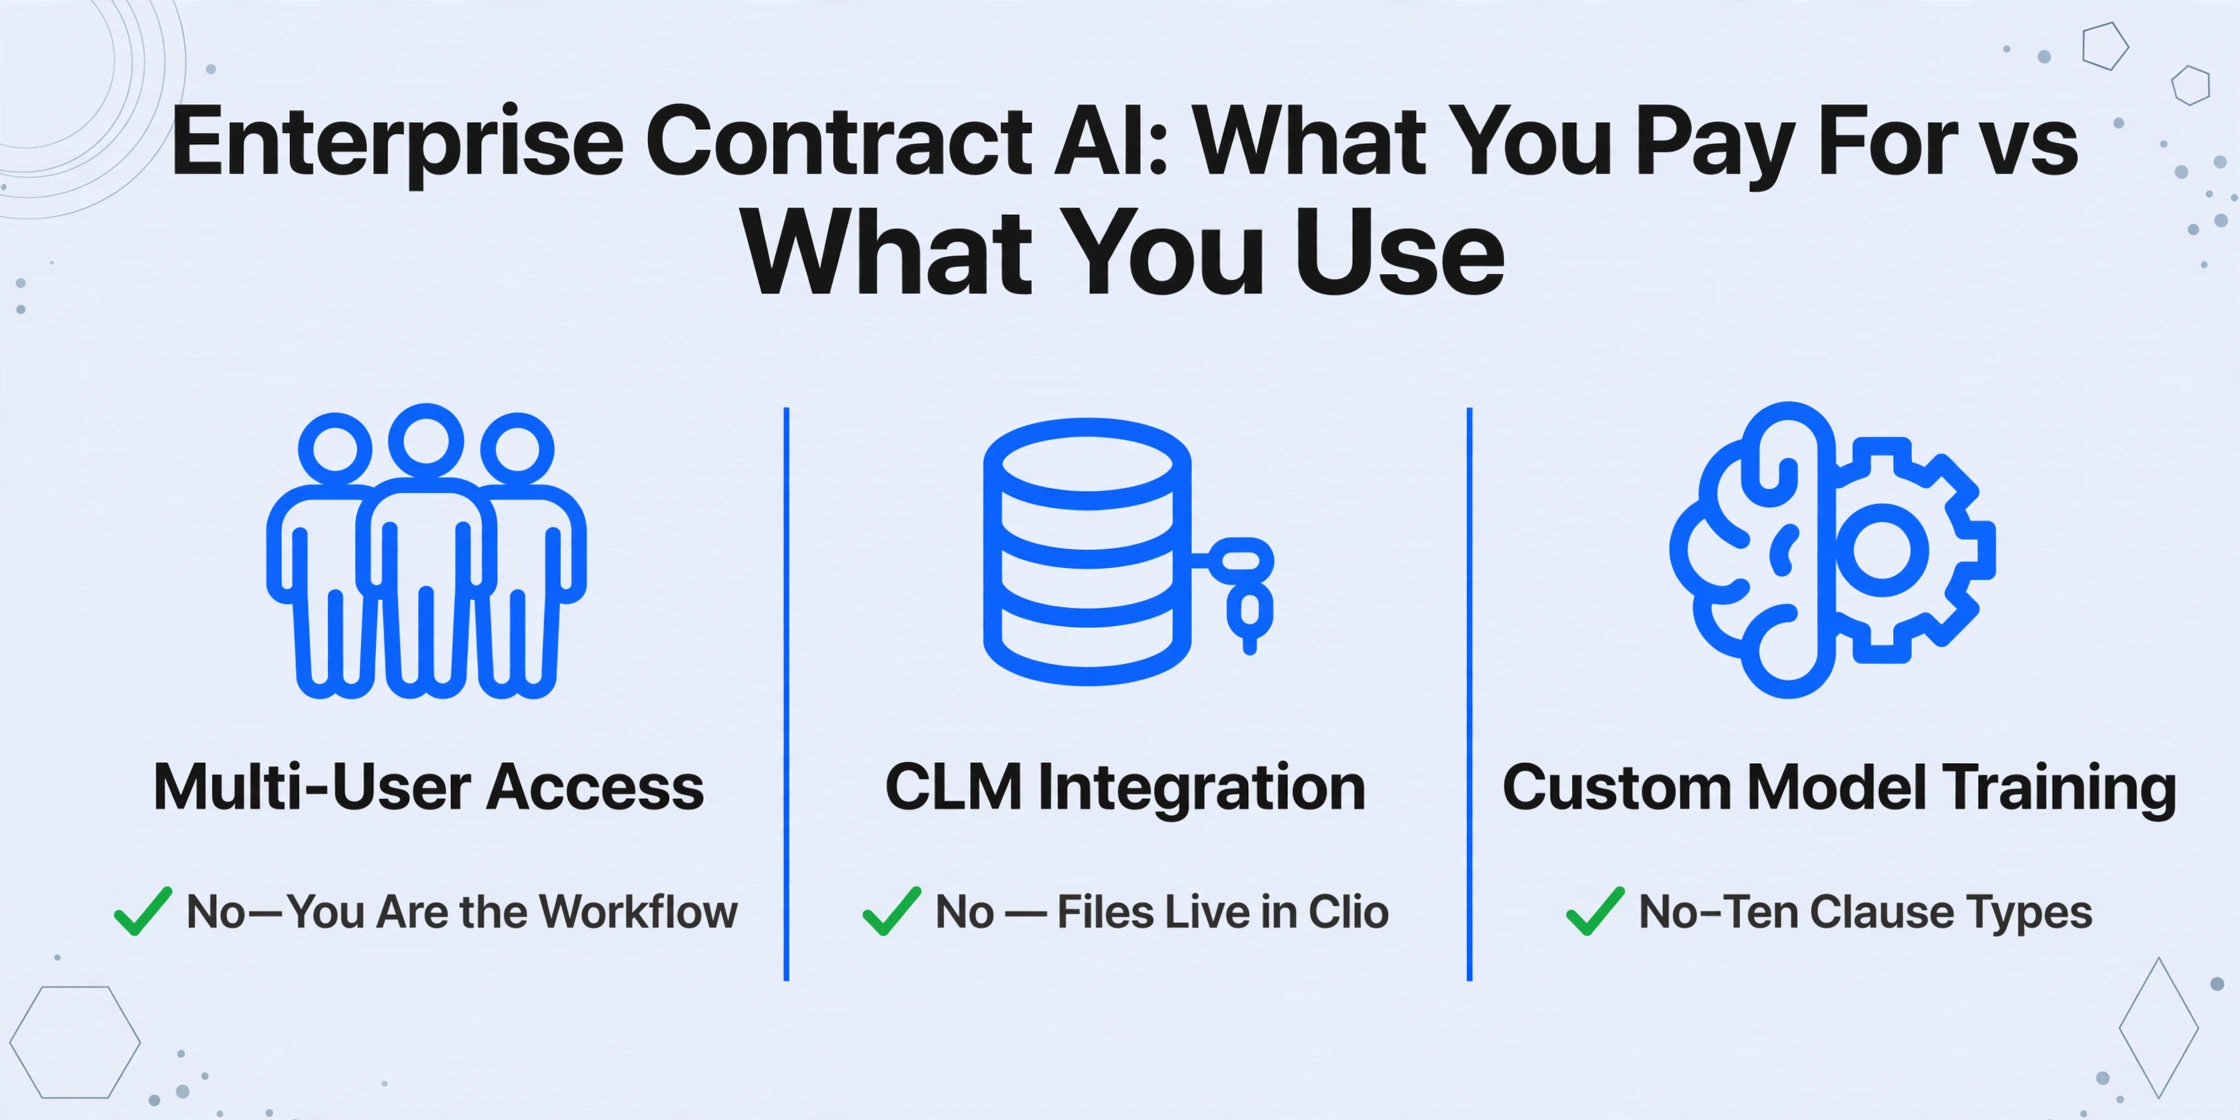
| 多ユーザーロールベースアクセス | 部門をまたいで契約例外を誰がレビュー、承認、またはエスカレーションできるかを定義 | 不要 — あなた自身がレビュー、承認、エスカレーションのワークフローです |
| CLM/文書管理統合 | iManage、NetDocuments、SharePointとの双方向同期 | 不要 — 契約書はClio、MyCase、またはデスクトップのフォルダにあります |
| 条項タイプごとのカスタムMLモデルトレーニング | 数千の前例にわたって組織固有の条項文言を認識するようにシステムをトレーニング | 不要 — 必要なのは50種類ではなく10種類の条項タイプで、文言は企業プレイブックごとではなくクライアントごとに異なります |
| SSO/SAML認証 | ファーム全体にわたるエンタープライズID管理 | 不要 — ログインは1つ、ユーザーは1人です |
| 義務抽出と期限追跡 | 自動カレンダートリガーで契約ポートフォリオ全体の継続的義務を解析 | 有用かもしれませんが、よりシンプルなアプローチで実現可能です |
これらの機能が無用というわけではありません。それらは、その機能が作られた購入者にとって不可欠なものです。問題は、契約AIベンダーが、月に30件の契約を処理し、それぞれから10個のフィールドを必要とする購入者向けの製品を構築していないことです。価格モデルは、彼らが設計対象としている顧客がスイート全体を必要とするため、あなたもそうだと想定しています。2026年のドキュメント抽出価格設定の状況に関する分析で検討したように、エンタープライズ層と低価格層の差は抽出品質ではなく、抽出エンジンの周りに組み込まれたその他すべての要素にあります。
独立系弁護士が契約から実際に抽出する10のフィールド
取引分野の独立系弁護士がベンダー契約、雇用契約、NDA(秘密保持契約)をレビューする場合、大手法律事務所のデューデリジェンスチームが対象企業の全契約ポートフォリオに対して実施するような条項レベルの詳細な調査を行うわけではありません。その作業はより範囲が狭く、一貫性があります。各契約から同じ重要なフィールド一式を特定し、弁護士がリスクを評価し、取引先間で条件を比較し、義務の整理された記録を維持できるようにすることです。
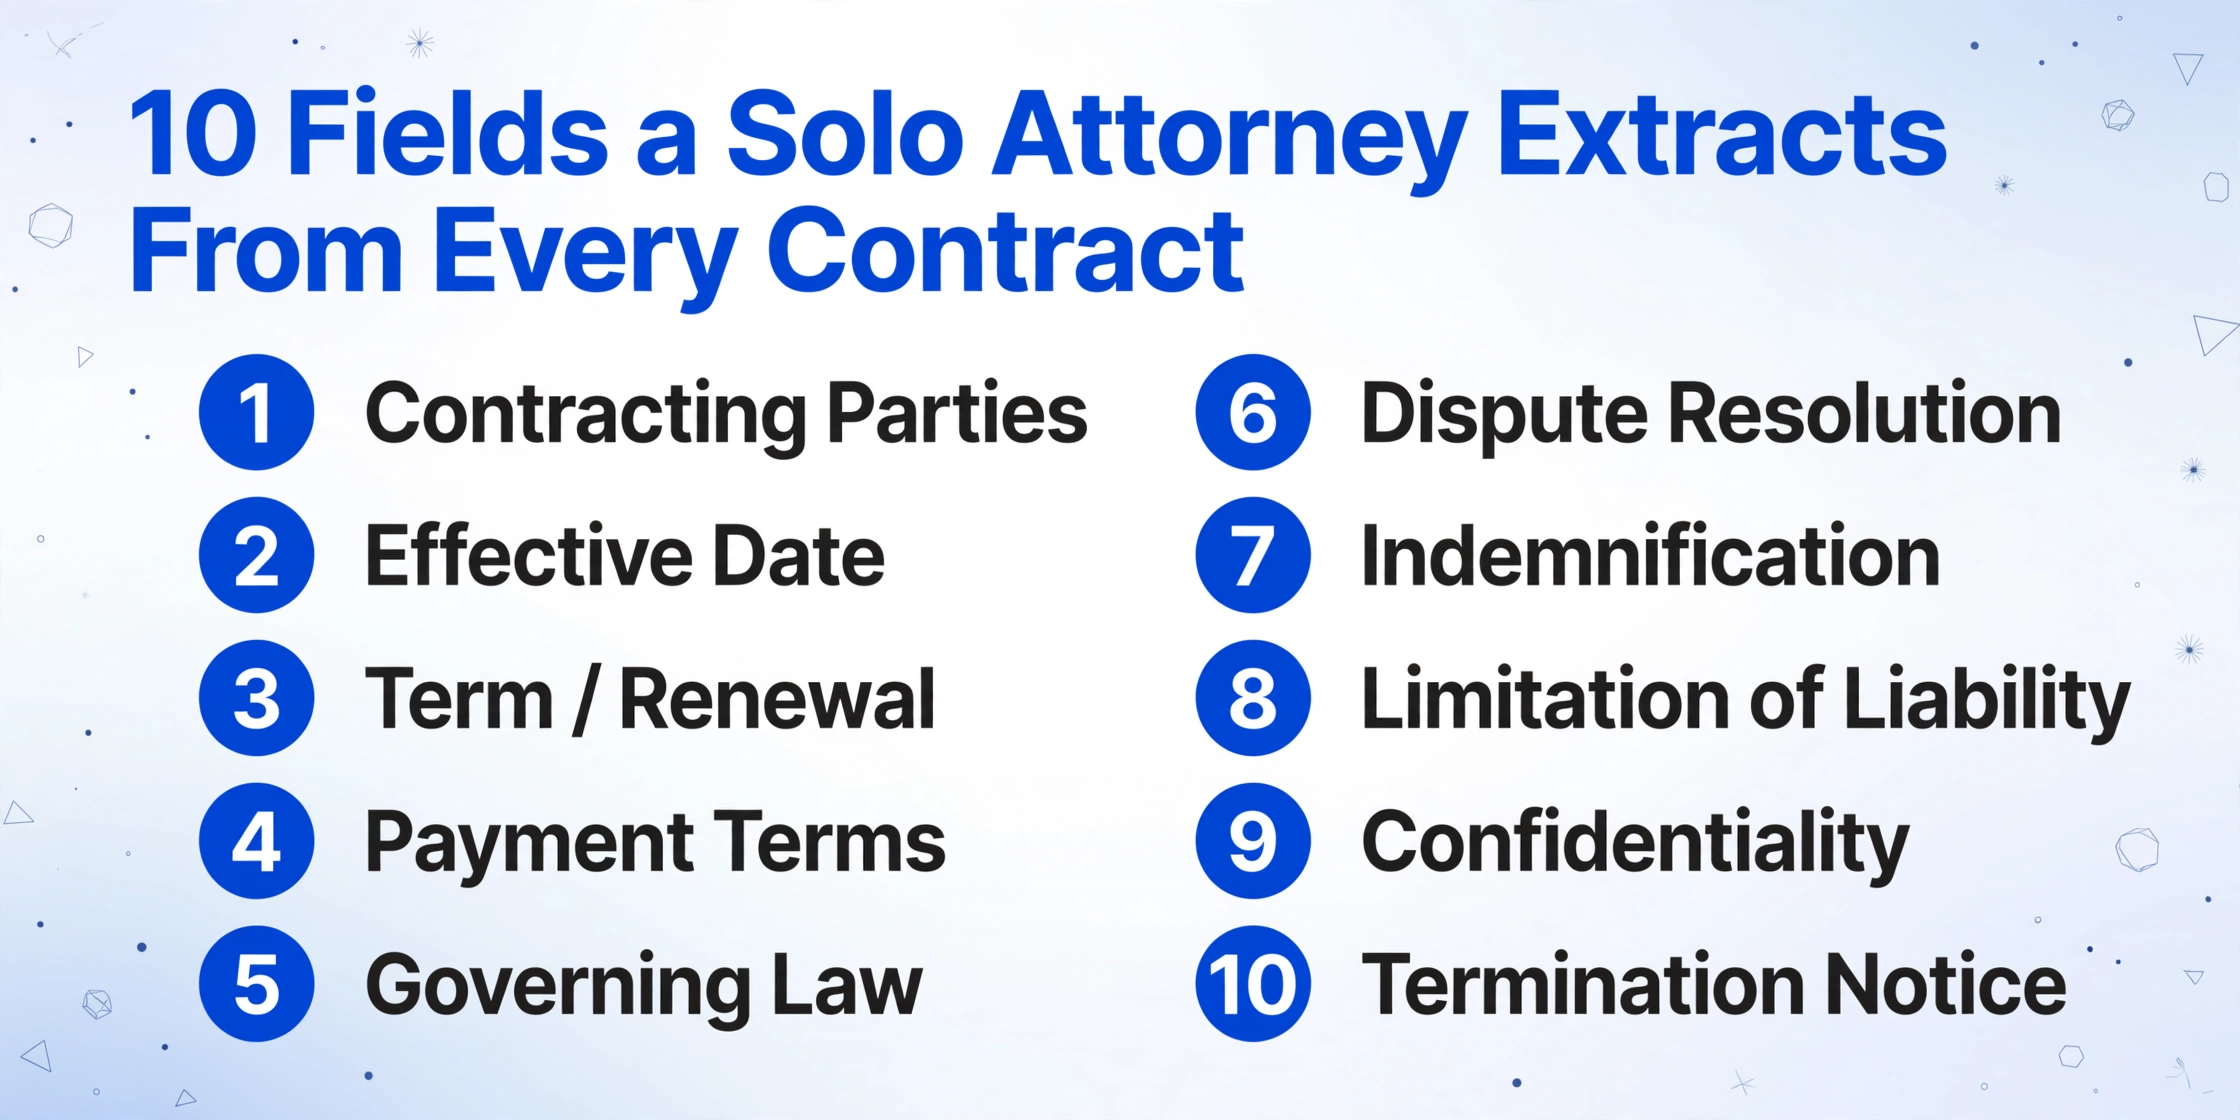
典型的な独立開業(企業取引、雇用法、不動産、一般業務のいずれであっても)において、重要となるフィールドは、予測可能なセットに集約されます。
| フィールド | 重要な理由 | 含まれる契約 |
|---|---|---|
| 契約当事者 | 正しい法人の特定が必要。誤った当事者では契約が無効になる | すべての契約 |
| 発効日 | 履行義務と消滅時効の起算点を決定する | すべての契約 |
| 期間/更新 | 自動更新条項は中小企業向け契約で最も一般的な落とし穴 | サービス契約、賃貸借契約、ベンダー契約 |
| 支払条件 | 料金体系、請求サイクル、延滞料金 | ベンダー契約、サービス契約、雇用契約 |
| 準拠法 | どの州法が適用されるかを決定 — 裁判地選択の分析に重要 | 州をまたぐ当事者を含むすべての契約 |
| 紛争解決 | 仲裁か訴訟か、裁判地、弁護士費用負担条項 | サービス契約、雇用契約、商業賃貸借契約 |
| 補償(インデムニティ) | 補償義務の範囲 — 相互か片務か、上限ありか無制限か | ベンダー契約、サービス契約、建設契約 |
| 秘密保持 | 期間、範囲、既存情報や独自開発情報の例外 | NDA(秘密保持契約)、雇用契約、パートナーシップ契約 |
| 契約終了 | 予告期間、都合による終了、違反時の是正期間 | サービス契約、ベンダー契約、雇用契約 |
| 責任制限 | 上限額と、特定カテゴリの損害を除外するかどうか | ベンダー契約、SaaS契約、サービス契約 |
これは、訓練済みのNLPモデルによる分類が必要な50種類の条項リストではありません。ほとんどの実務分野のほとんどの契約に繰り返し登場する、短く安定したフィールド群です。独立系弁護士が月に20件の契約をレビューする場合 — 実務中心の弁護士にとって現実的な件数であり、訴訟中心で業務委託契約書や和解契約書も扱う事務所ではもう少し少ない — 各契約の抽出作業は同じ10の質問を20回繰り返すことになります。
エンタープライズ向けツールは、異なる問いに答えるために作られています。「この300ページのM&A契約書の条項14.2(b)は、当社の標準プレイブックの文言から逸脱しているか。逸脱している場合、その逸脱は、当社のトレーニング済みモデルにある14,000件の先例条項に対してどのようにスコアリングされるか。」これは、現実的で価値のある分析です。しかし、これは、10ページの商業賃貸借契約書や標準的なベンダー契約書をレビューする独立系弁護士が問う質問でもありません。
カスタム列抽出: AIにどの条項を探すかを指示する
エンタープライズ向け契約AIと独立開業の予算のギャップを埋める機能は、カスタム列抽出と呼ばれます。その仕組みは単純です。抽出したいフィールド名(「準拠法」「補償範囲」「解約通知期間」など)を入力すると、AIが各条項の意味を理解して、各ドキュメント内の対応する値を特定します。これは、条項がページのどこにあるかではなく、何を意味するかに基づいています。各フィールドの周囲にボックスを描き、契約書の種類ごとにレイアウトを保存する必要があるテンプレートベースのツールとは異なり、カスタム列抽出は、ドキュメントごとの設定なしで、あらゆる契約書形式に対応します。
これが、エンタープライズ向け契約AIやテンプレートベースのOCRとの決定的な違いです。テンプレートツールは位置を記憶します(「準拠法は常に7ページの右下の段落に表示される」など)。そのため、相手方が異なる形式を使用した瞬間に機能しなくなります。エンタープライズ向けNLPスイートは、数千件の類似契約書にわたる条項言語のコーパスを学習し、分類モデルを構築します。カスタム列抽出は、その中間に位置します。視覚言語モデルを使用してドキュメント全体を読み取り、意味的に一致するコンテンツを特定します。これは、事前トレーニングされた分類ではなく、各ページの実際のテキストに反応します。モデルをトレーニングしているのではなく、契約書ごとにAIに何を探すかを指示しているのです。
独立系弁護士にとって、これは、ベンダー契約書の束を一括アップロードし、上記の10個のフィールド名を列ヘッダーに入力し、各契約書のフィールドが行に入力された単一のスプレッドシートを受け取ることを意味します。構築するテンプレートも、トレーニングするモデルも、契約書の種類ごとのセットアップもありません。AIはレイアウトテンプレートに照合するのではなく、各ドキュメントを個別に読み取るため、同じ列リストがNDA(秘密保持契約)、サービス契約、雇用契約にも対応します。
ファイルは安全に処理され、保存されることはありません。
もしあなたの業務で、予測可能な形式の契約書を大量に扱っているなら——たとえば、毎月50件の同一フランチャイズ契約書——契約データのExcel抽出を扱う変換ページでは、ドキュメントの種類から出力構造までの完全なワークフローを説明しています。
$19でできること vs $500でできること
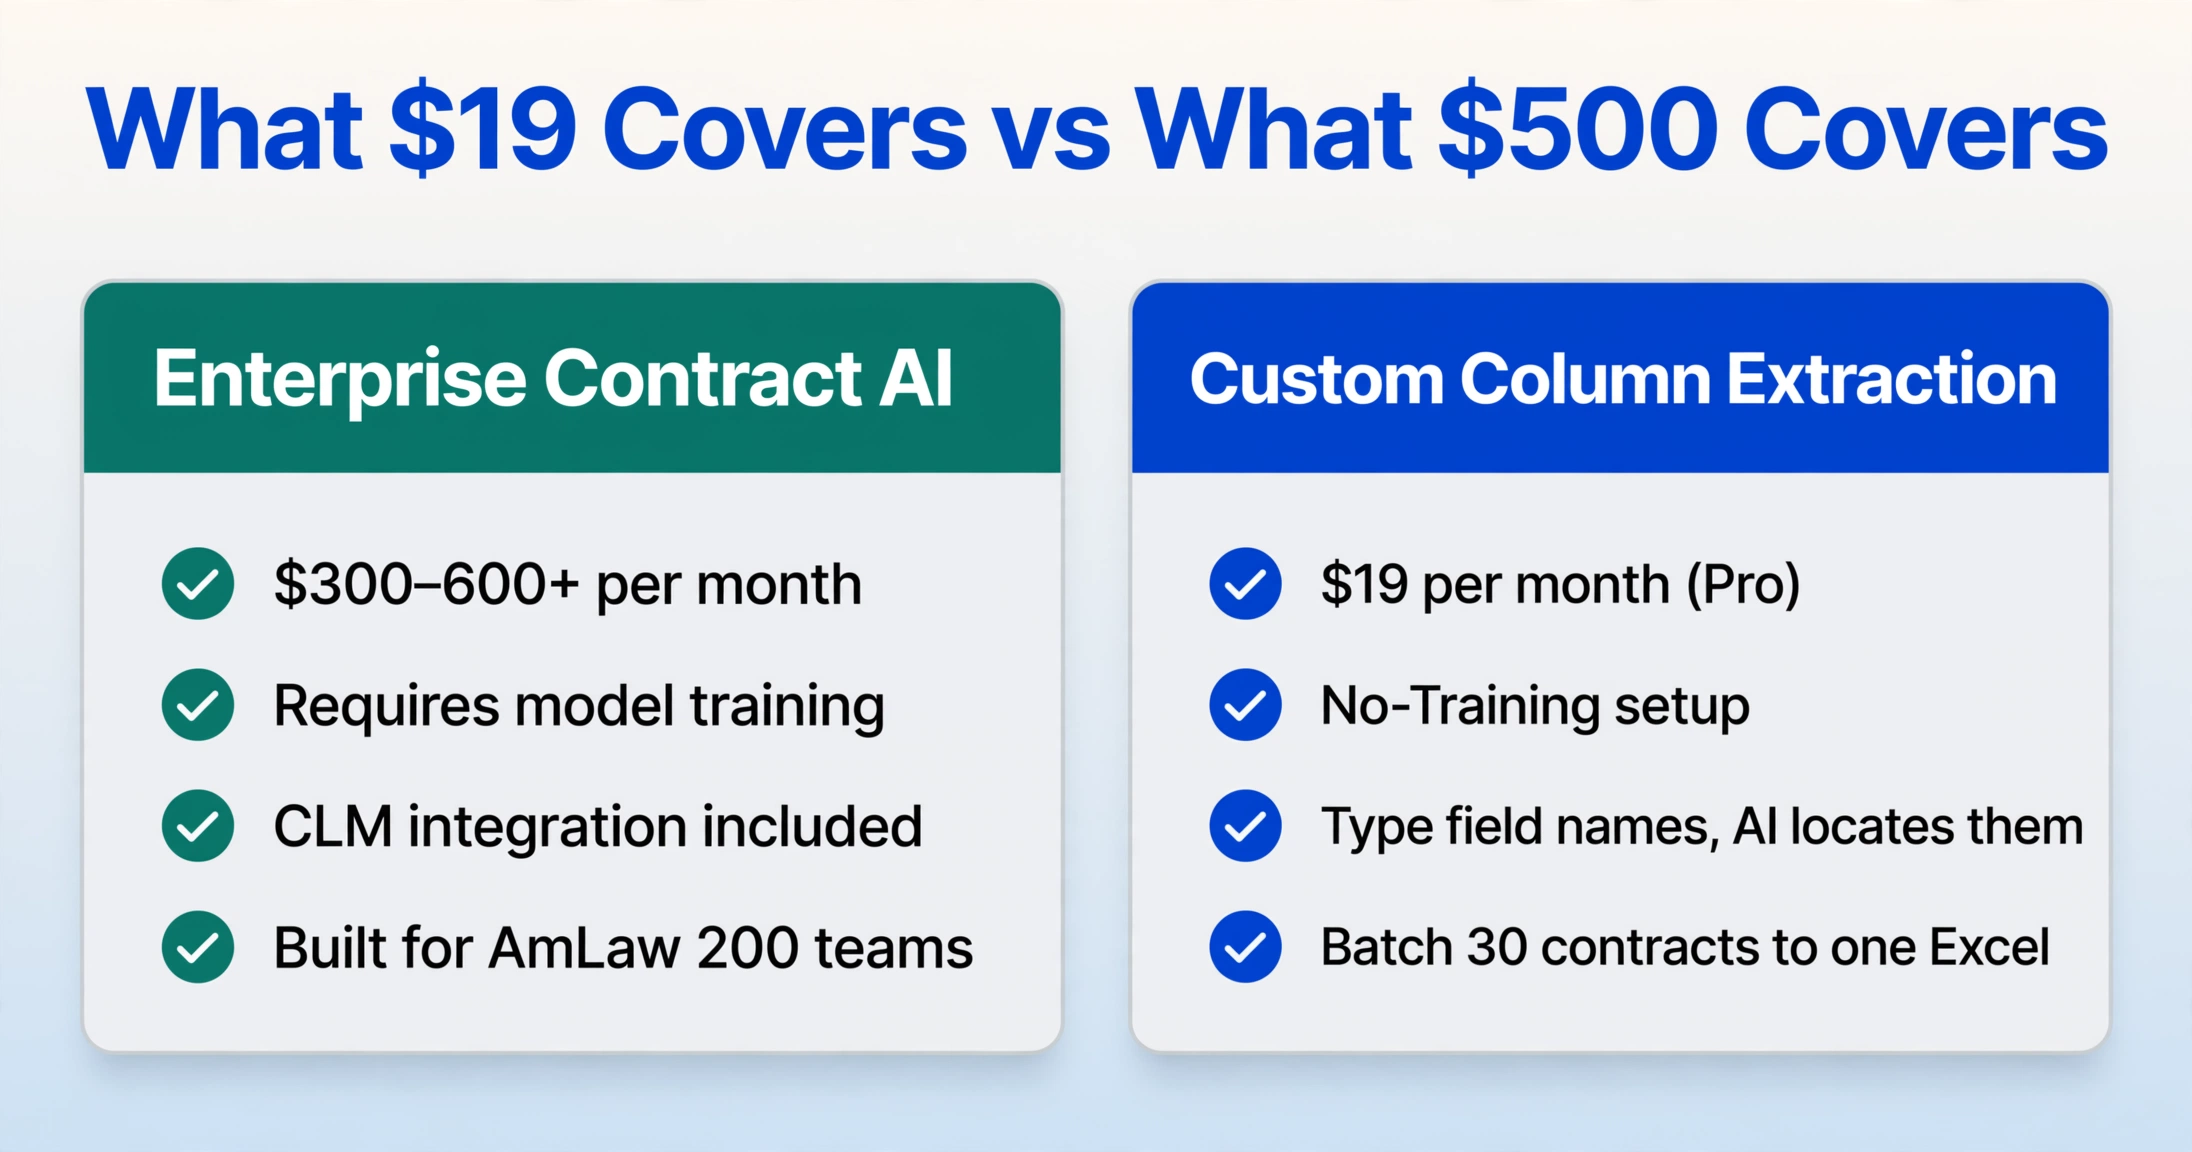
ImageToTable.aiのProプラン(月額$19、400クレジット=約400ページ相当)と、Kiraの約月額$500の価格差は、ひとつの問いに集約されます。それは、契約書に特化したAIプラットフォームを購入しているのか、それとも契約書も得意とするドキュメント抽出を購入しているのか、ということです。
| 機能 | エンタープライズ向け契約AI(月額$300〜600+) | カスタム列抽出(月額$19のProプラン) |
|---|---|---|
| あらゆる契約PDFから当事者名、日付、支払条件を抽出 | 可能 — 条項タイプのモデル学習・設定後 | 可能 — フィールド名を入力するだけで、AIがドキュメントごとに特定 |
| 30件の契約を一括処理して1つのスプレッドシートにまとめる | 可能 | 可能 — 複数ファイルをアップロードして1つのExcelにマージ |
| スキャン済み契約書、PDF、画像ベースのドキュメントに対応 | 可能 — OCR前処理パイプライン | 可能 — 視覚言語モデルがドキュメントを直接読み取る |
| 標準文言の学習済みプレイブックと個々の条項を比較 | 可能 — 中核機能 | 不可 — プレイブック比較や逸脱スコアリングはなし |
| 代替条項文言の提案 | 可能 — AIによる条項ドラフト機能を備えたツールもあり | 不可 — 抽出のみでドラフト機能はなし |
| 義務の追跡と期限アラートの自動化 | 可能 — 契約ライフサイクル管理(CLM)と統合 | 不可 — 出力はスプレッドシートのみ。カレンダー管理は手動 |
| 第三者リスク評価・取引先分析 | 可能 — 外部データと統合するツールもあり | 不可 |
| 契約タイプごとのテンプレート設定 | 必要な場合が多い | 不要 — 同じ列リストが契約タイプを問わず機能 |
| 30件の契約をレビューする独立系弁護士の月額コスト | $300〜600+ | $19(Proプラン、400クレジット) |
境界線は明確です。標準条項プレイブックに照らして交渉を行う業務 — 相手方の補償条項の文言が、自社の推奨表現から定められた許容範囲を超えて逸脱している場合にAIが警告する必要があるケース — であれば、エンタープライズ向け契約AIはその価値に見合います。その用途には、学習済みの条項分類モデルと逸脱検出エンジンが必要であり、一般的なドキュメント抽出ツールにはどちらも備わっていません。
あなたの業務で、上記の表にある10項目のフィールドを、月に20〜40件の契約書から抽出して確認可能なスプレッドシートにする必要があるなら、エンタープライズツールは「少しだけ良い抽出」を提供しているわけではありません。それは、異なる価格帯で、異なるワークフロー向けに設計された、まったく別の製品カテゴリを提供しているのです。これは、エンタープライズ契約なしでの文書抽出ガイドで整理した構造的な価格設定のミスマッチと同じです。月額サブスクリプションモデルが存在するのは、購入者が組織であり、最低契約期間は組織の購入者を獲得するために必要な営業プロセスを反映したものであって、テクノロジーのコストを反映したものではないからです。
独立系弁護士にとって、従量課金とサブスクリプションの選択は、ボリュームの予測可能性に帰着します。月30件の契約書であれば、月400クレジットの$19のProプランは、1契約あたり約13クレジットを提供し、1文書あたり10フィールドを抽出するには十分すぎるほどで、クレジットも余ります。経済性が崩れるのは、契約書あたりの抽出範囲が拡大し、クレジット消費量がプランの割り当てを超えた場合のみですが、10フィールドを抽出する独立系弁護士にとって、それが発生する可能性は低いでしょう。
契約抽出が既存の業務管理にどう適合するか
Clio、MyCase、PracticePanther、Smokeballは、別の問題を解決します。これらは案件管理、請求可能時間の追跡、クライアントとのコミュニケーションの保存、請求書の作成を行います。契約書からデータを抽出することはありません。すでに月額$39〜$125でClioを利用している独立系弁護士が、契約抽出ツールに置き換えることはありません。この2つの機能は補完関係にあります。
実務的なワークフローは次のとおりです。相手方弁護士またはクライアントからメールで契約書を受け取る → PDFをローカルに保存する → その週の契約書を、10のフィールド列を定義した抽出ツールに一括アップロードする → すべてのフィールドが入力されたスプレッドシートを受け取る → 主要フィールドをClioのケースノートやクライアントファイルにインポートする前に、スプレッドシートに異常がないか確認する。抽出ステップは、各契約書を開き、準拠法条項を探して読み、スプレッドシートに「Delaware」と入力するという手作業を置き換えます。法的判断を置き換えるものではありません。弁護士は依然として出力を確認します。また、ABA弁護士職務基本規則 規則1.1 コメント[8]は、テクノロジー能力とは、使用するツールの利点と限界を理解することを意味し、判断をツールに委ねなければならないという意味ではないことを明確にしています。
この区別 — 抽出は業務管理の補完であり、どちらかの代替ではない — は、エンタープライズ向け契約AI市場が曖昧にしてきた点です。IroncladやEvisortは、起草から交渉、更新まで契約ライフサイクル全体を管理するオールインワンの契約ライフサイクル管理(CLM)プラットフォームとして自らを位置づけています。独立系弁護士にCLMプラットフォームは必要ありません。以前公開した単一ツールと複数ツールのコスト分析もここに当てはまります。抽出と業務管理を単一のツールにバンドルすると、既存のClioサブスクリプションでカバーされているかどうかに関係なく、管理機能の分も支払うことになります。
テクノロジー予算が限られている独立系弁護士にとって、文書抽出が独立開業のツールスタックにどう適合するかという広範な問題 — 処理が必要な請求書、領収書、銀行明細書と並んで — は、フリーランサー予算での文書抽出に関するガイドで詳しく説明しています。原則は同じです。実際に必要な10のフィールドを特定し、業界最大手の企業ではなく、自分のボリュームに合わせた価格設定のツールを見つけ、スプレッドシートを判断の入力として扱い、判断の代わりとはしないことです。
FAQ
AI抽出はデジタル文書だけでなく、スキャンした契約書やPDFも処理できますか?
はい。ImageToTable.aiは視覚言語モデルを使用して文書を視覚的に読み取ります。つまり、埋め込まれたテキストレイヤーを抽出するのではなく、ページ上のピクセルを人間の目と同じように処理します。そのため、スキャンした契約書、コピーから作成されたPDF、さらにはスマートフォンで撮影した紙の契約書の写真も処理できます。欄外の手書き注記は印刷テキストよりも精度が低くなる場合がありますが、スキャン文書の主要な印刷コンテンツはデジタルPDFと同じ精度で抽出されます。
契約書の種類ごとに異なるテンプレートが必要ですか — NDA、雇用契約書、ベンダー契約書など?
いいえ。カスタム列抽出はテンプレート照合ではなく意味理解を使用するため、「発効日」「準拠法」「補償条項」といった同じ列名が異なる契約書タイプ間で機能します。AIは条項の意味を理解して各フィールドを特定するので、以前の文書でどこにあったかを記憶する必要はありません。NDA、雇用契約書、ベンダー契約書はすべて、同じ列定義で同じバッチで処理できます。
このツールは抽出した条項を標準プレイブックと比較できますか?
いいえ。ここが手頃な価格の抽出とエンタープライズ向け契約AIの分岐点です。ImageToTable.aiは補償条項のテキストをスプレッドシートに抽出しますが、条項を推奨文言と照合してスコアリングしたり、逸脱をフラグ付けしたりはしません。抽出された条項を読み、ご自身の判断を適用してください。自動プレイブック比較が業務上の必須要件である場合、KiraやDiligenのようなツールが適切なカテゴリーです — そして月額300〜600ドルの価格はその能力を反映しています。
$19のProプランでは月に何件の契約書を処理できますか?
Proプランには月400クレジットが含まれ、各ページが1クレジットを消費します。平均的な契約書が10ページで、各契約書から10フィールドを抽出する場合、月に約40件の契約書を処理できます。3〜5ページの短いNDAや業務委託契約書なら処理件数は増えます。長い契約書では減ります。クレジットカウンターはダッシュボードに表示されるため、月を通して使用状況を確認できます。
データは安全で、弁護士の守秘義務に適合していますか?
ファイルは処理中のみ転送され、処理後に削除されます。保存されることはなく、モデルのトレーニングにも使用されず、アカウント所有者以外の誰もアクセスできません。詳細な取り扱いについては、プラットフォームのプライバシーポリシーをご確認ください。本ツールはデータ処理においてSOC 2に準拠しています。特定の州の弁護士会が技術倫理に関する意見を出している実務(クラウドベースの法務技術に関するガイダンスを発行している州弁護士会もあります)については、重要な考慮点は、処理モデル(送信、抽出、削除)がお住まいの地域の規則における合理性の基準を満たしているかどうかです。これまでのところ、ほとんどの州弁護士会の意見では、データ保持がない一時的なクラウド処理は、弁護士がベンダーのデータ取り扱い慣行を確認している限り、合理的な技術的能力の範囲内であるとされています。
外国語の契約書や複数言語が混在する条項の場合はどうですか?
視覚言語モデルは、ドイツ語、フランス語、スペイン語、ポルトガル語、日本語、韓国語を含む複数の言語をサポートしています。フランス語で書かれた契約書は、フランス語のフィールドテキストが保持されたまま抽出されます。英語の準拠法条項と残りがドイツ語の契約書は、両方とも抽出されます。同じ契約書内の複数言語の文書もサポートされていますが、特に言語の切り替わり付近に現れるフィールドでは、単一言語の文書よりも精度が若干低くなる場合があります。
ClioやMyCaseなどのツールとどう違うのですか?
契約抽出は、実務管理システムへの入力であり、その代替ではありません。典型的なワークフローは次のとおりです。契約フィールドをスプレッドシートに抽出する → スプレッドシートの正確性を確認し、例外をフラグ付けする → 確認済みのデータをClioのケースノート、カスタムフィールド、またはクライアントの案件ファイルに入力します。抽出は、各契約書を読み、10個のフィールドを手動でスプレッドシートに入力する必要があるデータキャプチャのステップを処理します。判断、クライアントへのアドバイス、案件管理は、あなたと実務管理ソフトウェアに委ねられます。
各契約10項目、月30件の契約、1つのスプレッドシート。ツールはあなたの業務に必要なこと以上をする必要はありません。
契約抽出を試す