SPEDの手動レビューがブラジルの会計担当者に
想像以上に多くの時間を費やさせる理由
毎年、6月30日のデジタル会計帳簿(ECD)の期限と7月31日のデジタル税務帳簿(ECF)の期限が近づく数週間、ブラジル中の会計チームは同じ作業に取り組みます。公式バリデーションプログラム(PVA)でECDファイルを開き、.txtコピーをエクスポートし、パイプ区切りでExcelにインポートして、手動レビューを開始します。目的は分析ではありません。確認です。システムが提出しようとしているデータに、税務調査、罰則、または提出を遅らせる直前の修正を引き起こす可能性のある重大な不整合がないかをチェックするのです。
この記事はSPEDの申告方法についてではありません。中堅企業が毎年40〜80時間を費やす手動レビューの工程がそもそもなぜ存在するのか、SPED形式のどのような構造的特徴が標準的なツールではその工程を避けられなくしているのか、そして「ただ早く始めるだけ」では完全な答えにならない理由について解説します。
刻々と迫る時計:SPEDの年間カウントダウン
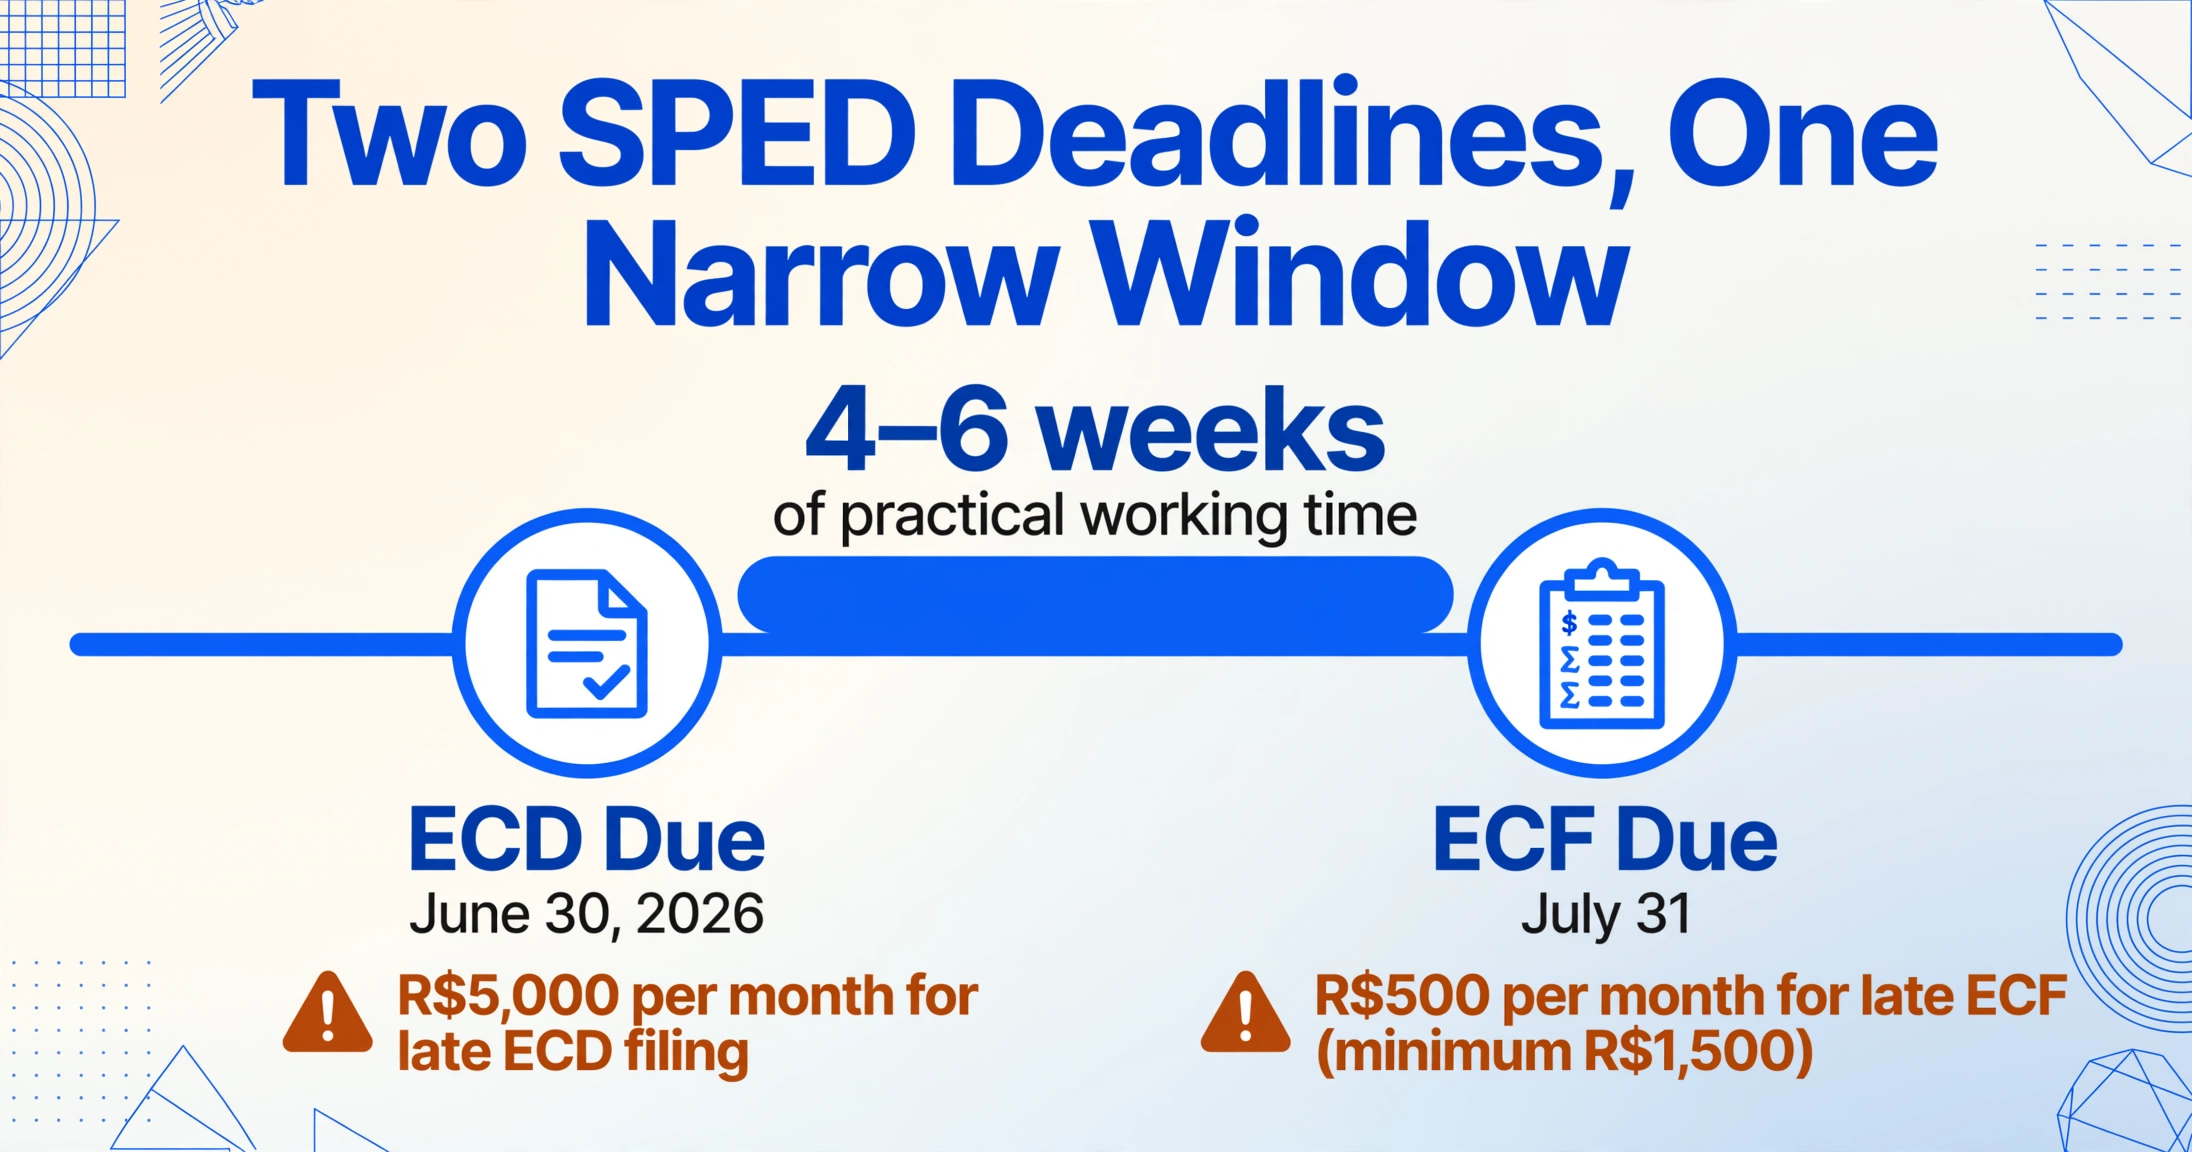
このスケジュールは意図的にタイトに設計されています。ECDは前暦年分について6月の最終営業日が期限です。2025年暦年分のデータの場合、期限は2026年6月30日です。ECFはその1か月後の7月31日が期限です。この2つの期限の間に、企業の経理チームは前年度の決算を締め、ECDファイルを生成・検証して提出し、さらにECDの出力を基盤としてECFの税額計算を行う必要があります。つまり、ECD提出からECF期限までの実働期間はおよそ4〜6週間しかなく、その間にチームはECDデータの整合性と、ECF調整額が正しく導出されていることを確認する手動レビューも並行して行わなければなりません。
どちらかの期限を逃した場合の結果は自動的に決まります。ECDの遅延申告は月額R$5,000、ECFの遅延申告は法律第10.426/2002号に基づき月額R$500(最低R$1,500)です。しかし、罰金は全体像の一部にすぎません。遅延や不整合のある申告は税務監査の対象に指定される可能性を高めます。その結果生じるコストは、直接的な専門家報酬と間接的な経営陣の時間の両面で、月額の罰金をはるかに上回ります。
したがって、このプレッシャーは人為的なものではありません。構造的なものなのです。期限にはほとんど余裕がなく、罰金は現実に課され、手動レビューはファイル内のデータとレセイタ・フェデラルが見るデータの間にある唯一の防衛線なのです。
「データは正しい」確認に40〜80時間かかる理由
手動によるSPEDレビューがこれほど時間を要する理由を理解するには、中規模企業のECDファイルに実際に何が含まれているかを確認する必要があります。このファイルは、公的デジタル会計システム(Sistema Público de Escrituração Digital、略してSPED)のレイアウト仕様(現在はECDがレイアウチ9、ECFがレイアウチ12)に従って構造化されたプレーンテキスト文書です。各行は、保持するレコードの種類を識別するレジストロコードで始まります。一般的なファイルは80,000〜150,000行に及びます。
手動レビュー担当者の仕事は、すべての行を読むことではありません。主要なレジストログループ(試算表(C155)、勘定科目表(C050)、決算残高(C157)、仕訳サマリー(I200/I250))が内部的に整合していること、およびECFの税務調整(e-Lalur用のM300、e-Lacs用のM350)が基礎となるECDデータと一致していることを検証することです。実際には、ファイルからデータのサブセットを抽出し、合計を相互参照し、特定の勘定残高をあるセクションから別のセクションへ追跡することを意味します。
SPED形式の3つの構造的特徴により、この作業は本来あるべきよりもはるかに時間がかかります。
構造的問題1:Excelが構造化データとして読み取れない固定幅テキスト
ECDファイルはスプレッドシートではありません。各レジストロタイプがパイプ文字で区切られた特定の文字位置に独自のフィールドレイアウトを持つ固定幅テキストファイルです。パイプ区切りでテキストインポートウィザードを使用してExcelで開くと、各行が1行になりますが、各列の意味は最初の列に表示されるレジストロコードに完全に依存します。
C155レジストロ(試算表明細)には、390文字の構造内の特定の位置に、勘定科目コード、期首残高、借方移動、貸方移動、期末残高のフィールドがあります。I200レジストロ(仕訳)には、仕訳日付、仕訳番号、合計金額のフィールドがあり、まったく異なるレイアウトです。生のExcelインポートでは、両方が同じスプレッドシートに存在し、列GはC155行では「期首残高」を意味し、I200行では「仕訳合計」を意味する場合があります。スプレッドシートにはそれらを区別して扱う方法がありません。
試算表だけを抽出するために、レビュー担当者は列Aが「C155」に等しい行についてスプレッドシートをフィルタリングします。これにより、表示されるデータは試算表レコードに減りますが、列ヘッダーは依然として一般的なものです。レビュー担当者は、C155行の列Hが期首残高に対応し、列Iが借方移動に対応することを覚えているか、調べる必要があります。フィルタの1つのタイプミスやインポート中の列の配置ミスにより、もっともらしく見えるが構造的に間違っているデータセットが生成されます。時間コストはフィルタリングだけではありません。数千行をスキャンしながらフィールドレイアウトを頭の中に保持するという精神的負荷です。
構造上の問題2: 1つのファイルに40種類以上のレジストロ
ECDレイアウトは、6つのブロコ(0、C、I、J、K、9)にわたって40種類以上の異なるレジストロタイプを定義しています。各レジストロタイプには異なるフィールドレイアウトがあります。試算表(C155)を仕訳(I200)やコストセンター配分(C100)と照合する必要があるレビュー担当者は、同じファイルから3つの異なるサブセットを抽出し、それぞれに異なる列マッピングを適用し、それらの合計を手動で調整する必要があります。
ECFはさらに複雑さを増します。そのレジストロ構造には、ブロコE(回復されたECDデータ)、ブロコM(e-Lalurおよびe-Lacs調整)、ブロコY(関連当事者および移転価格情報)が含まれます。ECFのM300レジストロ(e-Lalur Part A調整)は、ECDのC050勘定科目表の特定の勘定コードを参照します。これは、レビュー担当者が2つの独立した.txtファイルを開き、それぞれから一致するサブセットを抽出し、手動で整合性を検証する必要があるファイル間依存関係です。
PVAによる検証では、このファイル間の整合性はチェックされません。PVAは、各ファイルがレイアウト仕様を満たしていることを検証します。勘定4.01.01のECDの期末残高が、ECFのE010回復レコードに引き継がれた期首残高と一致するかどうかは検証しません。その検証は完全に人間のレビュー担当者に委ねられています。
構造上の問題3: PVAにファイル間検証機能が組み込まれていない
これはSPEDエコシステムにおける最も重大なギャップです。ECDおよびECF用のProgramas Validadores e Assinadores(PVA)は独立しています。各ファイル内の構文、フィールド範囲、レジストロの順序を検証します。2つのファイル間のデータを相互参照することはありません。特定の勘定のECDの期末残高が、ECFがブロコEで回復した期首残高と異なる場合の不整合をフラグすることはありません。ECFのM300調整がECDの会計引当に対応しているかどうかもチェックしません。
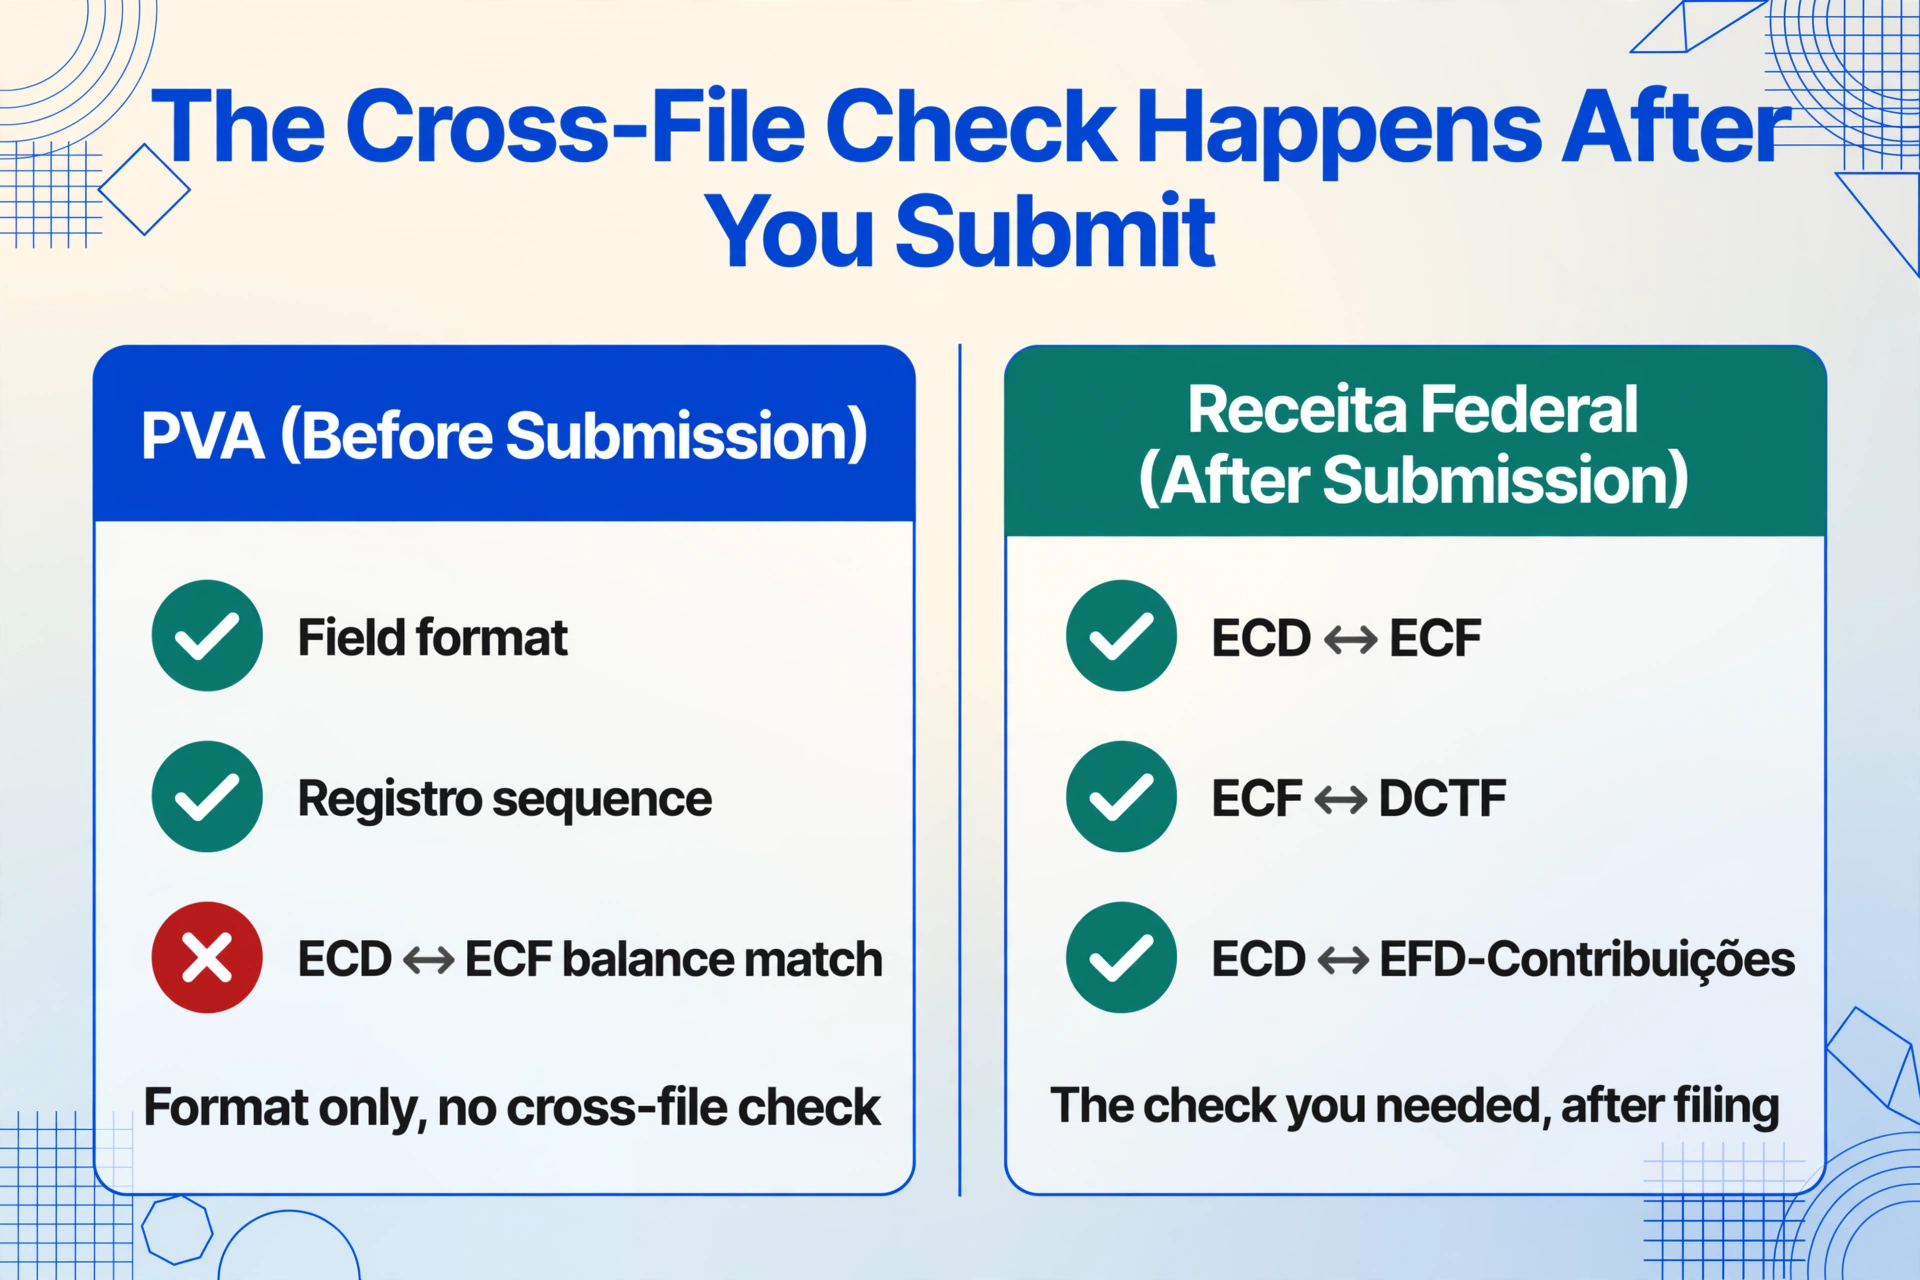
もちろん、レセイタ・フェデラルは提出後にこの相互参照を実行します。RFB独自のシステムは、2026年以降、人工知能機能で強化されたますます高度な自動クロスチェックを使用して、ECDデータをECFデータと、ECFをDCTFと、ECDをEFD-Contribuiçõesと比較します。提出後に差異が発見された場合、会社は通知を受け取り、調整が記録され、監査リスクが高まります。手動レビューは、これらの差異が恒久的な記録の一部になる前に発見して修正する唯一の機会です。
結果として、会計担当者は自動化された相互参照エンジンなら数秒で実行できる作業に何時間も費やすことになります。そしてRFBは提出境界の向こう側にすでにそのエンジンを保有しています。
連鎖的な影響:ECDレビューの遅延がECF申告に及ぼす影響
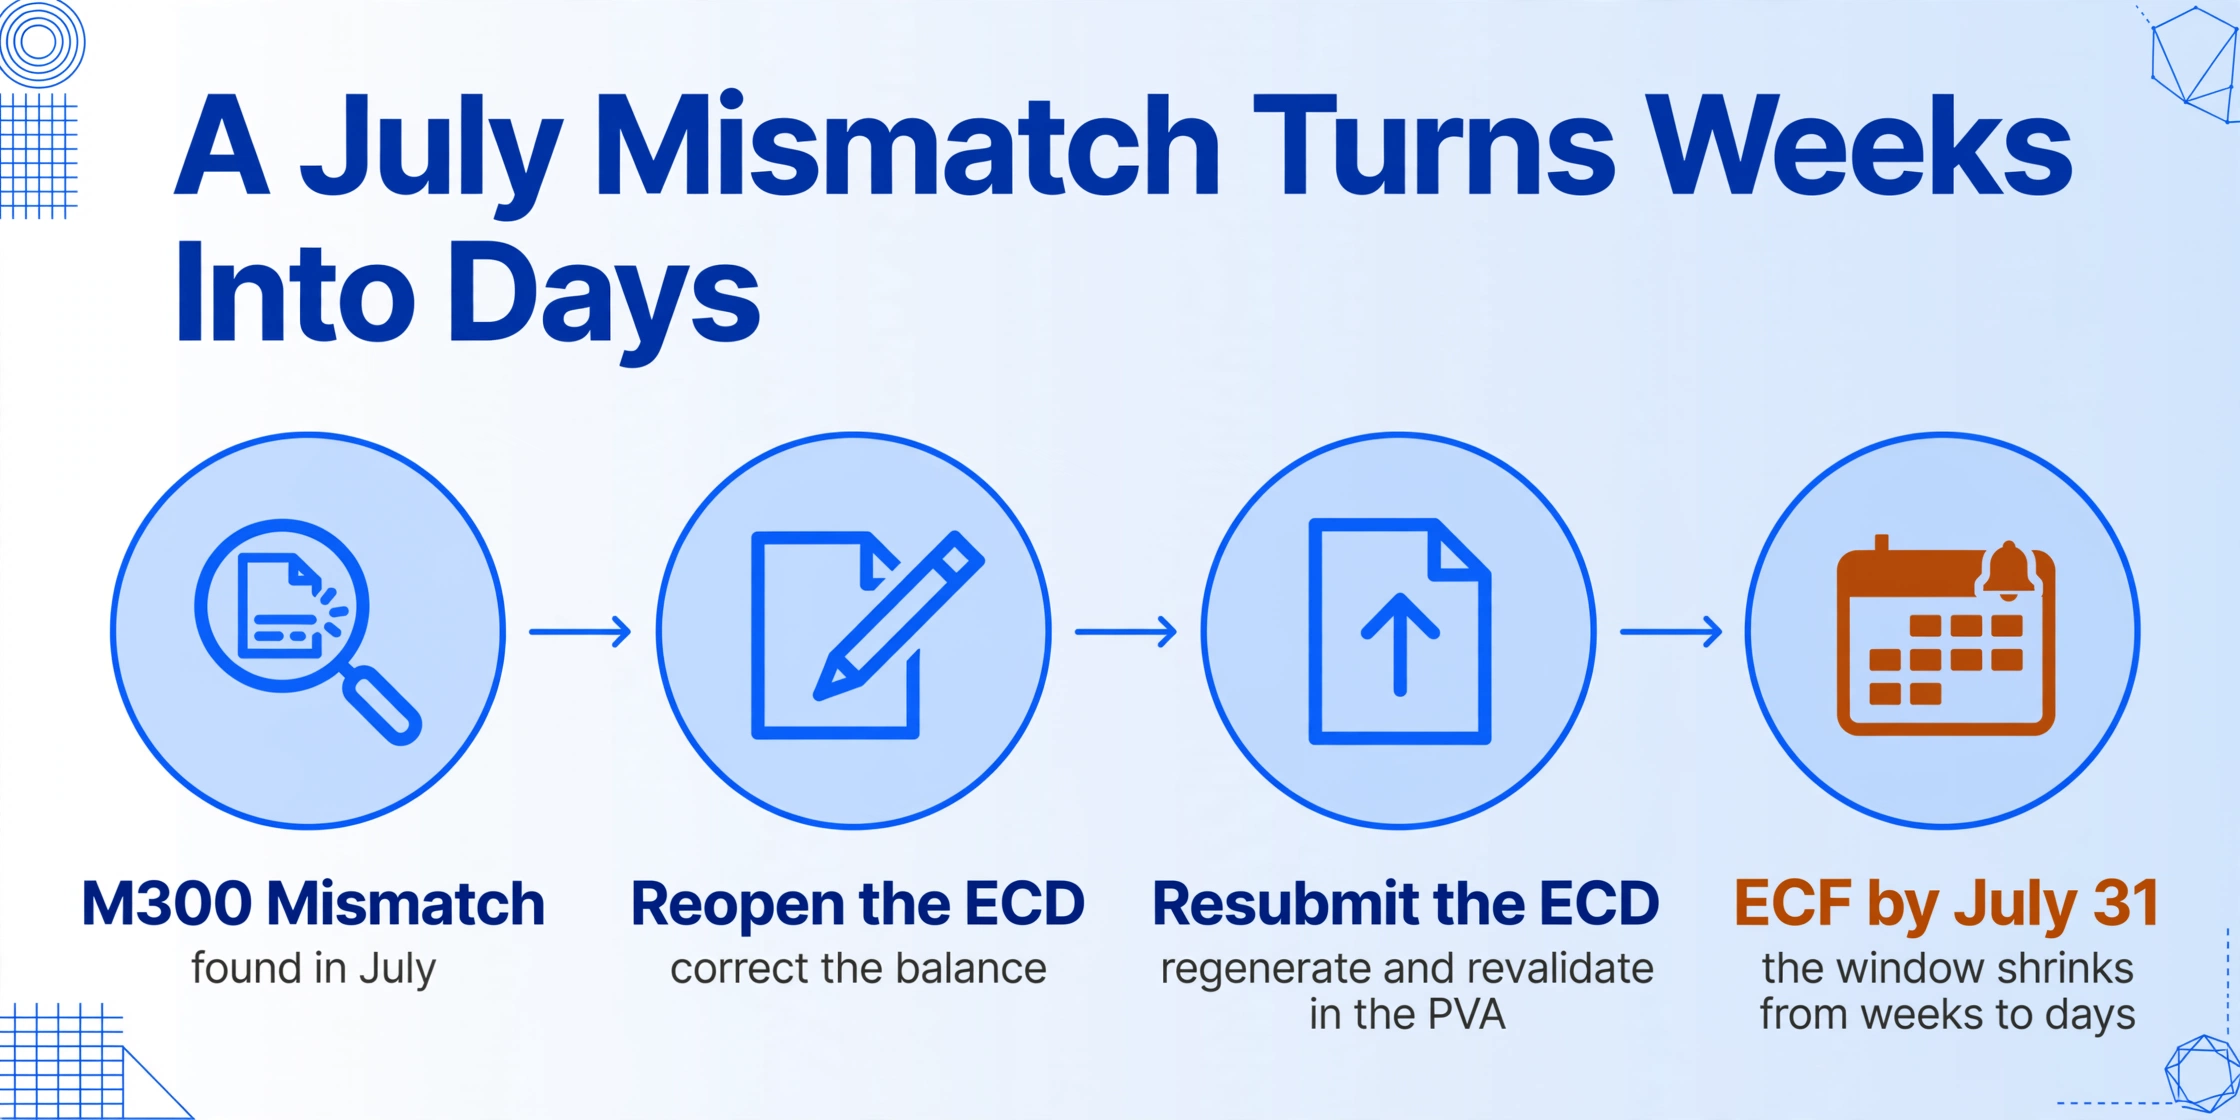
ECFは会計上の基礎をECDに依存しているため(ブロコEはECDの最終残高とマッピングされた勘定科目を復元します)、ECDレビューの遅延やエラーはECFのスケジュールに直接影響します。ECF準備中に修正が必要な問題(「このM300調整が対応するECD勘定科目と一致しない」など)が見つかった場合、ECDファイルを再オープンし、修正を行い、代替ECDファイルを生成し、PVAで再検証してから再送信し、その後ようやくECFを続行できます。この連鎖的な手戻りは、SPEDサイクルにおける土壇場でのストレスの最大の原因です。
実際には、7月の第2週にECD↔ECFの不整合を発見した企業は、ECFを確定する前にECDの修正を処理する必要があり、両方とも7月31日までに提出しなければならないという、時間的に厳しい状況に直面します。作業期間は数週間から数日に短縮され、修正のたびにファイルの別の場所で新たな不整合が発生するリスクが伴います。
業界の動向(そして手動レビューが続く理由)
レセイタ・フェデラルは、ファイル間分析機能に投資しています。2026年に導入されるAI強化データクロスチェック(複数のブラジルのアドバイザリー企業が報告)は、提出側ツールができることと、RFBの提出後分析ができることのギャップが広がっていることを示しています。しかし、納税者側では、提出前レビューに利用できるツールは追いついていません。PVAは形式を検証します。Excelはレジストロコードでフィルタリングします。その間のすべて、つまりデータが一貫性があり、完全で、ファイル間で照合可能であるという実際の検証は、依然として手動です。
この非対称性こそが、会計担当者がSPEDレビューに数週間を費やす根本的な理由です。彼らが遅い、または準備不足だからではなく、この形式が会社の最も重要な財務データを、構造が異なる複数のテキストファイルに分散させ、利用可能なツールは、読者がフィールドレイアウトとファイル間の関係を頭に入れながら数万行をスキャンすることを前提としているからです。これは、外から見ると準備の問題のように見える形式の問題であり、その違いが重要なのは、解決策が構造的であり、動機付けの問題ではないからです。
重要な洞察: SPEDの手動レビューの問題は、「期限までの時間が足りない」という問題ではありません。レジストロの種類が多すぎること、ファイル間の参照が少なすぎること、そしてPVAの形式検証と人間のレビュアーの目との間に分析ツールがまったくないことが問題です。バイトオフセットではなく意味によって複数のレジストロタイプを読み取り、同じセッションで任意のSPEDファイルから構造化テーブルを生成できるツールは、便利なものではありません。それは、構造的な問題に対する構造的な答えです。
よくある質問
Q: 中規模企業の場合、ECDの完全な手動レビューには通常どのくらいの時間がかかりますか?
報告された会計事務所のワークフローによると、ECDデータが80,000行から150,000行ある企業のECD↔ECFクロスリファレンスレビュー全体には、年間8〜12時間かかります。3年間の比較期間の場合、クロスリファレンスのステップだけで合計30時間を超え、初期のデータ抽出とフォーマット作業は含まれません。
Q: PVAはデータの不整合を検出しますか?
PVAは構文とフォーマットの準拠(フィールドタイプ、必須レジストロ、シーケンス順序)を検証します。異なるレジストロタイプ間、またはECDファイルとECFファイル間の意味論的なクロスチェックは実行しません。前期の期末残高と一致しない期首残高を持つC155レコードは、フィールドフォーマットが正しければ、PVA検証を通過します。
Q: 手動レビュー中に見つかる最も一般的な不整合は何ですか?
最も頻繁に見られる問題は、ブロコE(E010)におけるECDの期末残高とECFの回収残高の不一致、基礎となる会計引当に対するM300調整額の誤り、そしてE015マッピング勘定テーブルにおけるクロスリファレンスの欠落です。これらはすべて、PVAでは検出されないファイル間の不整合です。
Q: 会社がSPEDモジュールを備えた主要なERPを使用している場合でも、手動レビューは必要ですか?
はい。ERPモジュール(SAP TDF、Oracle NetSuite Brazil Localization、Senior、Domínio)は、会社のトランザクションデータからECDおよびECFファイルを生成します。生成されたECDとECFの出力間のファイル間整合性チェックは実行しません。ファイル生成は自動化されていますが、データ検証は自動化されていません。手動レビューのステップは、生成ツールの機能ではなく、SPEDフォーマット自体の機能です。
Q: ECF提出後に不整合が見つかった場合はどうなりますか?
会社は修正データを添えて修正済みECF(ECF retificadora)を提出します。レセイタ・フェデラルは、リスクスコアリングプロセスの一環として、元の申告と修正された申告を比較します。頻繁な修正、または大きな金額変更を伴う修正は、会社の監査リスクスコアを引き上げます。RFBのクロスリファレンスエンジンは、提出されたECD、ECF、DCTF、およびEFD-Contribuiçõesデータ間の不一致を自動的にフラグ付けします。
Q: AI抽出ツールはSPEDの手動レビュー時間の短縮に役立ちますか?
カスタム列抽出を使用するImageToTable.aiのようなツールは、レビューのデータ準備部分(試算表、e-Lalur調整、およびECDおよびECFファイルからのクロスリファレンステーブルを構造化されたExcelテーブルに抽出すること)を数時間から数分に短縮できます。レビュー担当者は引き続き専門的な判断を適用しますが、混在するレジストロタイプを含む生のパイプ区切りテキストではなく、クリーンなデータに対して行います。時間の節約は、現在レビューサイクルの大部分を占めているフィルタリング、列の再マッピング、および構造クリーンアップのステップを排除することから生まれます。
期限を超えて — より良いツールに値するプロセス
毎年のSPEDレビューサイクルは、基本的なミスマッチを明らかにします。データが存在する形式と、それを検証するために使用するツールは、異なる目的で設計されています。SPED形式は機械検証用に設計されました — 固定長フィールド、レジストロコード、パイプ区切り文字、すべてパーサー向けに最適化されています。ほとんどの会計担当者がレビューに使用するツールは汎用の表計算ソフトであり、レジストロの種類に関係なくすべての行を同じように扱います。レビュー担当者は両者のギャップを埋める必要があり、その橋渡し作業こそが毎年40〜80時間を費やす原因です。
このギャップを埋めることは、技術的な意味では難しくありません。機械的に反復的です:フィルター、確認、マッピング、検証、別のレジストロコードで再フィルター、繰り返し。抽出ステップがレジストロタイプをフィルターではなく意味で理解すれば、この作業は不要になります。6月〜7月の期限サイクルに直面するブラジルの会計チームにとって、問題は手動レビューが必要かどうかではなく、その前段階のデータ準備に利用可能な時間の大半を費やす必要があるかどうかです。