Warum die manuelle SPED-Prüfung brasilianische Buchhalter
Mehr Zeit kostet, als die meisten glauben
Jedes Jahr, in den Wochen vor der Frist am 30. Juni für die digitale Buchführung (Escrituração Contábil Digital, kurz ECD) und der Frist am 31. Juli für die digitale Steuerbuchführung (Escrituração Contábil Fiscal, kurz ECF), finden sich Buchhaltungsteams in ganz Brasilien im selben Rhythmus wieder: die ECD-Datei im offiziellen Validierungsprogramm (Programa Validador e Assinador, kurz PVA) öffnen, eine .txt-Kopie exportieren, sie mit Pipe-Trennzeichen in Excel importieren und mit der manuellen Prüfung beginnen. Das Ziel ist keine Analyse. Es ist die Bestätigung – die Prüfung, dass die Daten, die das System einreichen will, keine wesentlichen Unstimmigkeiten aufweisen, die eine Steuerprüfung, eine Strafe oder eine Last-Minute-Korrektur auslösen könnten, die die Einreichung verzögert.
In diesem Artikel geht es nicht darum, wie die SPED eingereicht wird. Es geht darum, warum der manuelle Prüfschritt – der für ein mittelständisches Unternehmen jedes Jahr 40 bis 80 Stunden in Anspruch nimmt – überhaupt existiert, welche strukturellen Merkmale des SPED-Formats ihn mit Standardwerkzeugen unvermeidbar machen und warum „einfach früher anfangen“ keine vollständige Antwort ist.
Die Uhr, die weiter tickt: SPEDs jährlicher Countdown
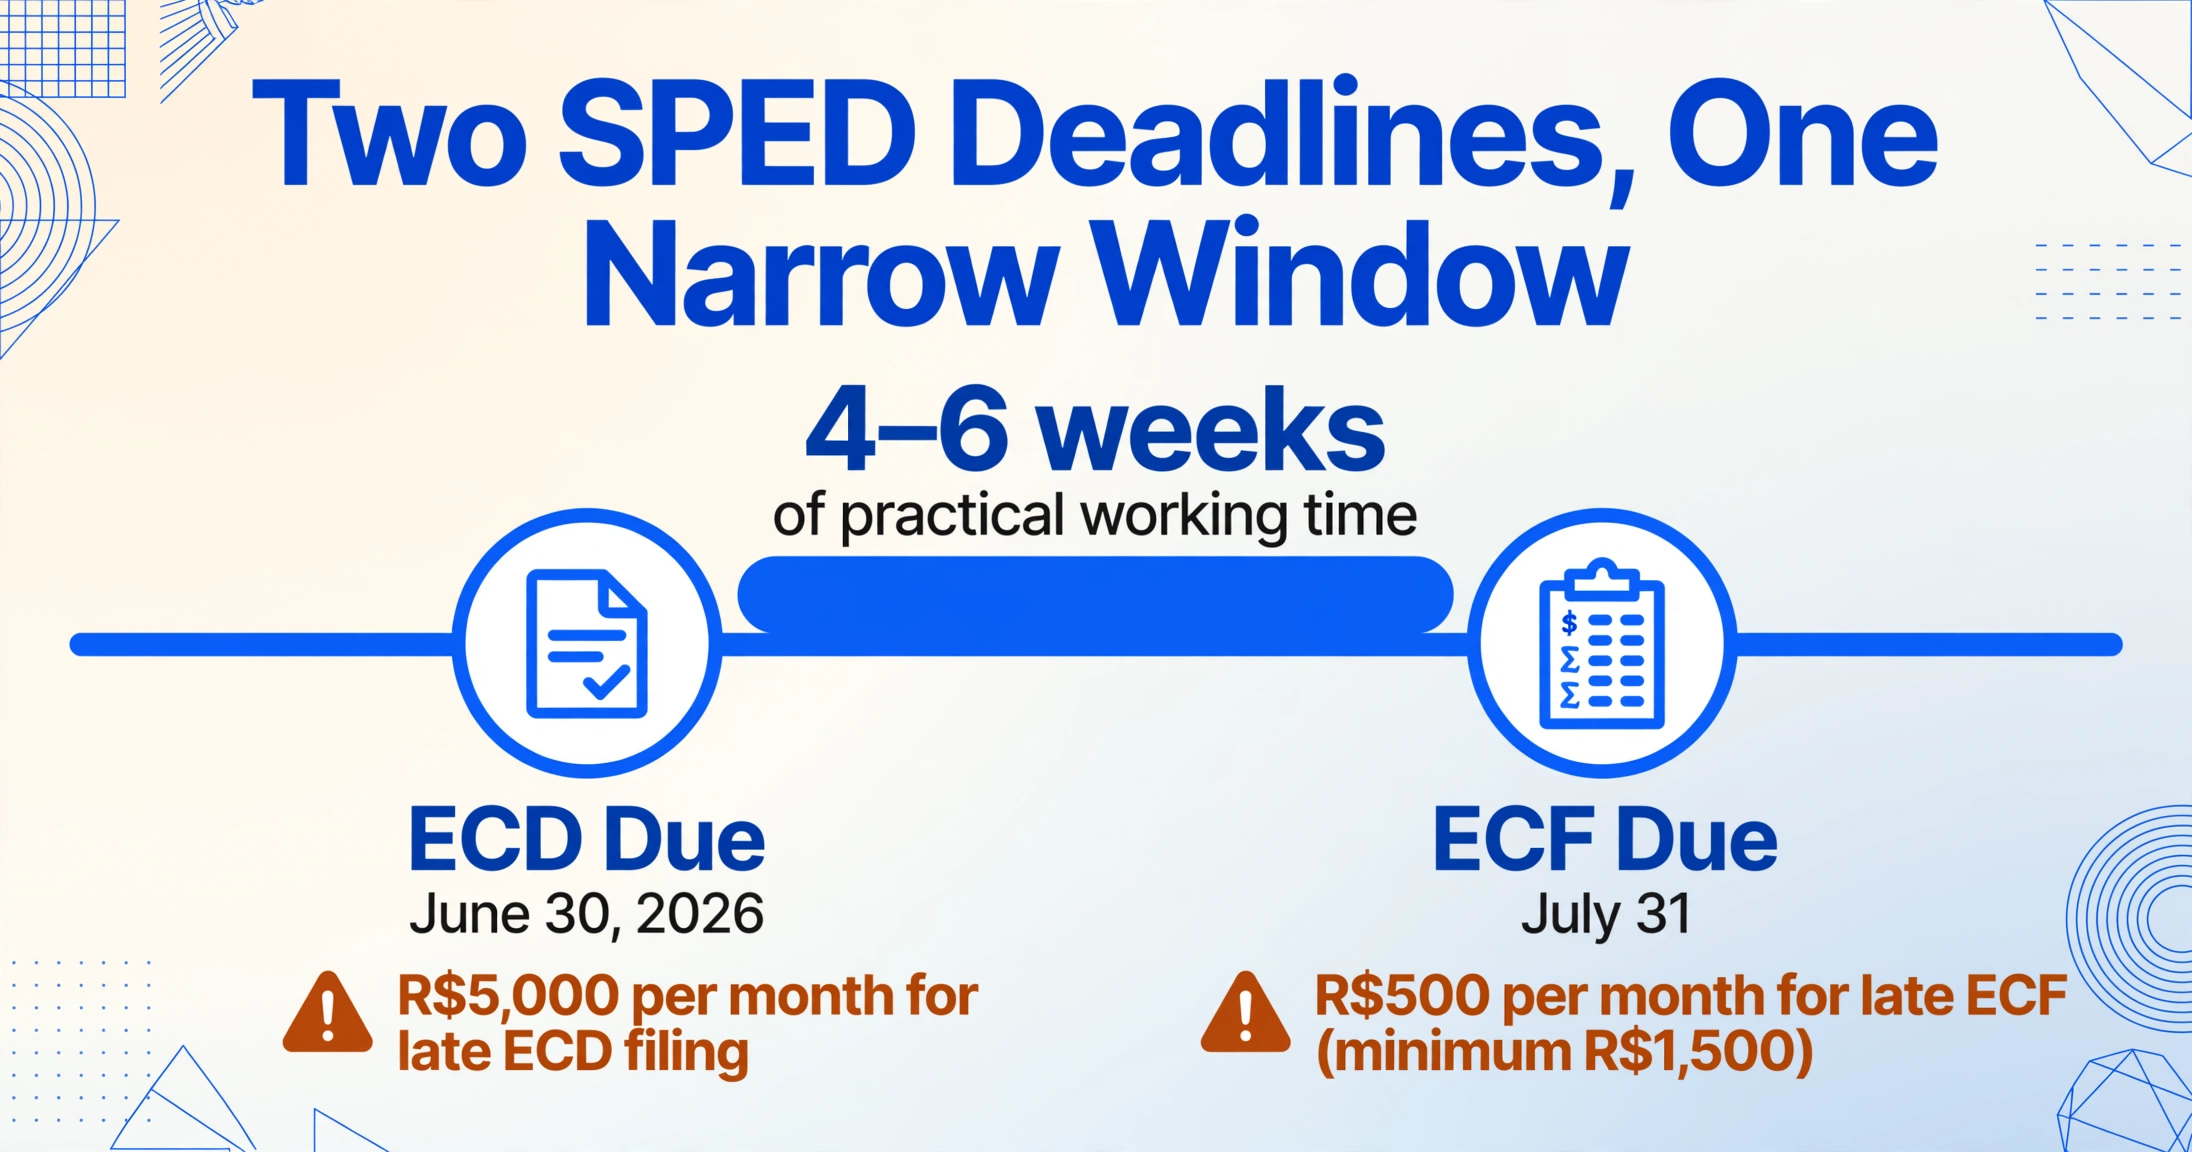
Die Zeitleiste ist von Natur aus eng. Die ECD ist bis zum letzten Werktag im Juni für das vorangegangene Kalenderjahr fällig – der 30. Juni 2026 für die Daten des Kalenderjahres 2025. Die ECF folgt einen Monat später, am 31. Juli. Zwischen den beiden Fristen muss das Buchhaltungsteam eines Unternehmens die Bücher für das Vorjahr abschließen, die ECD-Datei erstellen und validieren, sie einreichen und dann die Ausgabe der ECD als Grundlage für die Steuerberechnung der ECF verwenden. Dies lässt ungefähr vier bis sechs Wochen praktischer Arbeitszeit zwischen der ECD-Einreichung und der ECF-Frist – und in diesen Wochen führt das Team auch die manuelle Prüfung durch, die bestätigt, dass die ECD-Daten konsistent sind und die ECF-Anpassungen korrekt daraus abgeleitet wurden.
Die Folge des Verpassens einer der beiden Fristen ist automatisch: R$5.000 pro Monat für die verspätete ECD-Einreichung, plus R$500 pro Monat (mindestens R$1.500) für die verspätete ECF-Einreichung gemäß Gesetz Nr. 10.426/2002. Aber Strafen erzählen nur einen Teil der Geschichte. Eine verspätete oder inkonsistente Einreichung erhöht die Wahrscheinlichkeit, für eine Steuerprüfung markiert zu werden – ein Ergebnis, dessen Kosten die monatliche Geldstrafe bei weitem übersteigen, sowohl in direkten professionellen Gebühren als auch in indirekter Ablenkung des Managements.
Der Druck ist also nicht künstlich. Er ist strukturell: Die Fristen lassen wenig Spielraum, die Strafen sind real, und die manuelle Prüfung ist die einzige Sicherung zwischen den Daten, wie sie in der Datei stehen, und den Daten, wie die Receita Federal sie sehen wird.
Warum „Die Daten sind korrekt“ 40 bis 80 Stunden Bestätigung erfordert
Um zu verstehen, warum die manuelle SPED-Prüfung so viel Zeit in Anspruch nimmt, muss man sich ansehen, was die ECD-Datei eines mittelständischen Unternehmens tatsächlich enthält. Die Datei ist ein reines Textdokument, das gemäß der Layout-Spezifikation des Öffentlichen Digitalen Buchführungssystems (Sistema Público de Escrituração Digital, oder SPED) strukturiert ist — derzeit Leiaute 9 für ECD und Leiaute 12 für ECF. Jede Zeile beginnt mit einem Registro-Code, der die Art des Datensatzes identifiziert. Eine typische Datei umfasst 80.000 bis 150.000 Zeilen.
Die Aufgabe eines manuellen Prüfers besteht nicht darin, jede Zeile zu lesen. Es geht darum, zu verifizieren, dass die wichtigsten Registro-Gruppen — die Saldenbilanz (C155), der Kontenplan (C050), die Abschlusssalden (C157), die Journaleintrag-Zusammenfassungen (I200/I250) — intern konsistent sind und dass die Steueranpassungen der ECF (M300 für e-Lalur, M350 für e-Lacs) mit den zugrunde liegenden ECD-Daten übereinstimmen. In der Praxis bedeutet dies, Teilmengen aus der Datei zu extrahieren, Summen abzugleichen und bestimmte Kontosalden von einem Abschnitt zum anderen nachzuverfolgen.
Drei strukturelle Merkmale des SPED-Formats machen diese Arbeit weitaus zeitaufwändiger, als sie sein sollte.
Strukturelles Problem 1: Festbreiten-Text, den Excel nicht als strukturierte Daten lesen kann
Eine ECD-Datei ist keine Tabellenkalkulation. Sie ist eine Festbreiten-Textdatei, bei der jeder Registro-Typ sein eigenes Feldlayout an bestimmten Zeichenpositionen hat, getrennt durch Pipe-Zeichen. Wenn man sie in Excel mit dem Textimport-Assistenten und Pipe-Trennzeichen öffnet, wird jede Zeile zu einer Tabellenzeile — aber die Bedeutung jeder Spalte hängt vollständig davon ab, welcher Registro-Code in der ersten Spalte erscheint.
Ein C155-Registro (Saldenbilanz-Detail) hat Felder für Kontocode, Eröffnungssaldo, Soll-Bewegung, Haben-Bewegung und Abschlusssaldo an bestimmten Positionen innerhalb seiner 390-Zeichen-Struktur. Ein I200-Registro (Journaleintrag) hat Felder für Buchungsdatum, Buchungsnummer und Gesamtbetrag — ein völlig anderes Layout. Im rohen Excel-Import sitzen beide in derselben Tabelle, und Spalte G könnte für eine C155-Zeile „Eröffnungssaldo“ und für eine I200-Zeile „Journalgesamtbetrag“ bedeuten. Die Tabellenkalkulation hat keine Möglichkeit, sie unterschiedlich zu behandeln.
Um nur die Saldenbilanz zu extrahieren, filtert der Prüfer die Tabelle nach Zeilen, bei denen Spalte A gleich „C155“ ist. Dies reduziert die sichtbaren Daten auf Saldenbilanz-Datensätze, aber die Spaltenüberschriften bleiben generisch — der Prüfer muss sich merken oder nachschlagen, dass Spalte H in einer C155-Zeile dem Eröffnungssaldo entspricht, während Spalte I der Soll-Bewegung entspricht. Ein einziger Tippfehler im Filter oder eine falsch platzierte Spalte während des Imports erzeugt einen Datensatz, der plausibel aussieht, aber strukturell falsch ist. Der Zeitaufwand liegt nicht nur im Filtern. Es ist der mentale Aufwand, das Feldlayout im Kopf zu behalten, während man Tausende von Zeilen durchsucht.
Strukturproblem 2: Über 40 Registro-Typen in einer einzigen Datei
Das ECD-Layout definiert über 40 verschiedene Registro-Typen in sechs Blocos (0, C, I, J, K und 9). Jeder Registro-Typ hat ein anderes Feldlayout. Ein Prüfer, der die Saldenliste (C155) mit den Journalbuchungen (I200) und den Kostenstellenverteilungen (C100) abgleichen muss, muss drei verschiedene Teilmengen aus derselben Datei extrahieren, jede mit eigenem Spaltenmapping, und dann die Summen manuell über alle abgleichen.
Der ECF fügt eine weitere Komplexitätsebene hinzu. Seine Registro-Struktur umfasst Bloco E (wiederhergestellte ECD-Daten), Bloco M (e-Lalur- und e-Lacs-Anpassungen) und Bloco Y (Informationen zu verbundenen Parteien und Verrechnungspreisen). Das M300-Registro des ECF (e-Lalur Teil-A-Anpassungen) verweist auf spezifische Kontonummern aus dem C050-Kontenplan des ECD – eine dateiübergreifende Abhängigkeit, die den Prüfer zwingt, zwei unabhängige .txt-Dateien zu öffnen, passende Teilmengen aus jeder zu extrahieren und die Konsistenz manuell zu überprüfen.
Keine vom PVA durchgeführte Validierung prüft diese dateiübergreifende Konsistenz. Der PVA validiert, dass jede einzelne Datei dem Layout-Spezifikation entspricht. Er prüft nicht, ob der Endsaldo des ECD für Konto 4.01.01 mit dem Anfangssaldo übereinstimmt, der in den E010-Wiederherstellungsdatensatz des ECF übernommen wurde. Diese Überprüfung bleibt vollständig dem menschlichen Prüfer überlassen.
Strukturproblem 3: Keine dateiübergreifende Validierung im PVA integriert
Dies ist die folgenreichste Lücke im SPED-Ökosystem. Die Programas Validadores e Assinadores (PVAs) für ECD und ECF sind unabhängig. Sie validieren Syntax, Feldbereiche und Registro-Reihenfolge innerhalb jeder Datei. Sie referenzieren keine Daten zwischen den beiden Dateien. Sie kennzeichnen keine Inkonsistenz, bei der der Endsaldo des ECD für ein bestimmtes Konto vom Anfangssaldo abweicht, den der ECF in Bloco E wiederhergestellt hat. Sie prüfen nicht, ob die M300-Anpassungen im ECF den buchhalterischen Rückstellungen im ECD entsprechen.
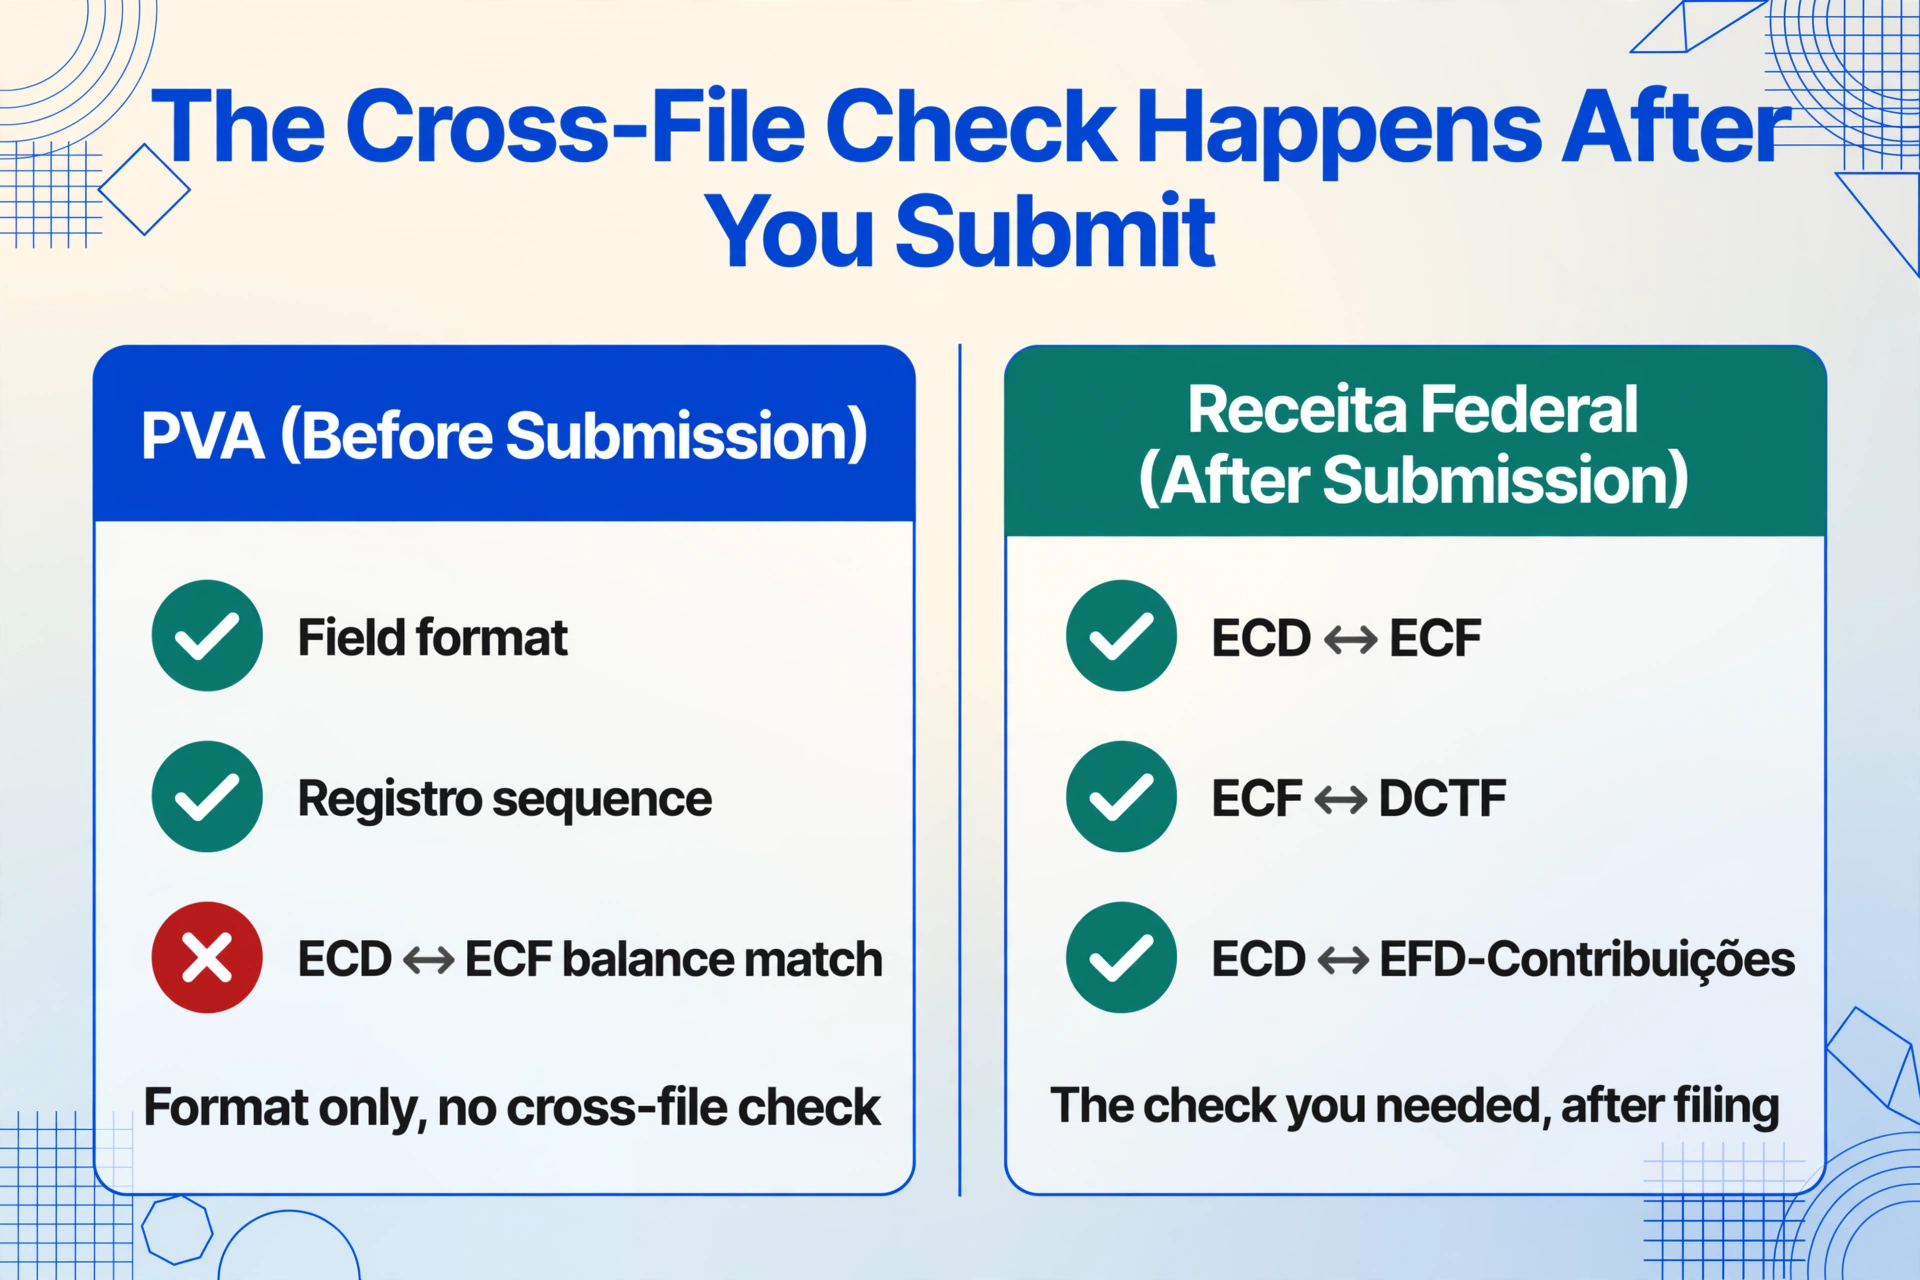
Die Receita Federal führt diese Querverweise natürlich durch – nach der Einreichung. Die eigenen Systeme der RFB vergleichen ECD-Daten mit ECF-Daten, ECF mit DCTF und ECD mit EFD-Contribuições, unter Verwendung zunehmend ausgefeilter automatisierter Querprüfungen, die seit 2026 um Funktionen künstlicher Intelligenz erweitert wurden. Wenn nach der Einreichung eine Abweichung festgestellt wird, erhält das Unternehmen eine Mitteilung, die Anpassung wird erfasst und das Prüfungsrisiko steigt. Die manuelle Prüfung ist die einzige Gelegenheit, diese Abweichungen zu erkennen und zu beheben, bevor sie Teil der dauerhaften Akte werden.
Das Ergebnis: ein Prozess, bei dem der Buchhalter Stunden mit Arbeiten verbringt, die eine automatisierte Querverweis-Engine in Sekunden erledigen könnte – und die RFB hat diese Engine bereits auf ihrer Seite der Einreichungsgrenze.
Der Kaskadeneffekt: Wenn die ECD-Prüfung die ECF-Einreichung verzögert
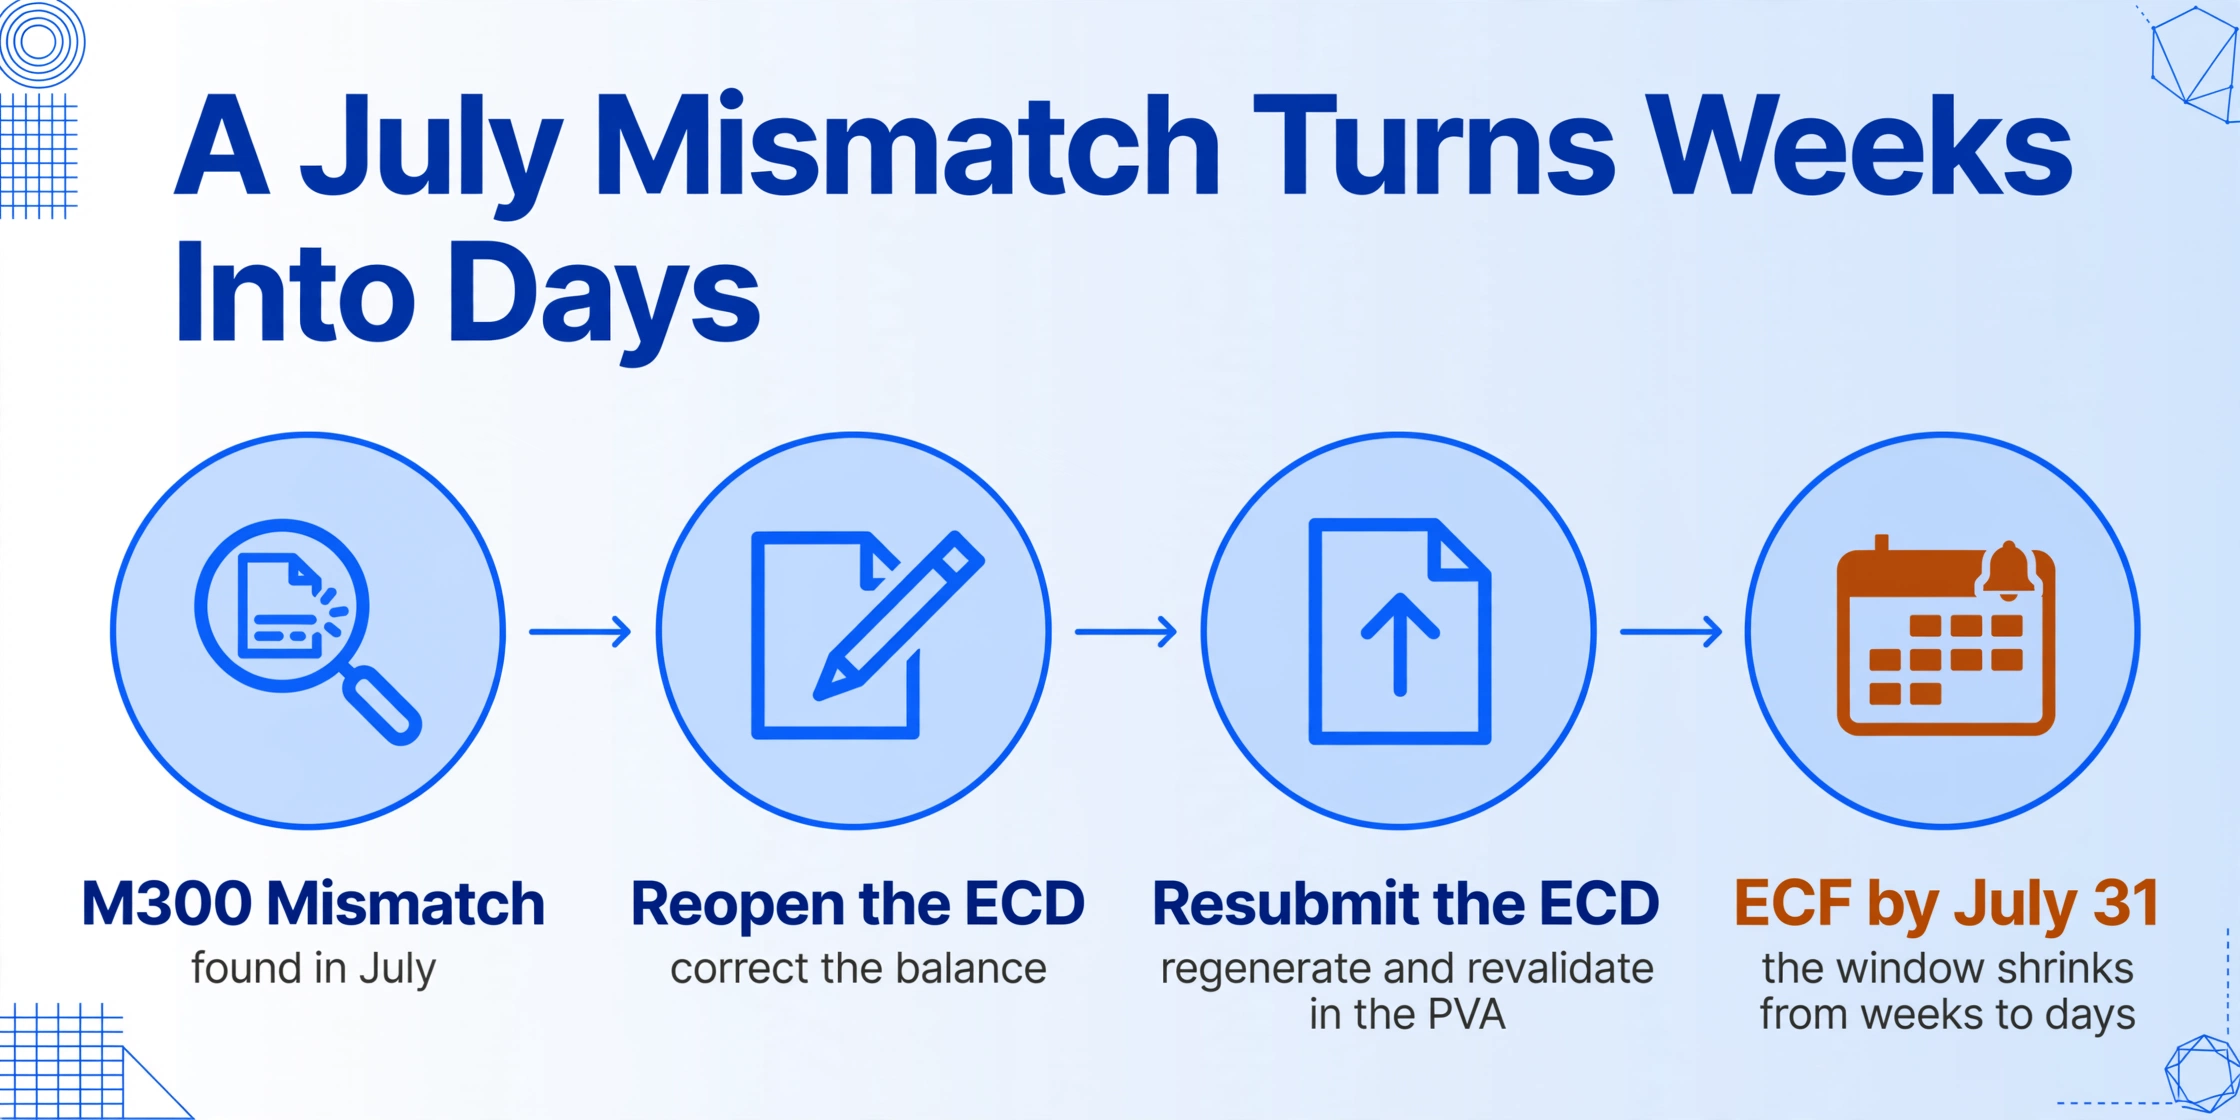
Da die ECF für ihre buchhalterische Grundlage von der ECD abhängt (der Bloco E übernimmt die Endsaldi und zugeordneten Konten der ECD), wirkt sich jede Verzögerung oder jeder Fehler bei der ECD-Prüfung direkt auf den ECF-Zeitplan aus. Eine während der ECF-Vorbereitung entdeckte Korrektur – „diese M300-Anpassung stimmt nicht mit dem entsprechenden ECD-Konto überein“ – erfordert, die ECD-Datei erneut zu öffnen, die Korrektur vorzunehmen, eine Ersatz-ECD-Datei zu generieren, sie im PVA erneut zu validieren und erneut einzureichen, bevor die ECF fortgesetzt werden kann. Diese kaskadenartige Nacharbeit ist die größte Quelle für Last-Minute-Stress im SPED-Zyklus.
In der Praxis steht ein Unternehmen, das in der zweiten Juliwoche eine ECD↔ECF-Inkonsistenz entdeckt, vor einem komprimierten Zeitplan: Die Korrektur der ECD muss verarbeitet werden, bevor die ECF finalisiert werden kann, und beide müssen bis zum 31. Juli eingereicht werden. Das Arbeitsfenster schrumpft von Wochen auf Tage, und jede Korrektur birgt das Risiko, an anderer Stelle in der Datei eine neue Inkonsistenz einzuführen.
Wohin sich die Branche entwickelt (und warum die manuelle Prüfung fortbesteht)
Die Receita Federal investiert in ihre Fähigkeiten zur dateiübergreifenden Analyse. Die Einführung KI-gestützter Datenabgleiche im Jahr 2026 (von mehreren brasilianischen Beratungsfirmen berichtet) signalisiert, dass die Kluft zwischen dem, was Tools auf Einreichungsseite leisten können, und dem, was die RFB-Analyse nach der Einreichung leisten kann, größer wird. Auf der Seite des Steuerpflichtigen haben die für die Vorab-Prüfung verfügbaren Tools jedoch nicht Schritt gehalten. Der PVA validiert das Format. Excel filtert nach Registro-Code. Alles dazwischen – die eigentliche Überprüfung, ob die Daten konsistent, vollständig und von einer Datei zur nächsten abgleichbar sind – bleibt manuell.
Diese Asymmetrie ist der grundlegende Grund, warum Buchhalter Wochen mit der SPED-Prüfung verbringen. Nicht weil sie langsam oder unvorbereitet sind, sondern weil das Format die wichtigsten Finanzdaten eines Unternehmens auf mehrere Textdateien mit unterschiedlichen Strukturen verteilt und die verfügbaren Tools vom Leser erwarten, dass er die Feldlayouts und dateiübergreifenden Beziehungen im Kopf behält, während er Zehntausende von Zeilen scannt. Es ist ein Formatproblem, das von außen wie ein Vorbereitungsproblem aussieht – und der Unterschied ist wichtig, weil die Lösung struktureller und nicht motivationaler Natur ist.
Wichtige Erkenntnis: Das Problem der manuellen SPED-Prüfung ist kein Problem von „zu wenig Zeit vor der Frist“. Es ist ein Problem von zu vielen Registro-Typen, zu wenigen dateiübergreifenden Referenzen und null analytischen Tools zwischen der Formatvalidierung des PVA und den Augen des menschlichen Prüfers. Ein Tool, das mehrere Registro-Typen nach Bedeutung lesen kann – nicht nach Byte-Offset – und in derselben Sitzung strukturierte Tabellen aus jeder SPED-Datei erzeugt, ist keine Bequemlichkeit. Es ist eine strukturelle Antwort auf ein strukturelles Problem.
Häufig gestellte Fragen
F: Wie lange dauert eine vollständige manuelle ECD-Prüfung bei einem mittelständischen Unternehmen in der Regel?
Basierend auf den gemeldeten Arbeitsabläufen von Buchhaltungskanzleien dauert eine vollständige ECD↔ECF-Abgleichsprüfung für ein Unternehmen mit 80.000 bis 150.000 Zeilen ECD-Daten 8 bis 12 Stunden pro Jahr. Bei einem Vergleichszeitraum von drei Jahren übersteigt die Gesamtprüfzeit 30 Stunden allein für den Abgleichsschritt, ohne die anfängliche Datenextraktion und Formatierungsarbeit.
F: Erkennt der PVA Dateninkonsistenzen?
Der PVA validiert die Einhaltung von Syntax und Format – Feldtypen, erforderliche Registros, Sequenzreihenfolge. Er führt keine semantischen Quervergleiche zwischen verschiedenen Registro-Typen oder zwischen ECD- und ECF-Dateien durch. Ein C155-Datensatz mit einem Eröffnungssaldo, der nicht mit dem Schlusssaldo des Vorjahres übereinstimmt, besteht die PVA-Validierung, solange das Feldformat korrekt ist.
F: Welche sind die häufigsten Inkonsistenzen, die bei der manuellen Prüfung gefunden werden?
Die häufigsten Probleme sind Abweichungen zwischen den Schlussalden des ECD und den übernommenen Salden des ECF im Bloco E (E010), Fehler bei den M300-Anpassungsbeträgen im Verhältnis zur zugrunde liegenden Buchungsrückstellung sowie fehlende Querverweise in der zugeordneten Kontentabelle E015. Dies sind alles dateiübergreifende Inkonsistenzen, die der PVA nicht erkennt.
F: Ist eine manuelle Prüfung weiterhin erforderlich, wenn das Unternehmen ein großes ERP mit SPED-Modulen verwendet?
Ja. ERP-Module (SAP TDF, Oracle NetSuite Brazil Localization, Senior, Domínio) generieren die ECD- und ECF-Dateien aus den Transaktionsdaten des Unternehmens. Sie führen keine dateiübergreifenden Konsistenzprüfungen zwischen den generierten ECD- und ECF-Ausgaben durch. Die Dateigenerierung ist automatisiert; die Datenprüfung nicht. Der manuelle Prüfschritt ist keine Funktion des Generierungstools, sondern eine Funktion des SPED-Formats selbst.
F: Was passiert, wenn nach der Einreichung des ECF eine Inkonsistenz festgestellt wird?
Das Unternehmen reicht einen Ersatz-ECF (ECF retificadora) mit den korrigierten Daten ein. Die Receita Federal vergleicht die ursprüngliche und die korrigierte Einreichung im Rahmen ihres Risikobewertungsprozesses. Häufige Korrekturen oder Korrekturen mit großen Wertänderungen erhöhen den Prüfungsrisikowert des Unternehmens. Die Querverweis-Engine der RFB kennzeichnet automatisch Unstimmigkeiten zwischen den eingereichten ECD-, ECF-, DCTF- und EFD-Contribuições-Daten.
F: Können KI-Extraktionstools dazu beitragen, die manuelle SPED-Prüfzeit zu reduzieren?
Tools wie ImageToTable.ai, die Benutzerdefinierte Spaltenextraktion verwenden, können den Datenaufbereitungsteil der Prüfung – das Extrahieren der Saldenliste, der e-Lalur-Anpassungen und der Querverweistabellen aus ECD- und ECF-Dateien in strukturierte Excel-Tabellen – von Stunden auf Minuten reduzieren. Der Prüfer wendet weiterhin professionelles Urteilsvermögen an, tut dies jedoch mit sauberen Daten anstelle von rohem, pipe-getrenntem Text mit gemischten Registro-Typen. Die Zeitersparnis ergibt sich aus der Eliminierung der Filter-, Spaltenzuordnungs- und Strukturbereinigungsschritte, die derzeit den Großteil des Prüfzyklus ausmachen.
Jenseits der Frist – Ein Prozess, der bessere Werkzeuge verdient
Der jährliche SPED-Prüfungszyklus offenbart eine grundlegende Diskrepanz: Das Format, in dem Ihre Daten vorliegen, und das Werkzeug, mit dem Sie sie prüfen, wurden für unterschiedliche Zwecke entwickelt. Das SPED-Format wurde für die maschinelle Validierung konzipiert – feste Feldbreiten, Registro-Codes, Pipe-Trennzeichen, alles optimiert für einen Parser. Das Werkzeug, das die meisten Buchhalter zur Prüfung verwenden, ist eine universelle Tabellenkalkulation, die jede Zeile unabhängig vom Registro-Typ gleich behandelt. Der Prüfer muss die Lücke zwischen beiden schließen – und diese Überbrückungsarbeit ist es, die jedes Jahr 40 bis 80 Stunden in Anspruch nimmt.
Diese Lücke zu schließen, ist technisch gesehen nicht schwierig. Es ist mechanisch repetitiv: filtern, prüfen, zuordnen, verifizieren, erneut mit einem anderen Registro-Code filtern, wiederholen. Die Arbeit entfällt, wenn der Extraktionsschritt Registro-Typen nach ihrer Bedeutung und nicht nach einem Filter versteht. Für brasilianische Buchhaltungsteams, die sich dem Prüfungszyklus im Juni-Juli stellen, stellt sich nicht die Frage, ob die manuelle Prüfung notwendig ist – sondern ob die ihr vorausgehende Datenaufbereitung den Großteil der verfügbaren Zeit in Anspruch nehmen muss.