Pourquoi la revue manuelle du SPED coûte aux comptables brésiliens
Plus de temps que la plupart ne le pensent
Chaque année, dans les semaines précédant l'échéance du 30 juin pour l'Écriture comptable numérique (Escrituração Contábil Digital, ou ECD) et celle du 31 juillet pour l'Écriture fiscale numérique (Escrituração Contábil Fiscal, ou ECF), les équipes comptables de tout le Brésil adoptent le même rythme : ouvrir le fichier ECD dans le programme officiel de validation (Programa Validador e Assinador, ou PVA), exporter une copie .txt, l'importer dans Excel avec des délimiteurs pipe, puis commencer la revue manuelle. L'objectif n'est pas l'analyse. C'est la confirmation — vérifier que les données que le système s'apprête à soumettre ne présentent aucune incohérence matérielle susceptible de déclencher un audit fiscal, une pénalité ou une correction de dernière minute qui retarderait le dépôt.
Cet article ne traite pas de la manière de déposer la SPED. Il explique pourquoi l'étape de révision manuelle — celle qui prend de 40 à 80 heures chaque année pour une entreprise de taille moyenne — existe en premier lieu, quelles caractéristiques structurelles du format SPED la rendent incontournable avec les outils standard, et pourquoi « commencer plus tôt » n'est pas une réponse complète.
L'horloge qui tourne : le compte à rebours annuel de la SPED
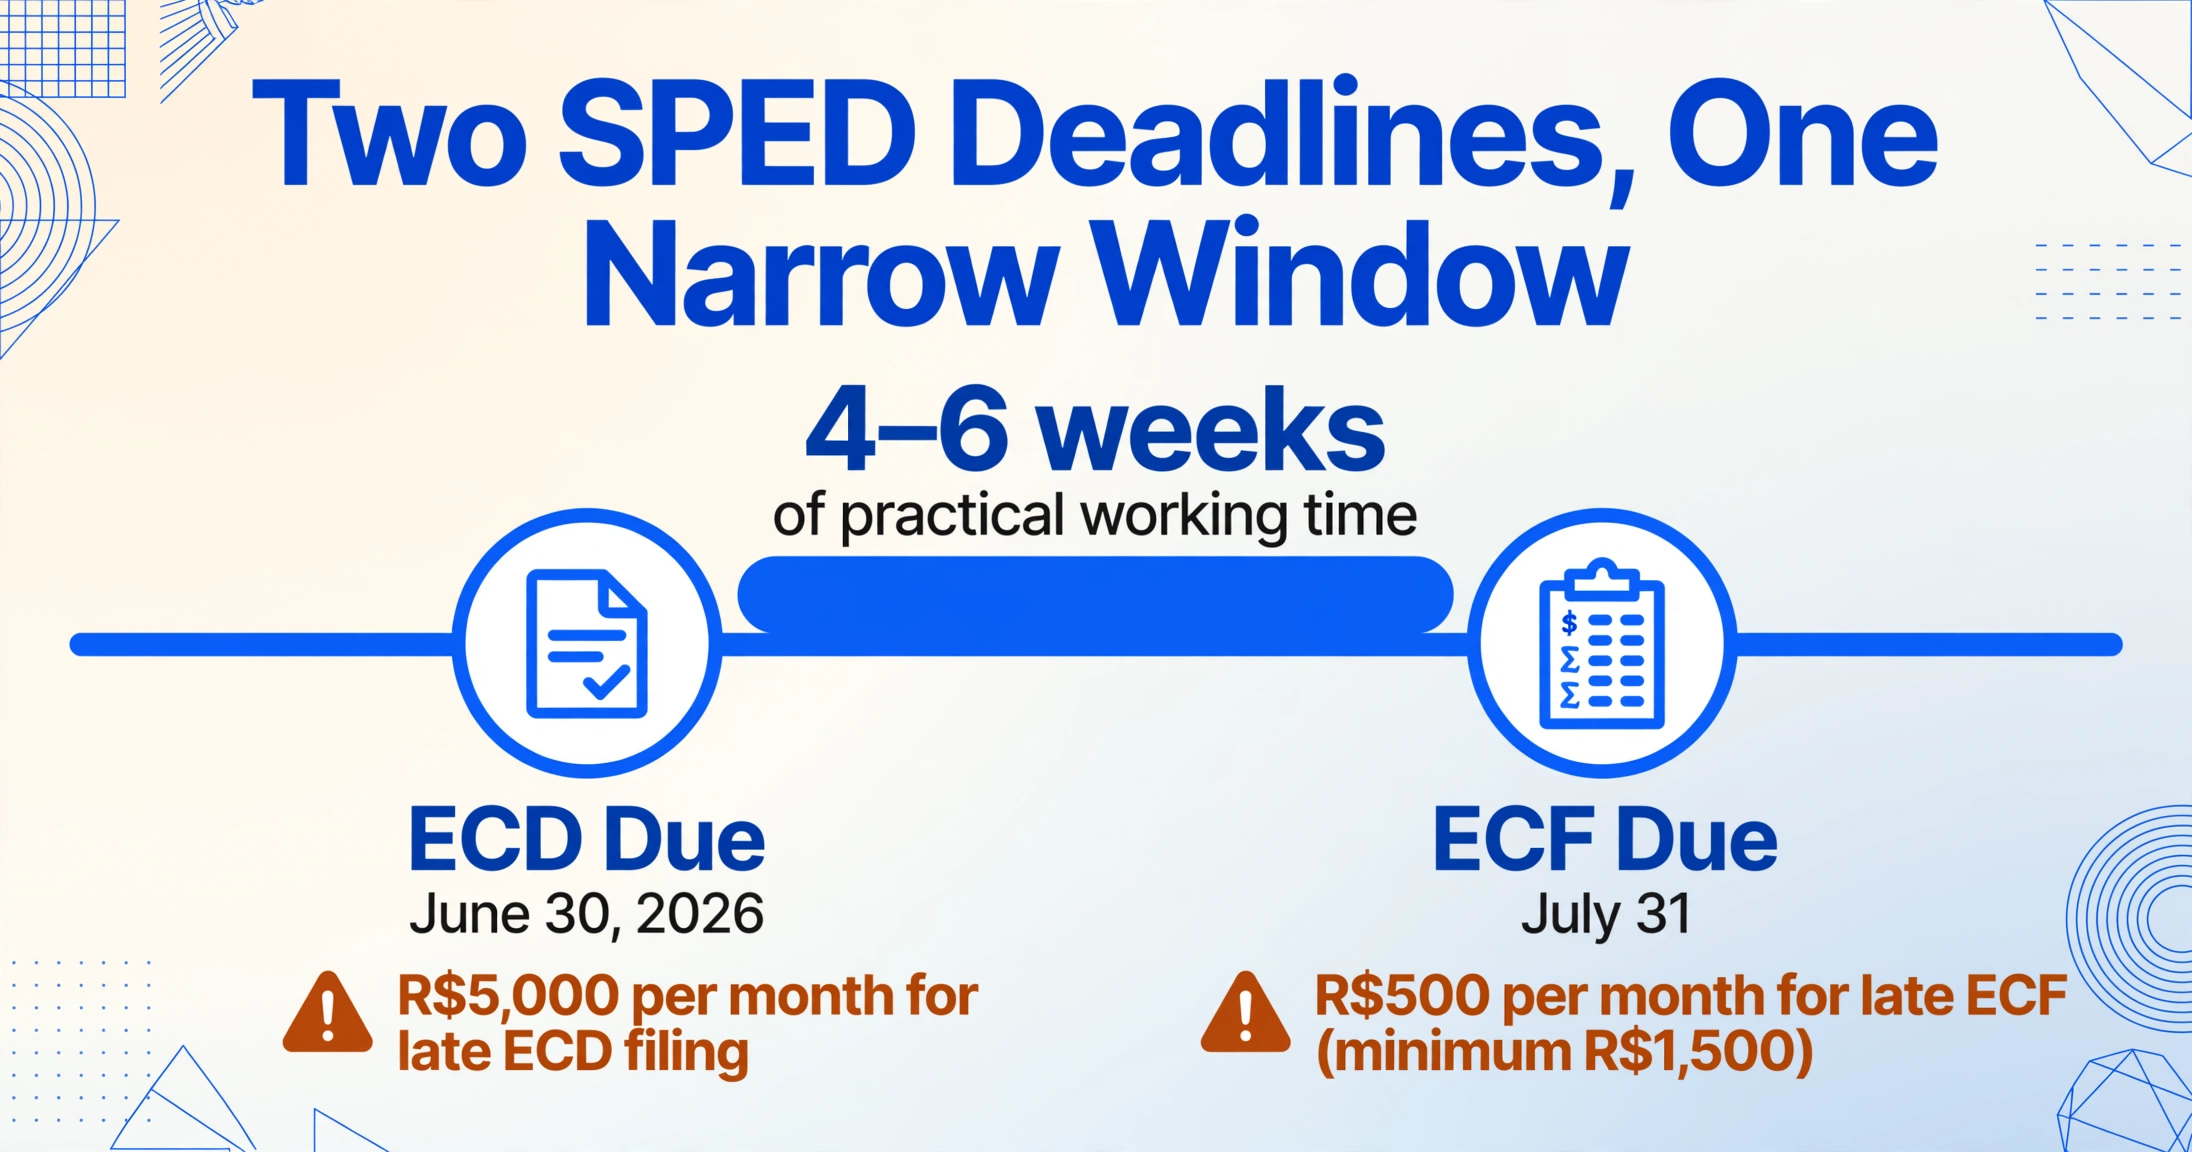
Le calendrier est serré par conception. L'ECD doit être déposée au plus tard le dernier jour ouvrable de juin pour l'année civile précédente — le 30 juin 2026 pour les données de l'année civile 2025. L'ECF suit un mois plus tard, le 31 juillet. Entre les deux échéances, l'équipe comptable d'une entreprise doit clôturer les comptes de l'année précédente, générer et valider le fichier ECD, le soumettre, puis utiliser les résultats de l'ECD comme fondement du calcul fiscal de l'ECF. Cela laisse environ quatre à six semaines de temps de travail pratique entre la soumission de l'ECD et l'échéance de l'ECF — et pendant ces semaines, l'équipe effectue également la révision manuelle qui confirme que les données de l'ECD sont cohérentes et que les ajustements de l'ECF en sont correctement dérivés.
La conséquence du non-respect de l'une ou l'autre échéance est automatique : R$5 000 par mois pour le dépôt tardif de l'ECD, plus R$500 par mois (minimum R$1 500) pour le dépôt tardif de l'ECF en vertu de la Loi n° 10.426/2002. Mais les amendes ne racontent qu'une partie de l'histoire. Une soumission tardive ou incohérente augmente la probabilité d'être signalé pour un audit fiscal — un résultat dont le coût dépasse de loin l'amende mensuelle, tant en honoraires professionnels directs qu'en distraction de gestion indirecte.
La pression, donc, n'est pas artificielle. Elle est structurelle : les échéances laissent peu de marge, les amendes sont réelles, et la révision manuelle est la seule protection entre les données telles qu'elles figurent dans le fichier et les données telles que la Receita Federal les verra.
Pourquoi « Les données sont correctes » demande 40 à 80 heures de vérification
Pour comprendre pourquoi la vérification manuelle du SPED absorbe autant de temps, il faut examiner ce que contient réellement le fichier ECD d'une entreprise de taille moyenne. Le fichier est un document texte brut structuré selon la spécification de mise en page du Système public d'écriture numérique (Sistema Público de Escrituração Digital, ou SPED) — actuellement Leiaute 9 pour l'ECD et Leiaute 12 pour l'ECF. Chaque ligne commence par un code Registro qui identifie le type d'enregistrement qu'elle porte. Un fichier type compte 80 000 à 150 000 lignes.
Le travail d'un vérificateur manuel n'est pas de lire chaque ligne. Il consiste à vérifier que les principaux groupes de Registro — le bilan de vérification (C155), le plan comptable (C050), les soldes de clôture (C157), les synthèses d'écritures de journal (I200/I250) — sont cohérents entre eux et que les ajustements fiscaux de l'ECF (M300 pour e-Lalur, M350 pour e-Lacs) correspondent aux données ECD sous-jacentes. En pratique, cela signifie extraire des sous-ensembles de données du fichier, recouper les totaux et tracer des soldes de comptes spécifiques d'une section à l'autre.
Trois caractéristiques structurelles du format SPED rendent ce travail bien plus long qu'il ne devrait l'être.
Problème structurel 1 : un texte à largeur fixe qu'Excel ne peut pas lire comme données structurées
Un fichier ECD n'est pas un tableur. C'est un fichier texte à largeur fixe où chaque type de Registro possède sa propre disposition de champs à des positions de caractères spécifiques, délimitée par des barres verticales. Lorsqu'on l'ouvre dans Excel avec l'assistant d'importation de texte et le délimiteur barre verticale, chaque ligne devient une rangée — mais la signification de chaque colonne dépend entièrement du code Registro qui apparaît dans la première colonne.
Un Registro C155 (détail du bilan de vérification) comporte des champs pour le code de compte, le solde d'ouverture, le mouvement de débit, le mouvement de crédit et le solde de clôture à des positions spécifiques dans sa structure de 390 caractères. Un Registro I200 (écriture de journal) comporte des champs pour la date d'écriture, le numéro d'écriture et le montant total — une disposition entièrement différente. Dans l'importation Excel brute, les deux se trouvent dans la même feuille de calcul, et la colonne G peut signifier « solde d'ouverture » pour une ligne C155 et « total du journal » pour une ligne I200. La feuille de calcul n'a aucun moyen de les traiter différemment.
Pour extraire uniquement le bilan de vérification, le vérificateur filtre la feuille de calcul pour les lignes où la colonne A est égale à « C155 ». Cela réduit les données visibles aux enregistrements du bilan de vérification, mais les en-têtes de colonnes restent génériques — le vérificateur doit se souvenir ou rechercher que la colonne H d'une ligne C155 correspond au solde d'ouverture, tandis que la colonne I correspond au mouvement de débit. Une seule faute de frappe dans le filtre ou une colonne mal placée lors de l'importation produit un ensemble de données qui semble plausible mais qui est structurellement erroné. Le coût en temps ne réside pas seulement dans le filtrage. C'est la charge mentale de garder la disposition des champs en tête tout en parcourant des milliers de lignes.
Problème structurel n° 2 : plus de 40 types de Registro dans un seul fichier
Le format ECD définit plus de 40 types de Registro distincts répartis sur six Blocos (0, C, I, J, K et 9). Chaque type de Registro possède une structure de champs différente. Un réviseur qui doit recouper le bilan de vérification (C155) avec les écritures du journal (I200) et les affectations aux centres de coûts (C100) doit extraire trois sous-ensembles différents du même fichier, chacun avec son propre mappage de colonnes, puis rapprocher manuellement les totaux entre eux.
L'ECF ajoute une autre couche de complexité. Sa structure de Registro comprend le Bloco E (données ECD récupérées), le Bloco M (ajustements e-Lalur et e-Lacs) et le Bloco Y (informations sur les parties liées et les prix de transfert). Le Registro M300 de l'ECF (ajustements de la partie A d'e-Lalur) fait référence à des codes de compte spécifiques du plan comptable C050 de l'ECD — une dépendance inter-fichiers qui oblige le réviseur à ouvrir deux fichiers .txt indépendants, à extraire des sous-ensembles correspondants de chacun, et à vérifier la cohérence manuellement.
Aucune validation effectuée par le PVA ne vérifie cette cohérence inter-fichiers. Le PVA valide que chaque fichier individuel respecte la spécification du format. Il ne vérifie pas que le solde de clôture de l'ECD pour le compte 4.01.01 correspond au solde d'ouverture reporté dans l'enregistrement de récupération E010 de l'ECF. Cette vérification est entièrement laissée au réviseur humain.
Problème structurel n° 3 : aucune validation inter-fichiers intégrée au PVA
C'est la lacune la plus conséquente de l'écosystème SPED. Les Programas Validadores e Assinadores pour l'ECD et l'ECF sont indépendants. Ils valident la syntaxe, les plages de champs et la séquence des Registro dans chaque fichier. Ils ne recoupent pas les données entre les deux fichiers. Ils ne signalent pas une incohérence lorsque le solde de clôture de l'ECD pour un compte donné diffère du solde d'ouverture que l'ECF a récupéré dans le Bloco E. Ils ne vérifient pas que les ajustements M300 de l'ECF correspondent aux provisions comptables de l'ECD.
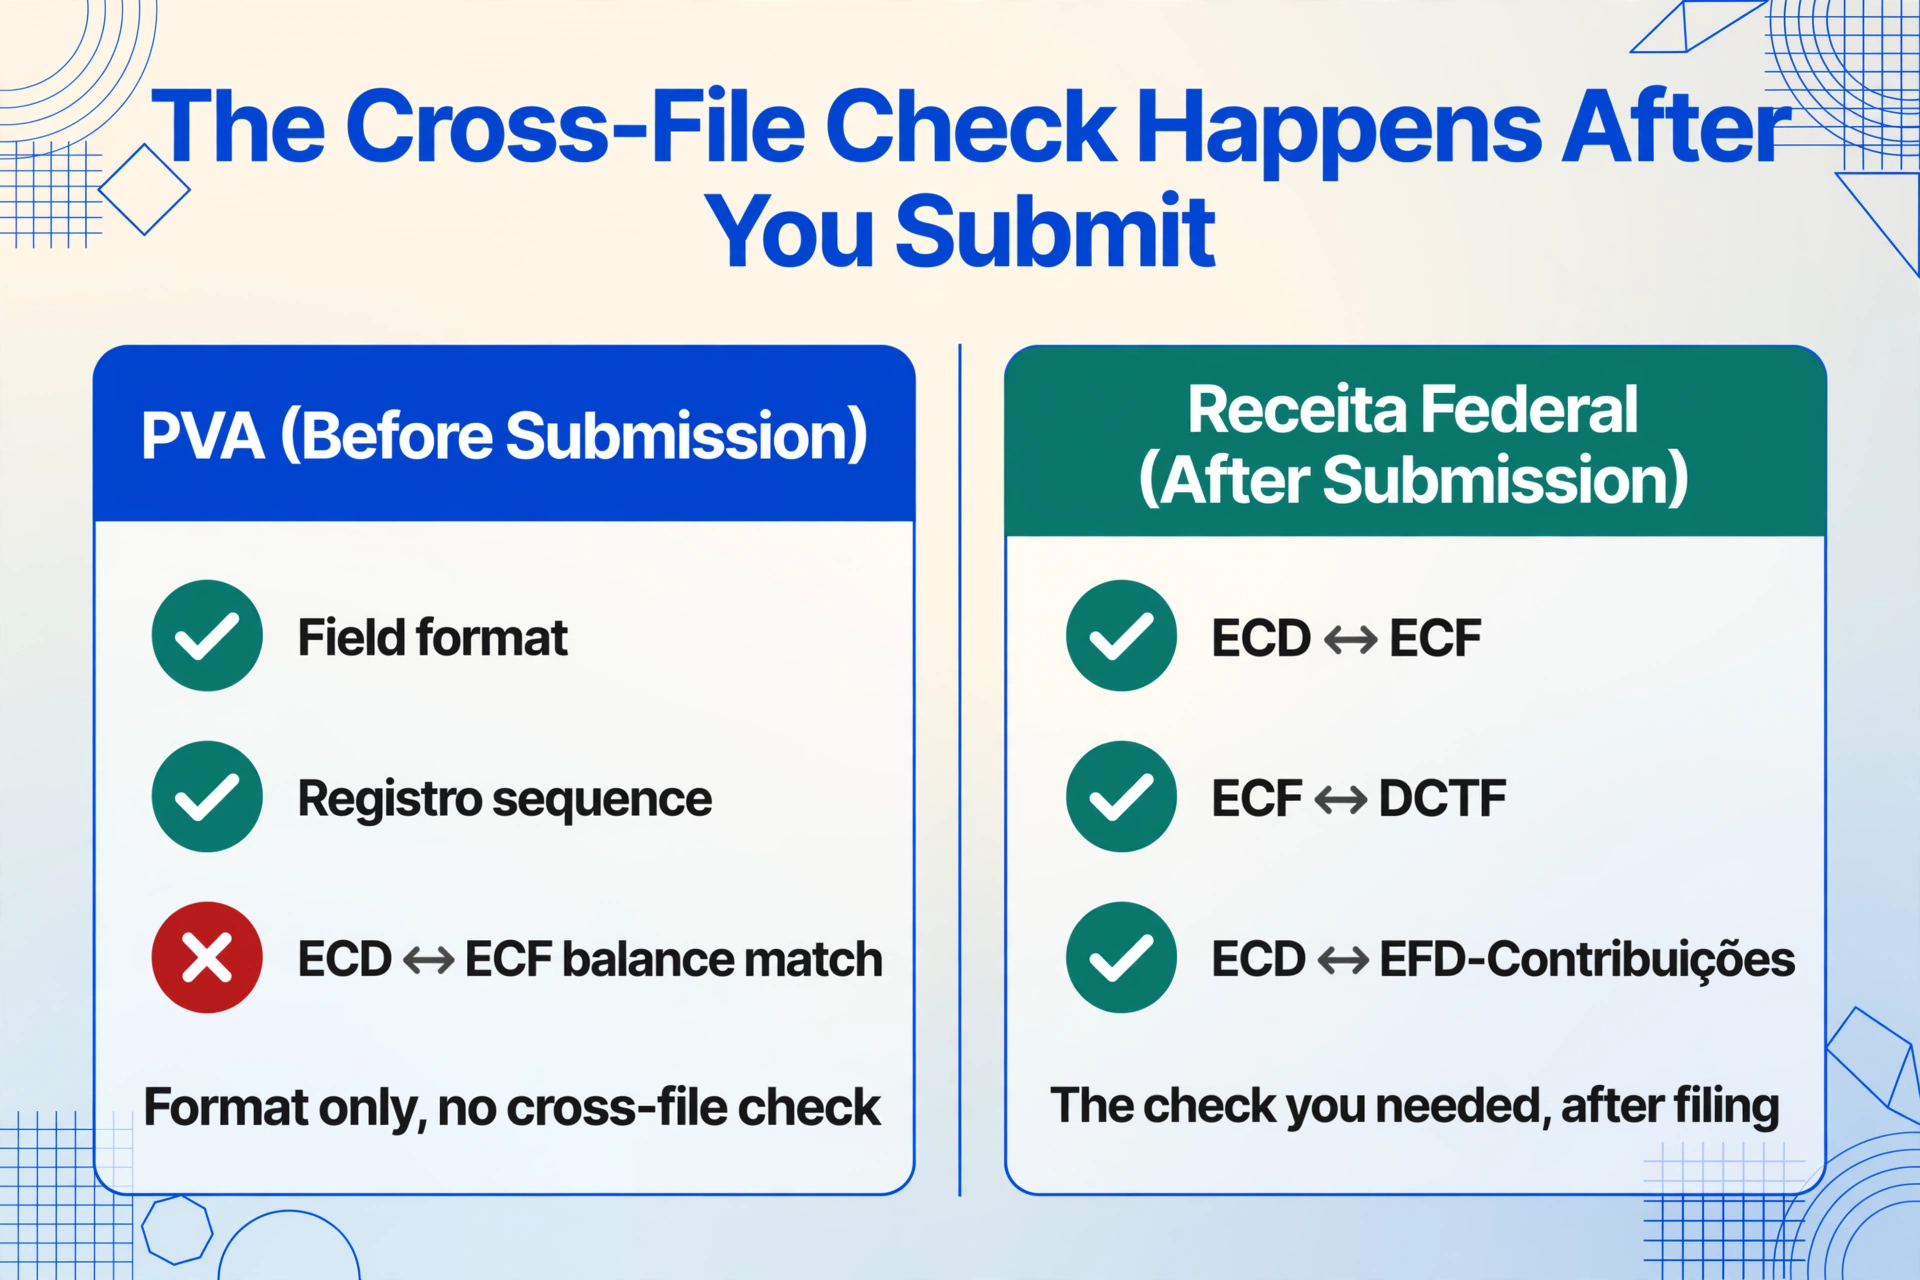
La Receita Federal, bien sûr, effectue ce recoupement — après la soumission. Les systèmes de la RFB comparent les données de l'ECD à celles de l'ECF, l'ECF à la DCTF, et l'ECD à l'EFD-Contribuições, en utilisant des contrôles croisés automatisés de plus en plus sophistiqués, renforcés par des capacités d'intelligence artificielle depuis 2026. Lorsqu'un écart est détecté après la soumission, l'entreprise reçoit un avis, l'ajustement est enregistré et le risque d'audit augmente. La revue manuelle est la seule occasion de détecter et de corriger ces écarts avant qu'ils ne fassent partie du dossier permanent.
Le résultat : un processus où le comptable passe des heures à faire un travail qu'un moteur de recoupement automatisé pourrait faire en quelques secondes — et la RFB possède déjà ce moteur de son côté de la frontière de soumission.
L'effet cascade : quand la revue de l'ECD retarde le dépôt de l'ECF
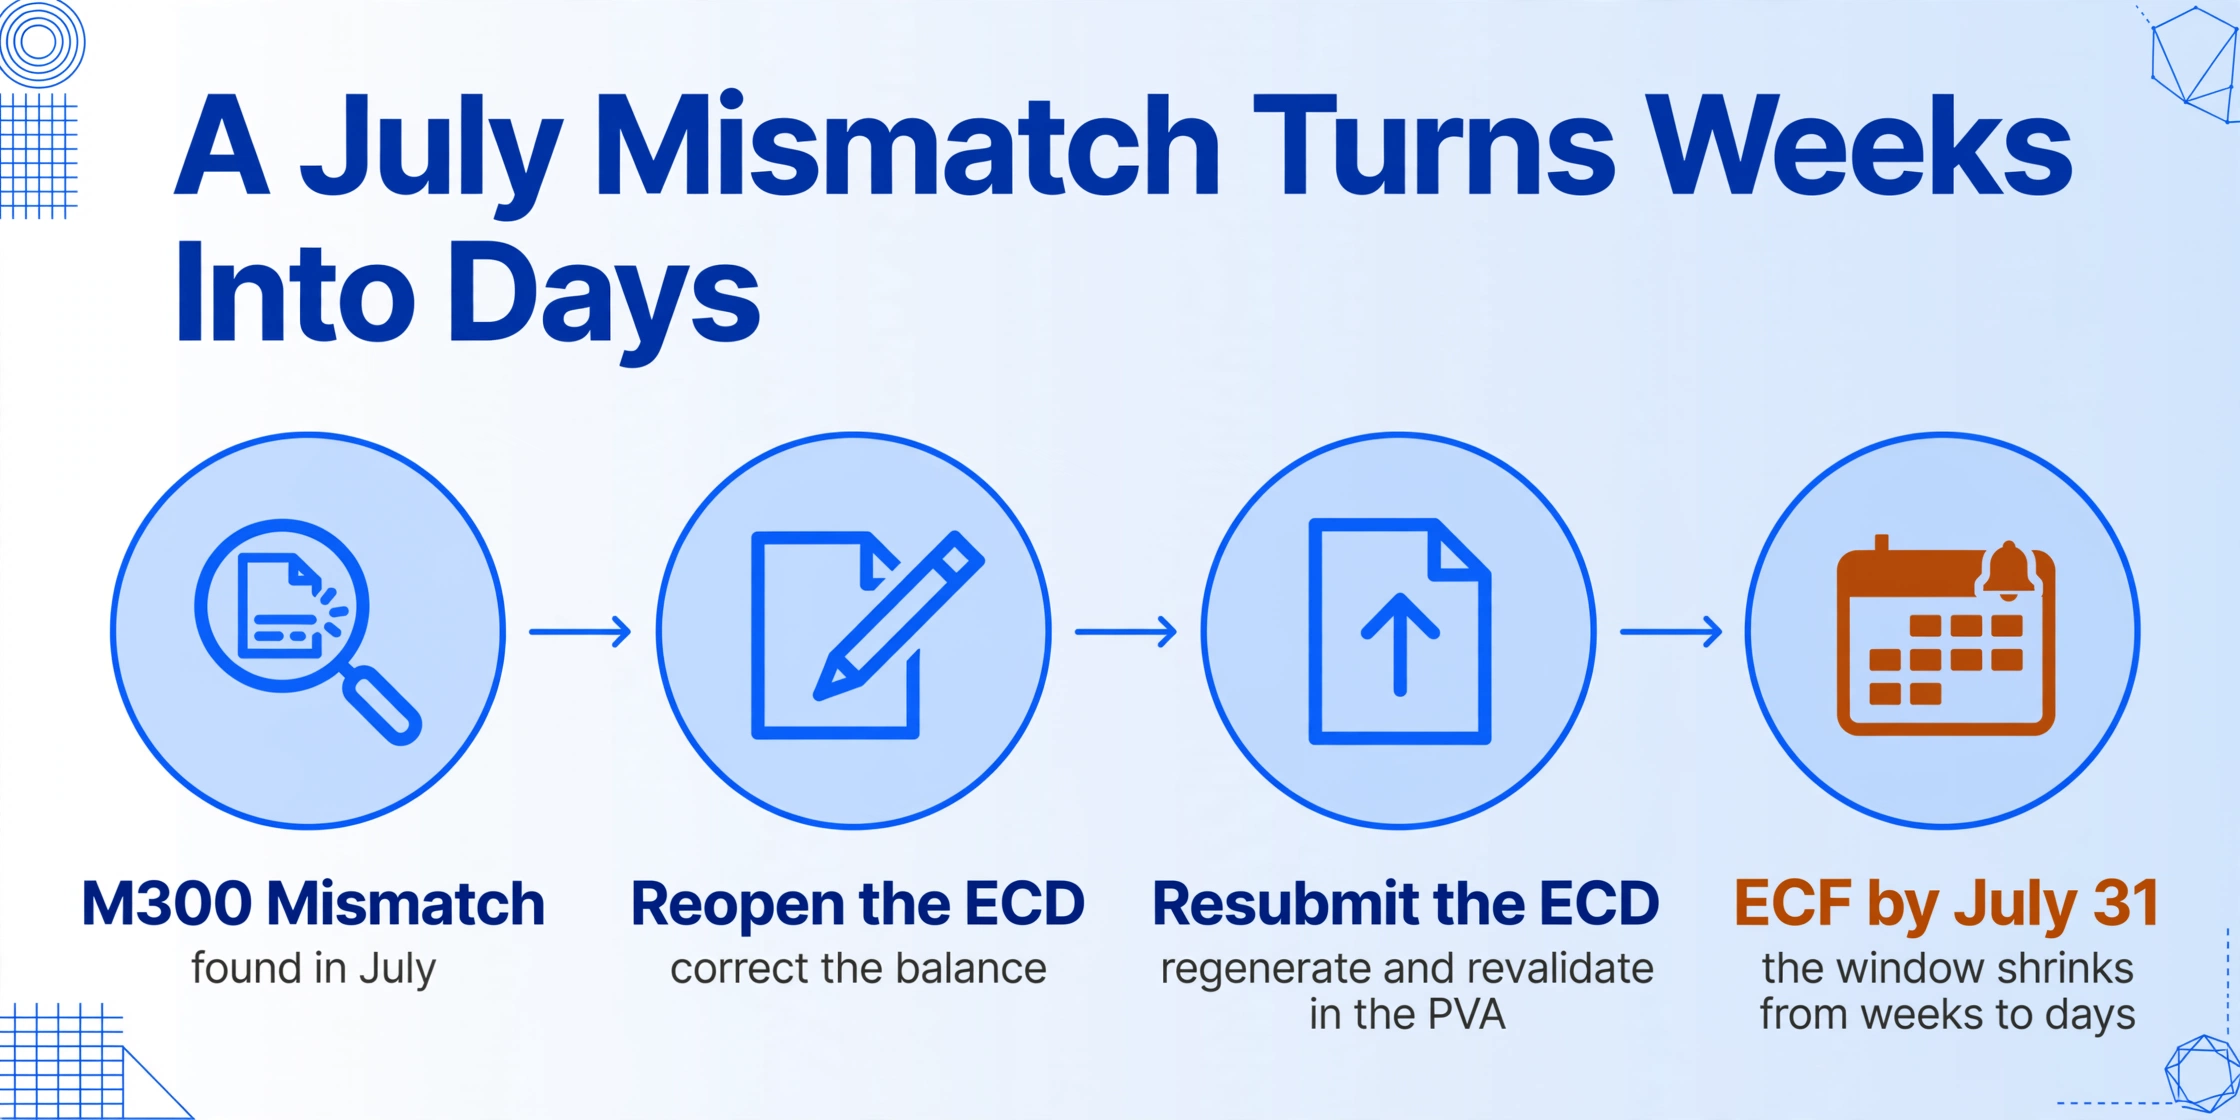
Parce que l'ECF dépend de l'ECD pour sa base comptable (le Bloco E récupère les soldes finaux et les comptes mappés de l'ECD), tout retard ou erreur dans la revue de l'ECD se répercute directement sur le calendrier de l'ECF. Une correction découverte pendant la préparation de l'ECF — « cet ajustement M300 ne correspond pas au compte ECD correspondant » — exige de rouvrir le fichier ECD, d'apporter la correction, de générer un fichier ECD de substitution, de le revalider dans le PVA et de le soumettre à nouveau avant que l'ECF puisse être finalisé. Ce travail en cascade est la principale source de stress de dernière minute dans le cycle SPED.
En pratique, une entreprise qui découvre une incohérence ECD↔ECF au cours de la deuxième semaine de juillet fait face à un calendrier compressé où la correction de l'ECD doit être traitée avant que l'ECF puisse être finalisé, et les deux doivent être soumis avant le 31 juillet. La fenêtre de travail se réduit de semaines à jours, et chaque correction comporte le risque d'introduire une nouvelle incohérence ailleurs dans le fichier.
Où va l'industrie (et pourquoi la revue manuelle persiste)
La Receita Federal investit dans ses capacités d'analyse inter-fichiers. L'introduction en 2026 du croisement de données amélioré par l'IA (rapportée par plusieurs cabinets de conseil brésiliens) signale que l'écart entre ce que les outils de soumission peuvent faire et ce que l'analyse post-soumission de la RFB peut faire se creuse. Du côté du contribuable, cependant, les outils disponibles pour la revue pré-soumission n'ont pas suivi le rythme. Le PVA valide le format. Excel filtre par code Registro. Tout le reste — la vérification réelle que les données sont cohérentes, complètes et appariables d'un fichier à l'autre — reste manuel.
Cette asymétrie est la raison fondamentale pour laquelle les comptables passent des semaines sur la revue SPED. Non pas parce qu'ils sont lents ou mal préparés, mais parce que le format répartit les données financières les plus importantes d'une entreprise sur plusieurs fichiers texte aux structures divergentes, et que les outils disponibles exigent que le lecteur garde en tête les dispositions des champs et les relations inter-fichiers tout en parcourant des dizaines de milliers de lignes. C'est un problème de format qui ressemble à un problème de préparation vu de l'extérieur — et la différence importe parce que la solution est structurelle, pas motivationnelle.
Point clé : Le problème de la revue manuelle SPED n'est pas un problème de « trop peu de temps avant l'échéance ». C'est un problème de trop de types de Registro, de trop peu de références inter-fichiers et d'absence totale d'outils analytiques entre la validation de format du PVA et les yeux du réviseur humain. Un outil capable de lire plusieurs types de Registro par leur sens — et non par décalage d'octets — et de produire des tableaux structurés à partir de n'importe quel fichier SPED dans la même session n'est pas une commodité. C'est une réponse structurelle à un problème structurel.
Questions fréquemment posées
Q : Combien de temps prend généralement un examen manuel complet de l'ECD pour une entreprise de taille moyenne ?
D'après les flux de travail déclarés des cabinets comptables, un examen complet de recoupement ECD↔ECF pour une entreprise dont les données ECD comptent 80 000 à 150 000 lignes prend 8 à 12 heures par an. Pour une fenêtre de comparaison sur trois ans, le temps total d'examen dépasse 30 heures pour la seule étape de recoupement, sans compter le travail initial d'extraction et de mise en forme des données.
Q : Le PVA détecte-t-il les incohérences de données ?
Le PVA valide la conformité syntaxique et formelle — types de champs, Registros obligatoires, ordre de séquencement. Il n'effectue pas de vérifications sémantiques croisées entre différents types de Registro ni entre les fichiers ECD et ECF. Un enregistrement C155 dont le solde d'ouverture ne correspond pas au solde de clôture de l'exercice précédent passera la validation du PVA tant que le format du champ est correct.
Q : Quelles sont les incohérences les plus courantes relevées lors de l'examen manuel ?
Les problèmes les plus fréquents sont les écarts entre les soldes de clôture de l'ECD et les soldes récupérés de l'ECF dans le Bloco E (E010), les erreurs dans les montants des ajustements M300 par rapport à la provision comptable sous-jacente, et les références croisées manquantes dans le tableau des comptes mappés E015. Ce sont toutes des incohérences inter-fichiers que le PVA ne détecte pas.
Q : L'examen manuel est-il encore nécessaire si l'entreprise utilise un ERP majeur avec des modules SPED ?
Oui. Les modules ERP (SAP TDF, Oracle NetSuite Brazil Localization, Senior, Domínio) génèrent les fichiers ECD et ECF à partir des données transactionnelles de l'entreprise. Ils n'effectuent pas de contrôles de cohérence inter-fichiers entre les sorties ECD et ECF générées. La génération des fichiers est automatisée ; la vérification des données ne l'est pas. L'étape d'examen manuel n'est pas une fonction de l'outil de génération mais une fonction du format SPED lui-même.
Q : Que se passe-t-il si une incohérence est constatée après le dépôt de l'ECF ?
L'entreprise dépose un ECF substitutif (ECF retificadora) avec les données corrigées. La Receita Federal compare les déclarations originale et corrigée dans le cadre de son processus de notation des risques. Les corrections fréquentes ou celles qui impliquent d'importantes variations de valeurs augmentent le score de risque d'audit de l'entreprise. Le moteur de recoupement de la RFB signale automatiquement les divergences entre les données déposées de l'ECD, de l'ECF, de la DCTF et de l'EFD-Contribuições.
Q : Les outils d'extraction par IA peuvent-ils contribuer à réduire le temps d'examen manuel du SPED ?
Des outils comme ImageToTable.ai qui utilisent l'Extraction de colonnes personnalisées peuvent réduire la partie préparation des données de l'examen — extraction de la balance de vérification, des ajustements e-Lalur et des tableaux de recoupement des fichiers ECD et ECF dans des tableaux Excel structurés — de plusieurs heures à quelques minutes. L'examinateur applique toujours son jugement professionnel, mais sur des données propres plutôt que sur du texte brut délimité par des barres verticales avec des types de Registro mélangés. Le gain de temps provient de l'élimination des étapes de filtrage, de remappage des colonnes et de nettoyage structurel qui consomment actuellement la majeure partie du cycle d'examen.
Au-delà de l'échéance — Un processus qui mérite de meilleurs outils
Le cycle annuel de révision du SPED révèle un décalage fondamental : le format dans lequel vos données résident et l'outil que vous utilisez pour les vérifier ont été conçus à des fins différentes. Le format SPED a été conçu pour une validation automatique — champs de largeur fixe, codes Registro, délimiteurs par barre verticale, le tout optimisé pour un analyseur syntaxique. L'outil que la plupart des comptables utilisent pour le réviser est un tableur à usage général, qui traite chaque ligne de la même manière, quel que soit le type de Registro. Le réviseur doit combler l'écart entre les deux — et ce travail de rapprochement est ce qui prend 40 à 80 heures chaque année.
Combler cet écart n'est pas difficile d'un point de vue technique. C'est mécaniquement répétitif : filtrer, vérifier, mapper, valider, refiltrer avec un code Registro différent, recommencer. Ce travail disparaît lorsque l'étape d'extraction comprend les types de Registro par leur sens plutôt que par un filtre. Pour les équipes comptables brésiliennes confrontées au cycle d'échéance de juin-juillet, la question n'est pas de savoir si la révision manuelle est nécessaire — elle est de savoir si la préparation des données qui la précède doit occuper la majeure partie du temps disponible.