Copilot a été conçu pour travailler dans Excel,
pas pour extraire des données d'un PDF
Le guide de Microsoft indique que Copilot dans Excel peut transformer un PDF en feuille de calcul modifiable (Microsoft). Un fil sur r/excel raconte une autre histoire : un utilisateur a écrit que Copilot « n'a pas pu répondre à une simple demande de conversion de PDF en Excel », tandis que ChatGPT « l'a fait en quelques secondes avec un résultat parfait » (r/excel). L'écart vient de quelque chose de plus précis qu'une fonctionnalité défaillante : un assistant conversationnel à qui l'on demande une tâche pour laquelle il n'a jamais été conçu.
Points clés à retenir
- Ce n'est probablement pas votre invite, car Copilot dans Excel a été conçu pour modifier des classeurs, et l'importation d'un dossier de PDF dans un tableau se produit avant même que sa tâche ne commence.
- Un outil qui obtient 86 % sur des champs individuels obtient encore moins de la moitié de ses lignes entièrement correctes.
- Arrêtez de chercher une meilleure invite, car la solution consiste à nommer vos colonnes une seule fois et à traiter tout le dossier en un seul lot.
Copilot in Excel et un outil PDF vers Tableau résolvent deux problèmes différents
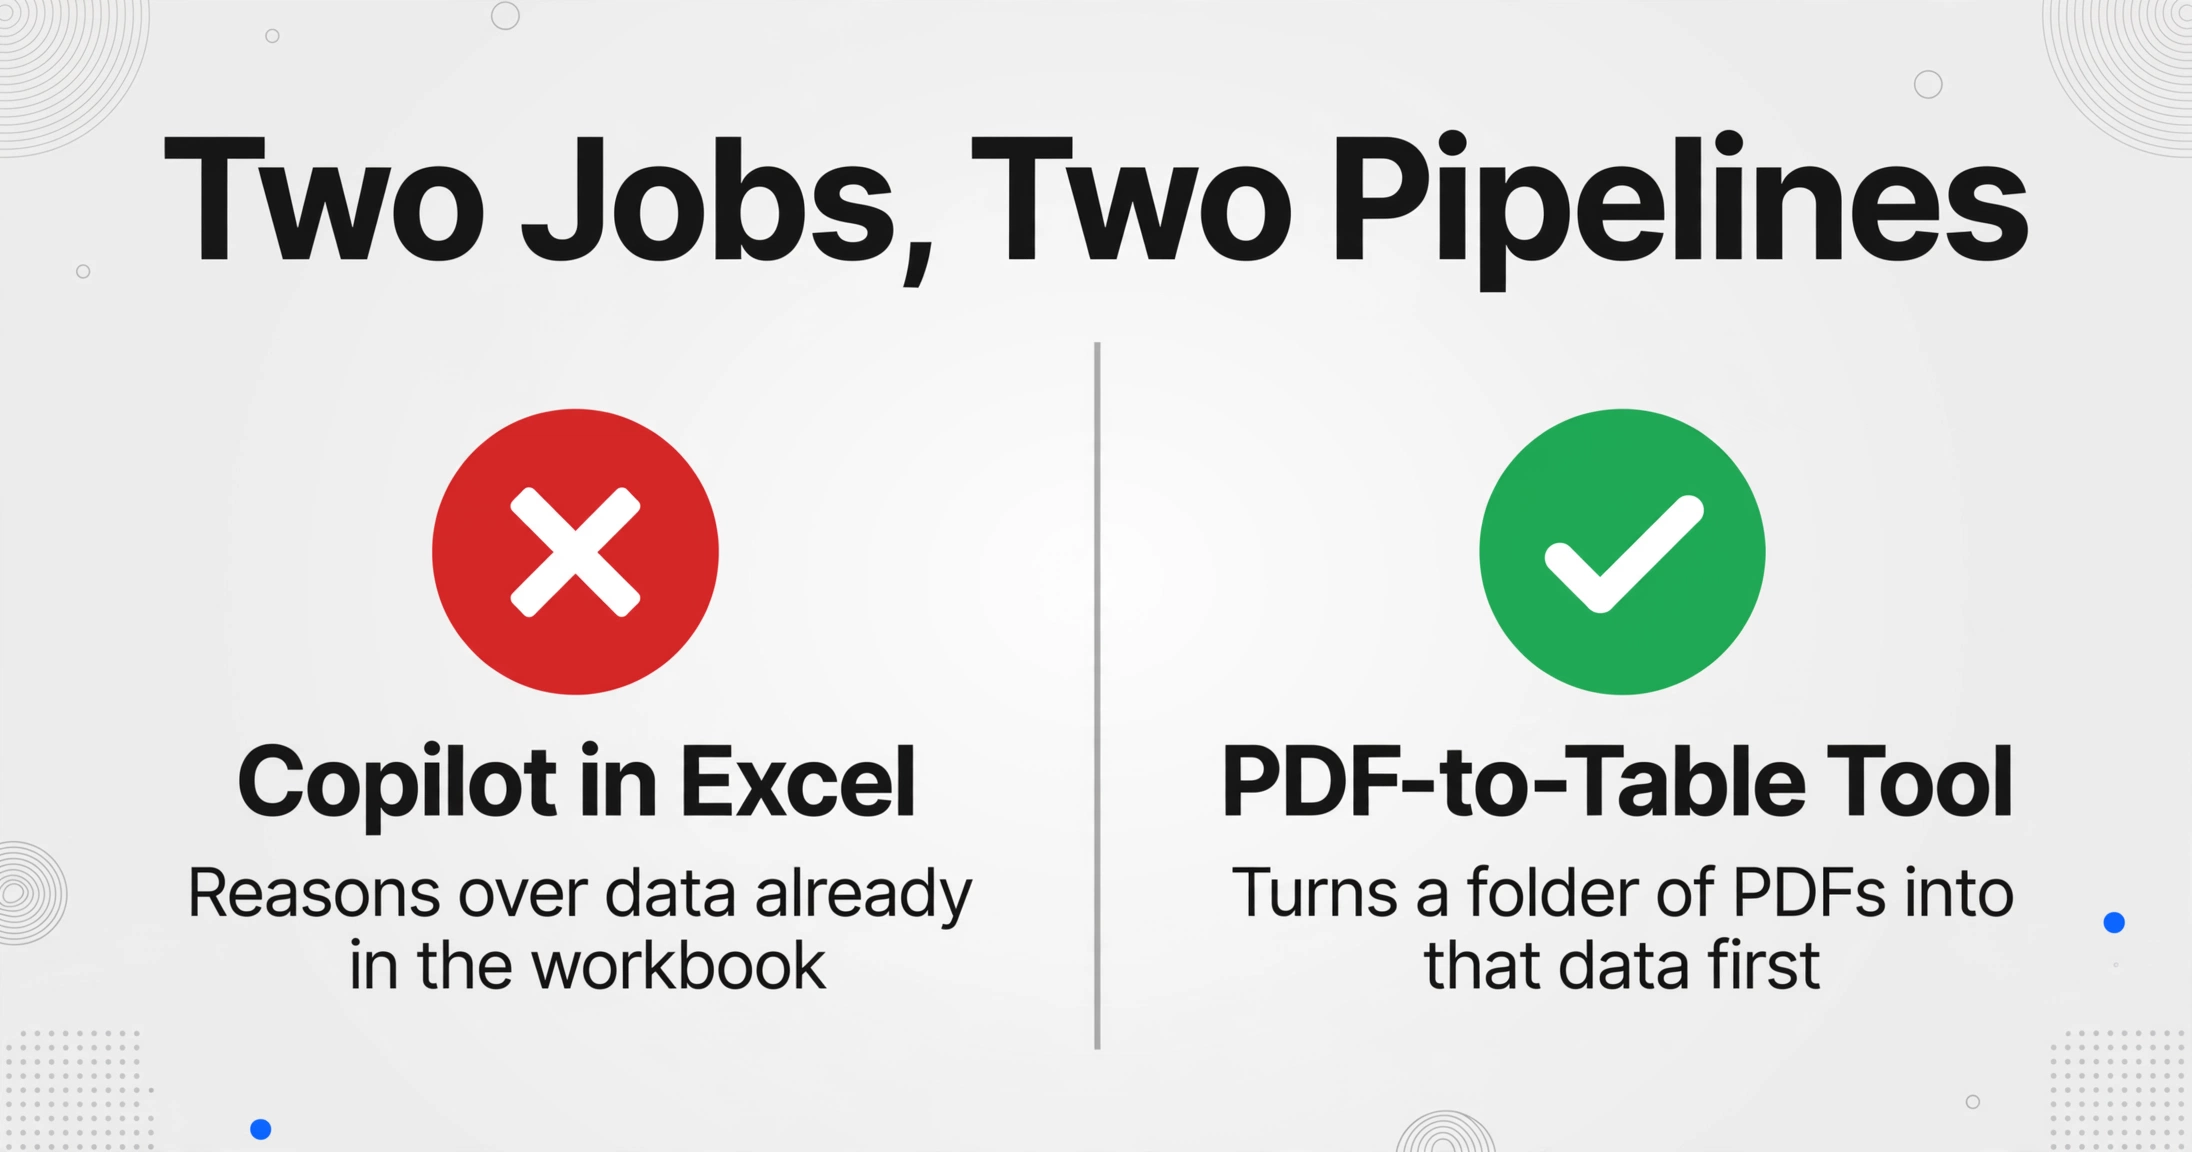
Copilot raisonne sur les données déjà présentes dans votre classeur. Transformer un dossier de PDF en ces données est une tâche qui se produit avant que le travail de Copilot ne commence.
Le rôle documenté de Copilot in Excel est le classeur. Microsoft le décrit comme une fonctionnalité qui vous aide à « créer et modifier des classeurs » : générer et expliquer des formules, renvoyer des informations sous forme de graphiques ou de tableaux croisés dynamiques, surligner, trier, filtrer et résumer des colonnes de texte. Chacune de ces tâches part d'un tableau qui existe déjà sur une feuille.
La tâche de conversion PDF en tableau est l'ingestion. Les données vivent en dehors du classeur, dans un format de fichier qui stocke l'emplacement des caractères sur une page plutôt que la colonne à laquelle ils appartiennent. Obtenir ces données dans un tableau avec les colonnes souhaitées, à partir de chaque fichier, est une étape distincte qui se produit avant que toute analyse puisse commencer.
Microsoft a fourni un pipeline séparé pour l'ingestion pendant des années. L'importateur plus ancien Données → Obtenir des données → À partir d'un fichier → À partir d'un PDF ne lit que la couche de texte qu'un PDF contient par hasard, c'est pourquoi il ne renvoie rien sur un document scanné. Ce chemin et celui de Copilot ne sont pas le même code, et aucun des deux n'a été conçu pour produire le même ensemble de colonnes à partir de cinquante fichiers formatés différemment. Le guide PDF vers données structurées explique pourquoi chaque méthode de conversion échoue, et sur quels types de fichiers.
Garder les deux tâches séparées explique la frustration dans ce fil sans en faire un débat de marque. Copilot n'échoue pas dans l'analyse. On lui confie une tâche d'ingestion, et c'est là qu'il a le moins de matière à travailler.
Ce que Copilot in Excel fait vraiment bien
Copilot est bon pour le travail pour lequel il a été conçu, et le même fil de discussion sceptique le reconnaît.
Les utilisateurs qui sont restés avec lui l'ont décrit comme « excellent pour générer des formules » et utile pour les comptes rendus de réunion, les résumés de documents et la construction d'une analyse sur un sujet technique. Une réponse était franche sur la valeur réelle : « la seule chose pour laquelle j'ai vraiment senti qu'il m'aidait, c'est l'écriture de VBA. » Lorsque les données sont déjà dans la feuille, demander à Copilot d'expliquer une formule ou de faire ressortir une valeur aberrante est un usage raisonnable d'un assistant IA.
La ligne de partage honnête est de savoir si les données existent déjà dans le classeur.
| Ce que vous faites | Copilot in Excel | Un outil d'extraction par lot |
|---|---|---|
| Les données sont déjà dans une feuille | Très adapté : formules, informations, tableaux croisés dynamiques, résumés | Pas le sujet ; les données sont déjà structurées |
| Un PDF propre dont vous avez besoin une fois | Fonctionne généralement après un collage manuel et un nettoyage | Fonctionne, mais le cas ponctuel n'a pas besoin d'un pipeline |
| Un dossier de PDF avec les mêmes champs | Fragile : un fichier à la fois, les en-têtes dérivent entre les exécutions | Le cas conçu pour cela : les mêmes colonnes pour chaque fichier |
| Une exécution mensuelle récurrente | Mauvaise forme : re-solliciter réintroduit la dérive | Réutilisez le même ensemble de colonnes et relancez le lot |
Une fois que les données sources sont un tableau, Copilot peut prendre le relais et faire un travail utile dessus. Le problème, c'est tout ce qui doit se passer avant ce moment.
Pourquoi un assistant conversationnel échoue face à l'extraction répétable
Quatre propriétés structurelles d'un assistant de chat nuisent à l'extraction répétable, et aucune n'est corrigée par une meilleure requête.
La forme de la sortie n'est pas garantie. La propre FAQ de Microsoft indique que Copilot « peut parfois faire des erreurs, mal interpréter des informations ou produire des résultats inexacts », et déconseille de l'utiliser « pour des décisions dans des domaines sensibles comme la finance, le droit ou la médecine » (Support Microsoft). Une fonction de feuille de calcul Copilot retirée portait le même avertissement sous une forme plus nette : les résultats « peuvent changer au fil du temps, même avec les mêmes arguments », et pour tout ce qui exige « précision ou reproductibilité », Microsoft renvoyait les utilisateurs aux formules natives (fonction COPILOT). Un outil dont le fabricant vous dit de ne pas lui confier des décisions financières est un bon partenaire de réflexion, mais un piètre système de référence.
Il n'y a pas de contrat sur les colonnes. Vous demandez un tableau et vous obtenez un tableau, mais pas forcément le même deux fois. L'exécution suivante peut renommer « Invoice Date » en « Date », décaler une colonne ou fusionner deux champs en un seul. Un utilisateur du fil r/excel a décrit l'effet avec précision : « J'obtiens des résultats très différents avec exactement les mêmes données et instructions. » Lorsque quarante fichiers produisent quarante tableaux légèrement différents, les fusions et renommages retombent sur la personne qui cherchait à gagner du temps.
L'outil est conçu pour un fichier à la fois. La documentation d'OpenAI sur le téléchargement de fichiers limite les documents à 2 millions de jetons chacun et les images à 20 Mo, et ces limites s'appliquent à une seule conversation plutôt qu'à un dossier (OpenAI). Un relevé bancaire de douze pages contenant trois tableaux correspond exactement au format qui atteint ces plafonds, et l'échec est silencieux : la réponse revient plus courte que le document. Les fichiers scannés aggravent la situation, car il n'y a pas de couche de texte à lire à moins que l'outil ne traite la page comme une image, ce qui est abordé dans si l'IA peut extraire des données d'un PDF.
La précision au niveau de l'enregistrement est bien inférieure à la précision au niveau du champ. C'est le chiffre que la plupart des gens ne voient jamais. Le benchmark de sortie structurée de Cleanlab sépare la Field Accuracy (la part des champs individuels corrects) de l'Output Accuracy (la part des enregistrements où chaque champ est correct). Sur son ensemble Data Table Analysis, gpt-4.1-mini a obtenu 86,3 % au niveau du champ mais 45 % au niveau de l'enregistrement ; sur l'extraction de réclamations d'assurance, la précision des enregistrements se situait entre 30 % et 40 % pour les modèles de pointe ; sur l'extraction de PII, elle tombait à 26 % à 46 % (Cleanlab).
Un taux de champ de 90 % semble rassurant jusqu'à ce que vous ayez besoin de la ligne entière. Dix champs à 95 % chacun laissent environ 60 % de chances qu'une ligne donnée soit parfaitement propre, et les erreurs s'accumulent à mesure que le lot grandit. Pour un dossier de factures, le seul chiffre qui compte est le nombre de lignes correctes.
Le même schéma apparaît en dehors d'Excel. Dans un fil r/ChatGPT sur l'analyse de listes d'entrepreneurs à partir de PDF, l'auteur du message original a vu un document unique fonctionner parfaitement, puis les résultats s'effondrer lorsque trois fichiers ont été combinés : « Je n'arrivais pas à obtenir plus de 4 résultats sur une feuille de calcul qui aurait dû en contenir plus de 100. » Un commentateur a résumé l'expérience : « analyser des PDF est un vrai coup de dés... Des pages manquantes, des lignes manquantes, des valeurs manquantes » (r/ChatGPT). Rien dans un modèle plus grand ne supprime ces quatre propriétés, c'est pourquoi un outil spécialisé pour le traitement par lot de documents est une catégorie de produit différente, et non un chatbot plus puissant.
Un test que vous pouvez effectuer en vingt minutes
La plupart des recherches sur Copilot dans Excel qui ne fonctionne pas se résument à une question : est-ce mon invite, ou l'outil ? Vous pouvez trancher sur vos propres fichiers avant de changer quoi que ce soit, et vous devriez exécuter les mêmes vérifications sur un Copilot PDF vers Excel et sur un ChatGPT. Quatre d'entre elles séparent une démo qui vous a impressionné une fois d'un outil sur lequel vous pouvez bâtir un processus mensuel.
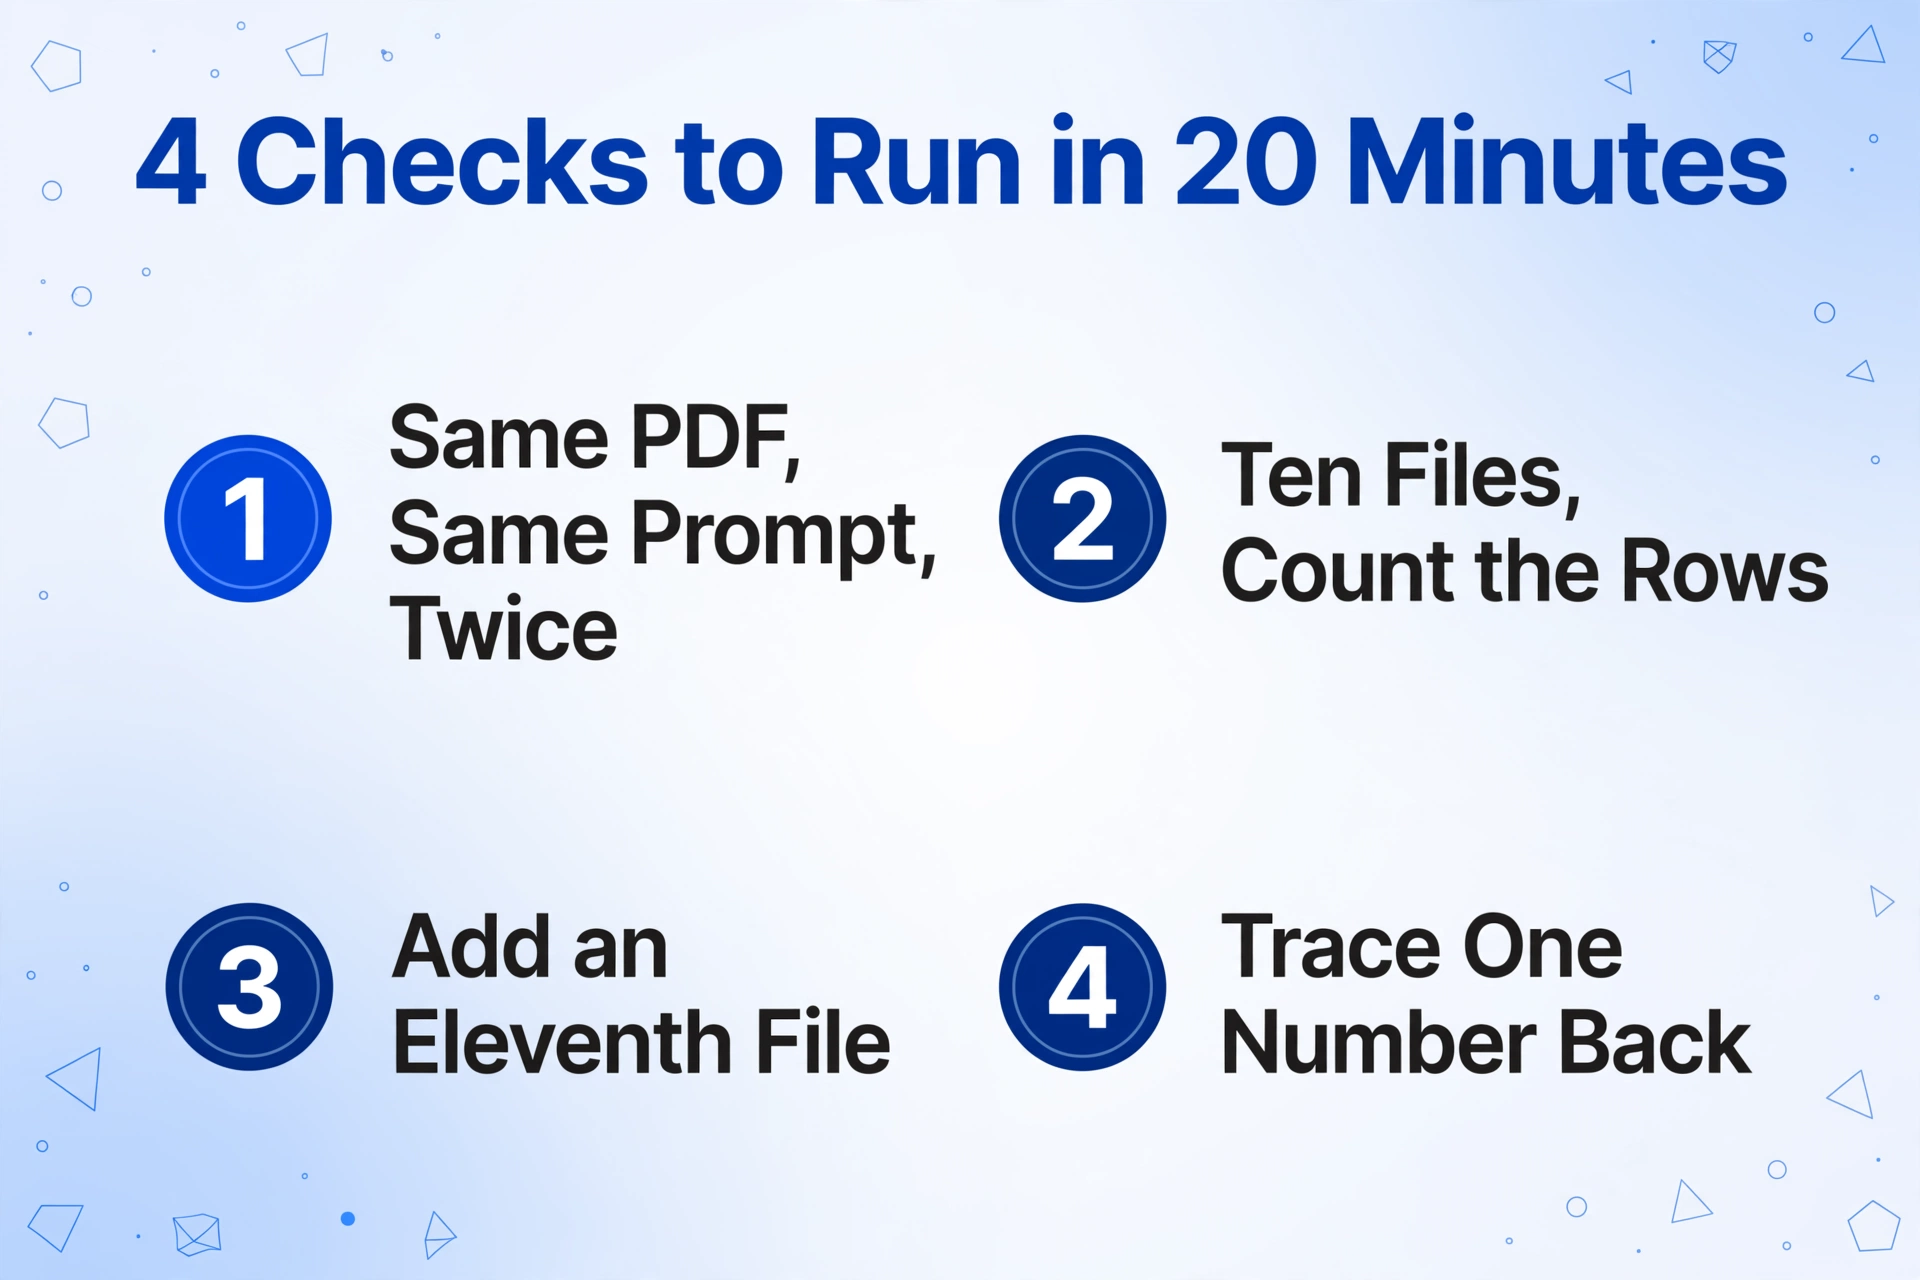
Exécutez le même PDF deux fois avec la même invite
Comparez la ligne d'en-têtes cellule par cellule. Si les noms de colonnes ou leur ordre diffèrent entre deux exécutions sur un même fichier, vous n'avez pas de contrat de colonnes, et aucune formule en aval ne tiendra.
Exécutez dix fichiers et comptez les lignes
Un relevé avec 63 transactions devrait produire 63 lignes. Notez le nombre attendu à côté du nombre réel pour chaque fichier. Un seul fichier qui renvoie 40 lignes est le mode de défaillance qui ne s'annonce jamais.
Ajoutez un onzième fichier avec une mise en page différente
Utilisez un relevé d'une autre banque, ou une facture d'un autre fournisseur. Un outil qui ne tient que sur des mises en page identiques est une démo, pas un pipeline, car les ensembles de documents réels ne sont jamais uniformes.
Retracez un nombre jusqu'à sa page
Choisissez une valeur extraite unique et trouvez d'où elle vient dans la source. Si la vérification signifie rouvrir chaque PDF à la main, l'extraction a fait gagner moins de temps qu'il n'en a coûté pour faire confiance.
Si l'une de ces vérifications échoue, l'outil convient pour un usage ponctuel et ne convient pas pour un travail répétable. C'est cette distinction, et non un verdict sur la marque, qui est l'objet du test.
Ce dont un outil fiable à grande échelle a besoin
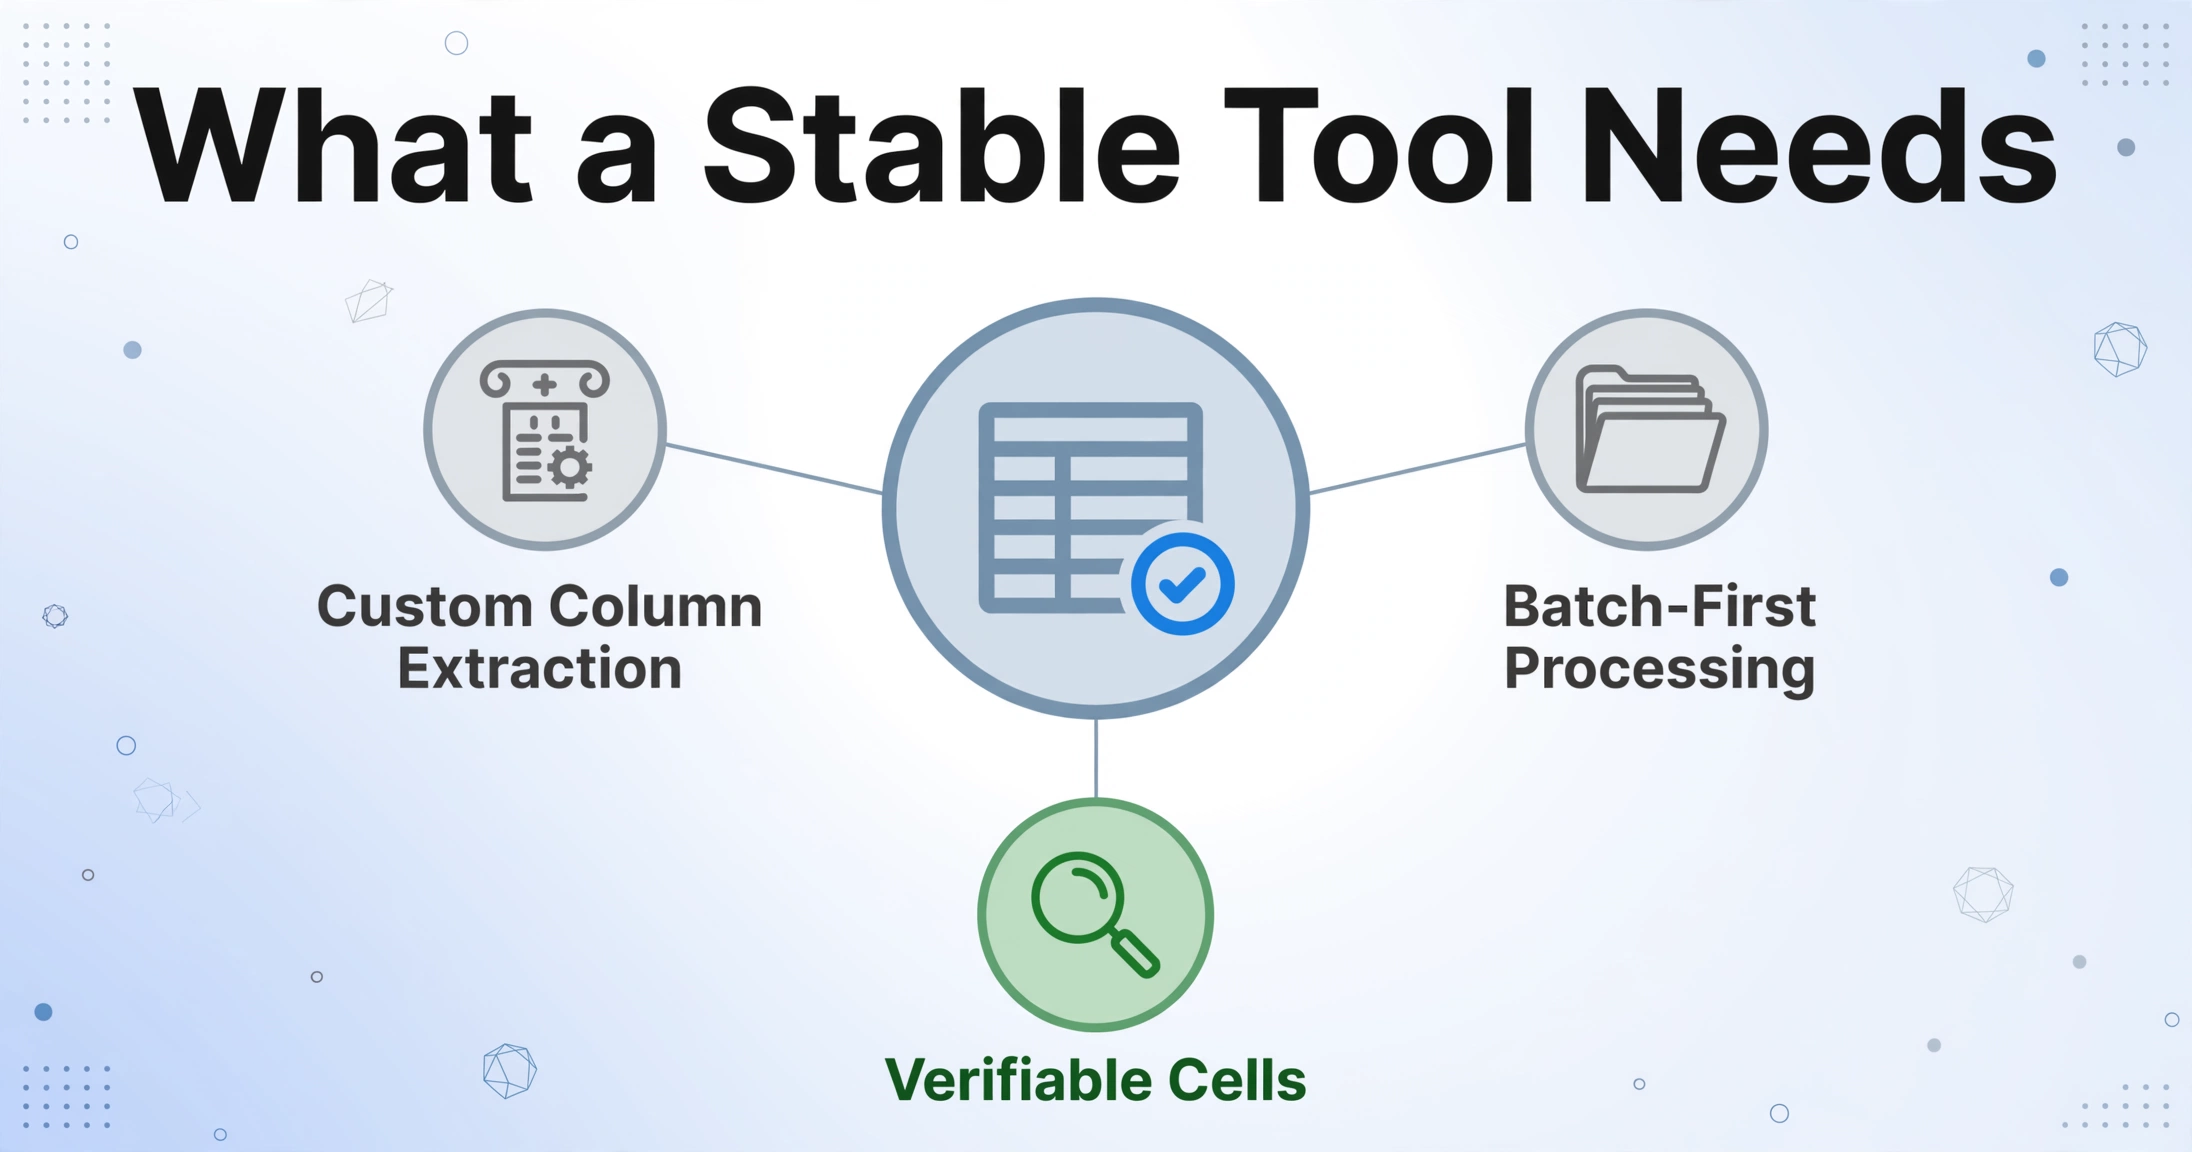
Un outil qui passe ces vérifications est construit autour du contrat de sortie d'abord, pas du document. Ce choix de conception unique produit la plupart des autres propriétés.
La première exigence est que vous nommiez les colonnes de sortie, et que ces noms deviennent les en-têtes exacts du résultat. C'est l'Extraction de colonnes personnalisées : au lieu de laisser le modèle décider quoi renvoyer, vous saisissez les champs souhaités, comme « Invoice Number », « Statement Date » et « Balance », et l'IA localise chaque valeur selon sa signification plutôt que son emplacement. L'ensemble de colonnes vous appartient, il reste donc identique d'un fichier à l'autre.
La deuxième exigence est que l'outil traite le dossier plutôt que le fichier. Traitement par lots en priorité signifie que cinquante documents entrent et qu'un seul tableau ressort, au lieu de cinquante conversations séparées que vous assemblez ensuite. C'est la différence entre poser une question cinquante fois et exécuter un seul traitement une fois, et c'est le point où les assistants généralistes sont structurellement les plus faibles.
Deux exigences plus mineures suivent. La ligne d'en-tête doit être identique à chaque exécution du même ensemble de colonnes, et vous devez pouvoir pointer vers n'importe quelle cellule extraite et voir la région de la source d'où elle provient, car une valeur que vous ne pouvez pas vérifier est une valeur que vous revérifiez à la main. Un outil auquel il manque l'un ou l'autre ne supprime pas l'étape de vérification, il la déplace.
ImageToTable.ai est construit sur ces deux éléments principaux, l'extraction de colonnes personnalisées et le traitement par lots : vous téléversez les documents, saisissez les noms de colonnes souhaités et obtenez un seul tableur où ces noms sont les en-têtes. Le produit annonce une précision allant jusqu'à 99 % sur les données de tableaux imprimés, avec une page unique traitée en 5 à 10 secondes contre environ 3 minutes qu'une personne passe à saisir la même page à la main. La même approche est comparée au champ plus large dans la comparaison des logiciels d'extraction de données, qui est l'endroit où regarder si la décision se joue entre fournisseurs plutôt qu'entre catégories.
Les fichiers sont traités de manière sécurisée et ne sont pas stockés.
La distinction entre décrire un document et extraire un ensemble fixe de champs n'est pas qu'une simple fonctionnalité produit. Elle change ce que vous pouvez construire à partir du résultat, ce qui explique pourquoi les assistants généralistes ne suffisent pas pour la même tâche sur des captures d'écran.
Quand Copilot, ChatGPT ou Claude est le bon choix
Copilot est le bon outil pour un travail ponctuel sur des données déjà présentes dans un classeur, et le mauvais outil pour un traitement par lots récurrent où les colonnes doivent correspondre exactement.
Utilisez-le lorsque la source est un fichier unique et propre, lorsque vous explorez un jeu de données que vous possédez déjà, ou lorsque vous avez besoin d'une explication de formule ou d'un résumé de colonne de texte. ChatGPT est un choix raisonnable dans les mêmes situations, et il peut bien convertir un seul PDF bien structuré du premier coup. Un succès isolé est un point de données sur un fichier, pas une garantie concernant le dossier.
Confiez le travail à un outil d'extraction dédié lorsque l'opération se répète, lorsque les fichiers proviennent de plusieurs sources, lorsque le résultat alimente des rapports ou des paiements, et lorsqu'une mauvaise cellule a un coût. La frontière entre transcription et extraction est ce qui sépare les deux catégories, et il vaut la peine de lire en entier l'extraction de documents manuscrits, où la même distinction décide si un nombre peut être fiable. Rien de tout cela ne fait d'un assistant généraliste un mauvais produit. Cela en fait le mauvais produit pour une tâche définie par la répétition et la cohérence.
Copilot dans Excel et PDF vers Excel : questions fréquentes
Pourquoi Copilot dans Excel indique-t-il qu'il ne peut pas lire mon PDF ?
Copilot dans Excel fonctionne sur les données du classeur. Un PDF présent dans un dossier ne fait pas partie de son contexte, sauf si vous l'associez via une interface prise en charge, et même dans ce cas, il est traité comme un document plutôt que chargé comme un tableau. Si le PDF est un scan sans couche de texte, il n'y a rien à lire pour une étape basée sur le texte.
ChatGPT est-il meilleur que Copilot pour convertir un PDF en Excel ?
Pour une conversion ponctuelle d'un fichier propre unique de PDF en Excel avec ChatGPT, cela arrive parfois, et le fil r/excel mentionne quelqu'un qui a eu exactement cette expérience. Les deux sont des assistants généralistes, et aucun ne garantit que les mêmes noms de colonnes reviennent à l'exécution suivante. Choisissez entre eux en fonction du flux de travail dont vous avez besoin, et non de celui qui a réussi une fois.
Copilot in Excel peut-il convertir un PDF en tableau ?
Le guide de Microsoft indique que oui, et pour un fichier bien structuré, c'est une description juste. La limite apparaît avec l'échelle et les entrées désordonnées : plusieurs fichiers en une seule passe, des mises en page incohérentes et des pages scannées. La conversion qui fonctionne dans une démo n'est pas la même chose qu'un processus que vous pouvez relancer le mois prochain.
Pourquoi les en-têtes de colonnes changent-ils entre les exécutions ?
Parce qu'un modèle conversationnel génère une réponse à chaque fois plutôt que de remplir un schéma fixe. La forme de la sortie fait partie de ce que le modèle décide, elle peut donc varier selon le fichier, la formulation, ou sans raison particulière. Seul un ensemble de colonnes défini fixe les en-têtes.
Que dois-je rechercher dans un outil de conversion PDF en Excel ?
Cinq choses : vous définissez les colonnes de sortie, il traite plusieurs fichiers en une seule exécution, les en-têtes sont identiques entre les exécutions, les valeurs extraites peuvent être retracées jusqu'à la page source, et il gère les documents scannés plutôt que uniquement les fichiers avec une couche de texte.
Est-ce un problème de prompt ?
Pas vraiment. Un meilleur prompt peut améliorer un résultat unique, et cela vaut la peine d'essayer. Cela ne crée pas un contrat de colonnes fixe sur cinquante fichiers, et cela n'augmente pas la limite de taille de fichier ou le nombre de fichiers en une seule passe. Ce sont des limites structurelles, pas des problèmes de formulation.
Le changement utile consiste à passer de la question « quelle IA est la plus intelligente » à « quelle est la forme de cette tâche ». Copilot, ChatGPT et Claude sont conçus pour raisonner sur des données que vous possédez déjà. Un dossier de PDF est une donnée que vous ne possédez pas encore, et le travail de le transformer en tableau est défini par la répétition, des colonnes fixes et la vérification, plutôt que par l'ingéniosité. Décidez d'abord lequel des deux vous faites, et le choix de l'outil cesse d'être une question d'opinion.