Copilot Fue Diseñado para Trabajar Dentro de Excel,
No para Extraer Datos de un PDF
La guía oficial de Microsoft dice que Copilot en Excel puede convertir un PDF en una hoja de cálculo editable (Microsoft). Un hilo en r/excel cuenta algo distinto: un usuario escribió que Copilot "no pudo completar la simple solicitud de convertir un pdf a excel", mientras que ChatGPT "lo hizo en segundos con un resultado perfecto" (r/excel). La diferencia viene de algo más específico que una función defectuosa: un asistente conversacional al que se le pide hacer un trabajo para el que nunca fue diseñado.
Conclusiones Clave
- Probablemente no sea su indicación, porque Copilot en Excel fue diseñado para editar libros de trabajo y convertir una carpeta de PDF en una tabla ocurre antes de que su trabajo siquiera comience.
- Una herramienta que obtiene 86 % en campos individuales aún logra menos de la mitad de sus filas completamente correctas.
- Deje de buscar una mejor indicación, porque la solución es nombrar sus columnas una vez y procesar toda la carpeta en un solo lote.
Copilot in Excel y una herramienta de PDF a tabla resuelven dos problemas distintos
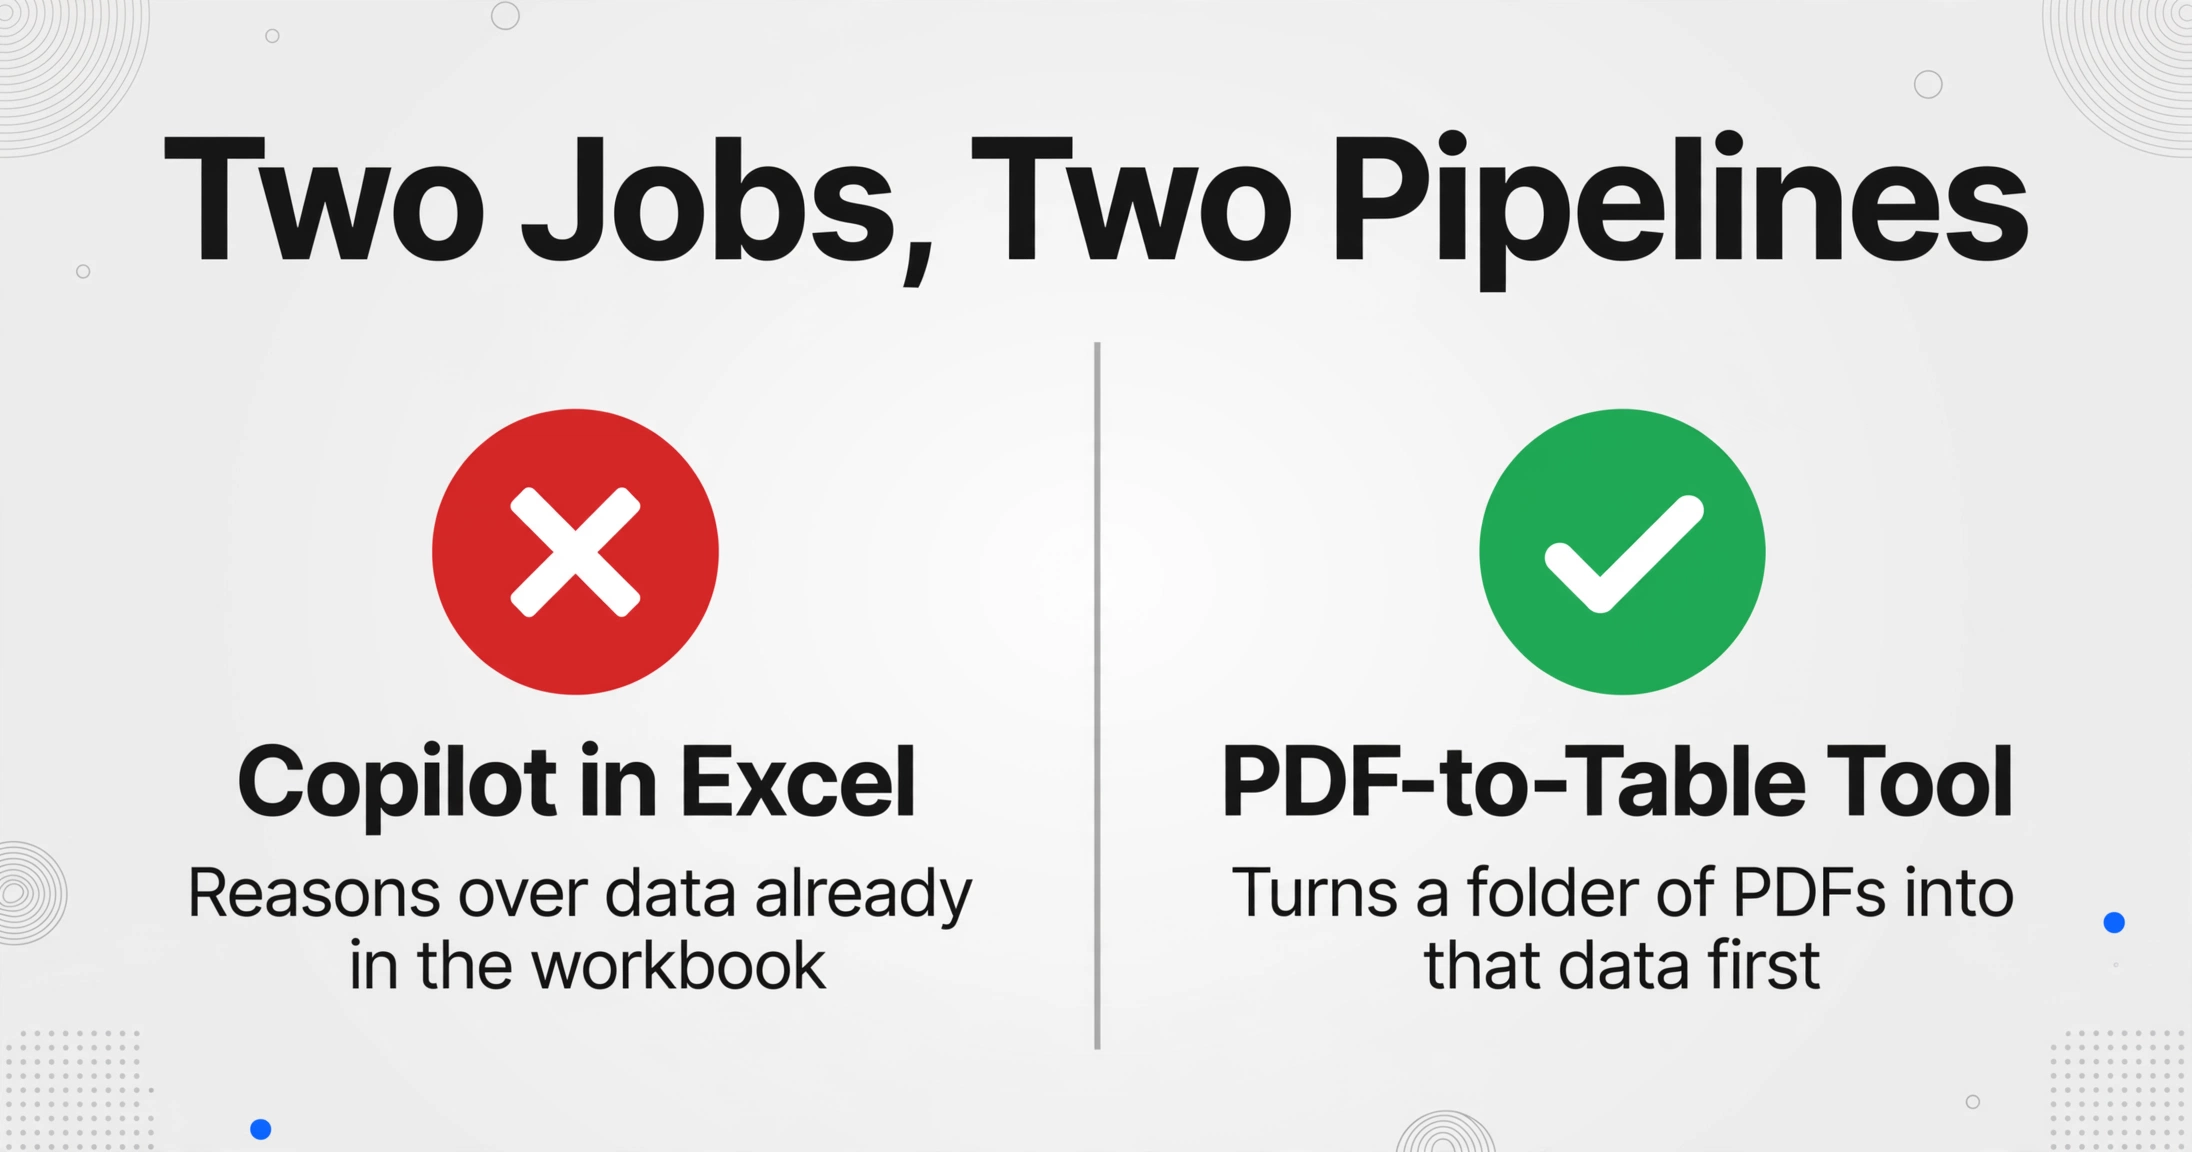
Copilot razona sobre datos que ya están en su libro de trabajo. Convertir una carpeta de PDFs en esos datos es una tarea que ocurre antes de que comience el trabajo de Copilot.
El trabajo documentado de Copilot in Excel es el libro de trabajo. Microsoft lo describe como una función que le ayuda a "crear y editar libros de trabajo": generar y explicar fórmulas, devolver información como gráficos o tablas dinámicas, resaltar, ordenar, filtrar y resumir columnas de texto. Cada una de esas tareas comienza desde una tabla que ya existe en una hoja.
La tarea de PDF a tabla es la ingesta. Los datos viven fuera del libro de trabajo, en un formato de archivo que almacena dónde se ubican los caracteres en una página en lugar de a qué columna pertenecen. Convertir esos datos en una tabla con las columnas que usted desea, desde cada archivo, es un paso separado que ocurre antes de que pueda comenzar cualquier análisis.
Microsoft ha lanzado un proceso separado para la ingesta durante años. El importador más antiguo Datos → Obtener datos → Desde archivo → Desde PDF lee solo la capa de texto que un PDF contiene, por lo que no devuelve nada en un documento escaneado. Ese proceso y el de Copilot no son el mismo código, y ninguno fue creado para producir el mismo conjunto de columnas a partir de cincuenta archivos con formatos diferentes. La guía de PDF a datos estructurados explica por qué falla cada método de conversión y en qué tipos de archivo.
Mantener separadas las dos tareas explica la frustración en ese hilo sin convertirlo en un debate de marcas. Copilot no está fallando en el análisis. Se le está asignando una tarea de ingesta, y la ingesta es donde tiene menos con qué trabajar.
Lo que Copilot en Excel realmente hace bien
Copilot es bueno en el trabajo para el que fue diseñado, y el mismo hilo escéptico lo dice.
Los usuarios que se quedaron con él lo describieron como "excelente para generar fórmulas" y útil para actas de reuniones, resúmenes de documentos y para construir un análisis sobre un tema técnico. Una respuesta fue directa sobre el valor real: "lo único en lo que siento que realmente me ha ayudado es a escribir VBA". Cuando los datos ya están en la hoja, pedirle a Copilot que explique una fórmula o que señale un valor atípico es un uso razonable de un asistente de IA.
La línea divisoria honesta es si los datos ya existen en el libro de trabajo.
| Lo que está haciendo | Copilot en Excel | Una herramienta de extracción por lotes |
|---|---|---|
| Los datos ya están en una hoja | Muy adecuado: fórmulas, información, tablas dinámicas, resúmenes | No es el objetivo; los datos ya están estructurados |
| Un PDF limpio que necesita una sola vez | Normalmente funciona después de un pegado manual y una limpieza | Funciona, pero el caso puntual no necesita un proceso automatizado |
| Una carpeta de PDF con los mismos campos | Frágil: un archivo a la vez, los encabezados varían entre ejecuciones | El caso diseñado: las mismas columnas de cada archivo |
| Una ejecución mensual recurrente | Forma incorrecta: volver a solicitar reintroduce la variación | Reutilice el mismo conjunto de columnas y vuelva a ejecutar el lote |
Una vez que los datos de origen son una tabla, Copilot puede tomar el control y hacer un trabajo útil con ellos. El problema es todo lo que tiene que suceder antes de ese momento.
Por qué un asistente conversacional falla en la extracción repetible
Cuatro propiedades estructurales de un asistente de chat van en contra de la extracción repetible, y ninguna se soluciona con un mejor mensaje.
La forma de la salida no está garantizada. Las preguntas frecuentes de Microsoft dicen que Copilot "a veces puede cometer errores, malinterpretar información o producir resultados inexactos", y desaconsejan usarlo "para decisiones en áreas sensibles como finanzas, asuntos legales o temas médicos" (Soporte de Microsoft). Una función de hoja de cálculo retirada de Copilot llevaba la misma advertencia en forma más contundente: los resultados "pueden cambiar con el tiempo, incluso con los mismos argumentos", y para cualquier cosa que requiera "precisión o reproducibilidad", Microsoft remitía a los usuarios a las fórmulas nativas (función COPILOT). Una herramienta cuyo fabricante le dice que no confíe en ella para decisiones financieras es un buen compañero de pensamiento y un mal sistema de registro.
No hay un contrato de columnas. Usted pide una tabla y obtiene una tabla, pero no necesariamente la misma dos veces. La siguiente ejecución puede renombrar "Invoice Date" a "Date", mover una columna o fusionar dos campos en uno. Un usuario en el hilo de r/excel describió el efecto con precisión: "Obtengo resultados muy diferentes con exactamente los mismos datos e instrucciones". Cuando cuarenta archivos producen cuarenta tablas ligeramente diferentes, la fusión y el renombrado recaen en la persona que intentaba ahorrar tiempo.
Está diseñado para un archivo a la vez. La documentación de carga de archivos de OpenAI limita los documentos a 2 millones de tokens cada uno y las imágenes a 20MB, y esos límites se aplican a una sola conversación, no a una carpeta (OpenAI). Un extracto bancario de doce páginas con tres tablas es exactamente la forma que alcanza esos límites, y el fallo es silencioso: la respuesta llega más corta que el documento. Los archivos escaneados lo empeoran, ya que no hay capa de texto que leer a menos que la herramienta trate la página como una imagen, lo cual se cubre en si la IA puede extraer datos de un PDF.
La precisión a nivel de registro es mucho menor que la precisión a nivel de campo. Este es el número que casi nadie ve. El punto de referencia de salida estructurada de Cleanlab separa Field Accuracy (la proporción de campos individuales correctos) de Output Accuracy (la proporción de registros donde cada campo es correcto). En su conjunto de Data Table Analysis, gpt-4.1-mini obtuvo 86.3 % a nivel de campo, pero 45 % a nivel de registro; en extracción de reclamos de seguros, la precisión a nivel de registro se situó entre 30 % y 40 % en los modelos de frontera; en extracción de PII cayó a 26 %–46 % (Cleanlab).
Un número de campo como 90 % suena tranquilizador hasta que necesita la fila completa. Diez campos al 95 % cada uno dejan aproximadamente un 60 % de probabilidad de que una fila dada esté completamente limpia, y los errores se acumulan a medida que crece el lote. Para una carpeta de facturas, el único número que importa es cuántas filas son correctas.
El mismo patrón aparece fuera de Excel. En un hilo de r/ChatGPT sobre el análisis de listas de contratistas desde PDF, el autor original tuvo un solo documento que funcionó bien, y luego vio cómo los resultados se desplomaban al combinar tres archivos: «No pude lograr que generara más de 4 resultados en una hoja de cálculo que debería haber tenido más de 100». Un comentarista resumió la experiencia: «parsear PDF es una verdadera lotería... Faltan páginas, faltan líneas, faltan valores» (r/ChatGPT). Nada de un modelo más grande elimina esas cuatro propiedades, por lo que una herramienta diseñada específicamente para procesamiento por lotes de documentos es una categoría de producto diferente, no un chatbot más potente.
Una prueba que puede hacer en veinte minutos
La mayoría de las búsquedas sobre Copilot en Excel que no funciona se reducen a una pregunta: ¿es mi indicación o la herramienta? Puede resolverlo con sus propios archivos antes de cambiar nada, y debería ejecutar las mismas comprobaciones tanto en una ejecución de Copilot de PDF a Excel como en una de ChatGPT. Cuatro de ellas separan una demostración que le impresionó una vez de una herramienta sobre la que puede construir un proceso mensual.
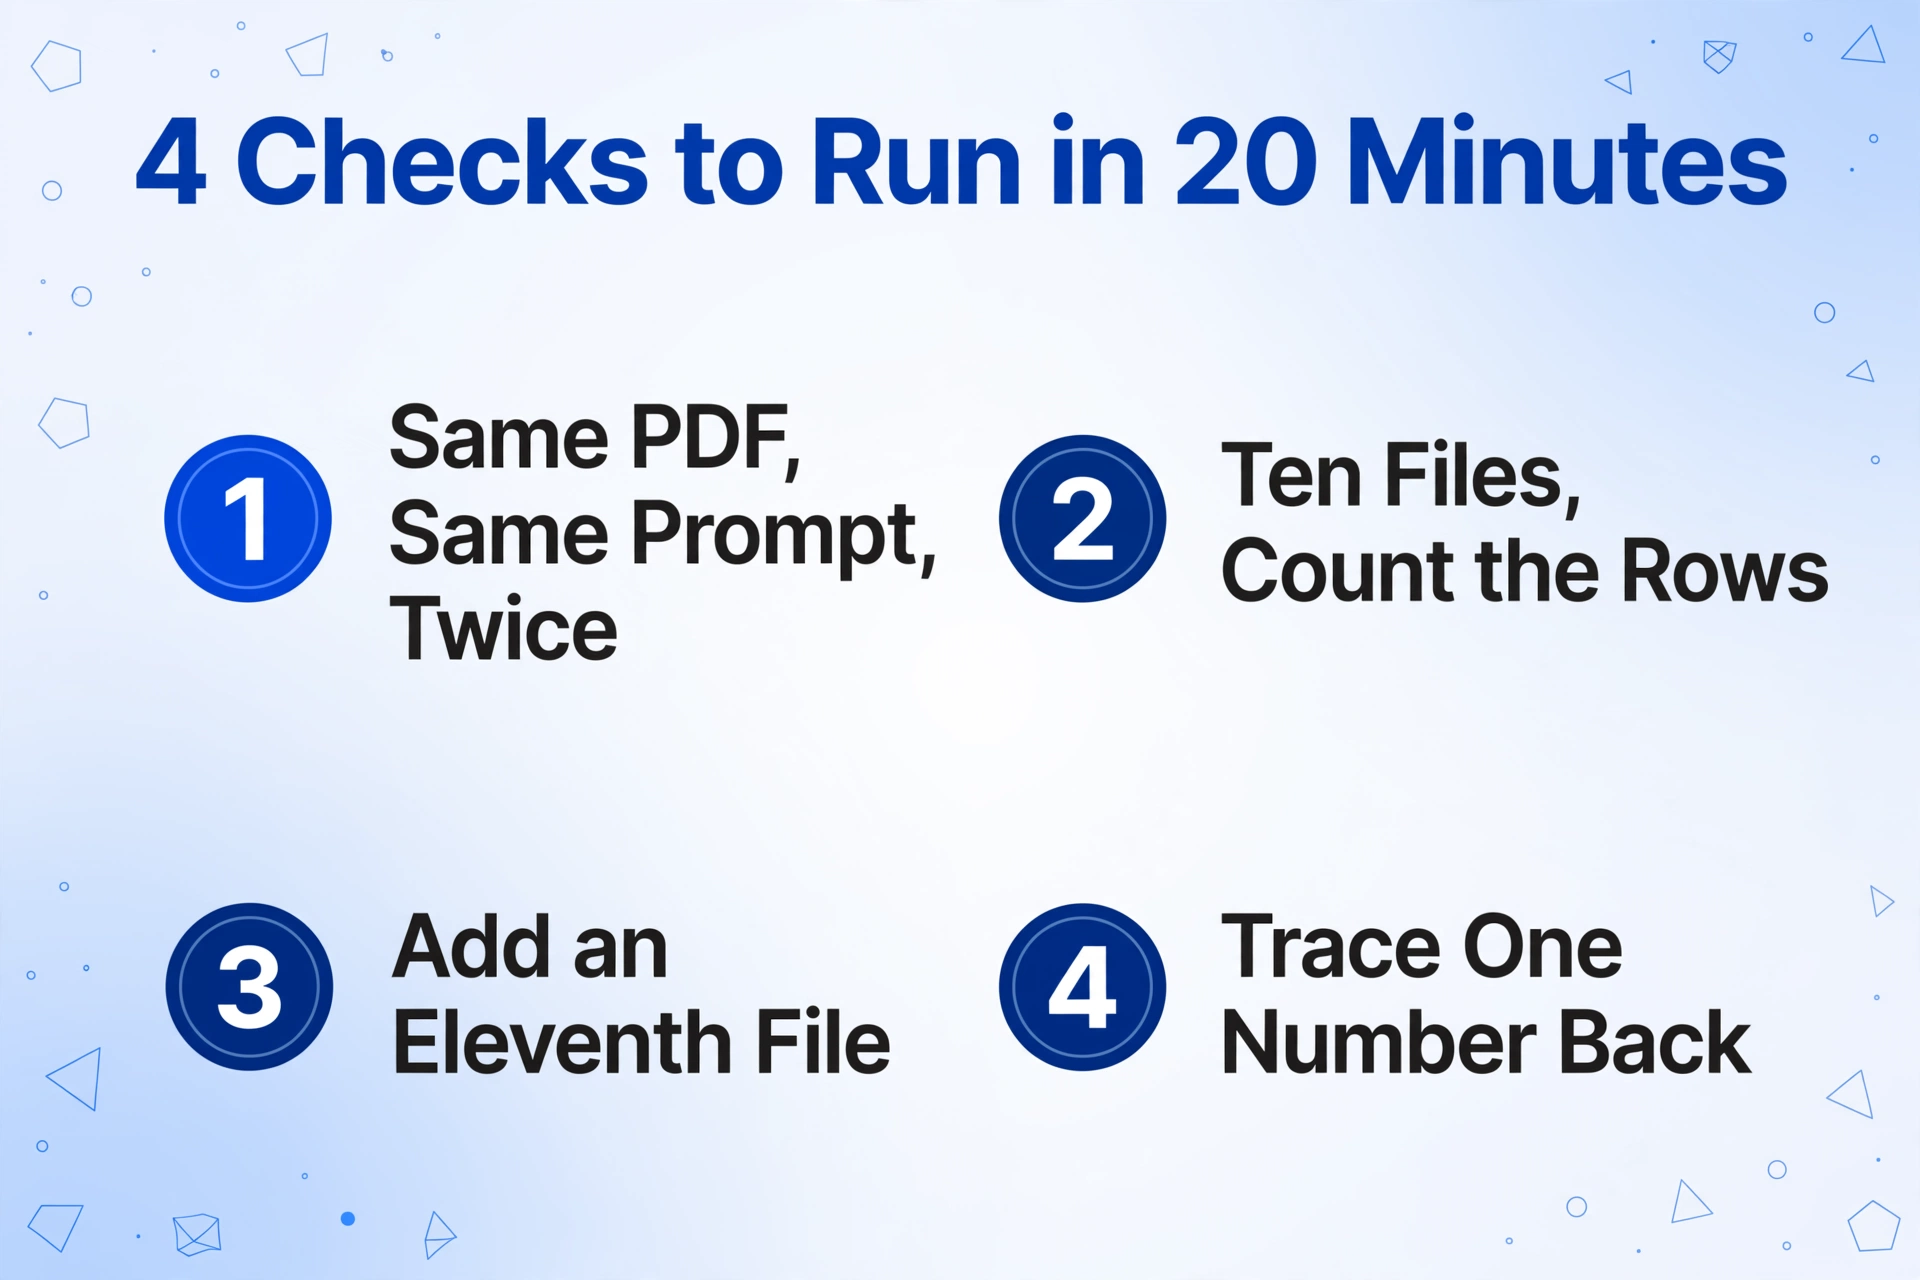
Ejecute el mismo PDF dos veces con la misma indicación
Compare la fila de encabezados celda por celda. Si los nombres de columna o su orden difieren entre dos ejecuciones sobre un mismo archivo, no tiene un contrato de columnas y ninguna fórmula posterior se mantendrá.
Ejecute diez archivos y cuente las filas
Un estado de cuenta con 63 transacciones debería producir 63 filas. Anote el recuento esperado junto al real para cada archivo. Un solo archivo que devuelva 40 filas es el modo de fallo que nunca se anuncia a sí mismo.
Añada un undécimo archivo con un diseño diferente
Use un estado de cuenta de otro banco o una factura de otro proveedor. Una herramienta que solo funciona con diseños idénticos es una demostración, no un proceso, porque los conjuntos de documentos reales nunca son uniformes.
Rastree un número hasta su página
Elija un único valor extraído y encuentre de dónde proviene en el origen. Si la verificación implica reabrir cada PDF manualmente, la extracción ahorró menos tiempo del que costó confiar en ella.
Si alguna de estas comprobaciones falla, la herramienta sirve para un caso puntual y no para un trabajo repetible. Esa distinción, no un veredicto sobre la marca, es el propósito de la prueba.
Lo que necesita una herramienta que resista el procesamiento por lotes a gran escala
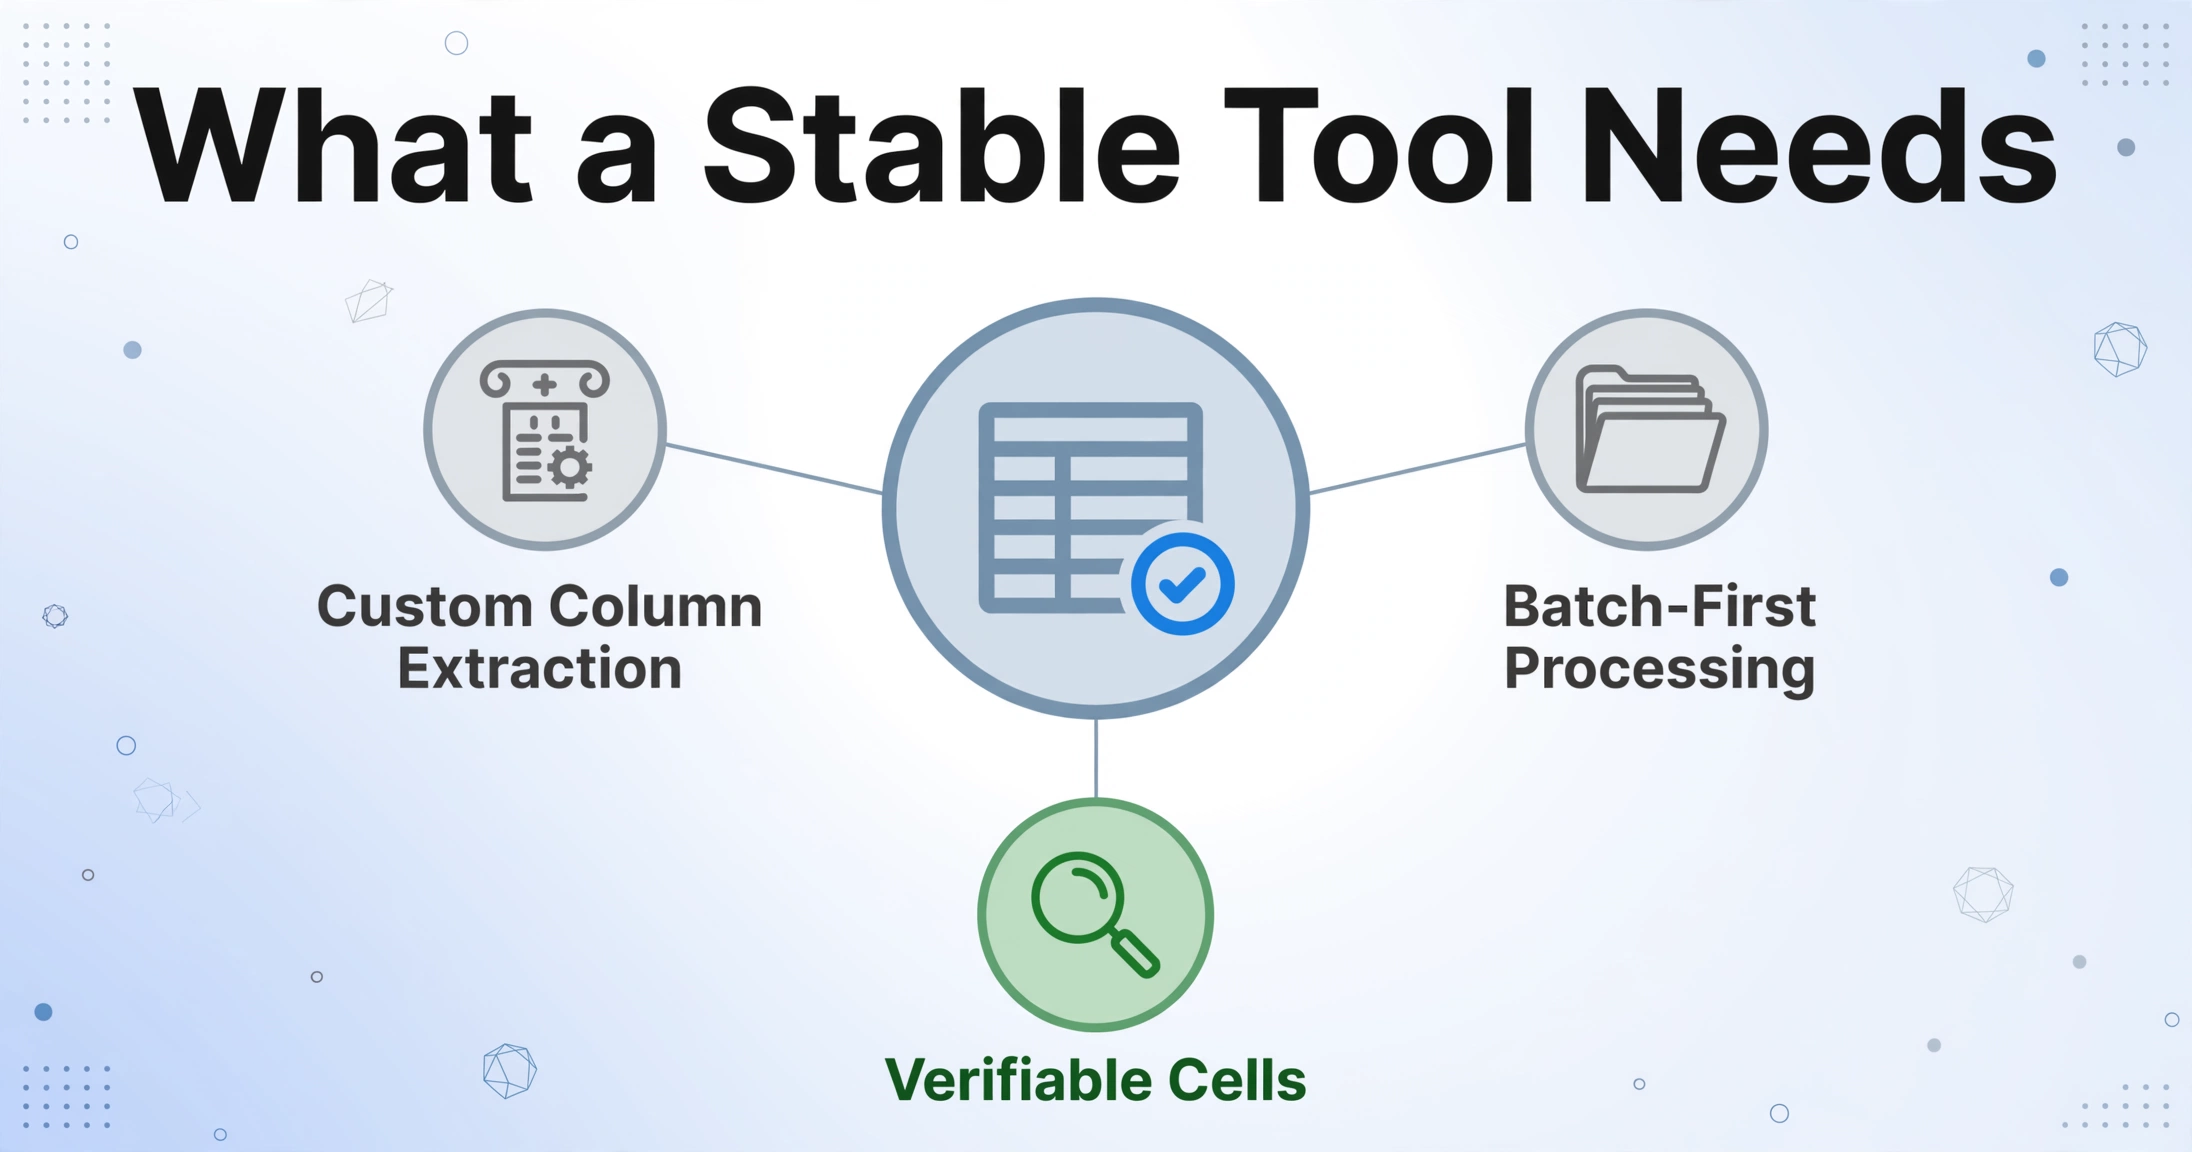
Una herramienta que supera esas comprobaciones está construida en torno al contrato de salida primero, no al documento. Esa única decisión de diseño produce la mayoría de las demás propiedades.
El primer requisito es que usted nombre las columnas de salida, y esos nombres se convierten en los encabezados exactos del resultado. Esto es Extracción de Columnas Personalizadas: en lugar de dejar que el modelo decida qué devolver, usted escribe los campos que desea, como "Invoice Number", "Statement Date" y "Balance", y la IA localiza cada valor por lo que significa en lugar de por dónde se encuentra. El conjunto de columnas es suyo, por lo que se mantiene igual de un archivo a otro.
El segundo requisito es que la herramienta procese la carpeta en lugar del archivo. Procesamiento por lotes prioritario significa que entran cincuenta documentos y sale una sola tabla, en lugar de cincuenta conversaciones separadas que usted pega después. Es la diferencia entre hacer una pregunta cincuenta veces y ejecutar un solo trabajo una vez, y es el punto donde los asistentes generales son estructuralmente más débiles.
Dos requisitos menores vienen después. La fila de encabezados debe ser idéntica cada vez que ejecute el mismo conjunto de columnas, y usted debe poder señalar cualquier celda extraída y ver la región de la fuente de la que proviene, porque un valor que no puede verificar es un valor que debe revisar a mano. Una herramienta que carece de cualquiera de estos no está ahorrando el paso de revisión, lo está moviendo.
ImageToTable.ai está construido sobre esas dos piezas principales, la extracción de columnas personalizadas y el procesamiento por lotes: usted sube los documentos, escribe los nombres de columna que desea y obtiene una hoja de cálculo donde esos nombres son los encabezados. El producto cita una precisión de hasta 99 % en datos de tablas impresas, con una sola página procesada en 5 a 10 segundos frente a los aproximadamente 3 minutos que una persona dedica a teclear la misma página a mano. El mismo enfoque se presenta frente al campo más amplio en la comparación de software de extracción de datos, que es donde debe mirar si la decisión es entre proveedores en lugar de entre categorías.
Los archivos se procesan de forma segura y no se almacenan.
La distinción entre describir un documento y extraer un conjunto fijo de campos de él no es solo una característica del producto. Cambia lo que puedes construir sobre el resultado, que es el argumento de por qué los asistentes generales se quedan cortos para la misma tarea en capturas de pantalla.
Cuándo Copilot, ChatGPT o Claude es la opción correcta
Copilot es la herramienta adecuada para trabajos puntuales sobre datos que ya están en un libro de trabajo, y la herramienta equivocada para un lote recurrente donde las columnas deben coincidir.
Úselo cuando la fuente sea un solo archivo limpio, cuando esté explorando un conjunto de datos que ya tiene, o cuando necesite que le expliquen una fórmula o que le resuman una columna de texto. ChatGPT es una opción razonable en las mismas situaciones, y es posible que convierta correctamente un PDF ordenado al primer intento. Un solo éxito es un dato sobre un archivo, no una garantía sobre la carpeta.
Entregue el trabajo a una herramienta de extracción dedicada cuando la operación se repita, cuando los archivos lleguen de varias fuentes, cuando el resultado alimente informes o pagos, y cuando una celda incorrecta tenga un costo. La línea entre transcripción y extracción es lo que separa las dos categorías, y vale la pena leerla completa para extracción de documentos manuscritos, donde la misma distinción decide si se puede confiar en un número. Nada de esto convierte a un asistente general en un mal producto. Lo convierte en el producto equivocado para un trabajo definido por la repetición y la consistencia.
Copilot en Excel y PDF a Excel: preguntas frecuentes
¿Por qué Copilot en Excel dice que no puede leer mi PDF?
Copilot en Excel trabaja con los datos dentro del libro de trabajo. Un PDF en una carpeta no forma parte de su contexto a menos que lo adjunte en una superficie compatible, e incluso entonces se procesa como documento en lugar de cargarse como tabla. Si el PDF es un escaneo sin capa de texto, no hay nada que un paso basado en texto pueda leer.
¿Es ChatGPT mejor que Copilot para convertir PDF a Excel?
Para una conversión única de PDF a Excel con ChatGPT de un solo archivo limpio, a veces lo es, y el hilo de r/excel incluye a alguien que tuvo exactamente esa experiencia. Ambos son asistentes generales, y ninguno garantiza que los mismos nombres de columna vuelvan en la siguiente ejecución. Elija entre ellos según el flujo de trabajo que necesite, no según cuál haya tenido éxito una vez.
¿Puede Copilot in Excel convertir un PDF en una tabla?
La guía de Microsoft dice que sí, y para un archivo bien formado esa es una descripción justa. La limitación aparece con la escala y con entradas desordenadas: varios archivos en una sola pasada, diseños inconsistentes y páginas escaneadas. La conversión que funciona en una demostración no es lo mismo que un proceso que pueda repetir el próximo mes.
¿Por qué cambian los encabezados de columna entre ejecuciones?
Porque un modelo conversacional genera una respuesta cada vez en lugar de completar un esquema fijo. La forma de la salida es parte de lo que el modelo decide, por lo que puede variar según el archivo, la redacción o nada en particular. Solo un conjunto de columnas definido fija los encabezados.
¿Qué debo buscar en una herramienta de PDF a Excel?
Cinco cosas: que usted defina las columnas de salida, que procese muchos archivos en una sola ejecución, que los encabezados sean idénticos entre ejecuciones, que los valores extraídos puedan rastrearse hasta la página de origen, y que maneje documentos escaneados en lugar de solo archivos con capa de texto.
¿Es un problema de indicaciones?
En su mayoría no. Una mejor indicación puede mejorar un resultado individual, y vale la pena intentarlo. No crea un contrato de columnas fijo entre cincuenta archivos, y no eleva el límite de tamaño de archivo ni la cantidad de archivos en una sola pasada. Esos son límites estructurales, no problemas de redacción.
El cambio útil es pasar de preguntar "qué IA es más inteligente" a preguntar "qué forma tiene esta tarea". Copilot, ChatGPT y Claude están diseñados para razonar sobre datos que usted ya tiene. Una carpeta de PDF es datos que aún no tiene, y el trabajo de convertirlos en una tabla se define por la repetición, las columnas fijas y la verificación, no por la inteligencia. Decida primero cuál de las dos cosas está haciendo, y la elección de herramienta dejará de ser una cuestión de opinión.