L'IA peut-elle extraire les données des étiquettes d'expédition
& des manifestes ? Ce qui fonctionne, ce qui ne fonctionne pas
Oui — l'IA de vision moderne extrait les données des étiquettes d'expédition avec une grande précision sur les champs imprimés, et gère les tableaux de manifestes multi-lignes sans configuration de modèle par transporteur. Mais la fourchette de confiance est large : les numéros de suivi et les chaînes décodées par code-barres dépassent 97 %, tandis que les annotations de poids manuscrites, les abréviations de niveau de service et les cellules de manifeste fragmentées descendent à 70–85 %. La vraie question n'est pas « l'IA peut-elle le faire » mais « à quels champs pouvez-vous faire confiance sans vérification manuelle ».
Points clés à retenir
- Les numéros de suivi sur les étiquettes imprimées atteignent une précision d'extraction de 97-99 % — supérieure à celle d'un humain fatigué à la sixième heure de saisie manuelle.
- Sur un lot de 50 étiquettes et 3 manifestes, 88-94 % des champs sont extraits correctement sans intervention humaine. Corriger les 6-12 % restants prend 5-15 minutes au lieu de 60-120.
- Le vrai défi avec les manifestes n'est pas de lire le texte mais de maintenir l'alignement des colonnes — 200 lignes sur 12 pages où un seul décalage de champ se répercute sur l'ensemble du document.
Avant de répartir la réponse entre étiquettes et manifestes, une distinction compte : l'OCR traditionnel et l'extraction sémantique par IA traitent ces documents de manière très différente. Un outil OCR basé sur des modèles qui fonctionne sur les étiquettes FedEx Ground échouera sur une étiquette UPS Air ou une étiquette DHL eCommerce, car chaque transporteur positionne les champs dans des quadrants différents. L'extraction sémantique — l'approche où l'IA lit un champ selon sa signification, et non selon son emplacement — gère plusieurs formats de transporteurs sans configuration par fournisseur. Cette différence est le fondement de tout ce qui suit, et elle est abordée en détail dans notre guide complet sur l'OCR pour la logistique.
Étiquettes d'expédition : répartition de la précision champ par champ
Une étiquette d'expédition standard — qu'elle provienne d'UPS, FedEx, USPS ou DHL — contient 8 à 12 points de données extractibles compressés dans un espace plus petit qu'une page A5. La densité est le défi : une étiquette thermique de 4″ × 6″ peut contenir un numéro de suivi, un code-barres, deux blocs d'adresse, un indicateur de niveau de service, le poids du colis, la date d'expédition et des champs de référence, le tout séparé par des repères visuels plutôt que par des zones étiquetées.
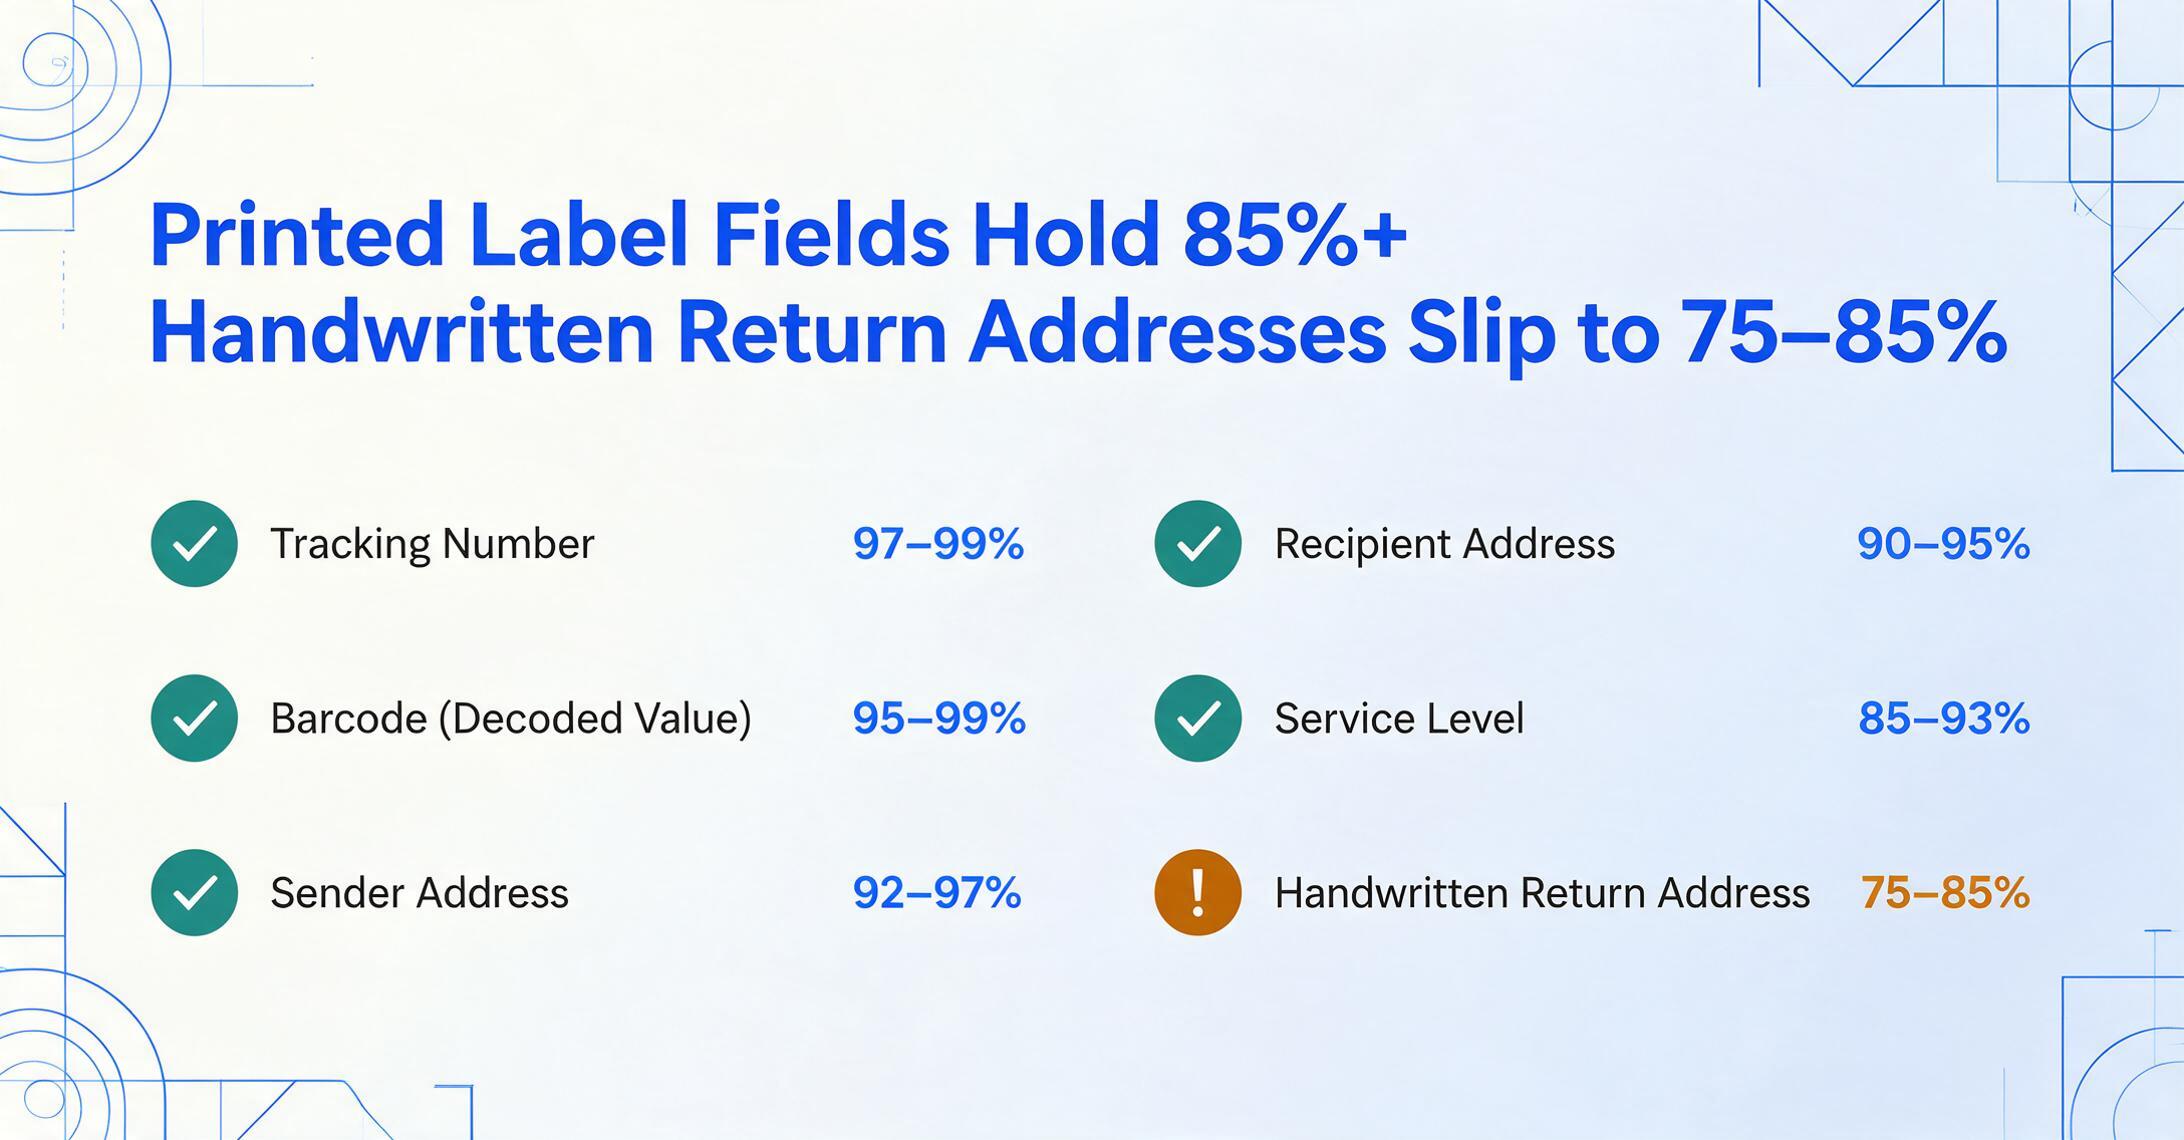
Voici le profil de précision au niveau des champs pour l'extraction sémantique par IA sur les étiquettes d'expédition typiques imprimées par les transporteurs (texte imprimé, bonne qualité d'image) :
| Champ | Plage de précision IA | Pourquoi cette plage |
|---|---|---|
| Numéro de suivi | 97–99% | Alphanumérique avec clé de contrôle ; les préfixes transporteurs (1Z, 9361, GM) sont des motifs prévisibles. Les modèles d'IA les reconnaissent comme des codes structurés, pas du texte libre. |
| Code-barres (valeur décodée) | 95–99% | Les modèles de vision détectent les zones de code-barres et les transmettent pour décodage. La valeur textuelle dans le code-barres correspond souvent au numéro de suivi imprimé — un signal de validation croisée utile. |
| Adresse de l'expéditeur | 92–97% | Généralement imprimée dans une police cohérente. Les adresses de retour imprimées sur les étiquettes thermiques sont parmi les champs les plus fiables. Les adresses de retour manuscrites tombent à 75–85%. |
| Adresse du destinataire | 90–95% | Identique à l'expéditeur pour le texte imprimé, mais parfois l'étiquette de destination est apposée sur une étiquette précédente, créant une ombre ou une occlusion partielle qui dégrade la précision. |
| Niveau de service (Sol, 2 jours, Express, etc.) | 85–93% | Les indicateurs de service varient énormément — UPS utilise une grille de cases à cocher, FedEx une barre colorée avec texte, USPS une description de classe. L'IA doit interpréter à la fois l'étiquette et son contexte visuel. Les abréviations transporteurs (« PRI » vs « Priority ») ajoutent de l'ambiguïté. |
| Poids du colis | 85–95% | Les champs de poids imprimés sont fiables. Les corrections de poids manuscrites (courantes aux guichets d'expédition) sont le principal point de défaillance — un « 2,5 » griffonné sur un « 2,0 » est difficile à analyser avec confiance pour toute IA. |
| Date d'expédition | 90–96% | Les dates apparaissent dans plusieurs formats (30/06/2026, 30-JUIN-2026, 2026-06-30). L'IA sémantique les normalise bien, mais certains transporteurs impriment la date d'expédition dans le même format que le numéro de suivi, à proximité — l'IA doit les distinguer par le contexte de l'étiquette, pas par le format. |
| Champs de référence (N° commande, N° service, Réf client) | 80–90% | Les numéros de référence sont spécifiques au transporteur et souvent fusionnés dans un champ « Référence » générique. Quand l'étiquette indique « Réf : 54829-12 », l'IA extrait correctement la chaîne, mais savoir si cette chaîne correspond à un numéro de commande, une référence client ou un numéro de facture interne dépend du contexte. |
Le chiffre clé — champs imprimés à 90%+ — est cohérent avec les références générales de précision pour l'IA de vision moderne par rapport à l'OCR traditionnelle. L'essentiel pour les équipes logistiques est que les numéros de suivi et les adresses sont des problèmes essentiellement résolus pour les étiquettes imprimées, tandis que les indicateurs de niveau de service et les champs de référence nécessitent encore une vérification ponctuelle.
La question du code-barres : l'IA est-elle perturbée ?
C'est la préoccupation que les professionnels de la logistique soulèvent le plus souvent : une étiquette d'expédition est un champ dense d'éléments visuels mixtes — texte, codes-barres, codes QR, cases à cocher, logos de transporteurs — le tout condensé dans un petit espace. L'IA ne va-t-elle pas tenter de « lire » le code-barres comme du texte et produire un résultat inexploitable qui polluera le reste de l'extraction ?
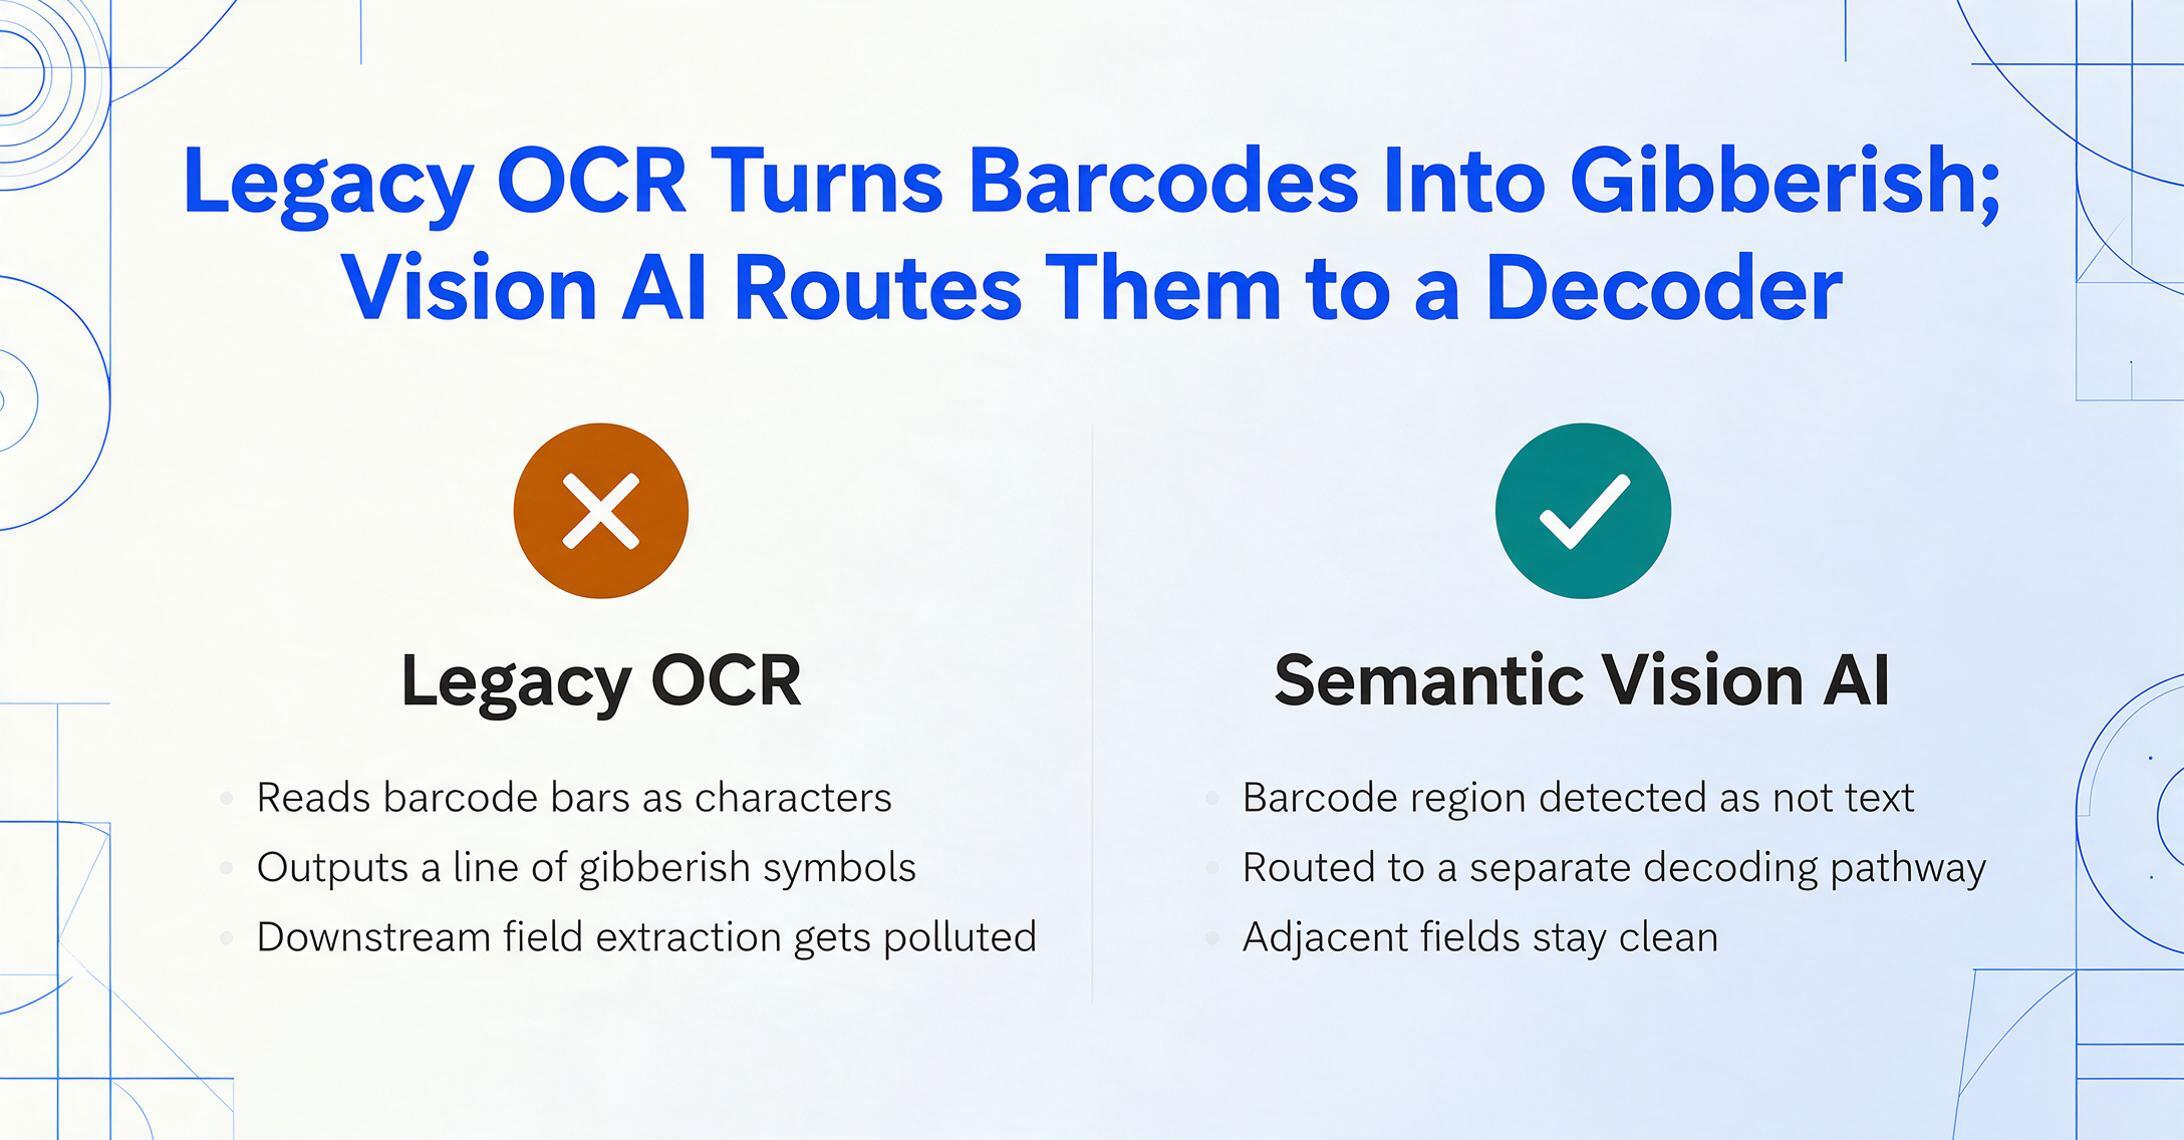
La réponse courte est que l'IA à vision ne confond pas les zones de code-barres avec les zones de texte — car les caractéristiques visuelles d'un code-barres (barres alternées de largeur variable avec une zone de silence blanche en bordure) sont fondamentalement différentes de celles des caractères de texte (traits, empattements, espacement des lettres). Le socle visuel de l'IA fait cette distinction au niveau de la détection des caractéristiques, et non au niveau du post-traitement. La zone du code-barres est identifiée comme « non-texte » et acheminée vers un chemin de décodage séparé plutôt que d'être envoyée dans le même pipeline OCR.
Cette distinction est importante car elle évite un problème classique de l'OCR hérité : lorsqu'un moteur OCR traditionnel rencontre un code-barres Code 128 dense ou un code QR, il tente souvent de lire les barres comme des caractères — produisant une ligne de symboles incohérents qui pollue ensuite toute extraction de champs en aval. L'opérateur doit alors supprimer ce charabia du résultat. L'IA à vision sémantique évite entièrement ce problème en n'acheminant pas les zones de code-barres vers le décodeur de texte dès le départ.
Le résultat pratique est que vous pouvez extraire des données d'une étiquette sans craindre que le code-barres ne provoque des erreurs en cascade dans les champs adjacents. Le défi passe de la « pollution par code-barres » à une autre question : l'IA associe-t-elle correctement la valeur décodée du code-barres au numéro de suivi imprimé sur la même étiquette ? Dans la plupart des cas, ils correspondent — le code-barres encode le même numéro de suivi imprimé au-dessus en texte lisible par l'humain. Lorsqu'ils ne correspondent pas (étiquette mal appliquée ou réemballage en entrepôt), l'écart constitue en soi un signal utile indiquant qu'un examen humain est nécessaire.
Quand le texte adjacent au code-barres peut encore piéger l'IA
Bien que les zones de code-barres soient correctement traitées, le texte imprimé dans ou immédiatement à côté des libellés de zone de code-barres peut prêter à confusion. Par exemple, les étiquettes USPS impriment le numéro de suivi à la fois en texte lisible au-dessus du code-barres et comme valeur encodée du code-barres. Certains transporteurs impriment un numéro de référence secondaire directement sous le code-barres dans une police plus petite qui empiète sur ce que l'IA perçoit comme la zone de silence du code-barres. Dans ces cas, l'IA peut soit :
- Ignorer complètement le texte secondaire car il a été rogné de la zone de détection de texte ;
- Soit, si la distance entre le code-barres et le texte est suffisamment grande, l'identifier correctement mais avec une confiance moindre en raison de la proximité d'une zone non textuelle.
Ces cas particuliers concernent environ 3 à 5 % des étiquettes et sont facilement détectés lors d'une relecture humaine. Le point important est qu'il s'agit de données manquées, pas de données erronées — l'IA extrait avec précision ce qu'elle identifie et signale les zones de faible confiance pour révision.
Manifestes d'expédition : données tabulaires à grande échelle
Les manifestes d'expédition présentent un défi d'extraction fondamentalement différent de celui des étiquettes. Un manifeste — qu'il s'agisse du manifeste de fin de journée d'un transporteur, d'un manifeste de cargaison maritime ou d'un manifeste d'entrée en douane — est un document multi-lignes listant chaque envoi d'un lot, s'étendant souvent sur plusieurs pages. Là où une étiquette est dense mais petite, un manifeste est structuré mais volumineux : 20 à 200 lignes de données d'expédition, chaque ligne contenant une partie ou la totalité des mêmes champs que ceux figurant sur les étiquettes individuelles.
L'ensemble des champs d'une ligne de manifeste comprend généralement : numéro de suivi ou numéro PRO, numéro BOL, nom de l'expéditeur, nom du destinataire, nombre de colis, poids, classe de service, description de la marchandise, et souvent code SH et valeur déclarée. Les manifestes de cargaison à l'importation régis par 19 CFR § 4.7a exigent en outre les codes SCAC, les numéros de conteneur, les identifiants de scellé et le port de chargement — les mêmes éléments de données dont les équipes douanières et comptables fournisseurs ont besoin pour le rapprochement des factures de fret.
Le défi d'extraction pour les manifestes est la délimitation des lignes tabulaires :
- Tableaux avec ou sans bordures. Les manifestes de ramassage quotidiens de FedEx utilisent des lignes de grille explicites. Les manifestes d'exportation DHL omettent souvent les bordures, s'appuyant sur l'alignement vertical des espaces. Les manifestes SCAN USPS (Shipping Container and Marking) utilisent des colonnes à largeur fixe avec des abréviations d'en-tête. L'IA doit reconnaître la structure du tableau dans chaque format avant de pouvoir extraire les lignes individuelles.
- Suite sur plusieurs pages. Un seul manifeste peut s'étendre sur 8 à 12 pages. L'IA doit identifier quelles lignes appartiennent à quel envoi entre les sauts de page, et si les en-têtes de colonnes se répètent sur chaque page (c'est généralement le cas, mais pas toujours à la même position verticale).
- Lignes de cumul. Les manifestes incluent souvent des lignes de sous-total (« Total page : 15 colis, 28,5 lb »), des lignes de total général à la fin, et des champs réservés au transporteur. L'IA doit distinguer les lignes de données des lignes de métadonnées — une étape de classification que l'OCR par modèle traite avec des règles fixes et que l'IA sémantique traite en lisant le libellé de la ligne.
- Densité de données mixte. Certaines lignes de manifeste comportent 5 champs, d'autres 15. L'IA voit les cellules remplies de chaque ligne indépendamment — une ligne avec un nombre de colis mais sans description de marchandise doit donner une cellule nulle, et non une erreur de décalage de colonne qui pousserait les champs suivants dans la mauvaise colonne.
Sur les manifestes bien structurés avec des lignes de grille explicites, l'extraction sémantique par IA atteint une précision de 90 à 95 % au niveau des lignes — soit 9 à 9,5 lignes sur 10 entièrement extraites avec des champs correctement alignés. Sur les manifestes sans bordures ou mal structurés, la précision au niveau des lignes chute à 75–85 %, le désalignement des colonnes étant le mode de défaillance le plus courant. Pour le flux de travail pratique qui transforme une semaine d'étiquettes et un manifeste de plusieurs pages en une seule feuille de calcul de suivi, consultez notre guide sur l'extraction des données d'étiquettes d'expédition et de manifestes vers Excel.
Là où l'IA a encore besoin d'un appui humain
Sans surprise, les points de défaillance se concentrent autour des mêmes scénarios qui piègent les opérateurs de saisie de données humains — juste avec des marges d'erreur différentes.
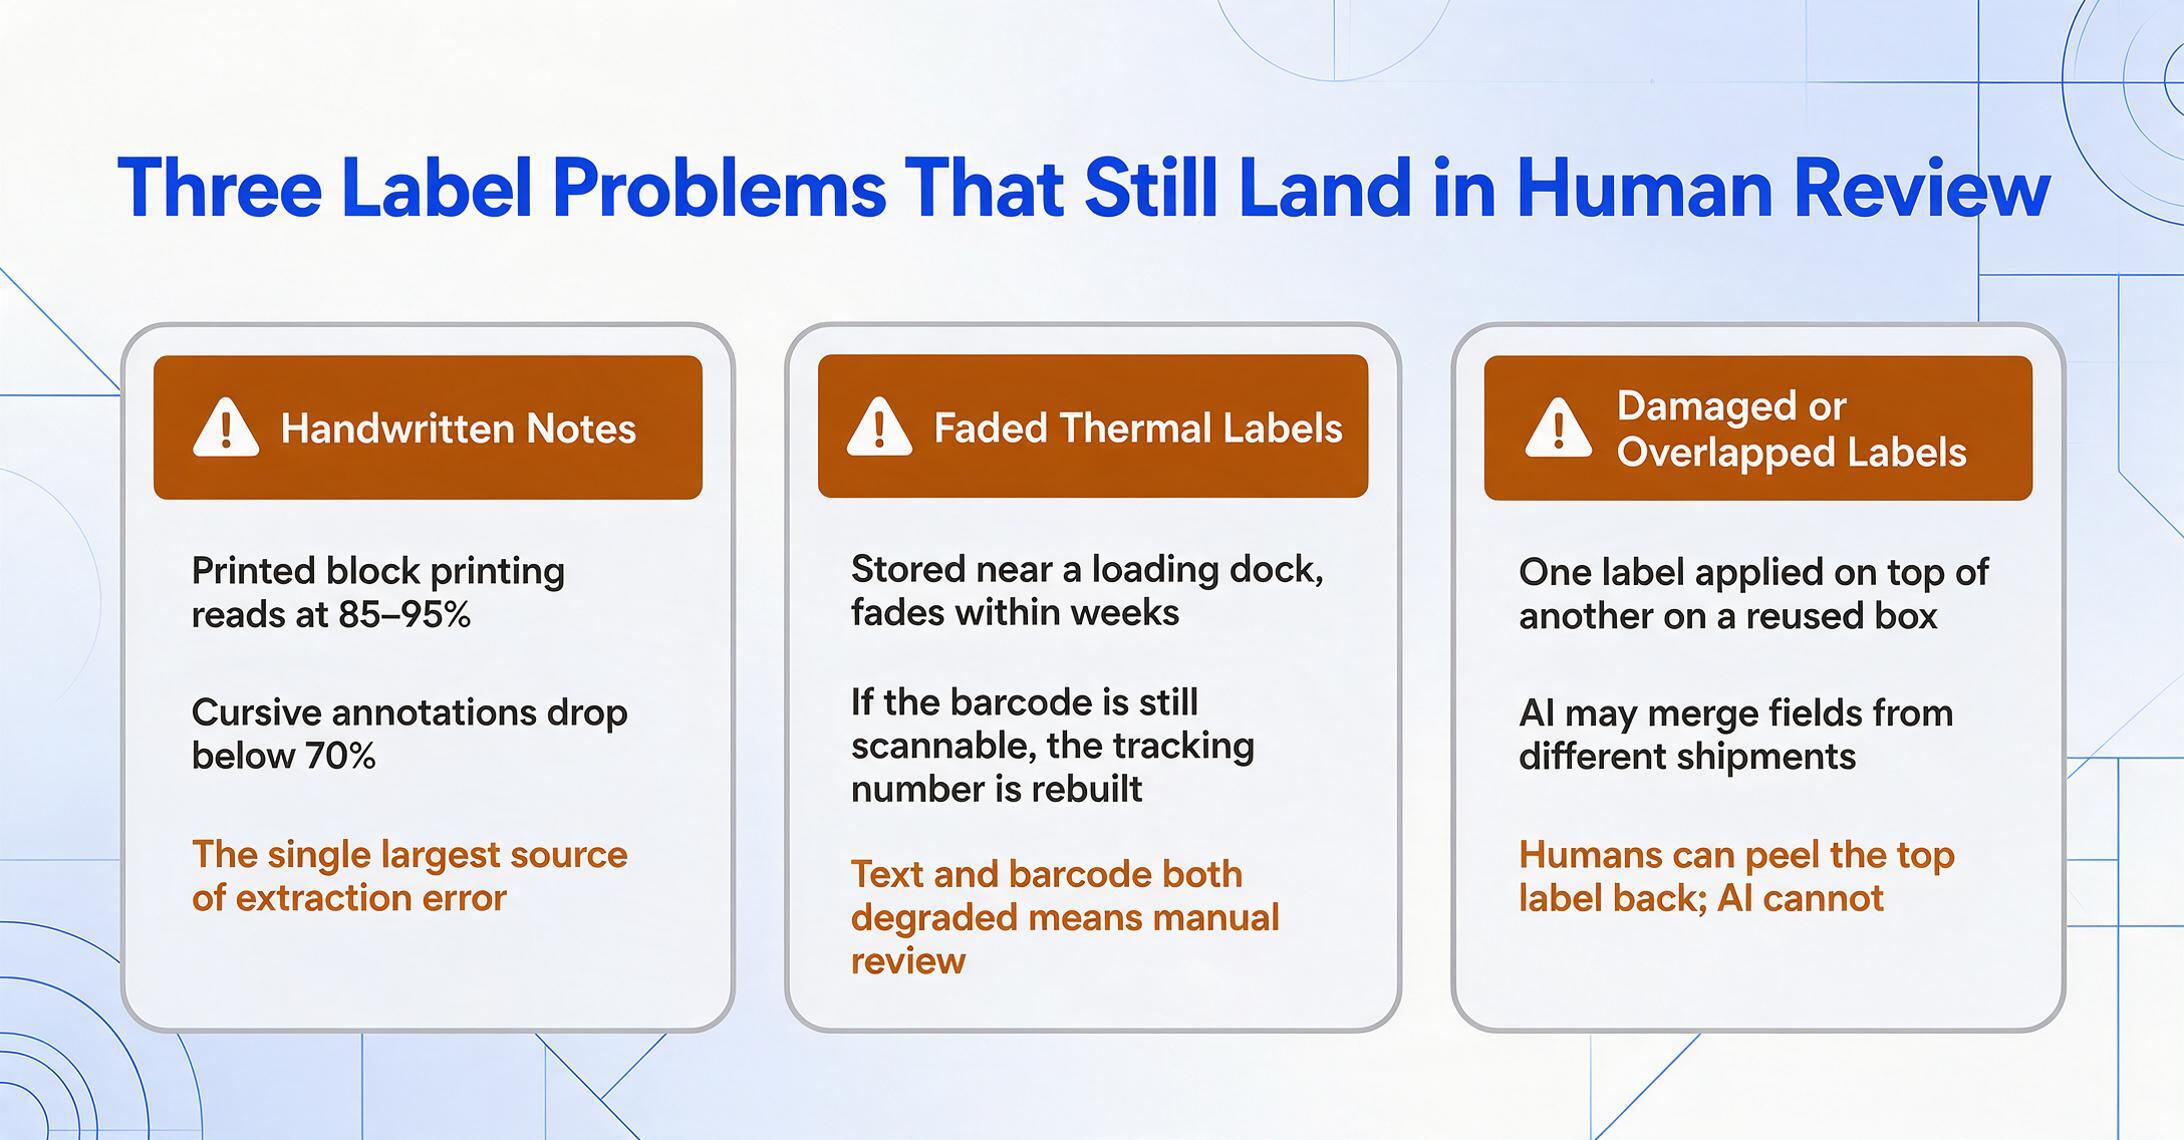
Annotations manuscrites. Un répartiteur griffonne « URGENT » sur une ligne de manifeste. Un employé d'entrepôt corrige un poids à la main sur une étiquette thermique. Un chauffeur écrit « REFUSÉ » à côté d'une adresse de livraison. Le texte manuscrit superposé sur des documents imprimés est la plus grande source d'erreur d'extraction, quel que soit le modèle d'IA. Comme indiqué dans notre comparaison de précision entre l'IA et l'OCR traditionnel, la précision de l'écriture manuscrite sur une écriture en caractères d'imprimerie propres atteint 85–95 %, mais les annotations cursives griffonnées dans les marges ou sur du texte imprimé existant tombent sous 70 %.
Étiquettes à transfert thermique à faible contraste. Les étiquettes thermiques directes se délavent avec le temps, surtout dans les environnements d'entrepôt. Une étiquette sur une palette stockée près d'un quai de chargement en plein soleil peut devenir illisible en quelques semaines. Si le code-barres est encore scannable, l'IA peut reconstruire le numéro de suivi à partir de la valeur décodée — mais si le texte imprimé et le code-barres sont tous deux dégradés, l'étiquette entière devient un cas de revue manuelle.
Étiquettes endommagées ou superposées. Un carton d'expédition réutilisé avec deux étiquettes — une partiellement arrachée, une appliquée par-dessus — est le scénario le plus difficile pour tout outil d'extraction. L'IA peut tenter de lire le texte des deux étiquettes, fusionner des champs de différents envois, ou manquer l'étiquette valide entièrement. Les opérateurs humains gèrent mieux cela car ils peuvent physiquement décoller l'étiquette supérieure. L'IA n'a pas d'opération équivalente.
Dérive des en-têtes de colonnes du manifeste. Certains transporteurs génèrent des manifestes où l'en-tête de colonne apparaît en page 1 mais pas sur les pages suivantes. Une IA sémantique qui a appris les positions des colonnes à partir de la page 1 doit suivre les mêmes positions à travers la pagination. Si le rendu PDF déplace les positions des colonnes entre les pages (un problème connu avec certains logiciels d'impression de transporteurs), l'alignement de l'IA peut dériver d'un champ par page, en cascade sur tout le manifeste.
L'essentiel à retenir : Sur un lot type de 50 étiquettes d'expédition et 3 manifestes, attendez-vous à ce que 88 à 94 % des champs soient extraits correctement sans aucune intervention humaine. Les 6 à 12 % restants nécessitent entre 5 et 15 minutes de vérification et de correction — contre 60 à 120 minutes de saisie manuelle pour le même volume. Le gain de temps est réel, mais le seuil de confiance compte : pour les données de suivi et d'acheminement (précision de 95 à 99 %), l'automatisation peut fonctionner sans contrôle. Pour les données de facturation et de conformité (totaux des manifestes, codes SH, valeurs déclarées), une couche de vérification humaine reste la procédure sûre.
Obtenir les meilleurs résultats avec l'extraction d'étiquettes d'expédition et de manifestes
La précision de l'extraction sur les étiquettes d'expédition et les manifestes n'est pas une propriété fixe du modèle d'IA — elle est influencée par la qualité de l'image, la façon dont vous définissez vos colonnes et le fait de regrouper ou non les documents associés. Quelques ajustements pratiques font la différence entre « fonctionne la plupart du temps » et « suffisamment fiable pour être déployé ».
1. Capturez l'étiquette entière, pas un recadrage. Lorsque vous prenez des photos d'étiquettes d'expédition au quai de réception ou au comptoir d'expédition, incluez toute la zone de l'étiquette plus une petite marge. Une image recadrée qui coupe la zone de silence autour d'un code-barres peut empêcher le décodage du code-barres, et un coin manquant peut faire perdre l'adresse de l'expéditeur ou l'indicateur de service. L'IA peut gérer une certaine occlusion, mais la marge d'erreur est faible sur une étiquette de 4″ × 6″.
2. Nommez vos colonnes de manière sémantique. Lorsque vous utilisez l'Extraction de colonnes personnalisées — où vous saisissez les noms de champs souhaités et l'IA localise les données correspondantes par sens — les noms de colonnes qui correspondent à la façon dont les transporteurs libellent les champs donnent de meilleurs résultats. « Numéro de suivi » fonctionne sur toutes les étiquettes de transporteur car l'IA comprend le concept. « Nom de l'expéditeur » est plus fiable que « De » (qui pourrait correspondre au bloc d'adresse de l'expéditeur ou au champ « De » d'une déclaration en douane). « Niveau de service » couvre à la fois les libellés « Service : » et « Classe ». L'IA fait correspondre les noms de colonnes aux concepts du document de manière sémantique, et non par correspondance exacte de chaîne.
3. Regroupez les étiquettes et les manifestes séparément. Un lot de 30 étiquettes d'expédition produit une feuille de calcul propre avec une ligne par étiquette — chaque ligne contenant le numéro de suivi, le poids, l'adresse et le niveau de service pour cet envoi. Un lot de manifestes produit des lignes déjà structurées comme des données au niveau de l'envoi. Si vous mélangez les deux dans un même lot, l'IA traite chaque document indépendamment, mais les lignes de sortie auront des densités de champs différentes (les étiquettes ont moins de champs spécifiques aux manifestes comme les codes SH et les numéros de conteneur). Pour des résultats plus propres, exécutez les étiquettes et les manifestes comme des lots séparés. Traitement par lots en priorité — conçu pour traiter plusieurs documents en parallèle et les fusionner en un seul tableau — fonctionne mieux lorsque les documents d'un lot partagent la même structure.
4. Utilisez le code-barres comme signal de validation croisée. Le numéro de suivi imprimé sur l'étiquette doit correspondre à la valeur décodée du code-barres. Lorsque vous définissez les deux comme colonnes d'extraction, vous obtenez deux lectures indépendantes du même point de données. S'ils diffèrent, cette étiquette nécessite une vérification humaine — le colis a peut-être été réétiqueté, ou le code-barres peut appartenir à un autre envoi. Cette vérification croisée automatisée détecte les erreurs qui passeraient autrement inaperçues jusqu'à ce que le colis soit scanné au prochain hub.
5. Exécutez les manifestes avec une vérification au niveau des lignes. Pour les manifestes exportés depuis les systèmes des transporteurs (FedEx Ship Manager, UPS WorldShip ou DHL Express), le PDF est généralement généré par machine et hautement structuré — la précision d'extraction y est de 95 % ou plus. Pour les manifestes compilés manuellement, ou ceux provenant de transporteurs plus petits dont le format est incohérent, configurez un seuil de confiance : toute ligne où la confiance par champ de l'IA tombe sous 80 % doit être signalée pour vérification manuelle avant que les données n'entrent dans votre TMS ou votre feuille de calcul de rapprochement des frais de transport.
Questions fréquemment posées
L'IA peut-elle extraire des données d'étiquettes d'expédition imprimées thermiquement avec un texte taché ou décoloré ?
Partiellement. Si le texte imprimé reste lisible pour un humain, la plupart des modèles d'IA de vision peuvent le lire avec une précision de 80 à 90 %. Si l'étiquette thermique a décoloré au point que le texte est à peine visible, le code-barres — s'il est encore scannable — constitue la solution de repli la plus fiable. Si le texte et le code-barres sont tous deux dégradés, l'étiquette nécessite une saisie manuelle des données. Utilisez des rubans de transfert thermique de haute qualité et évitez une exposition prolongée à la lumière directe du soleil ou à des sources de chaleur pour maximiser la lisibilité des étiquettes.
L'extraction par IA fonctionne-t-elle sur les étiquettes d'expédition internationales avec des adresses d'expéditeur/destinataire non anglaises ?
Oui, bien que la précision varie selon l'écriture. Les adresses en écriture latine (anglais, français, allemand, espagnol) sont reconnues à 90–95 % sur les étiquettes imprimées. Les adresses en écriture asiatique (chinois, japonais, coréen) tombent à 80–88 % dans les mêmes conditions. L'IA extrait correctement les caractères mais peut avoir une confiance plus faible sur les limites de caractères pour les écritures CJK, car le modèle de segmentation visuelle a été principalement entraîné sur des jeux de données en caractères latins. Les étiquettes multi-écritures — où l'adresse de l'expéditeur est en anglais et celle du destinataire en japonais — sont traitées comme des régions visuelles distinctes, et non comme une détection de langue conflictuelle, de sorte qu'un côté n'interfère pas avec l'autre.
L'IA peut-elle traiter des manifestes multipages où le tableau se poursuit sur plusieurs pages ?
Oui — l'extraction sémantique par IA lit chaque page indépendamment, puis fusionne les résultats selon la structure des colonnes. La condition clé est que les en-têtes de colonnes soient cohérents d'une page à l'autre. Si les en-têtes apparaissent en page 1 mais pas sur les pages suivantes, l'IA déduit les positions des colonnes à partir de la mise en page de la page 1. Si le logiciel du transporteur déplace les positions des colonnes entre les pages (un problème connu avec certains systèmes d'impression logistiques), un désalignement au niveau des lignes peut survenir. Pour les manifestes critiques, vérifiez la dernière ligne de chaque page par rapport à la première ligne de la page suivante afin de détecter toute dérive d'alignement.
En quoi l'extraction de manifestes diffère-t-elle de l'extraction d'étiquettes d'expédition ?
Fondamentalement différente. Une étiquette d'expédition est un document à envoi unique où le défi réside dans la densité — extraire le texte d'un espace restreint et encombré sans interférence entre les champs. Un manifeste est un document à envois multiples où le défi réside dans la structure — identifier correctement les limites du tableau, la délimitation des lignes et l'alignement des colonnes sur plusieurs pages. Le même modèle d'IA gère les deux, mais la stratégie d'extraction diffère : les étiquettes privilégient la précision au niveau des champs, tandis que les manifestes privilégient l'intégrité au niveau des lignes.
L'IA extrait-elle les données des code-barres des étiquettes d'expédition, ou dois-je utiliser un lecteur de code-barres séparé ?
L'IA visuelle peut décoder les code-barres à partir des images d'étiquettes, notamment Code 128, Code 39, EAN-13, UPC-A, PDF417 et les codes QR. La valeur décodée est renvoyée comme un champ texte standard dans le résultat d'extraction. Cela signifie que vous n'avez pas besoin d'un lecteur de code-barres séparé si votre flux de travail peut traiter les images. Cependant, un lecteur de code-barres dédié sur le quai de réception reste plus rapide et plus fiable que de photographier chaque étiquette — l'extraction de code-barres par IA est idéale lorsque vous capturez déjà l'image de l'étiquette à d'autres fins (comme l'extraction d'adresse ou de poids) et souhaitez obtenir la valeur du code-barres comme sous-produit gratuit.
Quelle est la qualité d'image minimale requise pour une extraction fiable ?
Pour les étiquettes d'expédition imprimées : au moins 150 DPI équivalents sur la zone de l'étiquette, avec un éclairage uniforme et un minimum d'ombres. Pour les manifestes : 200 DPI minimum sur la zone tabulaire, avec la page à plat et non incurvée au niveau de la reliure. La plupart des smartphones en mode photo standard répondent automatiquement à ces exigences. L'échec de qualité le plus courant n'est pas la résolution — c'est le flou de mouvement d'une photo prise à main levée dans une lumière faible. Une photo bien éclairée et stable prise à bout de bras produit de meilleurs résultats d'extraction qu'un scan haute résolution avec un éclairage incohérent.
Les étiquettes d'expédition et les manifestes sont deux des documents les plus courants — et les plus variables en termes de format — dans les opérations logistiques. L'IA gère les deux, mais savoir où elle fonctionne de manière fiable et où elle a encore besoin d'un soutien est la différence entre un flux de travail déployé et une preuve de concept qui ne quitte jamais la phase de démonstration.
Essayez avec vos propres documents