A IA Consegue Extrair Dados de Etiquetas de Remessa
& Manifestos? O Que Funciona, O Que Não Funciona
Sim — a IA de visão moderna extrai dados de etiquetas de remessa com alta precisão em campos impressos e lida com tabelas de manifestos de várias linhas sem configuração de modelo por transportadora. Mas a faixa de confiança é ampla: números de rastreamento e strings decodificadas por código de barras passam de 97%, enquanto anotações de peso manuscritas, abreviações de nível de serviço e células de manifesto fragmentadas caem para 70–85%. A questão real não é "a IA consegue fazer", mas "em quais campos você pode confiar sem verificação manual".
Principais Conclusões
- Números de rastreamento em etiquetas impressas atingem 97-99% de precisão de extração — maior do que um humano cansado na sexta hora de digitação manual.
- Em um lote de 50 etiquetas e 3 manifestos, 88-94% dos campos são extraídos corretamente com zero intervenção humana. Corrigir os 6-12% restantes leva de 5 a 15 minutos em vez de 60 a 120.
- O verdadeiro desafio com manifestos não é ler o texto, mas manter o alinhamento das colunas — 200 linhas em 12 páginas onde um único deslocamento de campo se propaga por todo o documento.
Antes de dividirmos a resposta entre etiquetas e manifestos, uma distinção importa: o OCR tradicional e a extração semântica por IA lidam com esses documentos de formas muito diferentes. Uma ferramenta de OCR baseada em modelo que funciona em etiquetas FedEx Ground falhará em uma etiqueta UPS Air ou em uma etiqueta DHL eCommerce, porque cada transportadora posiciona os campos em quadrantes diferentes. A extração semântica — a abordagem em que a IA lê um campo pelo que ele significa, não por onde está — lida com múltiplos formatos de transportadora sem configuração por fornecedor. Essa diferença é a base para tudo abaixo, e é abordada em profundidade no nosso guia abrangente de OCR para logística.
Etiquetas de Remessa: Análise de Precisão Campo a Campo
Uma etiqueta de remessa padrão — seja da UPS, FedEx, USPS ou DHL — carrega de 8 a 12 pontos de dados extraíveis comprimidos em um espaço menor que uma página A5. A densidade é o desafio: uma etiqueta térmica de 4″ × 6″ pode conter um número de rastreamento, um código de barras, dois blocos de endereço, um indicador de nível de serviço, peso do pacote, data de envio e campos de referência, todos separados por guias visuais em vez de caixas rotuladas.
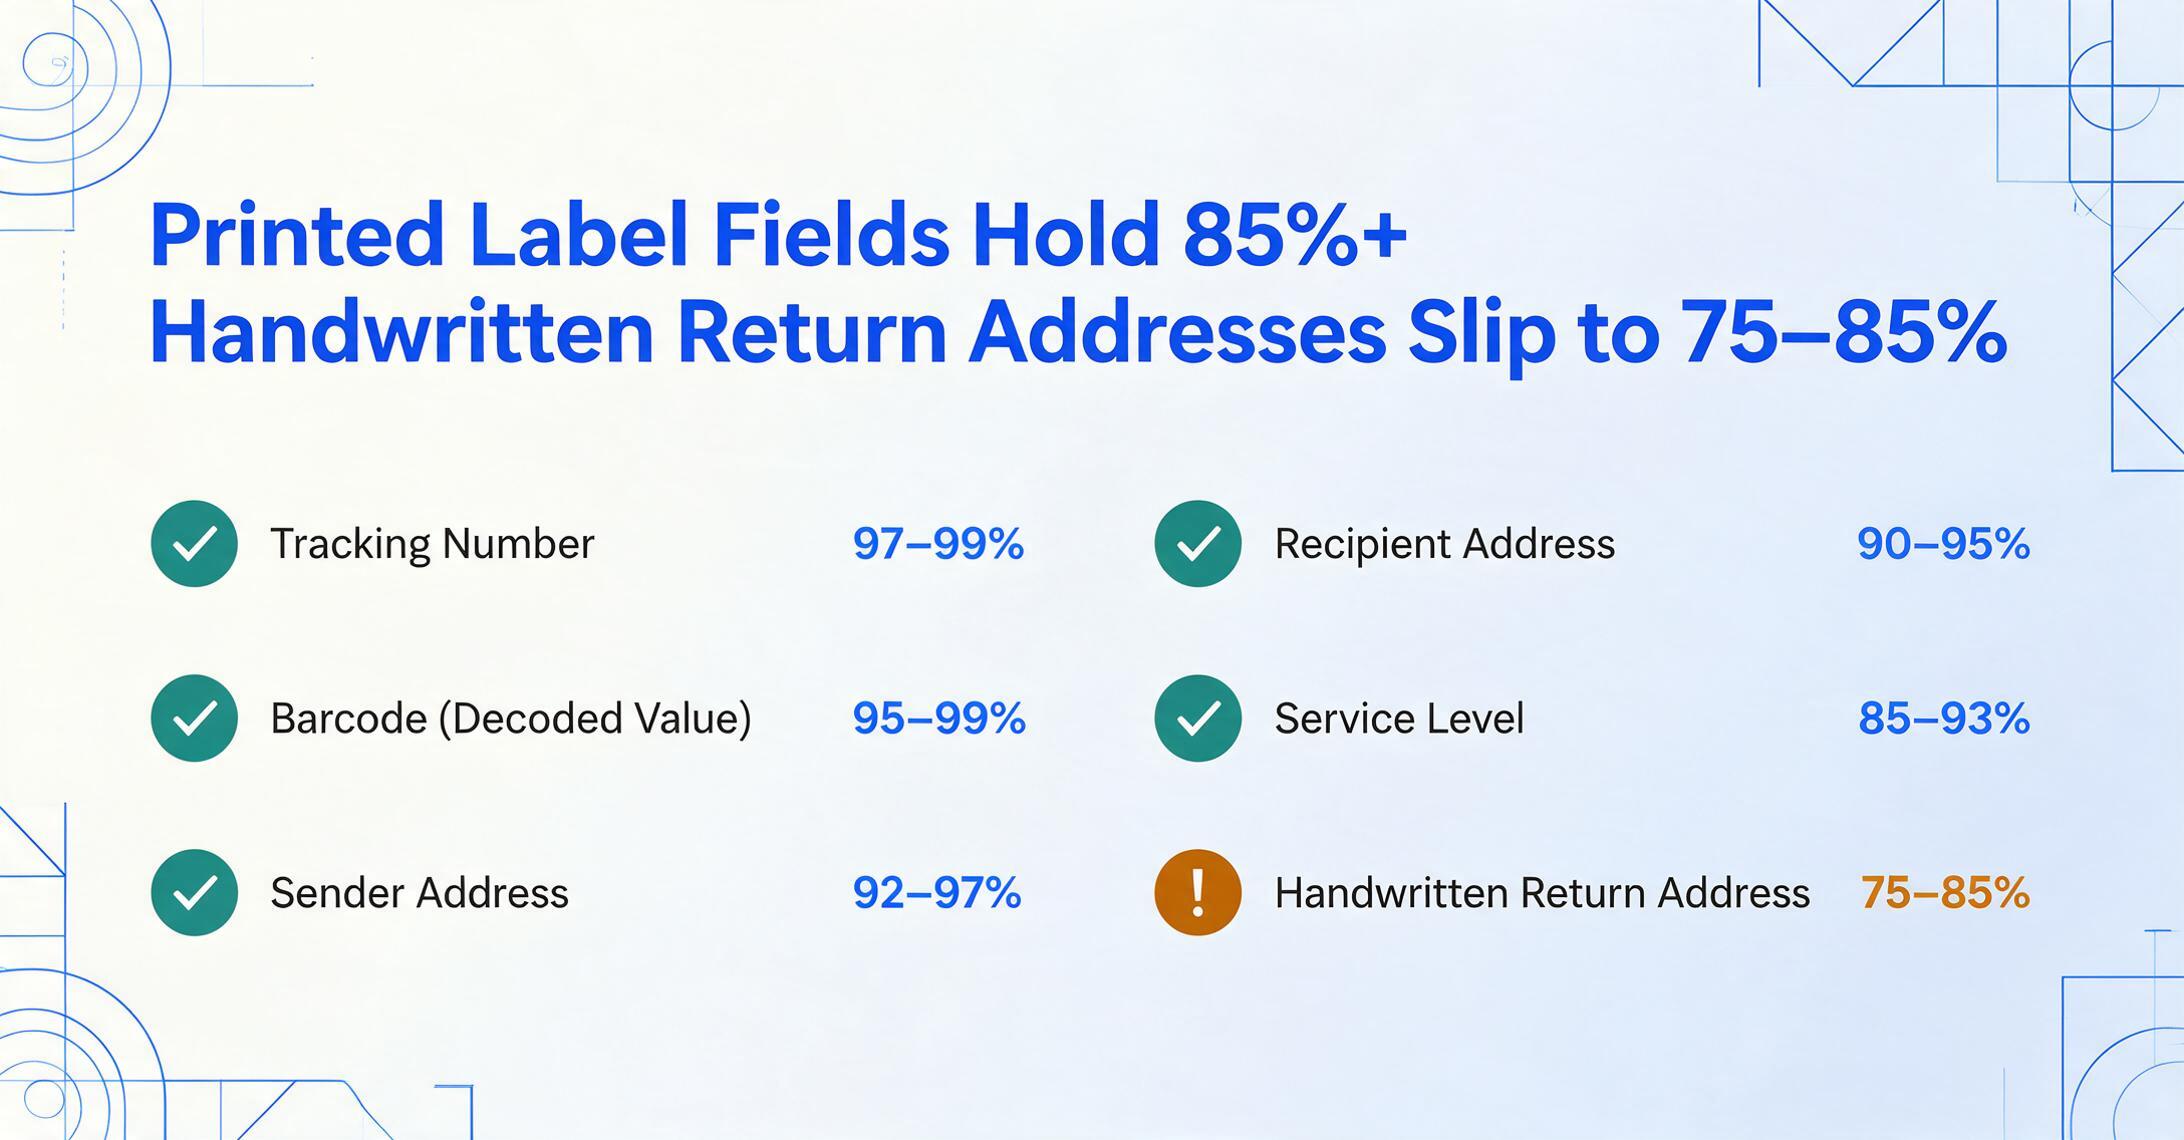
Aqui está o perfil de precisão em nível de campo para extração semântica por IA em etiquetas de remessa típicas impressas pela transportadora (texto impresso, boa qualidade de imagem):
| Campo | Faixa de Precisão da IA | Por que essa faixa |
|---|---|---|
| Número de rastreio | 97–99% | Alfanumérico com dígitos verificadores; prefixos das transportadoras (1Z, 9361, GM) são padrões previsíveis. Modelos de IA reconhecem estes como códigos estruturados, não texto livre. |
| Código de barras (valor decodificado) | 95–99% | Modelos de visão detectam regiões de código de barras e as enviam para decodificação. O valor do texto dentro do código de barras geralmente corresponde ao número de rastreio impresso — um sinal útil de validação cruzada. |
| Endereço do remetente | 92–97% | Geralmente impresso em fonte consistente. Endereços de devolução impressos em etiquetas térmicas estão entre os campos mais confiáveis. Endereços de devolução escritos à mão caem para 75–85%. |
| Endereço do destinatário | 90–95% | Mesmo que o remetente para texto impresso, mas às vezes a etiqueta de destino é aplicada sobre uma etiqueta anterior, criando uma sombra ou oclusão parcial que degrada a precisão. |
| Nível de serviço (Ground, 2-Day, Express, etc.) | 85–93% | Indicadores de serviço variam muito — a UPS usa uma grade de caixas de seleção, a FedEx usa uma barra colorida com texto, os USPS usam uma descrição de classe. A IA deve interpretar tanto a etiqueta quanto seu contexto visual. Abreviações das transportadoras ("PRI" vs "Priority") adicionam ambiguidade. |
| Peso da encomenda | 85–95% | Campos de peso impressos são confiáveis. Correções de peso manuscritas (comuns em balcões de despacho) são o principal ponto de falha — um "2,5" rabiscado sobre um "2,0" é difícil para qualquer IA interpretar com confiança. |
| Data de postagem | 90–96% | Datas aparecem em múltiplos formatos (30/06/2026, 30-JUN-2026, 2026-06-30). A IA semântica normaliza bem estes, mas algumas transportadoras imprimem a data de postagem no mesmo formato do número de rastreio, em proximidade — a IA deve distingui-los pelo contexto da etiqueta, não pelo formato. |
| Campos de referência (Nº Pedido, Nº Depto, Ref. do Cliente) | 80–90% | Números de referência são específicos da transportadora e frequentemente mesclados em um campo genérico "Referência". Quando a etiqueta diz "Ref: 54829-12", a IA extrai a string corretamente, mas se essa string corresponde a um número de pedido, uma referência do cliente ou um número de fatura interna depende do contexto. |
O número principal — campos impressos com 90%+ — é consistente com os benchmarks gerais de precisão para IA de visão moderna vs. OCR tradicional. O insight chave para equipes de logística é que números de rastreio e endereços são problemas essencialmente resolvidos para etiquetas impressas, enquanto indicadores de nível de serviço e campos de referência ainda exigem verificação pontual.
A Questão do Código de Barras: A IA Fica Confusa?
Esta é a preocupação que os profissionais de logística mais levantam: uma etiqueta de remessa é um campo denso de elementos visuais mistos — texto, códigos de barras, códigos QR, caixas de seleção, logotipos de transportadoras — tudo compactado em um espaço pequeno. A IA não vai tentar "ler" o código de barras como texto e produzir uma saída sem sentido que polui o resto da extração?
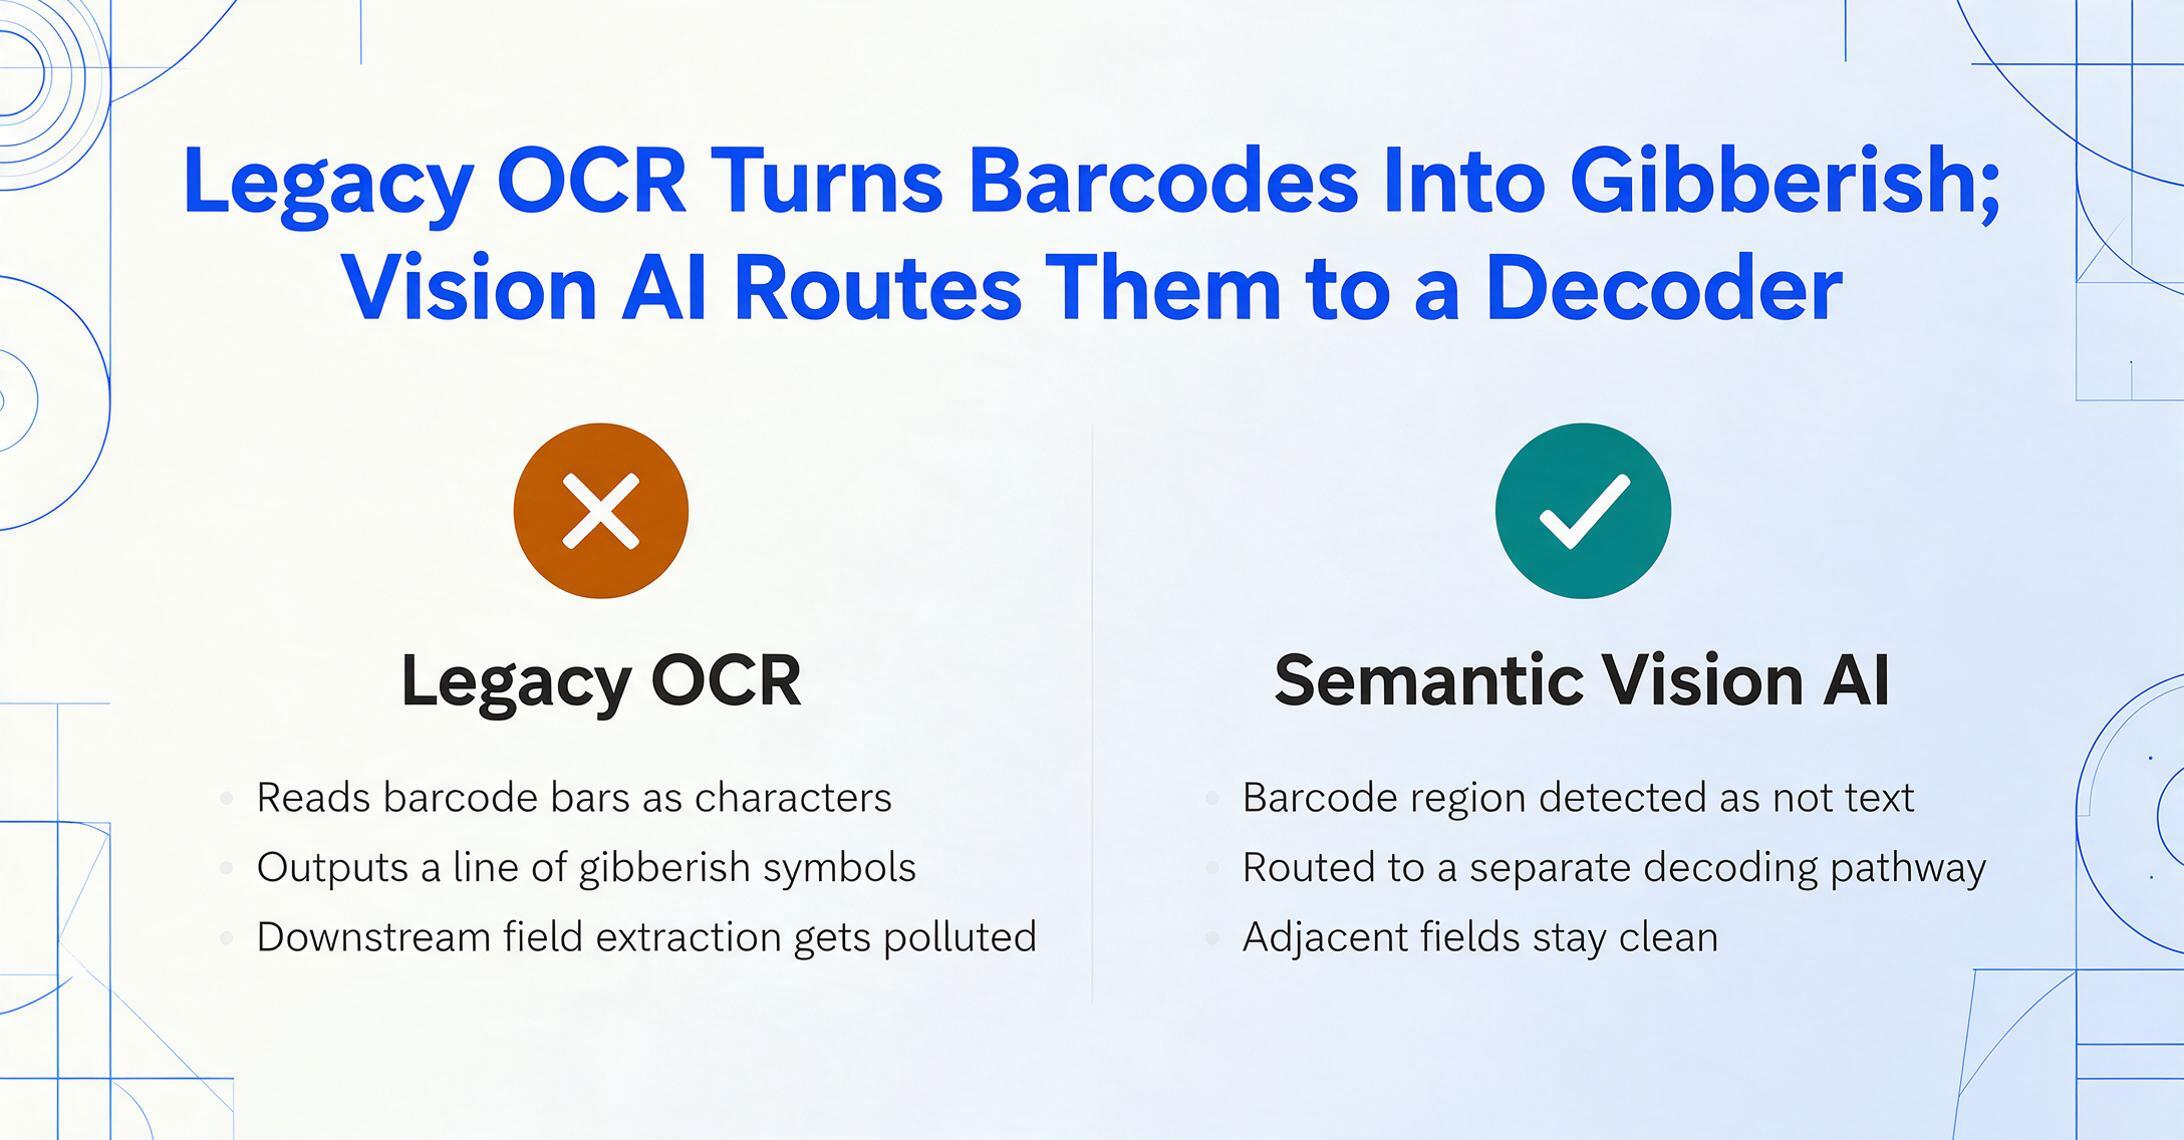
A resposta curta é que a IA de visão não confunde regiões de código de barras com regiões de texto — porque as características visuais de um código de barras (barras alternadas de largura variável com uma borda de zona de silêncio branca) são fundamentalmente diferentes das características visuais de caracteres de texto (traços, serifas, espaçamento entre letras). A espinha dorsal visual da IA distingue isso na camada de detecção de características, não na camada de pós-processamento. A área do código de barras é identificada como "não texto" e encaminhada para um caminho de decodificação separado, em vez de ser alimentada no mesmo pipeline de OCR.
Essa distinção é importante porque evita um problema clássico do OCR legado: quando um mecanismo de OCR tradicional encontra um código de barras Code 128 denso ou um código QR, ele frequentemente tenta ler as barras como caracteres — produzindo uma linha de símbolos sem sentido que então polui qualquer extração de campo subsequente. O operador então precisa editar o lixo para fora da saída. A IA de visão semântica evita isso completamente ao não encaminhar regiões de código de barras para o decodificador de texto em primeiro lugar.
O resultado prático é que você pode extrair dados de uma etiqueta sem se preocupar que o código de barras cause erros em cascata nos campos adjacentes. O desafio muda de "poluição por código de barras" para uma questão diferente: se a IA associa corretamente o valor do código de barras decodificado com o número de rastreamento impresso na mesma etiqueta. Na maioria dos casos, eles coincidem — o código de barras codifica o mesmo número de rastreamento impresso acima dele em texto legível por humanos. Quando não coincidem (uma etiqueta aplicada incorretamente ou uma reembalagem no armazém), a discrepância é por si só um sinal útil de que a revisão humana deve investigar.
Onde o Texto Adjacente ao Código de Barras Ainda Pode Enganar a IA
Embora as regiões dos códigos de barras sejam processadas corretamente, o texto impresso dentro ou imediatamente adjacente às áreas dos códigos pode causar confusão. Por exemplo, etiquetas dos Correios dos EUA (USPS) imprimem o número de rastreamento tanto em texto legível acima do código de barras quanto como o valor codificado no código. Algumas transportadoras imprimem um número de referência secundário diretamente abaixo do código de barras, em uma fonte menor que se estende até o que a IA percebe como a zona de silêncio do código. Nesses casos, a IA pode:
- Perder completamente o texto secundário por ter sido cortado da região de detecção de texto;
- Ou, se a distância entre o código de barras e o texto for grande o suficiente, identificá-lo corretamente, mas com menor confiança devido à proximidade de uma região não textual.
Esses casos extremos afetam cerca de 3–5% das etiquetas e são facilmente detectados em uma revisão humana. O ponto importante é que são dados perdidos, não dados errados — a IA extrai com precisão o que identifica e sinaliza regiões de baixa confiança para revisão.
Manifestos de Remessa: Dados Tabulares em Escala
Manifestos de remessa apresentam um desafio de extração fundamentalmente diferente das etiquetas. Um manifesto — seja de coleta no final do dia de uma transportadora, de carga marítima ou de desembaraço aduaneiro — é um documento com várias linhas listando cada remessa em um lote, geralmente abrangendo várias páginas. Enquanto uma etiqueta é densa, mas pequena, um manifesto é estruturado, mas grande: de 20 a 200 linhas de dados de remessa, cada uma contendo alguns ou todos os mesmos campos que aparecem em etiquetas individuais.
O conjunto de campos para uma linha de manifesto normalmente inclui: número de rastreamento ou número PRO, número do conhecimento de embarque (BOL), nome do remetente, nome do destinatário, quantidade de pacotes, peso, classe de serviço, descrição da mercadoria e, frequentemente, código HS e valor declarado. Manifestos de carga de importação regidos pelo 19 CFR § 4.7a também exigem códigos SCAC, números de contêiner, identificações de lacres e porto de embarque — os mesmos elementos de dados que as equipes de desembaraço aduaneiro e contas a pagar (AP) precisam para a conciliação de faturas de frete.
O desafio de extração para manifestos é a delimitação de linhas tabulares:
- Tabelas com bordas vs. sem bordas. Manifestos de coleta diária da FedEx usam linhas de grade explícitas. Manifestos de exportação da DHL frequentemente omitem bordas completamente, confiando no alinhamento vertical por espaços em branco. Manifestos SCAN dos Correios dos EUA (USPS) usam colunas de largura fixa com abreviações de cabeçalho. A IA deve reconhecer a estrutura da tabela em cada formato antes de poder extrair linhas individuais.
- Continuação em várias páginas. Uma única execução de manifesto pode abranger de 8 a 12 páginas. A IA deve identificar quais linhas pertencem a qual remessa entre as quebras de página e se os cabeçalhos das colunas se repetem em cada página (geralmente sim, mas nem sempre na mesma posição vertical).
- Linhas de agregação. Manifestos frequentemente incluem linhas de subtotal ("Total da Página: 15 pacotes, 28,5 lbs"), linhas de total geral no final e campos de uso exclusivo da transportadora. A IA deve distinguir linhas de dados de linhas de metadados — uma etapa de classificação que o OCR de modelo lida com regras fixas e que a IA semântica lida lendo o rótulo da linha.
- Densidade de dados mista. Algumas linhas de manifesto carregam 5 campos, outras carregam 15. A IA vê as células preenchidas de cada linha de forma independente — uma linha com uma quantidade de pacotes, mas sem descrição da mercadoria, deve resultar em uma célula nula, não em um erro de deslocamento de coluna que empurra os campos subsequentes para a coluna errada.
Em manifestos bem estruturados, com linhas de grade explícitas, a extração semântica por IA atinge 90–95% de precisão no nível de linha — ou seja, 9 a 9,5 de cada 10 linhas são totalmente extraídas com campos corretamente alinhados. Em manifestos sem bordas ou mal estruturados, a precisão no nível de linha cai para 75–85%, sendo o desalinhamento de colunas o modo de falha mais comum. Para o fluxo de trabalho prático que transforma uma semana de etiquetas e um manifesto de várias páginas em uma planilha de rastreamento, consulte nosso guia sobre extração de dados de etiquetas de remessa e manifestos para o Excel.
Onde a IA Ainda Precisa de Revisão Humana
Como era de se esperar, os pontos de falha se concentram nos mesmos cenários que atrapalham operadores humanos de entrada de dados — apenas com margens de erro diferentes.
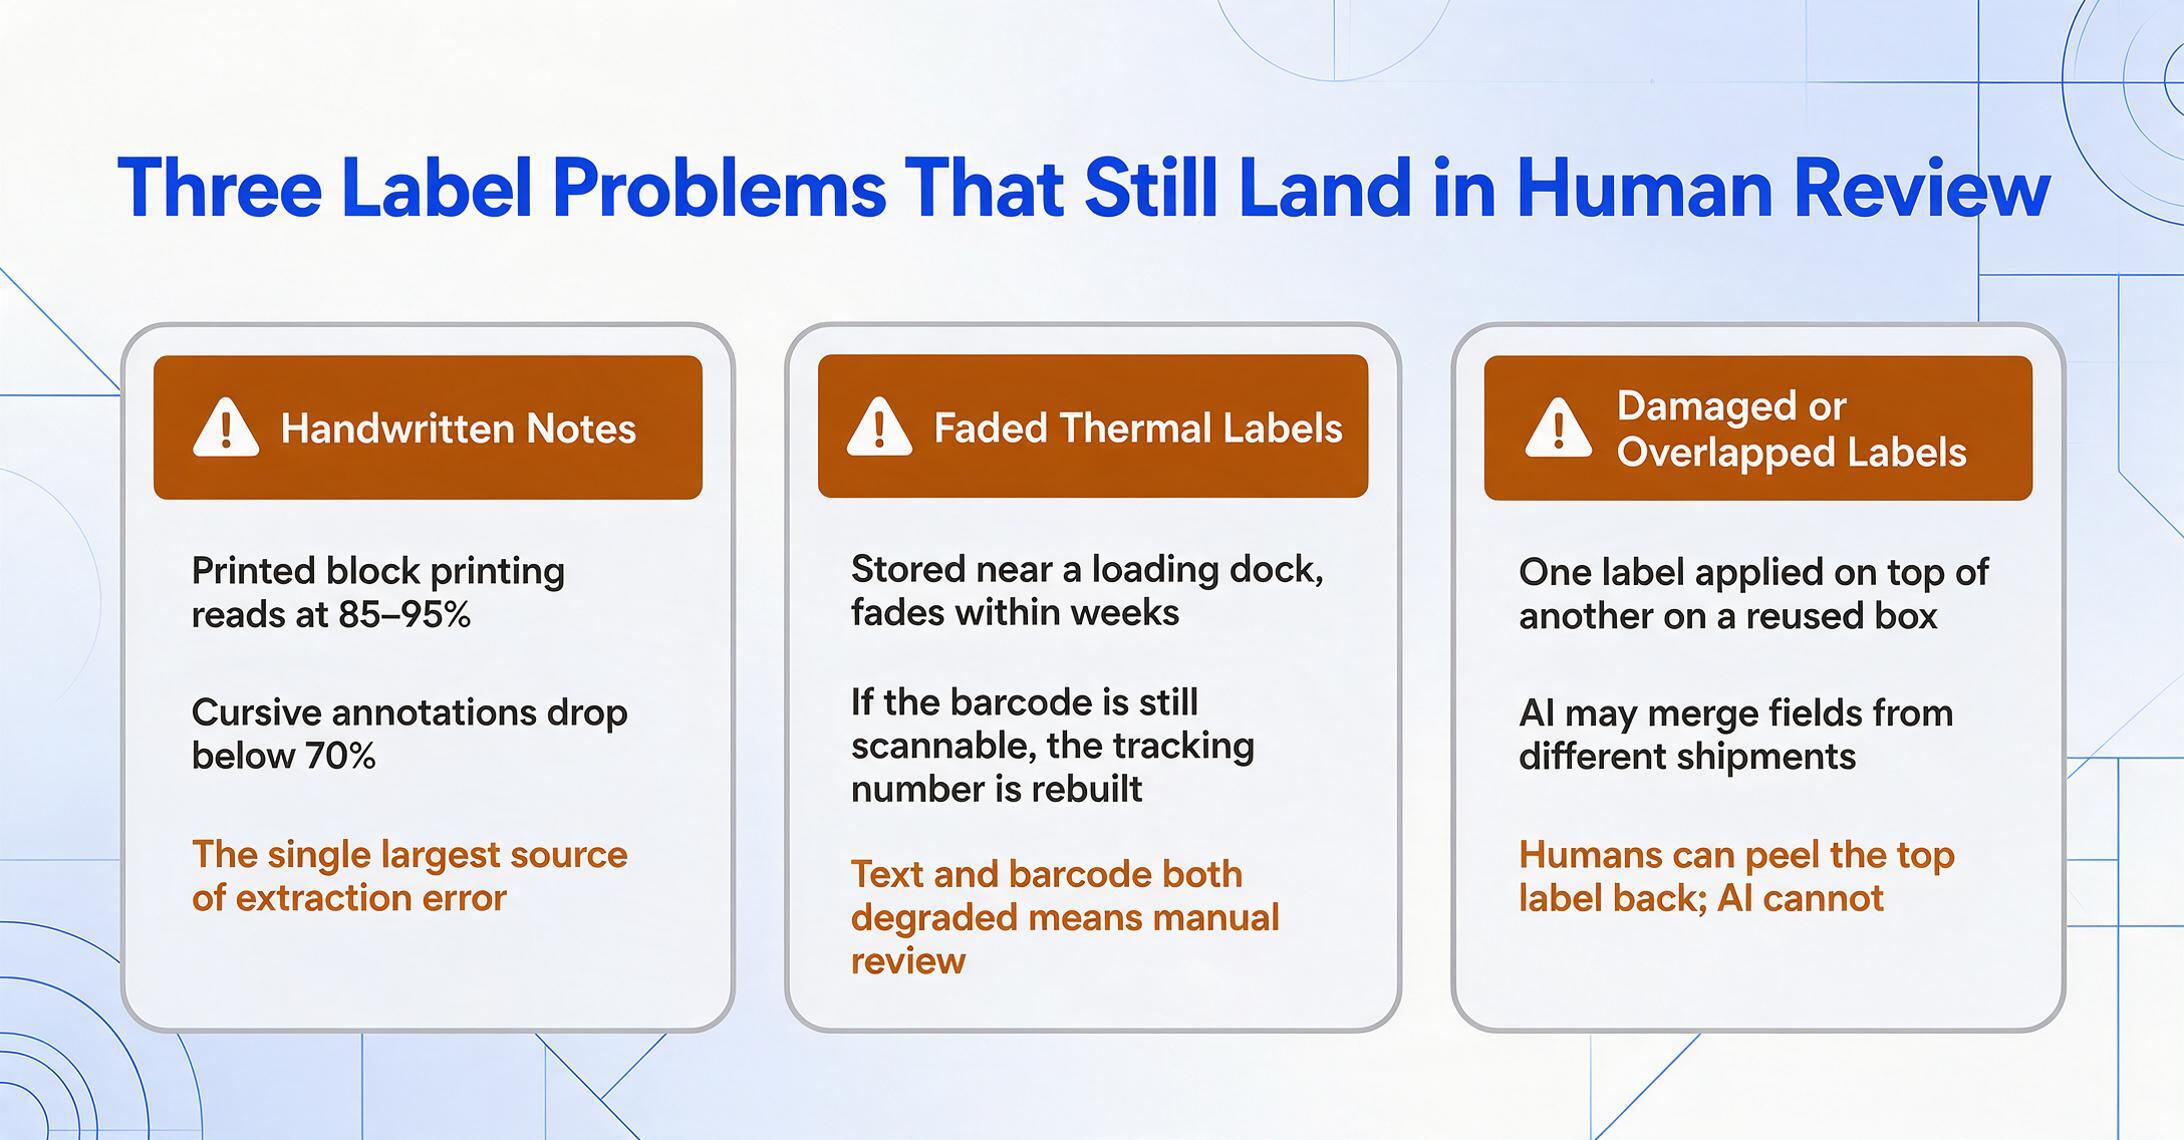
Anotações manuscritas. Um despachante rabisca "RUSH" em uma linha do manifesto. Um funcionário do armazém corrige um valor de peso à mão em uma etiqueta térmica. Um motorista escreve "REFUSED" ao lado de um endereço de entrega. Texto manuscrito sobreposto a documentos impressos é a maior fonte de erro de extração, independentemente do modelo de IA. Conforme abordado em nossa comparação de precisão entre IA e OCR tradicional, a precisão de manuscritos em letra de forma limpa chega a 85–95%, mas anotações cursivas rabiscadas nas margens ou sobre texto impresso caem abaixo de 70%.
Etiquetas de transferência térmica com baixo contraste. Etiquetas térmicas diretas desbotam com o tempo, especialmente em ambientes de armazém. Uma etiqueta em um palete armazenado perto de uma doca de carga sob luz solar direta pode se tornar ilegível em semanas. Se o código de barras ainda for escaneável, a IA pode reconstruir o número de rastreamento a partir do valor decodificado — mas se tanto o texto impresso quanto o código de barras estiverem degradados, a etiqueta inteira se torna um caso de revisão manual.
Etiquetas danificadas ou sobrepostas. Uma caixa de remessa reutilizada com duas etiquetas — uma parcialmente rasgada, outra aplicada por cima — é o cenário mais difícil para qualquer ferramenta de extração. A IA pode tentar ler texto das duas etiquetas, mesclar campos de diferentes remessas ou perder a etiqueta válida por completo. Operadores humanos lidam melhor com isso porque podem fisicamente remover a etiqueta de cima. A IA não tem operação equivalente.
Desvio no cabeçalho de colunas do manifesto. Algumas transportadoras geram manifestos em que o cabeçalho das colunas aparece na página 1, mas não nas páginas seguintes. Uma IA semântica que aprendeu as posições das colunas na página 1 deve acompanhar as mesmas posições ao longo da paginação. Se a renderização do PDF deslocar as posições das colunas entre páginas (um problema conhecido em alguns softwares de impressão de transportadoras), o alinhamento da IA pode desviar um campo por página, em cascata por todo o manifesto.
A conclusão prática: Em um lote típico de 50 etiquetas de remessa e 3 manifestos, espere que 88–94% dos campos sejam extraídos corretamente sem intervenção humana. Os 6–12% restantes exigem entre 5 e 15 minutos de revisão e correção — em comparação com 60–120 minutos de entrada manual de dados para o mesmo volume. A economia de tempo é real, mas o limite de confiança importa: para dados de rastreamento e roteamento (95–99% de precisão), a automação pode operar sem supervisão. Para dados de faturamento e conformidade (totais de manifesto, códigos SH, valores declarados), uma camada de revisão humana ainda é o procedimento operacional seguro.
Obtendo os Melhores Resultados na Extração de Etiquetas de Remessa e Manifestos
A precisão da extração em etiquetas de remessa e manifestos não é uma propriedade fixa do modelo de IA — ela é influenciada pela qualidade da imagem, pela forma como você define suas colunas e se você agrupa documentos relacionados em lote. Alguns ajustes práticos fazem a diferença entre "funciona na maioria das vezes" e "confiável o suficiente para implantar".
1. Capture a etiqueta inteira, não um recorte. Ao tirar fotos de etiquetas de remessa no cais de recebimento ou no balcão de expedição, inclua toda a área da etiqueta mais uma pequena margem. Uma imagem recortada que corta a zona de silêncio ao redor de um código de barras pode impedir a decodificação do código, e um canto ausente pode perder o endereço do remetente ou o indicador de serviço. A IA pode lidar com alguma oclusão, mas a margem de erro é pequena em uma etiqueta de 4″ × 6″.
2. Nomeie suas colunas semanticamente. Ao usar Extração de Colunas Personalizadas — onde você digita os nomes dos campos desejados e a IA localiza dados correspondentes por significado — nomes de colunas que correspondem a como as transportadoras rotulam os campos produzem melhores resultados. "Número de Rastreamento" funciona em todas as etiquetas de transportadoras porque a IA entende o conceito. "Nome do Remetente" é mais confiável que "De" (que pode corresponder ao bloco de endereço do remetente ou ao campo "De" em uma declaração aduaneira). "Nível de Serviço" cobre tanto os rótulos "Serviço:" quanto "Classe". A IA mapeia nomes de colunas para conceitos de documentos semanticamente, não por correspondência exata de string.
3. Agrupe etiquetas e manifestos separadamente. Um lote de 30 etiquetas de remessa produz uma planilha limpa com uma linha por etiqueta — cada linha contendo o número de rastreamento, peso, endereço e nível de serviço para aquela remessa. Um lote de manifestos produz linhas que já estão estruturadas como dados em nível de remessa. Se você misturar os dois em um único lote, a IA processa cada documento independentemente, mas as linhas de saída terão densidades de campo diferentes (etiquetas têm menos campos específicos de manifesto, como códigos SH e números de contêiner). Para resultados mais limpos, execute etiquetas e manifestos como lotes separados. Processamento Prioritário em Lote — projetado para lidar com múltiplos documentos em paralelo e mesclá-los em uma única tabela — funciona melhor quando os documentos em um lote compartilham a mesma estrutura.
4. Use o código de barras como um sinal de validação cruzada. O número de rastreamento impresso na etiqueta deve corresponder ao valor decodificado do código de barras. Quando você define ambos como colunas de extração, obtém duas leituras independentes do mesmo ponto de dados. Se eles diferirem, essa etiqueta precisa de revisão humana — o pacote pode ter sido reetiquetado, ou o código de barras pode pertencer a uma remessa diferente. Essa verificação cruzada automatizada captura erros que, de outra forma, passariam despercebidos até o pacote ser escaneado no próximo hub.
5. Execute manifestos com revisão em nível de linha. Para manifestos exportados de sistemas de transportadoras (FedEx Ship Manager, UPS WorldShip ou DHL Express), o PDF geralmente é gerado por máquina e altamente estruturado — a precisão da extração nesses casos é de 95%+. Para manifestos compilados manualmente, ou manifestos de transportadoras menores onde a formatação é inconsistente, configure um limite de confiança: qualquer linha em que a confiança por campo da IA fique abaixo de 80% deve ser sinalizada para verificação manual antes que os dados entrem no seu TMS ou na planilha de conciliação de frete.
Perguntas Frequentes
A IA consegue extrair dados de etiquetas de remessa impressas termicamente com texto borrado ou desbotado?
Parcialmente. Se o texto impresso ainda estiver legível para um humano, a maioria dos modelos de IA de visão consegue lê-lo com 80–90% de precisão. Se a etiqueta térmica desbotou a ponto de o texto estar quase invisível, o código de barras — se ainda puder ser escaneado — é o caminho de fallback mais confiável. Se tanto o texto quanto o código de barras estiverem degradados, a etiqueta exige entrada manual de dados. Use fitas de transferência térmica de alta qualidade e evite exposição prolongada à luz solar direta ou fontes de calor para maximizar a legibilidade da etiqueta.
A extração por IA funciona em etiquetas de remessa internacionais com endereços de remetente/destinatário em idiomas que não sejam inglês?
Sim, embora a precisão varie conforme o script. Endereços em alfabeto latino (inglês, francês, alemão, espanhol) são reconhecidos com 90–95% de precisão em etiquetas impressas. Endereços em alfabeto asiático (chinês, japonês, coreano) caem para 80–88% nas mesmas condições. A IA extrai os caracteres corretamente, mas pode ter menor confiança nos limites de caracteres para scripts CJK, porque o modelo de segmentação visual foi treinado predominantemente em conjuntos de dados de caracteres latinos. Etiquetas com múltiplos scripts — onde o endereço do remetente está em inglês e o do destinatário em japonês — são tratadas como regiões visuais separadas, não como detecção de idioma conflitante, então um lado não interfere no outro.
A IA consegue lidar com manifestos de várias páginas quando a tabela continua entre páginas?
Sim — a extração semântica por IA lê cada página de forma independente e depois combina os resultados com base na estrutura de colunas. O requisito principal é que os cabeçalhos de coluna sejam consistentes de página a página. Se os cabeçalhos aparecem na página 1, mas não nas páginas seguintes, a IA infere as posições das colunas a partir do layout da página 1. Se o software da transportadora desloca as posições das colunas entre páginas (um problema conhecido em alguns sistemas de impressão logística), pode ocorrer desalinhamento ao nível de linha. Para manifestos críticos, verifique a última linha de cada página contra a primeira linha da página seguinte para detectar desvios de alineamento.
Como a extração de manifestos difere da extração de etiquetas de remessa?
Fundamentalmente diferente. Uma etiqueta de remessa é um documento de envio único onde o desafio é a densidade — extraer texto de um espaço pequeno e lotado sem interferência entre campos. Um manifesto é um documento de múltiples envíos onde o desafio é a estrutura — identificar corretamente os limites da tabela, a delimitação de linhas e o alineamento de colunas em várias páginas. O mesmo modelo de IA lida com ambos, mas a estratégia de extração difere: as etiquetas priorizan a precisão ao nível de campo, enquanto os manifestos priorizan a integridad ao nível de linha.
A IA extrae dados de códigos de barras de etiquetas de remessa, ou preciso de um scanner de códigos de barras separado?
A IA de visão pode decodificar códigos de barras de imagens de etiquetas, incluindo Code 128, Code 39, EAN-13, UPC-A, PDF417 e QR. O valor decodificado é retornado como um campo de texto regular na saída da extração. Isso significa que você não precisa de um scanner de códigos de barras separado se seu fluxo de trabalho pode processar imagens. No entanto, um scanner de códigos de barras dedicado no dock de recepção ainda é mais rápido e confiable que fotografar cada etiqueta — a extração de códigos de barras por IA é melhor usada quando você já está capturando a imagem da etiqueta para outros propósitos (como extração de endereço ou peso) e deseja o valor do código de barras como subproducto gratuito.
Qual é a qualidade mínima de imagem necessária para uma extração confiable?
Para etiquetas de remessa impressas: pelo menos 150 DPI equivalentes na área da etiqueta, com iluminação uniforme e sombra mínima. Para manifestos: mínimo de 200 DPI na área tabular, com a página plana e não curvada na encuadernación. A maioria dos smartphones no modo de foto padrão cumpre esses requisitos automaticamente. A falha de qualidade mais comum não é a resolução — é o desfoque de movimento causado por uma foto tirada à mano em condições de pouca luz. Uma foto bem iluminada e estável tirada à distância do braço produz melhores resultados de extração que um escaneo de alta resolução com iluminação inconsistente.
Etiquetas de remessa e manifestos são dois dos documentos mais comuns — e com maior variação de formato — nas operações de logística. A IA lida com ambos, mas saber onde ela funciona de forma confiável e onde ainda precisa de suporte é a diferença entre um fluxo de trabalho implantado e uma prova de conceito que nunca sai da fase de demonstração.
Experimente com Seus Próprios Documentos