Kann KI Versandetiketten-
& Manifestdaten extrahieren? Was funktioniert, was nicht
Ja – moderne Vision-KI extrahiert Versandetikettendaten mit hoher Genauigkeit aus gedruckten Feldern und verarbeitet mehrzeilige Manifesttabellen ohne Vorlagenkonfiguration pro Transportunternehmen. Die Konfidenzspanne ist jedoch breit: Sendungsverfolgungsnummern und Barcode-dekodierte Zeichenfolgen liegen über 97 %, während handschriftliche Gewichtsangaben, Servicelevel-Abkürzungen und fragmentierte Manifestzellen auf 70–85 % fallen. Die eigentliche Frage ist nicht „Kann KI das?", sondern „Welchen Feldern können Sie ohne manuelle Prüfung vertrauen?"
Wichtigste Erkenntnisse
- Sendungsverfolgungsnummern auf gedruckten Etiketten erreichen eine Extraktionsgenauigkeit von 97–99 % – höher als ein müder Mensch in der sechsten Stunde manueller Eingabe.
- Bei einer Charge von 50 Etiketten und 3 Manifesten werden 88–94 % der Felder ohne menschliches Eingreifen korrekt extrahiert. Die Korrektur der restlichen 6–12 % dauert 5–15 Minuten statt 60–120.
- Die eigentliche Herausforderung bei Manifesten ist nicht das Lesen von Text, sondern die Aufrechterhaltung der Spaltenausrichtung – 200 Zeilen über 12 Seiten, bei denen eine einzelne Feldverschiebung das gesamte Dokument kaskadiert.
Bevor wir die Antwort in Etiketten versus Manifeste aufteilen, ist eine Unterscheidung wichtig: Herkömmliche OCR und semantische KI-Extraktion verarbeiten diese Dokumente sehr unterschiedlich. Ein vorlagenbasiertes OCR-Tool, das mit FedEx-Ground-Etiketten funktioniert, scheitert an einem UPS-Air-Etikett oder einem DHL-eCommerce-Etikett, weil jedes Transportunternehmen die Felder in anderen Quadranten positioniert. Semantische Extraktion – der Ansatz, bei dem die KI ein Feld danach liest, was es bedeutet, nicht wo es steht – verarbeitet mehrere Transportunternehmensformate ohne anbieterspezifische Konfiguration. Dieser Unterschied ist die Grundlage für alles Folgende und wird ausführlich in unserem umfassenden OCR-Leitfaden für Logistik behandelt.
Versandetiketten: Feldgenauigkeit im Detail
Ein Standard-Versandetikett – ob von UPS, FedEx, USPS oder DHL – enthält 8–12 extrahierbare Datenpunkte, komprimiert auf eine Fläche kleiner als eine A5-Seite. Die Dichte ist die Herausforderung: Ein 4″ × 6″-Thermoetikett kann eine Sendungsverfolgungsnummer, einen Barcode, zwei Adressblöcke, einen Servicelevel-Indikator, Paketgewicht, Versanddatum und Referenzfelder enthalten – alles getrennt durch visuelle Führungslinien statt beschrifteter Felder.
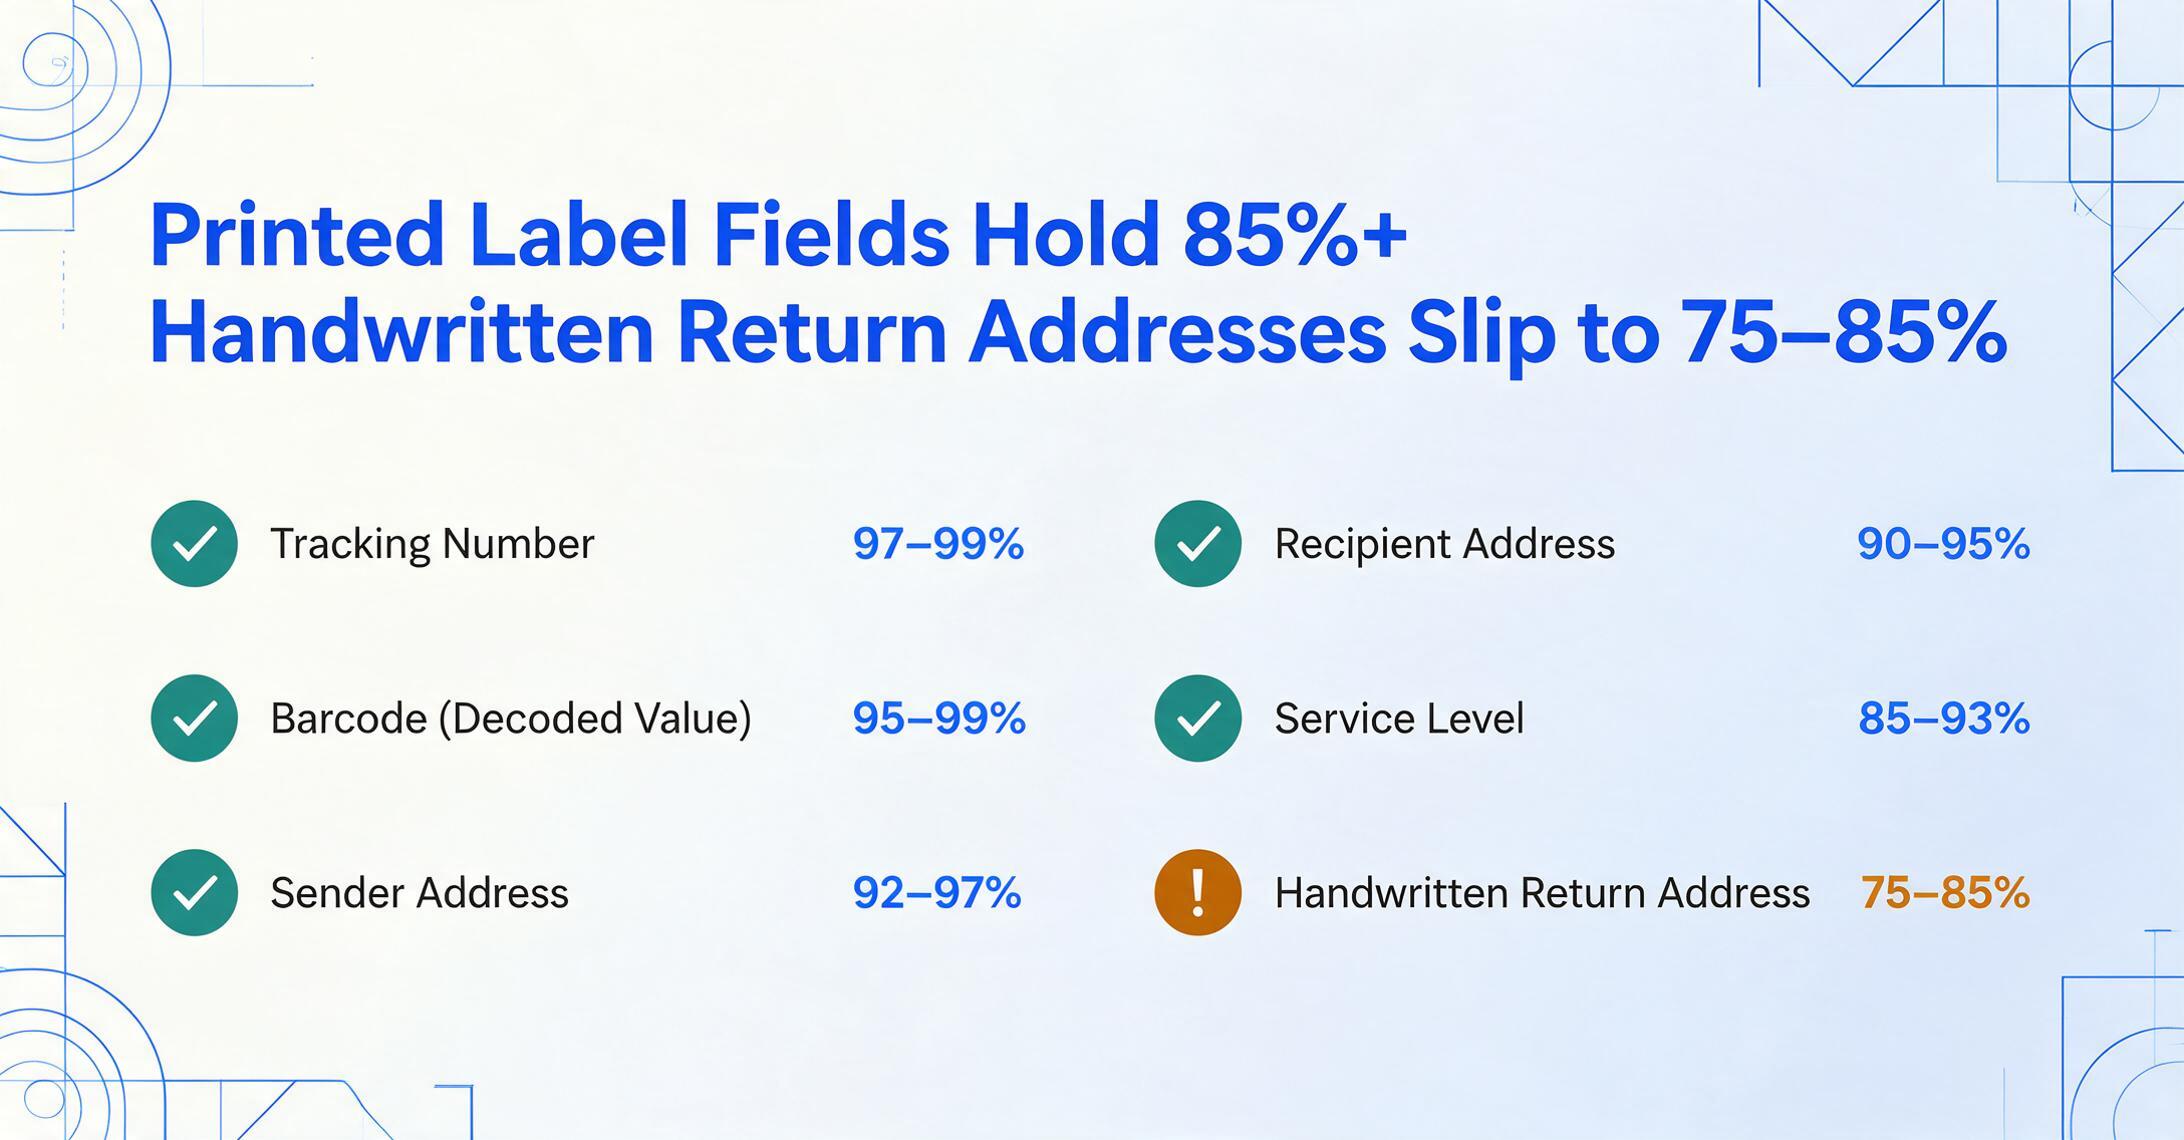
Hier ist das Feldgenauigkeitsprofil für semantische KI-Extraktion bei typischen, vom Transportunternehmen gedruckten Versandetiketten (gedruckter Text, gute Bildqualität):
| Feld | KI-Genauigkeitsspanne | Warum diese Spanne |
|---|---|---|
| Sendungsnummer | 97–99% | Alphanumerisch mit Prüfziffern; Carrier-Präfixe (1Z, 9361, GM) sind vorhersagbare Muster. KI-Modelle erkennen diese als strukturierte Codes, nicht als Freitext. |
| Barcode (decodierter Wert) | 95–99% | Bildmodelle erkennen Barcode-Bereiche und leiten sie zur Decodierung weiter. Der Textwert im Barcode stimmt oft mit der gedruckten Sendungsnummer überein – ein nützliches Kreuzvalidierungssignal. |
| Absenderadresse | 92–97% | Meist in einheitlicher Schriftart gedruckt. Gedruckte Rücksendeadressen auf Thermoetiketten gehören zu den zuverlässigsten Feldern. Handschriftliche Rücksendeadressen fallen auf 75–85%. |
| Empfängeradresse | 90–95% | Gleiches gilt wie für Absender bei gedrucktem Text, aber manchmal wird das Ziel-Etikett über ein vorheriges geklebt, was zu Schatten oder teilweiser Verdeckung führt und die Genauigkeit mindert. |
| Service-Level (Ground, 2-Day, Express usw.) | 85–93% | Service-Indikatoren variieren stark – UPS verwendet ein Kästchenraster, FedEx einen farbigen Balken mit Text, USPS eine Klassenbeschreibung. Die KI muss sowohl das Etikett als auch seinen visuellen Kontext interpretieren. Carrier-Abkürzungen („PRI“ vs. „Priority“) erhöhen die Mehrdeutigkeit. |
| Paketgewicht | 85–95% | Gedruckte Gewichtsfelder sind zuverlässig. Handschriftliche Gewichtskorrekturen (häufig an Abgabeschaltern) sind der Hauptfehlerpunkt – eine über ein „2,0“ gekritzelte „2,5“ ist für jede KI schwer sicher zu parsen. |
| Versanddatum | 90–96% | Daten erscheinen in mehreren Formaten (30.06.2026, 30-JUN-2026, 2026-06-30). Semantische KI normalisiert diese gut, aber manche Carrier drucken das Versanddatum im gleichen Format wie die Sendungsnummer und in unmittelbarer Nähe – die KI muss sie anhand des Etikettenkontexts unterscheiden, nicht des Formats. |
| Referenzfelder (Bestellnr., Abteilungsnr., Kundenreferenz) | 80–90% | Referenznummern sind carrierspezifisch und oft in einem generischen „Referenz“-Feld zusammengefasst. Wenn auf dem Etikett „Ref: 54829-12“ steht, extrahiert die KI die Zeichenfolge korrekt, aber ob diese Zeichenfolge einer Bestellnummer, einer Kundenreferenz oder einer internen Rechnungsnummer entspricht, hängt vom Kontext ab. |
Die Kernzahl – gedruckte Felder mit 90 %+ – deckt sich mit den allgemeinen Genauigkeitsbenchmarks moderner Bild-KI im Vergleich zu traditioneller OCR. Die wichtigste Erkenntnis für Logistikteams ist, dass Sendungsnummern und Adressen bei gedruckten Etiketten praktisch gelöste Probleme sind, während Service-Level-Indikatoren und Referenzfelder weiterhin stichprobenartige Prüfungen erfordern.
Die Barcode-Frage: Wird KI verwirrt?
Das ist die Sorge, die Logistikfachleute am häufigsten äußern: Ein Versandetikett ist ein dichtes Feld gemischter visueller Elemente – Text, Barcodes, QR-Codes, Kontrollkästchen, Transportunternehmen-Logos – alles auf engstem Raum. Wird die KI nicht versuchen, den Barcode als Text zu „lesen" und fehlerhafte Ausgaben zu erzeugen, die den Rest der Extraktion verunreinigen?
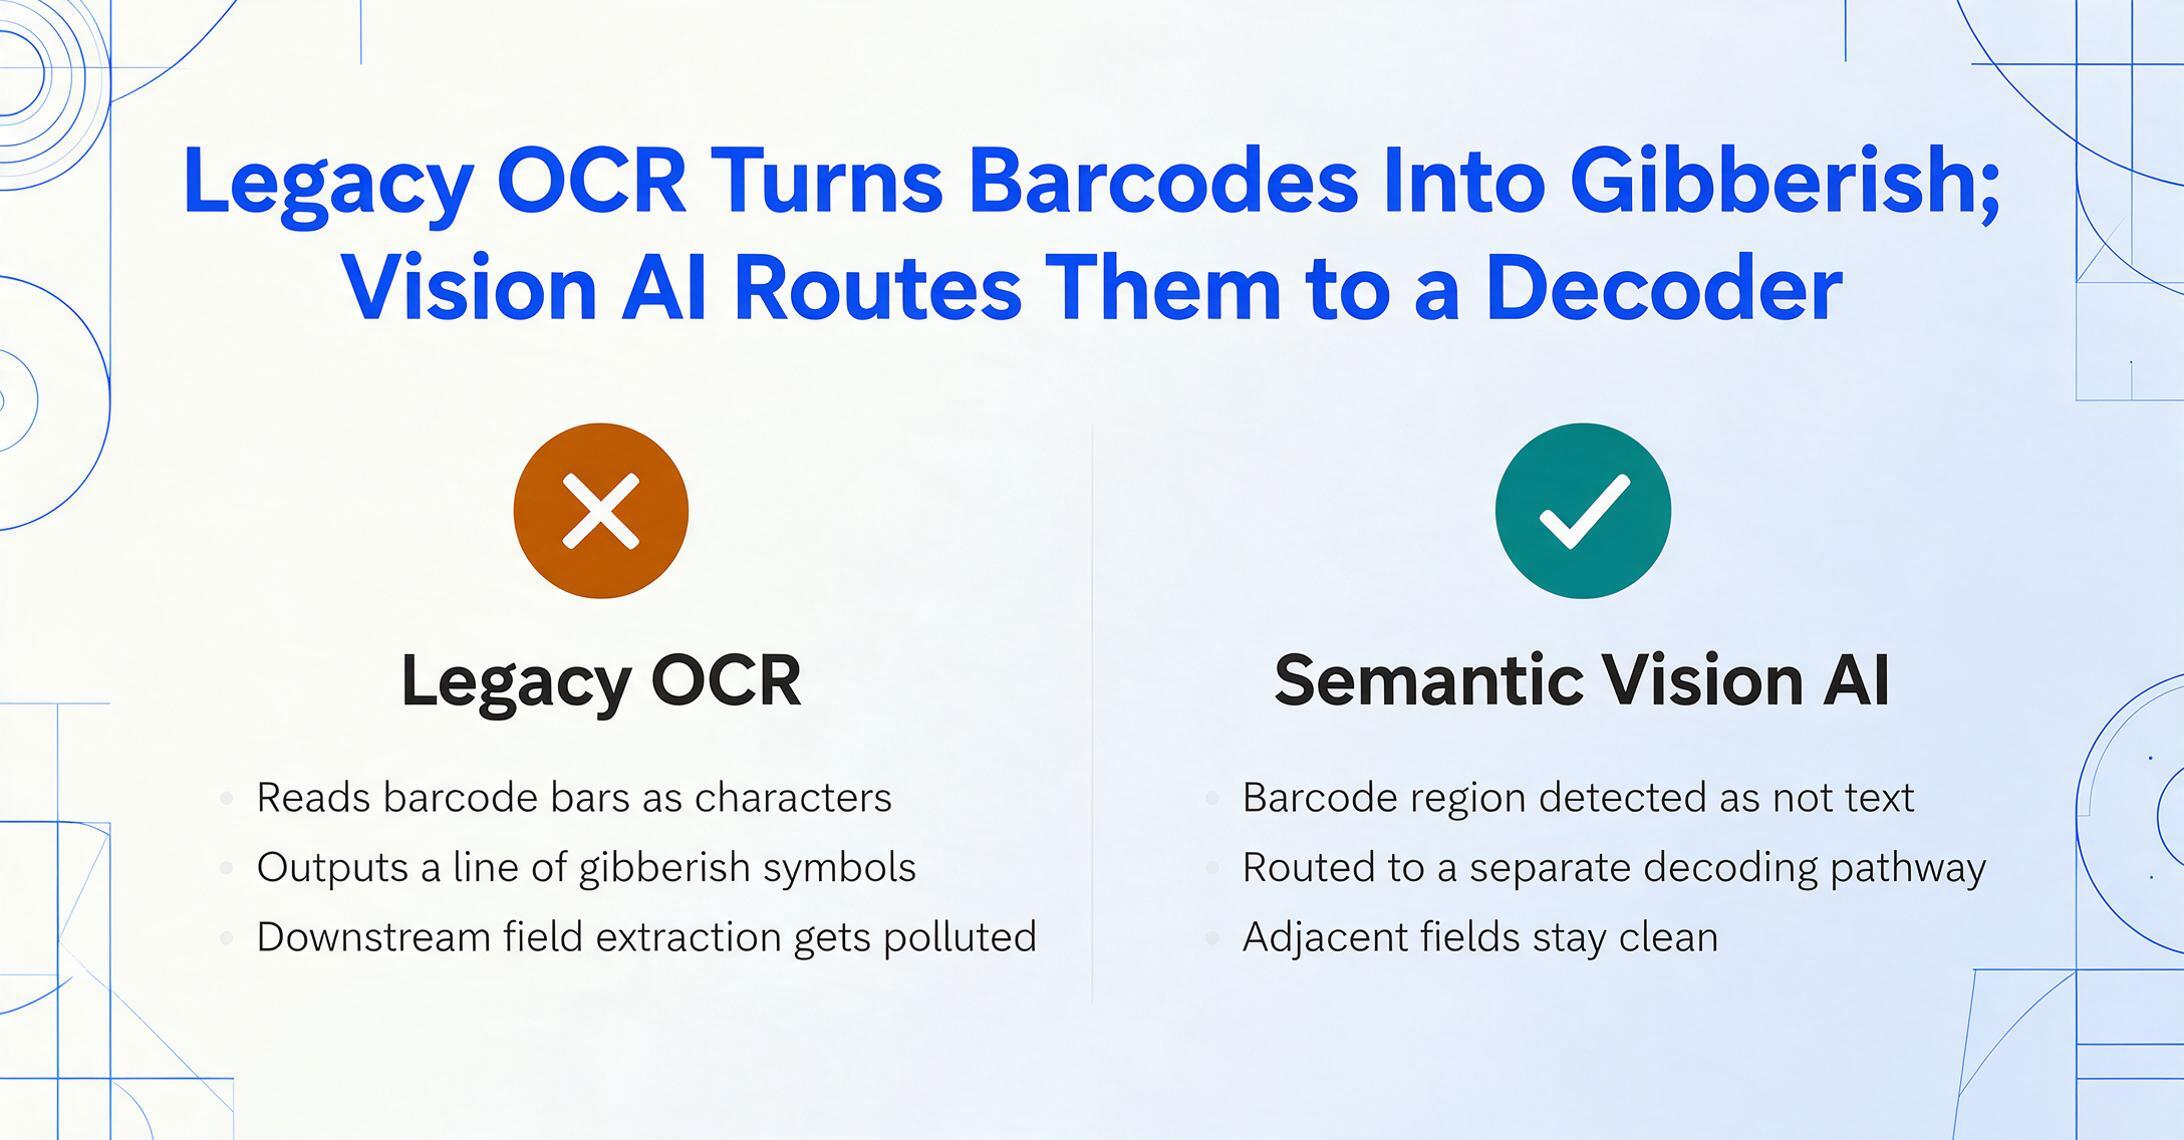
Die kurze Antwort lautet: Vision-KI verwechselt Barcode-Bereiche nicht mit Textbereichen – denn die visuellen Merkmale eines Barcodes (abwechselnde Striche variabler Breite mit einer weißen Ruhezone als Rand) unterscheiden sich grundlegend von den visuellen Merkmalen von Textzeichen (Striche, Serifen, Buchstabenabstände). Das visuelle Rückgrat der KI unterscheidet diese bereits auf der Merkmalserkennungsebene, nicht erst in der Nachbearbeitung. Der Barcode-Bereich wird als „kein Text" identifiziert und an einen separaten Dekodierungspfad weitergeleitet, anstatt in dieselbe OCR-Pipeline eingespeist zu werden.
Diese Unterscheidung ist wichtig, weil sie ein klassisches Problem der Legacy-OCR vermeidet: Wenn eine herkömmliche OCR-Engine auf einen dichten Code-128-Barcode oder einen QR-Code stößt, versucht sie oft, die Striche als Zeichen zu lesen – und erzeugt eine Zeile aus Kauderwelsch-Symbolen, die dann jede nachgelagerte Feldextraktion verunreinigt. Der Bediener muss das Kauderwelsch anschließend manuell aus der Ausgabe entfernen. Semantic Vision AI vermeidet dies vollständig, indem Barcode-Bereiche von vornherein nicht an den Textdecoder weitergeleitet werden.
Das praktische Ergebnis: Sie können Daten aus einem Etikett extrahieren, ohne befürchten zu müssen, dass der Barcode Folgefehler in benachbarten Feldern verursacht. Die Herausforderung verschiebt sich von „Barcode-Verschmutzung" zu einer anderen Frage: ob die KI den dekodierten Barcode-Wert korrekt der aufgedruckten Sendungsverfolgungsnummer auf demselben Etikett zuordnet. In den meisten Fällen stimmen sie überein – der Barcode kodiert dieselbe Sendungsverfolgungsnummer, die darüber in lesbarem Text aufgedruckt ist. Wenn sie nicht übereinstimmen (ein falsch angebrachtes Etikett oder eine Umpackung im Lager), ist die Abweichung selbst ein nützlicher Hinweis darauf, dass eine manuelle Prüfung erforderlich ist.
Wenn Text neben Barcodes die KI noch täuschen kann
Barcodebereiche werden zwar korrekt erkannt, aber Text innerhalb oder direkt neben Barcode-Etiketten kann zu Verwirrung führen. So druckt die USPS die Sendungsnummer sowohl als lesbaren Text über dem Barcode als auch als codierten Barcode-Wert. Manche Spediteure drucken eine sekundäre Referenznummer direkt unter dem Barcode in einer kleineren Schrift, die in den von der KI wahrgenommenen Ruhebereich des Barcodes hineinragt. In diesen Fällen kann die KI entweder:
- den sekundären Text vollständig übersehen, weil er aus dem Texterkennungsbereich herausgeschnitten wurde;
- oder, wenn der Abstand zwischen Barcode und Text groß genug ist, ihn zwar korrekt identifizieren, aber mit geringerer Konfidenz aufgrund der Nähe zu einem Nicht-Text-Bereich.
Diese Randfälle betreffen etwa 3–5 % der Etiketten und fallen bei einer manuellen Prüfung leicht auf. Wichtig ist: Es handelt sich um fehlende Daten, nicht um falsche Daten – die KI extrahiert das, was sie erkennt, präzise und markiert Bereiche mit geringer Konfidenz zur Prüfung.
Versandmanifeste: Tabellendaten im großen Stil
Versandmanifeste stellen eine grundlegend andere Extraktionsherausforderung dar als Etiketten. Ein Manifest – sei es das Tagesabschlussmanifest eines Spediteurs, ein Seefrachtmanifest oder ein Zollinlandsmanifest – ist ein mehrzeiliges Dokument, das alle Sendungen einer Charge auflistet und oft mehrere Seiten umfasst. Während ein Etikett dicht, aber klein ist, ist ein Manifest strukturiert, aber groß: 20 bis 200 Zeilen mit Sendungsdaten, jede Zeile enthält einige oder alle Felder, die auch auf einzelnen Etiketten erscheinen.
Der Feldsatz einer Manifestzeile umfasst typischerweise: Sendungsnummer oder PRO-Nummer, BOL-Nummer, Absendername, Empfängername, Paketanzahl, Gewicht, Serviceklasse, Warenbeschreibung und oft HS-Code sowie Warenwert. Für eingehende Frachtmanifeste, die 19 CFR § 4.7a unterliegen, sind zusätzlich SCAC-Codes, Containernummern, Siegelnummern und Verladehafen erforderlich – dieselben Daten, die Zoll- und AP-Teams für die Frachtrechnungsabstimmung benötigen.
Die Extraktionsherausforderung bei Manifesten ist die tabellarische Zeilenabgrenzung:
- Tabellen mit und ohne Rahmen. FedEx-Tagesabschlussmanifeste verwenden explizite Gitterlinien. DHL-Exportmanifeste verzichten oft ganz auf Rahmen und verlassen sich auf vertikale Leerraumausrichtung. USPS-SCAN-Manifeste (Shipping Container and Marking) verwenden Spalten mit fester Breite und Kopfabkürzungen. Die KI muss die Tabellenstruktur in jedem Format erkennen, bevor sie einzelne Zeilen extrahieren kann.
- Fortsetzung über mehrere Seiten. Ein einzelnes Manifest kann 8–12 Seiten umfassen. Die KI muss erkennen, welche Zeilen zu welcher Sendung über Seitenumbrüche hinweg gehören und ob sich Spaltenüberschriften auf jeder Seite wiederholen (meistens ja, aber nicht immer an genau derselben vertikalen Position).
- Summenzeilen. Manifeste enthalten oft Zwischensummenzeilen („Seitensumme: 15 Pakete, 28,5 lbs“), Endsummenzeilen und nur für den Spediteur bestimmte Felder. Die KI muss Datenzeilen von Metadatenzeilen unterscheiden – ein Klassifizierungsschritt, den die Template-OCR mit festen Regeln und die semantische KI durch Lesen der Zeilenbeschriftung bewältigt.
- Gemischte Datendichte. Einige Manifestzeilen enthalten 5 Felder, andere 15. Die KI sieht die ausgefüllten Zellen jeder Zeile unabhängig – eine Zeile mit Paketanzahl, aber ohne Warenbeschreibung sollte zu einer Null-Zelle führen, nicht zu einem Spaltenverschiebungsfehler, der nachfolgende Felder in die falsche Spalte drückt.
Bei gut strukturierten Manifesten mit klaren Gitterlinien erreicht die semantische KI-Erkennung eine Zeilengenauigkeit von 90–95 % – das bedeutet, dass 9 bis 9,5 von 10 Zeilen vollständig mit korrekt ausgerichteten Feldern extrahiert werden. Bei randlosen oder schlecht strukturierten Manifesten sinkt die Zeilengenauigkeit auf 75–85 %, wobei Spaltenfehlausrichtungen der häufigste Fehlermodus sind. Für den praktischen Workflow, der eine Woche voller Etiketten und ein mehrseitiges Manifest in eine Sendungsverfolgungs-Tabelle verwandelt, lesen Sie unseren Leitfaden zum Extrahieren von Versandetiketten- und Manifestdaten nach Excel.
Wo KI weiterhin menschliche Unterstützung benötigt
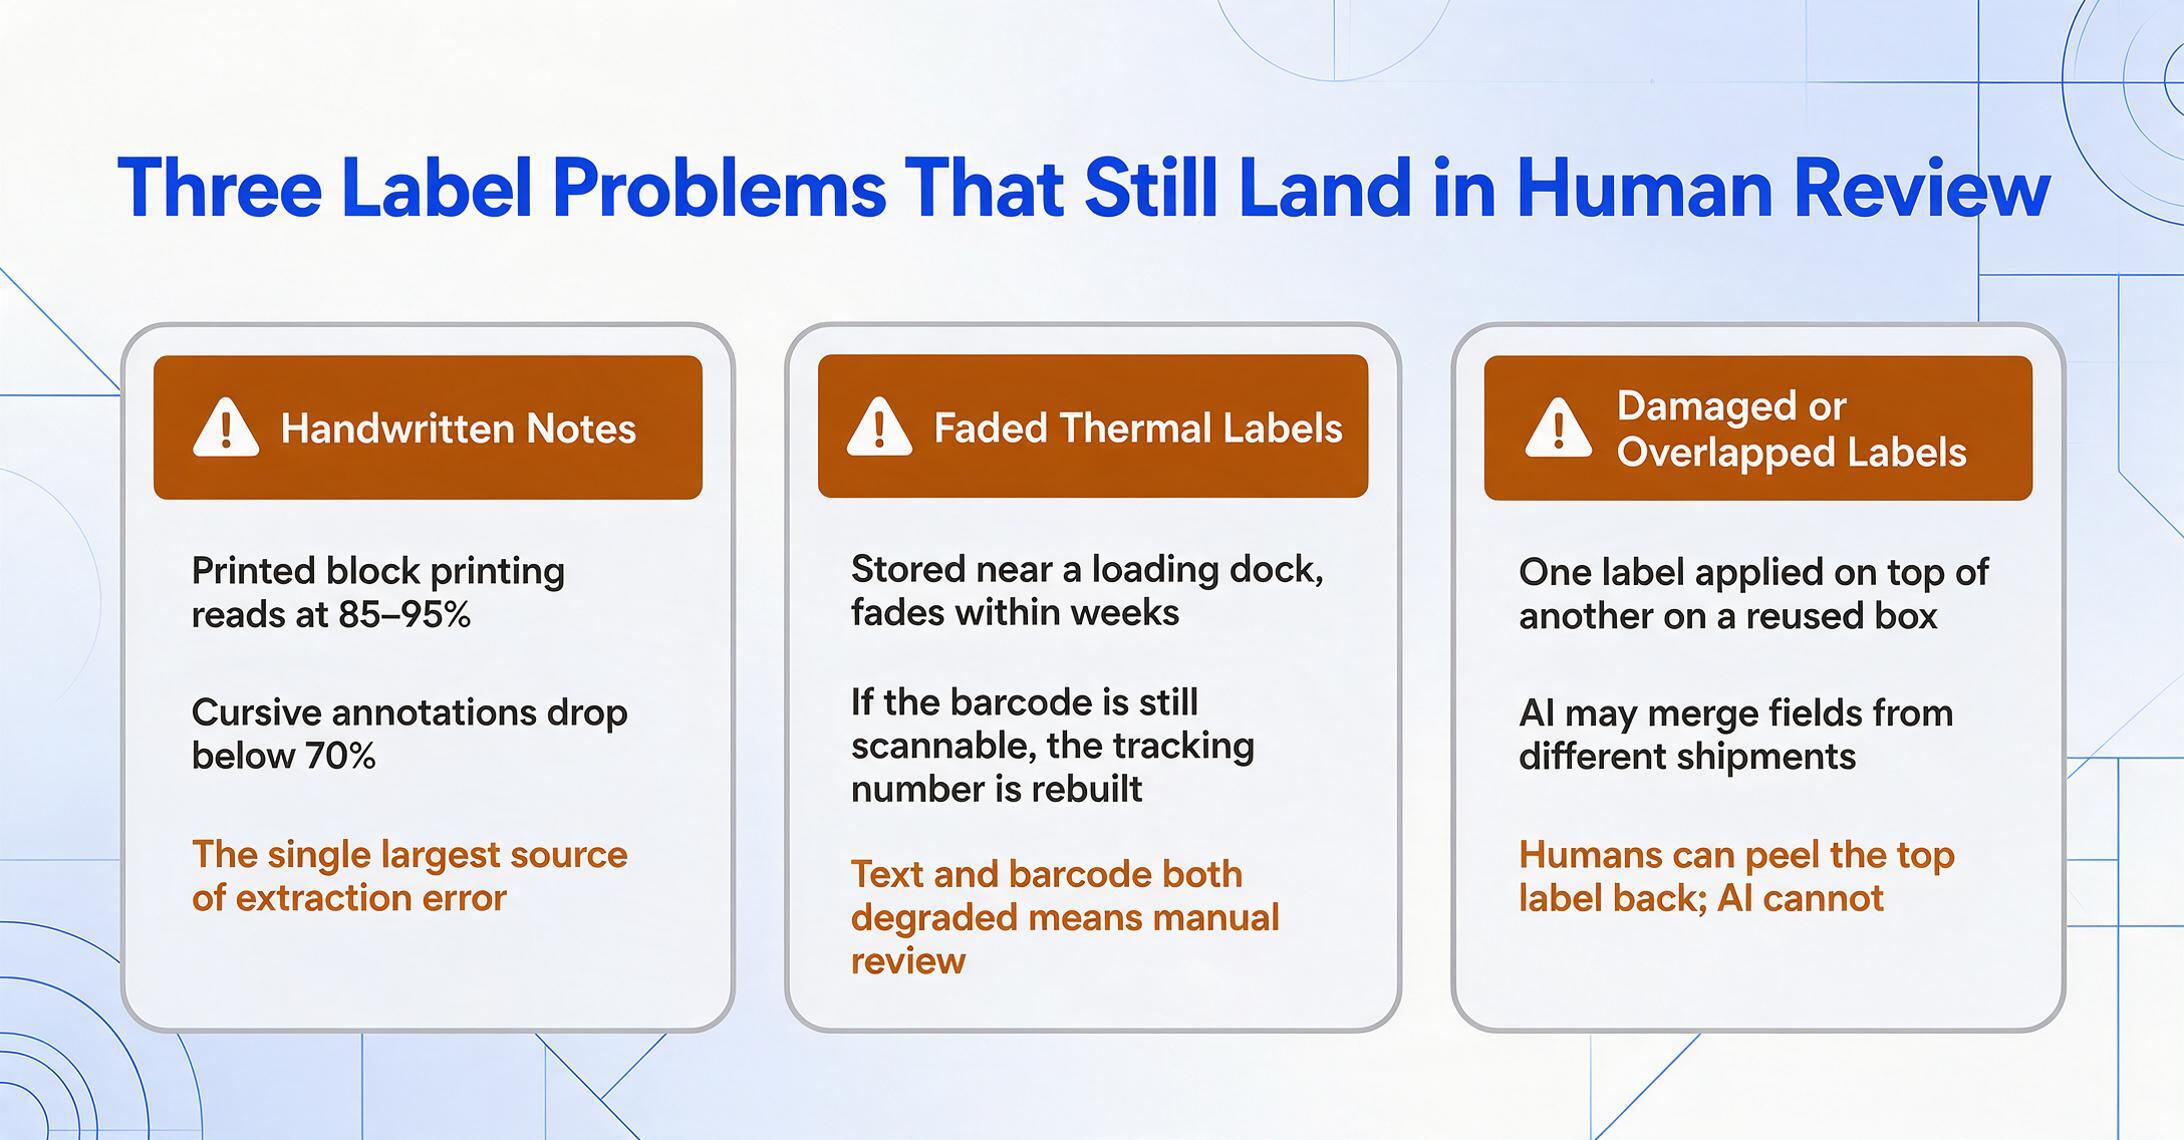
Wenig überraschend konzentrieren sich die Fehlerquellen auf dieselben Szenarien, die auch menschliche Datenerfasser herausfordern – nur mit unterschiedlichen Fehlergrenzen.
Handschriftliche Anmerkungen. Ein Disponent kritzelt „EILT" über eine Manifestzeile. Ein Lagerangestellter korrigiert eine Gewichtsangabe von Hand auf einem Thermodirekt-Etikett. Ein Fahrer schreibt „VERWEIGERT" neben eine Lieferadresse. Handschriftlicher Text, der über gedruckte Dokumente gelegt wird, ist die größte einzelne Fehlerquelle bei der Extraktion, unabhängig vom KI-Modell. Wie in unserem Vergleich der Genauigkeit von KI vs. traditioneller OCR beschrieben, erreicht die Handschrifterkennung bei sauberen Druckschriften 85–95 %, aber kursive Anmerkungen in Rändern oder über vorhandenem Drucktext fallen unter 70 %.
Thermodirekt-Etiketten mit geringem Kontrast. Thermodirekt-Etiketten verblassen mit der Zeit, besonders in Lagerumgebungen. Ein Etikett auf einer Palette in der Nähe einer Laderampe in direktem Sonnenlicht kann innerhalb von Wochen unlesbar werden. Wenn der Barcode noch scannbar ist, kann die KI die Sendungsverfolgungsnummer aus dem dekodierten Wert rekonstruieren – aber wenn sowohl der gedruckte Text als auch der Barcode verschlechtert sind, wird das gesamte Etikett zu einem Fall für die manuelle Überprüfung.
Beschädigte oder überlappende Etiketten. Ein wiederverwendeter Versandkarton mit zwei Etiketten – eines teilweise abgerissen, eines darüber angebracht – ist das schwierigste Szenario für jedes Extraktionstool. Die KI könnte versuchen, Text von beiden Etiketten zu lesen, Felder aus verschiedenen Sendungen zusammenzuführen oder das gültige Etikett ganz zu übersehen. Menschliche Operatoren kommen damit besser zurecht, weil sie das obere Etikett physisch abziehen können. Die KI hat keine gleichwertige Möglichkeit.
Abweichung der Manifest-Spaltenkopfzeilen. Einige Transportunternehmen erstellen Manifeste, bei denen die Spaltenkopfzeile auf Seite 1 erscheint, aber nicht auf den Folgeseiten. Eine semantische KI, die die Spaltenpositionen von Seite 1 gelernt hat, muss dieselben Positionen durch die Paginierung verfolgen. Wenn das PDF-Rendering die Spaltenpositionen zwischen den Seiten verschiebt (ein bekanntes Problem bei einigen Transportunternehmen-Drucksoftware), kann die Ausrichtung der KI um ein Feld pro Seite abweichen und sich über das gesamte Manifest ausbreiten.
Die praktische Erkenntnis: Bei einem typischen Batch von 50 Versandetiketten und 3 Manifesten werden voraussichtlich 88–94 % der Felder ohne menschliches Eingreifen korrekt extrahiert. Die verbleibenden 6–12 % erfordern zwischen 5 und 15 Minuten Prüfung und Korrektur – verglichen mit 60–120 Minuten manueller Dateneingabe für dieselbe Menge. Die Zeitersparnis ist real, aber die Konfidenzschwelle ist entscheidend: Für Sendungsverfolgungs- und Routing-Daten (95–99 % Genauigkeit) kann die Automatisierung unbeaufsichtigt laufen. Für Abrechnungs- und Compliance-Daten (Manifest-Summen, HS-Codes, deklarierte Werte) ist eine menschliche Prüfinstanz weiterhin das sichere Betriebsverfahren.
Optimale Ergebnisse bei der Extraktion von Versandetiketten und Manifesten erzielen
Die Extraktionsgenauigkeit bei Versandetiketten und Manifesten ist keine feste Eigenschaft des KI-Modells – sie wird durch die Bildqualität, die Definition Ihrer Spalten und die Frage, ob Sie zusammengehörige Dokumente bündeln, beeinflusst. Ein paar praktische Anpassungen machen den Unterschied zwischen „funktioniert meistens" und „zuverlässig genug für den Einsatz".
1. Erfassen Sie das gesamte Etikett, nicht nur einen Ausschnitt. Wenn Sie Versandetiketten am Wareneingang oder an der Versandtheke fotografieren, erfassen Sie den gesamten Etikettbereich plus einen kleinen Rand. Ein beschnittenes Bild, das die Ruhezone um einen Barcode abschneidet, kann die Barcode-Dekodierung verhindern, und eine fehlende Ecke könnte die Absenderadresse oder den Serviceindikator verlieren. Die KI kann einige Verdeckungen verarbeiten, aber die Fehlertoleranz bei einem 4″ × 6″-Etikett ist gering.
2. Benennen Sie Ihre Spalten semantisch. Bei der Benutzerdefinierten Spaltenextraktion – bei der Sie die gewünschten Feldnamen eingeben und die KI passende Daten nach Bedeutung findet – liefern Spaltennamen, die der Feldbezeichnung der Transportunternehmen entsprechen, bessere Ergebnisse. „Sendungsverfolgungsnummer" funktioniert auf jedem Transportunternehmen-Etikett, da die KI das Konzept versteht. „Absendername" ist zuverlässiger als „Von" (das möglicherweise den Absenderadressblock oder das Feld „Von" in einer Zollerklärung abgleicht). „Servicelevel" deckt sowohl „Service:"- als auch „Klasse"-Bezeichnungen ab. Die KI ordnet Spaltennamen Dokumentkonzepten semantisch zu, nicht durch exakten String-Abgleich.
3. Bündeln Sie Etiketten und Manifeste separat. Ein Batch von 30 Versandetiketten erzeugt eine saubere Tabelle mit einer Zeile pro Etikett – jede Zeile enthält Sendungsverfolgungsnummer, Gewicht, Adresse und Servicelevel für diese Sendung. Ein Manifest-Batch erzeugt Zeilen, die bereits als Sendungsdaten strukturiert sind. Wenn Sie beide in einem Batch mischen, verarbeitet die KI jedes Dokument unabhängig, aber die Ausgabezeilen haben unterschiedliche Felddichten (Etiketten haben weniger manifest-spezifische Felder wie HS-Codes und Containernummern). Für sauberere Ergebnisse führen Sie Etiketten und Manifeste als separate Batches aus. Die Batch-First-Verarbeitung – entwickelt, um mehrere Dokumente parallel zu verarbeiten und in einer einzigen Tabelle zusammenzuführen – funktioniert am besten, wenn die Dokumente in einem Batch dieselbe Struktur aufweisen.
4. Nutzen Sie den Barcode als Kreuzvalidierungssignal. Die auf dem Etikett gedruckte Sendungsverfolgungsnummer sollte mit dem dekodierten Wert des Barcodes übereinstimmen. Wenn Sie beide als Extraktionsspalten definieren, erhalten Sie zwei unabhängige Messwerte desselben Datenpunkts. Wenn sie abweichen, muss dieses Etikett menschlich geprüft werden – das Paket wurde möglicherweise neu etikettiert, oder der Barcode gehört zu einer anderen Sendung. Diese automatisierte Kreuzprüfung erkennt Fehler, die sonst unbemerkt blieben, bis das Paket am nächsten Hub gescannt wird.
5. Manifeste mit Prüfung auf Zeilenebene ausführen. Bei Manifesten, die aus Transportunternehmenssystemen (FedEx Ship Manager, UPS WorldShip oder DHL Express) exportiert werden, ist das PDF in der Regel maschinell erzeugt und stark strukturiert – die Extraktionsgenauigkeit liegt hier bei 95 %+. Bei manuell erstellten Manifesten oder Manifesten kleinerer Transportunternehmen mit uneinheitlicher Formatierung sollten Sie einen Konfidenzschwellenwert festlegen: Jede Zeile, bei der die feldbezogene Konfidenz der KI unter 80 % fällt, sollte vor der Übernahme in Ihr TMS oder Ihre Frachtabgleich-Tabelle zur manuellen Prüfung markiert werden.
Häufig gestellte Fragen
Kann KI Daten aus thermisch gedruckten Versandetiketten mit verschmiertem oder verblasstem Text extrahieren?
Teilweise. Wenn der gedruckte Text für einen Menschen noch lesbar ist, können die meisten Vision-KI-Modelle ihn mit 80–90 % Genauigkeit lesen. Wenn das Thermoetikett so stark verblasst ist, dass der Text kaum noch sichtbar ist, ist der Barcode – sofern er noch scanbar ist – der zuverlässigste Ausweichpfad. Wenn sowohl Text als auch Barcode beeinträchtigt sind, ist eine manuelle Dateneingabe erforderlich. Verwenden Sie hochwertige Thermotransferbänder und vermeiden Sie längere direkte Sonneneinstrahlung oder Wärmequellen, um die Lesbarkeit der Etiketten zu maximieren.
Funktioniert die KI-Extraktion bei internationalen Versandetiketten mit nicht-englischen Absender-/Empfängeradressen?
Ja, die Genauigkeit variiert jedoch je nach Schrift. Adressen in lateinischer Schrift (Englisch, Französisch, Deutsch, Spanisch) werden auf gedruckten Etiketten mit 90–95 % erkannt. Adressen in asiatischer Schrift (Chinesisch, Japanisch, Koreanisch) fallen unter denselben Bedingungen auf 80–88 %. Die KI extrahiert die Zeichen korrekt, hat aber bei CJK-Schriften möglicherweise eine geringere Konfidenz bei Zeichengrenzen, da das visuelle Segmentierungsmodell überwiegend mit lateinischen Zeichendatensätzen trainiert wurde. Etiketten mit mehreren Schriften – wenn die Absenderadresse auf Englisch und die Empfängeradresse auf Japanisch ist – werden als separate visuelle Bereiche behandelt, nicht als widersprüchliche Spracherkennung, sodass eine Seite die andere nicht beeinträchtigt.
Kann KI mehrseitige Manifeste verarbeiten, bei denen sich die Tabelle über mehrere Seiten erstreckt?
Ja — die semantische KI-Extraktion liest jede Seite unabhängig und führt die Ergebnisse anschließend anhand der Spaltenstruktur zusammen. Die wichtigste Voraussetzung ist, dass die Spaltenüberschriften von Seite zu Seite konsistent sind. Wenn die Überschriften auf Seite 1 erscheinen, aber nicht auf den Folgeseiten, leitet die KI die Spaltenpositionen aus dem Layout von Seite 1 ab. Wenn die Software des Transportunternehmens die Spaltenpositionen zwischen den Seiten verschiebt (ein bekanntes Problem bei einigen Logistikdrucksystemen), kann es zu Fehlausrichtungen auf Zeilenebene kommen. Bei kritischen Manifesten sollten Sie die letzte Zeile jeder Seite mit der ersten Zeile der nächsten Seite abgleichen, um Abweichungen in der Ausrichtung zu erkennen.
Wie unterscheidet sich die Manifest-Extraktion von der Extraktion von Versandetiketten?
Grundlegend anders. Ein Versandetikett ist ein Dokument für eine einzelne Sendung, bei dem die Herausforderung in der Dichte liegt — Text aus einem kleinen, überfüllten Bereich zu extrahieren, ohne dass sich Felder gegenseitig beeinflussen. Ein Manifest ist ein Dokument mit mehreren Sendungen, bei dem die Herausforderung in der Struktur liegt — Tabellengrenzen, Zeilenabgrenzung und Spaltenausrichtung über mehrere Seiten hinweg korrekt zu identifizieren. Dasselbe KI-Modell verarbeitet beides, aber die Extraktionsstrategie unterscheidet sich: Etiketten priorisieren Genauigkeit auf Feldebene, während Manifeste Integrität auf Zeilenebene priorisieren.
Extrahiert KI Barcodedaten aus Versandetiketten oder benötige ich einen separaten Barcodescanner?
Vision-KI kann Barcodes aus Etikettenbildern dekodieren, einschließlich Code 128, Code 39, EAN-13, UPC-A, PDF417 und QR-Codes. Der dekodierte Wert wird als reguläres Textfeld in der Extraktionsausgabe zurückgegeben. Das bedeutet, dass Sie keinen separaten Barcodescanner benötigen, wenn Ihr Workflow Bilder verarbeiten kann. Ein dedizierter Barcodescanner am Wareneingang ist jedoch immer noch schneller und zuverlässiger als das Fotografieren jedes Etiketts — die KI-Extraktion für Barcodes eignet sich am besten, wenn Sie das Etikettenbild bereits für andere Zwecke erfassen (z. B. Adress- oder Gewichtsextraktion) und den Barcodewert als kostenloses Nebenprodukt erhalten möchten.
Welche Mindestbildqualität ist für eine zuverlässige Extraktion erforderlich?
Für gedruckte Versandetiketten: mindestens 150 DPI auf dem Etikettenbereich, mit gleichmäßiger Beleuchtung und minimalem Schattenwurf. Für Manifeste: mindestens 200 DPI auf dem Tabellenbereich, wobei die Seite flach und nicht an der Bindung gekrümmt sein sollte. Die meisten Smartphones erfüllen diese Anforderungen im Standardfotomodus automatisch. Der häufigste Qualitätsfehler ist nicht die Auflösung – sondern die Bewegungsunschärfe durch ein Handfoto bei schlechten Lichtverhältnissen. Ein gut beleuchtetes, ruhig aufgenommenes Foto auf Armeslänge liefert bessere Extraktionsergebnisse als ein hochauflösender Scan mit inkonsistenter Beleuchtung.
Versandetiketten und Manifeste gehören zu den häufigsten – und formatvariabelsten – Dokumenten in Logistikabläufen. Die KI verarbeitet beide, aber zu wissen, wo sie zuverlässig funktioniert und wo sie noch Unterstützung benötigt, ist der Unterschied zwischen einem eingesetzten Workflow und einem Proof of Concept, der die Demo-Phase nie verlässt.
Testen Sie es mit Ihren eigenen Dokumenten