AIは配送ラベル
& マニフェストのデータを抽出できる?できること・できないこと
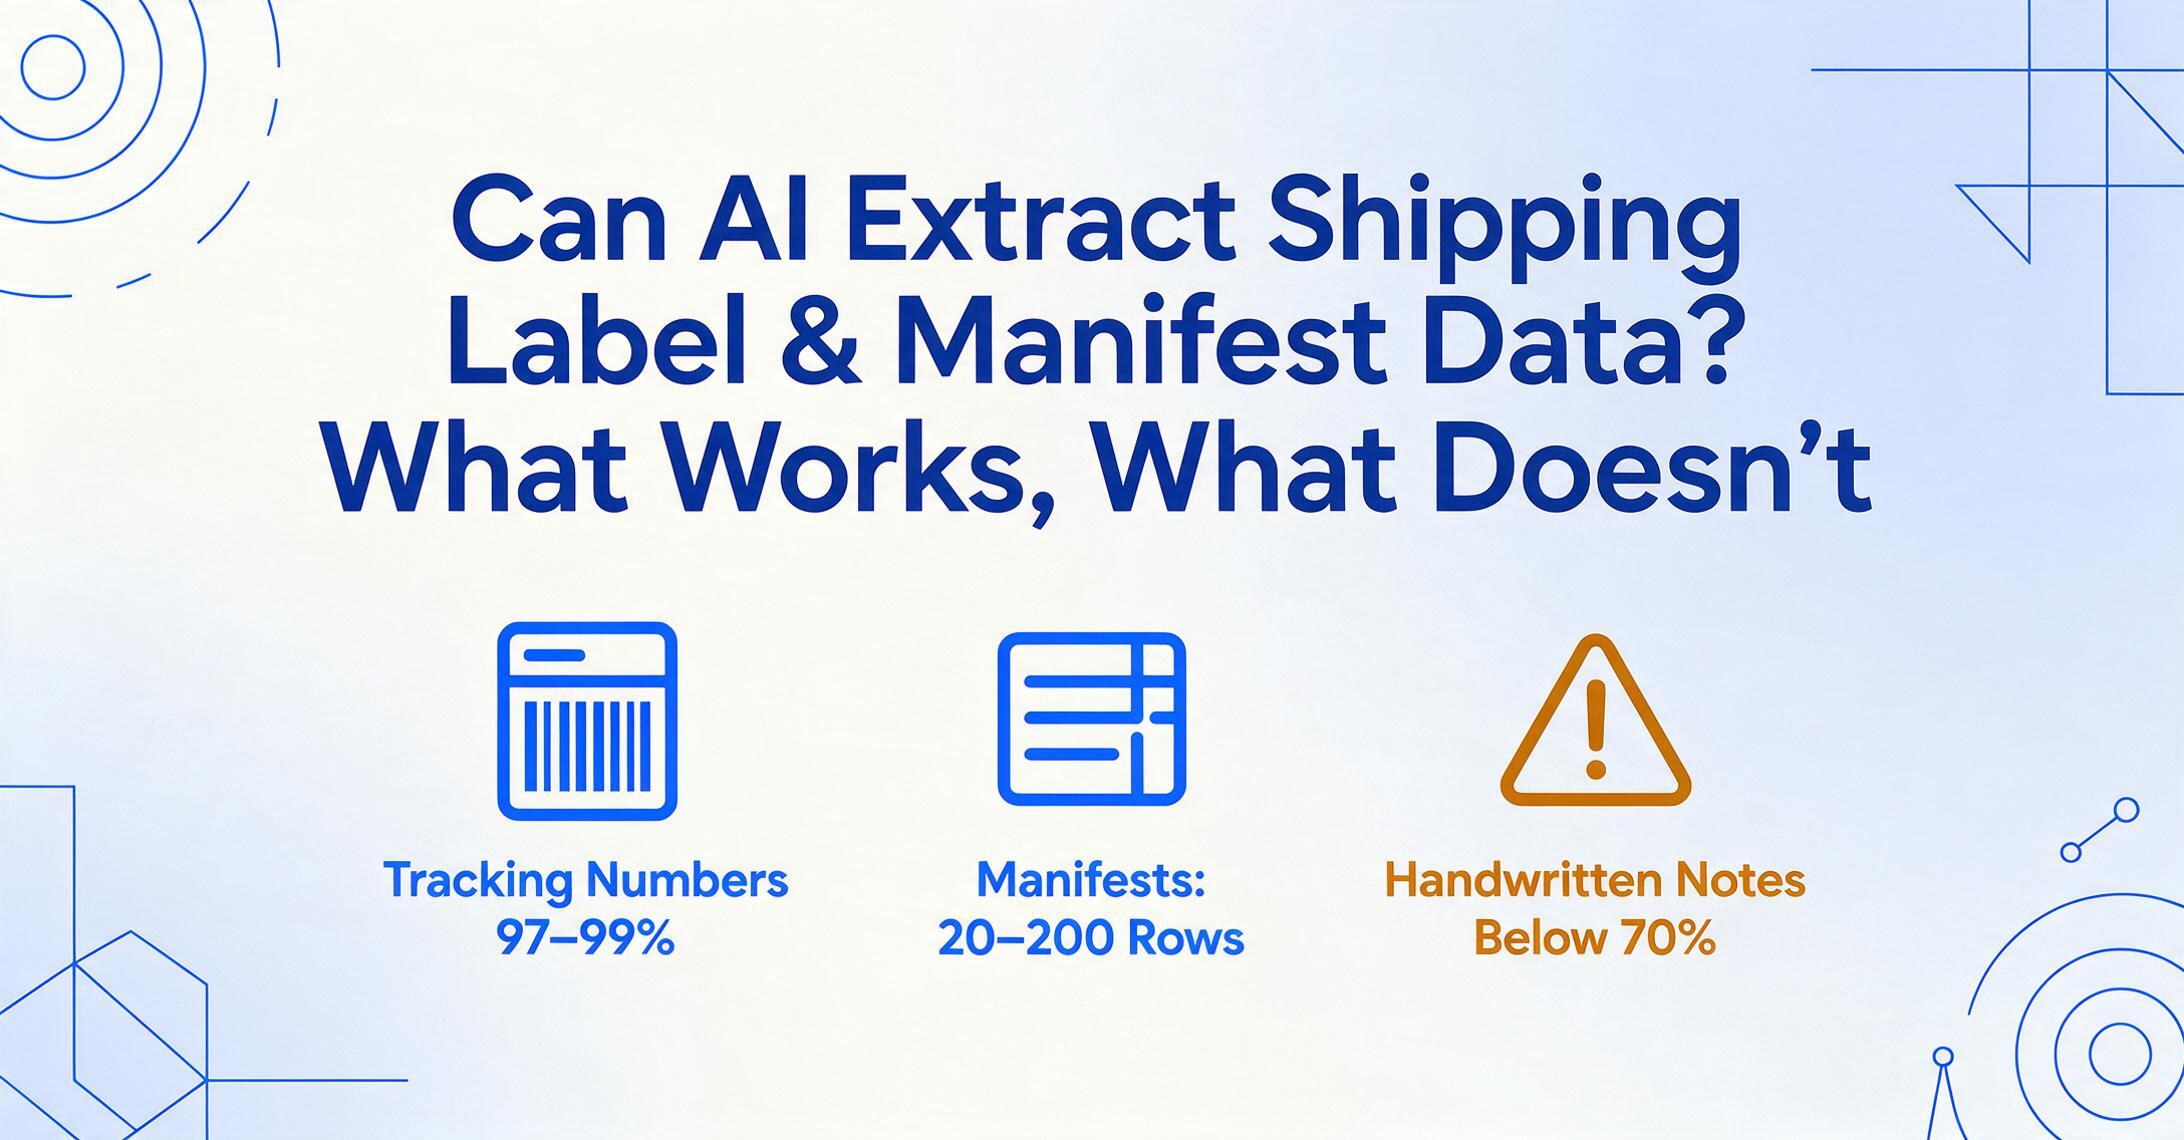
はい — 最新のビジョンAIは、印刷されたフィールドの配送ラベルデータを高い精度で抽出し、運送会社ごとのテンプレート設定なしで複数行のマニフェストテーブルも処理できます。ただし、信頼度の幅は広く、追跡番号やバーコードでデコードされた文字列は97%以上である一方、手書きの重量注記、サービスレベルの略語、断片化されたマニフェストのセルは70~85%まで低下します。本当の問いは「AIにできるか」ではなく、「どのフィールドを手動確認なしで信頼できるか」です。
主なポイント
- 印刷されたラベルの追跡番号は97~99%の抽出精度を達成 — 手動入力6時間目の疲れた人間よりも高い精度です。
- 50枚のラベルと3つのマニフェストのバッチでは、88~94%のフィールドが人手を介さずに正しく抽出されます。残りの6~12%を修正するのに60~120分ではなく5~15分で済みます。
- マニフェストの本当の課題はテキストの読み取りではなく、列の位置合わせを維持することです — 12ページにわたる200行で、1つのフィールドのずれがドキュメント全体に連鎖します。
答えを配送ラベルとマニフェストに分ける前に、一つ重要な違いがあります。従来のOCRとセマンティックAI抽出では、これらのドキュメントの扱い方が大きく異なります。FedEx Groundのラベルで機能するテンプレートベースのOCRツールは、UPS AirのラベルやDHL eCommerceのラベルでは失敗します。運送会社ごとにフィールドの配置が異なるためです。セマンティック抽出 — AIがフィールドの位置ではなく意味で読み取るアプローチ — は、ベンダーごとの設定なしで複数の運送会社フォーマットに対応します。この違いが以下のすべての基盤であり、物流向けOCR総合ガイドで詳しく解説しています。
配送ラベル:フィールド別の精度内訳
標準的な配送ラベル — UPS、FedEx、USPS、DHLのいずれであっても — は、A5ページより小さいスペースに8〜12個の抽出可能なデータポイントが詰め込まれています。課題はその密度です。4″ × 6″のサーマルラベルには、追跡番号、バーコード、2つの住所ブロック、サービスレベル表示、荷物の重量、発送日、参照フィールドが含まれ、それらはラベル付きのボックスではなく視覚的なガイドで区切られているだけです。
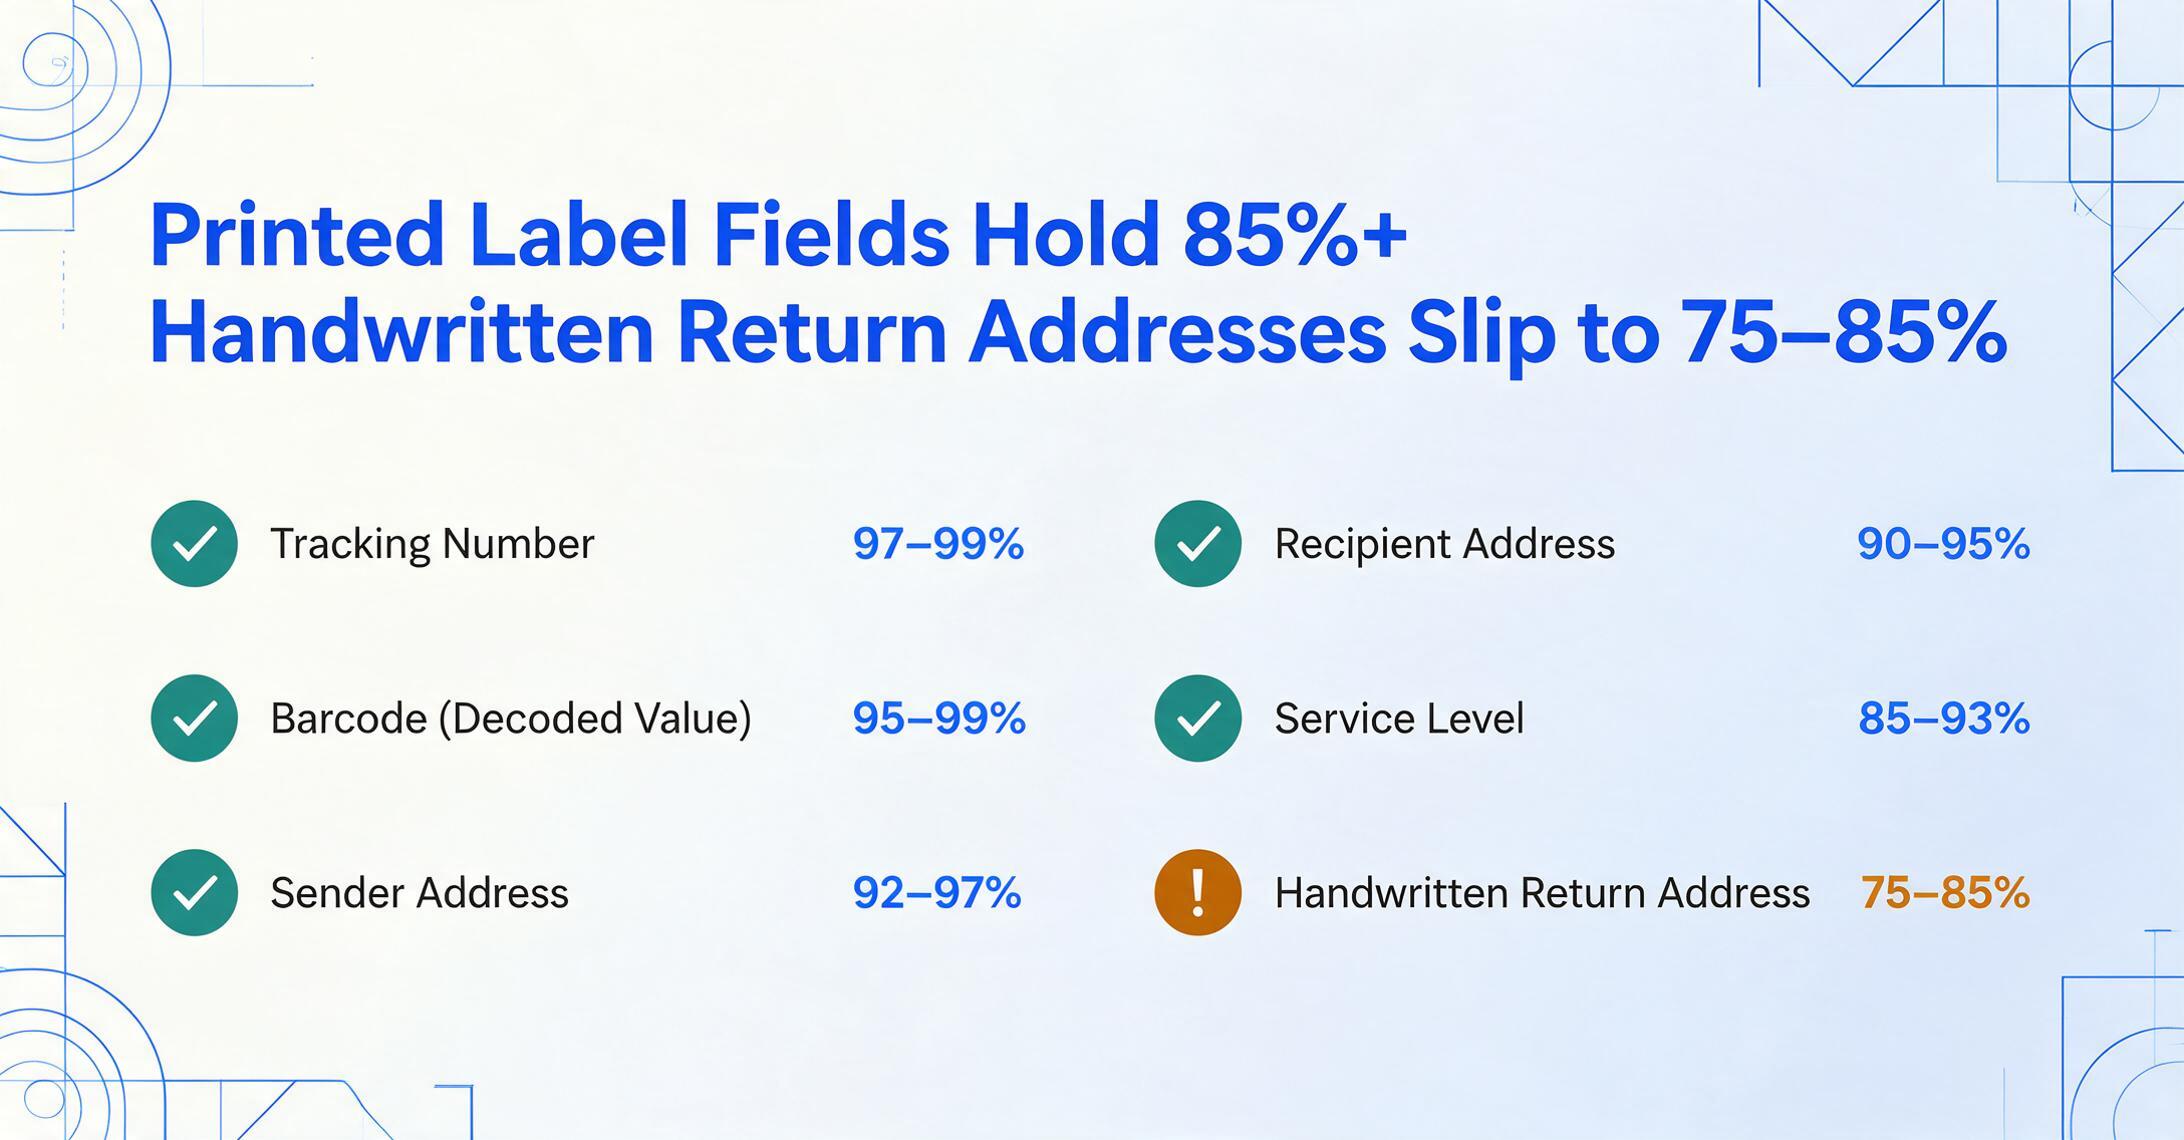
以下は、一般的な運送会社印刷の配送ラベル(印刷テキスト、良好な画像品質)におけるセマンティックAI抽出のフィールド別精度プロファイルです:
| フィールド | AI精度の範囲 | この範囲になる理由 |
|---|---|---|
| 追跡番号 | 97–99% | チェックディジット付きの英数字。運送会社のプレフィックス(1Z、9361、GM)は予測可能なパターンです。AIモデルはこれらを自由テキストではなく構造化コードとして認識します。 |
| バーコード(デコード値) | 95–99% | ビジョンモデルがバーコード領域を検出し、デコード処理に渡します。バーコード内のテキスト値は印刷された追跡番号と一致することが多く、有用なクロスバリデーションのシグナルになります。 |
| 差出人住所 | 92–97% | 通常は統一された書体で印刷されています。サーマルラベルに印刷された返送先住所は、最も信頼できるフィールドの一つです。手書きの返送先住所は75–85%まで低下します。 |
| 受取人住所 | 90–95% | 印刷テキストであれば差出人と同様ですが、以前のラベルの上に宛先ラベルが貼られ、影や部分的な遮蔽が生じて精度が低下することがあります。 |
| サービスレベル(Ground、2-Day、Expressなど) | 85–93% | サービス表示は大きく異なります。UPSはチェックボックスグリッド、FedExはテキスト付きのカラーバー、USPSはクラス説明を使用します。AIはラベルとその視覚的コンテキストの両方を解釈する必要があります。運送会社の略称(「PRI」と「Priority」)も曖昧さを加えます。 |
| 荷物の重量 | 85–95% | 印刷された重量フィールドは信頼できます。主な失敗点は手書きの重量修正(発送カウンターでよく見られます)です。「2.0」の上に走り書きされた「2.5」を自信を持って解析するのは、どのAIにとっても困難です。 |
| 発送日 | 90–96% | 日付は複数の形式(06/30/2026、30-JUN-2026、2026-06-30)で表示されます。セマンティックAIはこれらをうまく正規化しますが、一部の運送会社は発送日を追跡番号と同じ形式で近接して印刷するため、AIは形式ではなくラベルのコンテキストで区別する必要があります。 |
| 参照フィールド(PO#、Dept#、Customer Ref) | 80–90% | 参照番号は運送会社ごとに異なり、しばしば汎用的な「Reference」フィールドに統合されます。ラベルに「Ref: 54829-12」とある場合、AIは文字列を正しく抽出しますが、その文字列がPO番号、顧客参照、内部請求番号のいずれに該当するかはコンテキスト次第です。 |
注目すべき数字 — 印刷フィールドで90%以上 — は、最新のビジョンAIと従来のOCRの一般的な精度ベンチマークと一致しています。物流チームにとっての重要な洞察は、追跡番号と住所は印刷ラベルにおいてほぼ解決済みの問題である一方、サービスレベル表示と参照フィールドには依然としてスポットチェックが必要だということです。
バーコードの疑問:AIは混乱するのか?
これは物流の専門家が最もよく口にする懸念です。配送ラベルは、テキスト、バーコード、QRコード、チェックボックス、運送会社のロゴなど、さまざまな視覚要素が狭いスペースに密集したフィールドです。AIがバーコードをテキストとして「読み取ろう」として、抽出結果の残りの部分を汚染するようなゴミ出力を生成しないでしょうか?
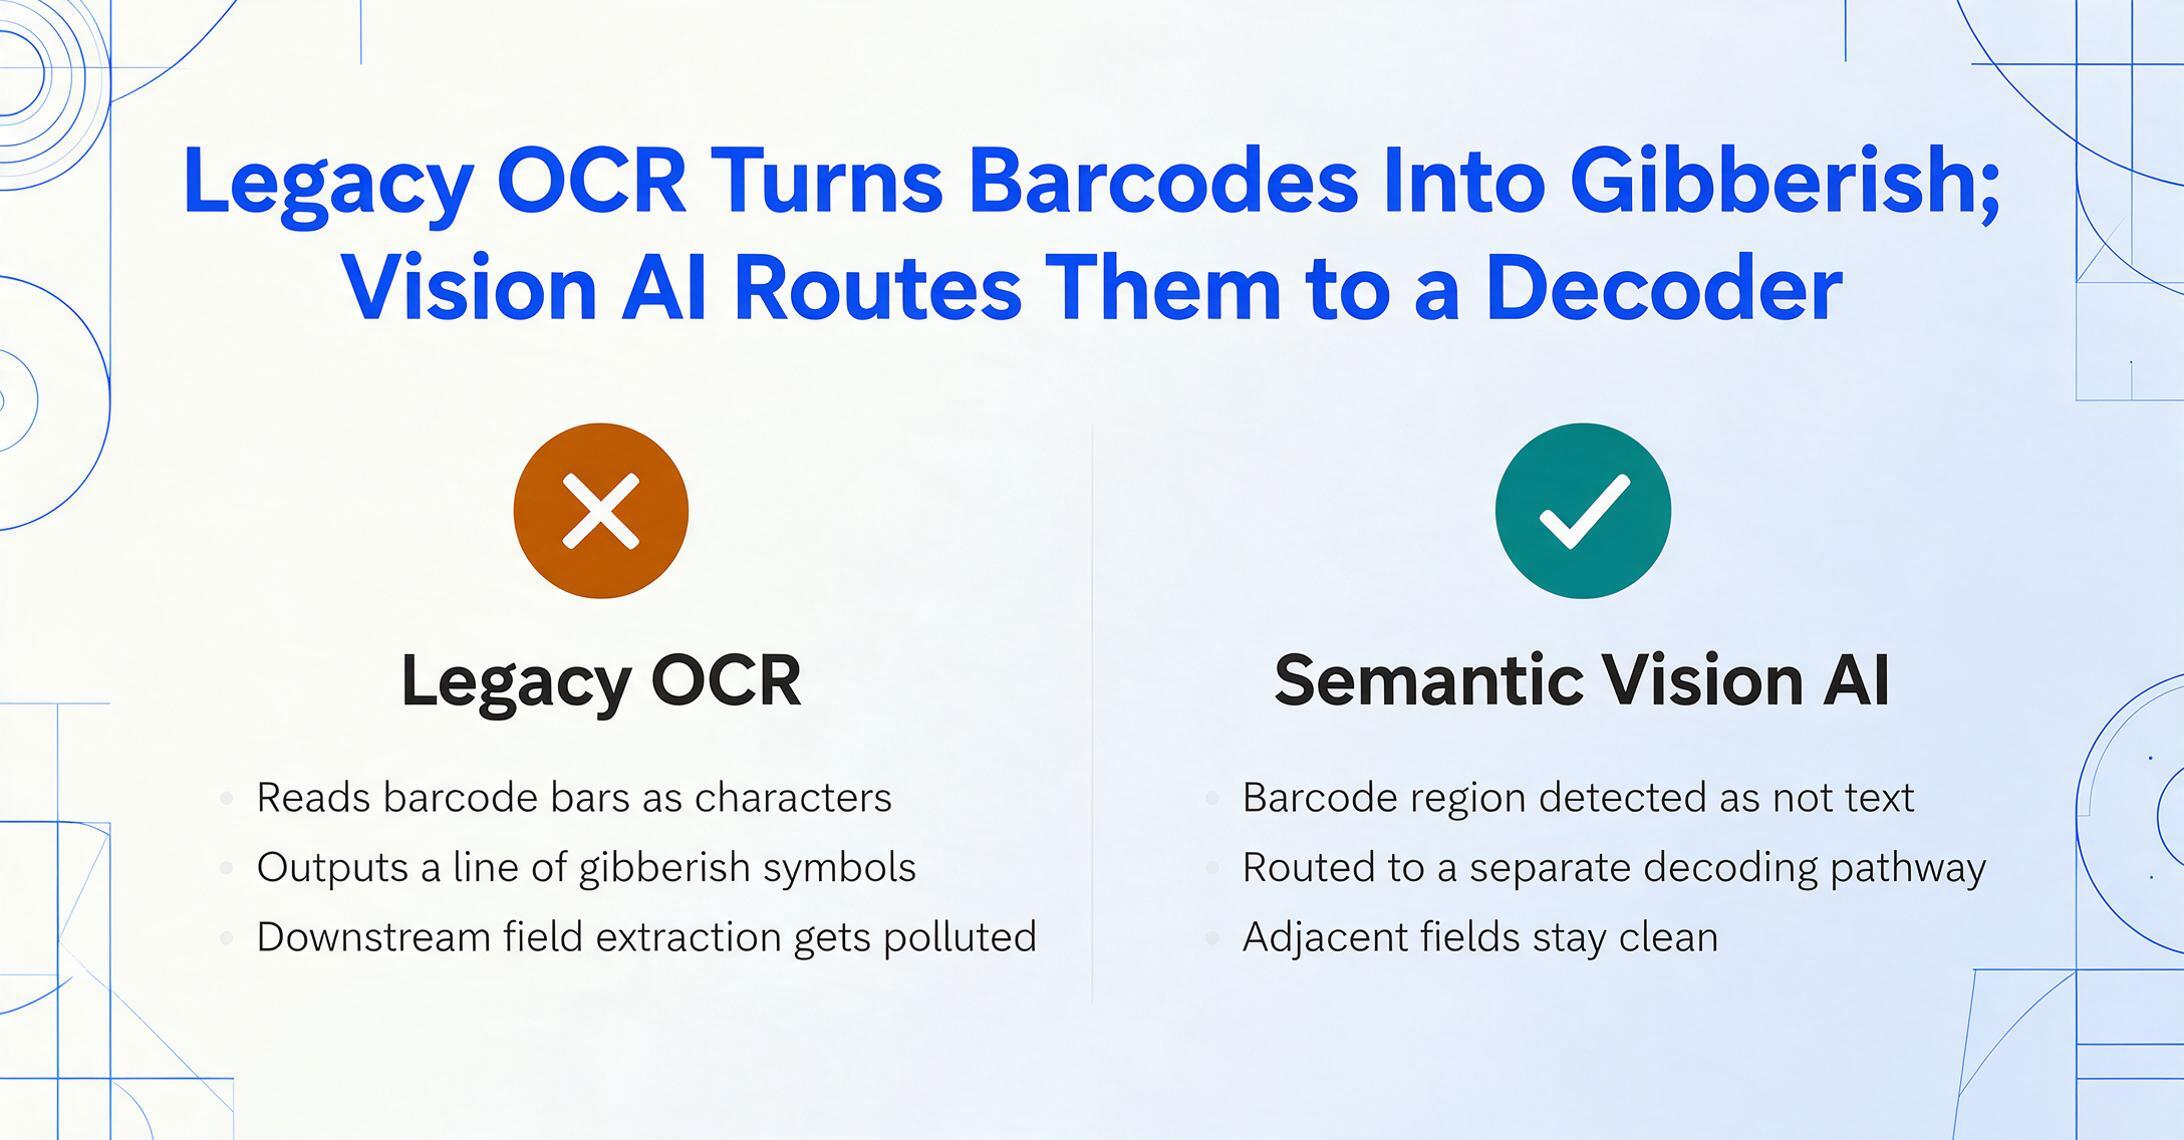
結論から言うと、ビジョンAIはバーコード領域をテキスト領域と混同しません。なぜなら、バーコードの視覚的特徴(幅の異なるバーが交互に並び、白いクワイエットゾーンの境界がある)は、テキスト文字の視覚的特徴(ストローク、セリフ、字間)とは根本的に異なるからです。AIの視覚バックボーンは、後処理層ではなく特徴検出層でこれらを区別します。バーコード領域は「テキストではない」と識別され、同じOCRパイプラインに投入されるのではなく、別のデコード経路に振り分けられます。
この区別が重要なのは、従来のOCRの典型的な問題を回避できるからです。従来のOCRエンジンが高密度のCode 128バーコードやQRコードに遭遇すると、バーを文字として読み取ろうとし、意味不明な記号の行を生成して、下流のフィールド抽出を汚染することがよくあります。その後、オペレーターが出力からその意味不明な部分を編集して取り除かなければなりません。セマンティックビジョンAIは、そもそもバーコード領域をテキストデコーダーに振り分けないことで、この問題を完全に回避します。
実用的な結果として、バーコードが隣接するフィールドに連鎖的なエラーを引き起こす心配なく、ラベルからデータを抽出できます。課題は「バーコード汚染」から別の問いへと移ります。それは、AIがデコードしたバーコードの値を、同じラベルに印刷された追跡番号と正しく関連付けられるかどうかです。ほとんどの場合、両者は一致します。バーコードは、その上に人間が読めるテキストで印刷された同じ追跡番号をエンコードしているからです。一致しない場合(ラベルの貼り間違いや倉庫での再梱包)、その不一致自体が、人間によるレビューで調査すべき有用なフラグとなります。
バーコード隣接テキストがAIを誤らせるケース
バーコード領域は正しく処理されますが、バーコード領域のラベル内部またはすぐ隣に印刷されたテキストは混乱を招くことがあります。たとえば、USPSのラベルは追跡番号をバーコード上部の人間が読めるテキストおよびエンコードされたバーコード値の両方で印刷します。一部の運送会社は、バーコードのすぐ下に小さなフォントで二次参照番号を印刷し、それがAIがバーコードのクワイエットゾーンと認識する領域にはみ出すことがあります。このような場合、AIは次のいずれかを行います:
- 二次テキストがテキスト検出領域から切り取られたため、完全に見落とす;
- または、バーコードとテキストの距離が十分に大きい場合、非テキスト領域への近接により信頼度は低いものの正しく識別する。
これらのエッジケースはラベルの約3~5%に影響し、人間によるレビューで簡単に発見できます。重要なのは、これらが誤ったデータではなく見落とされたデータであるという点です。AIは識別したものを正確に抽出し、信頼度の低い領域をレビュー用にフラグ付けします。
配送マニフェスト:大規模な表形式データ
配送マニフェストは、ラベルとは根本的に異なる抽出の課題を提示します。マニフェスト — 運送会社の日次集荷マニフェスト、海上貨物マニフェスト、または通関輸入マニフェストのいずれであっても — は、バッチ内のすべての出荷をリストする複数行のドキュメントであり、多くの場合複数ページにわたります。ラベルが高密度だが小さいのに対し、マニフェストは構造化されているが大きく、20~200行の出荷データがあり、各行には個々のラベルに表示されるフィールドの一部またはすべてが含まれます。
マニフェスト行のフィールドセットには通常、追跡番号またはPRO番号、BOL番号、荷送人名、荷受人名、荷物数、重量、サービス区分、品目説明が含まれ、多くの場合HSコードと申告価額も含まれます。19 CFR § 4.7aに準拠する輸入貨物マニフェストでは、さらにSCACコード、コンテナ番号、シールID、積込港が必要です — これらは通関およびAPチームが運賃請求書の照合に必要とする同じデータ要素です。
マニフェストの抽出課題は表形式の行の区切りです:
- 罫線あり vs. 罫線なしの表。FedExの日次集荷マニフェストは明示的なグリッド線を使用します。DHLの輸出マニフェストは多くの場合罫線を完全に省略し、垂直方向の空白配置に依存しています。USPSのSCANマニフェスト(Shipping Container and Marking)はヘッダー略語付きの固定幅列を使用します。AIは個々の行を抽出する前に、各フォーマットの表構造を認識する必要があります。
- 複数ページの継続。1つのマニフェストは8~12ページにわたることがあります。AIはページ区切りを越えてどの行がどの出荷に属するかを識別し、列ヘッダーが各ページで繰り返されるかどうか(通常は繰り返されますが、常に同じ垂直位置とは限りません)を判断する必要があります。
- 集計行。マニフェストには多くの場合、小計行(「ページ合計:15個、28.5 lbs」)、末尾の総合計行、運送会社専用フィールドが含まれます。AIはデータ行とメタデータ行を区別する必要があります — これはテンプレートOCRが固定ルールで処理し、セマンティックAIが行ラベルを読むことで処理する分類ステップです。
- 混在するデータ密度。マニフェストの行によって5フィールドの場合もあれば15フィールドの場合もあります。AIは各行の入力済みセルを個別に認識します — 荷物数はあるが品目説明がない行は、nullセルになるべきであり、後続のフィールドを誤った列に押し込む列ずれエラーになってはなりません。
明確なグリッド線がある整ったマニフェストでは、セマンティックAI抽出は行レベルの精度90~95%を達成します。つまり10行中9~9.5行が、フィールドの位置ずれなく完全に抽出されるということです。罫線がない、または構造が不十分なマニフェストでは、行レベルの精度は75~85%に低下し、最も多い失敗パターンは列の位置ずれです。1週間分の配送ラベルと複数ページのマニフェストを1つの追跡スプレッドシートにまとめる実践的なワークフローについては、配送ラベルとマニフェストのデータをExcelに抽出するガイドをご覧ください。
AIが依然として人のバックアップを必要とする場面
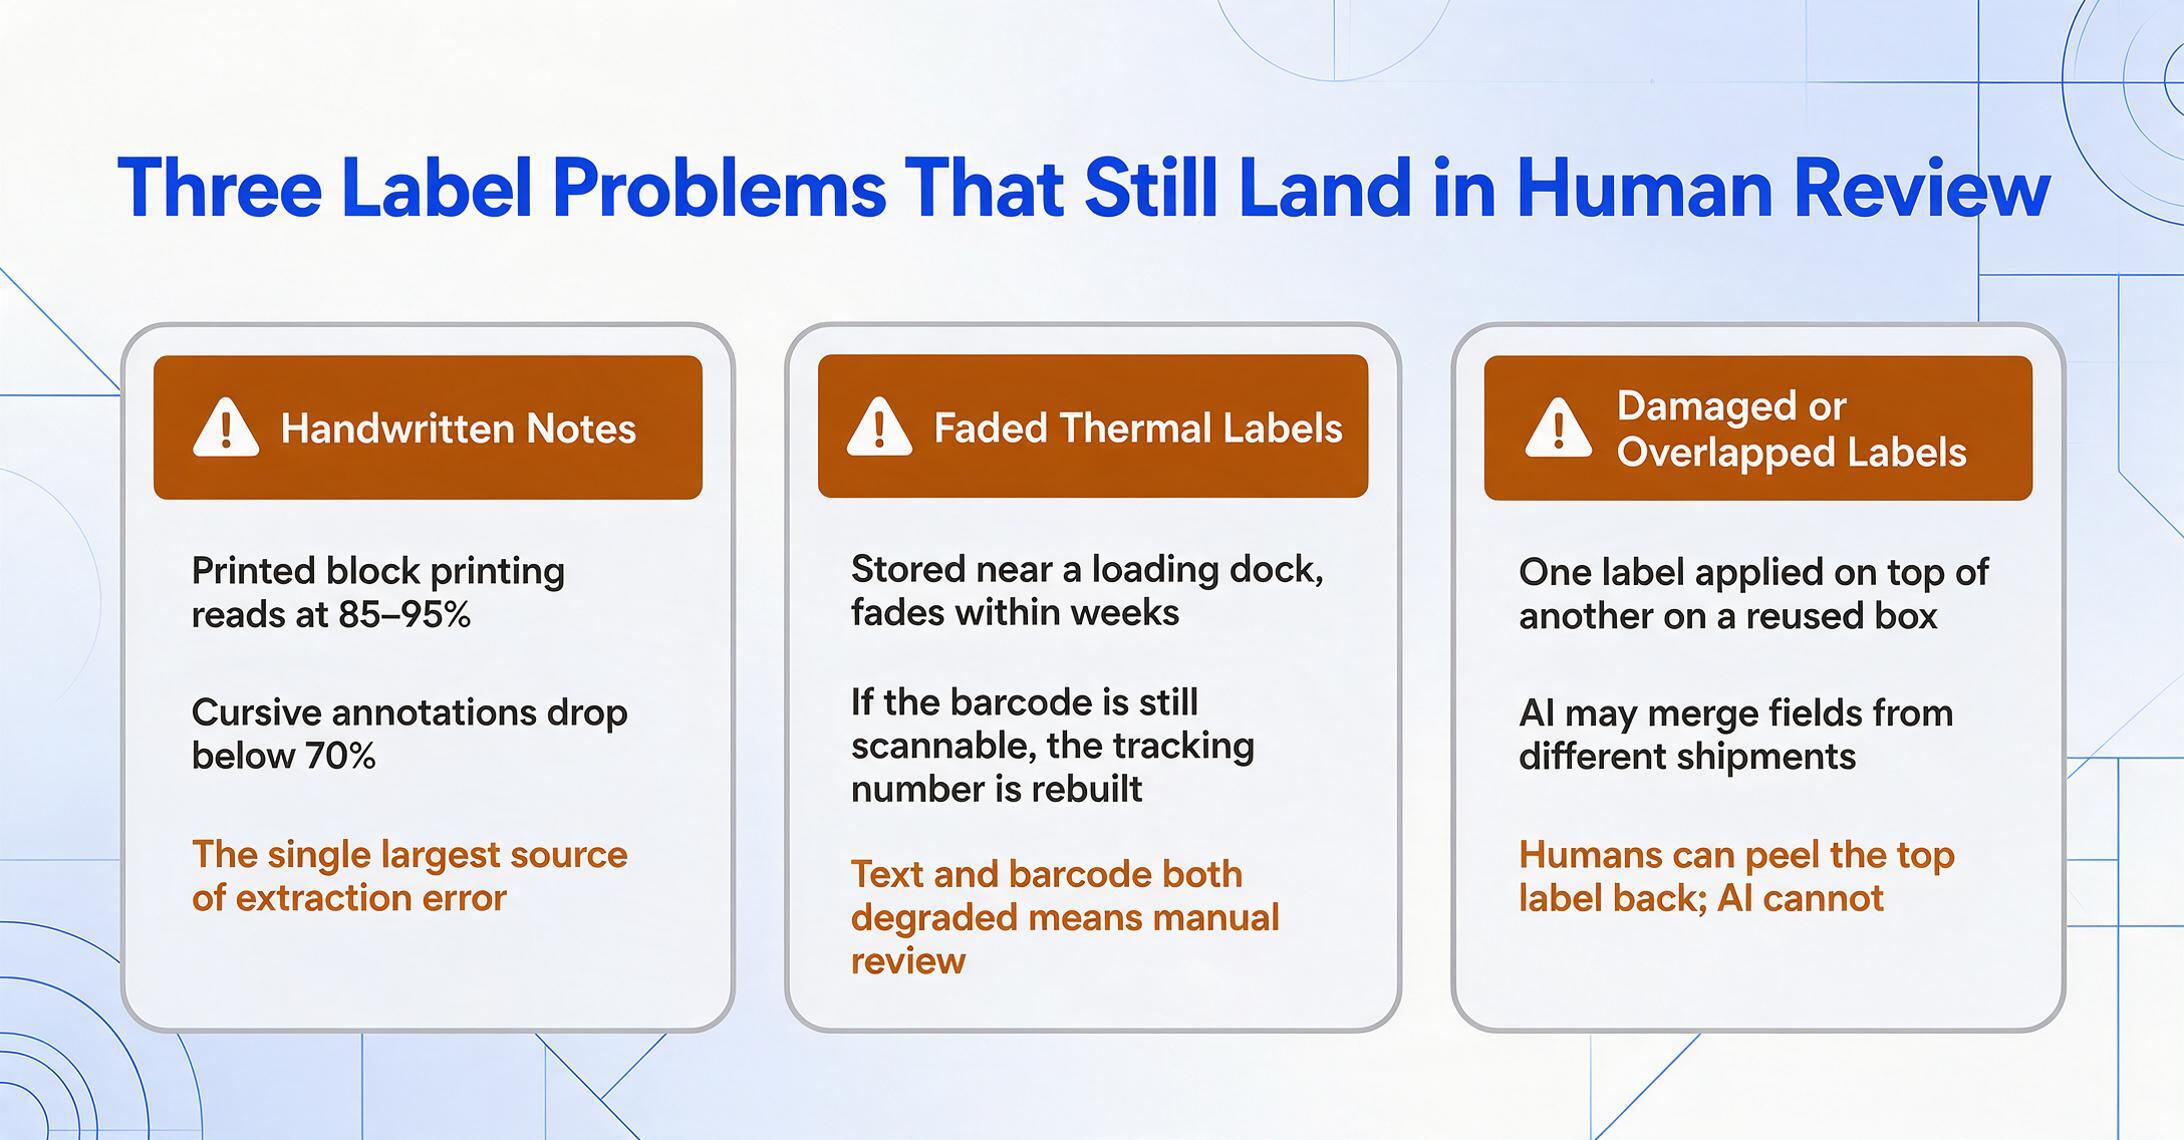
当然ながら、失敗点は人間のデータ入力オペレーターがつまずくのと同じシナリオに集中します。ただしエラーの度合いは異なります。
手書きの注記。配車担当者がマニフェストの行に「RUSH」と走り書きする。倉庫の担当者がサーマルラベル上の重量数値を手書きで修正する。ドライバーが配送先住所の横に「REFUSED」と書く。印刷された書類に重ねて書かれた手書き文字は、AIモデルに関係なく、抽出エラーの最大の原因です。AIと従来のOCRの精度比較で触れたように、きれいなブロック体の手書き文字の精度は85~95%に達しますが、余白や既存の印刷文字の上に走り書きされた筆記体の注記は70%未満に低下します。
コントラストの低い熱転写ラベル。ダイレクトサーマルラベルは時間とともにかすれます。特に倉庫環境では顕著です。荷役ドックの近くで直射日光にさらされたパレット上のラベルは、数週間で読めなくなることがあります。バーコードがまだスキャン可能であれば、AIはデコードした値から追跡番号を復元できます。しかし印刷文字とバーコードの両方が劣化している場合、そのラベル全体が手動確認の対象になります。
破損または重なったラベル。再利用された配送箱に2枚のラベルがあり、1枚は一部が破れ、もう1枚がその上に貼られているケースは、どの抽出ツールにとっても最も難しいシナリオです。AIは両方のラベルから文字を読み取ろうとしたり、異なる荷物のフィールドを統合したり、有効なラベルを完全に見落としたりする可能性があります。人間のオペレーターは上のラベルを物理的にめくることができるため、より適切に対応できます。AIにはそれに相当する操作がありません。
マニフェストの列ヘッダーのずれ。運送会社によっては、列ヘッダーが1ページ目にしか表示されず、以降のページにはないマニフェストを生成することがあります。1ページ目から列の位置を学習したセマンティックAIは、ページ送りを通じて同じ位置を追跡する必要があります。PDFのレンダリングでページ間の列位置がずれると(一部の運送会社の印刷ソフトウェアで知られる問題)、AIの位置合わせが1ページにつき1フィールドずつずれ、マニフェスト全体に連鎖的に影響することがあります。
実用的な結論: 通常、配送ラベル50枚とマニフェスト3件のバッチでは、フィールドの88~94%が人手を介さずに正しく抽出されると見込まれます。残りの6~12%には5~15分の確認と修正が必要です。同じ量を手作業で入力する場合の60~120分と比べてみてください。時間短縮は確実ですが、信頼度のしきい値が重要です。追跡・ルーティングデータ(精度95~99%)は自動化を無監視で実行できます。一方、請求・コンプライアンスデータ(マニフェストの合計、HSコード、申告価額)については、人による確認レイヤーが依然として安全な運用手順です。
配送ラベルとマニフェスト抽出で最高の結果を得るには
配送ラベルとマニフェストの抽出精度は、AIモデルの固定された特性ではありません。画像品質、列の定義方法、関連するドキュメントをまとめてバッチ処理するかどうかに影響されます。いくつかの実践的な調整が、「だいたい動く」と「導入できるほど信頼できる」の差を生みます。
1. 切り抜きではなくラベル全体を撮影する。 受付ドックや発送カウンターで配送ラベルを撮影する際は、ラベル領域全体に少し余白を加えて含めてください。バーコード周囲の余白を切り落とした画像はバーコードのデコードを妨げる可能性があり、角が欠けていると差出人住所やサービス表示が失われることがあります。AIはある程度の遮蔽には対応できますが、4″ × 6″のラベルでは誤差の許容範囲は狭いです。
2. 列名は意味的に付ける。 カスタム列抽出を使う場合 — 欲しいフィールド名を入力すると、AIが意味に基づいて一致するデータを探す仕組み — では、運送会社がフィールドに付けるラベルに合った列名ほど良い結果が得られます。「Tracking Number」はAIが概念を理解するため、どの運送会社のラベルでも機能します。「Sender Name」は「From」よりも信頼性が高いです(「From」は差出人住所ブロックや通関申告書の「From」フィールドに一致する可能性があります)。「Service Level」は「Service:」と「Class」の両方のラベルをカバーします。AIは列名を完全一致ではなく、意味的にドキュメントの概念へマッピングします。
3. ラベルとマニフェストは別々にバッチ処理する。 配送ラベル30枚のバッチは、1枚につき1行の整ったスプレッドシートを生成します — 各行にはその配送の追跡番号、重量、住所、サービスレベルが含まれます。マニフェストのバッチは、すでに配送単位のデータとして構造化された行を生成します。両者を1つのバッチに混ぜると、AIは各ドキュメントを個別に処理しますが、出力行のフィールド密度が異なります(ラベルにはHSコードやコンテナ番号などマニフェスト固有のフィールドが少ない)。より整った結果を得るには、ラベルとマニフェストを別々のバッチで実行してください。バッチファースト処理 — 複数のドキュメントを並行して処理し、1つのテーブルにマージするよう設計されています — は、バッチ内のドキュメントが同じ構造を共有しているときに最も効果を発揮します。
4. バーコードをクロス検証のシグナルとして使う。 ラベルに印刷された追跡番号は、バーコードからデコードされた値と一致するはずです。両方を抽出列として定義すると、同じデータポイントを独立して2回読み取ることになります。もし値が異なれば、そのラベルは人による確認が必要です — 荷物がラベルを貼り替えられたか、バーコードが別の配送のものかもしれません。この自動クロスチェックにより、次のハブで荷物がスキャンされるまで見過ごされていたであろうエラーを検出できます。
5. 行レベルのレビューでマニフェストを処理します。 運送会社のシステム(FedEx Ship Manager、UPS WorldShip、DHL Express)からエクスポートされたマニフェストでは、PDFは通常機械生成で高度に構造化されているため、抽出精度は95%以上です。手作業で作成されたマニフェストや、書式が不統一な小規模運送会社のマニフェストでは、信頼度しきい値を設定してください。AIのフィールドごとの信頼度が80%を下回った行は、データがTMSや運賃照合スプレッドシートに入る前に手動確認のフラグを立てるべきです。
よくある質問
かすれたり薄れたりした感熱印刷の配送ラベルからAIはデータを抽出できますか?
部分的に可能です。印刷されたテキストが人間に判読できる状態であれば、ほとんどのビジョンAIモデルは80~90%の精度で読み取れます。感熱ラベルが薄れてテキストがほとんど見えない場合は、バーコードがまだスキャン可能であれば、それが最も信頼できる代替手段です。テキストとバーコードの両方が劣化している場合、そのラベルは人手によるデータ入力が必要です。ラベルの可読性を最大化するには、高品質の感熱転写リボンを使用し、直射日光や熱源への長時間の露出を避けてください。
送信者・受信者の住所が英語以外の国際配送ラベルでもAI抽出は機能しますか?
はい、ただし精度は文字体系によって異なります。ラテン文字の住所(英語、フランス語、ドイツ語、スペイン語)は印刷ラベルで90~95%認識されます。アジア系文字の住所(中国語、日本語、韓国語)は同じ条件で80~88%に低下します。AIは文字を正しく抽出しますが、CJK文字では文字境界の信頼度が低くなる場合があります。これは視覚的セグメンテーションモデルが主にラテン文字のデータセットで訓練されているためです。送信者住所が英語で受信者住所が日本語といった複数文字体系のラベルは、競合する言語検出ではなく別々の視覚領域として処理されるため、一方が他方に干渉することはありません。
テーブルがページをまたいで続くマルチページのマニフェストをAIは処理できますか?
はい。セマンティックAI抽出は各ページを個別に読み取り、列構造に基づいて結果をマージします。重要な要件は、列ヘッダーがページ間で一貫していることです。ヘッダーが1ページ目にあり後続ページにない場合、AIは1ページ目のレイアウトから列位置を推論します。運送会社のソフトウェアがページ間で列位置をずらす場合(一部の物流印刷システムで知られる問題)、行レベルのずれが発生することがあります。重要なマニフェストでは、各ページの最終行を次ページの最初の行と照合して、ずれを検出してください。
マニフェスト抽出は配送ラベル抽出とどう違いますか?
根本的に異なります。配送ラベルは単一配送のドキュメントで、課題は密度です。つまり、狭く混み合ったスペースからフィールド同士が干渉しないようにテキストを抽出することです。マニフェストは複数配送のドキュメントで、課題は構造です。つまり、複数ページにわたるテーブル境界、行の区切り、列の位置合わせを正確に識別することです。同じAIモデルが両方を処理しますが、抽出戦略は異なります。ラベルはフィールドレベルの精度を優先し、マニフェストは行レベルの整合性を優先します。
AIは配送ラベルからバーコードデータを抽出しますか、それとも別途バーコードスキャナーが必要ですか?
Vision AIはラベル画像からバーコードをデコードできます。Code 128、Code 39、EAN-13、UPC-A、PDF417、QRコードに対応しています。デコードされた値は抽出出力の通常のテキストフィールドとして返されます。つまり、ワークフローで画像を処理できるなら、別途バーコードスキャナーは不要です。ただし、入荷ドックの専用バーコードスキャナーのほうが、すべてのラベルを撮影するより速くて確実です。バーコードのAI抽出は、他の目的(住所や重量の抽出など)で既にラベル画像を取得しており、その副産物としてバーコード値も得たい場合に最適です。
信頼性の高い抽出に必要な画像品質の最低基準は?
印刷された配送ラベルの場合:ラベル領域で少なくとも150 DPI相当、照明が均一で影が最小限であること。マニフェストの場合:表形式の領域で最低200 DPI、ページが平らで綴じ部分が湾曲していないこと。ほとんどのスマートフォンは標準の写真モードでこれらの要件を自動的に満たします。最もよくある品質不良の原因は解像度ではなく、暗い場所で手持ち撮影した写真による手ぶれです。十分な明るさの下で腕を伸ばして安定して撮影した写真は、照明が不均一な高解像度スキャンよりも良い抽出結果をもたらします。
配送ラベルとマニフェストは、物流業務で最も一般的であり、最もフォーマットの変動が大きいドキュメントの2つです。AIはどちらも処理できますが、どこで確実に機能し、どこでまだバックアップが必要かを知ることが、実運用されるワークフローとデモ段階から抜け出せない概念実証との分かれ目になります。
自分のドキュメントで試す