150 évaluations de performance, une seule feuille
Traitement par lots sans copier-coller
Des recherches consolidées par CEB (désormais intégré à Gartner) montrent que les managers consacrent en moyenne 210 heures par an aux activités de gestion de la performance — et les employés 40 heures chacun en plus (SHRM/CEB). Ce qui surprend, c'est la part de ce temps qui ne relève pas du jugement. C'est de l'assemblage : ouvrir les documents d'évaluation, trouver la note en page 2, la copier dans une feuille de synthèse, répéter 150 fois.
Points clés à retenir
- Copier-coller 150 notes d'évaluation dans une feuille de calcul n'est pas un problème de lenteur — les flux de travail mono-document échouent à l'échelle du lot par conception.
- 150 évaluations hétérogènes, trois vocabulaires de notation, une seule échéance de calibration — la traduction mentale à ce volume devient une erreur systématique, pas un jugement.
- Définissez vos noms de colonnes une seule fois et l'IA lit par le sens plutôt que par la position — 150 évaluations atterrissent dans un tableau aligné en une seule passe.
L'écart entre 1 évaluation et 150 n'est pas une question de vitesse. C'est une question de conception.
Tout membre d'une équipe RH peut gérer une seule évaluation de performance. Vous ouvrez le PDF, lisez l'appréciation du manager, notez la note globale et classez le document. Les problèmes commencent lorsque le cycle se termine et que la date de la session de calibration est fixée : soudain, toutes les évaluations de l'entreprise arrivent en même temps, et le même flux de travail minutieux, un document à la fois, devient une file d'attente impossible à terminer.
Dans une enquête SHRM, 54 % des professionnels des RH ont indiqué que leur organisation organise des sessions de calibration formelles — et 69 % ont cité les évaluations incohérentes comme la raison la plus courante pour laquelle les notes sont modifiées lorsque les managers comparent leurs observations (SHRM). La calibration existe précisément pour détecter ces incohérences — mais elle ne peut discuter que de ce qui a été consigné dans le tableur. Si le tableur a été construit à la main, il hérite de toutes les erreurs de transcription et des lignes sautées de ce passage manuel.
C'est là que se situe le véritable écart. Le traitement d'un document unique est une tâche que l'on insère entre deux réunions. Le traitement par lots est un projet avec une échéance, une pile de documents hétérogènes et aucune tolérance pour l'erreur unique qui placerait un employé dans la mauvaise fourchette salariale. Les outils qui gèrent confortablement une seule évaluation n'ont jamais été conçus pour le lot — c'est pourquoi la saison des évaluations par lots se transforme en séances de copier-coller le week-end pour de nombreuses équipes.
Le traitement par lots des évaluations de performance est un problème de conception, pas un problème de saisie. Dès que la pile dépasse ce qu'une personne peut transcrire sans erreurs de fatigue, c'est le flux de travail lui-même — pas le transcripteur — qui doit changer.
Ce qu'un cycle d'évaluation vous livre concrètement
Avant de pouvoir traiter quoi que ce soit par lots, il est utile de savoir ce qu'un cycle terminé produit concrètement. Même les entreprises qui utilisent un logiciel de performance ont rarement un bouton unique « tout exporter » qui génère un tableau prêt pour la calibration. En pratique, les documents arrivent sous au moins quatre formes, généralement mélangées :
- PDF par évaluation provenant de la plateforme. Workday, Lattice, 15Five et BambooHR permettent tous des exports d'évaluation par employé — ce qui signifie un dossier de PDF un-par-personne, souvent par lots de cinquante ou plus, livré la semaine précédant la calibration.
- Exportations brutes de données de la plateforme. L'export alternatif est un CSV question par question qui doit encore être remodelé avant de correspondre à votre format de calibration.
- Formulaires Word et Google Docs. Les équipes de taille moyenne utilisent encore des modèles partagés pour leurs cycles : les managers remplissent un document, le signent et le renvoient par e-mail. Les RH se retrouvent avec une boîte de réception de pièces jointes, chacune dans un état d'édition légèrement différent.
- Feuilles d'évaluation scannées. Toujours une réalité dans la fabrication, le commerce de détail, la santé et les opérations terrain — un formulaire papier avec l'échelle d'évaluation du manager remplie à la main, scanné au bureau.
- Preuves issues des conversations Slack et Teams. Les éloges quotidiens et les notes de coaching qu'un manager envoie entre les cycles formels n'atteignent jamais le dossier d'évaluation, mais ils justifient souvent la note une fois la calibration commencée. Ces captures d'écran de feedback du manager doivent être intégrées au tableur aux côtés des documents d'évaluation, sinon la note n'a aucune preuve derrière elle.
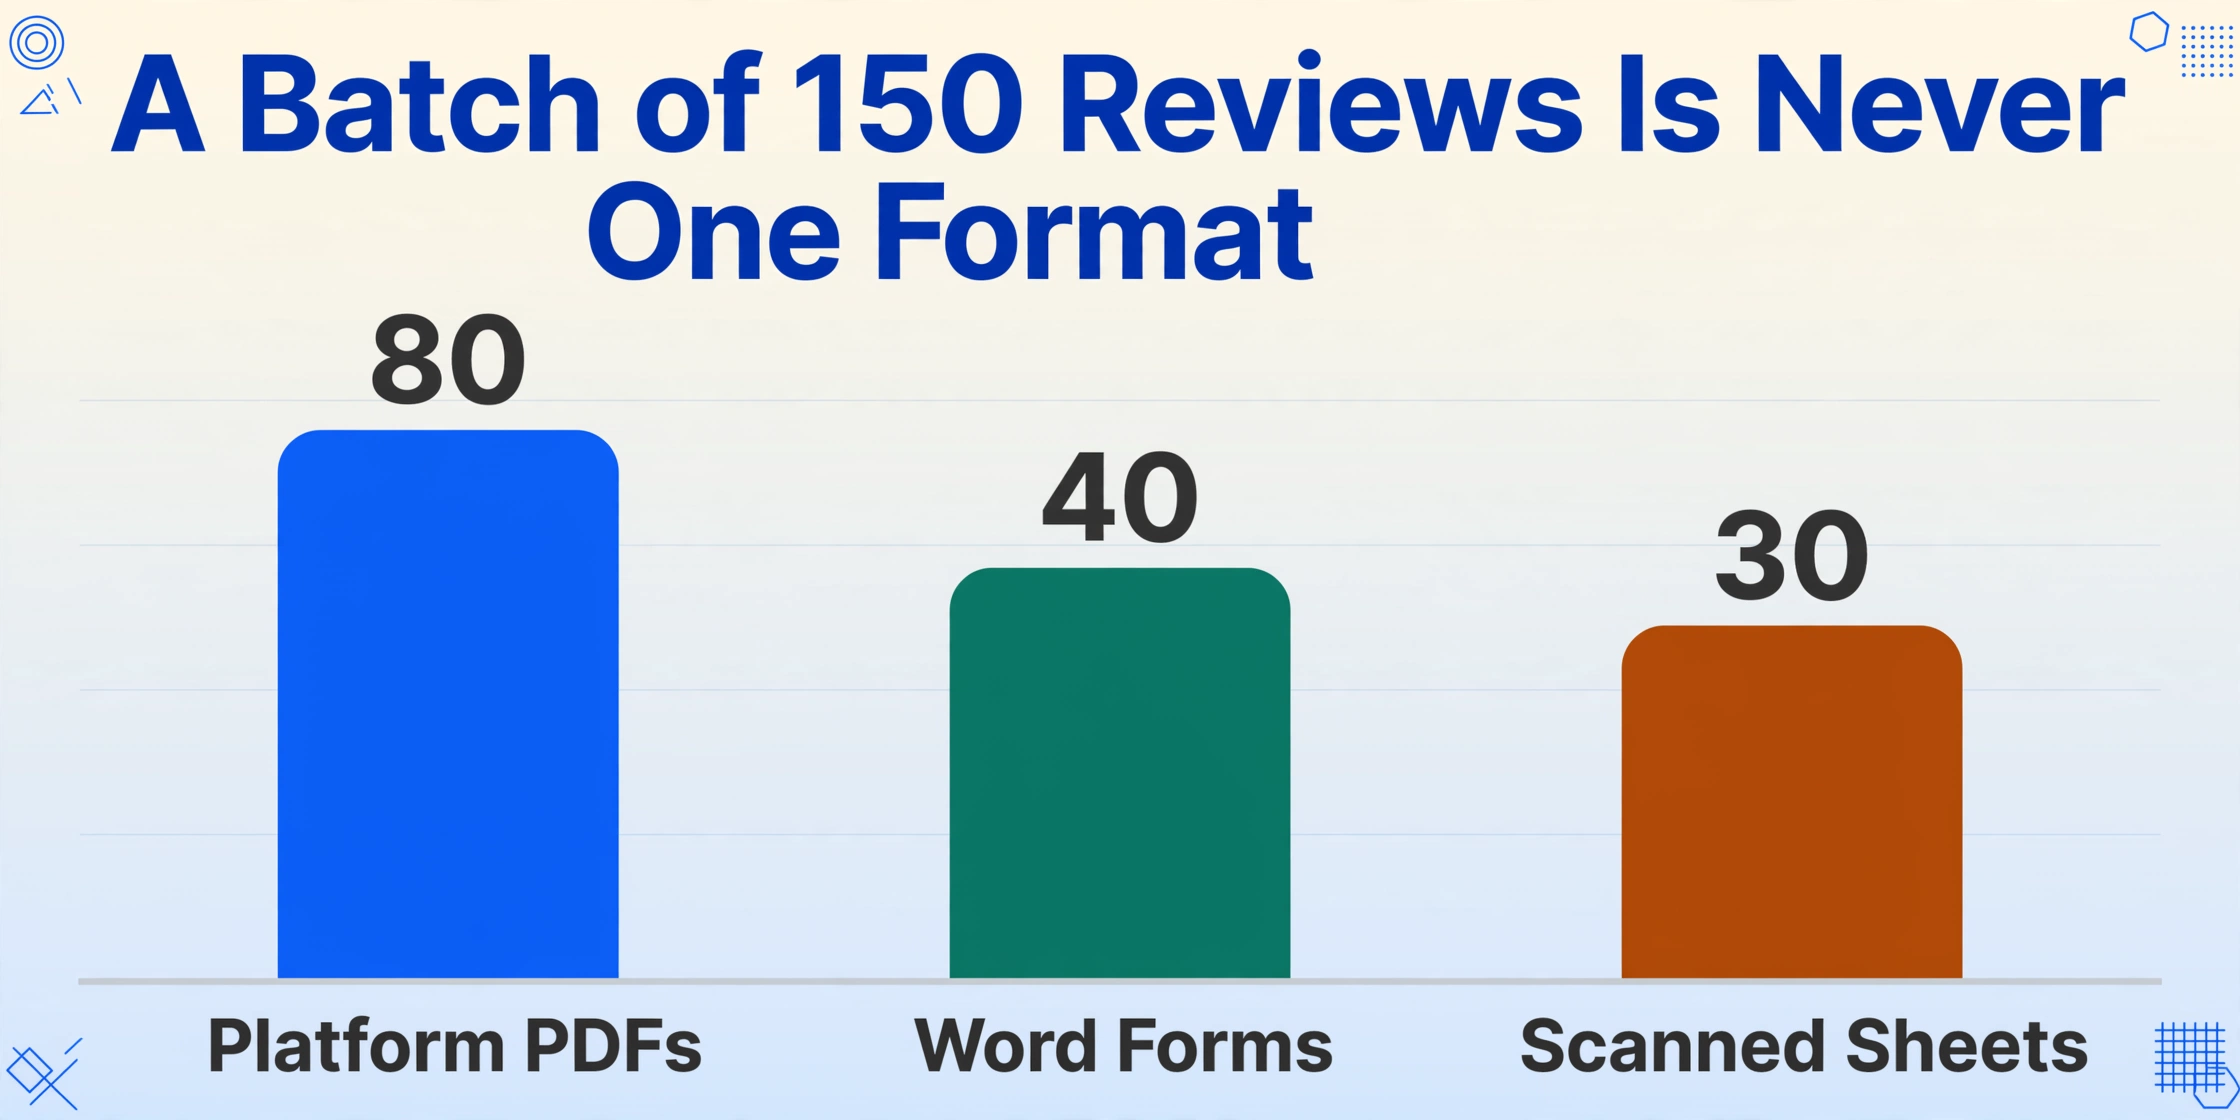
Le mélange est le problème. Un lot de 150 évaluations peut contenir 80 PDF de plateforme, 40 formulaires Word et 30 scans — et ils ne partagent ni mise en page, ni ordre des champs, ni même un vocabulaire commun pour la même note (« 4 », « Dépasse les attentes » et une coche dans la case au-dessus de « Répond aux attentes » signifient tous des choses différentes selon les formulaires). Un flux de travail conçu pour un format ne survit pas au contact de trois.
Les trois éléments qui cassent à l'échelle du lot
Le traitement par lots n'est pas un traitement de document unique effectué 150 fois. C'est une opération différente, avec des modes de défaillance qui n'existent pas quand la pile ne fait qu'un PDF d'épaisseur. Trois d'entre eux décident si la saison des évaluations fonctionne ou s'effondre.
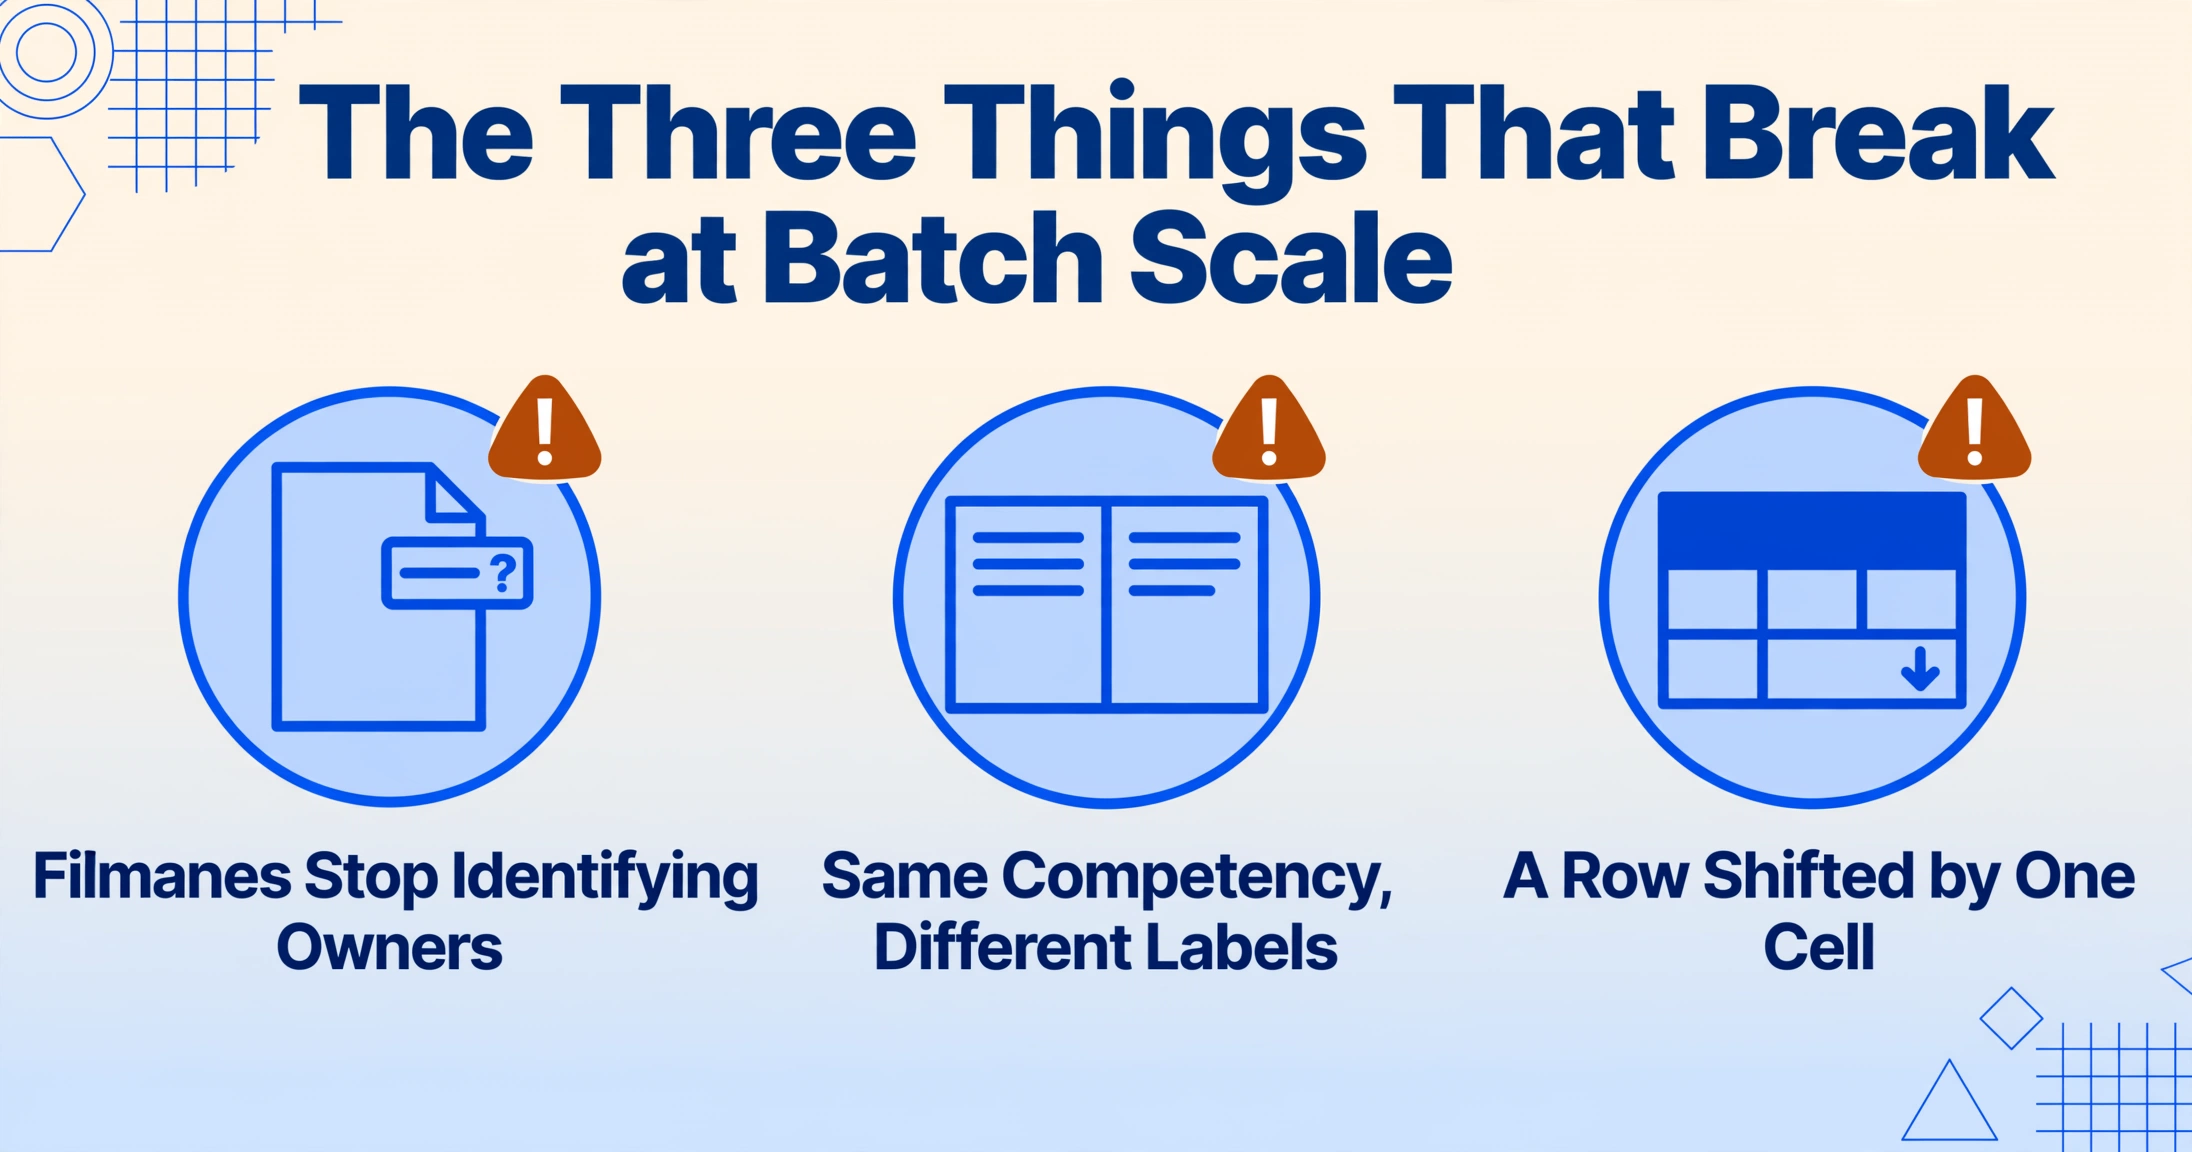
1. Le problème de nommage. Quand trois évaluations arrivent, vous pouvez associer « Chen_2025_Review.pdf » à son propriétaire sans réfléchir. Quand 150 arrivent dans un dossier Drive partagé et que la moitié des noms de fichiers indiquent « Scan_2025-12-04_0071.pdf » ou « Performance Review (1) (2) FINAL.pdf », le mapping mental s'effondre. Vous ouvrez des fichiers juste pour les identifier — et chaque fichier ouvert pour vérifier un nom est du temps non consacré à l'assemblage du tableau.
2. Le problème de variance structurelle. Une entreprise a rarement un seul modèle d'évaluation. Les managers de différents départements ajoutent des sections, sautent l'auto-évaluation, inscrivent une note dans la zone de commentaires au lieu du champ prévu, ou utilisent « Communication & Collaboration » tandis qu'un autre utilise « Compétences interpersonnelles » pour la même compétence. À l'échelle d'un document unique, vous traduisez ces différences mentalement. À l'échelle du lot, la traduction mentale devient une erreur systématique.
3. Le problème de consolidation. Même avec chaque évaluation extraite proprement, vous avez maintenant 150 ensembles de valeurs — et ce dont vous avez besoin, c'est d'un seul tableau, une ligne par employé, des colonnes alignées. L'étape de fusion, où 150 extractions deviennent une seule feuille de calcul avec des en-têtes correspondants, est l'endroit où les flux de travail par lots sont abandonnés au profit d'un repli manuel. C'est aussi là que se cachent les erreurs silencieuses : une ligne décalée d'une cellule, une colonne collée sous le mauvais en-tête.
Ces trois problèmes expliquent pourquoi la réponse à la saison des évaluations n'est pas « taper plus vite ». C'est un flux de travail où les documents eux-mêmes deviennent l'entrée et le tableau aligné la sortie — sans transcription intermédiaire qui pourrait dériver.
Comment une définition de colonne transforme 150 documents en une seule feuille
Le mécanisme qui gère les trois obstacles du traitement par lots à la fois est l'Extraction de colonnes personnalisées : vous saisissez les noms de colonnes souhaités — « Nom de l'employé », « Note globale », « Score de communication », « Recommandation de promotion » — et l'IA localise chaque valeur sur chaque document en comprenant ce que le champ signifie, et non où il se trouve sur la page. Les noms de colonnes que vous saisissez deviennent les en-têtes de la feuille de calcul finale, donc le résultat correspond à votre format de calibration par construction.
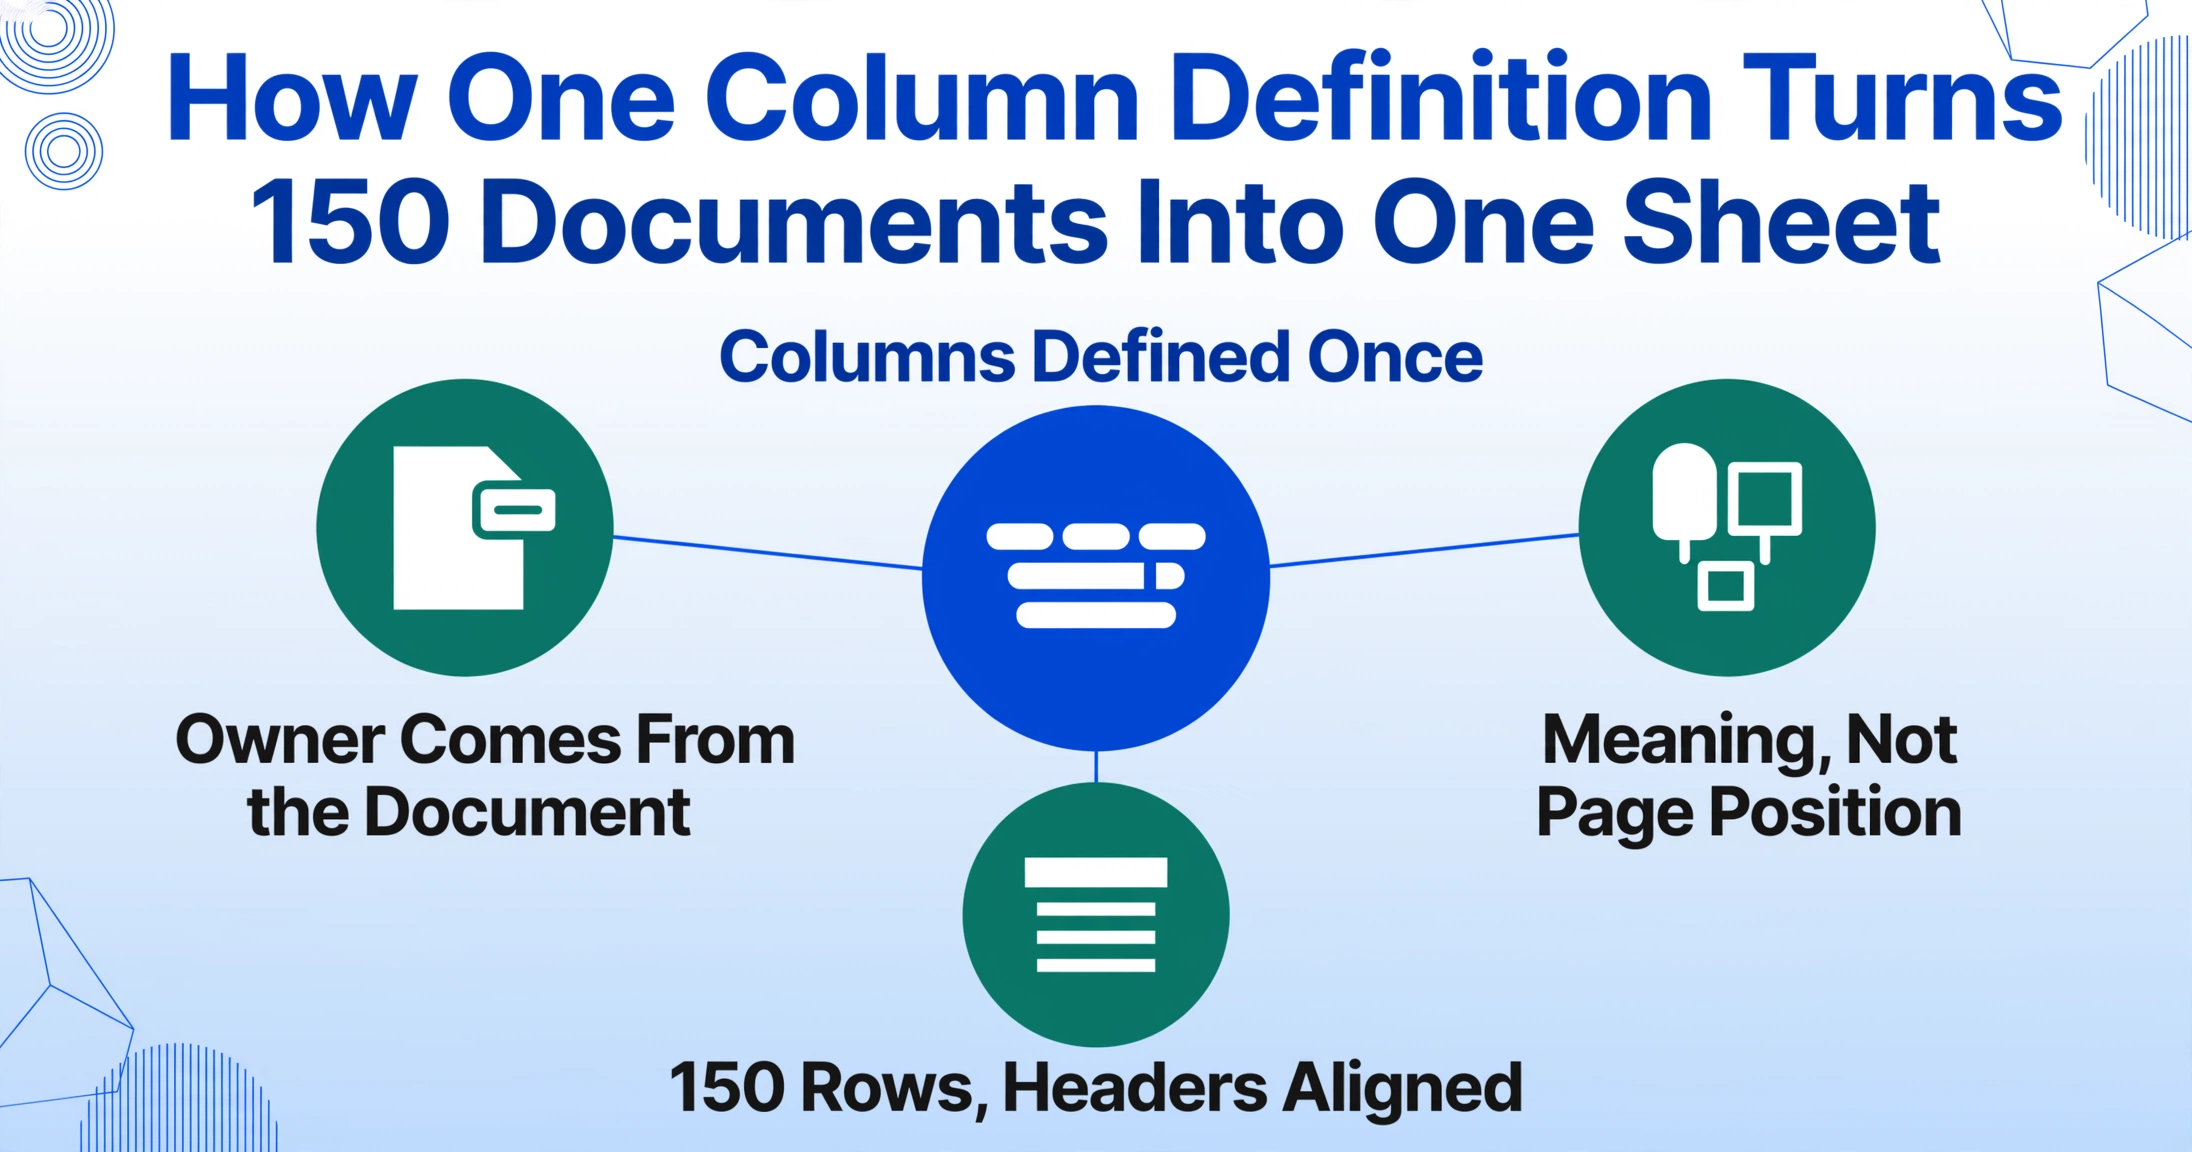
Comme la définition de colonne est la même pour les 150 documents, le problème de nommage disparaît : chaque ligne de sortie contient le nom de l'employé comme champ extrait, vous ne dépendez donc jamais des noms de fichiers pour la traçabilité. Le problème de variance structurelle disparaît également : qu'une évaluation indique « Communication » ou « Compétences interpersonnelles », l'IA mappe les deux vers la colonne nommée « Score de communication » en reconnaissant le sens. Et le problème de consolidation ne se pose jamais — un lot, un tableau, 150 lignes, toutes les colonnes alignées, car elles ont été définies une fois au départ.
Vous pouvez même ajouter des colonnes que les formulaires n'impriment jamais. Une colonne calculée comme « Score composite (Communication + Collaboration + Productivité + Qualité + Leadership ÷ 5) » permet à l'IA de calculer la moyenne des scores de compétences pendant l'extraction plutôt qu'après. Une colonne inférée comme « Niveau de performance (options : Élevé/Fort/En développement/À améliorer) » classe chaque employé selon votre grille d'évaluation pendant le traitement du lot. La feuille arrive avec le travail d'analyse déjà fait — aucune formule, aucune seconde passe dans Excel.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Si vous souhaitez la liste complète des champs et une procédure pas à pas pour créer la feuille de calibration — y compris les colonnes à extraire et pourquoi — le guide d'extraction des évaluations de performance pour la calibration des talents couvre le processus document par document. Cet article se concentre sur ce qui change lorsque vous l'exécutez à 150.
Que deviennent les exceptions dans un lot
Dans un lot de 150 documents, « le document moyen » est une fiction. Certaines évaluations n'auront pas d'auto-évaluation. Certains managers auront laissé la recommandation de promotion vide. Quelques feuilles scannées auront une note entourée au stylo que le scanner a capturée de biais. Les flux de travail par lots réussissent ou échouent selon la façon dont ils traitent ces exceptions — voici donc ce qui se passe réellement avec chacune d'elles.
Les champs manquants restent vides, ils ne sont pas inventés. Si une évaluation ne contient pas de score de compétence, cette cellule reste vide dans la sortie — l'IA n'invente pas un nombre pour la remplir. Une cellule vide dans la feuille est un signal honnête pour la conversation de calibration (« ce manager n'a pas noté la collaboration ») ; une valeur inventée corromprait silencieusement la distribution.
La traçabilité provient des champs extraits, pas des noms de fichiers. Parce que « Nom de l'employé » (et idéalement « ID employé ») sont des colonnes d'extraction, chaque ligne est traçable jusqu'à son document, quel que soit le nom du fichier. Lorsqu'un manager conteste une note dans la salle, vous pouvez ouvrir le document source en quelques secondes au lieu de chercher dans un dossier.
Vous vérifiez les cas risqués, pas les 150. En Mode Révision, survoler n'importe quelle cellule extraite met en évidence exactement d'où vient cette valeur sur l'image d'origine — donc vérifier par sondage les scores qui alimentent les décisions salariales prend des minutes, pas des heures. La même couche de vérification visuelle permet à une équipe RH de valider un lot sans relire chaque document de bout en bout.
Une autre chose à savoir sur les exceptions à l'échelle d'un lot : les échelles de notation diffèrent selon les départements. Une échelle de 1 à 5 en ingénierie et une échelle de 1 à 10 en vente produisent des nombres qui ne peuvent pas être comparés directement. Normalisez la colonne Note globale une fois les données dans la feuille — une passe de recherche-remplacement ou de formule, pas une session de ressaisie. La même normalisation s'applique si votre cycle mélange « 4 » avec « Dépasse les attentes » ; mappez les deux sur l'échelle numérique de votre grille après l'extraction.
De 150 lignes à un ordre du jour de calibration
Le résultat du lot n'est pas la livraison finale — c'est la session de calibration qui l'est. Mais la feuille que vous apportez dans la salle détermine si cette session débat de preuves ou d'impressions. Trois vérifications transforment 150 lignes alignées en un ordre du jour exploitable.
Vérifiez la distribution par rapport à votre courbe cible. Filtrez par Niveau de performance et comptez combien d'employés se trouvent dans chaque tranche. Une entreprise où 80 % de l'équipe est « Top » n'est pas une entreprise performante — c'est une entreprise non calibrée, et c'est la première chose que la session devrait aborder.
Faites un tableau croisé par manager pour révéler la clémence et la sévérité. Insérez un tableau croisé dynamique avec Manager en lignes et Moyenne du Score composite en valeurs, puis comparez la moyenne d'équipe de chaque manager à la moyenne de l'entreprise. Le manager à 4,6 contre une moyenne d'entreprise de 3,9 est votre point de départ de conversation de calibration — non pas parce que son équipe est mauvaise, mais parce que son échelle est différente.
Préparez le dossier de pré-lecture avant que quiconque n'entre. Filtrez la feuille pour ne garder que les employés que chaque session couvrira et partagez les lignes pertinentes à l'avance — notes, points forts des commentaires, recommandations de promotion. Les managers arrivent en ayant déjà vu les preuves, ce qui est précisément la dynamique de preuves documentées qui maintient l'équité des sessions de calibration plutôt qu'une dynamique fondée sur les impressions.
Ce modèle de lot s'étend à l'ensemble de la pile documentaire RH. Le même flux de travail un-lot-vers-un-tableau qui consolide la saison d'évaluation gère également les lettres d'offre et les contrats vers une base de données employés lorsque les promotions deviennent des embauches, les formulaires d'intégration vers les dossiers employés pour les nouveaux arrivants, et les données de CV vers des feuilles de calcul candidats lorsque le plan d'effectifs appelle au recrutement. Définissez les colonnes une fois ; chaque type de document suit le même chemin.
FAQ
Puis-je mélanger des PDF de plateforme, des formulaires Word et des feuilles scannées dans un même lot ?
Oui. Le traitement par lots ne nécessite pas de tri préalable par format ou mise en page. Vous définissez vos noms de colonnes une seule fois — Note globale, Score de communication, Recommandation de promotion — et l'IA lit chaque type de document en comprenant la signification des champs. Les PDF de plateforme, les formulaires Word et les scans passent tous par le même lot et aboutissent dans le même tableau aligné. Les PDF multipages sont découpés page par page et associés automatiquement à la bonne évaluation.
Comment puis-je relier une ligne au bon employé lorsque les noms de fichiers sont simplement « Scan_001.pdf » ?
Incluez « Nom de l'employé » (et ID employé, si vos formulaires en impriment un) comme colonnes d'extraction. Le nom est extrait du document lui-même et apparaît dans la ligne de sortie, de sorte que la traçabilité ne dépend jamais des noms de fichiers. Si vous souhaitez une seconde couche de redondance, renommez les fichiers avant le téléversement — mais en pratique, le champ de nom extrait suffit, car les évaluations impriment presque toujours le nom de l'employé bien en évidence sur la première page.
Que se passe-t-il lorsqu'une évaluation ne contient pas de score ou de section ?
Le champ manquant reste vide dans la sortie — l'IA ne devine pas. Une cellule vide est un signal honnête que vous pouvez traiter lors de la calibration (« ce manager n'a pas noté la collaboration ») plutôt qu'une erreur silencieuse. Si vous souhaitez que la feuille signale ces cas, ajoutez une colonne inférée comme « Exhaustivité de l'évaluation (options : Complète/Partielle) » et l'IA marquera chaque ligne lors de l'extraction.
Différents services utilisent différentes échelles de notation — puis-je quand même les comparer dans une seule feuille ?
L'extraction capture chaque note telle qu'imprimée sur le formulaire, dans sa propre colonne. Pour comparer entre services, normalisez la colonne Note globale une fois les données extraites — un simple rechercher-remplacer ou une formule convertit l'échelle de vente de 1 à 10 vers votre grille de 1 à 5. La même normalisation convertit les notes textuelles comme « Dépasse les attentes » en valeurs numériques. C'est une passe de cinq minutes sur une colonne, pas une session de ressaisie sur 150 lignes.
Les évaluations doivent être calibrées vendredi — combien de temps prend un lot complet ?
Le traitement par lots s'exécute en parallèle : des dizaines à des centaines de documents sont traités ensemble et fusionnés en un seul tableau de sortie, généralement en quelques minutes à quelques heures selon le volume et la longueur des documents. Le goulot d'étranglement pratique n'est pas l'extraction — c'est la passe de vérification ponctuelle qui suit, que le Mode Révision réduit à quelques minutes en vous permettant de vérifier les valeurs extraites par rapport aux images sources au lieu de relire chaque document.
Les données de performance des employés sont-elles confidentielles ?
Les fichiers sont traités de manière sécurisée et automatiquement supprimés après une période de conservation configurable ; aucune donnée d'entraînement n'est conservée à partir des téléversements des clients. La feuille de calcul extraite est un fichier que vous téléchargez et contrôlez, ce qui simplifie les demandes d'accès ou de suppression.
La Feuille Est le Point de Départ, Pas le Livrable
Il y a un changement discret lorsqu'une équipe RH cesse de transcrire les évaluations et commence à les traiter par lots. Les 8 à 10 heures qui disparaissaient dans le copier-coller réapparaissent sous une autre forme : du temps réellement consacré à lire la distribution, à remarquer quelle équipe de quel manager affiche une moyenne d'un point complet au-dessus de l'entreprise, et à préparer les preuves qui rendent la conversation de calibration productive. La saisie n'a jamais été le travail. La conversation l'était — et elle ne peut être aussi bonne que les données que vous apportez dans la salle.
Un lot, une feuille, chaque note et chaque commentaire en place — c'est ce qui fait que la saison des évaluations ressemble à une saison plutôt qu'à un siège. Téléversez une poignée de vos fichiers d'évaluation réels et regardez 150 documents devenir un tableau de calibration en une seule passe.