150件の業績評価を1枚のシートに
コピペ不要のバッチ処理
CEB(現在はガートナーの一部)を通じてまとめられた調査によると、マネージャーは業績管理業務に年間平均210時間を費やしており、従業員もさらに各自40時間を費やしています(SHRM/CEB)。驚くべきは、その時間の多くが判断ではなく「組み立て作業」だということです。評価ドキュメントを開き、2ページ目の評価を見つけ、サマリーシートにコピーし、それを150回繰り返す——これが現実です。
重要ポイント
- 150件の評価スコアをスプレッドシートにコピペするのは「遅さ」の問題ではない——単一ドキュメントのワークフローは、そもそもバッチ規模になると破綻する設計になっている。
- 150件の異種レビュー、3種類の評価語彙、1つのキャリブレーション期限——そのボリュームでの機械的な変換は、判断ではなく体系的なエラーになる。
- 列名を一度定義すれば、AIが位置ではなく意味で読み取る——150件の評価が1回のパスで1つの整列したテーブルに集約される。
1件のレビューと150件のレビューの差は、スピードではなく設計にある
ピープルチームの誰もが、1件の業績評価なら処理できます。PDFを開き、マネージャーの評価を読み、総合評価を記録して、ファイルに保存する。問題が始まるのは、サイクルが終了し、キャリブレーションセッションの日付が確定したときです。突然、会社全体のレビューが一度に届き、これまで慎重に1件ずつ行っていたワークフローが、完了できないキューに変わってしまいます。
SHRMの調査によると、HRプロフェッショナルの54%が自社で正式なキャリブレーションセッションを実施していると回答し、69%がマネージャー同士が評価を突き合わせた際に評価が変更される最も一般的な理由として「評価の不整合」を挙げています(SHRM)。キャリブレーションはそうした不整合を検出するために存在しますが、議論できるのはスプレッドシートに載せられた情報だけです。そのスプレッドシート自体が手作業で作られたものであれば、手入力による転記ミスや行の飛ばしがそのまま引き継がれます。
これこそが本当のギャップです。単一ドキュメントの処理は、会議の合間に挟み込めるタスクです。一方、バッチ処理は締め切りがあり、異種混在のドキュメントの山があり、従業員を誤った給与帯に落とすような1件のミスも許されないプロジェクトです。1件のレビューを快適に処理できるツールは、そもそもバッチ用に設計されていません。だからこそ、多くのチームでバッチレビューシーズンが週末のコピー&ペースト作業に陥ってしまうのです。
バッチ業績評価処理は、タイピングの問題ではなく設計の問題です。 1人が疲労によるミスなしで転記できる量を超えた瞬間、変わるべきなのはタイピストではなく、ワークフロー自体です。
レビューサイクルが実際に生み出すもの
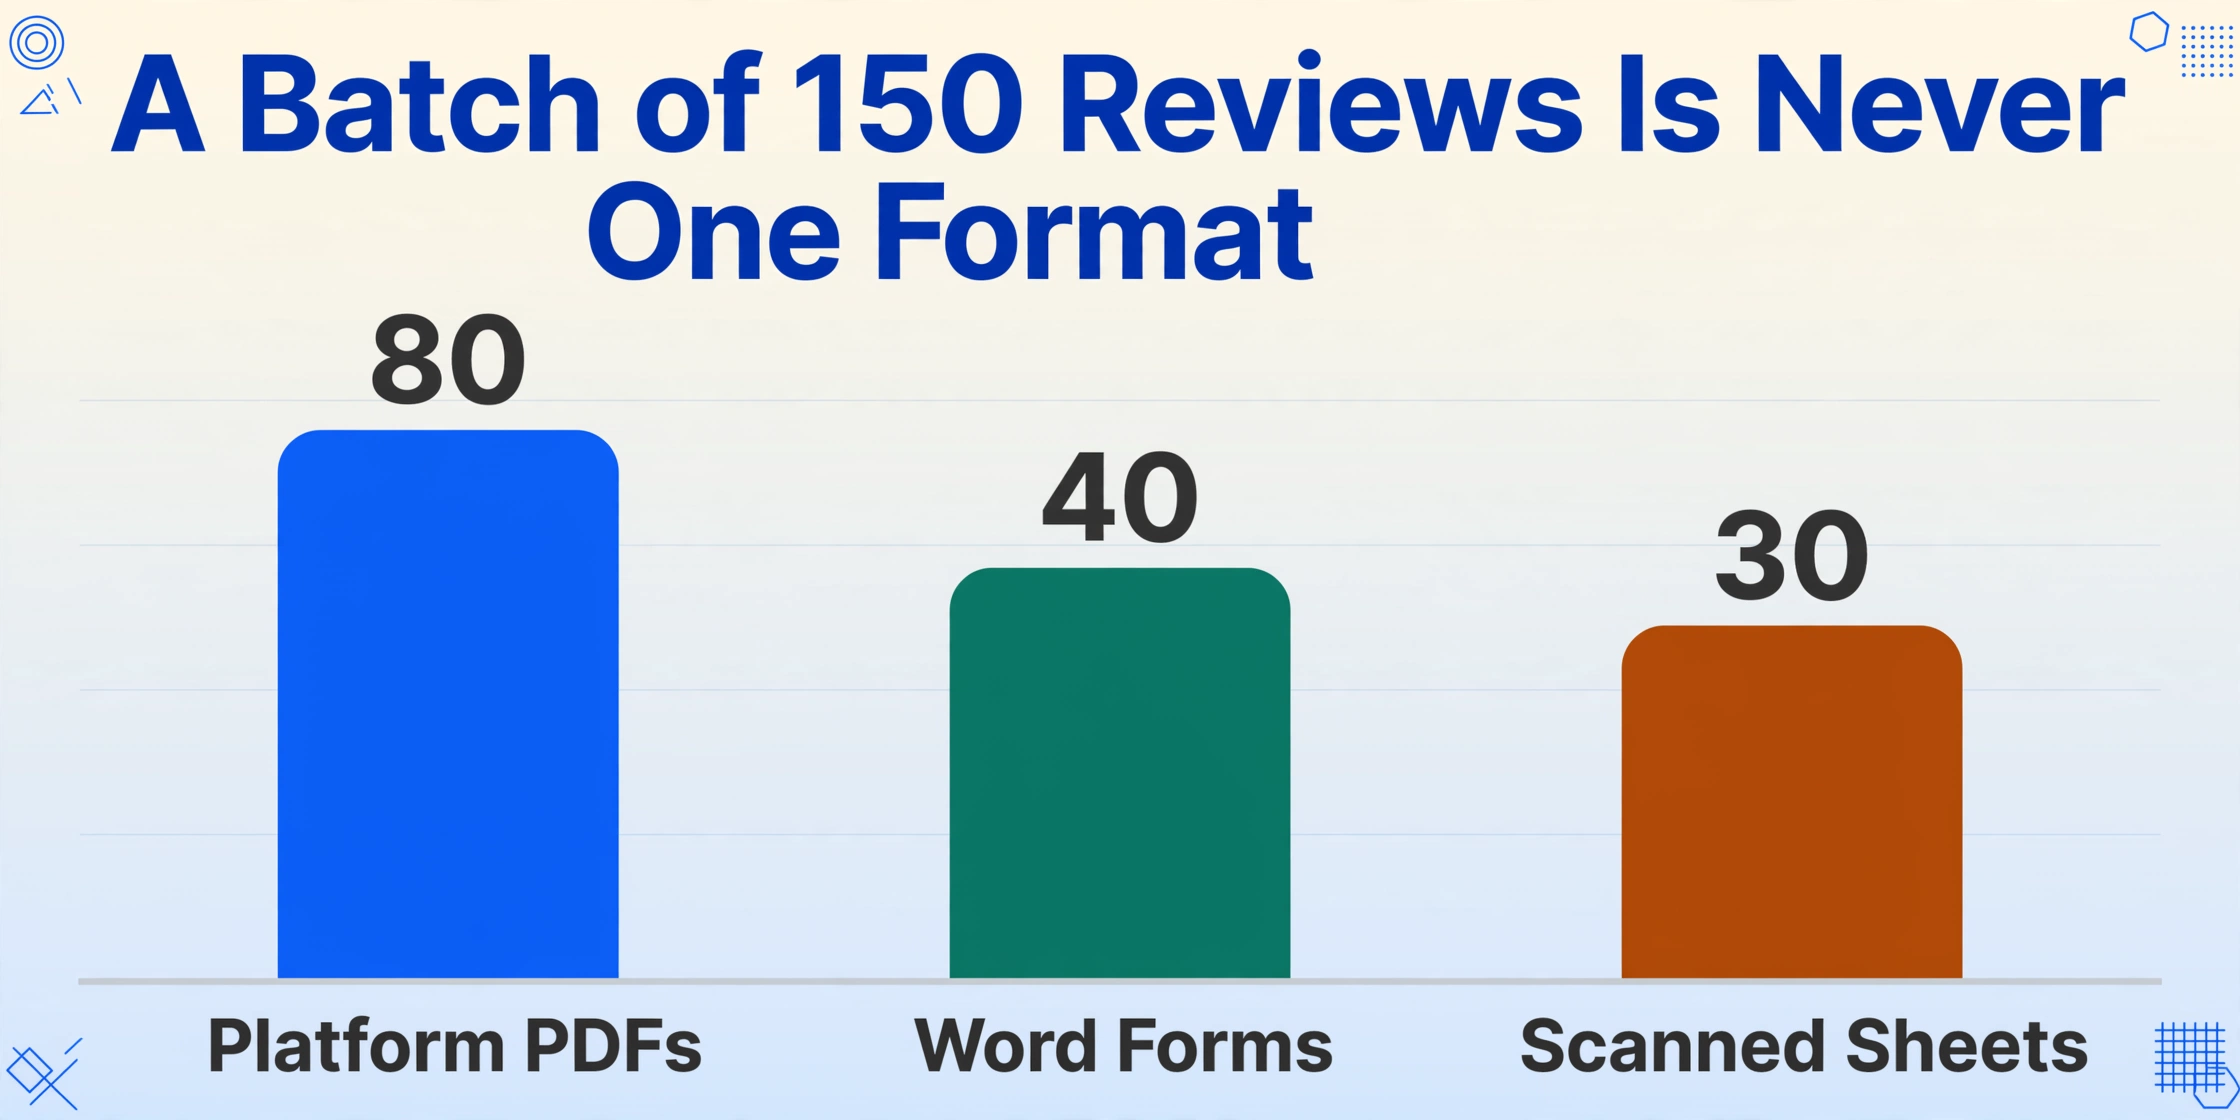
バッチ処理を始める前に、完了したサイクルが実際に何を生み出すかを知っておくと役立ちます。業績管理ソフトウェアを導入している企業でも、キャリブレーション対応のテーブルを出力する「すべてエクスポート」ボタンが1つあるケースはまれです。実際には、ドキュメントは少なくとも4つの形式で届き、通常は混在しています:
- プラットフォームからのレビューごとのPDF。 Workday、Lattice、15Five、BambooHRはいずれも従業員ごとのレビューエクスポートを許可しています。つまり、キャリブレーションの1週間前に届く、1人1ファイルのPDFフォルダ(多くの場合50件以上)が生成されます。
- プラットフォームの生データダンプ。 もう1つのエクスポート方法は、質問ごとのCSVですが、キャリブレーション形式に合わせるには再整形が必要です。
- WordおよびGoogleドキュメントのフォーム。 中規模チームでは今でも共有テンプレートでサイクルを運用しています。マネージャーがドキュメントに記入し、署名してメールで返送する。HRの受信トレイには、それぞれ編集状態が微妙に異なる添付ファイルが溜まります。
- スキャンされた評価シート。 製造業、小売、ヘルスケア、現場業務では今でも現実に存在します。マネージャーの評価尺度に手書きで記入された紙のフォームを、オフィスでスキャンしたものです。
- SlackやTeamsからのチャット証跡。 正式なサイクルの合間にマネージャーが送る日々の称賛やコーチングメモは、レビューファイルには届きません。しかし、キャリブレーションが始まると、それらが評価の根拠になることがよくあります。そうしたマネージャーフィードバックのスクリーンショットは、レビュードキュメントと一緒にシートに取り込まないと、評価の裏付けがなくなってしまいます。
問題はその混在にあります。150件のレビューのバッチには、80件のプラットフォームPDF、40件のWordフォーム、30件のスキャンが含まれているかもしれません。そして、それらはレイアウトも、フィールドの順序も、同じ評価に対する用語さえも共有していません(「4」、「期待を超える」、「期待を満たす」の上のボックスにチェックマーク、これらはすべてフォームによって異なる意味を持ちます)。1つのフォーマット用に作られたワークフローは、3つのフォーマットが混在すると機能しません。
バッチ規模で破綻する3つの問題
バッチ処理は、単一ドキュメント処理を150回行うことではありません。それは、1枚のPDFだけのスタックには存在しない失敗モードを持つ、異なる操作です。そのうちの3つが、レビューシーズンがうまくいくか、崩壊するかを左右します。
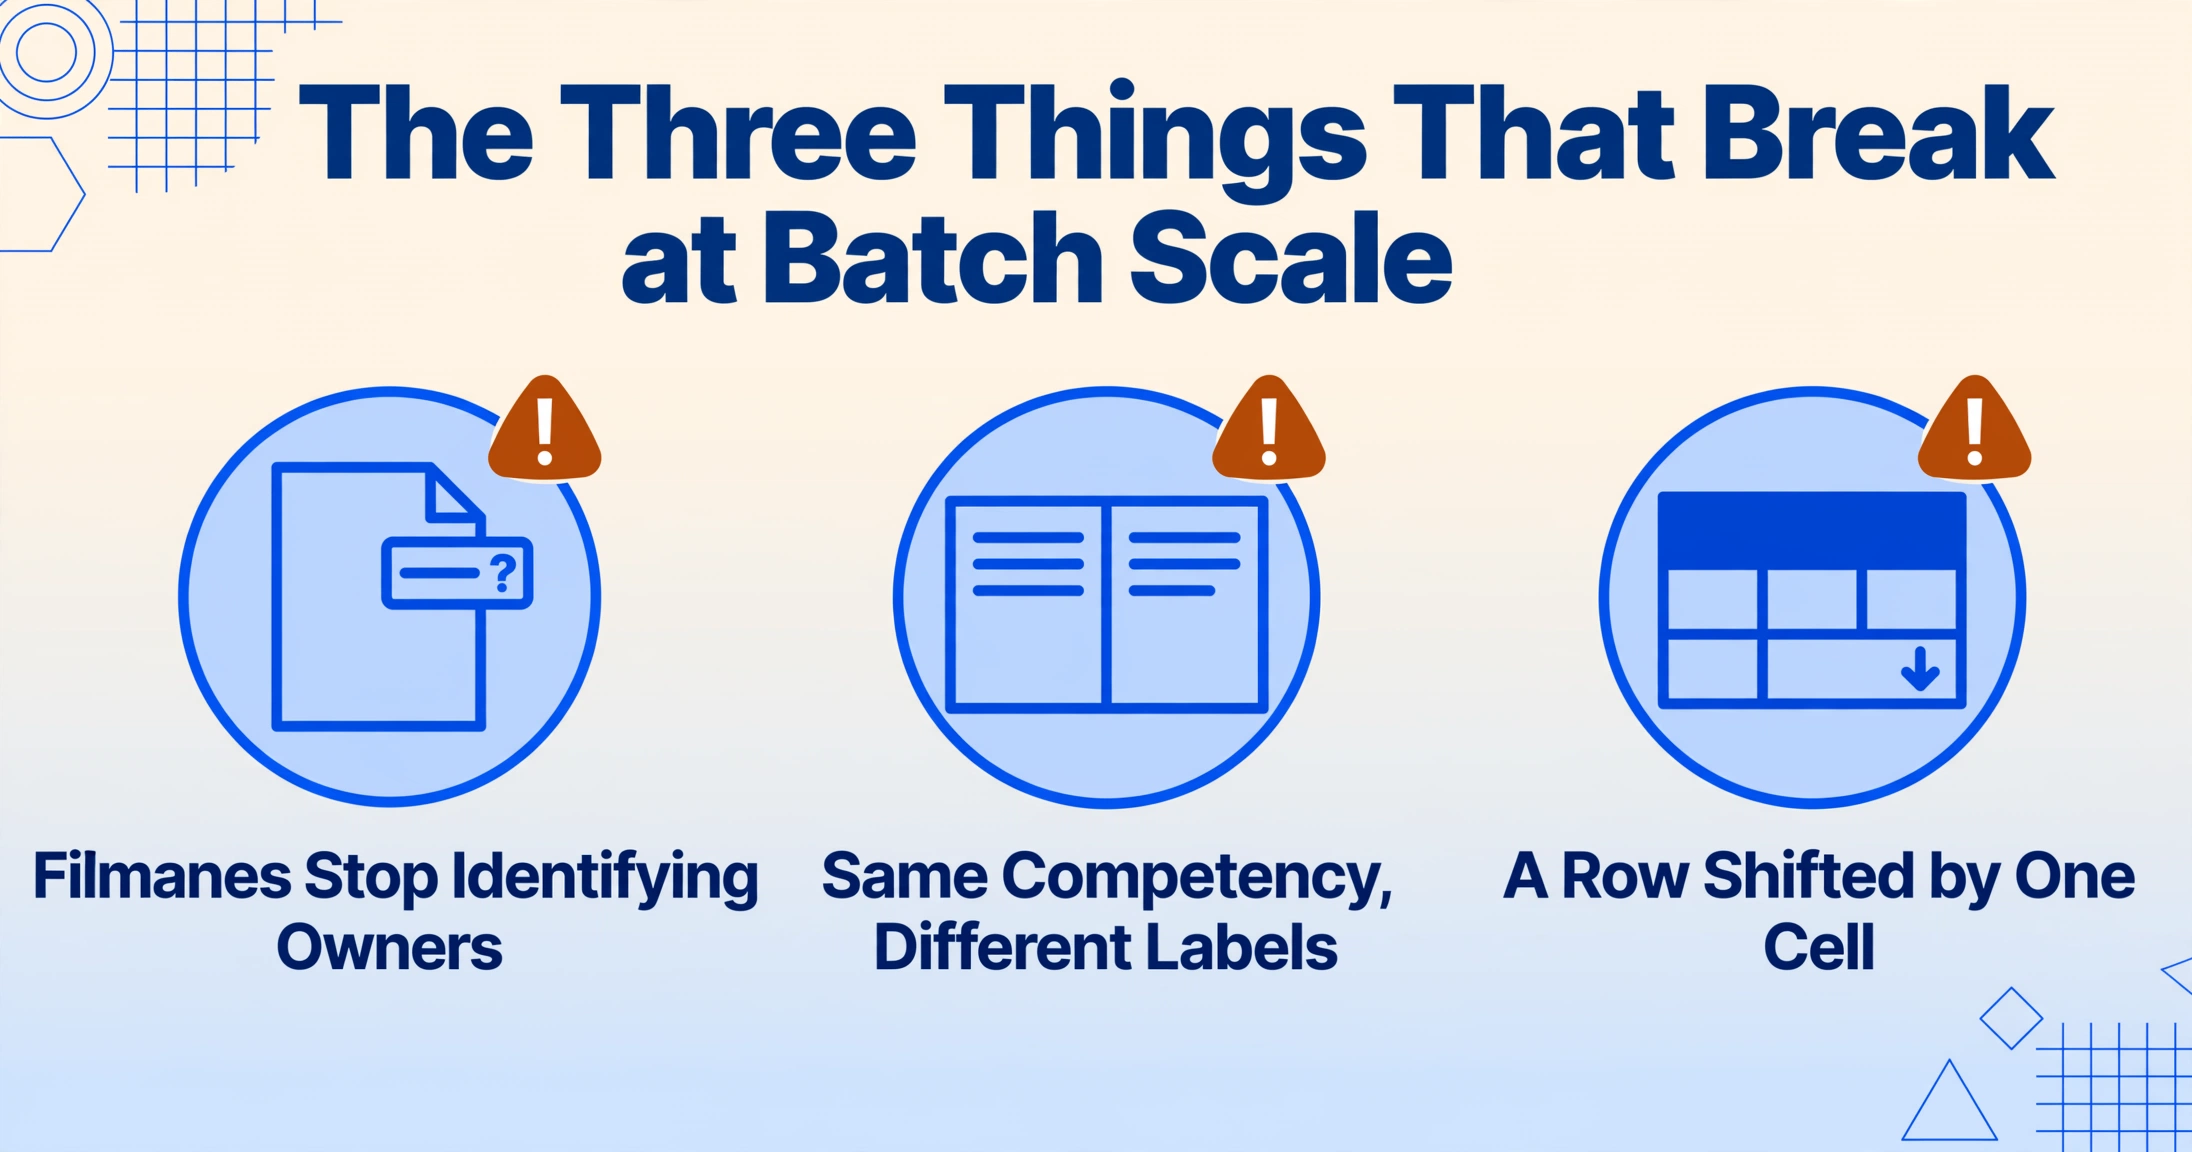
1. 命名の問題。レビューが3件届いた場合、「Chen_2025_Review.pdf」をその所有者にマッピングすることは、考えるまでもなくできます。しかし、150件が共有Driveフォルダに置かれ、ファイル名の半分が「Scan_2025-12-04_0071.pdf」や「Performance Review (1) (2) FINAL.pdf」のような場合、頭の中でのマッピングは崩壊します。識別するためだけにファイルを開くことになり、名前を確認するために開くすべてのファイルは、シートを組み立てる時間を奪います。
2. 構造のばらつきの問題。単一の会社に1つのレビューテンプレートしかないことは稀です。異なる部門のマネージャーはセクションを追加したり、自己評価をスキップしたり、評価フィールドではなくコメント欄に評価を書いたり、同じコンピテンシーに対して一方は「コミュニケーションとコラボレーション」を使い、もう一方は「対人スキル」を使ったりします。単一ドキュメントの規模では、これらの違いを頭の中で変換します。バッチ規模では、頭の中での変換は体系的なエラーになります。
3. 統合の問題。すべてのレビューがきれいに抽出されたとしても、150セットの値が手元にあり、必要なのは1つのテーブル、従業員ごとに1行、列が揃っていることです。150件の抽出結果が一致するヘッダーを持つ単一のスプレッドシートになるマージステップは、バッチワークフローが手動フォールバックに取って代わられる場所です。また、静かなエラーが潜む場所でもあります。1セルずれた行、間違ったヘッダーの下に貼り付けられた列などです。
これら3つの問題が、レビューシーズンへの答えが「より速くタイピングする」ことではない理由です。答えは、ドキュメント自体が入力となり、整列されたテーブルが出力となるワークフローです。つまり、ドリフトする中間の転記がないということです。
1つの列定義が150件のドキュメントを1枚のシートに変える仕組み
3つのバッチ処理の課題を同時に解決する仕組みがカスタム列抽出です。「従業員名」「総合評価」「コミュニケーションスコア」「昇進推薦」など、必要な列名を入力するだけで、AIが各ドキュメントの値を、ページ上の位置ではなくフィールドの意味を理解して特定します。入力した列名が最終スプレッドシートのヘッダーになるため、出力はキャリブレーション形式に最初から一致します。
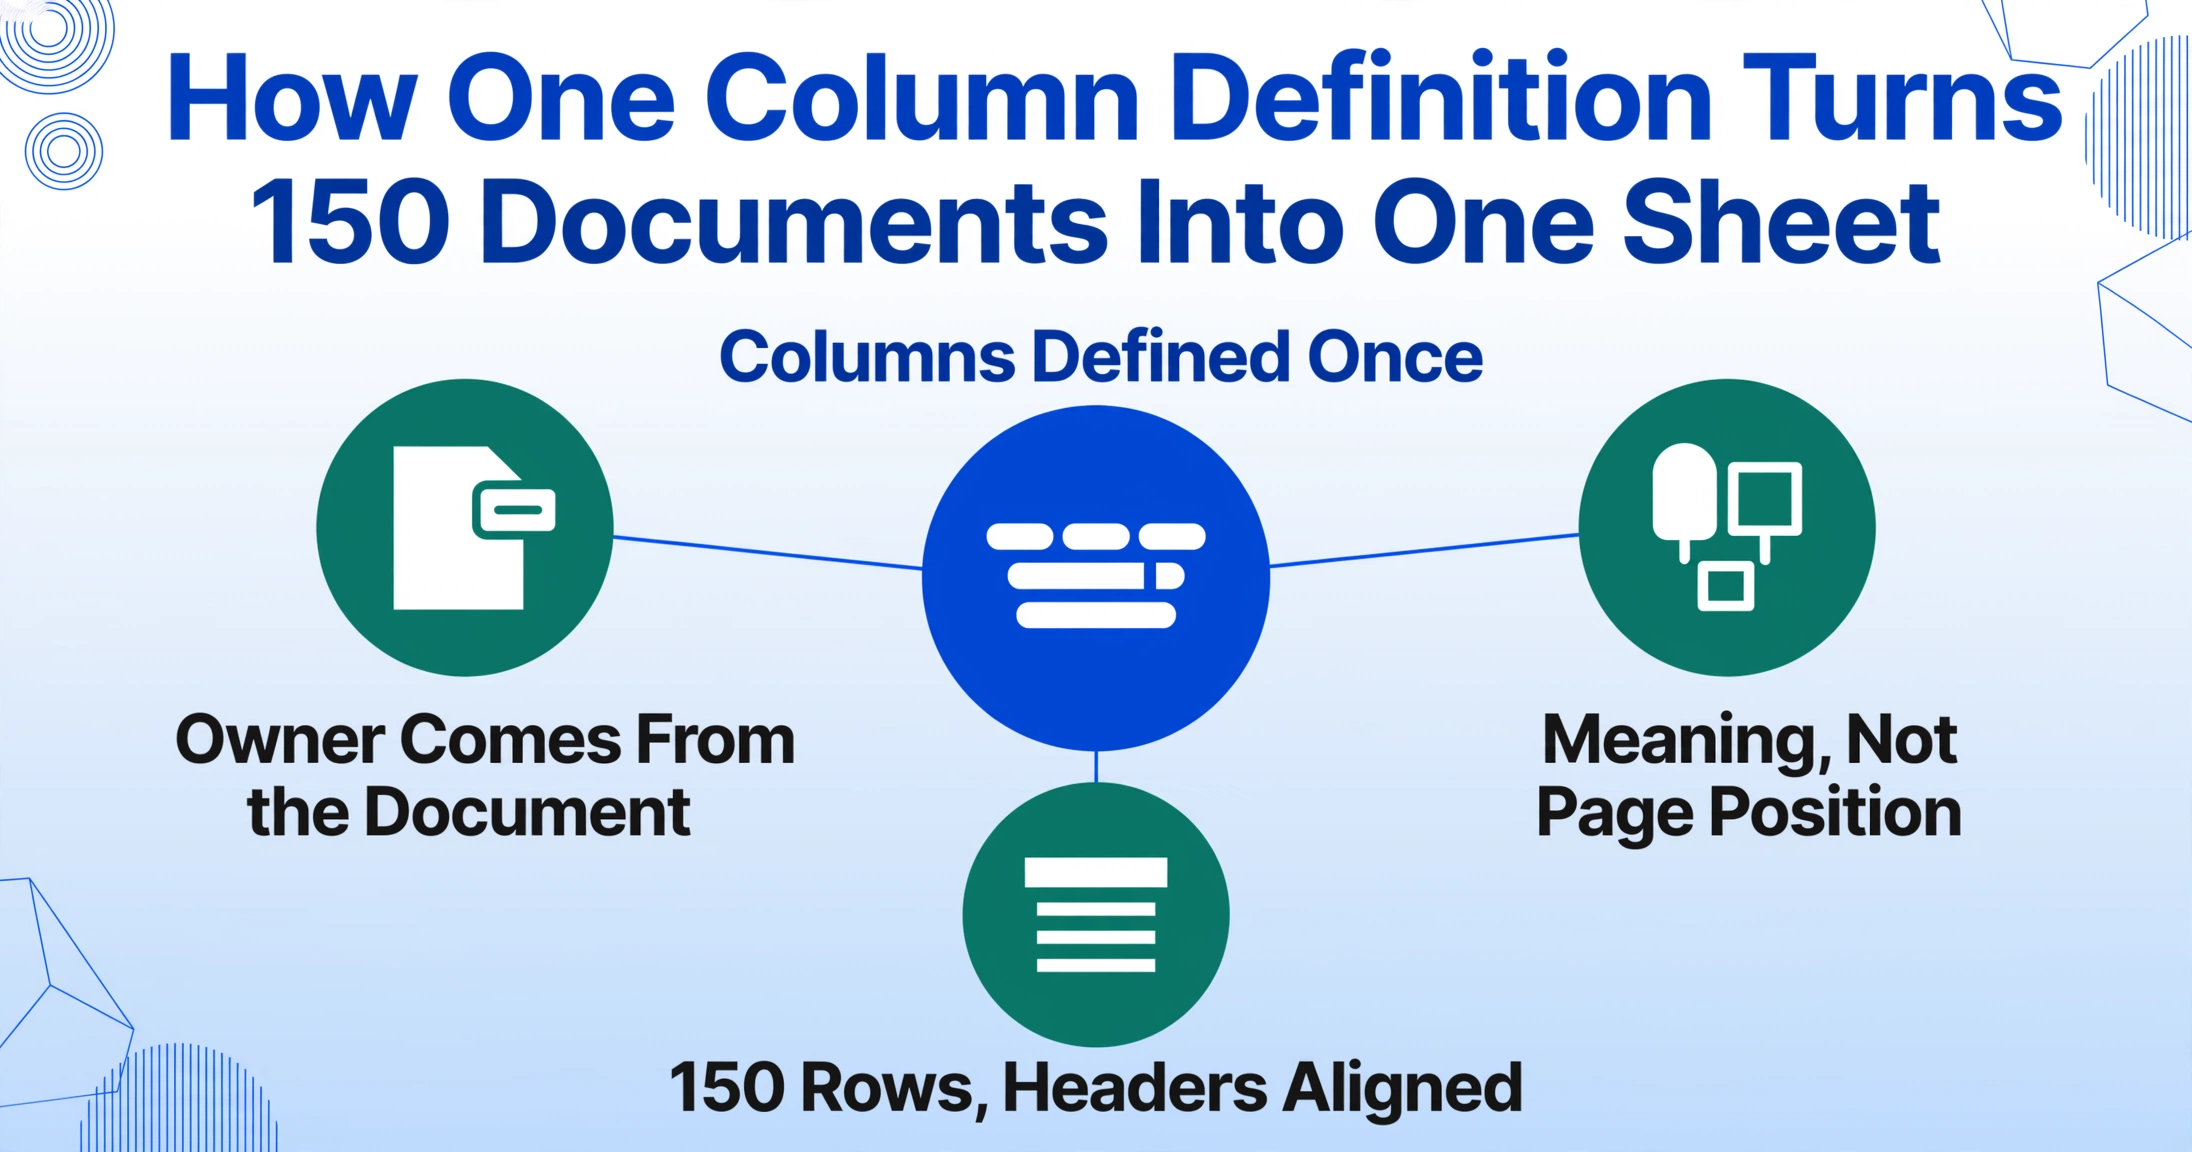
列定義が150件すべてのドキュメントで同じであるため、命名の問題は解消されます。各行には従業員名が抽出フィールドとして含まれるので、トレーサビリティをファイル名に依存する必要がありません。構造のばらつきの問題も解消されます。「Communication」と書かれたレビューでも「Interpersonal Skills」と書かれたレビューでも、AIは意味を認識して「コミュニケーションスコア」という列に両方をマッピングします。そして統合の問題はそもそも発生しません。1つのバッチ、1つのテーブル、150行、すべての列が整合しています。最初に一度だけ定義したからです。
フォームに印刷されない列を追加することもできます。「総合スコア(コミュニケーション+コラボレーション+生産性+品質+リーダーシップ÷5)」のような計算列を追加すれば、AIが抽出時にコンピテンシースコアを平均化します。また、「パフォーマンス階層(選択肢:上位/強い/成長中/改善が必要)」のような推論列を追加すれば、バッチ処理中にすべての従業員を評価基準に分類します。分析準備済みのシートが届くので、Excelでの数式や再処理は不要です。
ファイルは安全に処理され、保存されません。
完全なフィールドリストとキャリブレーションシート作成のステップバイステップの手順(抽出すべき列とその理由を含む)については、タレントキャリブレーション向け業績評価抽出ガイドでドキュメントごとに詳しく解説しています。この記事では、150件で実行したときに何が変わるかに焦点を当てています。
バッチ内の例外はどう扱われるか
150件のドキュメントを含むバッチでは、「平均的なドキュメント」というものは存在しません。一部のレビューには自己評価が欠けているかもしれません。マネージャーが昇進推薦を空白のままにしている場合もあります。スキャンされたシートには、ペンで丸印が付けられた評価が斜めに取り込まれていることもあります。バッチワークフローの成否は、こうした例外をどう扱うかにかかっています。そこで、それぞれの例外に実際に何が起こるのかをご説明します。
欠落フィールドは空白のまま残され、捏造されません。レビューにコンピテンシースコアが含まれていない場合、そのセルは出力で空白のままになります。AIが数値を埋めるために発明することはありません。シート内の空白セルは、キャリブレーションの会話にとって正直なシグナルです(「このマネージャーはコラボレーションを評価しなかった」)。捏造された数値は、分布を静かに歪めてしまうでしょう。
トレーサビリティはファイル名ではなく、抽出フィールドから得られます。「従業員名」(理想的には「従業員ID」)が抽出列であるため、ファイルの名前がどうであれ、すべての行はそのドキュメントに遡って追跡できます。マネージャーが会議で評価に異議を唱えた場合、フォルダを探し回る代わりに、数秒でソースドキュメントを開くことができます。
リスクのあるものだけを検証し、150件すべてを検証するわけではありません。レビューモードでは、抽出されたセルにカーソルを合わせると、その値が元の画像のどこから来たのかが正確にハイライト表示されます。そのため、給与決定に影響するスコアのスポットチェックは、数時間ではなく数分で完了します。同じ視覚的検証レイヤーにより、人事チームはすべてのドキュメントを最初から最後まで読み直すことなく、バッチを承認できます。
バッチ規模の例外についてもう1つ知っておくべきことがあります:評価スケールは部門によって異なります。エンジニアリングの1〜5スケールとセールスの1〜10スケールでは、直接比較できない数値が生成されます。データがシートに入ったら、総合評価列を正規化してください。再入力ではなく、検索と置換または数式による処理です。サイクルに「4」と「期待を上回る」が混在している場合も同じ正規化が適用されます。抽出後、両方をルーブリックの数値スケールにマッピングしてください。
150行からキャリブレーション議題へ
バッチ出力が成果物ではありません。キャリブレーションセッションこそが成果物です。しかし、会議に持ち込むシート次第で、そのセッションが証拠に基づく議論になるか、印象に基づく議論になるかが決まります。3つのチェックで、整合された150行を実用的な議題に変えられます。
目標カーブに対する分布を確認する。パフォーマンス階層でフィルタリングし、各バンドに何人の従業員が入っているかを数えます。チームの80%が「Top」に該当する会社は、高業績企業ではなく、キャリブレーションがされていない企業です。それがセッションで最初に議論すべき点です。
マネージャーごとにピボットして、寛大さと厳格さを明らかにする。マネージャーを行、総合スコアの平均を値にしたピボットテーブルを挿入し、各マネージャーのチーム平均を会社平均と比較します。会社平均3.9に対して4.6のマネージャーが、キャリブレーションの議論のきっかけになります。チームが悪いからではなく、評価基準が異なるからです。
参加者が入室する前に事前読み物パケットを作成する。各セッションで対象となる従業員にシートを絞り込み、関連する行(評価、ナラティブのハイライト、昇進推薦)を事前に共有します。マネージャーは証拠をすでに見た状態で到着します。これこそが、キャリブレーションセッションを印象主導ではなく公平に保つ、文書化された証拠のダイナミクスです。
このバッチパターンは、HRドキュメントスタック全体に広がります。レビューシーズンを統合する同じワンバッチ・ワンテーブルのワークフローは、昇進が採用に変わるときのオファーレターと契約書を従業員データベースに変換、新規入社者のためのオンボーディングフォームを従業員記録に変換、採用計画が募集を求める際の履歴書データを候補者スプレッドシートに変換も処理します。列を一度定義すれば、すべてのドキュメントタイプが同じ経路をたどります。
FAQ
プラットフォームのPDF、Wordフォーム、スキャンしたシートを1つのバッチに混在させてもよいですか?
はい。バッチ処理では、フォーマットやレイアウトによる事前の仕分けは必要ありません。列名を一度定義するだけで(総合評価、コミュニケーションスコア、昇進推薦など)、AIが各文書タイプを読み取り、フィールドの意味を理解します。プラットフォームのPDF、Wordフォーム、スキャンはすべて同じバッチを通過し、同じ整列されたテーブルにまとめられます。複数ページのPDFはページごとに分割され、自動的に正しいレビューに照合されます。
ファイル名が「Scan_001.pdf」だけの場合、行を正しい従業員にどうやって遡って対応づけますか?
抽出列に「従業員名」(フォームに印刷されている場合は従業員IDも)を含めてください。名前は文書自体から取得され、出力行に表示されるため、トレーサビリティはファイル名に依存しません。さらに冗長性を高めたい場合は、アップロード前にファイル名を変更してください。ただし実際には、レビューはほぼ常に従業員名を1ページ目に目立つように印刷するため、抽出された名前フィールドで十分です。
レビューにスコアやセクションが欠けている場合はどうなりますか?
欠落したフィールドは出力で空白のままになります。AIは推測しません。空白セルは、キャリブレーションで対応できる正直なシグナルです(「このマネージャーはコラボレーションを採点しなかった」など)。誤ったエラーではありません。シートにこれらのケースをフラグ付けさせたい場合は、「レビュー完全性(オプション:完全/部分的)」のような推論列を追加すると、AIが抽出中に各行をマークします。
部門ごとに異なる評価尺度を使用していますが、1つのシートで比較できますか?
抽出では、各評価がフォームに印刷されたとおりに、それぞれの列に取り込まれます。部門間で比較するには、データが出力されたら総合評価列を正規化してください。1回の検索と置換または数式で、1〜10の営業スケールを1〜5のルーブリックに変換できます。同じ正規化で、「期待を上回る」のようなテキスト評価も数値に変換できます。これは1つの列に対する5分の作業であり、150行にわたる再入力作業ではありません。
金曜日のキャリブレーションに向けてレビューが期限を迎えています — フルバッチにはどのくらい時間がかかりますか?
バッチ処理は並列で実行されます。数十から数百のドキュメントが同時に処理され、1つの出力テーブルに統合されます。通常は数分から数時間かかりますが、ボリュームとドキュメントの長さによって異なります。実際のボトルネックは抽出ではなく、その後のスポットチェックです。レビューモードでは、すべてのドキュメントを読み直す代わりに、抽出された値をソース画像と照合して確認できるため、このチェックを数分に抑えられます。
従業員の業績データはプライバシーが保護されますか?
ファイルは安全に処理され、設定可能な保持期間の後に自動的に削除されます。顧客のアップロードからトレーニングデータが保持されることはありません。抽出されたスプレッドシートはお客様がダウンロードして管理するファイルであり、アクセスや削除のリクエストへの対応が簡単です。
シートは成果物ではなく出発点
ピープルチームがレビューの手入力からバッチ処理へ移行すると、静かな変化が起こります。かつてコピーペーストに消えていた8〜10時間が、別のものとして現れます。それは、分布を実際に読み取り、どのマネージャーのチームが会社平均より1ポイント以上高いかに気づき、キャリブレーションの会話を生産的にするための証拠を準備する時間です。タイピングは決して仕事ではありませんでした。会話こそが仕事であり、それは会議室に持ち込むデータと同じくらいの質しか持てません。
1つのバッチ、1つのシート、すべての評価とコメントが揃っている — それがレビューシーズンを包囲攻撃ではなく季節のように感じさせるものです。実際のレビューファイルを数件アップロードして、150のドキュメントが1回のパスで1つのキャリブレーションテーブルになるのを見てください。