150 Evaluaciones de Desempeño, Una Sola Hoja
Procesamiento por Lotes Sin Copiar y Pegar
Investigación consolidada a través de CEB (ahora parte de Gartner) encontró que los gerentes dedican un promedio de 210 horas al año a actividades de gestión del desempeño — y los empleados otras 40 horas cada uno (SHRM/CEB). Lo sorprendente es cuánto de ese tiempo no es juicio. Es ensamblaje: abrir documentos de evaluación, encontrar la calificación en la página 2, copiarla en una hoja de resumen, repetir 150 veces.
Conclusiones Clave
- Copiar y pegar 150 puntuaciones de evaluación en una hoja de cálculo no es un problema de lentitud: los flujos de trabajo de un solo documento fallan a escala de lote por diseño.
- 150 evaluaciones heterogéneas, tres vocabularios de calificación, una fecha límite de calibración: la traducción mental a ese volumen se convierte en error sistemático, no en juicio.
- Define los nombres de tus columnas una vez y la IA lee por significado en lugar de por posición: 150 evaluaciones aterrizan en una tabla alineada en una sola pasada.
La brecha entre 1 evaluación y 150 no es velocidad. Es diseño.
Cualquier persona en un equipo de personas puede manejar una evaluación de desempeño. Abres el PDF, lees la evaluación del gerente, anotas la calificación general y lo archivas. El problema comienza cuando el ciclo cierra y se fija la fecha de la sesión de calibración: de repente, las evaluaciones de toda la empresa llegan a la vez, y el mismo flujo de trabajo cuidadoso de uno a la vez se convierte en una cola que no puedes terminar.
En una encuesta de SHRM, el 54% de los profesionales de RR. HH. dijo que su organización realiza sesiones formales de calibración — y el 69% citó calificaciones inconsistentes como la razón más común por la que las calificaciones se modifican cuando los gerentes comparan notas (SHRM). La calibración existe para detectar esas inconsistencias — pero solo puede discutir lo que llegó a la hoja de cálculo. Si la hoja de cálculo se construyó a mano, hereda cada error de transposición y línea omitida de ese pase manual.
Esa es la brecha real. El procesamiento de un solo documento es una tarea que encajas entre reuniones. El procesamiento por lotes es un proyecto con una fecha límite, una pila de documentos heterogéneos y cero tolerancia para el único error que coloca a un empleado en la banda salarial equivocada. Las herramientas que manejan cómodamente una evaluación nunca fueron diseñadas para el lote — por eso la temporada de evaluaciones por lotes se convierte en sesiones de copiar y pegar de fin de semana para muchos equipos.
El procesamiento por lotes de evaluaciones de desempeño es un problema de diseño, no de escritura. En el momento en que la pila supera lo que una persona puede transcribir sin errores por fatiga, el flujo de trabajo — no el transcriptor — tiene que cambiar.
Lo que un ciclo de evaluaciones realmente te entrega
Antes de poder procesar cualquier lote, ayuda saber qué produce un ciclo terminado en la práctica. Incluso las empresas que usan software de desempeño rara vez tienen un botón único de "exportar todo" que genere una tabla lista para calibración. En la práctica, los documentos llegan en al menos cuatro formatos, generalmente mezclados:
- PDFs por evaluación desde la plataforma. Workday, Lattice, 15Five y BambooHR permiten exportaciones de evaluaciones por empleado — lo que significa una carpeta de PDFs de un archivo por persona, a menudo en lotes de cincuenta o más, entregados la semana antes de la calibración.
- Volcados de datos sin procesar de la plataforma. La exportación alternativa es un CSV pregunta por pregunta que aún necesita remodelarse antes de que coincida con tu formato de calibración.
- Formularios de Word y Google Docs. Los equipos medianos aún ejecutan ciclos en plantillas compartidas: los gerentes llenan un documento, lo firman y lo envían por correo. RR. HH. termina con una bandeja de entrada de archivos adjuntos, cada uno en un estado de edición ligeramente diferente.
- Hojas de evaluación escaneadas. Siguen siendo reales en manufactura, retail, salud y operaciones de campo — un formulario en papel con la escala de calificación del gerente llenada a mano, escaneado de vuelta en la oficina.
- Evidencia de chat de Slack y Teams. Los elogios y notas de coaching diarios que un gerente envía entre ciclos formales nunca llegan al archivo de evaluación, sin embargo, a menudo justifican la calificación una vez que comienza la calibración. Esas capturas de pantalla de comentarios de gerentes tienen que incorporarse a la hoja junto con los documentos de evaluación, o la calificación no tiene evidencia detrás.
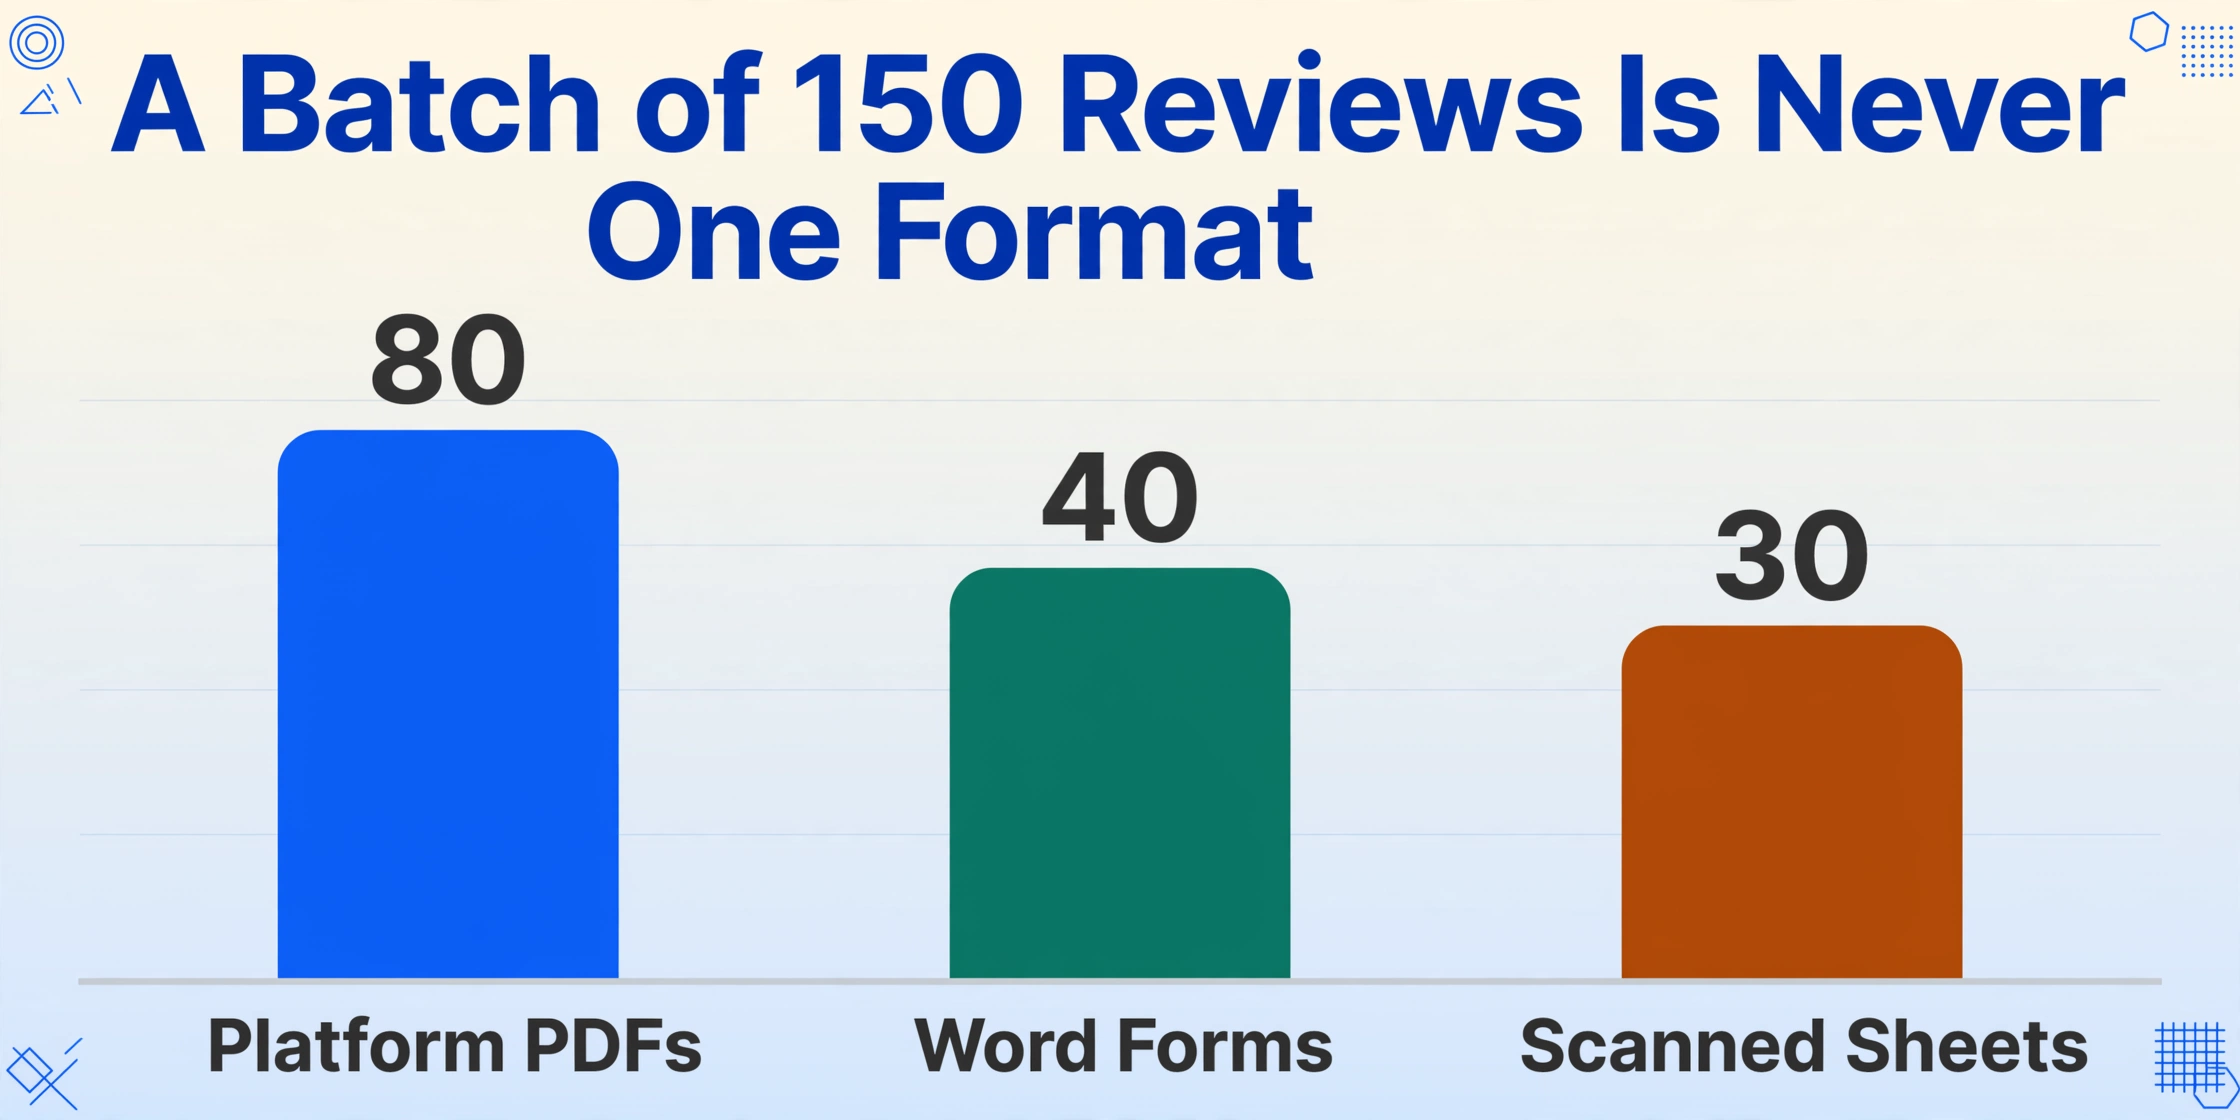
El problema es la mezcla. Un lote de 150 evaluaciones puede contener 80 PDFs de plataforma, 40 formularios de Word y 30 escaneos, y no comparten un diseño, un orden de campos, ni siquiera un vocabulario para la misma calificación ("4", "Exceeds Expectations" y una marca de verificación en la casilla sobre "Meets Expectations" significan cosas diferentes en diferentes formularios). Un flujo de trabajo diseñado para un formato no sobrevive al contacto con tres.
Las tres cosas que fallan a escala de lote
El procesamiento por lotes no es procesar un documento individual 150 veces. Es una operación diferente con modos de fallo que no existen cuando la pila tiene un solo PDF de grosor. Tres de ellos deciden si la temporada de evaluaciones funciona o colapsa.
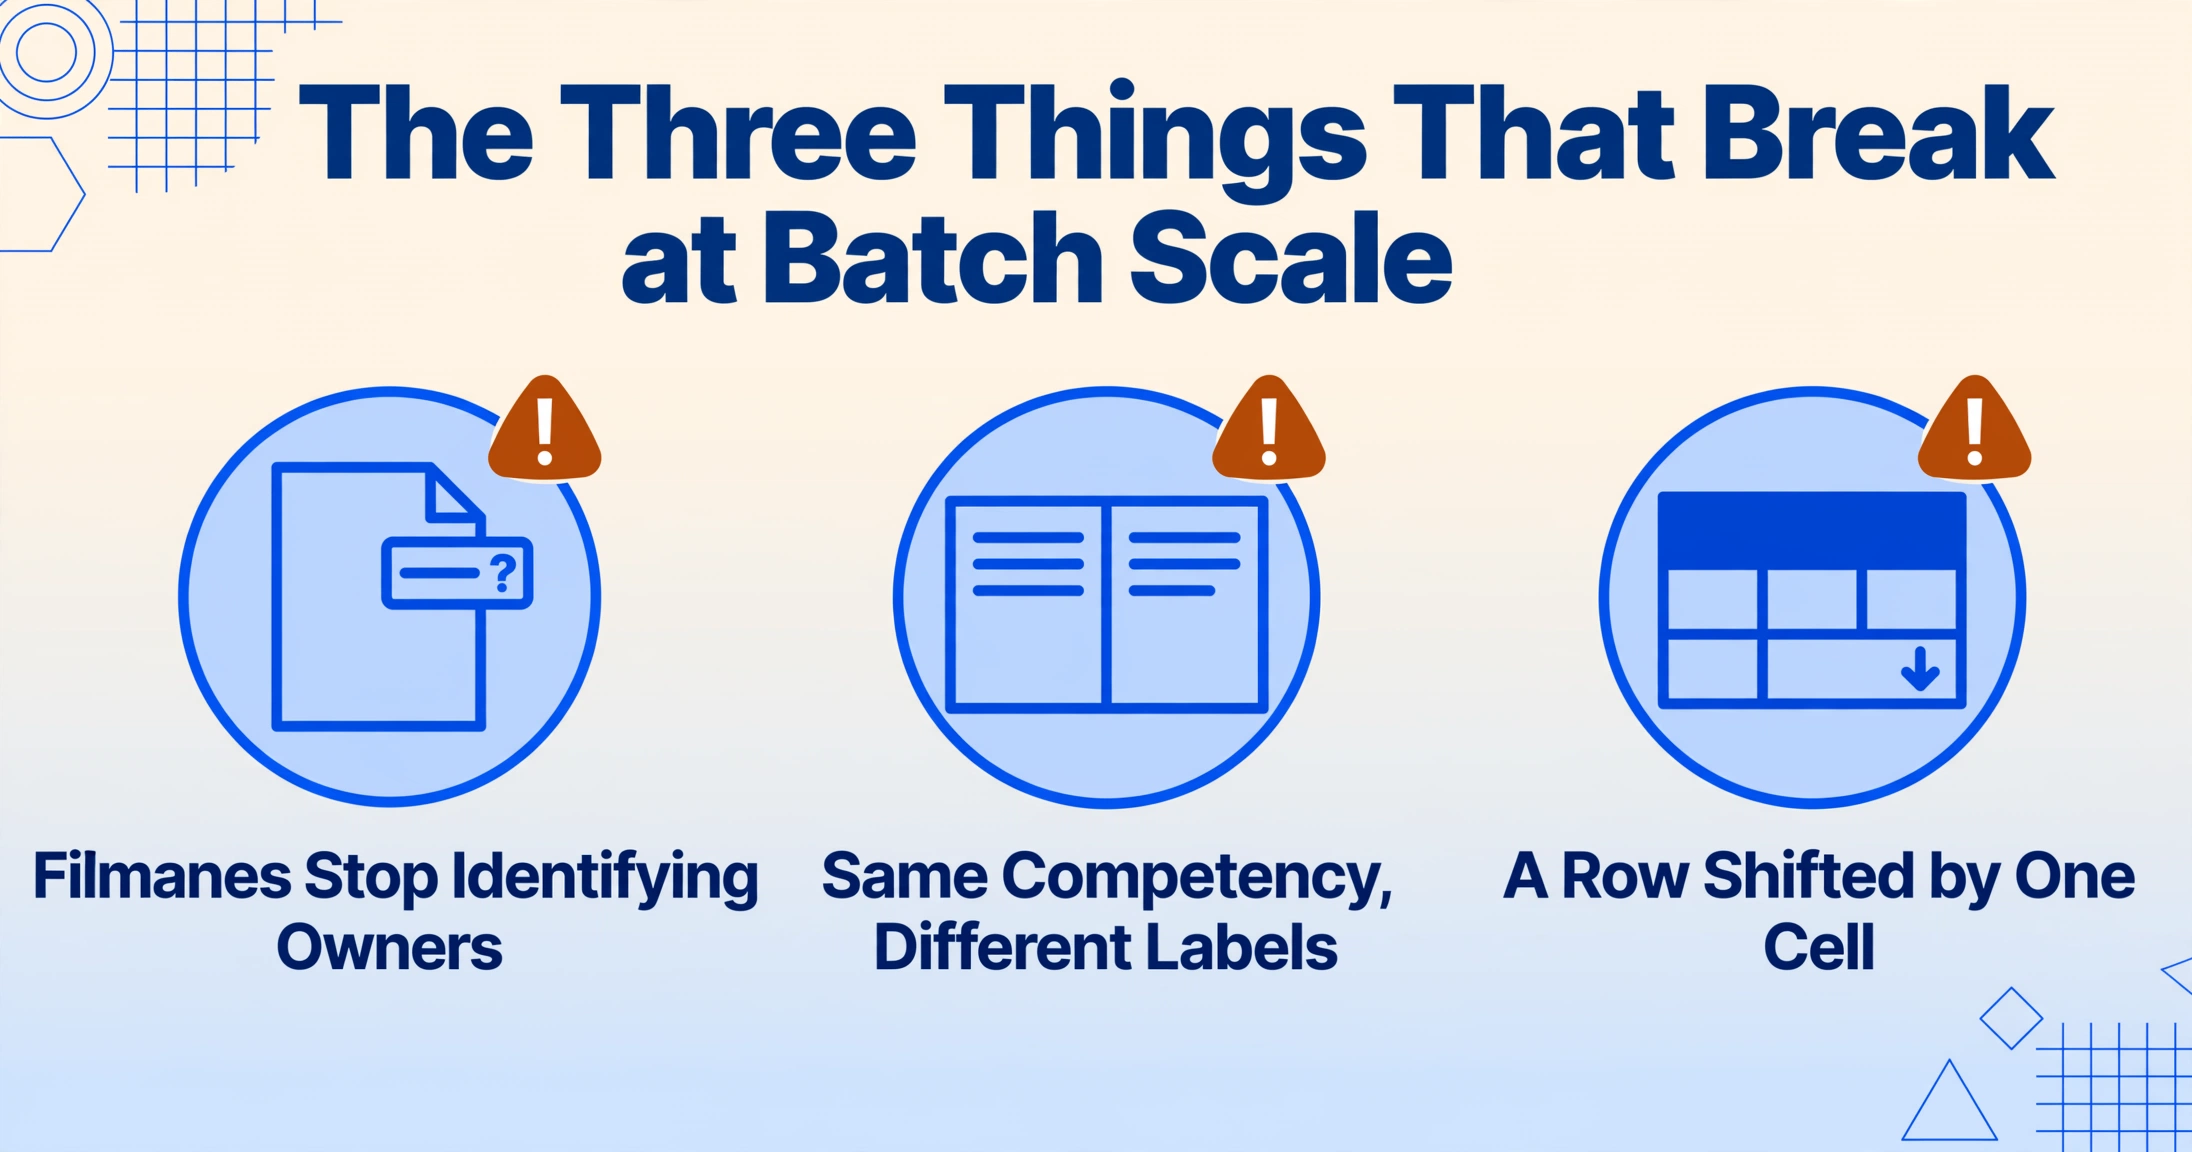
1. El problema de los nombres. Cuando llegan tres evaluaciones, puedes asignar "Chen_2025_Review.pdf" a su propietario sin pensarlo. Cuando 150 llegan a una carpeta compartida de Drive y la mitad de los nombres de archivo dicen "Scan_2025-12-04_0071.pdf" o "Performance Review (1) (2) FINAL.pdf", el mapeo mental colapsa. Abres archivos solo para identificarlos, y cada archivo que abres para verificar un nombre es tiempo que no dedicas a armar la hoja.
2. El problema de la variación estructural. Una sola empresa rara vez tiene una plantilla de evaluación. Los gerentes de diferentes departamentos añaden secciones, omiten la autoevaluación, escriben una calificación en el cuadro de comentarios en lugar del campo de calificación, o usan "Communication & Collaboration" mientras que otro usa "Interpersonal Skills" para la misma competencia. A escala de documento individual, traduces estas diferencias mentalmente. A escala de lote, la traducción mental se convierte en error sistemático.
3. El problema de la consolidación. Incluso con cada evaluación extraída limpiamente, ahora tienes 150 conjuntos de valores, y lo que necesitas es una tabla, una fila por empleado, con columnas alineadas. El paso de fusión, donde 150 extracciones se convierten en una sola hoja de cálculo con encabezados coincidentes, es donde los flujos de trabajo por lotes se abandonan por el método manual. También es donde se esconden los errores silenciosos: una fila desplazada una celda, una columna pegada bajo el encabezado incorrecto.
Estos tres problemas son la razón por la que la respuesta a la temporada de evaluaciones no es "escribir más rápido". Es un flujo de trabajo donde los documentos mismos se convierten en la entrada y la tabla alineada es la salida, sin transcripción intermedia que pueda desviarse.
Cómo una definición de columna convierte 150 documentos en una sola hoja
El mecanismo que resuelve los tres bloqueos del procesamiento por lotes a la vez es la Extracción de Columnas Personalizadas: escribes los nombres de las columnas que quieres — «Nombre del empleado», «Calificación general», «Puntuación de comunicación», «Recomendación de promoción» — y la IA localiza cada valor en cada documento al comprender qué significa el campo, no dónde está en la página. Los nombres de columna que introduces se convierten en los encabezados de la hoja de cálculo final, por lo que el resultado coincide con tu formato de calibración por construcción.
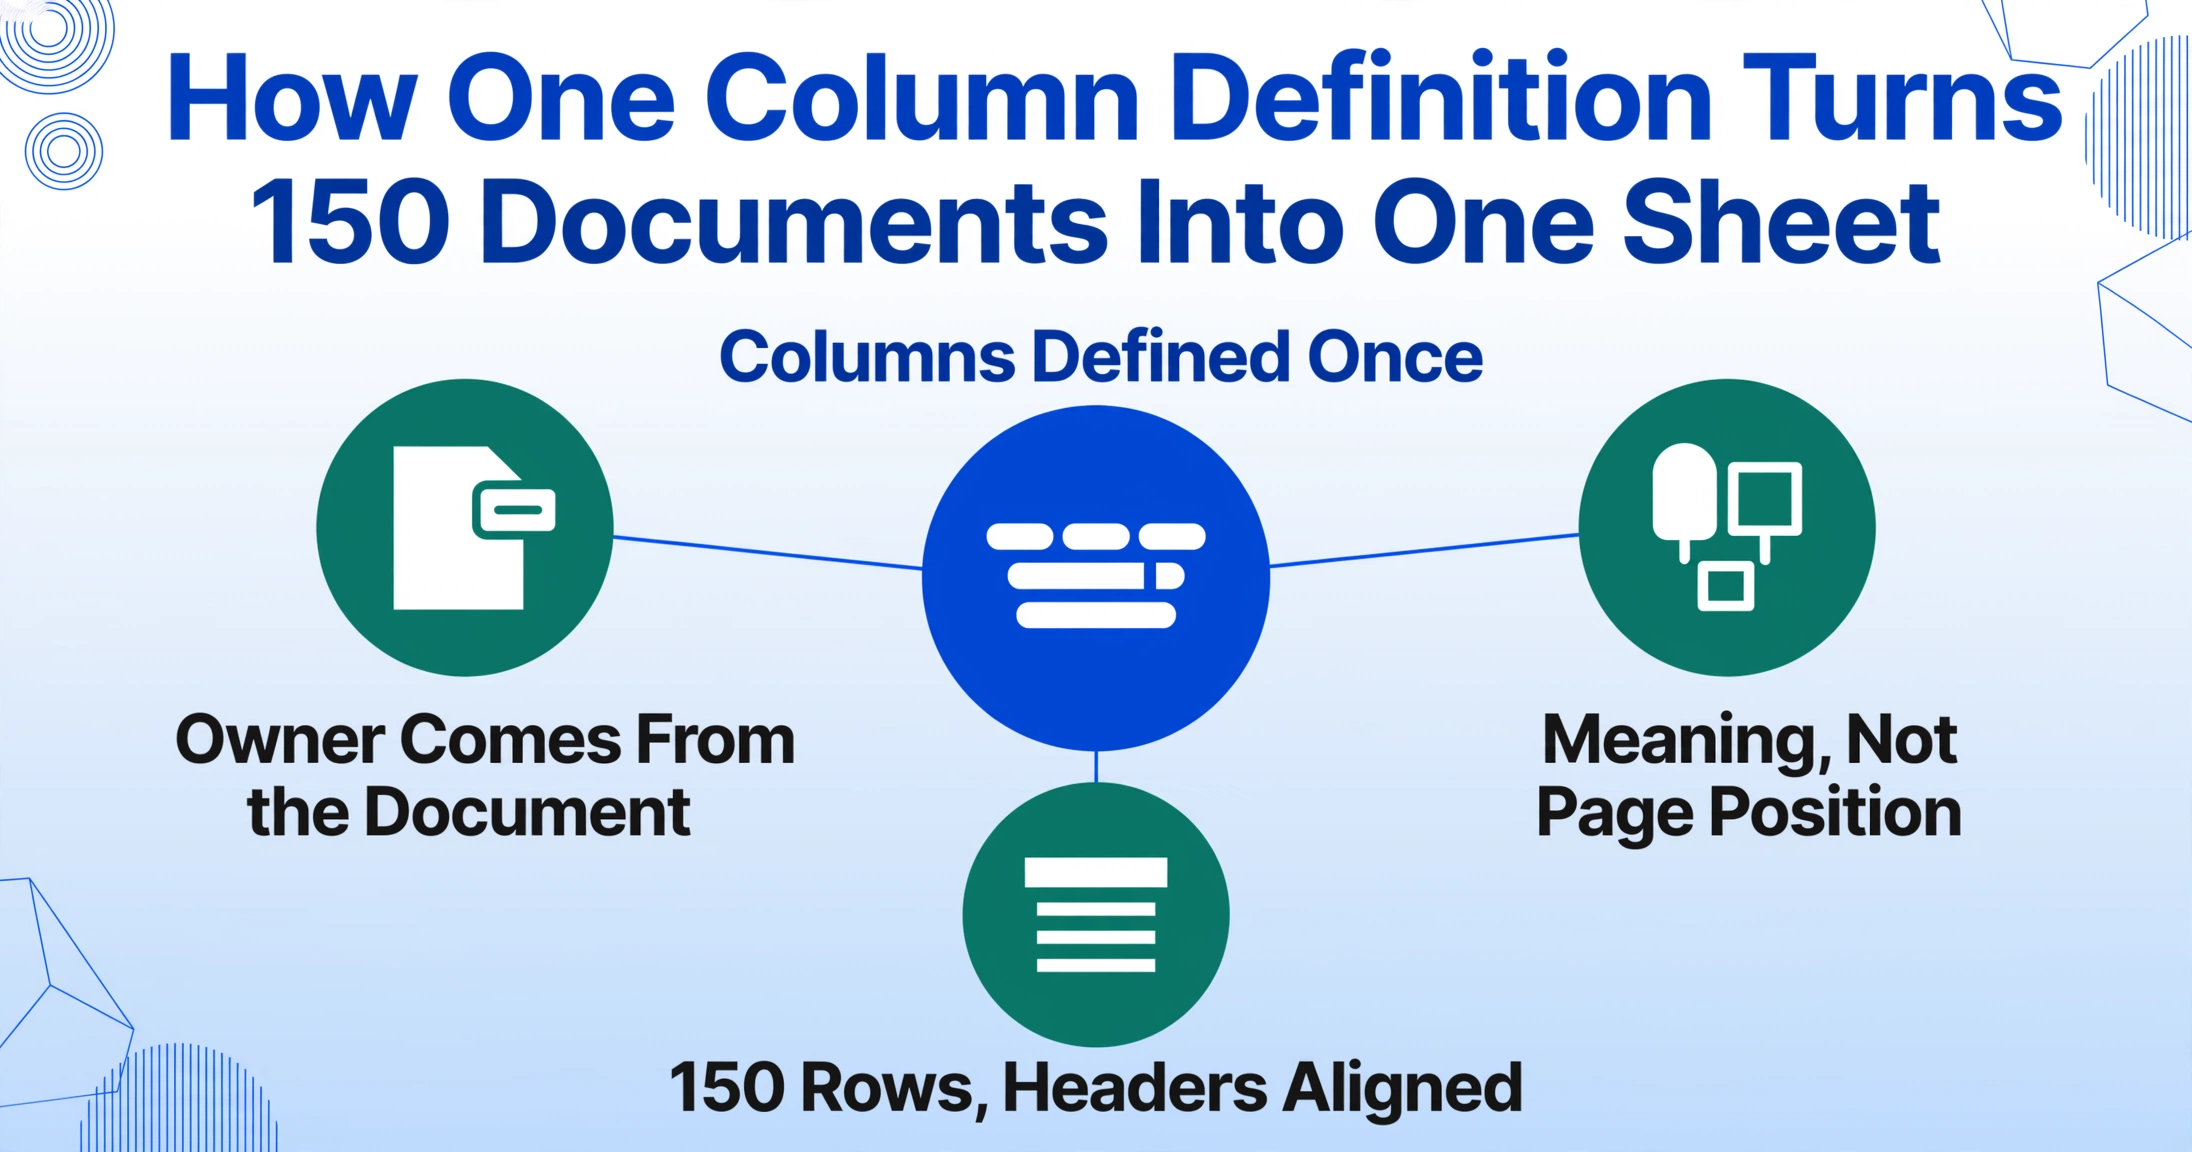
Como la definición de columna es la misma para los 150 documentos, el problema de los nombres se disuelve: cada fila de salida incluye el nombre del empleado como campo extraído, así que nunca dependes de los nombres de archivo para la trazabilidad. El problema de la variación estructural también se disuelve: tanto si una evaluación dice «Communication» como «Interpersonal Skills», la IA asigna ambos a la columna que llamaste «Puntuación de comunicación» al reconocer el significado. Y el problema de la consolidación nunca surge: un lote, una tabla, 150 filas, todas las columnas alineadas, porque se definieron una sola vez al principio.
Incluso puedes añadir columnas que los formularios nunca imprimen. Una columna calculada como «Puntuación compuesta (Communication + Collaboration + Productivity + Quality + Leadership ÷ 5)» hace que la IA promedie las puntuaciones de competencias durante la extracción en lugar de después. Una columna inferida como «Nivel de desempeño (opciones: Top/Strong/Developing/Needs Improvement)» clasifica a cada empleado según tu rúbrica mientras se procesa el lote. La hoja llega con el trabajo listo para el análisis ya hecho — sin fórmulas, sin una segunda pasada en Excel.
Los archivos se procesan de forma segura y no se almacenan.
Si quieres la lista completa de campos y un recorrido paso a paso para crear la hoja de calibración — incluyendo qué columnas extraer y por qué — la guía de extracción de evaluaciones de desempeño para la calibración de talento cubre el proceso documento por documento. Este artículo se centra en lo que cambia cuando lo ejecutas a escala de 150.
Qué Sucede con las Excepciones en un Lote
En un lote de 150 documentos, "el documento promedio" es una ficción. A algunas evaluaciones les faltará la autoevaluación. Algunos gerentes habrán dejado en blanco la recomendación de promoción. Algunas hojas escaneadas tendrán una calificación marcada con bolígrafo que el escáner capturó en ángulo. Los flujos de trabajo por lotes dependen de cómo manejan estas excepciones — así que esto es lo que realmente sucede con cada una.
Los campos faltantes permanecen en blanco, no se inventan. Si una evaluación no contiene una puntuación de competencia, esa celda se deja vacía en el resultado — la IA no inventa un número para llenarla. Una celda en blanco en la hoja es una señal honesta para la conversación de calibración ("este gerente no calificó la colaboración"); una inventada corrompería silenciosamente la distribución.
La trazabilidad proviene de los campos extraídos, no de los nombres de archivo. Debido a que "Nombre del empleado" (e idealmente "ID de empleado") son columnas de extracción, cada fila se puede rastrear hasta su documento independientemente de cómo se haya nombrado el archivo. Cuando un gerente cuestiona una calificación en la sala, puedes abrir el documento fuente en segundos en lugar de buscar en una carpeta.
Verificas los riesgosos, no los 150. En el Modo de revisión, al pasar el cursor sobre cualquier celda extraída se resalta exactamente de dónde proviene ese valor en la imagen original — así que revisar las puntuaciones que alimentan las decisiones de pago toma minutos, no horas. La misma capa de verificación visual es lo que permite que un equipo de personas apruebe un lote sin releer cada documento de principio a fin.
Una cosa más que vale la pena saber sobre las excepciones a escala de lote: las escalas de calificación difieren según el departamento. Una escala de 1–5 en ingeniería y una de 1–10 en ventas producen números que no se pueden comparar directamente. Normaliza la columna de Calificación general una vez que los datos estén en la hoja — un buscar y reemplazar o un paso de fórmula, no una sesión de reescritura. La misma normalización se aplica si tu ciclo mezcla "4" con "Exceeds Expectations"; mapea ambos a la escala numérica de tu rúbrica después de la extracción.
De 150 filas a una agenda de calibración
El resultado del lote no es el entregable: la sesión de calibración lo es. Pero la hoja que llevas a la sala determina si esa sesión debate evidencia o impresiones. Tres comprobaciones convierten 150 filas alineadas en una agenda de trabajo.
Comprueba la distribución frente a tu curva objetivo. Filtra por Nivel de desempeño y cuenta cuántos empleados cayeron en cada banda. Una empresa donde el 80% del equipo es "Top" no es una empresa de alto rendimiento: es una sin calibrar, y eso es lo primero que la sesión debería discutir.
Dinamiza por gerente para sacar a la luz la indulgencia y la severidad. Inserta una tabla dinámica con Gerente como filas y Promedio de Puntuación compuesta como valores, y luego compara el promedio del equipo de cada gerente con el promedio de la empresa. El gerente con 4.6 frente a un promedio de empresa de 3.9 es tu punto de partida para la conversación de calibración, no porque su equipo sea malo, sino porque su escala es diferente.
Prepara el paquete de lectura previa antes de que alguien entre. Filtra la hoja a los empleados que cada sesión cubrirá y comparte las filas relevantes con anticipación: calificaciones, aspectos destacados de las narrativas, recomendaciones de promoción. Los gerentes llegan habiendo visto ya la evidencia, que es precisamente la dinámica de evidencia documentada que mantiene las sesiones de calibración justas en lugar de impulsadas por impresiones.
Este patrón de lote se extiende por toda la pila de documentos de RR. HH. El mismo flujo de trabajo de un lote a una tabla que consolida la temporada de evaluaciones también maneja cartas de oferta y contratos en una base de datos de empleados cuando las promociones se convierten en contrataciones, formularios de incorporación en registros de empleados para los nuevos integrantes, y datos de currículums en hojas de cálculo de candidatos cuando el plan de plantilla requiere reclutar. Define las columnas una vez; cada tipo de documento sigue el mismo camino.
Preguntas frecuentes
¿Puedo mezclar PDFs de plataforma, formularios de Word y hojas escaneadas en un mismo lote?
Sí. El procesamiento por lotes no requiere clasificar previamente por formato o diseño. Tú defines los nombres de tus columnas una sola vez — Calificación general, Puntuación de comunicación, Recomendación de promoción — y la IA lee cada tipo de documento comprendiendo el significado de los campos. Los PDFs de plataforma, los formularios de Word y los escaneos pasan por el mismo lote y terminan en la misma tabla alineada. Los PDFs de varias páginas se dividen página por página y se emparejan automáticamente con la evaluación correcta.
¿Cómo rastreo una fila hasta el empleado correcto cuando los nombres de archivo son solo "Scan_001.pdf"?
Incluye "Nombre del empleado" (y ID de empleado, si tus formularios lo imprimen) como columnas de extracción. El nombre se extrae del propio documento y aparece en la fila de salida, así que la trazabilidad nunca depende de los nombres de archivo. Si quieres una segunda capa de redundancia, renombra los archivos antes de subirlos — pero en la práctica el campo de nombre extraído es suficiente porque las evaluaciones casi siempre imprimen el nombre del empleado de forma destacada en la primera página.
¿Qué ocurre cuando a una evaluación le falta una puntuación o una sección?
El campo faltante permanece en blanco en la salida — la IA no adivina. Una celda en blanco es una señal honesta que puedes gestionar en la calibración ("este gerente no puntuó la colaboración") en lugar de un error silencioso. Si quieres que la hoja marque estos casos, añade una columna inferida como "Integridad de la evaluación (opciones: Completa/Parcial)" y la IA marcará cada fila durante la extracción.
Diferentes departamentos usan diferentes escalas de calificación — ¿puedo compararlas en una misma hoja?
La extracción captura cada calificación tal como aparece impresa en el formulario, en su propia columna. Para comparar entre departamentos, normaliza la columna de Calificación general una vez que los datos estén fuera — una simple búsqueda y reemplazo o fórmula convierte la escala de ventas del 1–10 a tu rúbrica del 1–5. La misma normalización convierte calificaciones de texto como "Excede las expectativas" en valores numéricos. Es un pase de cinco minutos en una columna, no una sesión de reescritura en 150 filas.
Las evaluaciones deben estar calibradas para el viernes: ¿cuánto tiempo toma un lote completo?
El procesamiento por lotes se ejecuta en paralelo: docenas o cientos de documentos se procesan juntos y se fusionan en una sola tabla de salida, generalmente en unos minutos o un par de horas, según el volumen y la longitud de los documentos. El cuello de botella práctico no es la extracción, sino la revisión muestral posterior, que el Modo de revisión reduce a minutos al permitirte verificar los valores extraídos contra las imágenes originales en lugar de releer cada documento.
¿Se mantiene privados los datos de desempeño de los empleados?
Los archivos se procesan de forma segura y se eliminan automáticamente después de un período de retención configurable; no se conservan datos de entrenamiento de las cargas de los clientes. La hoja de cálculo extraída es un archivo que tú descargas y controlas, lo que facilita responder a solicitudes de acceso o eliminación.
La Hoja Es el Punto de Partida, No el Entregable
Hay un cambio silencioso cuando un equipo de personas deja de transcribir evaluaciones y comienza a procesarlas por lotes. Las 8 a 10 horas que antes desaparecían en copiar y pegar reaparecen como otra cosa: tiempo dedicado a leer la distribución, notar qué equipo de gerente promedia un punto completo por encima de la empresa y preparar la evidencia que hace productiva la conversación de calibración. Escribir nunca fue el trabajo. La conversación lo era, y solo puede ser tan buena como los datos que lleves a la sala.
Un lote, una hoja, cada calificación y comentario en su lugar: eso es lo que hace que la temporada de evaluaciones se sienta como una temporada en lugar de un asedio. Sube un puñado de tus archivos de evaluación reales y observa cómo 150 documentos se convierten en una tabla de calibración en una sola pasada.