150 Leistungsbeurteilungen, ein Tabellenblatt
Stapelverarbeitung ohne Kopieren und Einfügen
Die durch CEB (heute Teil von Gartner) gebündelte Forschung zeigt: Führungskräfte wenden durchschnittlich 210 Stunden pro Jahr für Leistungsmanagement-Aktivitäten auf – und Mitarbeitende jeweils weitere 40 Stunden (SHRM/CEB). Das Überraschende daran ist, wie viel dieser Zeit nicht Urteilsvermögen ist, sondern Zusammenstellung: Beurteilungsdokumente öffnen, die Bewertung auf Seite 2 finden, sie in eine Übersichtstabelle kopieren, 150-mal wiederholen.
Die wichtigsten Erkenntnisse
- Das Kopieren von 150 Beurteilungsergebnissen in eine Tabelle ist kein Problem der Geschwindigkeit – Einzeldokument-Workflows versagen im Batch-Maßstab konstruktionsbedingt.
- 150 heterogene Beurteilungen, drei Bewertungssysteme, eine Kalibrierungsfrist – mentales Übertragen wird in dieser Menge zum systematischen Fehler, nicht zum Urteilsvermögen.
- Definieren Sie Ihre Spaltennamen einmal und die KI liest nach Bedeutung statt nach Position – 150 Beurteilungen landen in einem einzigen Durchgang in einer einheitlichen Tabelle.
Die Lücke zwischen 1 Beurteilung und 150 ist keine Frage der Geschwindigkeit, sondern des Designs.
Jeder im People-Team kann eine Leistungsbeurteilung bearbeiten. Sie öffnen die PDF, lesen die Einschätzung des Vorgesetzten, notieren die Gesamtbewertung und legen sie ab. Die Probleme beginnen, wenn der Zyklus endet und das Datum der Kalibrierungssitzung feststeht: Plötzlich treffen alle Beurteilungen des Unternehmens auf einmal ein, und derselbe sorgfältige Einzel-Workflow wird zu einer Warteschlange, die Sie nicht bewältigen können.
In einer SHRM-Umfrage gaben 54 % der HR-Profis an, dass ihr Unternehmen formelle Kalibrierungssitzungen durchführt – und 69 % nannten inkonsistente Bewertungen als häufigsten Grund, warum Ratings geändert werden, sobald Vorgesetzte ihre Notizen vergleichen (SHRM). Kalibrierung existiert, um diese Inkonsistenzen zu erkennen – aber sie kann nur das besprechen, was es in die Tabelle geschafft hat. Wenn die Tabelle selbst von Hand erstellt wurde, erbt sie jeden Übertragungsfehler und jede übersprungene Zeile aus diesem manuellen Durchgang.
Das ist die eigentliche Lücke. Die Verarbeitung einzelner Dokumente ist eine Aufgabe, die Sie zwischen Besprechungen einschieben. Stapelverarbeitung ist ein Projekt mit einer Frist, einem Stapel heterogener Dokumente und keiner Toleranz für den einen Fehler, der einen Mitarbeiter in die falsche Gehaltsstufe bringt. Die Tools, die eine Beurteilung bequem verarbeiten, wurden nie für den Batch entwickelt – weshalb die Batch-Beurteilungssaison für viele Teams in Copy-Paste-Wochenenden ausartet.
Die Stapelverarbeitung von Leistungsbeurteilungen ist ein Designproblem, kein Tippproblem. Sobald der Stapel die Menge übersteigt, die eine Person ohne Ermüdungsfehler transkribieren kann, muss sich der Workflow selbst – nicht der Datentypist – ändern.
Was ein Beurteilungszyklus tatsächlich hervorbringt
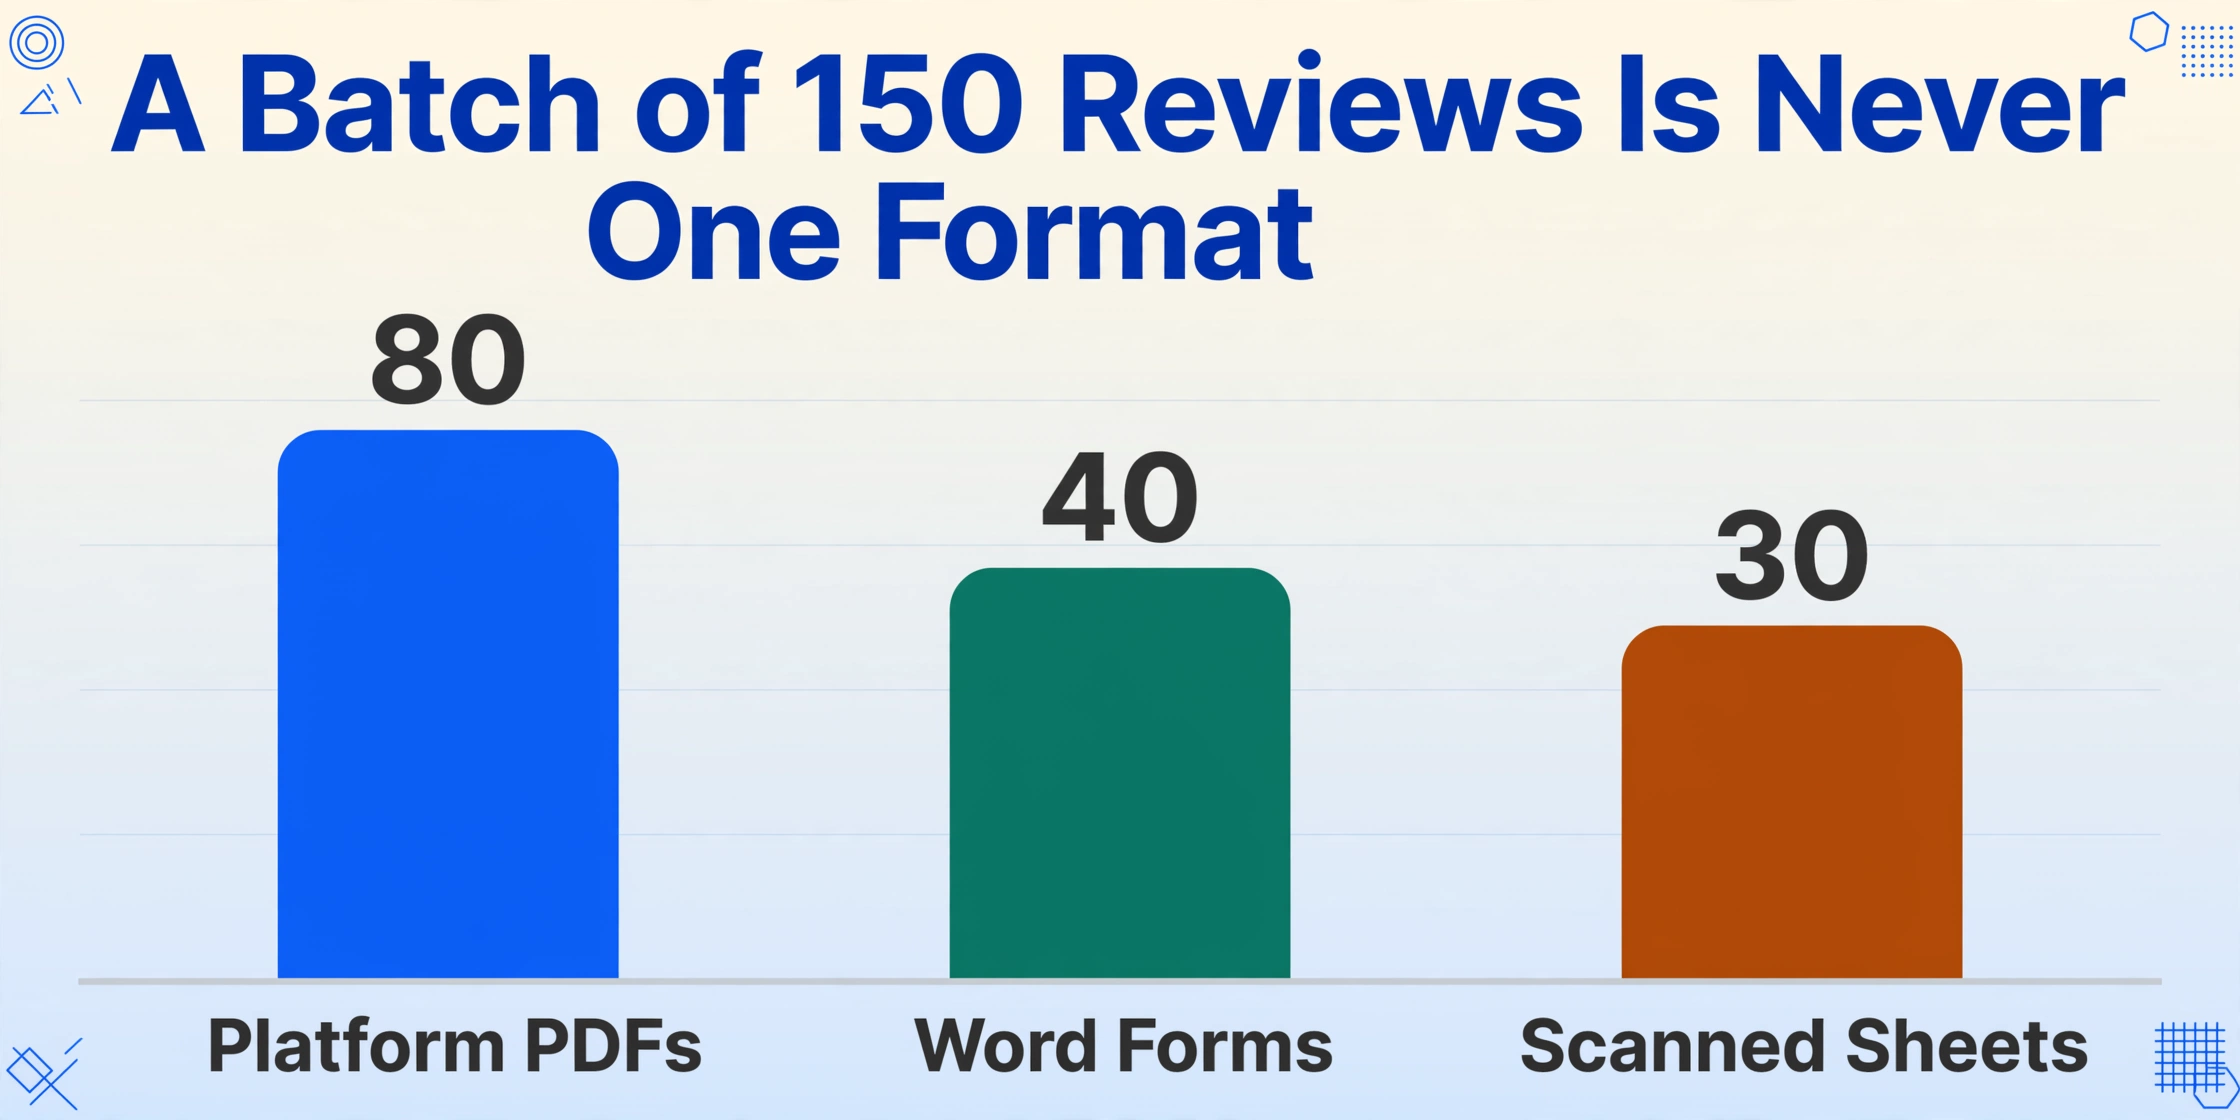
Bevor Sie etwas stapelverarbeiten können, hilft es zu wissen, was ein abgeschlossener Zyklus in der Praxis produziert. Selbst Unternehmen, die Performance-Software nutzen, haben selten einen „Alles exportieren“-Knopf, der eine kalibrierungsfertige Tabelle ausgibt. In der Praxis kommen die Dokumente in mindestens vier Formen an, meist gemischt:
- Pro-Beurtailungs-PDFs von der Plattform. Workday, Lattice, 15Five und BambooHR erlauben alle den Export von Beurteilungen pro Mitarbeiter – was einen Ordner mit einer Datei pro Person bedeutet, oft in Batches von fünfzig oder mehr, geliefert in der Woche vor der Kalibrierung.
- Rohe Plattform-Datenexporte. Die alternative Exportoption ist eine Frage-für-Frage-CSV, die noch umgeformt werden muss, bevor sie zu Ihrem Kalibrierungsformat passt.
- Word- und Google-Docs-Formulare. Mittlere Teams führen Zyklen immer noch mit gemeinsamen Vorlagen durch: Vorgesetzte füllen ein Dokument aus, unterschreiben es und senden es per E-Mail zurück. HR bleibt ein Posteingang mit Anhängen, jeder in einem leicht unterschiedlichen Bearbeitungszustand.
- Gescannte Beurteilungsbögen. In Fertigung, Einzelhandel, Gesundheitswesen und Außendienst immer noch Realität – ein Papierformular mit einer Bewertungsskala des Vorgesetzten, von Hand ausgefüllt und im Büro gescannt.
- Chat-Nachweise aus Slack und Teams. Das tägliche Lob und Coaching-Notizen, die ein Vorgesetzter zwischen formellen Zyklen sendet, erreichen nie die Beurteilungsakte, rechtfertigen aber oft das Rating, sobald die Kalibrierung beginnt. Diese Screenshots von Vorgesetzten-Feedback müssen zusammen mit den Beurteilungsdokumenten in die Tabelle gezogen werden, sonst hat das Rating keine Beweisgrundlage.
Das Problem ist die Mischung. Ein Batch von 150 Beurteilungen kann 80 Plattform-PDFs, 40 Word-Formulare und 30 Scans enthalten – und sie teilen weder ein Layout, eine Feldreihenfolge noch eine gemeinsame Terminologie für dieselbe Bewertung („4“, „Erwartungen übertroffen“ und ein Häkchen im Feld über „Erwartungen erfüllt“ bedeuten auf verschiedenen Formularen unterschiedliche Dinge). Ein Workflow, der für ein Format entwickelt wurde, übersteht den Kontakt mit drei Formaten nicht.
Die drei Dinge, die im Batch-Maßstab scheitern
Stapelverarbeitung ist nicht die Einzeldokument-Verarbeitung, die 150-mal ausgeführt wird. Es ist ein anderer Vorgang mit Fehlermodi, die es nicht gibt, wenn der Stapel nur ein PDF dick ist. Drei davon entscheiden, ob die Beurteilungssaison funktioniert oder zusammenbricht.
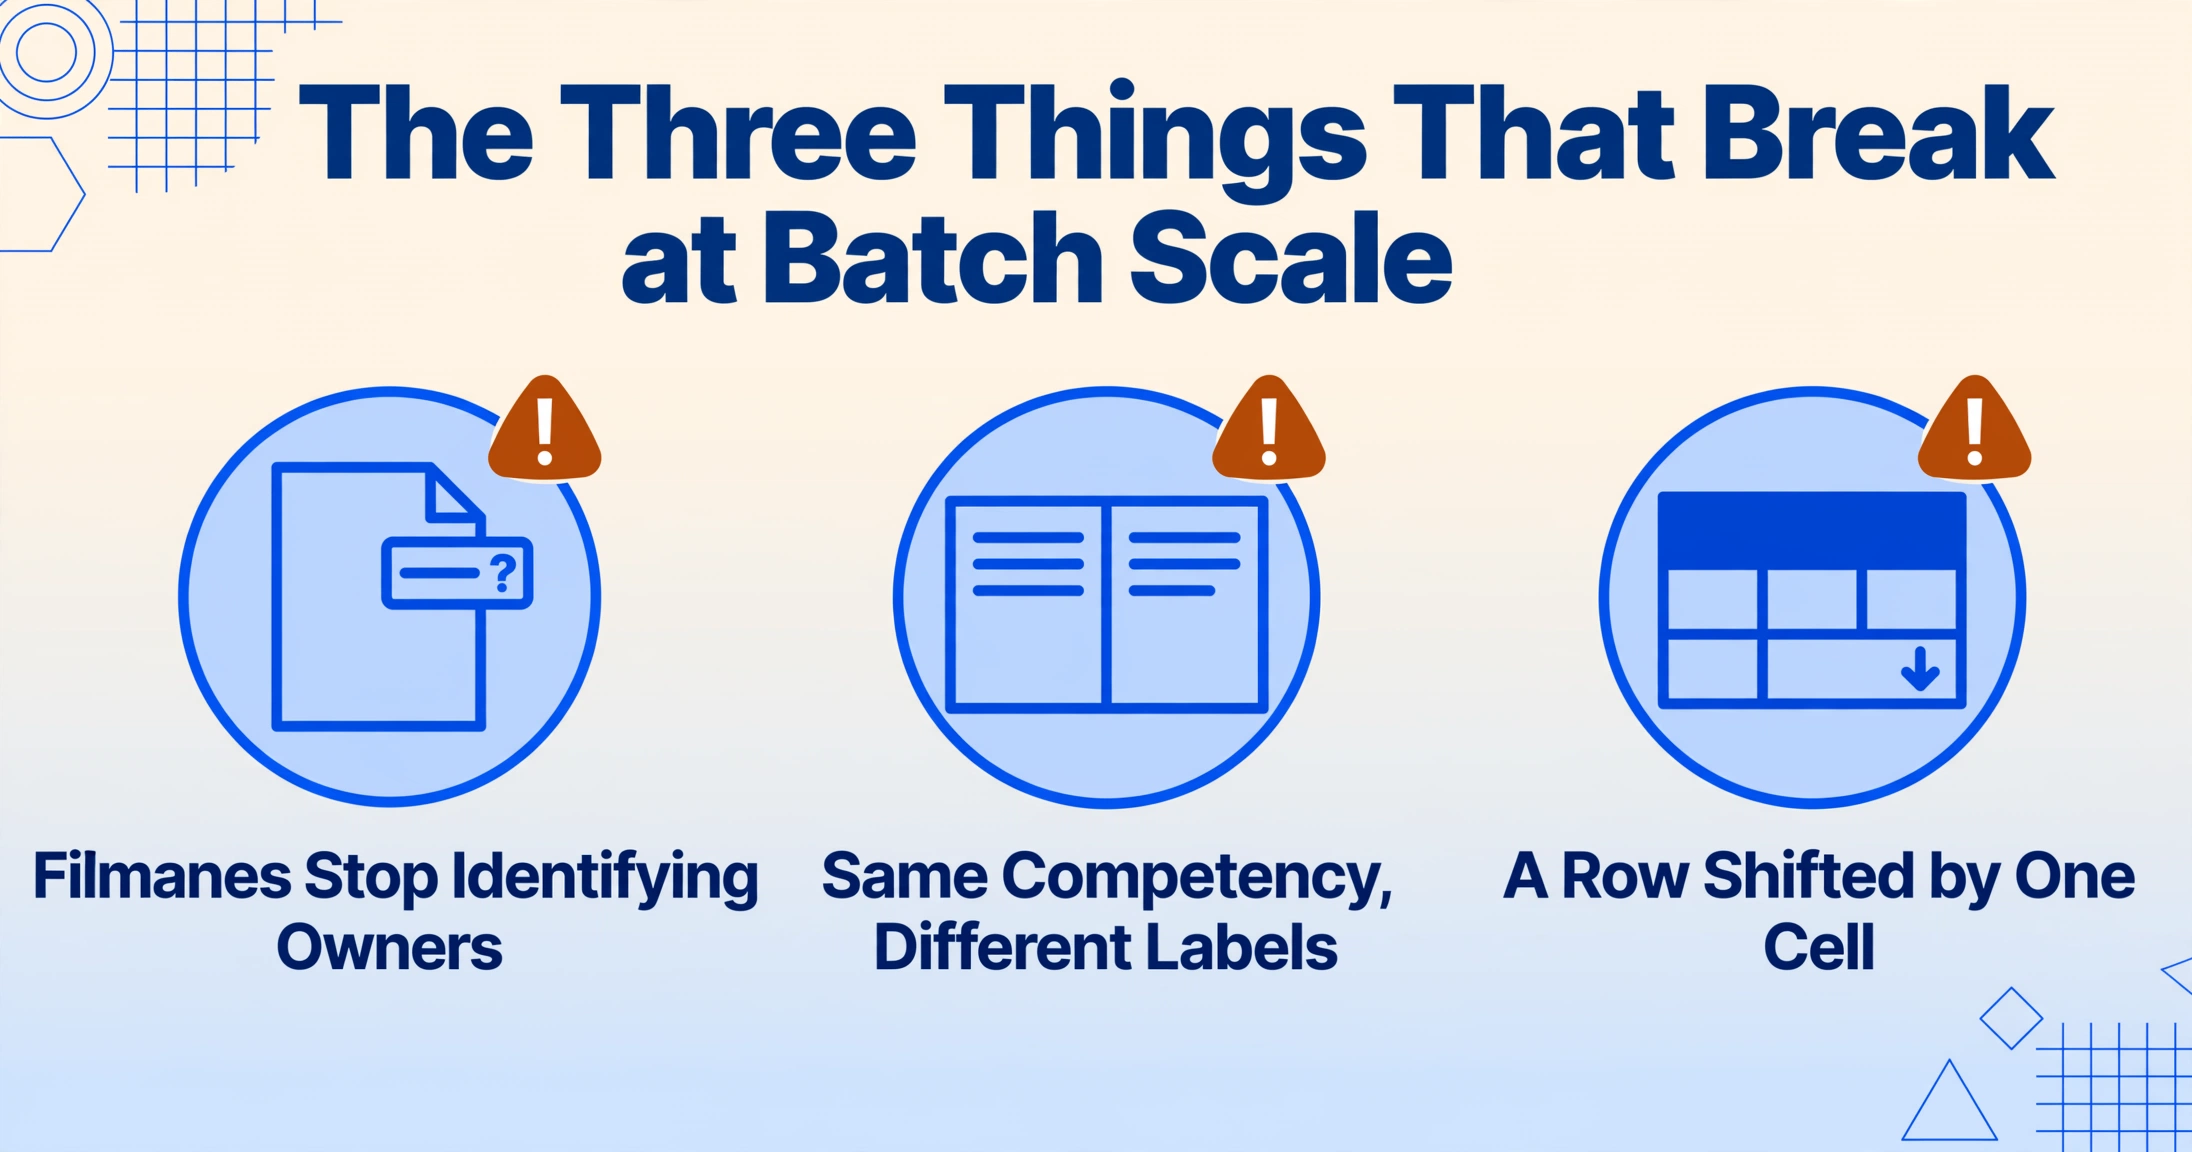
1. Das Benennungsproblem. Wenn drei Beurteilungen eintreffen, können Sie „Chen_2025_Review.pdf“ ohne Nachzudenken seinem Eigentümer zuordnen. Wenn 150 in einem gemeinsamen Drive-Ordner landen und die Hälfte der Dateinamen „Scan_2025-12-04_0071.pdf“ oder „Performance Review (1) (2) FINAL.pdf“ lautet, bricht die mentale Zuordnung zusammen. Sie öffnen Dateien nur, um sie zu identifizieren – und jede Datei, die Sie öffnen, um einen Namen zu prüfen, ist Zeit, die nicht in die Zusammenstellung der Tabelle fließt.
2. Das Problem der strukturellen Abweichung. Ein einzelnes Unternehmen hat selten nur eine Beurteilungsvorlage. Manager in verschiedenen Abteilungen fügen Abschnitte hinzu, überspringen die Selbsteinschätzung, schreiben eine Bewertung in das Kommentarfeld statt in das Bewertungsfeld oder verwenden „Kommunikation & Zusammenarbeit“, während ein anderer für dieselbe Kompetenz „Zwischenmenschliche Fähigkeiten“ verwendet. Im Einzeldokument-Maßstab gleichen Sie diese Unterschiede mental aus. Im Batch-Maßstab wird die mentale Übersetzung zu einem systematischen Fehler.
3. Das Konsolidierungsproblem. Selbst wenn jede Beurteilung sauber extrahiert wurde, haben Sie jetzt 150 Wertesätze – und was Sie brauchen, ist eine Tabelle, eine Zeile pro Mitarbeiter, Spalten ausgerichtet. Der Zusammenführungsschritt, in dem 150 Extraktionen zu einer einzigen Tabellenkalkulation mit übereinstimmenden Kopfzeilen werden, ist der Punkt, an dem Batch-Workflows zugunsten manueller Fallbacks aufgegeben werden. Es ist auch der Ort, an dem sich die stillen Fehler verstecken: eine um eine Zelle verschobene Zeile, eine Spalte, die unter der falschen Kopfzeile eingefügt wurde.
Diese drei Probleme sind der Grund, warum die Antwort auf die Beurteilungssaison nicht „schneller tippen“ lautet. Es ist ein Workflow, bei dem die Dokumente selbst zum Input werden und die ausgerichtete Tabelle der Output ist – ohne zwischengeschaltete Transkription, die Fehler einführen könnte.
Wie eine Spaltendefinition 150 Dokumente in eine Tabelle verwandelt
Der Mechanismus, der alle drei Batch-Hürden gleichzeitig bewältigt, ist die Benutzerdefinierte Spaltenextraktion: Sie geben die gewünschten Spaltennamen ein – „Mitarbeitername", „Gesamtbewertung", „Kommunikationswertung", „Beförderungsempfehlung" – und die KI findet jeden Wert auf jedem Dokument, indem sie versteht, was das Feld bedeutet, nicht wo es auf der Seite steht. Die von Ihnen eingegebenen Spaltennamen werden zu den Kopfzeilen der endgültigen Tabelle, sodass die Ausgabe von vornherein Ihrem Kalibrierungsformat entspricht.
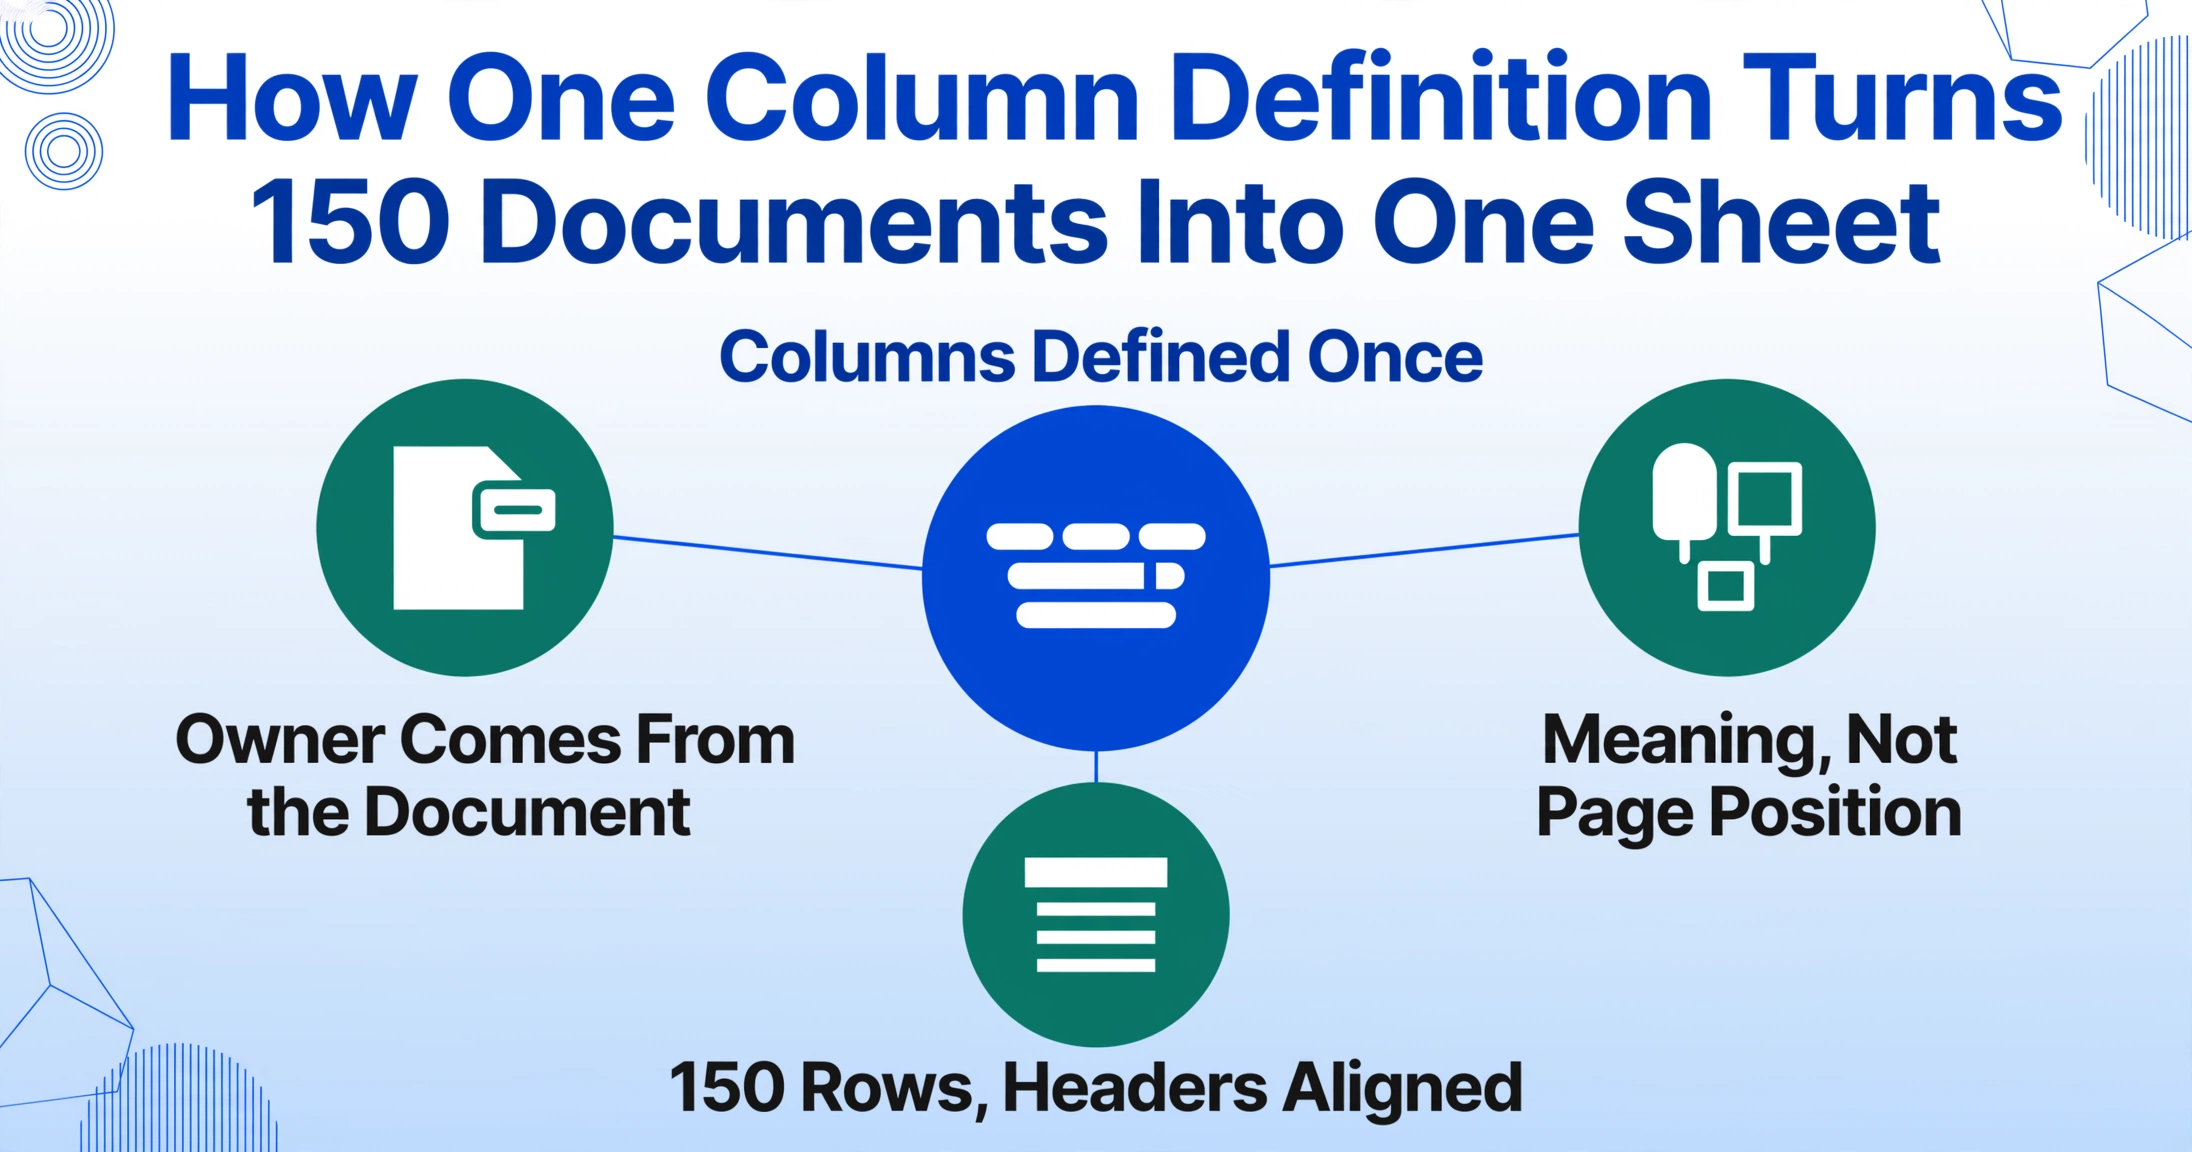
Da die Spaltendefinition für alle 150 Dokumente identisch ist, löst sich das Benennungsproblem auf: Jede Ausgabezeile enthält den Namen des Mitarbeiters als extrahiertes Feld, sodass Sie für die Rückverfolgbarkeit nie von Dateinamen abhängig sind. Auch das Problem der strukturellen Abweichungen löst sich auf: Ob eine Beurteilung „Kommunikation" oder „Zwischenmenschliche Fähigkeiten" sagt, die KI ordnet beides der von Ihnen benannten Spalte „Kommunikationswertung" zu, indem sie die Bedeutung erkennt. Und das Konsolidierungsproblem entsteht gar nicht erst – ein Batch, eine Tabelle, 150 Zeilen, alle Spalten ausgerichtet, weil sie am Anfang einmal definiert wurden.
Sie können sogar Spalten hinzufügen, die die Formulare nie ausdrucken. Eine berechnete Spalte wie „Gesamtwertung (Kommunikation + Zusammenarbeit + Produktivität + Qualität + Führung ÷ 5)" lässt die KI die Kompetenzwerte während der Extraktion mitteln, statt danach. Eine abgeleitete Spalte wie „Leistungsstufe (Optionen: Top/Stark/In Entwicklung/Verbesserungsbedürftig)" ordnet jeden Mitarbeiter während der Stapelverarbeitung Ihrer Bewertungsskala zu. Die Tabelle kommt mit der bereits erledigten Analysearbeit an – keine Formeln, kein zweiter Durchgang in Excel.
Dateien werden sicher verarbeitet und nicht gespeichert.
Wenn Sie die vollständige Feldliste und eine Schritt-für-Schritt-Anleitung zum Erstellen des Kalibrierungsblatts wünschen – einschließlich der Frage, welche Spalten extrahiert werden sollen und warum –, deckt der Leitfaden zur Extraktion von Leistungsbeurteilungen für die Talentkalibrierung den Prozess Dokument für Dokument ab. Dieser Artikel konzentriert sich darauf, was sich ändert, wenn Sie ihn bei 150 Dokumenten ausführen.
Was passiert mit den Ausnahmen in einem Batch
In einem Batch mit 150 Dokumenten ist „das durchschnittliche Dokument“ eine Fiktion. Bei einigen Beurteilungen fehlt die Selbsteinschätzung. Einige Manager haben die Beförderungsempfehlung leer gelassen. Ein paar gescannte Seiten haben eine Bewertung, die mit einem Stift eingekreist wurde und die der Scanner in einem Winkel erfasst hat. Batch-Workflows stehen und fallen mit der Behandlung dieser Ausnahmen – hier ist, was tatsächlich mit jeder einzelnen passiert.
Fehlende Felder bleiben leer, nicht erfunden. Wenn eine Beurteilung keine Kompetenzwertung enthält, bleibt diese Zelle in der Ausgabe leer – die KI erfindet keine Zahl, um sie zu füllen. Eine leere Zelle im Blatt ist ein ehrliches Signal für das Kalibrierungsgespräch („dieser Manager hat Zusammenarbeit nicht bewertet“); eine erfundene würde die Verteilung stillschweigend korrumpieren.
Rückverfolgbarkeit kommt von extrahierten Feldern, nicht von Dateinamen. Da „Mitarbeitername“ (und idealerweise „Mitarbeiter-ID“) Extraktionsspalten sind, ist jede Zeile unabhängig davon, wie die Datei benannt wurde, auf ihr Dokument zurückführbar. Wenn ein Manager eine Bewertung im Raum anficht, können Sie das Quelldokument in Sekunden öffnen, statt durch einen Ordner zu suchen.
Sie überprüfen die riskanten, nicht alle 150. Im Überprüfungsmodus hebt das Schweben über einer extrahierten Zelle genau hervor, woher dieser Wert auf dem Originalbild stammt – so dauert das Stichprobenprüfen der Wertungen, die Gehaltsentscheidungen speisen, Minuten statt Stunden. Dieselbe visuelle Verifizierungsebene ermöglicht es einem People-Team, einen Batch abzuzeichnen, ohne jedes Dokument vollständig erneut zu lesen.
Noch etwas Wissenswertes über Ausnahmen im Batch-Maßstab: Bewertungsskalen unterscheiden sich je nach Abteilung. Eine 1–5-Skala in der Technik und eine 1–10-Skala im Vertrieb erzeugen Zahlen, die nicht direkt vergleichbar sind. Normalisieren Sie die Gesamtbewertungsspalte, sobald die Daten im Blatt sind – ein Suchen-und-Ersetzen- oder Formeldurchlauf, keine Neuabtipp-Sitzung. Dieselbe Normalisierung gilt, wenn Ihr Zyklus „4“ mit „Erwartungen übertroffen“ mischt; ordnen Sie beide nach der Extraktion der numerischen Skala Ihres Bewertungsrasters zu.
Von 150 Zeilen zur Kalibrierungsagenda
Die Batch-Ausgabe ist nicht das Ergebnis — die Kalibrierungssitzung ist es. Doch das Tabellenblatt, das Sie in den Raum mitbringen, entscheidet darüber, ob die Sitzung über Belege oder über Eindrücke debattiert. Drei Prüfungen verwandeln 150 abgeglichene Zeilen in eine nutzbare Agenda.
Prüfen Sie die Verteilung gegen Ihre Zielkurve. Filtern Sie nach Leistungsstufe und zählen Sie, wie viele Mitarbeitende in jeder Stufe gelandet sind. Ein Unternehmen, bei dem 80 % des Teams „Top" sind, ist kein leistungsstarkes Unternehmen — es ist ein unkalibriertes, und das ist das erste Thema, das die Sitzung besprechen sollte.
Pivotieren Sie nach Manager, um Milde und Strenge aufzudecken. Fügen Sie eine Pivot-Tabelle ein, mit Manager als Zeilen und Durchschnitt der Gesamtwertung als Werte, und vergleichen Sie dann den Teamdurchschnitt jedes Managers mit dem Unternehmensdurchschnitt. Der Manager mit 4,6 gegen einen Unternehmensdurchschnitt von 3,9 ist Ihr Einstieg in die Kalibrierungsdiskussion — nicht weil sein Team schlecht ist, sondern weil seine Skala anders ist.
Erstellen Sie das Vorab-Lesepaket, bevor jemand den Raum betritt. Filtern Sie das Tabellenblatt auf die Mitarbeitenden, die jede Sitzung abdecken wird, und teilen Sie die relevanten Zeilen im Voraus — Bewertungen, Narrativ-Highlights, Beförderungsempfehlungen. Manager kommen an, nachdem sie die Belege bereits gesehen haben, und genau diese Dynamik mit dokumentierten Belegen hält Kalibrierungssitzungen fair statt eindrucksgetrieben.
Dieses Batch-Muster erstreckt sich über den gesamten HR-Dokumentenstapel. Derselbe Ein-Batch-zu-einer-Tabelle-Workflow, der die Beurteilungssaison konsolidiert, verarbeitet auch Angebotsschreiben und Verträge zu einer Mitarbeiterdatenbank, wenn Beförderungen zu Einstellungen werden, Onboarding-Formulare zu Mitarbeiterdatensätzen für die neuen Kollegen und Lebenslaufdaten zu Kandidaten-Tabellen, wenn der Personalplan Recruiting vorsieht. Definieren Sie die Spalten einmal; jeder Dokumenttyp folgt demselben Pfad.
FAQ
Kann ich Plattform-PDFs, Word-Formulare und gescannte Blätter in einem Stapel mischen?
Ja. Die Stapelverarbeitung erfordert keine Vorsortierung nach Format oder Layout. Sie definieren Ihre Spaltennamen einmal — Gesamtbewertung, Kommunikationswertung, Beförderungsempfehlung — und die KI liest jeden Dokumenttyp, indem sie die Bedeutung der Felder versteht. Plattform-PDFs, Word-Formulare und Scans durchlaufen denselben Stapel und landen in derselben ausgerichteten Tabelle. Mehrseitige PDFs werden Seite für Seite aufgeteilt und automatisch der richtigen Beurteilung zugeordnet.
Wie kann ich eine Zeile dem richtigen Mitarbeiter zuordnen, wenn die Dateinamen nur „Scan_001.pdf" lauten?
Nehmen Sie „Mitarbeitername" (und Mitarbeiter-ID, falls Ihre Formulare eine ausweisen) als Extraktionsspalten auf. Der Name wird aus dem Dokument selbst gelesen und erscheint in der Ausgabezeile, sodass die Rückverfolgbarkeit nie von Dateinamen abhängt. Wenn Sie eine zweite Redundanzebene wünschen, benennen Sie die Dateien vor dem Hochladen um — in der Praxis reicht das extrahierte Namensfeld jedoch aus, da Beurteilungen den Mitarbeiternamen fast immer gut sichtbar auf der ersten Seite angeben.
Was passiert, wenn einer Beurteilung eine Wertung oder ein Abschnitt fehlt?
Das fehlende Feld bleibt in der Ausgabe leer — die KI rät nicht. Eine leere Zelle ist ein ehrliches Signal, das Sie in der Kalibrierung behandeln können („dieser Vorgesetzte hat Zusammenarbeit nicht bewertet"), statt eines stillen Fehlers. Wenn das Blatt diese Fälle kennzeichnen soll, fügen Sie eine abgeleitete Spalte wie „Vollständigkeit der Beurteilung (Optionen: Vollständig/Teilweise)" hinzu, und die KI markiert jede Zeile während der Extraktion.
Verschiedene Abteilungen verwenden unterschiedliche Bewertungsskalen — kann ich sie trotzdem in einem Blatt vergleichen?
Die Extraktion erfasst jede Wertung so, wie sie auf dem Formular gedruckt ist, in einer eigenen Spalte. Zum Vergleich über Abteilungen hinweg normalisieren Sie die Spalte Gesamtbewertung, sobald die Daten vorliegen — ein einziger Suchen-und-Ersetzen-Vorgang oder eine Formel überführt die 1–10-Verkaufsskala in Ihr 1–5-Raster. Dieselbe Normalisierung ordnet Textwertungen wie „Erwartungen übertroffen" numerischen Werten zu. Das ist ein Fünf-Minuten-Durchgang über eine Spalte, keine Neuabtipp-Sitzung über 150 Zeilen.
Reviews müssen bis Freitag zur Kalibrierung vorliegen – wie lange dauert ein kompletter Batch?
Die Stapelverarbeitung läuft parallel: Dutzende bis Hunderte von Dokumenten werden gemeinsam verarbeitet und zu einer Ausgabetabelle zusammengeführt – in der Regel dauert das je nach Umfang und Dokumentlänge einige Minuten bis ein paar Stunden. Der praktische Engpass ist nicht die Extraktion, sondern die anschließende Stichprobenprüfung. Der Überprüfungsmodus hält diese auf wenige Minuten, indem Sie die extrahierten Werte direkt mit den Quellbildern abgleichen, statt jedes Dokument erneut zu lesen.
Werden Mitarbeiter-Leistungsdaten privat gehalten?
Dateien werden sicher verarbeitet und nach einem konfigurierbaren Aufbewahrungszeitraum automatisch gelöscht; aus Kunden-Uploads werden keine Trainingsdaten gespeichert. Die extrahierte Tabelle ist eine Datei, die Sie herunterladen und kontrollieren – das hält auch Zugriffs- oder Löschungsanfragen unkompliziert.
Die Tabelle ist der Ausgangspunkt, nicht das Ergebnis
Es gibt einen stillen Wandel, wenn ein People-Team aufhört, Reviews manuell zu übertragen, und stattdessen auf Stapelverarbeitung setzt. Die 8 bis 10 Stunden, die früher im Copy-Paste verschwanden, tauchen als etwas anderes wieder auf: Zeit, die tatsächlich damit verbracht wird, die Verteilung zu lesen, zu bemerken, dass das Team eines Managers im Schnitt einen ganzen Punkt über dem Unternehmensdurchschnitt liegt, und die Belege vorzubereiten, die das Kalibrierungsgespräch produktiv machen. Das Tippen war nie die eigentliche Aufgabe. Das Gespräch war es – und es kann nur so gut sein wie die Daten, die Sie in den Raum bringen.
Ein Batch, eine Tabelle, jede Bewertung und jeder Kommentar an Ort und Stelle – genau das macht die Review-Saison zu einer Saison statt zu einer Belagerung. Laden Sie eine Handvoll Ihrer echten Review-Dateien hoch und sehen Sie zu, wie 150 Dokumente in einem einzigen Durchgang zu einer Kalibrierungstabelle werden.