業績評価をExcelに抽出して
人材キャリブレーションに活用する方法
人材キャリブレーションセッションの成否は、誰かが会議室に入る前に決まっています。SHRMの調査によると、人事担当者の54%が組織で正式なキャリブレーションセッションを実施していると回答し、69%が「評価の不一致」を、マネージャー同士が評価を比較した際に評価が変更される最も一般的な理由として挙げています(SHRM)。会議で修正できるのは、スプレッドシートが取得できた範囲だけです。
重要なポイント
- 120人分の評価サイクルでは、キャリブレーション準備を始める前に転記に8~10時間かかります。これは誰も予算化していない項目です。
- 給与や昇進の決定は、誰も監査していないスプレッドシートに基づいて行われます。評価数値を1つ誤入力するだけで、従業員が属する業績ランクが変わってしまいます。
- 列を一度定義してすべてのドキュメントをドロップするだけで、総合スコアとパフォーマンス階層がすでに計算されたシートが作成され、会議開始前にピボットできる状態になります。
キャリブレーションのボトルネックは判断ではなくデータの組み立て
タレントキャリブレーションの目的は、マネージャー間で業績評価を標準化することです。チーム全体の平均が4.6なのに会社全体の平均が3.9というマネージャーを見つけ出し、エンジニアリングでの「4」と営業での「4」が同じ意味になるようにすることです。すべてのレビューが1枚のシートに、従業員ごとに1行で、比較可能なフィールドとして揃うまでは、そのどれも実現できません。
その組み立てのステップこそ、プロセスが静かに失敗するところです。CEB(現在はガートナーの一部)によると、マネージャーは年間平均210時間をパフォーマンス管理活動に費やしており、従業員もそれぞれ年間40時間を費やしています。一方、人事幹部の77%が、レビューが従業員の貢献を正確に反映していないと回答しています(SHRM/CEB)。その210時間の大きな部分は、フィードバックを書くことではありません。収集することです。レビューのエクスポート、フォームの印刷、評価のサマリーワークブックへの再入力。そして、数字が少しでもずれていれば、誰かがすぐに疑問を呈するのです。
解決策は、会議室にもっと判断を持ち込むことではありません。会議室の下に信頼できるデータ層を築くことです。そしてその層は、レビュードキュメントを転記の試練なしにスプレッドシートに変換することから始まります。
業績レビューデータが実際に存在する場所
何かを抽出する前に、レビューサイクルが実際に何を生み出すかを知っておくと役立ちます。パフォーマンスソフトウェアを導入している企業でも、すぐに使えるキャリブレーションシートを渡してくれる「すべてエクスポート」ボタンが1つあるというケースはまれです。実際には、データは少なくとも4つの形で届きます。
- プラットフォームのエクスポート。Workday、Lattice、15Five、BambooHRはいずれも管理者がサイクルデータを取得できますが、エクスポートされるのは通常、質問と回答の生のダンプであり、従業員ごとのサマリー行ではありません。たとえばCulture Ampは、サイクルデータをCSVまたはXLSXとしてエクスポートしますが、キャリブレーション形式に合わせるにはまだ再整形が必要です(Culture Ampサポート)。
- レビューごとのPDF。一部のプラットフォームは、各レビューを個別のPDFとしてのみエクスポートします。従業員ごとに1ファイルで、多くの場合50件単位で配信されます。それはドキュメントのフォルダーであって、データセットではありません。
- WordおよびGoogle ドキュメントのフォーム。中規模のチームの多くは、今でも共有フォームテンプレートでレビューサイクルを運用しています。マネージャーがドキュメントに記入し、署名し、メールで返送します。人事部門は、それぞれ編集状態が少しずつ異なる添付ファイルの受信箱を抱えることになります。
- スキャンまたは手書きの評価シート。製造業、小売業、現場業務では今でも現実にあります。マネージャーが紙のフォームに記入し、人事部門がデジタル化しますが、その「デジタル化」は通常、再入力です。
万能のエクスポートボタンは存在しません。ドキュメント自体が真実の源泉だからです。形式はマネージャーがたまたま使ったもの次第です。だからこそ、多くのチームで組み立てのステップが手作業になってしまうのです。
正式なドキュメントと並んで、証拠の多くはチャットから出ることはありません。マネージャーがSlackのDMやTeamsのチャンネルで送る日々の称賛、懸念、コーチングメモは、キャリブレーションの場で評価を正当化する材料になることがよくあります。そして、こうしたマネージャーフィードバックのスクリーンショットも、レビューフォームと同じくらい再入力が発生しやすいのです。
手動組み立てが人事チームに与えるコスト
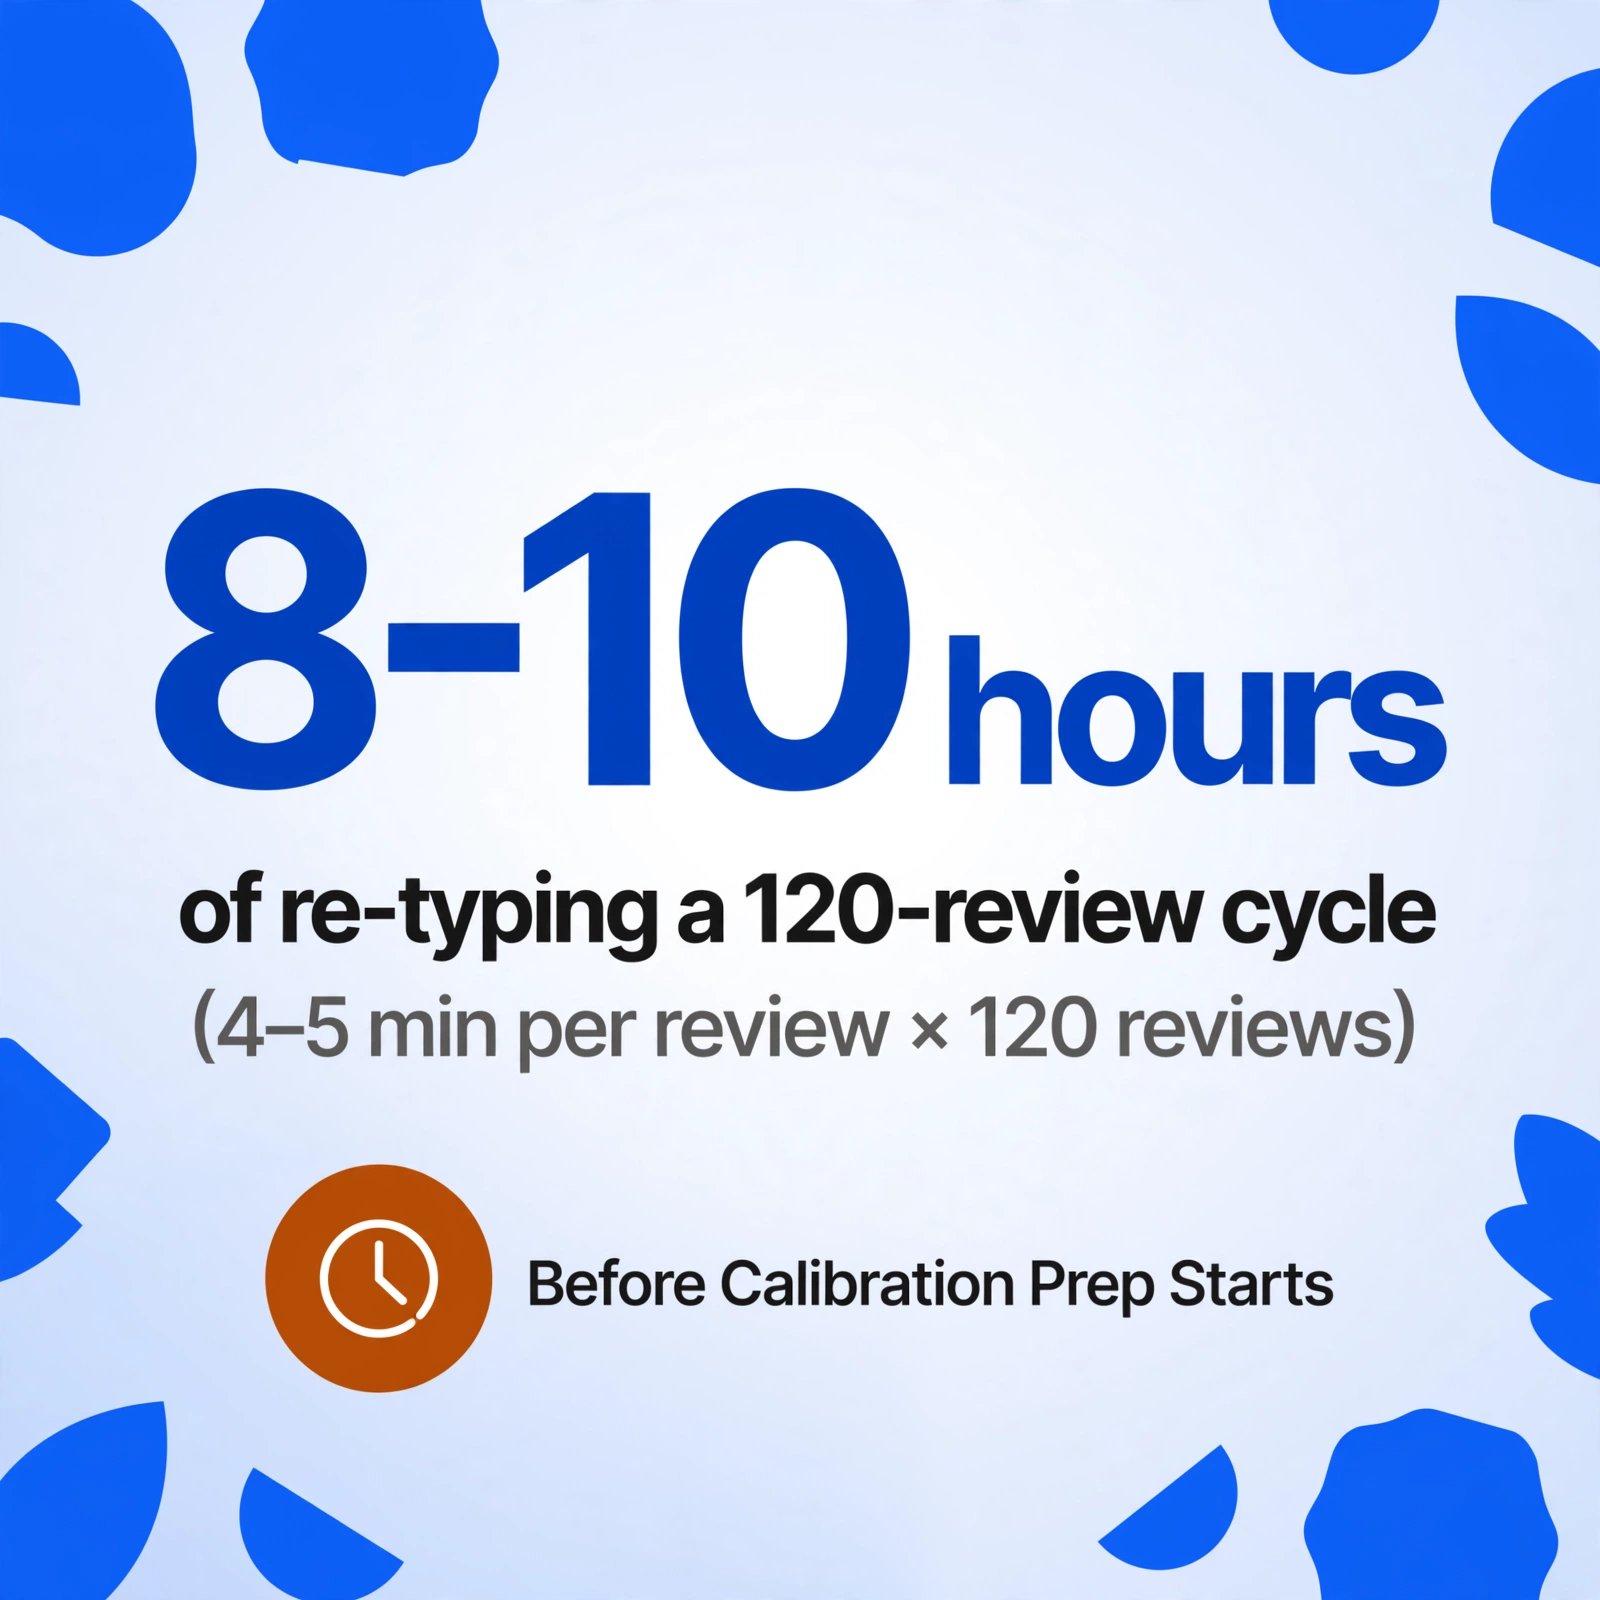
誰も予算化していない計算があります。人事オペレーションのスペシャリストが120人分の評価サイクルをまとめる場合、評価1件につき約4〜5分かけて基本情報(従業員名、部署、マネージャー、総合評価、5つのコンピテンシースコア、昇進推薦)を再入力し、物語セクションに引き継ぐ価値がある部分がないかざっと目を通します。120件の場合、校正準備が始まる前に8〜10時間の転記作業が発生します。
時間は目に見えるコストです。目に見えないコストは、入力ミスが後工程に与える影響です。数字の桁を間違えて4.2が4.7になれば、従業員が属する等級が変わります。「改善点」の行を飛ばせば、成長のための会話が間違った前提から始まります。校正シートが報酬や昇進の決定に反映されるとき、キー入力のミスには必ず名前が紐づいています。
さらに深刻な問題は、手動入力が最も起こりやすい状況で最もミスが多くなることです。サイクルの終盤、固定されたセッション日の直前、全員が疲弊しているときです。そんなとき、転記ミスはまれな例外ではなく、系統的な問題になり始めます。
本当のコストは入力速度ではありません。スプレッドシートが給与・昇進・後継者育成の決定における唯一の情報源になり、それを構築した入力作業を誰も監査しないことです。
校正スプレッドシートの設計:抽出すべき項目
スプレッドシートの役割は、評価の違いを可視化して比較可能にすることであり、すべてのレビューの全文章をアーカイブすることではありません。すべてを抽出するチームはセッション中ずっとスクロールし、適切な項目を抽出するチームは意思決定に時間を使います。(実際の動作を確認したい場合は、パフォーマンスレビューデータのExcel抽出ツールページで同じ列をライブデモとともに確認できます。)
| フィールド | シートに含めるべき理由 |
|---|---|
| 従業員名 / 従業員ID | 主要な識別子。同じ名前の従業員が2人いる場合、IDが重要になります。 |
| 部署 / マネージャー | キャリブレーションの2つの軸:チーム別の分布と、マネージャーごとの甘辛チェック。 |
| 評価期間 | 複数サイクルのシートの整合性を保ちます — 昨年の4.0は今年の4.0ではありません。 |
| 総合評価 | フォームに記載されたまま取得 — 1~5の評価尺度で4.2、「期待を上回る」など、フォームが使用する形式のまま。抽出後にExcelで尺度を正規化してください。 |
| コンピテンシースコア | コンピテンシーごとに1列(コミュニケーション、コラボレーション、生産性、品質、リーダーシップ)。列を分けることで、評価ギャップの原因が明確になります。 |
| 総合スコア | 計算列:AIが抽出時にコンピテンシースコアを平均するため、後処理なしで単一の比較可能な数値が得られます。 |
| パフォーマンス階層 | 推論列:AIが各評価をあなたのルーブリック(Top / Strong / Developing / Needs Improvement)にマッピングします。フォームに階層が印刷されていなくてもです。 |
| 昇進推薦 | 後継者計画に直結するフィールド — そして会議で最も異議を唱えられる可能性が高いフィールドです。 |
| 強み / 改善点 / 成長目標 | 記述式のテキスト列。すべての文章は必要ありません — 成長計画を変える文章だけが必要です。 |
| ハイポテンシャルフラグ | 後継者育成のための推論列:AIが、あなたが定義した基準に基づき、より広い範囲への準備ができていると評価された従業員にフラグを立てます。 |
これらの列のうち2つは、どのフォームにも存在しないため特別な注意が必要です。パフォーマンス階層とハイポテンシャルフラグは推論列です — 列名に希望するオプションを入力するだけで(例:「パフォーマンス階層(オプション: Top/Strong/Developing/Needs Improvement)」)、AIが各レビューを読み取り、抽出時にカテゴリを割り当てます。数式もExcelでの再処理も不要です。また、総合スコアは計算列です:列名に計算方法を記述するだけで(「総合スコア(コミュニケーション + コラボレーション + 生産性 + 品質 + リーダーシップ ÷ 5)」)、AIがスコアを読み取りながら計算を実行します。
ステップバイステップ:レビューをキャリブレーションシートに変換する
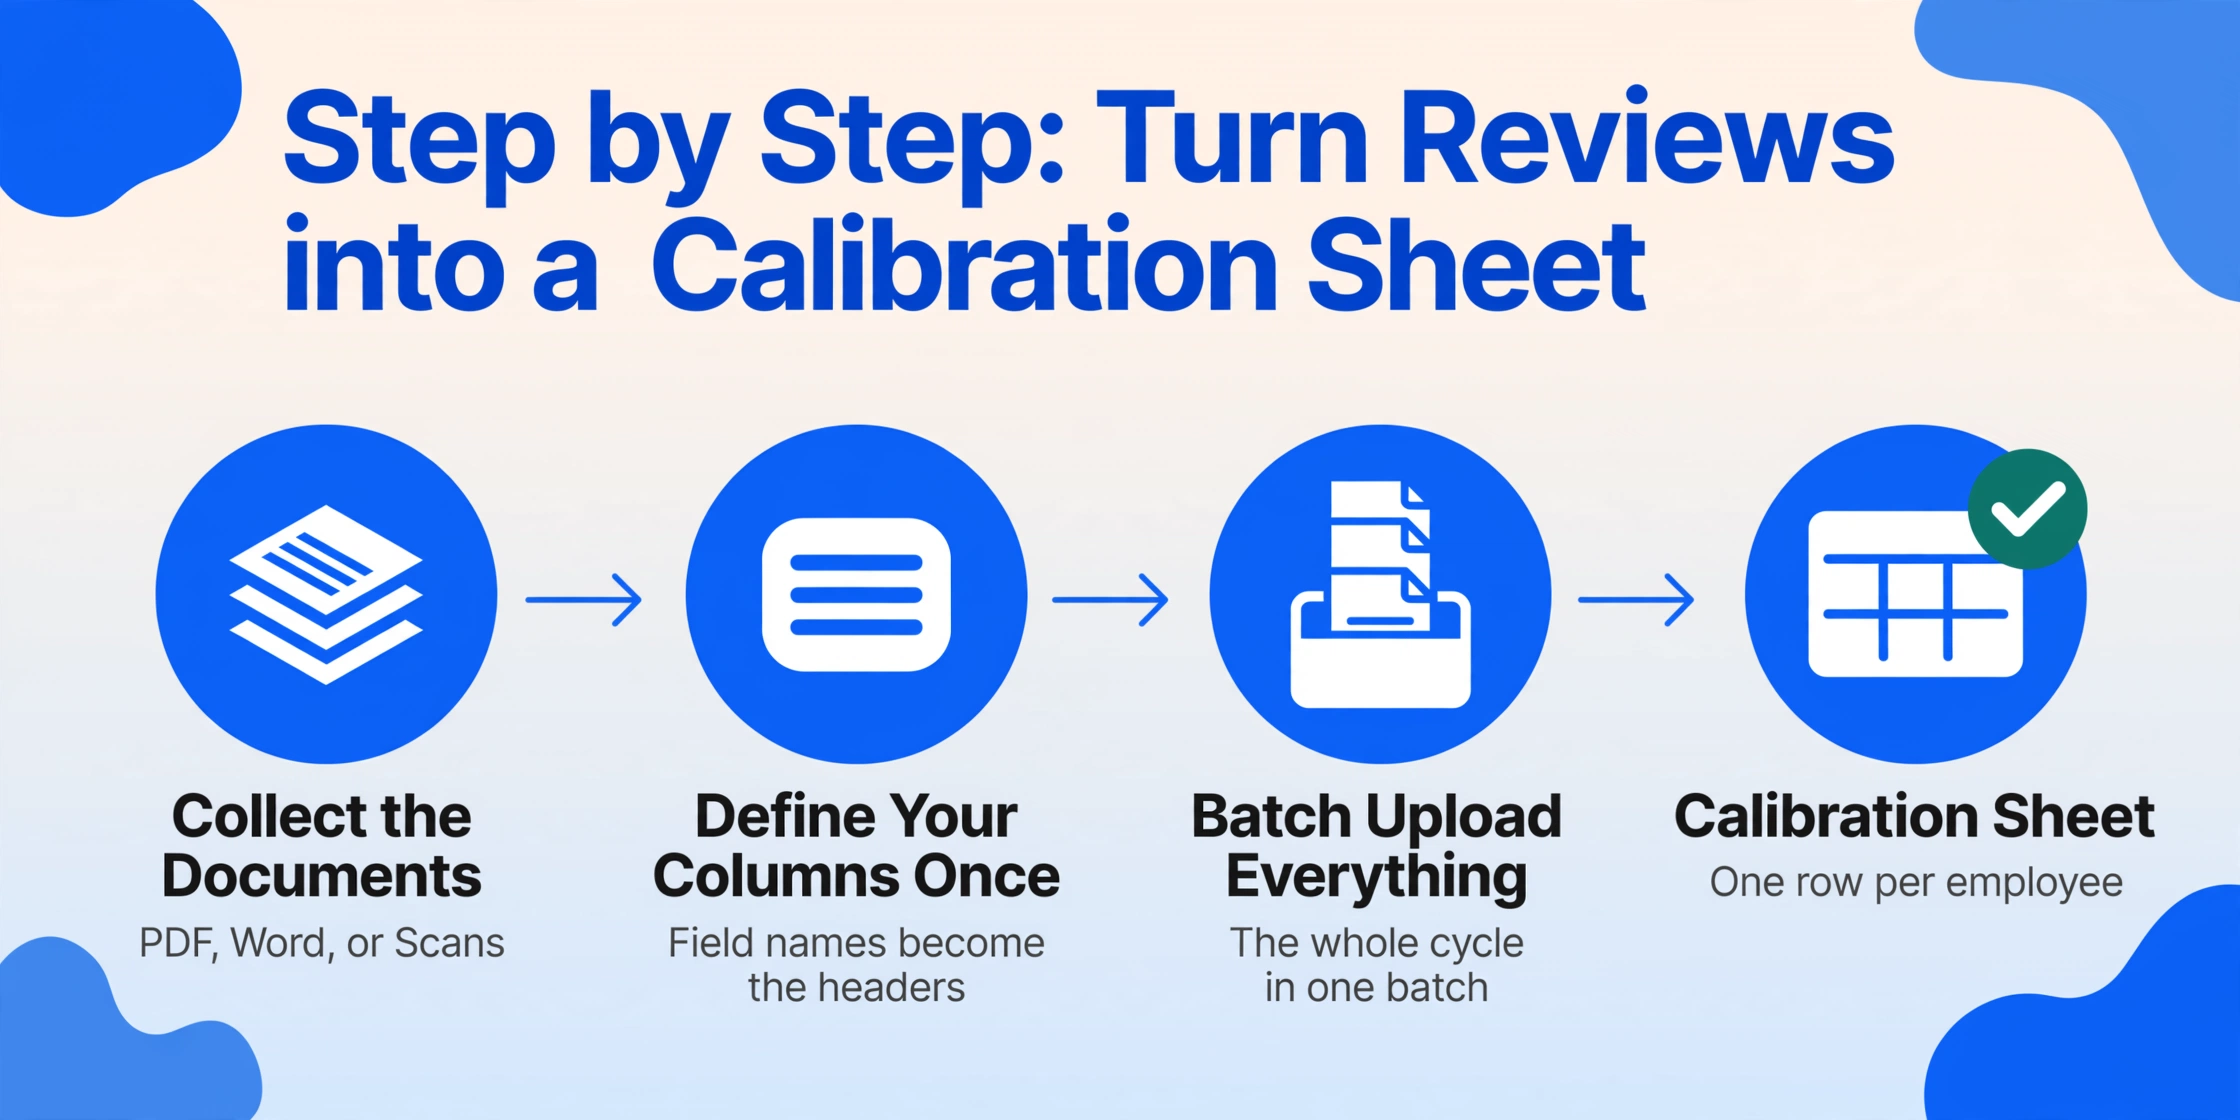
以下のワークフローは、評価サイクルで生成された成果物(プラットフォームのPDFエクスポート、Wordフォーム、スキャン済みシート、またはそれらの混合)に関係なく機能します。このワークフローはカスタム列抽出に基づいています。抽出したいフィールド名を入力すると、AIが各ドキュメント上の各値を、その値がどこにあるかではなく、フィールドの意味を理解して特定します。入力した列名が出力スプレッドシートのヘッダーになるため、シートはキャリブレーション形式に自動的に一致します。
ステップ1:レビュードキュメントを収集する
すべてを1か所に集めます。プラットフォームからのPDFエクスポート、完成したWordまたはGoogle ドキュメントのフォーム、紙の評価表のスキャンなどです。まだメールでレビューを送ってくるマネージャーがいる場合は、コレクションリンク(ファイルを処理キューに直接ドロップできる共有可能なアップロードページ)またはメール受信箱(専用アドレスにレビューを転送すると自動的にキューに追加されます)を使用すれば、「レビューをメールで送ってください」と追いかける手間が省けます。採用向けの履歴書データ抽出で説明したのと同じ収集パターンがここでも当てはまります。他の人はアカウントを持つ必要がなく、ファイルを送信するだけです。
ステップ2:列を一度定義する
上記のセクションのフィールドリストを、ご自身の評価サイクルに合わせて調整して入力します。列名は「総合評価」「コミュニケーションスコア」「昇進推薦」のように平易な言葉で指定し、2つの派生列(「パフォーマンス階層」「総合スコア」)を追加します。これはサイクルごとに一度定義するだけで、同じ設定は次回以降のテンプレートとして保存できます。
ステップ3:すべてを一括アップロード
すべてのドキュメントを1つのバッチにドロップします。形式もレイアウトも混在していて、事前の仕分けは不要です。複数ページのPDFはページごとに分割され、自動的に正しいレビューに照合されます。120件のレビューを1つのバッチにすると、1つのテーブルが生成されます。従業員ごとに120行、すべての列が整列された状態です。
ファイルは安全に処理され、保存されることはありません。
ステップ4:派生列で分析準備を完了させる
パフォーマンス階層と総合スコアは抽出時に計算されるため、シートにはすでに難しい作業が完了した状態で届きます。各従業員には階層と比較可能なスコアが設定され、数式を1つも書く必要はありません。部署ごとに評価尺度が異なる場合(ここでは1~5、あちらでは1~10)は、データ出力後にExcelで総合評価列を正規化してください。これは5分で終わる置換作業であり、入力し直す作業ではありません。
ステップ5:会議前にスポットチェック
キャリブレーションセッションの前に、簡単な検証パスを実行してください。レビューモードで抽出されたセルにカーソルを合わせると、元のドキュメントの該当箇所がハイライト表示され、その値がどこから来たのかが正確にわかります。そのため、会議の場でマネージャーが評価に異議を唱えた場合でも、フォルダーを探し回らずに数秒で出典を示せます。レビューモードは、給与の話に進む前に誤入力された数字を発見する場でもあります。
ステップ6:エクスポートとピボット
Excel(XLSX)にエクスポートすれば、キャリブレーションシートが完成します。従業員ごとに1行、ピボット可能な列が用意されています。このシートは、セッション自体の作業用ドキュメントになります。
生のシートからキャリブレーションセッションへ
シートの目的は、セッションの作業を開始前に可視化することです。3つのチェックで、生の行がキャリブレーションの議題に変わります。
ターゲットカーブに対する分布を確認します。HRコンサルタントのDick Grote氏がよく引用するベンチマーク分布では、優秀な業績者が従業員の50~60%、上位層が5~10%、下位層が2~5%とされています(SHRM)。パフォーマンス階層でフィルタリングして数を数えてください。従業員の80%が「Top」の会社は、高業績企業ではなく、キャリブレーションされていない企業です。
マネージャー別にピボットして、寛大さと厳格さを見つけます。マネージャーを行、総合スコアの平均を値とするピボットテーブルを挿入し、各マネージャーのチーム平均を会社平均と比較します。会社平均が3.9のところ、4.6のマネージャーが最初のキャリブレーションの議論の対象です。チームが悪いからではなく、評価尺度が異なるからです。
階層と部署ごとに事前読了パケットを作成します。セッションで議論する従業員にシートを絞り込み、関連する行(評価、物語のハイライト、昇進推薦)を事前に共有します。マネージャーは証拠をすでに見た状態で到着します。これこそが、キャリブレーションセッションを印象ベースではなく、文書化された証拠に基づく生産的なものにする原動力です。
このシートを構築したのと同じ抽出ワークフローは、HRドキュメントスタックの他の部分にも拡張できます。オンボーディングフォーム抽出ガイドでは、オンボーディング書類から構造化された従業員レコードを抽出する方法を、バッチ給与明細抽出ガイドでは、監査用の給与ドキュメントに適用するパターンを、バッチオファーレター処理では、キャリブレーションで決定された昇進を契約レコードに変換する方法を説明しています。1つの列定義アプローチで、多くのドキュメントタイプに対応できます。
位置ベース解析がレビューフォームで失敗する理由
業績レビューフォームは、従来のOCRにとって最悪のレイアウトです。評価表には結合セルと列チェックボックスがあります。コンピテンシーはリッカート尺度のグリッドとして配置されており、行ごとに5つの円が並びます。各セクションの下にはコメントボックスがあり、マネージャーはボックスが許す長さで自由に記入します。スキャンした用紙では、評価が手書きで記入されることもあります。
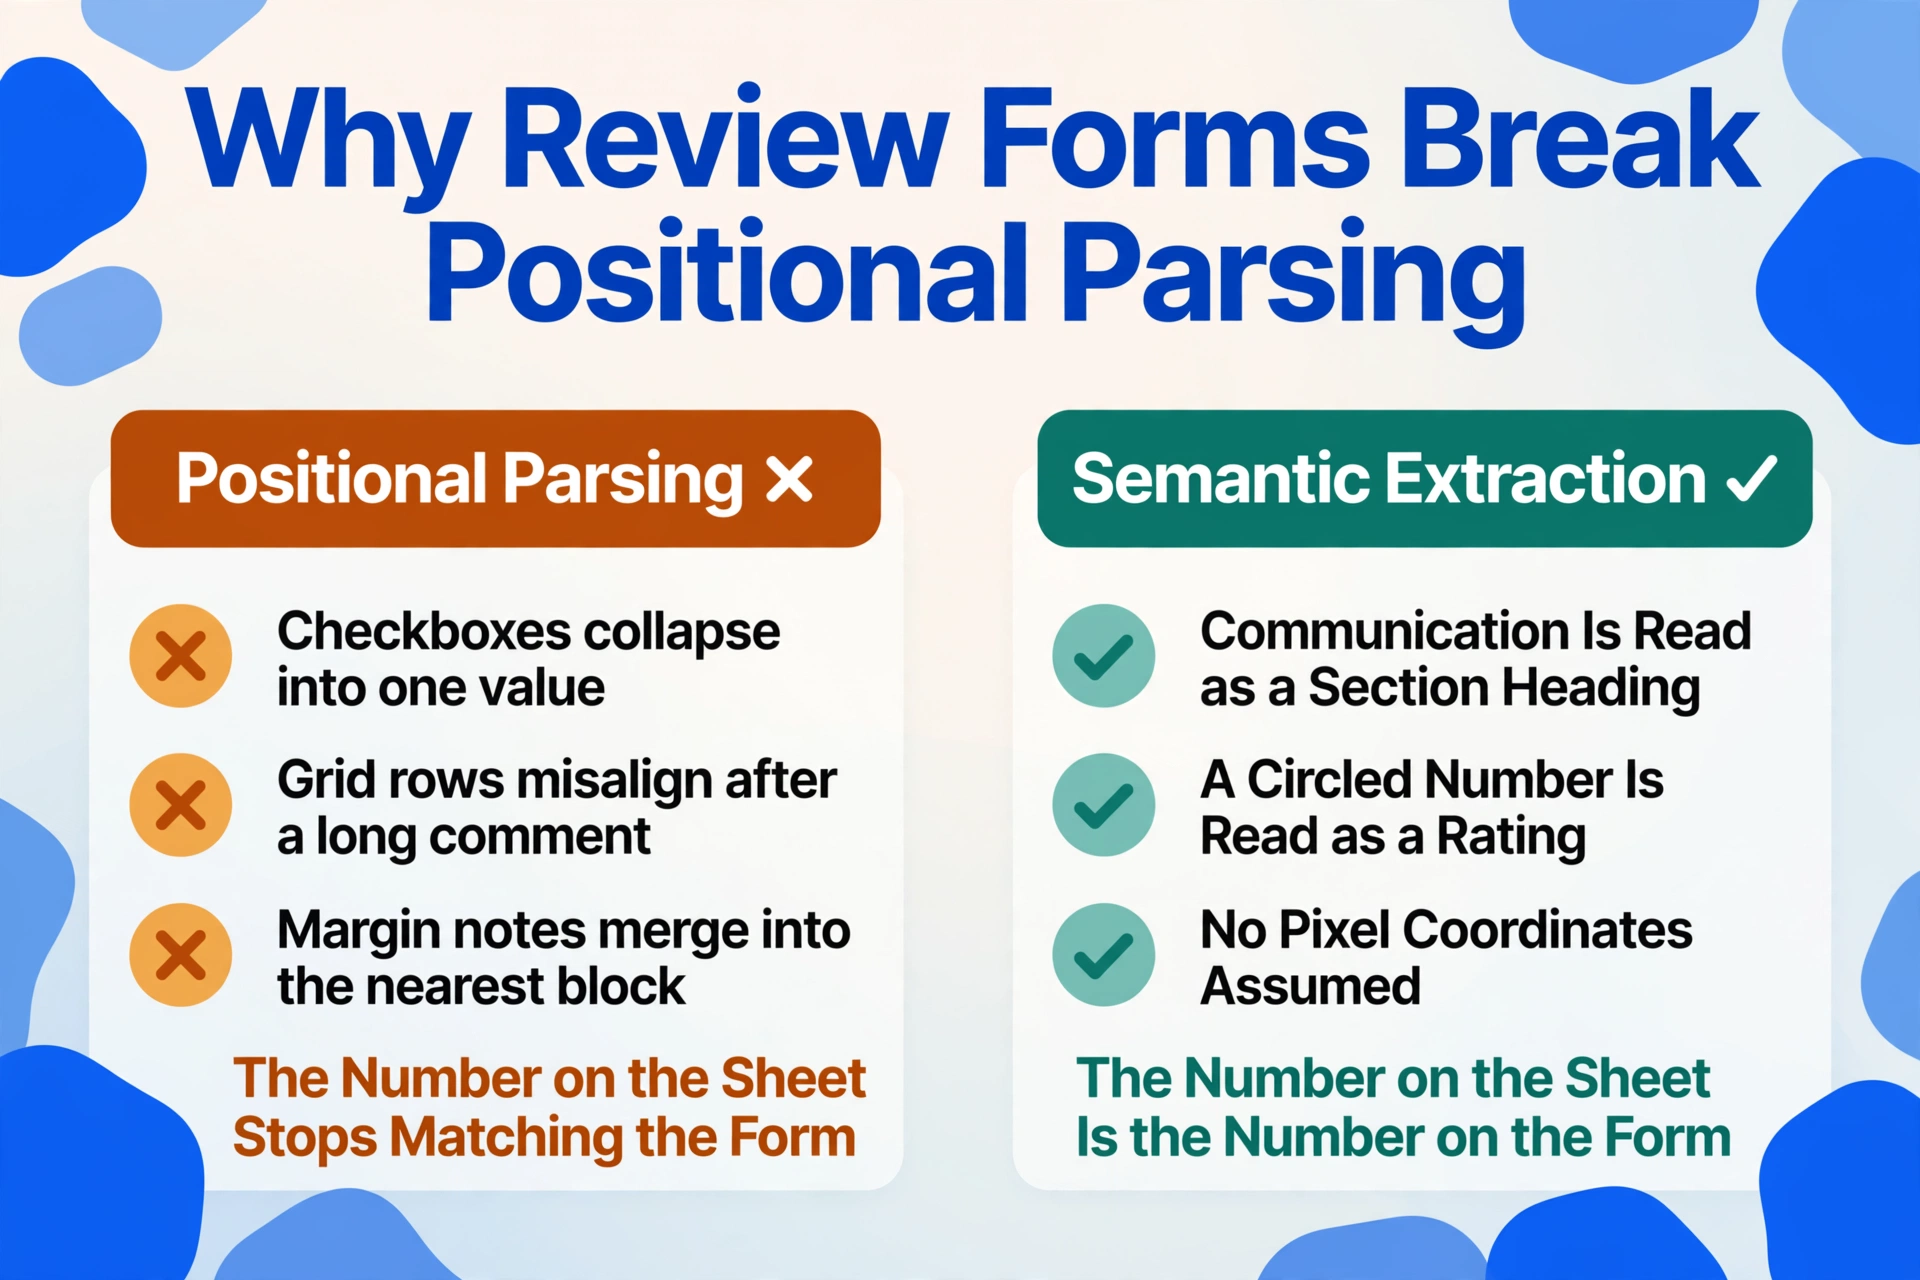
位置ベースのパーサー(期待される座標でテキストを探すタイプ)は、これによって特定の方法で失敗します。チェックボックス列は単一の値に折りたたまれ、長いコメントの後にグリッド行がずれ、手書きの余白メモは最も近いテキストブロックに統合されます。セマンティック抽出は、値がどこにあるかを想定しないため、この種の失敗をすべて回避します。AIは「コミュニケーション」をセクション見出しとして読み取り、その下の行がコミュニケーションスコアであることを認識し、グリッド内の丸で囲まれた数字が評価であることを、ピクセル位置ではなく意味で理解します。
これは、データが議論そのものであるため、HR領域ではほとんどの領域よりも重要です。r/humanresourcesのスレッドでは、実務者が1~5の評価尺度で4と5をどう区別するか、「期待を上回る」には成果量が必要か、質が必要か、その両方なのかを議論しています(r/humanresources)。経験豊富なHR担当者が評価の意味について意見が分かれるのであれば、抽出レイヤーは少なくとも議論の余地がないものでなければなりません。用紙上の数字は、フォーム上の数字でなければならないのです。
正直な限界:きれいな印刷フォームは、チェックボックスや評価グリッドを含めて確実に抽出できます。コメントボックス内の密集した手書き文字は信頼度が低くなります。手書きのみの評価は追加の手動レビューが必要とみなし、レビューモードで検証してください。
機微データ:法的根拠、保持期間、公平性
人事評価は雇用記録であり、そこから作成するスプレッドシートは個人データのデータセットです。そのため、ワークフローの進め方が変わります。これを怖がらせるためではなく、防御可能な形でファイルを構築できるようにするためです。
GDPRの下では、業績データの処理は通常、雇用上の必要性または正当な利益を法的根拠とし、従業員は自分のデータにアクセスする権利(第15条)と不正確な情報を訂正してもらう権利(第16条)を保持します。つまり、抽出されたすべての値の出所の追跡可能性が重要になり、過去の評価サイクルの保持期間は放置して蓄積させるのではなく、定義して実行する必要があります。米国では、評価が昇進や報酬の決定に影響する場合、EEOCの差別的影響に関する枠組みが適用されます。フィルタリングする基準(階層、総合スコア)は職務関連であるべきで、キャリブレーションプロセス自体(誰がレビューしたか、どのような根拠か)を文書化する必要があります。
運用面では、スプレッドシートのパイプラインは透明性があるため防御可能です。キャリブレーションに必要なフィールドのみを抽出し(データ最小化)、会議の前にレビューモードでソース文書と照合して値を検証し、各数値の出所を監査可能な形で記録します。従業員が削除や訂正を要求した場合、管理下にあるファイルの行を編集するだけです。ベンダーのデータベースを解きほぐす必要はありません。
FAQ
手書きの人事評価フォームも読み取れますか?
印刷または入力されたフォーム(チェックボックス、評価グリッド、コメント欄を含む)は確実に抽出できます。構造化されたフォーム(ラベル付きフィールドのある紙の評価シートなど)の読みやすい手書き文字も問題なく抽出できます。非構造化ボックス内の密集した筆記体は信頼性が低くなるため、手動でレビューする必要があります。AIが低信頼度の領域にフラグを付けるので、どこを確認すべきかがわかります。
評価はすでにLattice、Workday、15Fiveにあるのですが、それでも抽出は必要ですか?
プラットフォームがキャリブレーションに必要なすべてのフィールドを含む従業員別のサマリーをエクスポートできる場合は、そのエクスポートを使用してください。抽出はそこでは何も追加しません。しかし、プラットフォームのエクスポートは多くの場合、質問ごとのダンプやレビューごとのPDFであり、それでも組み立てが必要です。また、プラットフォーム外でWordやGoogle ドキュメントのフォームを使用しているチームには、エクスポート機能がまったくありません。抽出は、プラットフォームが提供するものとキャリブレーションシートが必要とするものの間のギャップを埋めます。
コンピテンシーをまたいだ総合スコアを計算できますか?
はい。計算列として「総合スコア(コミュニケーション+コラボレーション+生産性+品質+リーダーシップ÷5)」のように定義すると、AIが処理中に抽出したコンピテンシースコアを平均し、結果が新しい列としてシートに表示されます。Excelの数式は不要です。バッチ全体に対して一度の処理で実行されます。
評価をパフォーマンス階層に分類できますか?
はい、推論列で対応できます。「パフォーマンス階層(選択肢:Top/Strong/Developing/Needs Improvement)」と入力すると、AIが各従業員の評価と定義したカテゴリに基づいて階層を割り当てます。フォーム自体に階層が印刷されていなくても問題ありません。ラベルと基準を設定すれば、分類済みのシートが完成します。
一度に何件のレビューを処理できますか?
バッチアップロードでは、1回のセッションで評価サイクル全体を処理できます。数十件から数百件のドキュメントが並列処理され、従業員ごとに1行の単一の出力テーブルに統合されます。マルチページのPDFは自動的に分割・照合されるため、40ページのサイクル書き出しでも手動でのページ処理は不要です。
従業員のパフォーマンスデータはプライバシーが保護されますか?
ファイルは処理後、設定可能な保持期間を経て自動的に削除され、顧客のアップロードからトレーニングデータが保持されることはありません。抽出されたスプレッドシートはお客様が管理するファイルに保存されます。そのため、アクセス要求や削除要求への対応も簡単です。
人材キャリブレーションは、会議に持ち込んだデータでのみ機能します。そのデータがPDFやフォームのフォルダに眠ったままだと、セッションは最初から不利な立場で交渉することになります。どんなに優れたファシリテーションスキルでも、そもそも作られていないスプレッドシートを修正することはできません。
次期サイクルのシートをドキュメント自体から作成しましょう。実際のレビューファイルを数件アップロードすれば、キャリブレーションテーブルが数秒で完成します。評価、コンピテンシー、階層、フィードバックが一度に抽出され、誰かが「4.2」について議論を始める前に、ソースと照合されます。