Comment extraire les évaluations de performance dans Excel
pour l'étalonnage des talents
Une séance d'étalonnage des talents se gagne ou se perd avant même que quiconque entre dans la salle. Dans une enquête de SHRM, 54 % des professionnels des RH ont déclaré que leur organisation organise des séances d'étalonnage formelles — et 69 % ont cité des notes incohérentes comme la raison la plus courante pour laquelle les notes sont modifiées lorsque les managers comparent leurs constats (SHRM). La réunion ne peut corriger que ce que le tableur a réussi à capturer.
Points clés
- Un cycle d'évaluation de 120 personnes coûte 8 à 10 heures de transcription avant même que la préparation de l'étalonnage ne commence — une ligne de dépenses que personne ne budgète.
- Les décisions de rémunération et de promotion sont prises à partir d'un tableur que personne n'a audité — une seule note mal saisie change le niveau de performance dans lequel un employé se retrouve.
- Définissez vos colonnes une fois et déposez tous les documents — la feuille arrive avec les scores composites et les niveaux de performance déjà calculés, prête à pivoter avant le début de la réunion.
Le goulot d'étranglement de la calibration, c'est l'assemblage des données, pas le jugement
La calibration des talents existe pour normaliser les évaluations de performance entre les managers — pour repérer le manager dont toute l'équipe affiche une moyenne de 4,6 alors que la moyenne de l'entreprise est de 3,9, et pour s'assurer qu'un « 4 » signifie la même chose dans l'ingénierie que dans la vente. Rien de tout cela ne peut se produire tant que chaque évaluation n'est pas sur une seule feuille, une ligne par employé, avec des champs comparables.
C'est cette étape d'assemblage qui fait échouer le processus en silence. CEB (désormais intégré à Gartner) a constaté que les managers consacrent en moyenne 210 heures par an aux activités de gestion de la performance — et les employés 40 heures chacun — tandis que 77 % des responsables RH ont déclaré que les évaluations ne reflètent pas fidèlement les contributions des employés (SHRM/CEB). Une grande partie de ces 210 heures n'est pas consacrée à la rédaction de commentaires. C'est de la collecte — exporter les évaluations, imprimer les formulaires, et ressaisir les notes dans un classeur de synthèse que quelqu'un d'autre remettra en question dès que les chiffres sembleront anormaux.
La solution n'est pas d'ajouter plus de jugement dans la salle. C'est une couche de données fiable sous la salle — et cette couche commence par la conversion des documents d'évaluation en feuille de calcul sans parcours de ressaisie.
Où vivent réellement les données d'évaluation de performance
Avant de pouvoir extraire quoi que ce soit, il est utile de savoir ce que votre cycle d'évaluation produit réellement. Même les entreprises dotées d'un logiciel de performance ont rarement un bouton « tout exporter » qui fournit une feuille de calibration prête à l'emploi. En pratique, les données arrivent sous au moins quatre formes :
- Exports de plateforme. Workday, Lattice, 15Five et BambooHR permettent tous aux administrateurs de récupérer les données de cycle — mais l'export est généralement un vidage brut de questions et réponses, pas une ligne de synthèse par employé. Culture Amp, par exemple, exporte les données de cycle en CSV ou XLSX qui nécessitent encore un remodelage avant de correspondre à votre format de calibration (support Culture Amp).
- PDF par évaluation. Certaines plateformes n'exportent chaque évaluation que sous forme de PDF distinct — un fichier par employé, souvent livré par lots de cinquante. C'est un dossier rempli de documents, pas un ensemble de données.
- Formulaires Word et Google Docs. De nombreuses équipes de taille moyenne utilisent encore des modèles de formulaires partagés pour leurs cycles d'évaluation : les managers remplissent un document, le signent et le renvoient par e-mail. Les RH se retrouvent avec une boîte de réception de pièces jointes, chacune dans un état de modification légèrement différent.
- Feuilles d'évaluation scannées ou manuscrites. Toujours une réalité dans la fabrication, la vente au détail et les opérations terrain — un manager remplit un formulaire papier, les RH le numérisent, et la « numérisation » consiste généralement à ressaisir.
Il n'existe pas de bouton d'export universel parce que les documents eux-mêmes sont la source de vérité. Les formats sont ceux que les managers ont utilisés — c'est précisément pour cela que l'étape d'assemblage reste manuelle pour tant d'équipes.
Parallèlement aux documents formels, une grande partie des preuves ne quitte jamais le chat. Les éloges quotidiens, les préoccupations et les notes de coaching qu'un manager envoie dans un message Slack ou un canal Teams justifient souvent une note dans la salle de calibration — et ces captures d'écran de commentaires de manager sont tout aussi sujettes à la ressaisie que les formulaires d'évaluation eux-mêmes.
Ce que coûte l'assemblage manuel à une équipe People
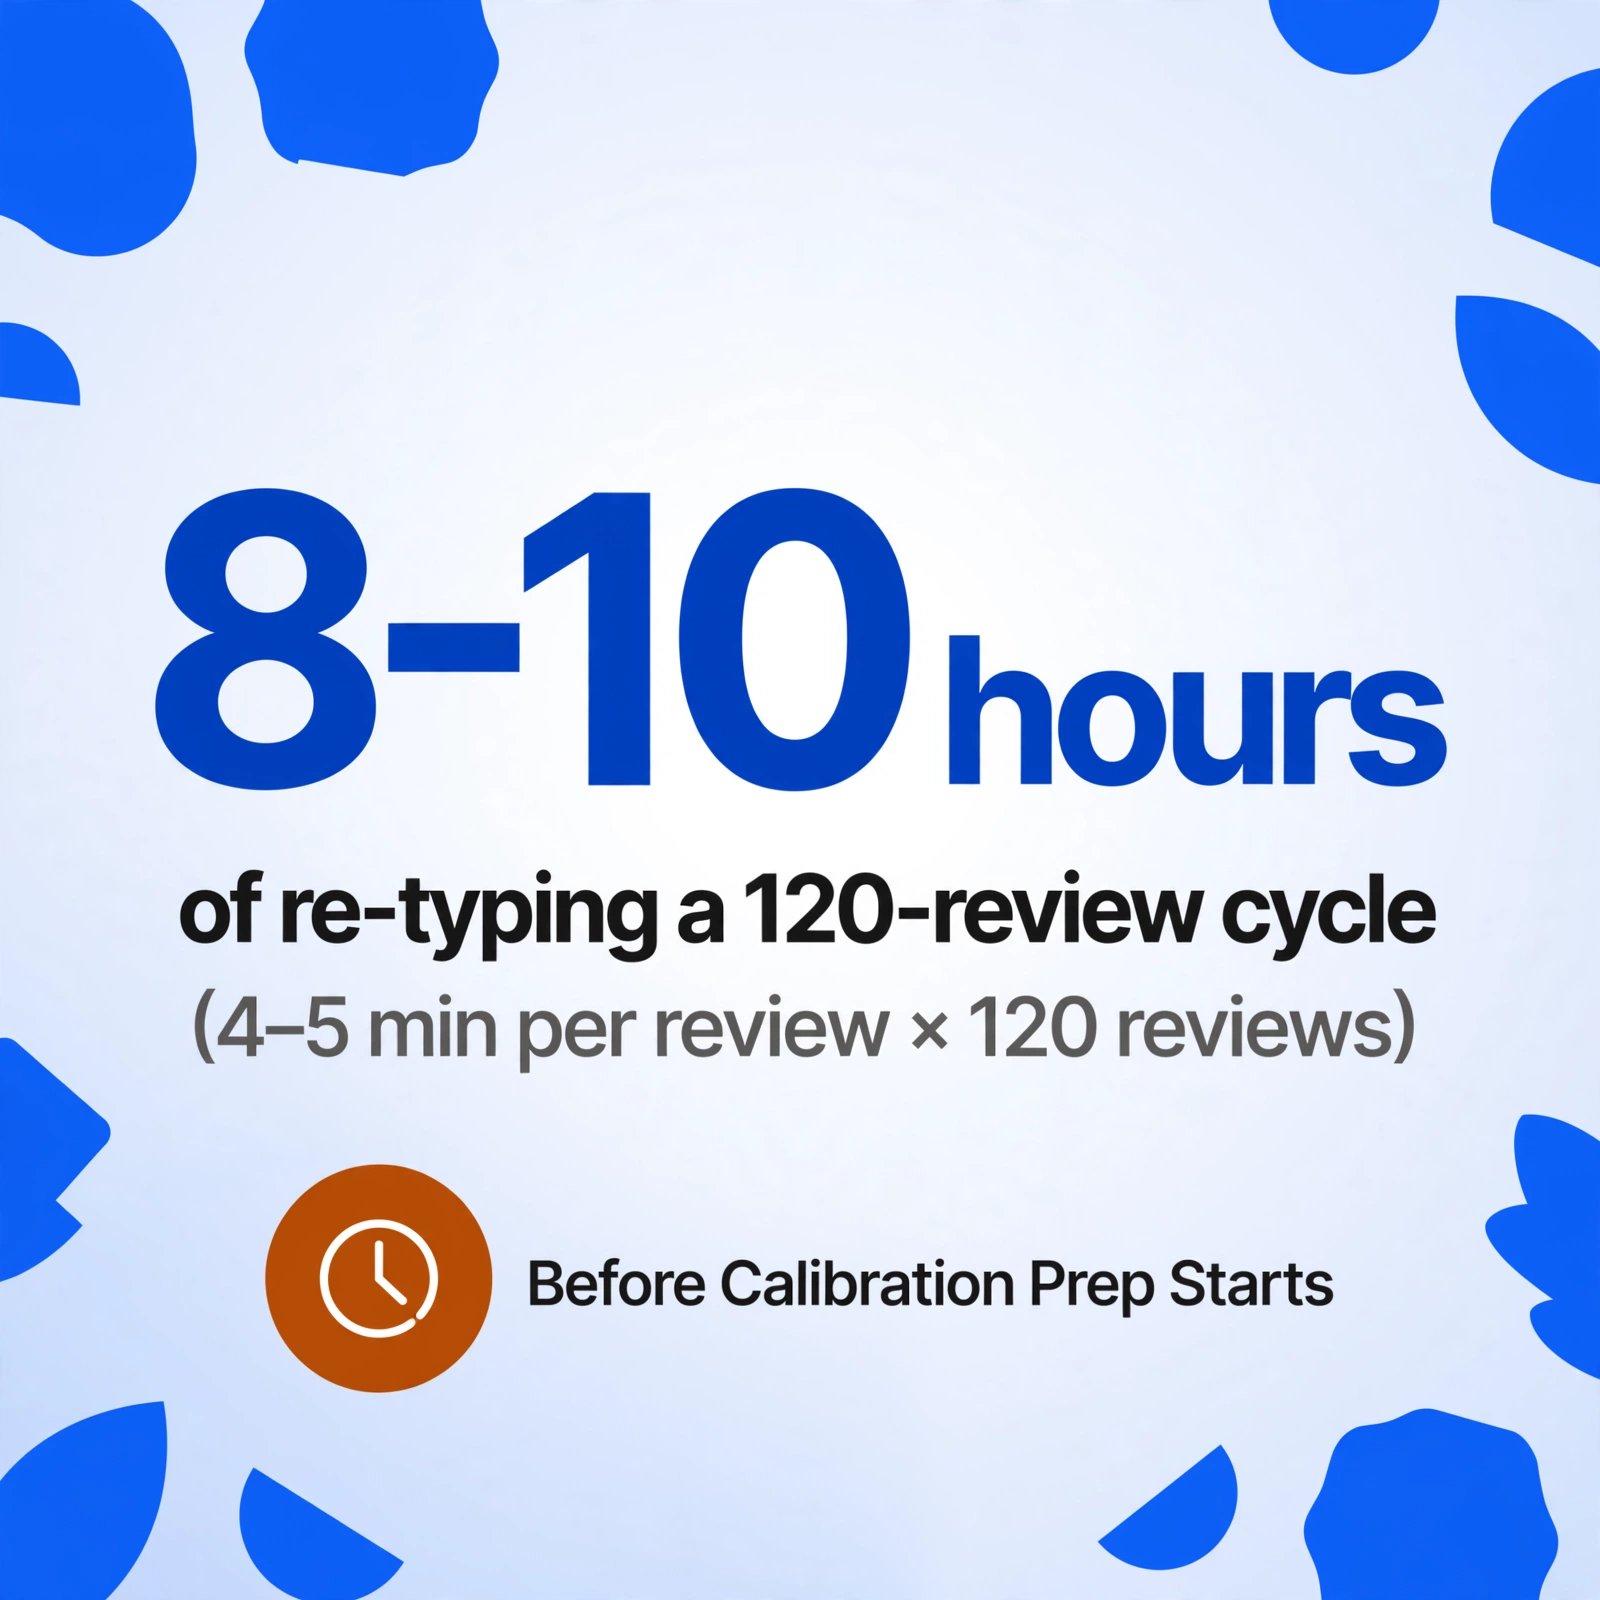
Voici le calcul que personne ne budgète. Un spécialiste des opérations RH qui consolide un cycle d'évaluation de 120 personnes passe environ 4 à 5 minutes par évaluation à ressaisir l'essentiel — nom de l'employé, service, manager, évaluation globale, les cinq scores de compétences, recommandation de promotion — et à parcourir les sections narratives pour repérer ce qui vaut la peine d'être repris. Pour 120 évaluations, cela représente 8 à 10 heures de transcription avant même d'avoir commencé la préparation de la calibration.
Le temps est le coût visible. Le coût invisible, c'est ce qu'une erreur de saisie provoque en aval. Un 4,2 inversé devient un 4,7 et change la fourchette dans laquelle un employé se retrouve. Une ligne sautée dans « Axes d'amélioration » signifie qu'une conversation de développement part du mauvais endroit. Lorsque la feuille de calibration alimente les décisions de rémunération et de promotion, chaque erreur de frappe a un nom attaché.
Le problème plus profond, c'est que la saisie manuelle est au pire de sa forme précisément quand elle est la plus probable — à la fin d'un cycle, sous une date de session fixe, quand tout le monde est épuisé. C'est là que les erreurs de transcription cessent d'être de rares exceptions et deviennent systématiques.
Le vrai coût n'est pas la vitesse de frappe. C'est que le tableur devient la source unique de vérité pour les décisions de rémunération, de promotion et de succession — et personne n'audite jamais la saisie qui l'a construit.
Concevoir la feuille de calibration : quelles données extraire
Le rôle du tableur est de rendre les différences de notation visibles et comparables — pas d'archiver chaque mot de chaque évaluation. Les équipes qui extraient tout passent leur session à défiler ; les équipes qui extraient les bons champs la passent à décider. (Si vous préférez voir le jeu de champs en action plutôt que d'en lire la description, la page de l'outil d'extraction de données d'évaluation de performance vers Excel présente les mêmes colonnes avec une démo en direct.)
| Champ | Pourquoi il figure dans la feuille |
|---|---|
| Nom de l'employé / ID de l'employé | Identifiant principal. L'ID compte lorsque deux employés portent le même nom. |
| Service / Manager | Les deux axes de la calibration : répartition par équipe et vérification de la clémence par manager. |
| Période d'évaluation | Garantit l'intégrité des feuilles multi-cycles — le 4,0 de l'année dernière n'est pas celui de cette année. |
| Évaluation globale | Saisie telle qu'imprimée sur le formulaire — 4,2 sur une échelle de 1 à 5, « Dépasse les attentes », selon ce que le formulaire utilise. Normalisez les échelles dans Excel après l'extraction. |
| Scores de compétences | Une colonne par compétence (Communication, Collaboration, Productivité, Qualité, Leadership). Les séparer montre d'où vient un écart de notation. |
| Score composite | Une colonne calculée : l'IA fait la moyenne des scores de compétences pendant l'extraction, pour obtenir un chiffre comparable unique sans post-traitement. |
| Niveau de performance | Une colonne inférée : l'IA classe chaque évaluation selon votre grille — Top / Strong / Developing / Needs Improvement — même si le formulaire n'imprime jamais de niveau. |
| Recommandation de promotion | Le champ qui alimente la planification de la relève — et celui le plus susceptible d'être contesté en réunion. |
| Points forts / Axes d'amélioration / Objectifs de développement | Colonnes de texte narratif. Vous n'avez pas besoin de chaque phrase — vous avez besoin des phrases qui changent un plan de développement. |
| Indicateur de haut potentiel | Une colonne inférée pour les discussions de succession : l'IA identifie les employés dont les évaluations décrivent une disposition à un périmètre élargi, selon les critères que vous définissez. |
Deux de ces colonnes méritent une attention particulière car elles n'existent sur aucun formulaire. Niveau de performance et Indicateur de haut potentiel sont des colonnes inférées — vous saisissez un nom de colonne avec les options souhaitées (par ex. « Niveau de performance (options : Top/Strong/Developing/Needs Improvement) »), et l'IA lit chaque évaluation et attribue la catégorie pendant l'extraction. Aucune formule, aucun second passage dans Excel. Et Score composite est une colonne calculée : décrivez le calcul dans le nom de la colonne (« Score composite (Communication + Collaboration + Productivité + Qualité + Leadership ÷ 5) ») et l'IA fait l'arithmétique en lisant les scores.
Étape par étape : transformez les évaluations en feuille de calibrage
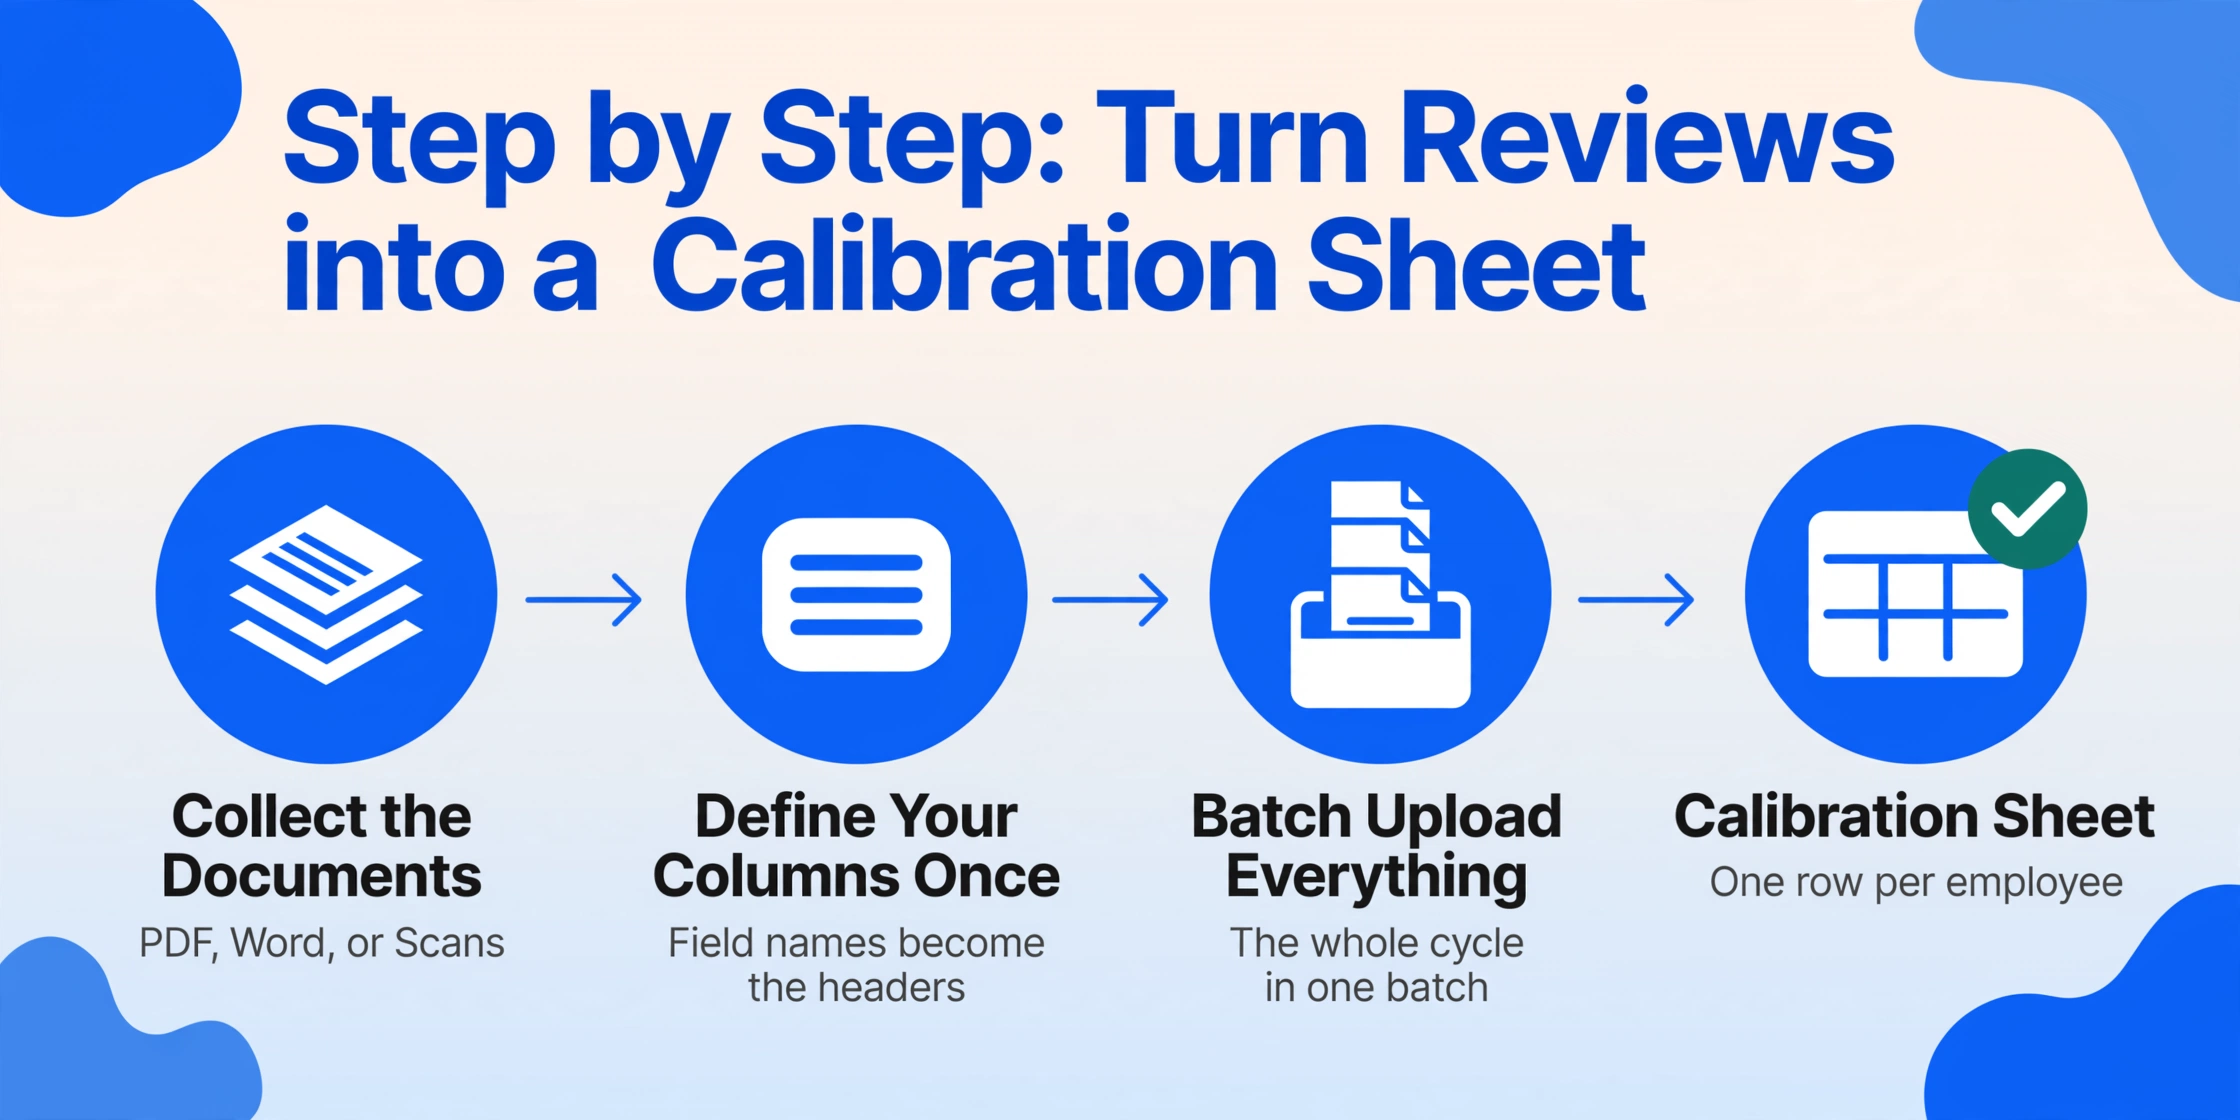
Le flux de travail ci-dessous fonctionne quel que soit le format produit par votre cycle — exports PDF de la plateforme, formulaires Word, feuilles scannées ou un mélange des trois. Il repose sur l'Extraction de colonnes personnalisées : vous saisissez les noms de champs souhaités, et l'IA localise chaque valeur sur chaque document en comprenant la signification du champ, et non son emplacement. Les noms de colonnes que vous saisissez deviennent les en-têtes de la feuille de calcul générée, de sorte que le tableau correspond à votre format de calibrage par construction.
Étape 1 : Collectez les documents d'évaluation
Rassemblez tout au même endroit : exports PDF de votre plateforme, formulaires Word ou Google Docs remplis, scans d'évaluations papier. Si vous récupérez des évaluations de managers qui les envoient encore par e-mail, un Lien de collecte — une page de téléversement partageable qui dépose les fichiers directement dans votre file de traitement — ou la Boîte de réception e-mail (transférez les évaluations à votre adresse dédiée et elles arrivent automatiquement dans la file) élimine la course au « envoyez-moi votre évaluation par e-mail ». Le même modèle de collecte que nous décrivons pour l'extraction de données de CV pour le recrutement s'applique ici : personne d'autre n'a besoin de compte, ils envoient simplement les fichiers.
Étape 2 : Définissez vos colonnes une fois
Saisissez la liste de champs de la section ci-dessus, adaptée à votre cycle. Nommez les colonnes en langage clair — « Évaluation globale », « Score de communication », « Recommandation de promotion » — et ajoutez les deux colonnes dérivées (« Niveau de performance », « Score composite »). Vous définissez cela une fois par cycle ; la même configuration peut être enregistrée comme modèle pour le cycle suivant.
Étape 3 : Téléversement de tout le lot
Déposez tous les documents dans un seul lot — formats mixtes, mises en page mixtes, sans pré-tri. Les PDF multipages sont divisés page par page et associés automatiquement à la bonne évaluation. Un lot de 120 évaluations produit un tableau : 120 lignes, une ligne par employé, avec toutes les colonnes alignées.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Étape 4 : Laissez les colonnes calculées préparer l'analyse
Comme le Niveau de performance et le Score composite sont calculés pendant l'extraction, la feuille arrive avec le travail difficile déjà fait : chaque employé a un niveau et un score comparable, et vous n'avez pas écrit une seule formule. Si votre cycle utilise une échelle d'évaluation qui varie selon le service (échelle de 1 à 5 ici, de 1 à 10 là), normalisez la colonne Évaluation globale dans Excel une fois les données exportées — c'est un rechercher-remplacer de cinq minutes, pas une session de ressaisie.
Étape 5 : Vérification rapide avant la réunion
Avant la session de calibration, effectuez une vérification rapide. En Mode Révision, survolez n'importe quelle cellule extraite et le document original met en évidence exactement l'endroit d'où provient cette valeur — ainsi, lorsqu'un manager conteste une évaluation en séance, vous pouvez montrer la source en quelques secondes au lieu de fouiller dans le dossier. Le Mode Révision permet également de détecter une erreur de saisie avant qu'elle n'atteigne une conversation salariale.
Étape 6 : Exportation et tableau croisé
Exportez vers Excel (XLSX) et vous obtenez la feuille de calibration — une ligne par employé, des colonnes prêtes à être pivotées. La feuille devient ensuite le document de travail de la session elle-même.
De la feuille brute à la session de calibration
L'intérêt de la feuille est de rendre le travail de la session visible avant qu'elle ne commence. Trois vérifications transforment les lignes brutes en ordre du jour de calibration.
Vérifiez la distribution par rapport à votre courbe cible. La répartition de référence couramment citée par le consultant RH Dick Grote place les performeurs solides à 50–60 % de l'effectif, avec la tranche supérieure à 5–10 % et la tranche inférieure à 2–5 % (SHRM). Filtrez par Performance Tier et comptez. Une entreprise où 80 % des employés sont « Top » n'est pas une entreprise performante — c'est une entreprise non calibrée.
Croisez par manager pour repérer l'indulgence et la sévérité. Insérez un tableau croisé dynamique avec Manager en lignes et Moyenne du Score composite en valeurs, puis comparez la moyenne d'équipe de chaque manager à la moyenne de l'entreprise. Le manager à 4,6 contre une moyenne d'entreprise de 3,9 est votre première discussion de calibration — non pas parce que son équipe est mauvaise, mais parce que son échelle est différente.
Préparez le dossier de pré-lecture par niveau et par service. Filtrez la feuille sur les employés que chaque session examinera et partagez les lignes pertinentes (évaluations, points forts des commentaires, recommandations de promotion) à l'avance. Les managers arrivent en ayant déjà vu les preuves — c'est précisément cette dynamique de preuves documentées qui rend les sessions de calibration productives plutôt que fondées sur les impressions.
Le même flux d'extraction qui a créé cette feuille s'étend au reste de votre pile de documents RH. Le guide d'extraction des formulaires d'onboarding couvre l'extraction de dossiers employés structurés à partir des documents d'intégration, le guide d'extraction de fiches de paie par lots montre le modèle appliqué aux documents de paie pour l'audit, et le traitement par lots des lettres d'offre transforme les promotions décidées lors de la calibration en dossiers contractuels — une approche de définition de colonnes, de nombreux types de documents.
Pourquoi les formulaires d'évaluation brisent l'analyse positionnelle
Les formulaires d'évaluation des performances sont un cas extrême pour l'OCR traditionnel. Le tableau de notation contient des cellules fusionnées et des cases à cocher. Les compétences sont présentées sous forme de grilles de Likert — cinq colonnes de cercles, une par ligne. Les zones de commentaires se trouvent sous chaque section, et les managers y écrivent autant que la zone le permet. Sur une feuille scannée, les notes sont parfois marquées à la main plutôt que tapées.
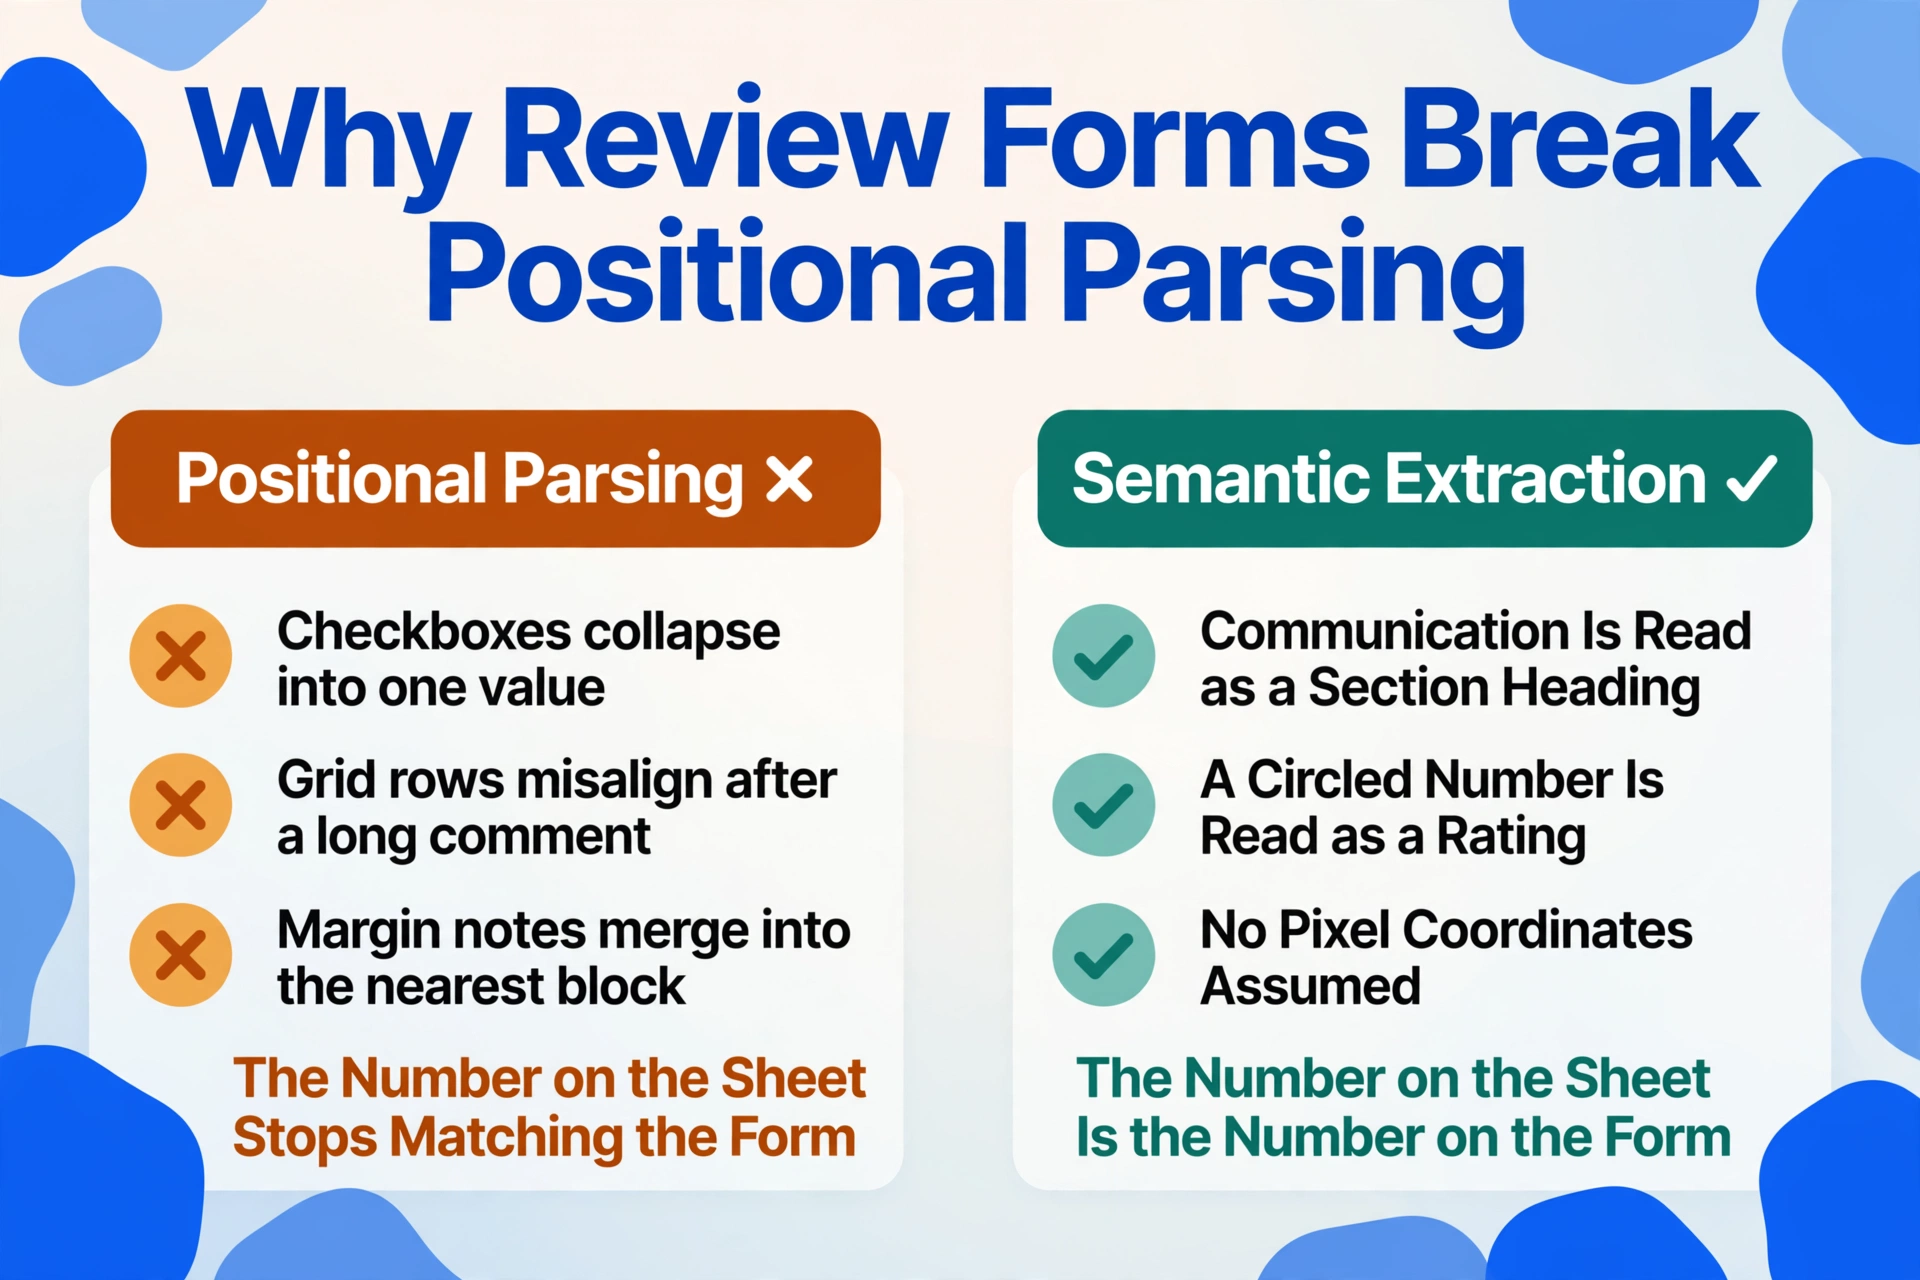
Les analyseurs basés sur la position — ceux qui cherchent du texte à des coordonnées attendues — échouent de manière spécifique : la colonne des cases à cocher se réduit à une seule valeur, les lignes de la grille se désalignent après un long commentaire, la note manuscrite en marge se fusionne avec le bloc de texte le plus proche. L'extraction sémantique contourne toute cette classe de problèmes car elle ne suppose jamais où se trouve une valeur. L'IA lit « Communication » comme un titre de section, sait que la ligne en dessous est le score de communication, et comprend qu'un nombre encerclé dans la grille est une note — par le sens, pas par la position des pixels.
Cela importe plus en RH que dans la plupart des domaines car les données sont l'argument. Dans un fil sur r/humanresources, les praticiens débattent de la façon de distinguer un 4 d'un 5 sur une échelle de 1 à 5 — si « dépasse les attentes » exige un volume de production, une qualité, ou les deux (r/humanresources). Si des professionnels RH expérimentés ne s'accordent pas sur la signification d'une note, la couche d'extraction doit au moins être indiscutable — le chiffre sur la feuille doit être le chiffre sur le formulaire.
Limites honnêtes : les formulaires imprimés propres s'extraient de manière fiable, y compris les cases à cocher et les grilles de notation. L'écriture manuscrite dense dans les zones de commentaires produit une confiance moindre — traitez les évaluations entièrement manuscrites comme nécessitant une vérification manuelle supplémentaire, et appuyez-vous sur le Mode Révision pour les vérifier.
Données sensibles : base légale, conservation et équité
Les évaluations de performance sont des dossiers d'emploi, et le tableur que vous construisez à partir d'elles est un ensemble de données personnelles. Cela change la façon dont le flux de travail doit être exécuté — non pas pour vous en dissuader, mais pour que le fichier soit construit de manière à pouvoir être défendu.
En vertu du RGPD, le traitement des données de performance repose généralement sur la nécessité professionnelle ou l'intérêt légitime comme base légale, et les employés conservent le droit d'accéder à leurs données (Article 15) et de faire corriger les inexactitudes (Article 16) — ce qui signifie que la traçabilité de chaque valeur extraite est importante, et que les périodes de conservation des anciens cycles doivent être définies et appliquées plutôt que laissées à s'accumuler. Aux États-Unis, le cadre de l'EEOC sur l'impact disproportionné s'applique lorsque les évaluations alimentent les décisions de promotion ou de rémunération : les critères sur lesquels vous filtrez (niveau, score composite) doivent être liés à l'emploi, et le processus d'étalonnage lui-même — qui a examiné, quelles preuves — doit être documenté.
Sur le plan opérationnel, un pipeline de tableur est défendable parce qu'il est transparent : extrayez uniquement les champs nécessaires à l'étalonnage (minimisation des données), vérifiez les valeurs par rapport au document source avec le Mode Révision avant la réunion, et conservez la piste d'audit de l'origine de chaque chiffre. Si un employé demande la suppression ou la correction, vous modifiez des lignes dans un fichier que vous contrôlez — pas en démêlant la base de données d'un fournisseur.
FAQ
Peut-il lire des formulaires d'évaluation de performance manuscrits ?
Les formulaires imprimés ou tapés — y compris les cases à cocher remplies, les grilles d'évaluation et les sections de commentaires — sont extraits de manière fiable. L'écriture manuscrite lisible sur un formulaire structuré (comme une feuille d'appréciation papier avec des champs étiquetés) est bien extraite. L'écriture cursive dense dans des zones non structurées produit une confiance plus faible et doit être examinée manuellement ; l'IA signale les zones de faible confiance pour que vous sachiez où regarder.
Mes évaluations sont déjà dans Lattice, Workday ou 15Five — ai-je encore besoin de l'extraction ?
Si votre plateforme exporte un résumé par employé avec tous les champs dont vous avez besoin pour l'étalonnage, utilisez cet export — l'extraction n'ajoute rien ici. Mais les exports de plateforme sont souvent des vidages question par question ou des PDF par évaluation qui nécessitent encore un assemblage, et les équipes qui utilisent des formulaires Word ou Google Docs en dehors de la plateforme n'ont aucun export. L'extraction comble l'écart entre ce que la plateforme vous fournit et ce dont la feuille d'étalonnage a besoin.
Peut-il calculer un score composite sur l'ensemble des compétences ?
Oui. Définissez une colonne calculée comme « Score composite (Communication + Collaboration + Productivité + Qualité + Leadership ÷ 5) » et l'IA fait la moyenne des scores de compétences extraits pendant le traitement — le résultat apparaît dans la feuille sous forme de nouvelle colonne, sans aucune formule Excel nécessaire. Cela fonctionne sur tout le lot en une seule passe.
Peut-il classer les évaluations en niveaux de performance ?
Oui, avec une colonne inférée. Saisissez « Niveau de performance (options : Top/Strong/Developing/Needs Improvement) » et l'IA attribue à chaque employé un niveau en fonction de ses évaluations et de vos catégories définies — même si le formulaire n'imprime jamais de niveau. Vous définissez les libellés et les critères ; la feuille arrive avec la classification déjà effectuée.
Combien d'évaluations puis-je traiter à la fois ?
Les téléversements par lot gèrent un cycle d'évaluation complet en une seule session — des dizaines à des centaines de documents sont traités en parallèle et fusionnés dans un tableau de sortie unique, une ligne par employé. Les PDF multipages sont scindés et appariés automatiquement, donc un export de cycle de 40 pages ne nécessite aucune gestion manuelle des pages.
Les données de performance des employés sont-elles confidentielles ?
Les fichiers sont traités puis automatiquement supprimés après une période de conservation configurable, et aucune donnée d'entraînement n'est conservée à partir des téléversements clients. La feuille de calcul extraite se trouve dans un fichier que vous contrôlez — c'est précisément ce qui rend les réponses aux demandes d'accès ou de suppression simples.
La calibration des talents ne fonctionne qu'avec les données que vous apportez. Si ces données restent dans un dossier de PDF et de formulaires, la session négocie déjà en position de faiblesse — aucune compétence d'animation ne corrige une feuille de calcul qui n'a jamais été créée.
Construisez la feuille du prochain cycle à partir des documents eux-mêmes. Téléversez quelques-uns de vos fichiers d'évaluation réels et voyez le tableau de calibration prendre forme en quelques secondes — évaluations, compétences, niveaux et retours en une seule passe, vérifiés par rapport à la source avant que quiconque ne s'assoie pour discuter d'un 4,2.